Die Datenarchitektur wandelt sich rasant – angetrieben durch den zunehmenden Einsatz von Cloud-Technologien und den modernen Data-Stack. Dadurch setzt sich ELT immer stärker durch. Aber was steckt genau hinter diesem Prozess?
In diesem Artikel sehen wir uns ELT und seine Rolle in fortgeschrittener Datenarchitektur genauer an.
Was ist ELT?
ELT steht für Extract, Load, Transform. Es handelt sich um einen Datenintegrationsprozess, bei dem Daten aus verschiedenen Quellen extrahiert, in ein Datenspeichersystem geladen und anschließend in ein Format transformiert werden, das sich leicht analysieren lässt.
Der ELT-Prozess wird vor allem in Architekturen des modernen Data-Stacks eingesetzt, in denen Daten in einem Data Lake oder Warehouse gespeichert, transformiert und analysiert werden.
Wie funktioniert ELT?
Wie der Name sagt, besteht ELT aus drei Schritten: Extract, Load und Transform. Schauen wir uns jeden Schritt genauer an.
Zuerst werden Daten aus unterschiedlichen Quellen wie Datenbanken, Dateien, APIs oder Webservices extrahiert. Das geschieht mit ELT-Tools oder mit eigens von Entwicklerinnen und Entwicklern geschriebenen Skripten.
Beispiele für Plattformen zur Datenextraktion sind Airbyte und Fivetran. Für eigene Skripte kommen Apache Spark und Python häufig zum Einsatz.
Die extrahierten Daten können strukturiert, semi-strukturiert oder unstrukturiert sein und aus unterschiedlichen Systemen stammen – etwa aus relationalen Datenbanken, NoSQL-Datenbanken oder Cloud-Speichern.
2. Load
Nach der Extraktion wird das Rohmaterial in ein zentrales Datenspeichersystem wie einen Data Lake oder ein Data Warehouse geladen. In diesem Schritt wird das extrahierte Datenmaterial unverändert und organisiert abgelegt.
Dateningenieurinnen und -ingenieure übernehmen in der Regel diesen Schritt und laden Daten auf Plattformen wie:
Diese Datenplattformen ermöglichen das schnelle Laden großer Datenmengen und dienen als Single Source of Truth für die aus verschiedenen Quellen gesammelten Daten.
Zum Schluss werden die Rohdaten in ein Format überführt, das für Analyse und Reporting optimiert ist. Dazu gehören das Bereinigen, Filtern, Aggregieren und Strukturieren der Daten, sodass BI- und Analytics-Tools effizient damit arbeiten können.
Dateningenieurinnen, -ingenieure oder Data Scientists verantworten diesen Schritt typischerweise und nutzen unter anderem:
- SQL-Abfragen
- Apache Spark
- Python-Bibliotheken wie Pandas oder NumPy
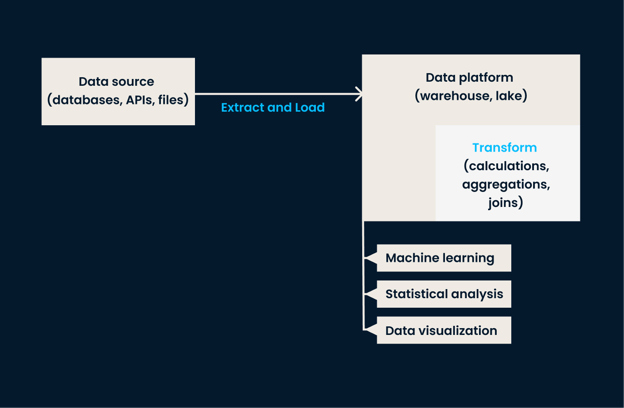
ELT-Datenpipeline: Extraktion und Laden erfolgen, bevor Daten transformiert werden. Die Transformation findet innerhalb der Datenplattform statt.
Die Transformation erfolgt im Data Warehouse oder Data Lake – ideal für große Datenvolumina. Mit modernen Cloud-Technologien lässt sich dieser Prozess nahezu in Echtzeit umsetzen – und Unternehmen erhalten schnell Zugriff auf aktuelle, verlässliche Daten.
Du willst Python für ELT lernen? Dann ist der Kurs ETL and ELT in Python genau das Richtige.
Vorteile von ELT
ELT bringt viele Vorteile mit sich. Hier die wichtigsten:
- Skalierbarkeit: Dank Cloud-Rechenleistung lassen sich große Datenmengen schneller extrahieren, laden und transformieren als mit klassischen ETL-Prozessen.
- Flexibilität: ELT integriert Daten aus unterschiedlichsten Quellen – strukturiert, semi-strukturiert und unstrukturiert.
- Schnelle Echtzeit-Einblicke: Rohdaten im Data Lake oder Warehouse können bei Bedarf zügig transformiert werden – für Echtzeit-Einblicke und schnellere Entscheidungen.
ELT vs. ETL
Vergleichen wir nun die Unterschiede zwischen ELT und ETL.
Wie erwähnt ist ELT ein neuerer Ansatz, bei dem Daten zuerst in ein zentrales Repository geladen werden und die Transformation danach erfolgt.
ETL (Extract, Transform, Load) ist dagegen der klassische Ansatz: Die Daten werden vor dem Laden in das Zielsystem transformiert. Diese grundlegenden Unterschiede wirken sich auf Prozess, Geschwindigkeit, Kosten und Sicherheit aus.
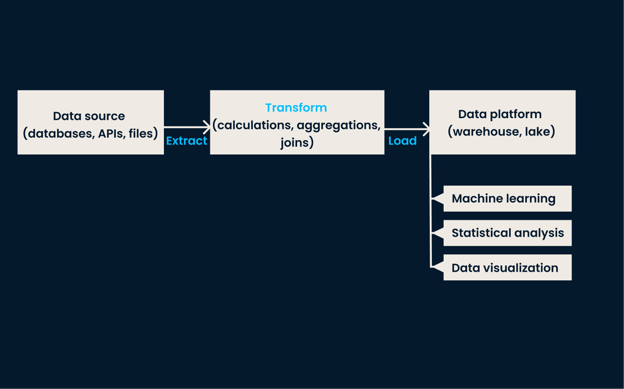
ETL-Pipeline: Die Transformation erfolgt, bevor die Daten in die Zielplattform geladen werden. Meist findet sie auf einem separaten Server statt – nicht in der Datenplattform selbst.
Prozess
ELT folgt dem Prinzip „erst laden, dann transformieren“: Daten werden im Rohformat in ein Speichersystem geschrieben und anschließend für die Analyse aufbereitet.
ETL hingegen setzt auf „extract–transform–load“: Daten werden aus verschiedenen Quellen extrahiert, transformiert und schließlich in ein Data Warehouse geladen.
Geschwindigkeit
ELT ist für seine höhere Verarbeitungsgeschwindigkeit bekannt, da keine zusätzliche Staging-Ebene erforderlich ist. So werden Analysen in Echtzeit oder nahezu in Echtzeit möglich.
ETL dauert oft länger, weil die Transformation vor dem Laden stattfindet und mehrere Schritte umfasst.
Kosten
ELT spart zudem oft teure ETL-Spezialsoftware, da Transformationen mit SQL-Abfragen oder anderen Open-Source-Tools durchgeführt werden können.
Klassische ETL-Prozesse passen häufig besser zu On-Premises-Infrastrukturen, in denen Datenquellen begrenzt und Hardware-Ressourcen weniger skalierbar sind als in der Cloud. On-Premises verursacht dabei oft höhere Kosten als Cloud-Infrastruktur.
Sicherheit
ELT ermöglicht Verschlüsselung und Maskierung personenbezogener Daten (PII) bereits beim Laden – innerhalb eines sicheren zentralen Repositories.
ETL muss die Datensicherheit während Extraktion und Transformation gewährleisten. Das ist schwieriger, weil Daten in zusätzliche Staging-Speicher verschoben und oft auf separaten Servern verarbeitet werden.
ELT: Einsatzszenarien
Dank höherer Verarbeitungsgeschwindigkeit und Cloud-Analytics glänzt ELT in einigen Szenarien besonders im Vergleich zu ETL.
Häufige Anwendungsfälle sind:
- Echtzeit-App-Reporting: ELT liefert Echtzeit-Einblicke in das Verhalten von App-Nutzenden.
- Data Warehousing: Viele Unternehmen laden und transformieren Daten per ELT in einem zentralen Data Warehouse für Reporting und Analytics.
- Cloudbasierte Datenintegration: Mit dem Aufstieg der Cloud ist ELT eine gefragte Option, um Datenquellen aus On-Premises- und Cloud-Anwendungen zusammenzuführen.
Für die Umsetzung von ELT stehen zahlreiche Tools und Technologien zur Verfügung. Dazu gehören:
Data Warehouses und Data Lakes
Im Load-Schritt des ELT-Prozesses sind Data Lakes und Data Warehouses zentral – sie stellen den unternehmensweiten Datenspeicher bereit.
Zu den beliebtesten Cloud-Datenplattformen zählen:
- Amazon Redshift: Cloud-Data-Warehouse, das sehr große Datenmengen schnell und effizient verarbeitet.
- Google BigQuery: Serverloses, skalierbares Cloud-Data-Warehouse für schnelle Abfragen großer Datensätze.
- Snowflake: Cloudbasiertes Data-Warehouse mit ELT-Unterstützung sowie starker Sicherheit und Performance.
- Amazon S3: Cloud-Speicher, der sich als Data Lake für Rohdaten eignet, die anschließend per SQL oder anderen Tools transformiert werden.
Viele Organisationen setzen aus Kostengründen auf Open-Source-Tools für ihre ELT-Prozesse.
Diese Tools unterstützen unterschiedliche Phasen des ELT-Prozesses:
- Apache Airflow: Automatisierung und Scheduling von ETL/ELT-Workflows.
- dbt: Open-Source-Software zur Transformation von Daten im Data Warehouse mit SQL.
- Airbyte: Open-Source-Plattform für Datenintegration, die ELT wie ETL unterstützt.
- Singer: Open-Source-Tool für ELT und ETL mit modularem Ansatz.
- Apache NiFi: Open-Source-Datenintegrationstool für Datenrouting, Transformation und Vermittlungslogik zwischen Systemen.
Open-Source-Tools passen hervorragend zu ELT-Prozessen: Sie bieten Flexibilität, starke Communitys und viele Integrationsmöglichkeiten.
Individuelle Skripte
Entwicklerinnen und Entwickler können für maximale Anpassbarkeit auch eigene Skripte in Programmiersprachen nutzen. Dabei kommen meist Pakete und Bibliotheken zur Datenverarbeitung und -transformation zum Einsatz.
Häufig verwendete Sprachen sind:
- Python: Mit Bibliotheken wie Pandas, NumPy und SQLAlchemy lassen sich Daten extrahieren, laden und transformieren.
- Apache Spark: Für Big-Data-Verarbeitung und -Analytik – oft mit Python (PySpark), Java oder Scala.
- R: Das tidyverse-Framework und weitere R-Bibliotheken wie dplyr und data.table eignen sich für Extraktion und Transformation.
- SQL: SQL-Abfragen für Transformationen, und SQL Server Integration Services (SSIS) ist ein bekanntes ETL-Tool, das auch ELT unterstützt.
- Scala: Häufig mit Apache Spark für Big Data und ELT-Aufgaben im Einsatz.
- Java: Weit verbreitet mit Big-Data-Frameworks wie Apache Hadoop und Apache Spark für ELT-Prozesse.
Fazit
ELT ist ein neuer, aufstrebender Ansatz in der Datenverarbeitung und bietet viele Vorteile gegenüber klassischen ETL-Methoden. Transformationen werden schneller und effizienter, zugleich steigt Flexibilität und Skalierbarkeit.
Wenn du mehr über ELT oder andere Data-Engineering-Konzepte lernen willst, schau dir unsere Data Engineer Certification oder den Data Engineer in Python Career Track an.


Die Datenarchitektur wandelt sich rasant – angetrieben durch den zunehmenden Einsatz von Cloud-Technologien und den modernen Data-Stack. Dadurch setzt sich ELT immer stärker durch. Aber was steckt genau hinter diesem Prozess?
In diesem Artikel sehen wir uns ELT und seine Rolle in fortgeschrittener Datenarchitektur genauer an.
Was ist ELT?
ELT steht für Extract, Load, Transform. Es handelt sich um einen Datenintegrationsprozess, bei dem Daten aus verschiedenen Quellen extrahiert, in ein Datenspeichersystem geladen und anschließend in ein Format transformiert werden, das sich leicht analysieren lässt.
Der ELT-Prozess wird vor allem in Architekturen des modernen Data-Stacks eingesetzt, in denen Daten in einem Data Lake oder Warehouse gespeichert, transformiert und analysiert werden.
Wie funktioniert ELT?
Wie der Name sagt, besteht ELT aus drei Schritten: Extract, Load und Transform. Schauen wir uns jeden Schritt genauer an.
1. Extract
Zuerst werden Daten aus unterschiedlichen Quellen wie Datenbanken, Dateien, APIs oder Webservices extrahiert. Das geschieht mit ELT-Tools oder mit eigens von Entwicklerinnen und Entwicklern geschriebenen Skripten.
Beispiele für Plattformen zur Datenextraktion sind Airbyte und Fivetran. Für eigene Skripte kommen Apache Spark und Python häufig zum Einsatz.
Die extrahierten Daten können strukturiert, semi-strukturiert oder unstrukturiert sein und aus unterschiedlichen Systemen stammen – etwa aus relationalen Datenbanken, NoSQL-Datenbanken oder Cloud-Speichern.
2. Load
Nach der Extraktion wird das Rohmaterial in ein zentrales Datenspeichersystem wie einen Data Lake oder ein Data Warehouse geladen. In diesem Schritt wird das extrahierte Datenmaterial unverändert und organisiert abgelegt.
Dateningenieurinnen und -ingenieure übernehmen in der Regel diesen Schritt und laden Daten auf Plattformen wie:
Diese Datenplattformen ermöglichen das schnelle Laden großer Datenmengen und dienen als Single Source of Truth für die aus verschiedenen Quellen gesammelten Daten.
3. Transform
Zum Schluss werden die Rohdaten in ein Format überführt, das für Analyse und Reporting optimiert ist. Dazu gehören das Bereinigen, Filtern, Aggregieren und Strukturieren der Daten, sodass BI- und Analytics-Tools effizient damit arbeiten können.
Dateningenieurinnen, -ingenieure oder Data Scientists verantworten diesen Schritt typischerweise und nutzen unter anderem:
ELT-Datenpipeline: Extraktion und Laden erfolgen, bevor Daten transformiert werden. Die Transformation findet innerhalb der Datenplattform statt.
Die Transformation erfolgt im Data Warehouse oder Data Lake – ideal für große Datenvolumina. Mit modernen Cloud-Technologien lässt sich dieser Prozess nahezu in Echtzeit umsetzen – und Unternehmen erhalten schnell Zugriff auf aktuelle, verlässliche Daten.
Du willst Python für ELT lernen? Dann ist der Kurs ETL and ELT in Python genau das Richtige.
Vorteile von ELT
ELT bringt viele Vorteile mit sich. Hier die wichtigsten:
ELT vs. ETL
Vergleichen wir nun die Unterschiede zwischen ELT und ETL.
Wie erwähnt ist ELT ein neuerer Ansatz, bei dem Daten zuerst in ein zentrales Repository geladen werden und die Transformation danach erfolgt.
ETL (Extract, Transform, Load) ist dagegen der klassische Ansatz: Die Daten werden vor dem Laden in das Zielsystem transformiert. Diese grundlegenden Unterschiede wirken sich auf Prozess, Geschwindigkeit, Kosten und Sicherheit aus.
ETL-Pipeline: Die Transformation erfolgt, bevor die Daten in die Zielplattform geladen werden. Meist findet sie auf einem separaten Server statt – nicht in der Datenplattform selbst.
Prozess
ELT folgt dem Prinzip „erst laden, dann transformieren“: Daten werden im Rohformat in ein Speichersystem geschrieben und anschließend für die Analyse aufbereitet.
ETL hingegen setzt auf „extract–transform–load“: Daten werden aus verschiedenen Quellen extrahiert, transformiert und schließlich in ein Data Warehouse geladen.
Geschwindigkeit
ELT ist für seine höhere Verarbeitungsgeschwindigkeit bekannt, da keine zusätzliche Staging-Ebene erforderlich ist. So werden Analysen in Echtzeit oder nahezu in Echtzeit möglich.
ETL dauert oft länger, weil die Transformation vor dem Laden stattfindet und mehrere Schritte umfasst.
Kosten
ELT spart zudem oft teure ETL-Spezialsoftware, da Transformationen mit SQL-Abfragen oder anderen Open-Source-Tools durchgeführt werden können.
Klassische ETL-Prozesse passen häufig besser zu On-Premises-Infrastrukturen, in denen Datenquellen begrenzt und Hardware-Ressourcen weniger skalierbar sind als in der Cloud. On-Premises verursacht dabei oft höhere Kosten als Cloud-Infrastruktur.
Sicherheit
ELT ermöglicht Verschlüsselung und Maskierung personenbezogener Daten (PII) bereits beim Laden – innerhalb eines sicheren zentralen Repositories.
ETL muss die Datensicherheit während Extraktion und Transformation gewährleisten. Das ist schwieriger, weil Daten in zusätzliche Staging-Speicher verschoben und oft auf separaten Servern verarbeitet werden.
ELT: Einsatzszenarien
Dank höherer Verarbeitungsgeschwindigkeit und Cloud-Analytics glänzt ELT in einigen Szenarien besonders im Vergleich zu ETL.
Häufige Anwendungsfälle sind:
ELT-Tools und -Technologien
Für die Umsetzung von ELT stehen zahlreiche Tools und Technologien zur Verfügung. Dazu gehören:
Data Warehouses und Data Lakes
Im Load-Schritt des ELT-Prozesses sind Data Lakes und Data Warehouses zentral – sie stellen den unternehmensweiten Datenspeicher bereit.
Zu den beliebtesten Cloud-Datenplattformen zählen:
Open-Source-ELT-Tools
Viele Organisationen setzen aus Kostengründen auf Open-Source-Tools für ihre ELT-Prozesse.
Diese Tools unterstützen unterschiedliche Phasen des ELT-Prozesses:
Open-Source-Tools passen hervorragend zu ELT-Prozessen: Sie bieten Flexibilität, starke Communitys und viele Integrationsmöglichkeiten.
Individuelle Skripte
Entwicklerinnen und Entwickler können für maximale Anpassbarkeit auch eigene Skripte in Programmiersprachen nutzen. Dabei kommen meist Pakete und Bibliotheken zur Datenverarbeitung und -transformation zum Einsatz.
Häufig verwendete Sprachen sind:
Fazit
ELT ist ein neuer, aufstrebender Ansatz in der Datenverarbeitung und bietet viele Vorteile gegenüber klassischen ETL-Methoden. Transformationen werden schneller und effizienter, zugleich steigt Flexibilität und Skalierbarkeit.
Wenn du mehr über ELT oder andere Data-Engineering-Konzepte lernen willst, schau dir unsere Data Engineer Certification oder den Data Engineer in Python Career Track an.