Chuyển đến nội dung chính

Giải thích về ELT: Tích hợp dữ liệu trong kỷ nguyên đám mây

Tìm hiểu quy trình ELT (Extract, Load, Transform) và vai trò của nó trong kiến trúc dữ liệu hiện đại. Khám phá cách ELT nâng cao tích hợp và xử lý dữ liệu.
Đã cập nhật 4 thg 10, 2026  · 7 phút đọc

Khám phá cùng AI

ChatGPTClaudePerplexity

Bức tranh kiến trúc dữ liệu đang thay đổi dưới tác động của việc sử dụng công nghệ đám mây ngày càng tăng và sự phổ biến của modern data stack. Do đó, quy trình ELT ngày càng được áp dụng rộng rãi. Nhưng chính xác thì quy trình này bao gồm những gì?

Trong bài viết này, chúng ta sẽ tìm hiểu về ELT và vai trò của nó trong kiến trúc dữ liệu tiên tiến.

ELT là gì?

ELT là viết tắt của Extract, Load, Transform (Trích xuất, Nạp, Chuyển đổi). Đây là một quy trình tích hợp dữ liệu, bao gồm việc trích xuất dữ liệu từ nhiều nguồn, nạp vào hệ thống lưu trữ dữ liệu và chuyển đổi thành định dạng dễ phân tích.

Quy trình ELT chủ yếu được sử dụng trong kiến trúc modern data stack, nơi dữ liệu được lưu trữ, chuyển đổi và phân tích trong data lake hoặc data warehouse.

ELT hoạt động như thế nào?

Đúng như tên gọi, ELT bao gồm ba bước chính: Extract, Load và Transform. Hãy cùng xem kỹ từng bước.

1. Extract

Bước đầu tiên trong quy trình ELT là trích xuất dữ liệu từ nhiều nguồn như cơ sở dữ liệu, tệp, API hoặc dịch vụ web. Việc này có thể được thực hiện bằng các công cụ ELT hoặc các script tùy chỉnh do nhà phát triển viết.

Một số nền tảng trích xuất dữ liệu phổ biến gồm Airbyte và Fivetran. Để viết script tùy chỉnh, Apache Spark và Python được sử dụng rộng rãi. 

Dữ liệu được trích xuất có thể là dữ liệu có cấu trúc, bán cấu trúc hoặc phi cấu trúc và có thể đến từ nhiều hệ thống khác nhau, như cơ sở dữ liệu quan hệ, cơ sở dữ liệu NoSQL hoặc lưu trữ đám mây.

2. Load

Sau khi dữ liệu được trích xuất, dữ liệu sẽ được nạp vào hệ thống lưu trữ dữ liệu tập trung như data lake hoặc data warehouse. Bước này liên quan đến việc tổ chức và lưu trữ dữ liệu đã trích xuất ở dạng thô, chưa qua chuyển đổi.

Các kỹ sư dữ liệu thường tham gia bước này, nơi họ nạp dữ liệu lên các nền tảng như:

Các nền tảng dữ liệu này cho phép nạp nhanh lượng dữ liệu lớn và cung cấp một nguồn sự thật duy nhất cho tất cả các loại dữ liệu khác nhau được thu thập từ nhiều nguồn.

3. Transform

Bước cuối cùng trong quy trình ELT là chuyển đổi dữ liệu thô thành định dạng tối ưu cho phân tích và báo cáo. Việc này bao gồm làm sạch, lọc, tổng hợp và cấu trúc dữ liệu theo cách phù hợp để các công cụ BI và phân tích có thể sử dụng.

Kỹ sư dữ liệu hoặc nhà khoa học dữ liệu thường chịu trách nhiệm bước này, họ có thể sử dụng các công cụ như:
  • Câu lệnh SQL
  • Apache Spark
  • Các thư viện Python như Pandas hoặc NumPy

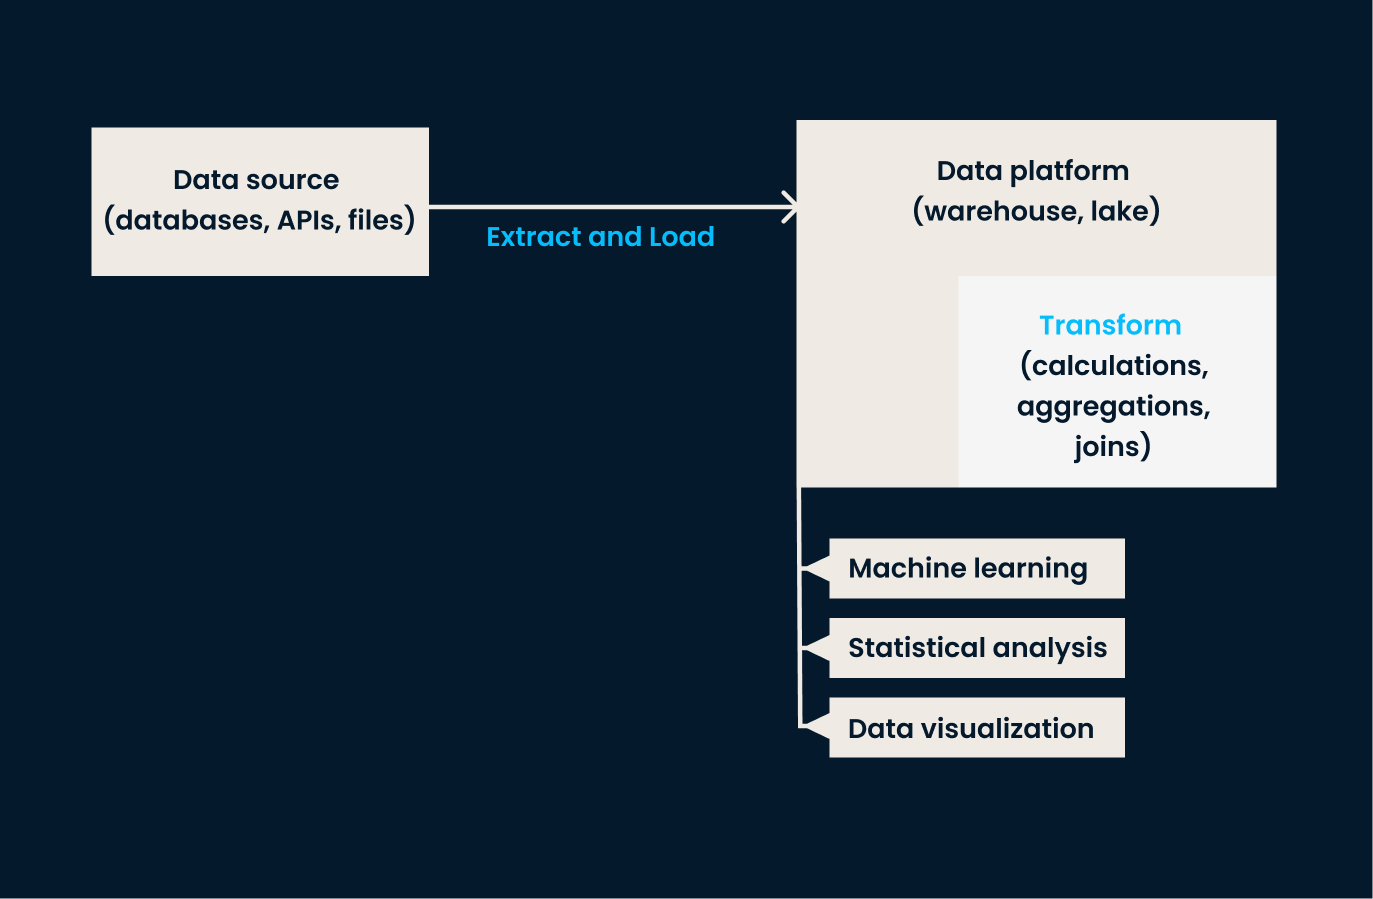
ELT data pipeline

Pipeline dữ liệu ELT: Các giai đoạn trích xuất và nạp diễn ra trước khi bất kỳ chuyển đổi nào được áp dụng lên dữ liệu. Bước chuyển đổi được thực hiện trong chính nền tảng dữ liệu.

Việc chuyển đổi dữ liệu được thực hiện trong data warehouse hoặc data lake, giúp xử lý khối lượng dữ liệu lớn dễ dàng hơn. Với các công nghệ đám mây hiện đại, quy trình này có thể diễn ra gần thời gian thực, giúp tổ chức truy cập dữ liệu mới và chính xác để phân tích.

Muốn tìm hiểu thêm về việc dùng Python cho ELT? Khóa học ETL và ELT bằng Python có thể là đúng thứ bạn cần.

Ưu điểm của ELT

ELT có nhiều lợi ích, dưới đây là một số điểm nổi bật:

  • Khả năng mở rộng: ELT cho phép trích xuất, nạp và chuyển đổi lượng dữ liệu lớn nhanh hơn so với quy trình ETL truyền thống nhờ sức mạnh của điện toán đám mây.
  • Tính linh hoạt: ELT cho phép tích hợp dữ liệu từ nhiều nguồn, bao gồm dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc.
  • Tốc độ tạo insight theo thời gian thực: Dữ liệu thô được lưu trong data lake hoặc data warehouse có thể được chuyển đổi theo nhu cầu một cách nhanh chóng, cung cấp insight theo thời gian thực để ra quyết định nhanh hơn.

ELT so với ETL

Giờ hãy so sánh sự khác biệt giữa ELT và ETL.

Như đã đề cập, ELT là cách tiếp cận mới trong xử lý dữ liệu, trong đó dữ liệu được nạp trước vào kho trung tâm, cho phép thực hiện chuyển đổi sau khi nạp.

Ngược lại, ETL (Extract, Transform, Load) là phương pháp truyền thống, trong đó dữ liệu được chuyển đổi trước khi nạp vào hệ thống đích. Những khác biệt cốt lõi này ảnh hưởng không chỉ đến quy trình mà còn đến tốc độ, chi phí và bảo mật.
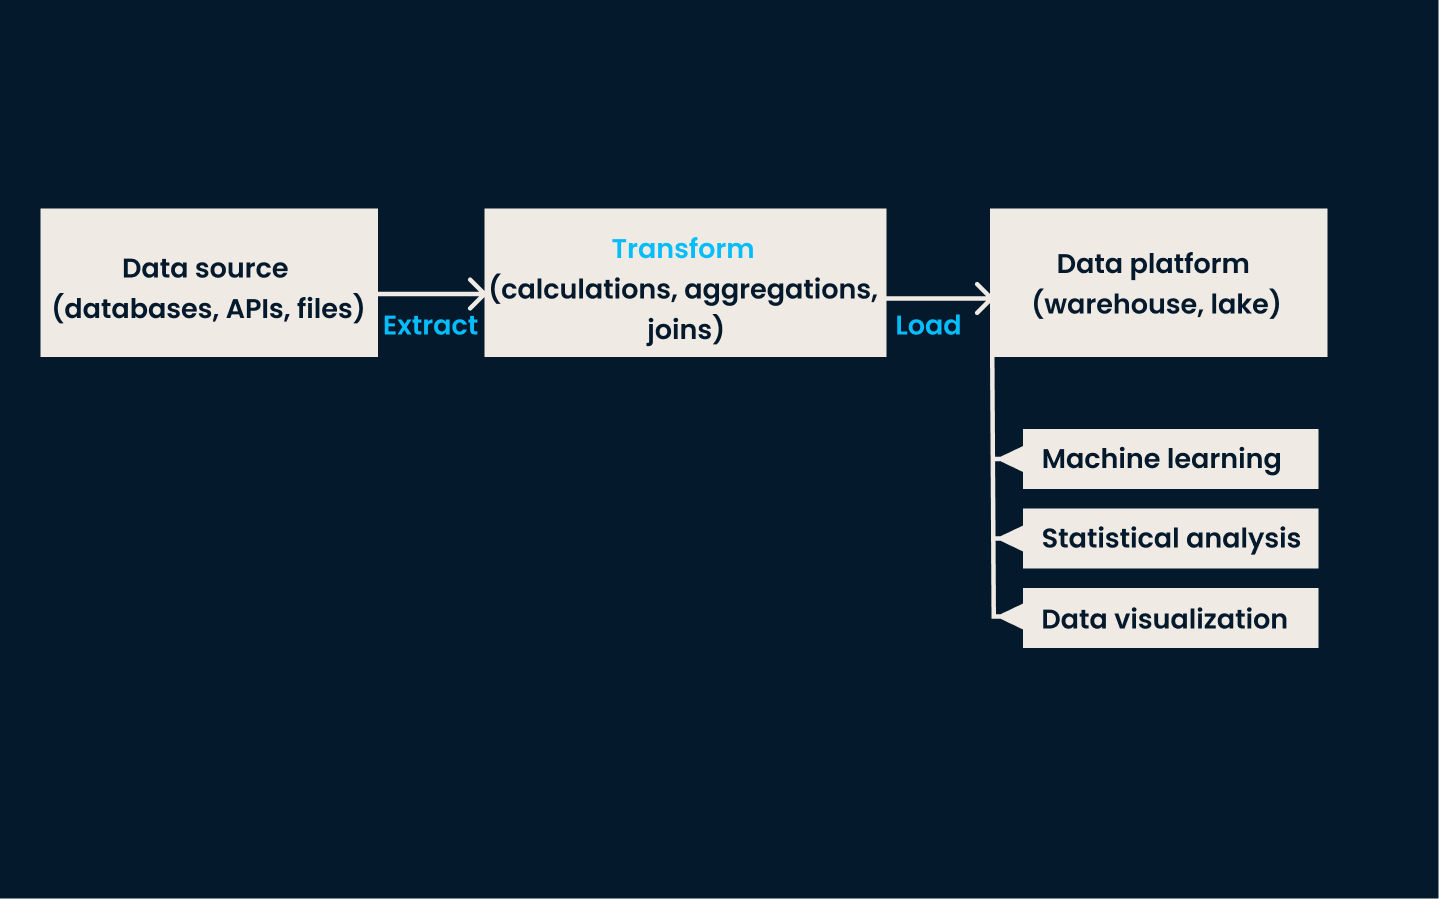
ETL data pipeline

Pipeline ETL: Bước chuyển đổi diễn ra trước khi nạp dữ liệu lên nền tảng đích. Thông thường, chuyển đổi diễn ra trên máy chủ tách biệt thay vì trong chính nền tảng dữ liệu.

Quy trình

ELT tuân theo cách làm “nạp trước, chuyển đổi sau”, trong đó dữ liệu được nạp vào hệ thống lưu trữ ở dạng thô rồi mới chuyển đổi để phân tích. 

Trong khi đó, ETL theo hướng “trích xuất - chuyển đổi - nạp”, tức dữ liệu được trích xuất từ nhiều nguồn, sau đó chuyển đổi và cuối cùng nạp vào data warehouse.

Tốc độ

Cách tiếp cận ELT nổi tiếng với tốc độ xử lý dữ liệu nhanh hơn vì loại bỏ nhu cầu về vùng trung gian. Điều này cho phép phân tích dữ liệu theo thời gian thực hoặc gần thời gian thực. 

Ngược lại, ETL thường mất nhiều thời gian hơn do có nhiều bước chuyển đổi và nạp dữ liệu.

Chi phí

Ngoài ra, ELT loại bỏ nhu cầu sử dụng phần mềm ETL đắt tiền, vì có thể thực hiện chuyển đổi bằng câu lệnh SQL hoặc các công cụ nguồn mở.

Ngược lại, các quy trình ETL truyền thống thường phù hợp hơn với hạ tầng on-premises, nơi nguồn dữ liệu hạn chế và tài nguyên phần cứng kém khả năng mở rộng hơn so với môi trường đám mây. Hạ tầng on-premises thường có chi phí cao hơn hạ tầng đám mây.

Bảo mật

Cuối cùng, ELT cho phép mã hóa dữ liệu và che giấu dữ liệu nhận dạng cá nhân (PII) ngay trong quá trình nạp vì nó được thực hiện trong kho trung tâm an toàn. 

Quy trình ETL phải đảm bảo an ninh dữ liệu xuyên suốt quá trình trích xuất và chuyển đổi. Tuy nhiên, điều đó khá thách thức do dữ liệu phải di chuyển đến vùng lưu trữ trung gian bổ sung và thường được xử lý trên máy chủ riêng biệt.

Trường hợp sử dụng ELT

Với tốc độ xử lý dữ liệu nhanh và năng lực phân tích trên đám mây, quy trình ELT tỏ ra vượt trội trong một số trường hợp so với ETL.

Dưới đây là một số cách sử dụng phổ biến của ELT:

  • Báo cáo thời gian thực cho ứng dụng: ELT giúp doanh nghiệp nắm bắt insight theo thời gian thực về hành vi người dùng trong ứng dụng.
  • Kho dữ liệu: Nhiều tổ chức dùng ELT để nạp và chuyển đổi dữ liệu vào kho dữ liệu tập trung nhằm phục vụ báo cáo và phân tích.
  • Tích hợp dữ liệu trên đám mây: Với sự trỗi dậy của công nghệ đám mây, ELT trở thành lựa chọn phổ biến để tích hợp nguồn dữ liệu từ nhiều ứng dụng on-premises và đám mây.

Công cụ và công nghệ ELT

Có nhiều công cụ và công nghệ để tổ chức triển khai quy trình ELT. Bao gồm:

Data warehouse và data lake

Trong bước nạp của quy trình ELT, data lake và data warehouse đóng vai trò thiết yếu, cung cấp không gian lưu trữ dữ liệu tập trung trong doanh nghiệp.

Dưới đây là các nền tảng dữ liệu đám mây phổ biến nhất:

  • Amazon Redshift: Dịch vụ kho dữ liệu đám mây có thể xử lý lượng dữ liệu khổng lồ nhanh chóng và hiệu quả.
  • Google BigQuery: Kho dữ liệu đám mây không máy chủ, có khả năng mở rộng, cho phép truy vấn nhanh các bộ dữ liệu lớn.
  • Snowflake: Kho dữ liệu dựa trên đám mây hỗ trợ quy trình ELT và cung cấp bảo mật, hiệu năng nâng cao.
  • Amazon S3: Dịch vụ lưu trữ đám mây có thể dùng làm data lake để lưu dữ liệu thô, sau đó chuyển đổi bằng câu lệnh SQL hoặc công cụ khác.

Công cụ ELT mã nguồn mở

Nhiều tổ chức cũng tận dụng các công cụ mã nguồn mở cho quy trình ELT nhờ hiệu quả chi phí.

Các công cụ này có thể hỗ trợ những giai đoạn khác nhau của quy trình ELT:

  • Apache Airflow: Dùng để tự động hóa luồng công việc và lập lịch các quy trình ETL/ELT.
  • dbt: Phần mềm mã nguồn mở để chuyển đổi dữ liệu trong data warehouse bằng SQL.
  • Airbyte: Nền tảng tích hợp dữ liệu mã nguồn mở hỗ trợ cả quy trình ELT và ETL.
  • Singer: Công cụ mã nguồn mở được dùng trong cả ELT và ETL theo cách tiếp cận mô-đun.
  • Apache NiFi: Công cụ tích hợp dữ liệu mã nguồn mở hỗ trợ định tuyến dữ liệu, chuyển đổi và logic trung gian hệ thống.

Công cụ mã nguồn mở rất phù hợp với quy trình ELT vì mang lại tính linh hoạt, cộng đồng nhà phát triển hỗ trợ và nhiều lựa chọn tích hợp.

Script tự xây dựng

Các nhà phát triển cũng có thể sử dụng các script viết bằng ngôn ngữ lập trình để tăng khả năng tùy biến. Cách này thường sử dụng các package và thư viện để xử lý và chuyển đổi dữ liệu.

Một số ngôn ngữ lập trình phổ biến dùng cho các script này gồm:

  • Python: Sử dụng các thư viện như Pandas, NumPy và SQLAlchemy có thể hỗ trợ trích xuất, nạp và chuyển đổi dữ liệu.
  • Apache Spark: Dùng để xử lý và phân tích dữ liệu lớn, thường tận dụng các ngôn ngữ như Python (PySpark), Java và Scala.
  • R: Khung tidyverse cùng các thư viện R khác như dplyr và data.table có thể được dùng để trích xuất và chuyển đổi dữ liệu.
  • SQL: Câu lệnh SQL có thể dùng cho các tác vụ chuyển đổi, và SQL Server Integration Services (SSIS) là công cụ ETL phổ biến cũng hỗ trợ quy trình ELT.
  • Scala: Thường dùng với Apache Spark cho xử lý dữ liệu lớn và tác vụ ELT.
  • Java: Thường dùng với các framework dữ liệu lớn như Apache Hadoop và Apache Spark cho quy trình ELT.

Tổng kết

Tóm lại, ELT là xu hướng mới nổi trong xử lý dữ liệu, mang lại nhiều lợi thế so với phương pháp ETL truyền thống. ELT cho phép chuyển đổi dữ liệu nhanh hơn, hiệu quả hơn, đồng thời mang lại tính linh hoạt và khả năng mở rộng cao hơn. 

Nếu bạn đang cân nhắc tìm hiểu thêm về ELT hoặc các khái niệm kỹ thuật dữ liệu khác, bạn có thể sẽ thích Chứng chỉ Data Engineer hoặc Lộ trình nghề nghiệp Data Engineer với Python của chúng tôi.

FAQs

ELT xử lý các vấn đề về chất lượng và tính nhất quán dữ liệu như thế nào?

ELT xử lý chất lượng và tính nhất quán dữ liệu bằng cách tận dụng khả năng của data warehouse hoặc data lake nơi dữ liệu được lưu trữ. Các bước kiểm tra chất lượng, làm sạch và xác thực dữ liệu được áp dụng trong giai đoạn chuyển đổi để đảm bảo tính nhất quán và độ chính xác. Các công cụ như dbt (data build tool) có thể được dùng để tạo pipeline chuyển đổi bao gồm các kiểm tra chất lượng này, giúp duy trì tiêu chuẩn cao về tính toàn vẹn dữ liệu.

ELT có thể được dùng cho streaming dữ liệu thời gian thực không và nếu có thì như thế nào?

Có, ELT có thể được sử dụng cho streaming dữ liệu theo thời gian thực. Điều này đạt được bằng cách tích hợp các công cụ tiếp nhận dữ liệu thời gian thực như Apache Kafka hoặc AWS Kinesis với pipeline ELT. Các công cụ này có thể liên tục stream dữ liệu vào data lake hoặc warehouse, nơi các chuyển đổi có thể được áp dụng gần thời gian thực bằng các công cụ như Apache Spark hoặc chuyển đổi dựa trên SQL, cho phép phân tích và ra quyết định kịp thời.

ELT tích hợp với quy trình học máy như thế nào?

ELT tích hợp với quy trình học máy bằng cách cung cấp pipeline dữ liệu vững chắc để đưa dữ liệu sạch, đã chuyển đổi vào các mô hình học máy. Sau khi dữ liệu được nạp vào data warehouse, dữ liệu có thể được chuyển đổi và chuẩn bị cho học máy bằng các công cụ như Apache Spark MLlib hoặc các thư viện Python như scikit-learn. Sự tích hợp này cho phép tiền xử lý dữ liệu, huấn luyện và đánh giá mô hình diễn ra liền mạch trong cùng môi trường, nâng cao hiệu quả và khả năng mở rộng.

Những lưu ý bảo mật nào khi triển khai ELT trong môi trường đám mây?

Khi triển khai ELT trong môi trường đám mây, các cân nhắc về bảo mật bao gồm mã hóa dữ liệu, kiểm soát truy cập và che giấu dữ liệu. Dữ liệu cần được mã hóa khi truyền và khi lưu trữ để bảo vệ thông tin nhạy cảm. Cơ chế kiểm soát truy cập, như RBAC (kiểm soát truy cập dựa trên vai trò), nên được áp dụng để đảm bảo chỉ người được ủy quyền mới có thể truy cập và thao tác dữ liệu. Các kỹ thuật che giấu dữ liệu có thể áp dụng để bảo vệ dữ liệu nhận dạng cá nhân (PII) trong quá trình nạp và chuyển đổi.

Các kỹ sư dữ liệu xử lý thách thức tiến hóa lược đồ trong quy trình ELT như thế nào?

Các chuyên gia dữ liệu xử lý tiến hóa lược đồ (schema evolution) trong quy trình ELT bằng các công cụ và thực hành quản lý lược đồ để thích ứng với thay đổi theo thời gian. Điều này bao gồm sử dụng các công cụ như Apache Avro hoặc JSON Schema cho tuần tự hóa dữ liệu linh hoạt và tiến hóa lược đồ. Ngoài ra, có thể áp dụng chiến lược phiên bản hóa và script di chuyển lược đồ tự động để quản lý thay đổi mà không làm gián đoạn pipeline dữ liệu. Các công cụ danh mục dữ liệu và quản lý siêu dữ liệu cũng đóng vai trò quan trọng trong việc theo dõi và ghi nhận thay đổi lược đồ để đảm bảo tính nhất quán và độ tin cậy của dữ liệu.


Austin Chia's photo
Author
Austin Chia
LinkedIn

Tôi là Austin, một blogger và cây bút công nghệ với nhiều năm kinh nghiệm làm nhà khoa học dữ liệu và nhà phân tích dữ liệu trong lĩnh vực chăm sóc sức khỏe. Khởi đầu hành trình công nghệ với nền tảng sinh học, tôi hiện hỗ trợ những người khác thực hiện chuyển đổi tương tự thông qua blog công nghệ của mình. Niềm đam mê công nghệ đã đưa tôi đến với việc cộng tác viết cho hàng chục công ty SaaS, truyền cảm hứng cho người khác và chia sẻ trải nghiệm của bản thân.

Chủ đề
Kỹ thuật Dữ liệu

Tìm hiểu thêm về kỹ thuật dữ liệu và xử lý dữ liệu với các khóa học này!

{count, plural, one {Khóa học} other {Khóa học}}

ETL và ELT với Python

{hours} giờ
40.1K
Học cách xây dựng các pipeline dữ liệu hiệu quả, hiệu suất cao và đáng tin cậy bằng cách sử dụng các nguyên tắc Extract, Transform, và Load.
Xem chi tiếtRight Arrow
Bắt Đầu Khóa Học

{count, plural, one {Lộ trình} other {Lộ trình}}

Kỹ sư dữ liệu trong Python

{hours} giờ
Nắm vững các kỹ năng được săn đón để thu thập, làm sạch, quản lý dữ liệu một cách hiệu quả, cũng như lên lịch và giám sát các quy trình xử lý dữ liệu, giúp bạn nổi bật trong lĩnh vực kỹ thuật dữ liệu.
Xem thêmRight Arrow
Liên quan

{count, plural, one {blog} other {blog}}

Claude Opus 4.6: Tính năng, Điểm chuẩn, Bài kiểm tra thực hành và hơn thế nữa

Mô hình mới nhất của Anthropic dẫn đầu ở mã hóa tác tử và lập luận phức tạp. Thêm vào đó, nó có cửa sổ ngữ cảnh 1M.
Matt Crabtree's photo

Matt Crabtree

10 phút

Xem ThêmXem Thêm