Merkezî Limit Teoremi: İstatistikte Temel Bir Kavramın Açıklaması
Merkezî limit teoremi, yeterince büyük bir örneklem büyüklüğüyle, popülasyon dağılımından bağımsız olarak örneklem ortalamasının örnekleme dağılımının normal dağılacağını belirtir. Formülünü, temel koşullarını ve istatistik ile makine öğrenimindeki uygulamalarını öğrenin.
Neredeyse herhangi bir tür veri dağılımından çok sayıda rastgele örnek alırsak, şaşırtıcı bir şey olur. Bu örneklerin ortalamaları, o tanıdık çan eğrisi şeklindeki normal dağılıma benzemeye başlar. Kısaca, buna merkezî limit teoremi (CLT) denir.
Olasılık ve istatistikte büyük bir öneme sahiptir; çünkü yalnızca küçük örneklere bakarken bile tüm popülasyonlar hakkında doğru tahminler yapabileceğimiz ve sonuçlar çıkarabileceğimiz anlamına gelir.
CLT’yi özellikle kullanışlı kılan şey, orijinal veriler normal dağılmasa bile çalışmasıdır. Bunu ayrıntılı olarak inceleyelim ve nasıl hesaplayabileceğimizi görelim.
Merkezî Limit Teoremi Nedir?
Merkezî limit teoremi (CLT), herhangi bir popülasyondan çok sayıda rastgele örnek alıp bu örneklerin ortalamalarına baktığımızda, bu ortalamaların, orijinal popülasyon hiç de normal görünmese bile, normal bir çan eğrisi şeklini almaya başlayacağını söyleyen bir istatistik fikridir.
Bu, büyük sayılar yasasıyla bağlantılıdır; bize daha fazla veri topladıkça örneklem ortalamamızın tüm popülasyonun gerçek ortalamasına giderek daha fazla yaklaştığını söyler. CLT ise bunu bir adım ileri götürür — örneklem ortalamasının daha doğru hale geldiğini ve bu ortalamaların deseninin öngörülebilir olduğunu söyler. Bu konuyu daha fazla keşfetmek isterseniz, İstatistiğe Giriş kursumuzda CLT ile büyük sayılar yasası arasındaki ilişki ve farkları öğreten alıştırmalar bulunuyor.
Bunu uygulamada görmenin harika bir yolu zar atmaktır. Zarı bir kez atarsak 1 ile 6 arasında rastgele bir sayı elde ederiz. Ancak yeterince çok atıştan sonra ortalama 3,5 civarında (adil bir zarın gerçek ortalaması) sabitlenir. Bunu tekrar tekrar yaptığınızda, bu ortalamaların dağılımı normal eğriye benzemeye başlar.
Merkezî Limit Teoremi Formülü
Merkezî limit teoremi için temel formül şöyledir:
Bu formülde:
X, normal dağılıma uyan örneklem ortalamasının örnekleme dağılımıdır.
N, normal dağılımdır.
𝜇, popülasyon ortalamasıdır.
σ, popülasyon standart sapmasıdır.
n, örneklem büyüklüğüdür.
Örneklem büyüklüğü arttıkça, örnekleme dağılımının standart sapması küçülür. Daha fazla veri topladıkça, örneklem ortalamalarımız gerçek popülasyon ortalaması etrafında daha sıkı kümelenir.
Merkezî Limit Teoremi Koşulları
Merkezî limit teoreminin beklediğimiz gibi işlemesi için dikkate alınması gereken birkaç koşul vardır:
Yeterince büyük örneklem büyüklüğü: Örneklem büyüklüğünün yeterince büyük olması gerekir. Genellikle 30 veya üzeri iyi kabul edilir. Ancak örneklem aldığımız popülasyon çarpıksa ya da çok sayıda aykırı değer içeriyorsa, o düzgün çan eğrisini görmek için daha büyük bir örnekleme ihtiyaç duyabiliriz.
Bağımsız ve özdeş dağılımlı (i.i.d.) örneklemler: Aldığımız örneklemlerin bağımsız ve özdeş dağılımlı (i.i.d.) olması gerekir. Bu, her bir örneklemin rastgele seçildiği ve aynı popülasyondan geldiği anlamına gelir. Bu doğru değilse, sonuçlar güvenilir olmayabilir.
Sınırlı popülasyon varyansı: Örneklem aldığımız popülasyonun varyansı sonlu olmalıdır. Cauchy dağılımı gibi sonsuz varyanslı bir dağılımdan gelen verilerde CLT geçerli olmaz.
Merkezî Limit Teoremi Örnekleri
Diyelim ki yerel bir kahve dükkânında günde kaç fincan kahve satıldığını bilmek istiyoruz. Yıllar boyunca, her gün satılan fincan sayısı burada yer verdiğim grafiğe benzer bir dağılım gösterebilir. Çoğu gün 80 ile 120 fincan arasında satarlar. Ancak tatiller veya özel etkinlikler gibi yoğun günlerde 150 hatta 180 fincana çıkar. Bu durumda veriler biraz çarpıktır (dengesiz).
Düzensiz grafik. Görsel: Yazar.
Küçük bir örnek aldığımızı varsayalım. Yıldan rastgele 5 gün seçip o günlerde kaç fincan satıldığını inceliyoruz.
Bu bize popülasyon ortalamasına ilişkin bir tahmin verir, ancak örneklem küçük olduğundan tam olmayabilir. Bu işlemi 10 kez tekrarlayıp her seferinde rastgele 5 gün seçtiğimizi, ortalamayı hesaplayıp sonuçları yazdığımızı düşünelim. 10 örneklem ortalaması şöyle olur:
Bu değerleri bir histogramda çizdiğimizde kabaca bir çan şekli görürüz, ancak hâlâ dengesiz görünebilir. Ayrıca bu ortalamaların yayılımı, popülasyondaki yayılımdan daha küçüktür.
10 fincanın grafiği. Görsel: Yazar.
Şimdi daha büyük bir örnek alalım. Bu kez rastgele 50 gün seçip satılan fincan sayısının ortalamasını hesaplayalım:
Bu tahmin, 100 olan popülasyon ortalamasına çok daha yakındır ve örneklem büyüklüğümüz daha büyük olduğu için daha hassas bir tahmindir.
Bu işlemi pek çok kez tekrarlayıp her defasında rastgele 50 gün seçer, ortalamayı hesaplar ve bu ortalamaları bir histogramda çizersek, orijinal veriler çarpık olsa bile belirgin, düzgün bir çan eğrisi görürüz. İşte merkezî limit teoreminin gücü budur.
Düzenli grafik. Görsel: Yazar.
Bu yayılımı şu formülle hatta hesaplayabiliriz:
Burada:
µ (popülasyon ortalaması) = 100
σ (popülasyon standart sapması) = 15
n (örneklem büyüklüğü) = 50
Dolayısıyla örneklem ortalamalarımızın standart sapması şöyledir:
Bu, örneklem ortalamalarının 100 fincana çok yakın olacağını ve yalnızca küçük bir değişkenlik (yaklaşık 2,12 fincan) göstereceğini söyler.
Merkezî Limit Teoremi Neden Önemlidir?
Artık gerçek dünyadaki verilerin tuhaf ve öngörülemez olabileceğini biliyoruz. Ancak merkezî limit teoremi, olup biteni güvenilir bir şekilde anlamamıza ve buna dayanarak daha iyi kararlar almamıza yardımcı olur. Gelin, önemini biraz daha ayrıntılı anlayalım.
İstatistiksel çıkarım
İstatistikte merkezî limit teoremi, t testleri, ANOVA ve regresyon gibi parametrik testlerin bu şekilde çalışmasının nedenidir. Bu testler, örneklem verilerinin sabit özelliklere sahip bir popülasyondan geldiği varsayımına dayanır.
Merkezî limit teoremi olmadan bu testlere güvenemezdik. Ayrıca bu teorem sayesinde, verinin dağılımı hakkında varsayım yapmayan parametrik olmayan (non-parametrik) testlere kıyasla parametrik testler çoğu zaman daha güçlüdür.
Endüstriyel uygulamalar
Ayrıca pek çok gerçek dünya durumunda karşımıza çıkar. Finansta, analistler geçmiş performansa bakarak ortalama hisse getirilerini tahmin etmek için kullanır. Anket ve oylamalarda, yanıtların bir örneklemini toplayarak tüm popülasyon hakkında tahminler yapılmasını sağlar. Makine öğrenimi ve büyük veride ise modellerin örneklemler üzerinde eğitildiği yerlerde kullanılır. Örneğin bir film uygulaması, öneri sistemini oluşturmak için kullanıcı etkinliklerinin bir örneklemini kullanabilir.
Merkezî Limit Teoremi Hesaplayıcısı
Standart sapma, değerlerin ortalamadan ne kadar saptığını gösteren bir sayıdır. Örneklem ortalamalarına (farklı örneklemlerden gelen ortalamalara) baktığımızda, bu ortalamaların ne kadar değiştiğini bilmek isteriz. Bunun için şu formülü kullanabiliriz:
Bu, popülasyon standart sapmasını örneklem büyüklüğünün kareköküne böldüğümüzde örnekleme dağılımının standart sapmasını elde ettiğimizi söyler. Örneklem büyüklüğü arttıkça bu değer küçülür.
Hızlı bir örneğe bakalım:
Örneklem Büyüklüğü (n)
Örneklem Ortalaması (μₓ̄)
Std. Sapma (σₓ̄)
5
17
1.788854
10
17
1.264911
25
17
0.800000
50
17
0.565685
100
17
0.400000
Gördüğünüz gibi ortalama aynı kalırken standart sapma küçülmeye devam eder. Bu da örneklem ne kadar büyükse, o kadar doğru ve tutarlı olduğunu gösterir.
Veri Biliminde Merkezî Limit Teoremi
Veri biliminde genellikle tüm popülasyonlarla değil, örneklemlerle uğraşırız. CLT, bu örneklem sonuçlarının nasıl davrandığını anlamamıza yardımcı olur ve yeterince fazla örnek alırsak, bu örneklem ortalamalarının, orijinal veriler bambaşka olsa bile, normal dağılıma benzemeye başlayacağını söyler.
Bunun gerçek dünyada da önemli faydaları vardır. Makine öğreniminde sıkça yeniden örnekleme (bootstrapping) gibi teknikleri değerleri tahmin etmek için kullanırız. CLT sayesinde bu tahminlerin doğru olduğundan emin olabiliriz.
Ayrıca A/B testlerinin de kilit oyuncusudur. Bir şirket bir web sayfasının veya özelliğin iki sürümünü denediğinde, CLT sonuçların anlamlı mı yoksa rastgele gürültü mü olduğunu anlamamıza yardımcı olur.
Hatta pekiştirmeli öğrenmede, sistemler deneme-yanılma ile öğrense de CLT dalgalanmaları yatıştırır. Daha fazla veri geldikçe ortalamalar daha kararlı hale gelir; bu da sistemin daha hızlı ve daha iyi öğrenmesine yardımcı olur.
Son olarak CLT’yi hipotez testi ve zaman serisi analizinde de görürsünüz. Veri bilimcilerin fikirleri sınamasına ve eğilimleri daha güvenle izlemesine yardımcı olur.
Son Düşünceler
İstatistiğe yeniyseniz merkezî limit teoremi teknik gelebilir; ancak verilerle akıllıca işler yapabilmemizin büyük nedenlerinden biridir. Rastgeleliği, anlayıp güvenebileceğimiz bir şeye dönüştürür. Aslında istatistiksel modellemenin yapı taşlarından biridir ve verilerle çalışan herkesin mutlaka bilmesi gerekir.
Daha fazla keşfetmek isterseniz, büyük sayılar yasası ve olasılık dağılımları hakkında okuyun — hepsi birbiriyle bağlantılıdır.
Karmaşık konuları basitleştirmeyi seven bir içerik stratejistiyim. Splunk, Hackernoon ve Tiiny Host gibi şirketlerin hedef kitleleri için ilgi çekici ve bilgilendirici içerikler üretmelerine yardımcı oldum.
Merkezî Limit Teoremi Hakkında SSS
Merkezî limit teoremi sayısal olmayan verilerle kullanılabilir mi?⌄
Evet, ancak doğrudan değil. CLT, özellikle ortalamalar ve toplamlar gibi sayısal verilere uygulanır. Bununla birlikte, kategorik veya sıralı veriler için veriyi sayısal forma dönüştürerek ya da diğer istatistiksel teknikleri kullanarak benzer ilkelerden yararlanabilirsiniz.
Örnekleme dağılımı ile popülasyon dağılımı arasındaki fark nedir?⌄
Popülasyon dağılımı tüm veri kümesini tanımlarken, örnekleme dağılımı tekrarlı örneklemelerden elde edilen örneklem istatistiklerinin (örneğin ortalamaların) dağılımını ifade eder.
Aykırı değerler merkezî limit teoremini nasıl etkiler?⌄
Aykırı değerler çarpıklığı ve varyansı artırır; bu da örnekleme dağılımının normalliğe yaklaşması için daha büyük bir örneklem büyüklüğüne ihtiyaç duyabileceğimiz anlamına gelir.
Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Python ve istatistik kullanarak sınırlı verilerden sonuçlar çıkarmayı öğrenin. Bu ders, rastgele örneklemden tabakalı ve küme örneklemeye kadar her şeyi kapsar.





Neredeyse herhangi bir tür veri dağılımından çok sayıda rastgele örnek alırsak, şaşırtıcı bir şey olur. Bu örneklerin ortalamaları, o tanıdık çan eğrisi şeklindeki normal dağılıma benzemeye başlar. Kısaca, buna merkezî limit teoremi (CLT) denir.
Olasılık ve istatistikte büyük bir öneme sahiptir; çünkü yalnızca küçük örneklere bakarken bile tüm popülasyonlar hakkında doğru tahminler yapabileceğimiz ve sonuçlar çıkarabileceğimiz anlamına gelir.
CLT’yi özellikle kullanışlı kılan şey, orijinal veriler normal dağılmasa bile çalışmasıdır. Bunu ayrıntılı olarak inceleyelim ve nasıl hesaplayabileceğimizi görelim.
Merkezî Limit Teoremi Nedir?
Merkezî limit teoremi (CLT), herhangi bir popülasyondan çok sayıda rastgele örnek alıp bu örneklerin ortalamalarına baktığımızda, bu ortalamaların, orijinal popülasyon hiç de normal görünmese bile, normal bir çan eğrisi şeklini almaya başlayacağını söyleyen bir istatistik fikridir.
Bu, büyük sayılar yasasıyla bağlantılıdır; bize daha fazla veri topladıkça örneklem ortalamamızın tüm popülasyonun gerçek ortalamasına giderek daha fazla yaklaştığını söyler. CLT ise bunu bir adım ileri götürür — örneklem ortalamasının daha doğru hale geldiğini ve bu ortalamaların deseninin öngörülebilir olduğunu söyler. Bu konuyu daha fazla keşfetmek isterseniz, İstatistiğe Giriş kursumuzda CLT ile büyük sayılar yasası arasındaki ilişki ve farkları öğreten alıştırmalar bulunuyor.
Bunu uygulamada görmenin harika bir yolu zar atmaktır. Zarı bir kez atarsak 1 ile 6 arasında rastgele bir sayı elde ederiz. Ancak yeterince çok atıştan sonra ortalama 3,5 civarında (adil bir zarın gerçek ortalaması) sabitlenir. Bunu tekrar tekrar yaptığınızda, bu ortalamaların dağılımı normal eğriye benzemeye başlar.
Merkezî Limit Teoremi Formülü
Merkezî limit teoremi için temel formül şöyledir:
Bu formülde:
X, normal dağılıma uyan örneklem ortalamasının örnekleme dağılımıdır.N, normal dağılımdır.𝜇, popülasyon ortalamasıdır.σ, popülasyon standart sapmasıdır.n, örneklem büyüklüğüdür.Örneklem büyüklüğü arttıkça, örnekleme dağılımının standart sapması küçülür. Daha fazla veri topladıkça, örneklem ortalamalarımız gerçek popülasyon ortalaması etrafında daha sıkı kümelenir.
Merkezî Limit Teoremi Koşulları
Merkezî limit teoreminin beklediğimiz gibi işlemesi için dikkate alınması gereken birkaç koşul vardır:
Merkezî Limit Teoremi Örnekleri
Diyelim ki yerel bir kahve dükkânında günde kaç fincan kahve satıldığını bilmek istiyoruz. Yıllar boyunca, her gün satılan fincan sayısı burada yer verdiğim grafiğe benzer bir dağılım gösterebilir. Çoğu gün 80 ile 120 fincan arasında satarlar. Ancak tatiller veya özel etkinlikler gibi yoğun günlerde 150 hatta 180 fincana çıkar. Bu durumda veriler biraz çarpıktır (dengesiz).
Düzensiz grafik. Görsel: Yazar.
Küçük bir örnek aldığımızı varsayalım. Yıldan rastgele 5 gün seçip o günlerde kaç fincan satıldığını inceliyoruz.
Bu örnekten elde ettiğimiz ortalama:
5 fincanın grafiği. Görsel: Yazar.
Bu bize popülasyon ortalamasına ilişkin bir tahmin verir, ancak örneklem küçük olduğundan tam olmayabilir. Bu işlemi 10 kez tekrarlayıp her seferinde rastgele 5 gün seçtiğimizi, ortalamayı hesaplayıp sonuçları yazdığımızı düşünelim. 10 örneklem ortalaması şöyle olur:
Bu değerleri bir histogramda çizdiğimizde kabaca bir çan şekli görürüz, ancak hâlâ dengesiz görünebilir. Ayrıca bu ortalamaların yayılımı, popülasyondaki yayılımdan daha küçüktür.
10 fincanın grafiği. Görsel: Yazar.
Şimdi daha büyük bir örnek alalım. Bu kez rastgele 50 gün seçip satılan fincan sayısının ortalamasını hesaplayalım:
Bu örneklemin ortalamasını hesapladığımızda şunu elde ederiz:
Bu tahmin, 100 olan popülasyon ortalamasına çok daha yakındır ve örneklem büyüklüğümüz daha büyük olduğu için daha hassas bir tahmindir.
Bu işlemi pek çok kez tekrarlayıp her defasında rastgele 50 gün seçer, ortalamayı hesaplar ve bu ortalamaları bir histogramda çizersek, orijinal veriler çarpık olsa bile belirgin, düzgün bir çan eğrisi görürüz. İşte merkezî limit teoreminin gücü budur.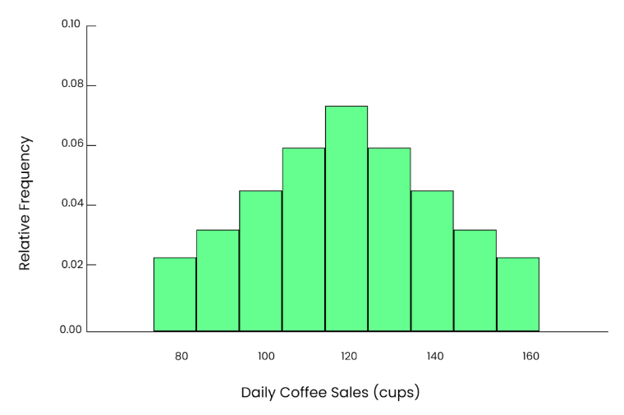
Düzenli grafik. Görsel: Yazar.
Bu yayılımı şu formülle hatta hesaplayabiliriz:
µ(popülasyon ortalaması) = 100σ(popülasyon standart sapması) = 15n(örneklem büyüklüğü) = 50Dolayısıyla örneklem ortalamalarımızın standart sapması şöyledir:
Bu, örneklem ortalamalarının 100 fincana çok yakın olacağını ve yalnızca küçük bir değişkenlik (yaklaşık 2,12 fincan) göstereceğini söyler.
Merkezî Limit Teoremi Neden Önemlidir?
Artık gerçek dünyadaki verilerin tuhaf ve öngörülemez olabileceğini biliyoruz. Ancak merkezî limit teoremi, olup biteni güvenilir bir şekilde anlamamıza ve buna dayanarak daha iyi kararlar almamıza yardımcı olur. Gelin, önemini biraz daha ayrıntılı anlayalım.
İstatistiksel çıkarım
İstatistikte merkezî limit teoremi, t testleri, ANOVA ve regresyon gibi parametrik testlerin bu şekilde çalışmasının nedenidir. Bu testler, örneklem verilerinin sabit özelliklere sahip bir popülasyondan geldiği varsayımına dayanır.
Merkezî limit teoremi olmadan bu testlere güvenemezdik. Ayrıca bu teorem sayesinde, verinin dağılımı hakkında varsayım yapmayan parametrik olmayan (non-parametrik) testlere kıyasla parametrik testler çoğu zaman daha güçlüdür.
Endüstriyel uygulamalar
Ayrıca pek çok gerçek dünya durumunda karşımıza çıkar. Finansta, analistler geçmiş performansa bakarak ortalama hisse getirilerini tahmin etmek için kullanır. Anket ve oylamalarda, yanıtların bir örneklemini toplayarak tüm popülasyon hakkında tahminler yapılmasını sağlar. Makine öğrenimi ve büyük veride ise modellerin örneklemler üzerinde eğitildiği yerlerde kullanılır. Örneğin bir film uygulaması, öneri sistemini oluşturmak için kullanıcı etkinliklerinin bir örneklemini kullanabilir.
Merkezî Limit Teoremi Hesaplayıcısı
Standart sapma, değerlerin ortalamadan ne kadar saptığını gösteren bir sayıdır. Örneklem ortalamalarına (farklı örneklemlerden gelen ortalamalara) baktığımızda, bu ortalamaların ne kadar değiştiğini bilmek isteriz. Bunun için şu formülü kullanabiliriz:
Bu, popülasyon standart sapmasını örneklem büyüklüğünün kareköküne böldüğümüzde örnekleme dağılımının standart sapmasını elde ettiğimizi söyler. Örneklem büyüklüğü arttıkça bu değer küçülür.
Hızlı bir örneğe bakalım:
Gördüğünüz gibi ortalama aynı kalırken standart sapma küçülmeye devam eder. Bu da örneklem ne kadar büyükse, o kadar doğru ve tutarlı olduğunu gösterir.
Veri Biliminde Merkezî Limit Teoremi
Veri biliminde genellikle tüm popülasyonlarla değil, örneklemlerle uğraşırız. CLT, bu örneklem sonuçlarının nasıl davrandığını anlamamıza yardımcı olur ve yeterince fazla örnek alırsak, bu örneklem ortalamalarının, orijinal veriler bambaşka olsa bile, normal dağılıma benzemeye başlayacağını söyler.
Bunun gerçek dünyada da önemli faydaları vardır. Makine öğreniminde sıkça yeniden örnekleme (bootstrapping) gibi teknikleri değerleri tahmin etmek için kullanırız. CLT sayesinde bu tahminlerin doğru olduğundan emin olabiliriz.
Ayrıca A/B testlerinin de kilit oyuncusudur. Bir şirket bir web sayfasının veya özelliğin iki sürümünü denediğinde, CLT sonuçların anlamlı mı yoksa rastgele gürültü mü olduğunu anlamamıza yardımcı olur.
Hatta pekiştirmeli öğrenmede, sistemler deneme-yanılma ile öğrense de CLT dalgalanmaları yatıştırır. Daha fazla veri geldikçe ortalamalar daha kararlı hale gelir; bu da sistemin daha hızlı ve daha iyi öğrenmesine yardımcı olur.
Son olarak CLT’yi hipotez testi ve zaman serisi analizinde de görürsünüz. Veri bilimcilerin fikirleri sınamasına ve eğilimleri daha güvenle izlemesine yardımcı olur.
Son Düşünceler
İstatistiğe yeniyseniz merkezî limit teoremi teknik gelebilir; ancak verilerle akıllıca işler yapabilmemizin büyük nedenlerinden biridir. Rastgeleliği, anlayıp güvenebileceğimiz bir şeye dönüştürür. Aslında istatistiksel modellemenin yapı taşlarından biridir ve verilerle çalışan herkesin mutlaka bilmesi gerekir.
Daha fazla keşfetmek isterseniz, büyük sayılar yasası ve olasılık dağılımları hakkında okuyun — hepsi birbiriyle bağlantılıdır.