सेंट्रल लिमिट थ्योरम: सांख्यिकी की एक प्रमुख अवधारणा की व्याख्या
सेंट्रल लिमिट थ्योरम कहता है कि पर्याप्त बड़े नमूना आकार के साथ, माध्य का सैम्पलिंग वितरण सामान्य होगा, चाहे आबादी का वितरण कुछ भी हो। इसका सूत्र, प्रमुख शर्तें, और सांख्यिकी व मशीन लर्निंग में उपयोग जानें।
यदि हम लगभग किसी भी प्रकार के डेटा वितरण से बहुत सारे रैंडम नमूने लें, तो कुछ चौंकाने वाली बात होती है। उन नमूनों का औसत सामान्य वितरण – यानी परिचित घंटी-आकार का वक्र – जैसा दिखने लगता है। यही सेंट्रल लिमिट थ्योरम (CLT) का सार है।
यह प्रायिकता और सांख्यिकी में इसलिए अहम है क्योंकि इसका मतलब है कि हम केवल छोटे नमूनों को देखकर भी पूरी आबादी के बारे में सटीक भविष्यवाणियाँ कर सकते हैं और निष्कर्ष निकाल सकते हैं।
CLT की खास उपयोगिता यह है कि यह तब भी काम करता है जब मूल डेटा सामान्य रूप से वितरित न हो। आइए इसे विस्तार से समझते हैं और देखते हैं कि इसकी गणना कैसे की जाती है।
सेंट्रल लिमिट थ्योरम क्या है?
सेंट्रल लिमिट थ्योरम, या CLT, सांख्यिकी में एक विचार है जो कहता है कि यदि हम किसी भी आबादी से बहुत सारे रैंडम नमूने लें और उन नमूनों के औसत देखें, तो वे औसत सामान्य, घंटी-आकार का वक्र बनाने लगते हैं, भले ही मूल आबादी बिल्कुल भी सामान्य न दिखती हो।
यह लॉ ऑफ लार्ज नंबर्स से जुड़ा है, जो बताता है कि जैसे-जैसे हम अधिक डेटा इकट्ठा करते हैं, हमारा नमूना औसत पूरी आबादी के सच्चे औसत के और करीब आता जाता है। CLT इसे एक कदम आगे ले जाता है — यह बताता है कि नमूना औसत अधिक सटीक होता जाता है और उन औसतों का पैटर्न अनुमानित हो जाता है। यदि आप इसे और खोजना चाहें, तो हमारे Intro to Statistics कोर्स में CLT और लॉ ऑफ लार्ज नंबर्स के बीच संबंध और अंतर पर अभ्यास उपलब्ध हैं।
इसे क्रियान्वयन में देखने का बढ़िया तरीका पासा फेंकना है। यदि हम इसे एक बार फेंकते हैं, तो 1 से 6 के बीच कोई भी संख्या आती है। लेकिन पर्याप्त बार फेंकने पर औसत 3.5 के आस-पास ठहर जाता है (एक निष्पक्ष पासे का सच्चा औसत)। इसे बार-बार करने पर, उन औसतों का वितरण सामान्य वक्र जैसा दिखने लगता है।
सेंट्रल लिमिट थ्योरम का सूत्र
यह रहा सेंट्रल लिमिट थ्योरम का बुनियादी सूत्र:
इस सूत्र में:
X नमूना माध्य का सैम्पलिंग वितरण है, जो सामान्य वितरण का अनुसरण करता है।
N सामान्य वितरण को दर्शाता है।
𝜇 आबादी का औसत (माध्य) है।
σ आबादी का मानक विचलन है।
n नमूना आकार है।
जैसे-जैसे नमूना आकार बड़ा होता है, सैम्पलिंग वितरण का मानक विचलन छोटा होता जाता है। जितना अधिक डेटा हम इकट्ठा करते हैं, हमारे नमूना माध्य उतने ही सच्चे आबादी माध्य के आस-पास सघन होते जाते हैं।
सेंट्रल लिमिट थ्योरम की शर्तें
CLT के अपेक्षित तरीके से काम करने के लिए कुछ शर्तों पर ध्यान देना होता है:
पर्याप्त बड़ा नमूना आकार: नमूना आकार पर्याप्त बड़ा होना चाहिए। आमतौर पर 30 या उससे अधिक को अच्छा माना जाता है। लेकिन यदि जिस आबादी से हम नमूना ले रहे हैं, वह तिरछी (skewed) हो या उसमें कई बाह्य मान (outliers) हों, तो उस सुंदर घंटी-आकार के वक्र को उभरते देखने के लिए हमें बड़ा नमूना चाहिए हो सकता है।
स्वतंत्र और समान रूप से वितरित (i.i.d.) नमूने: जो नमूने हम लेते हैं, वे independent and identically distributed (i.i.d.) होने चाहिए। यानी हर नमूना रैंडम रूप से चुना गया हो और उसी आबादी से आया हो। यदि यह सच न हो, तो परिणाम भरोसेमंद नहीं रहेंगे।
सीमित आबादी वैरिएंस: जिस आबादी से हम नमूना ले रहे हैं, उसका वैरिएंस सीमित होना चाहिए। यदि डेटा किसी ऐसे वितरण से आता है जिसका वैरिएंस अनंत है, जैसे Cauchy वितरण, तो CLT वहाँ लागू नहीं होगा।
सेंट्रल लिमिट थ्योरम के उदाहरण
मान लीजिए हम जानना चाहते हैं कि किसी स्थानीय कॉफी शॉप पर रोज़ कितने कप कॉफी बिकते हैं। वर्षों में, प्रतिदिन बेचे गए कपों की संख्या उस वितरण जैसी हो सकती है जिसे मैं यहाँ शामिल कर रहा/रही हूँ। अधिकांश दिनों में वे 80 से 120 कप के बीच बेचते हैं। लेकिन छुट्टियों या विशेष आयोजनों जैसे व्यस्त दिनों में, वे 150 या 180 कप तक बेचते हैं। इस मामले में डेटा थोड़ा तिरछा (uneven) है।
असमान ग्राफ। चित्र: लेखक।
मान लीजिए हम एक छोटा नमूना लेते हैं। हम साल के 5 दिनों को रैंडम रूप से चुनते हैं और देखते हैं कि उन दिनों में कितने कप बिके।
यह हमें आबादी माध्य का एक अनुमान देता है, लेकिन चूंकि नमूना छोटा है, यह सटीक न भी हो। यदि हम इस प्रक्रिया को 10 बार दोहराएँ, हर बार 5 दिन रैंडम रूप से चुनें, माध्य निकालें और परिणाम लिखें, तो 10 नमूना माध्य इस प्रकार होंगे:
यदि हम इन मानों को एक हिस्टोग्राम में प्लॉट करें, तो एक मोटा-सा घंटी आकार दिखेगा, पर यह अब भी असमान लग सकता है। और इन माध्यों का फैलाव, आबादी के फैलाव से छोटा होगा।
10 कप का ग्राफ। चित्र: लेखक।
अब एक बड़ा नमूना लेते हैं। इस बार, हम 50 दिनों को रैंडम रूप से चुनते हैं और बेचे गए कपों की औसत संख्या निकालते हैं:
यह अनुमान 100 के आबादी माध्य के बहुत करीब है, और क्योंकि हमारा नमूना आकार बड़ा है, यह अधिक सटीक अनुमान है।
यदि हम इस प्रक्रिया को कई बार दोहराएँ, हर बार 50 दिन रैंडम रूप से चुनें, माध्य निकालें और उन माध्यों को हिस्टोग्राम में प्लॉट करें, तो भले ही मूल डेटा तिरछा था, हमें एक स्पष्ट, समतल घंटी-आकार का वक्र दिखाई देगा। यही है सेंट्रल लिमिट थ्योरम की ताकत।
समतल (even) ग्राफ। चित्र: लेखक।
हम इस फैलाव की गणना इस सूत्र से भी कर सकते हैं:
यहाँ:
µ (आबादी माध्य) = 100
σ (आबादी मानक विचलन) = 15
n (नमूना आकार) = 50
तो, हमारे नमूना माध्यों का मानक विचलन होगा:
यह बताता है कि नमूना माध्य 100 कप के बहुत करीब होंगे और उनमें बहुत कम भिन्नता होगी (लगभग 2.12 कप)।
सेंट्रल लिमिट थ्योरम क्यों महत्वपूर्ण है
हमें पता है कि वास्तविक दुनिया में डेटा अजीब और अप्रत्याशित हो सकता है। लेकिन सेंट्रल लिमिट थ्योरम हमें इसे समझने और उसके आधार पर बेहतर निर्णय लेने का विश्वसनीय तरीका देता है। आइए इसकी अहमियत को और विस्तार से समझें।
सांख्यिकीय अनुमिति (Statistical inference)
सांख्यिकी में, सेंट्रल लिमिट थ्योरम वह वजह है कि t-टेस्ट, ANOVA, और रिग्रेशन जैसे पैरामीट्रिक परीक्षण अपेक्षित तरीके से काम करते हैं। ये परीक्षण इस विचार पर आधारित हैं कि नमूना डेटा किसी तय विशेषताओं वाली आबादी से आता है।
सेंट्रल लिमिट थ्योरम के बिना, हम उन परीक्षणों पर भरोसा नहीं कर पाते। और इसी कारण, पैरामीट्रिक परीक्षण अक्सर नॉन-पैरामीट्रिक परीक्षणों से अधिक शक्तिशाली होते हैं, जो डेटा के वितरण के बारे में मान्यताएँ नहीं बनाते।
उद्योग में उपयोग
यह कई वास्तविक-world परिस्थितियों में भी दिखता है। वित्त में, विश्लेषक पिछले प्रदर्शन के आधार पर औसत स्टॉक रिटर्न का अनुमान लगाने के लिए इसका उपयोग करते हैं। पोलिंग और सर्वेक्षणों में, यह प्रतिक्रियाओं के एक नमूने को इकट्ठा करके पूरी आबादी के बारे में भविष्यवाणी करता है। मशीन लर्निंग और बिग डेटा में, जहाँ मॉडल नमूनों पर प्रशिक्षित होते हैं, हम इसका उपयोग करते हैं। उदाहरण के लिए, कोई मूवी ऐप उपयोगकर्ताओं की गतिविधि के एक नमूने से अपना सिफारिश तंत्र बनाता है।
सेंट्रल लिमिट थ्योरम कैलकुलेटर
मानक विचलन वह संख्या है जो बताती है कि मान औसत से कितने फैले हुए हैं। जब हम नमूना माध्यों (विभिन्न नमूनों के औसत) को देखते हैं, तो हम जानना चाहते हैं कि वे औसत कितने बदलते हैं। इसके लिए हम यह सूत्र उपयोग कर सकते हैं:
यह बताता है कि जब हम आबादी के मानक विचलन को नमूना आकार के वर्गमूल से भाग देते हैं, तो हमें सैम्पलिंग वितरण का मानक विचलन मिलता है। जैसे-जैसे नमूना आकार बड़ा होता है, कुल मान छोटा होता जाता है।
आइए एक छोटा उदाहरण देखें:
नमूना आकार (n)
नमूना माध्य (μₓ̄)
मानक विचलन (σₓ̄)
5
17
1.788854
10
17
1.264911
25
17
0.800000
50
17
0.565685
100
17
0.400000
आप देख सकते हैं कि माध्य वही रहता है, लेकिन मानक विचलन लगातार घटता जाता है। यह दिखाता है कि नमूना जितना बड़ा, उतना ही अधिक सटीक और सुसंगत।
डेटा साइंस में सेंट्रल लिमिट थ्योरम
डेटा साइंस में, हम आमतौर पर पूरी आबादी नहीं बल्कि नमूनों से काम करते हैं। CLT हमें बताता है कि वे नमूना परिणाम कैसे व्यवहार करते हैं और यह सुनिश्चित करता है कि यदि हम पर्याप्त नमूने लें, तो उनके औसत सामान्य वितरण जैसे दिखने लगेंगे, भले ही मूल डेटा कुछ भी हो।
इसके कुछ बड़े वास्तविक लाभ भी हैं। मशीन लर्निंग में, हम अक्सर बूटस्ट्रैपिंग जैसी तकनीकों से मानों का अनुमान लगाते हैं। CLT की बदौलत, हमें भरोसा होता है कि वे अनुमान सटीक हैं।
यह A/B परीक्षण में भी प्रमुख भूमिका निभाता है। जब कोई कंपनी वेबपेज या फ़ीचर के दो संस्करण आज़माती है, तो CLT हमें यह समझने में मदद करता है कि परिणाम अर्थपूर्ण हैं या बस यादृच्छिक शोर।
यहाँ तक कि रिइन्फोर्समेंट लर्निंग में भी, जहाँ प्रणालियाँ ट्रायल-एंड-एरर से सीखती हैं, CLT अराजकता को समतल करता है। जैसे-जैसे अधिक डेटा आता है, औसत स्थिर होते जाते हैं, जो सिस्टम को तेज़ और बेहतर सीखने में मदद करता है।
अंत में, आप CLT को अनुमान परीक्षण और टाइम सीरीज़ विश्लेषण में भी देखेंगे। यह डेटा वैज्ञानिकों को अधिक आत्मविश्वास के साथ विचार जाँचने और रुझान ट्रैक करने में मदद करता है।
अंतिम विचार
यदि आप सांख्यिकी में नए हैं तो सेंट्रल लिमिट थ्योरम तकनीकी लग सकता है, लेकिन यही वह बड़ी वजह है कि हम डेटा के साथ समझदारी भरे काम कर पाते हैं। यह यादृच्छिकता को ऐसी चीज़ में बदल देता है जिसे हम समझ और भरोसा कर सकें। वास्तव में, यह सांख्यिकीय मॉडलिंग के आधार स्तंभों में से एक है और डेटा के साथ काम करने वाले किसी भी व्यक्ति के लिए अनिवार्य ज्ञान है।
यदि आप और खोजना चाहें, तो लॉ ऑफ लार्ज नंबर्स और प्रायिकता वितरण पर पढ़ें — ये सब एक-दूसरे से जुड़े हैं।
मैं एक कंटेंट स्ट्रैटेजिस्ट हूँ जिसे जटिल विषयों को सरल बनाना पसंद है। मैंने Splunk, Hackernoon, और Tiiny Host जैसी कंपनियों को अपने दर्शकों के लिए आकर्षक और सूचनात्मक सामग्री बनाने में मदद की है।
सेंट्रल लिमिट थ्योरम से जुड़े सामान्य प्रश्न
क्या सेंट्रल लिमिट थ्योरम का उपयोग गैर-संख्यात्मक डेटा के साथ किया जा सकता है?⌄
हाँ, लेकिन सीधे नहीं। CLT संख्यात्मक डेटा पर लागू होता है, खासकर माध्य और योग पर। हालाँकि, श्रेणीबद्ध या क्रमबद्ध डेटा के लिए, आप डेटा को संख्यात्मक रूप में बदलकर या अन्य सांख्यिकीय तकनीकों का उपयोग करके समान सिद्धांत लागू कर सकते हैं।
सैम्पलिंग वितरण और आबादी वितरण में क्या अंतर है?⌄
आबादी वितरण पूरे डेटासेट का वर्णन करता है, जबकि सैम्पलिंग वितरण दोहराए गए नमूनों से प्राप्त नमूना सांख्यिकियों (जैसे माध्य) के वितरण को दर्शाता है।
बाह्य मान (outliers) सेंट्रल लिमिट थ्योरम को कैसे प्रभावित करते हैं?⌄
बाह्य मान (outliers) तिरछापन और वैरिएंस बढ़ाते हैं, यानी सैम्पलिंग वितरण को सामान्य के करीब लाने के लिए हमें बड़ा नमूना आकार चाहिए हो सकता है।
Python और सांख्यिकी की मदद से सीमित डेटा से निष्कर्ष निकालना सीखें। इस पाठ्यक्रम में रैंडम सैंपलिंग से लेकर स्तरीकृत और क्लस्टर सैंपलिंग तक सब शामिल है।


यदि हम लगभग किसी भी प्रकार के डेटा वितरण से बहुत सारे रैंडम नमूने लें, तो कुछ चौंकाने वाली बात होती है। उन नमूनों का औसत सामान्य वितरण – यानी परिचित घंटी-आकार का वक्र – जैसा दिखने लगता है। यही सेंट्रल लिमिट थ्योरम (CLT) का सार है।
यह प्रायिकता और सांख्यिकी में इसलिए अहम है क्योंकि इसका मतलब है कि हम केवल छोटे नमूनों को देखकर भी पूरी आबादी के बारे में सटीक भविष्यवाणियाँ कर सकते हैं और निष्कर्ष निकाल सकते हैं।
CLT की खास उपयोगिता यह है कि यह तब भी काम करता है जब मूल डेटा सामान्य रूप से वितरित न हो। आइए इसे विस्तार से समझते हैं और देखते हैं कि इसकी गणना कैसे की जाती है।
सेंट्रल लिमिट थ्योरम क्या है?
सेंट्रल लिमिट थ्योरम, या CLT, सांख्यिकी में एक विचार है जो कहता है कि यदि हम किसी भी आबादी से बहुत सारे रैंडम नमूने लें और उन नमूनों के औसत देखें, तो वे औसत सामान्य, घंटी-आकार का वक्र बनाने लगते हैं, भले ही मूल आबादी बिल्कुल भी सामान्य न दिखती हो।
यह लॉ ऑफ लार्ज नंबर्स से जुड़ा है, जो बताता है कि जैसे-जैसे हम अधिक डेटा इकट्ठा करते हैं, हमारा नमूना औसत पूरी आबादी के सच्चे औसत के और करीब आता जाता है। CLT इसे एक कदम आगे ले जाता है — यह बताता है कि नमूना औसत अधिक सटीक होता जाता है और उन औसतों का पैटर्न अनुमानित हो जाता है। यदि आप इसे और खोजना चाहें, तो हमारे Intro to Statistics कोर्स में CLT और लॉ ऑफ लार्ज नंबर्स के बीच संबंध और अंतर पर अभ्यास उपलब्ध हैं।
इसे क्रियान्वयन में देखने का बढ़िया तरीका पासा फेंकना है। यदि हम इसे एक बार फेंकते हैं, तो 1 से 6 के बीच कोई भी संख्या आती है। लेकिन पर्याप्त बार फेंकने पर औसत 3.5 के आस-पास ठहर जाता है (एक निष्पक्ष पासे का सच्चा औसत)। इसे बार-बार करने पर, उन औसतों का वितरण सामान्य वक्र जैसा दिखने लगता है।
सेंट्रल लिमिट थ्योरम का सूत्र
यह रहा सेंट्रल लिमिट थ्योरम का बुनियादी सूत्र:
इस सूत्र में:
Xनमूना माध्य का सैम्पलिंग वितरण है, जो सामान्य वितरण का अनुसरण करता है।Nसामान्य वितरण को दर्शाता है।𝜇आबादी का औसत (माध्य) है।σआबादी का मानक विचलन है।nनमूना आकार है।जैसे-जैसे नमूना आकार बड़ा होता है, सैम्पलिंग वितरण का मानक विचलन छोटा होता जाता है। जितना अधिक डेटा हम इकट्ठा करते हैं, हमारे नमूना माध्य उतने ही सच्चे आबादी माध्य के आस-पास सघन होते जाते हैं।
सेंट्रल लिमिट थ्योरम की शर्तें
CLT के अपेक्षित तरीके से काम करने के लिए कुछ शर्तों पर ध्यान देना होता है:
सेंट्रल लिमिट थ्योरम के उदाहरण
मान लीजिए हम जानना चाहते हैं कि किसी स्थानीय कॉफी शॉप पर रोज़ कितने कप कॉफी बिकते हैं। वर्षों में, प्रतिदिन बेचे गए कपों की संख्या उस वितरण जैसी हो सकती है जिसे मैं यहाँ शामिल कर रहा/रही हूँ। अधिकांश दिनों में वे 80 से 120 कप के बीच बेचते हैं। लेकिन छुट्टियों या विशेष आयोजनों जैसे व्यस्त दिनों में, वे 150 या 180 कप तक बेचते हैं। इस मामले में डेटा थोड़ा तिरछा (uneven) है।
असमान ग्राफ। चित्र: लेखक।
मान लीजिए हम एक छोटा नमूना लेते हैं। हम साल के 5 दिनों को रैंडम रूप से चुनते हैं और देखते हैं कि उन दिनों में कितने कप बिके।
इस नमूने से हमें जो माध्य मिलता है, वह है:
5 कप का ग्राफ। चित्र: लेखक।
यह हमें आबादी माध्य का एक अनुमान देता है, लेकिन चूंकि नमूना छोटा है, यह सटीक न भी हो। यदि हम इस प्रक्रिया को 10 बार दोहराएँ, हर बार 5 दिन रैंडम रूप से चुनें, माध्य निकालें और परिणाम लिखें, तो 10 नमूना माध्य इस प्रकार होंगे:
यदि हम इन मानों को एक हिस्टोग्राम में प्लॉट करें, तो एक मोटा-सा घंटी आकार दिखेगा, पर यह अब भी असमान लग सकता है। और इन माध्यों का फैलाव, आबादी के फैलाव से छोटा होगा।
10 कप का ग्राफ। चित्र: लेखक।
अब एक बड़ा नमूना लेते हैं। इस बार, हम 50 दिनों को रैंडम रूप से चुनते हैं और बेचे गए कपों की औसत संख्या निकालते हैं:
जब हम इस नमूने का माध्य निकालते हैं, तो हमें मिलता है:
यह अनुमान 100 के आबादी माध्य के बहुत करीब है, और क्योंकि हमारा नमूना आकार बड़ा है, यह अधिक सटीक अनुमान है।
यदि हम इस प्रक्रिया को कई बार दोहराएँ, हर बार 50 दिन रैंडम रूप से चुनें, माध्य निकालें और उन माध्यों को हिस्टोग्राम में प्लॉट करें, तो भले ही मूल डेटा तिरछा था, हमें एक स्पष्ट, समतल घंटी-आकार का वक्र दिखाई देगा। यही है सेंट्रल लिमिट थ्योरम की ताकत।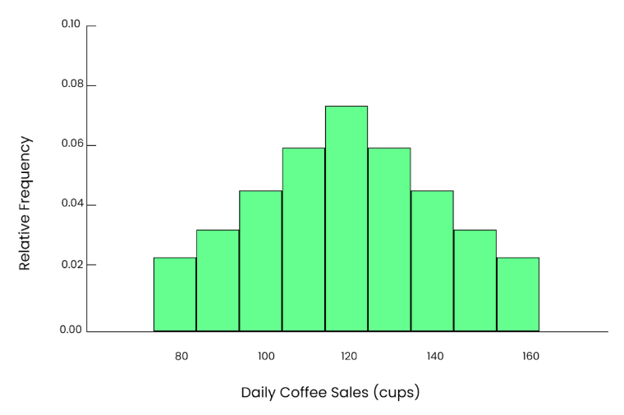
समतल (even) ग्राफ। चित्र: लेखक।
हम इस फैलाव की गणना इस सूत्र से भी कर सकते हैं:
µ(आबादी माध्य) = 100σ(आबादी मानक विचलन) = 15n(नमूना आकार) = 50तो, हमारे नमूना माध्यों का मानक विचलन होगा:
यह बताता है कि नमूना माध्य 100 कप के बहुत करीब होंगे और उनमें बहुत कम भिन्नता होगी (लगभग 2.12 कप)।
सेंट्रल लिमिट थ्योरम क्यों महत्वपूर्ण है
हमें पता है कि वास्तविक दुनिया में डेटा अजीब और अप्रत्याशित हो सकता है। लेकिन सेंट्रल लिमिट थ्योरम हमें इसे समझने और उसके आधार पर बेहतर निर्णय लेने का विश्वसनीय तरीका देता है। आइए इसकी अहमियत को और विस्तार से समझें।
सांख्यिकीय अनुमिति (Statistical inference)
सांख्यिकी में, सेंट्रल लिमिट थ्योरम वह वजह है कि t-टेस्ट, ANOVA, और रिग्रेशन जैसे पैरामीट्रिक परीक्षण अपेक्षित तरीके से काम करते हैं। ये परीक्षण इस विचार पर आधारित हैं कि नमूना डेटा किसी तय विशेषताओं वाली आबादी से आता है।
सेंट्रल लिमिट थ्योरम के बिना, हम उन परीक्षणों पर भरोसा नहीं कर पाते। और इसी कारण, पैरामीट्रिक परीक्षण अक्सर नॉन-पैरामीट्रिक परीक्षणों से अधिक शक्तिशाली होते हैं, जो डेटा के वितरण के बारे में मान्यताएँ नहीं बनाते।
उद्योग में उपयोग
यह कई वास्तविक-world परिस्थितियों में भी दिखता है। वित्त में, विश्लेषक पिछले प्रदर्शन के आधार पर औसत स्टॉक रिटर्न का अनुमान लगाने के लिए इसका उपयोग करते हैं। पोलिंग और सर्वेक्षणों में, यह प्रतिक्रियाओं के एक नमूने को इकट्ठा करके पूरी आबादी के बारे में भविष्यवाणी करता है। मशीन लर्निंग और बिग डेटा में, जहाँ मॉडल नमूनों पर प्रशिक्षित होते हैं, हम इसका उपयोग करते हैं। उदाहरण के लिए, कोई मूवी ऐप उपयोगकर्ताओं की गतिविधि के एक नमूने से अपना सिफारिश तंत्र बनाता है।
सेंट्रल लिमिट थ्योरम कैलकुलेटर
मानक विचलन वह संख्या है जो बताती है कि मान औसत से कितने फैले हुए हैं। जब हम नमूना माध्यों (विभिन्न नमूनों के औसत) को देखते हैं, तो हम जानना चाहते हैं कि वे औसत कितने बदलते हैं। इसके लिए हम यह सूत्र उपयोग कर सकते हैं:
यह बताता है कि जब हम आबादी के मानक विचलन को नमूना आकार के वर्गमूल से भाग देते हैं, तो हमें सैम्पलिंग वितरण का मानक विचलन मिलता है। जैसे-जैसे नमूना आकार बड़ा होता है, कुल मान छोटा होता जाता है।
आइए एक छोटा उदाहरण देखें:
आप देख सकते हैं कि माध्य वही रहता है, लेकिन मानक विचलन लगातार घटता जाता है। यह दिखाता है कि नमूना जितना बड़ा, उतना ही अधिक सटीक और सुसंगत।
डेटा साइंस में सेंट्रल लिमिट थ्योरम
डेटा साइंस में, हम आमतौर पर पूरी आबादी नहीं बल्कि नमूनों से काम करते हैं। CLT हमें बताता है कि वे नमूना परिणाम कैसे व्यवहार करते हैं और यह सुनिश्चित करता है कि यदि हम पर्याप्त नमूने लें, तो उनके औसत सामान्य वितरण जैसे दिखने लगेंगे, भले ही मूल डेटा कुछ भी हो।
इसके कुछ बड़े वास्तविक लाभ भी हैं। मशीन लर्निंग में, हम अक्सर बूटस्ट्रैपिंग जैसी तकनीकों से मानों का अनुमान लगाते हैं। CLT की बदौलत, हमें भरोसा होता है कि वे अनुमान सटीक हैं।
यह A/B परीक्षण में भी प्रमुख भूमिका निभाता है। जब कोई कंपनी वेबपेज या फ़ीचर के दो संस्करण आज़माती है, तो CLT हमें यह समझने में मदद करता है कि परिणाम अर्थपूर्ण हैं या बस यादृच्छिक शोर।
यहाँ तक कि रिइन्फोर्समेंट लर्निंग में भी, जहाँ प्रणालियाँ ट्रायल-एंड-एरर से सीखती हैं, CLT अराजकता को समतल करता है। जैसे-जैसे अधिक डेटा आता है, औसत स्थिर होते जाते हैं, जो सिस्टम को तेज़ और बेहतर सीखने में मदद करता है।
अंत में, आप CLT को अनुमान परीक्षण और टाइम सीरीज़ विश्लेषण में भी देखेंगे। यह डेटा वैज्ञानिकों को अधिक आत्मविश्वास के साथ विचार जाँचने और रुझान ट्रैक करने में मदद करता है।
अंतिम विचार
यदि आप सांख्यिकी में नए हैं तो सेंट्रल लिमिट थ्योरम तकनीकी लग सकता है, लेकिन यही वह बड़ी वजह है कि हम डेटा के साथ समझदारी भरे काम कर पाते हैं। यह यादृच्छिकता को ऐसी चीज़ में बदल देता है जिसे हम समझ और भरोसा कर सकें। वास्तव में, यह सांख्यिकीय मॉडलिंग के आधार स्तंभों में से एक है और डेटा के साथ काम करने वाले किसी भी व्यक्ति के लिए अनिवार्य ज्ञान है।
यदि आप और खोजना चाहें, तो लॉ ऑफ लार्ज नंबर्स और प्रायिकता वितरण पर पढ़ें — ये सब एक-दूसरे से जुड़े हैं।