课程
Python 中的聚类分析
4 小时
65.9K
在数据科学与机器学习中,发现隐藏模式并将相似数据点分组是一项重要能力。聚类算法在这一过程中发挥关键作用。
聚类是一种基础的机器学习与数据科学技术,旨在将相似的数据点聚在一起。它是一种无监督学习方法,这意味着它不需要带标签的数据来寻找模式。
聚类的主要目标是:
尽管聚类算法众多(您或许听说过K-means或层次聚类),DBSCAN 具有独特优势。作为一种基于密度的方法,DBSCAN 有以下长处:
本文将介绍 DBSCAN 算法是什么、DBSCAN 的工作原理、如何用 Python 实现它,以及在数据科学项目中何时使用它。
DBSCAN(Density-Based Spatial Clustering of Applications with Noise,即带噪声的基于密度的应用空间聚类)是一种强大的聚类算法,它将数据空间中彼此紧密相邻的点归为一簇。与部分其他聚类算法不同,DBSCAN 无需您事先指定簇的数量,因此在探索性数据分析中尤为有用。
该算法通过将簇定义为由低密度区域分隔的高密度区域来工作。这种方法使 DBSCAN 能够发现任意形状的簇,并将离群点识别为噪声。
DBSCAN 围绕三个关键概念展开:
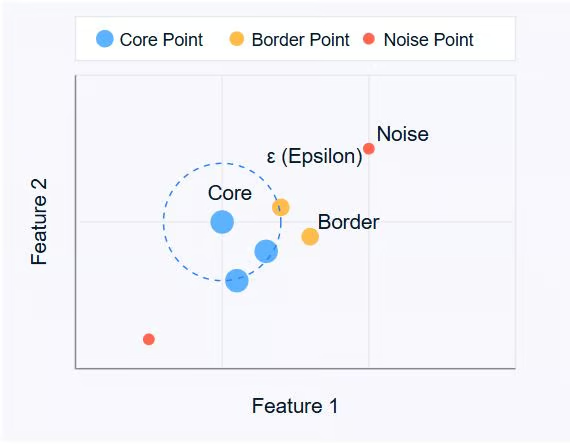
图片作者自制
上图展示了这些概念。核心点(蓝色)构成簇的核心,边界点(橙色)位于簇的边缘,噪声点(红色)是孤立的。
DBSCAN 使用两个主要参数:
通过调整这些参数,您可以控制算法如何定义簇,使其适应不同类型的数据集与聚类需求。
下一节我们将探讨 DBSCAN 算法的工作方式,了解其逐步识别数据中簇的过程。
DBSCAN 通过检查数据集中每个点的邻域来运行。该算法按照逐步流程,基于数据点的密度来识别簇。下面分解 DBSCAN 的工作机制:
该流程使 DBSCAN 能够形成任意形状的簇,并有效识别离群点。无需事先指定簇的数量是其一大优势。
需要注意的是,ε 与 MinPts 的选择会显著影响聚类结果。下一节我们将讨论如何有效选择这些参数,并介绍用于参数选择的 k-距离图方法。
要全面理解 DBSCAN 如何形成簇,需掌握两个关键概念:密度可达性与密度连通性。
若满足以下条件,点 q 从点 p 出发是密度可达的:
1. p 是核心点(在 ε 距离内至少有 MinPts 个点)
2. 存在一条点链 p = p1, ..., pn = q,使得每个 pi+1 都直接对 pi 密度可达。
通俗来说,您可以从 p 通过步步经过核心点、每一步长度不超过 ε 的方式到达 q。
若存在一点 o,使得 p 与 q 都从 o 出发是密度可达的,则 p 与 q 密度连通。
密度连通性是 DBSCAN 形成簇的基础。簇内所有点彼此密度连通,且若某点与簇中任一点密度连通,它也属于该簇。
DBSCAN 的有效性高度依赖于两个主要参数:ε(epsilon)与 MinPts。以下是选择这些参数的方法:
ε 决定两点被视为邻居的最大距离。选择合适的 ε 可参考:
1. 领域知识:如果您知道对当前问题而言有意义的距离尺度,可据此作为起点。
2. K-距离图:这是一种更系统的方法:
MinPts 决定形成高密度区域所需的最少点数。参考指南如下:
1. 一般规则:一个良好的起点是设定 MinPts = 2 * num_features,其中 num_features 为数据集的维度数。
2. 噪声考量:如果数据含噪或您希望检测更小的簇,可适当降低 MinPts。
3. 数据集规模:对于更大的数据集,为避免产生过多小簇,可能需要提高 MinPts。
请记住,参数选择会显著影响结果。通常建议尝试不同取值并评估聚类效果,以找到最契合您数据与问题的设置。
在 DBSCAN 中,距离度量的选择会显著影响聚类结果。默认情况下,DBSCAN 使用欧氏距离,这对紧凑、近似球形的簇效果较好,但并非适用于所有数据类型。
您可以指定其他度量,例如:
将距离度量与数据结构相匹配,可确保基于密度的聚类反映真实相似性。
在 scikit-learn 中,可通过 metric 参数显式设置(例如,metric='cosine')。某些自定义度量可能需要预先计算的距离矩阵。
由于 DBSCAN 依赖绝对距离值,未缩放的特征可能导致结果失真。取值范围更大的变量会主导距离计算,即便它们并不更重要。这可能使算法无法正确识别数据中的稠密区域。
为避免此问题,必须对特征进行缩放,使其贡献相当。常见方法包括:
标准化:使用 StandardScaler 将特征中心化为 0、方差为 1。
最小-最大缩放:将特征重缩放到固定范围(通常为 [0, 1]),可用 MinMaxScaler。
选择与数据分布匹配的缩放方法。若缺乏适当的预处理,即使 epsilon 和 MinPts 调得再好,DBSCAN 也可能无法检测到有意义的簇。
本节将使用 Python 与 scikit-learn 库实现 DBSCAN。我们将使用Make Moons 数据集来演示流程。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.cluster import DBSCAN
from sklearn.neighbors import NearestNeighbors
这些导入提供了数据处理、可视化、数据集创建以及实现 DBSCAN 算法所需的工具。
X, _ = make_moons(n_samples=200, noise=0.05, random_state=42)这段代码使用 scikit-learn 的 make_moons 函数创建一个合成数据集。数据集简述如下:
函数 make_moons 生成一个二元分类数据集,形状类似两个交错的半月。在本例中:
n_samples=200)noise=0.05)以使数据更贴近现实random_state=42 以保证可复现性该数据集非常适合用来演示 DBSCAN,因为:
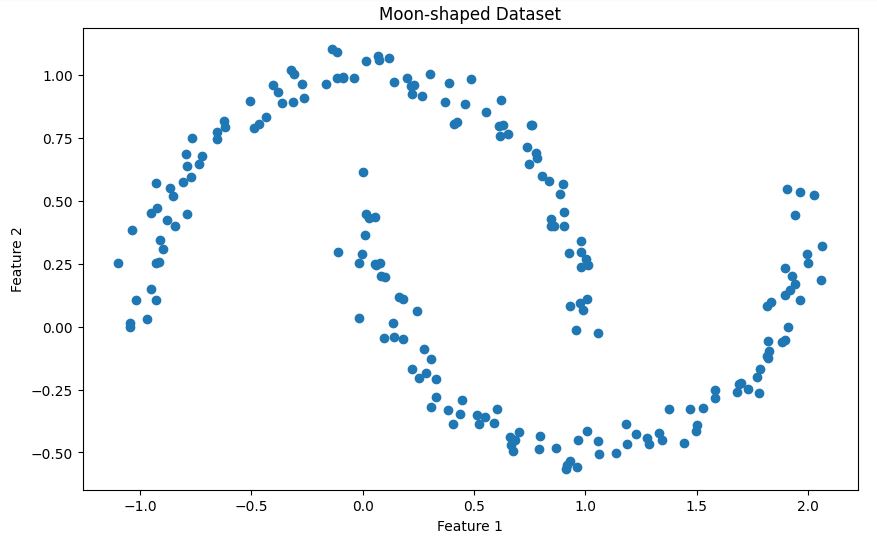
让我们将该数据集可视化,以便更好理解其结构:
# Visualize the dataset
plt.figure(figsize=(10, 6))
plt.scatter(X[:, 0], X[:, 1])
plt.title('Moon-shaped Dataset')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()
这将展示数据集中两个交错的半月形,如下图所示
我们使用 k-距离图方法来帮助选择合适的 epsilon 值:
plot_k_distance_graph,为每个点计算第 k 个最近邻的距离。# Function to plot k-distance graph
def plot_k_distance_graph(X, k):
neigh = NearestNeighbors(n_neighbors=k)
neigh.fit(X)
distances, _ = neigh.kneighbors(X)
distances = np.sort(distances[:, k-1])
plt.figure(figsize=(10, 6))
plt.plot(distances)
plt.xlabel('Points')
plt.ylabel(f'{k}-th nearest neighbor distance')
plt.title('K-distance Graph')
plt.show()
# Plot k-distance graph
plot_k_distance_graph(X, k=5)输出
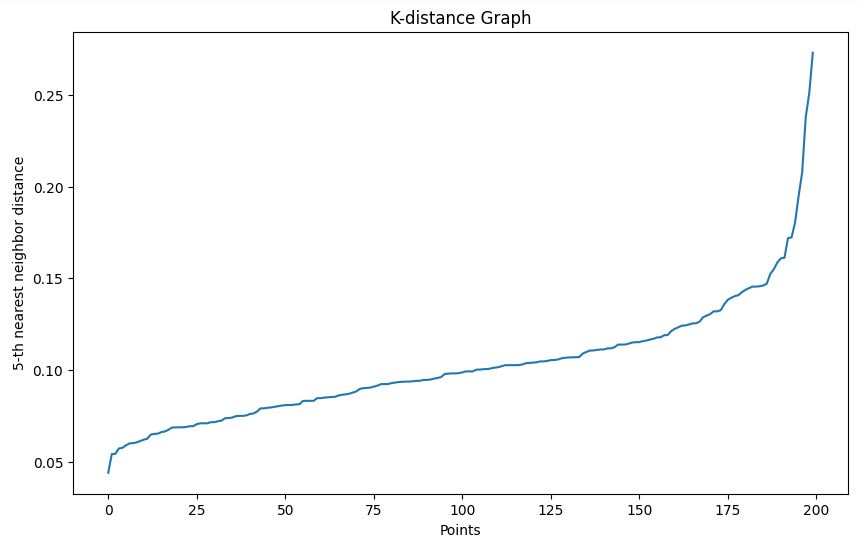
在本例中,基于 k-距离图,我们选择 epsilon 为 0.15。
我们使用 scikit-learn 的 DBSCAN 实现:
epsilon=0.15。min_samples=5(2 * 特征数,因为数据为二维)。# Perform DBSCAN clustering
epsilon = 0.15 # Chosen based on k-distance graph
min_samples = 5 # 2 * num_features (2D data)
dbscan = DBSCAN(eps=epsilon, min_samples=min_samples)
clusters = dbscan.fit_predict(X)我们绘制数据点的散点图,并根据其所属簇进行着色。被判为噪声的点通常会以不同颜色(常为黑色)显示。
# Visualize the results
plt.figure(figsize=(10, 6))
scatter = plt.scatter(X[:, 0], X[:, 1], c=clusters, cmap='viridis')
plt.colorbar(scatter)
plt.title('DBSCAN Clustering Results')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.show()
输出
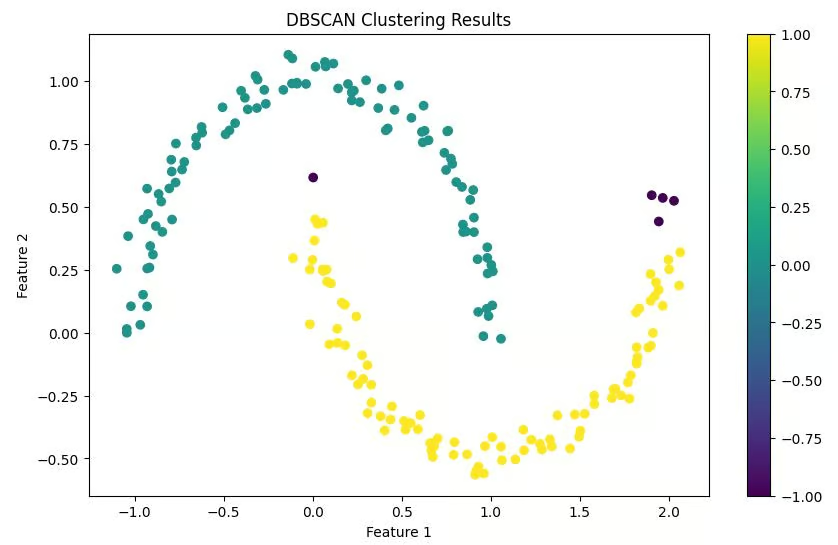
最后,我们打印找到的簇数量以及被分类为噪声的点数,以快速概览聚类结果。
# Print number of clusters and noise points
n_clusters = len(set(clusters)) - (1 if -1 in clusters else 0)
n_noise = list(clusters).count(-1)
print(f'Number of clusters: {n_clusters}')
print(f'Number of noise points: {n_noise}')
输出
Number of clusters: 2
Number of noise points: 5
该实现提供了从数据生成到结果解读的完整流程。需要注意的是,在真实场景中,您应以加载与预处理实际数据集替代示例数据生成。
请记住,成功进行 DBSCAN 聚类的关键往往在于恰当的参数选择。请大胆尝试不同的 epsilon 与 min_samples 取值,以找到最适合您数据集的设置。
尽管 DBSCAN 与 K-Means 均是常用聚类算法,但它们各具特点,适用于不同数据与用例。让我们对比二者以了解各自的使用时机。
|
特性 |
DBSCAN |
K-Means |
|
簇形状 |
可识别任意形状的簇 |
假设簇为凸且近似球形 |
|
簇数量 |
无需预先指定簇的数量 |
需事先指定簇数(K) |
|
离群点处理 |
将离群点识别为噪声点 |
将每个点都归入某簇,可能扭曲簇形状 |
|
对参数的敏感性 |
对 epsilon 与 MinPts 参数敏感 |
对初始质心位置与 K 的选择敏感 |
|
簇密度 |
可发现不同密度的簇 |
倾向于找到空间范围与密度相近的簇 |
|
可扩展性 |
对大型数据集效率较低,尤其是高维数据 |
通常更高效,更适合扩展至大型数据集 |
|
非球状簇的处理 |
对非球状簇表现良好 |
难以处理非球状形状 |
|
结果一致性 |
跨次运行结果一致 |
由于质心随机初始化,结果可能变化 |
为展示这些差异,我们将两种算法应用于半月形数据集
from sklearn.cluster import KMeans

# DBSCAN clustering
dbscan = DBSCAN(eps=0.15, min_samples=5)
dbscan_labels = dbscan.fit_predict(X)

# K-Means clustering
kmeans = KMeans(n_clusters=2, random_state=42)
kmeans_labels = kmeans.fit_predict(X)

# Visualize the results
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15, 6))

ax1.scatter(X[:, 0], X[:, 1], c=dbscan_labels, cmap='viridis')
ax1.set_title('DBSCAN Clustering')

ax2.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='viridis')
ax2.set_title('K-Means Clustering')

plt.show()
这段代码将 DBSCAN 与 K-Means 同时应用于数据集,并将结果并排可视化。
输出
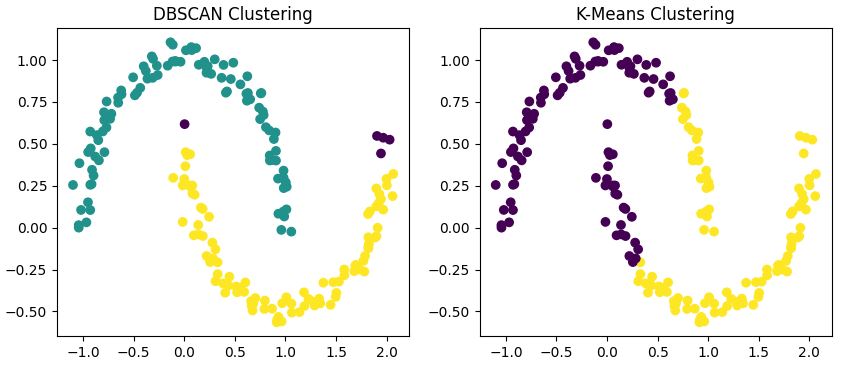
您会注意到
在了解 DBSCAN 的工作方式并与 K-Means 对比后,让我们看看在何种情况下应选择 DBSCAN。DBSCAN 的独特属性使其特别适合某些数据与问题领域。
延续之前的对比,DBSCAN 在处理非球状簇形状时尤为出色。如果您的数据形成任意模式,如我们前面探索的半月形,DBSCAN 往往优于传统算法(如 K-Means)。
例如,在地理分析中,自然地貌如河网或城市蔓延常呈现不规则形状,DBSCAN 能有效识别。
DBSCAN 的一大优势是能自动确定簇的数量。这在您可能不了解数据潜在结构的探索性数据分析中特别有用。
以市场细分为例:您可能事先并不知道存在多少个不同的客户群。DBSCAN 可在无需猜测簇数的情况下帮助发现这些细分。
DBSCAN 处理噪声点的方法使其对离群点具有鲁棒性。这在许多真实世界数据集中至关重要,因为测量误差或异常很常见。
例如,在用于网络安全的异常检测系统中,DBSCAN 能有效将正常的网络流量模式与潜在安全威胁区分开来。
不同于假设簇密度相近的 K-Means,DBSCAN 能识别密度不同的簇。这在数据中某些群体比其他群体更为紧凑的情境中尤为有用。
例如在天文学的星系分布分析中,宇宙不同区域的天体密度各异。
在了解何时使用 DBSCAN 之后,让我们看看它的弱点,并简要了解两种替代方案:OPTICS 与 HDBSCAN。
尽管 DBSCAN 功能强大,但也需注意其局限:
为改进聚类效果,可在使用 DBSCAN 前应用降维技术,如PCA、t-SNE 或 UMAP。这有助于降低噪声并提升算法识别稠密区域的能力。
OPTICS(Ordering Points To Identify the Clustering Structure,按点排序以识别聚类结构)是 DBSCAN 的一种有用替代方案。它通过动态调整邻域阈值,解决了 DBSCAN 使用固定 epsilon 值的局限。
OPTICS 在具有不同密度簇的数据集上更为有效,且能揭示 DBSCAN 可能遗漏的簇结构。Scikit-learn 在其聚类模块中包含了 OPTICS,接口与 DBSCAN 一致。
HDBSCAN(层次 DBSCAN)是对 DBSCAN 的现代扩展,它基于不同密度水平构建簇的层次结构。它免去了手动选择 epsilon 的需要,且通常以更少的参数调优获得更佳结果。
HDBSCAN 在真实世界、含噪或不平衡的数据集上往往优于基础版 DBSCAN。它以独立的 Python 包提供(hdbscan),并能很好地与 scikit-learn 集成。
DBSCAN 在诸多领域都有应用。
在地理信息系统(GIS)中,DBSCAN 可识别高活动或重点区域。例如,题为《Uncovering urban human mobility from large scale taxi GPS data》的研究展示了 DBSCAN 如何从出租车 GPS 数据中检测城市热点。
这一应用展示了 DBSCAN 在空间数据中识别高密度活动区域的能力,对城市规划与交通管理至关重要。
DBSCAN 可将像素聚成不同对象,用于图像中的目标识别等任务。题为“Segmentation of Brain Tumour from MRI Image – Analysis of K-means and DBSCAN Clustering”一文展示了 DBSCAN 在医学图像分析中的有效性。
研究者使用 DBSCAN 准确分割了 MRI 扫描中的脑肿瘤,展现了其在计算机辅助诊断与医学影像中的潜力。
在欺诈检测或系统健康监测中,DBSCAN 可隔离异常模式。题为“Efficient density and cluster-based incremental outlier detection in data streams”的研究展示了改进版 DBSCAN 在实时异常检测中的应用。
研究者将增量版 DBSCAN 应用于流数据中的离群点检测,具有在欺诈检测与系统健康监测中的潜在应用。
该研究展示了如何改造 DBSCAN 以识别连续数据流中的异常模式,这对于实时欺诈检测系统至关重要。
DBSCAN 可将偏好相近的用户归为一组,从而生成更准确的推荐。例如,题为“Multi-Cloud Based Service Recommendation System Using DBSCAN Algorithm”的研究展示了 DBSCAN 在改进推荐系统协同过滤方面的应用。研究者将 DBSCAN 作为聚类方法的一部分,根据用户的电影偏好与评分对用户分组,从而提升了电影推荐的准确性。
这一方法展示了 DBSCAN 如何在娱乐流媒体等领域提升个性化推荐。
DBSCAN 是数据科学家工具箱中的强大工具,尤其适用于簇数量未知且数据复杂、含噪的情境。然而,与任何算法一样,它并非万能之选。
成功聚类的关键在于理解您的数据、不同算法的优劣,并为任务选择合适工具。在许多情况下,尝试包括 DBSCAN 与 K-Means 在内的多种聚类方法并比较其结果,能为数据结构提供宝贵洞见。
随着实践与经验的积累,您将逐渐形成直觉,判断何时 DBSCAN 更可能揭示数据中的隐藏模式。
您可以通过 DataCamp 上的以下资源,进一步学习本文涉及的各类技术与方法:
热门 DataCamp 课程
课程
课程
学习路径