
课程
Python 中的聚类分析
4 小时
65.9K
在机器学习中,有两种技术可用于将对象划分为不同的组:分类与聚类。这常常让入门者产生不少困惑。
从表面看,分类和聚类似乎很相似。二者都使用算法来利用数据集中的特征,发现模式并将样本分到不同的组中。但在实际应用层面,它们截然不同。
本文将介绍每种技术、与之相关的不同算法及其应用,最重要的是,它们之间的差异。
分类任务属于“监督学习”问题。这类问题涉及基于历史数据训练模型,从而对新样本进行预测。
更正式地说,监督学习任务是在给定输入-输出样本对的基础上,学习一个函数,将输入映射到输出。因此,目标是近似从输入(X)到输出(y)的映射函数(f)——如果您有数学背景,您也许将其称为函数逼近问题。
需要注意的是,监督学习有两种形式:回归与分类。
在分类问题中,学习算法的目标是从一组特征近似出映射函数,以预测离散输出(例如,判断图像是猫还是狗)——参见我们的Python 文本分类入门教程以获得上手演示。
许多问题都可以应用分类算法,例如:
下面来看一些常见的分类算法。
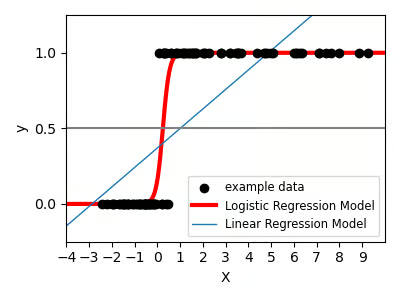
很多人会把逻辑回归误认为是回归算法,这可以理解。从技术上说,这并非全错。逻辑回归并不进行统计意义上的分类,它所做的是估计逻辑模型的参数。
之所以可以用逻辑回归做分类,是因为我们引入了用于分隔类别的决策边界。因此,在最简单的形式下,逻辑回归使用逻辑函数来建模二元因变量。
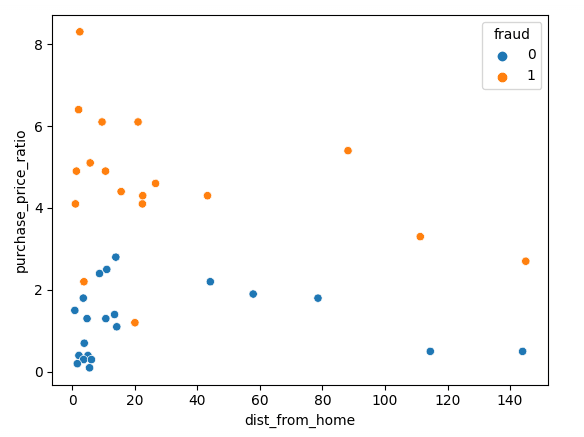
KNN 是最简单的机器学习算法之一,与逻辑回归不同的是,它既可用于分类,也可用于回归任务。
具体而言,它是非参数、惰性学习的算法。这意味着 KNN 不对样本特性或数据的定量/定性类型作假设(非参数),并将所有计算延后到函数评估阶段(惰性学习)。
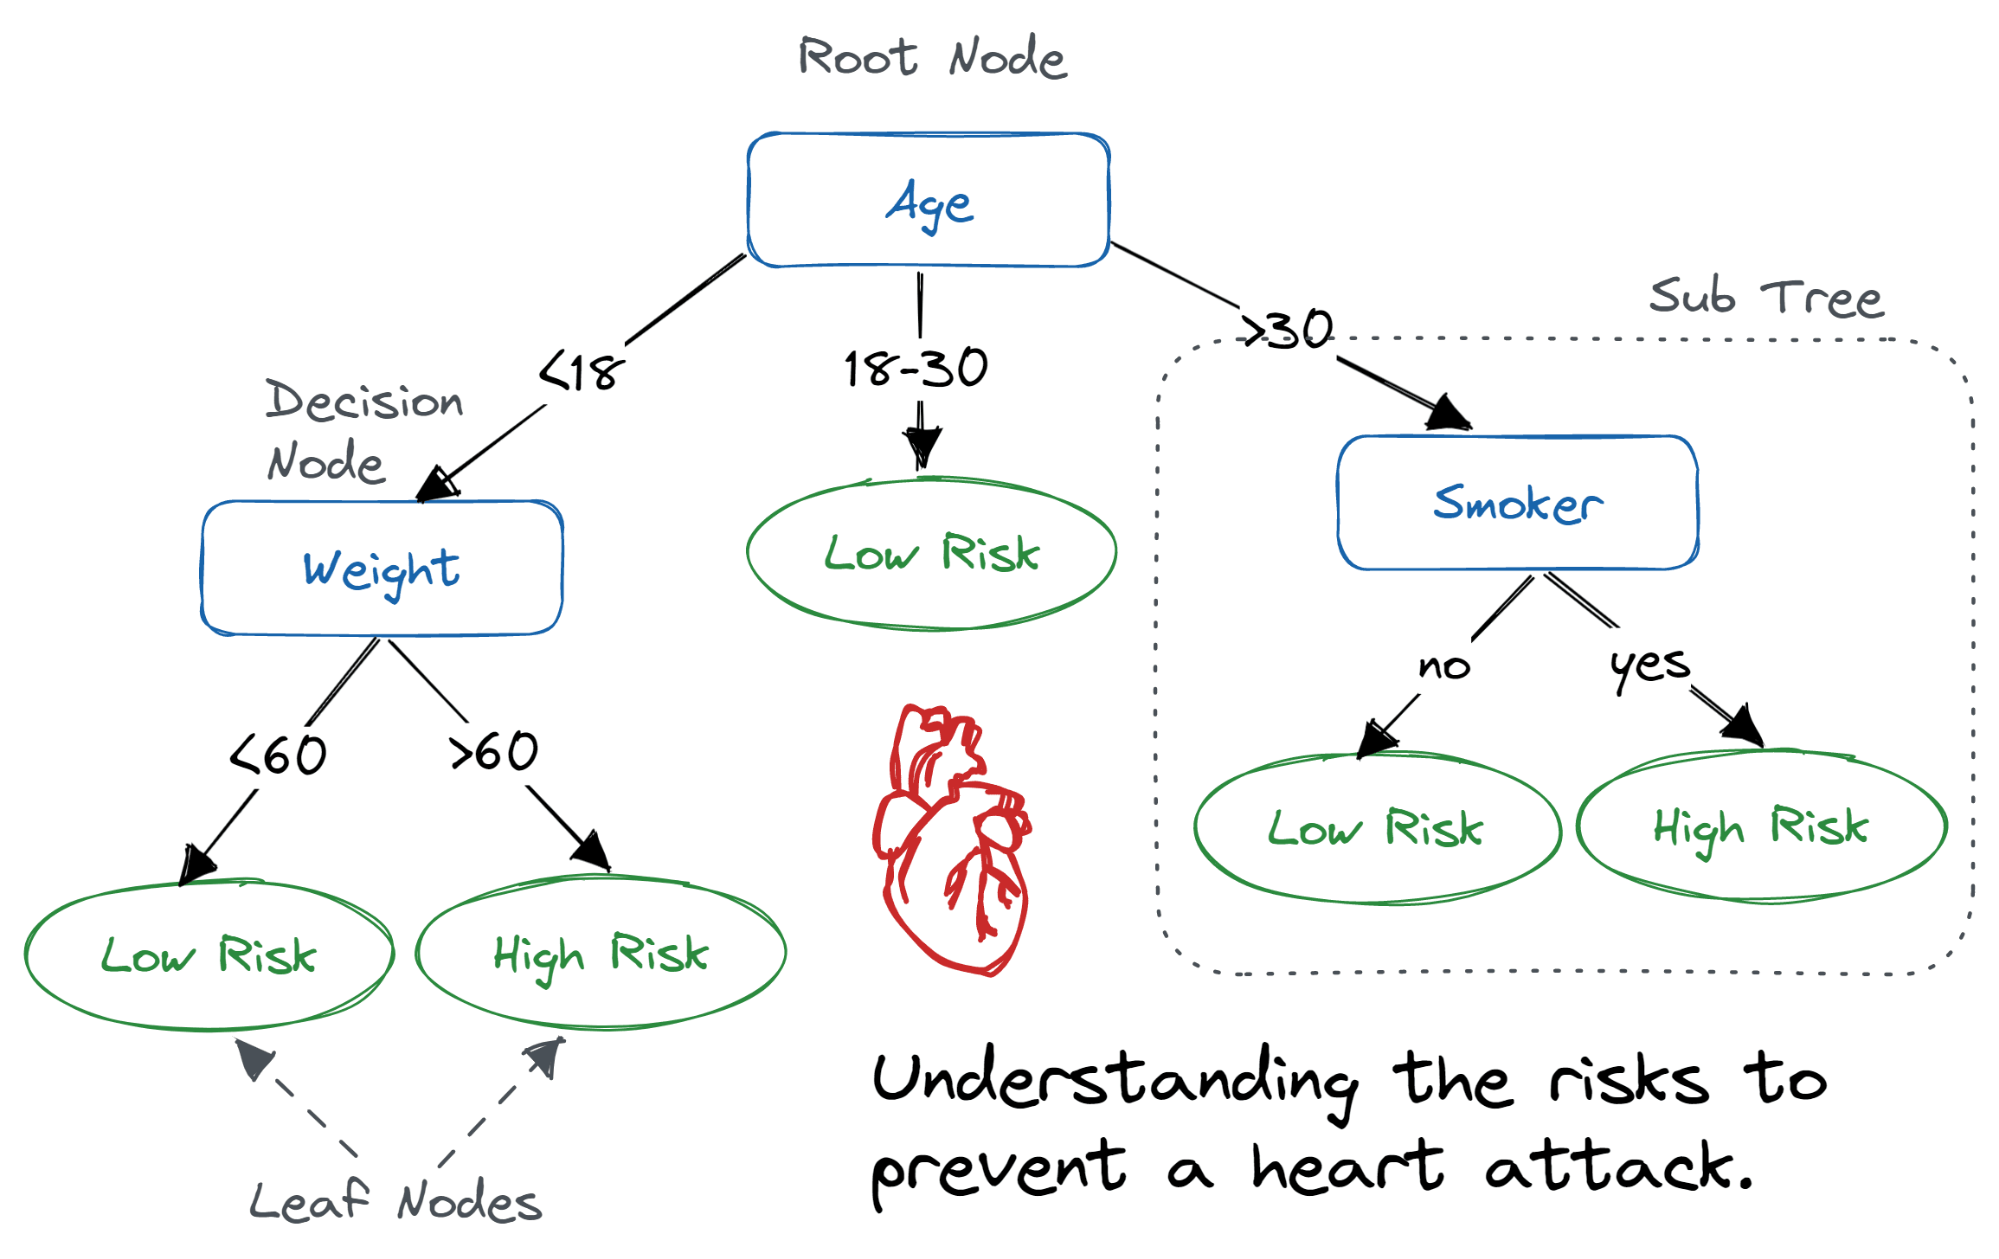
决策树算法是一种流行的非参数算法,同样可用于回归和分类。它之所以受欢迎,很大程度上是因为其可解释性和简单性——这是最易于可视化和理解的算法之一。
从概念上,您可以把决策树看作自根到叶的“流动”。从根到某个叶子的路径定义了基于特征作出的决策规则。
随机森林是由两个或多个决策树组成的集成模型。该技术利用自助聚合(bagging)和随机子空间方法来生长各棵树,从而得到一个强大的聚合预测器,可用于分类与回归。
注意,自助聚合(bagging)是一种生成多个预测器版本、以构建聚合预测器的技术。其目标是降低各预测器之间的相关性,从而使聚合模型具有更好的泛化能力。
通过从训练集中有放回地随机抽取样本,并用自助样本进行训练,为每个预测器引入随机性。
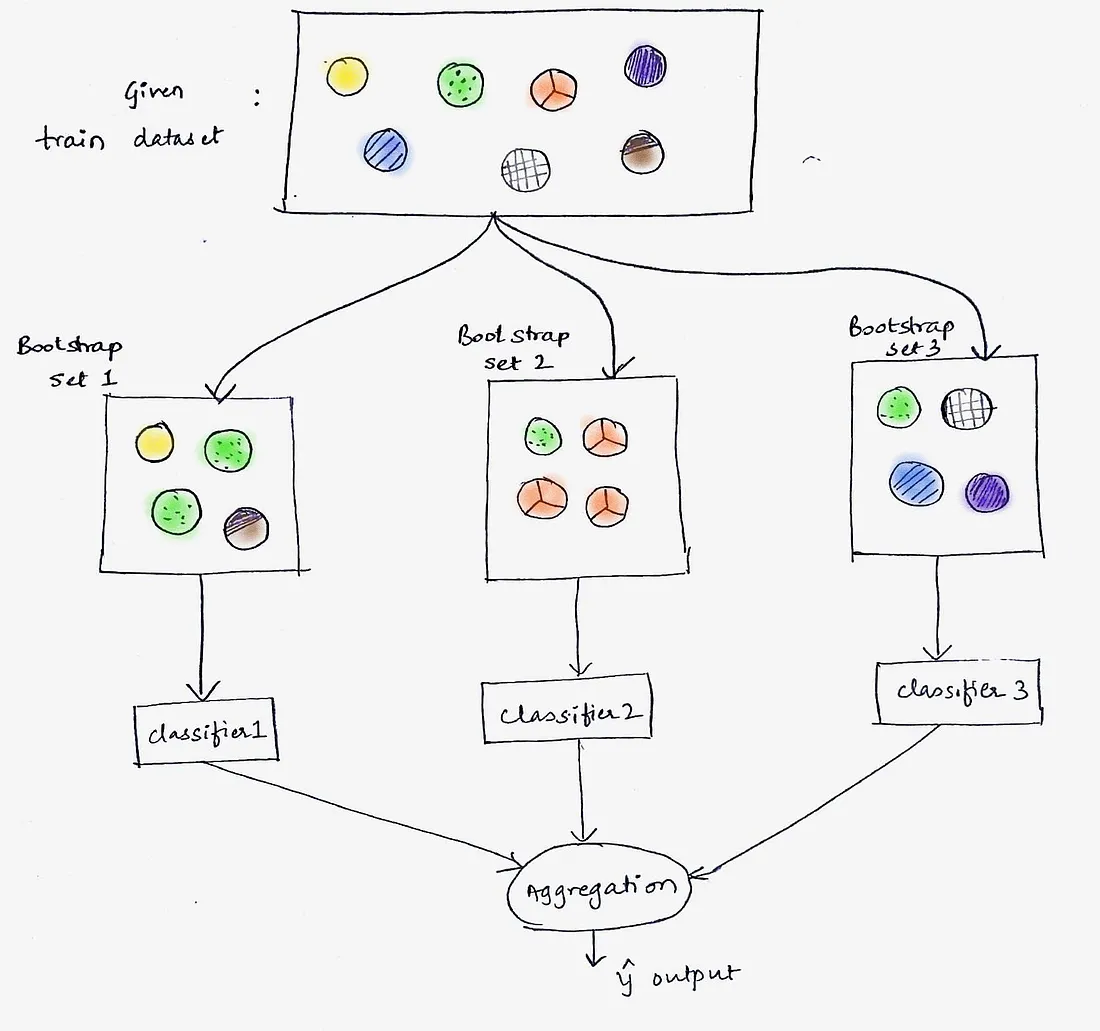
来源:Bagging:用可视化理解机器学习(1):什么是“Bagging”集成学习?
随机子空间方法也用于降低集成中预测器之间的相关性。它常被称为“特征袋装”,因为其做法与 bagging 相同,只不过作用于特征。即:随机子空间方法通过对特征进行有放回的随机抽样,为集成中的每个预测器构建于不同的特征子集上,从而降低相关性。
朴素贝叶斯分类器是一种基于贝叶斯定理的概率算法。贝叶斯定理是一条根据新数据更新概率的数学规则。
在朴素贝叶斯中,“朴素”的假设是:在进行预测时,数据集中的所有特征(或变量)彼此独立。这是一种简化,因为现实中特征往往并非独立。然而,尽管有这一朴素假设,该算法在许多分类任务中常常表现出乎意料地好。
因此,贝叶斯定理本身并不对变量独立性作任何假设。是朴素贝叶斯分类器为了简化与计算效率而作出了这一假设。
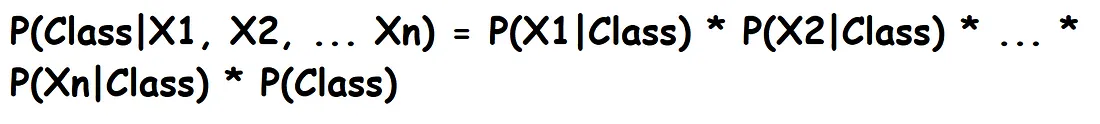
要理解聚类,我们先从无监督学习的定义说起。无监督学习旨在发现数据的潜在结构,而无监督学习算法不需要输入到输出的映射来完成这一点。
无监督学习通常用于在无需标签的情况下,发现数据中已有的模式,并据此将样本分组。它假设同组样本具有相似特征。因此,聚类是一种无监督学习技术,用于基于相似性或差异性将未标注数据分组。
聚类的使用场景包括:
以下是几种不同类型的聚类算法:
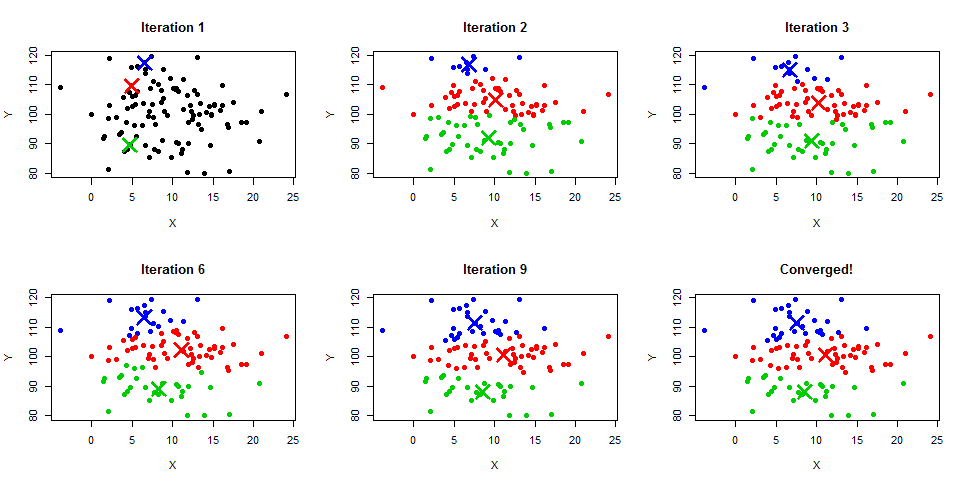
最常用、最流行的聚类算法之一是K-Means。它是一种以质心为基础的迭代算法,生成互不重叠的簇。
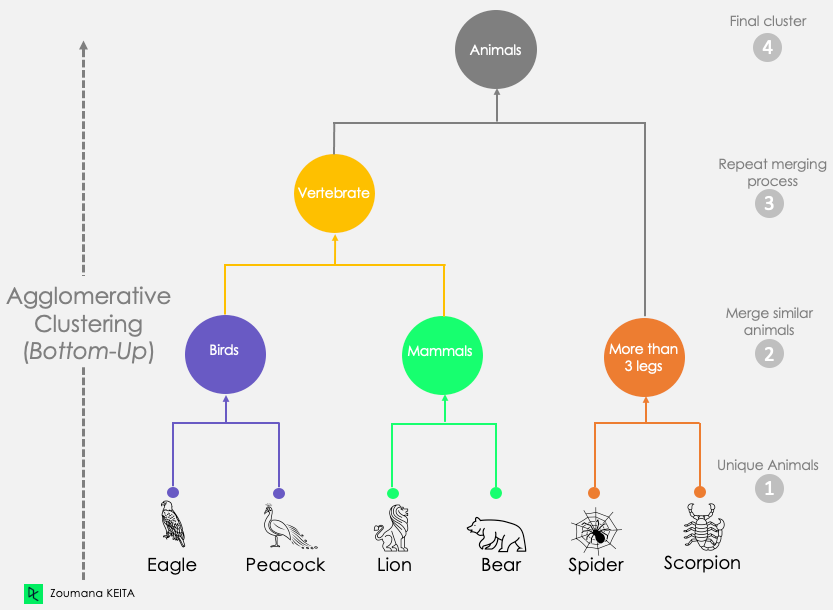
构建簇的另一种方式是建立簇的层级结构,因此称为“层次聚类”。构建层次结构有两种方式:
自底向上(凝聚式)
这是一种自底向上的方法,在初始阶段将每个观测视为一个簇。随着层级自下而上地构建,先将观测两两合并,再将成对合并的结果合并成更大的簇。
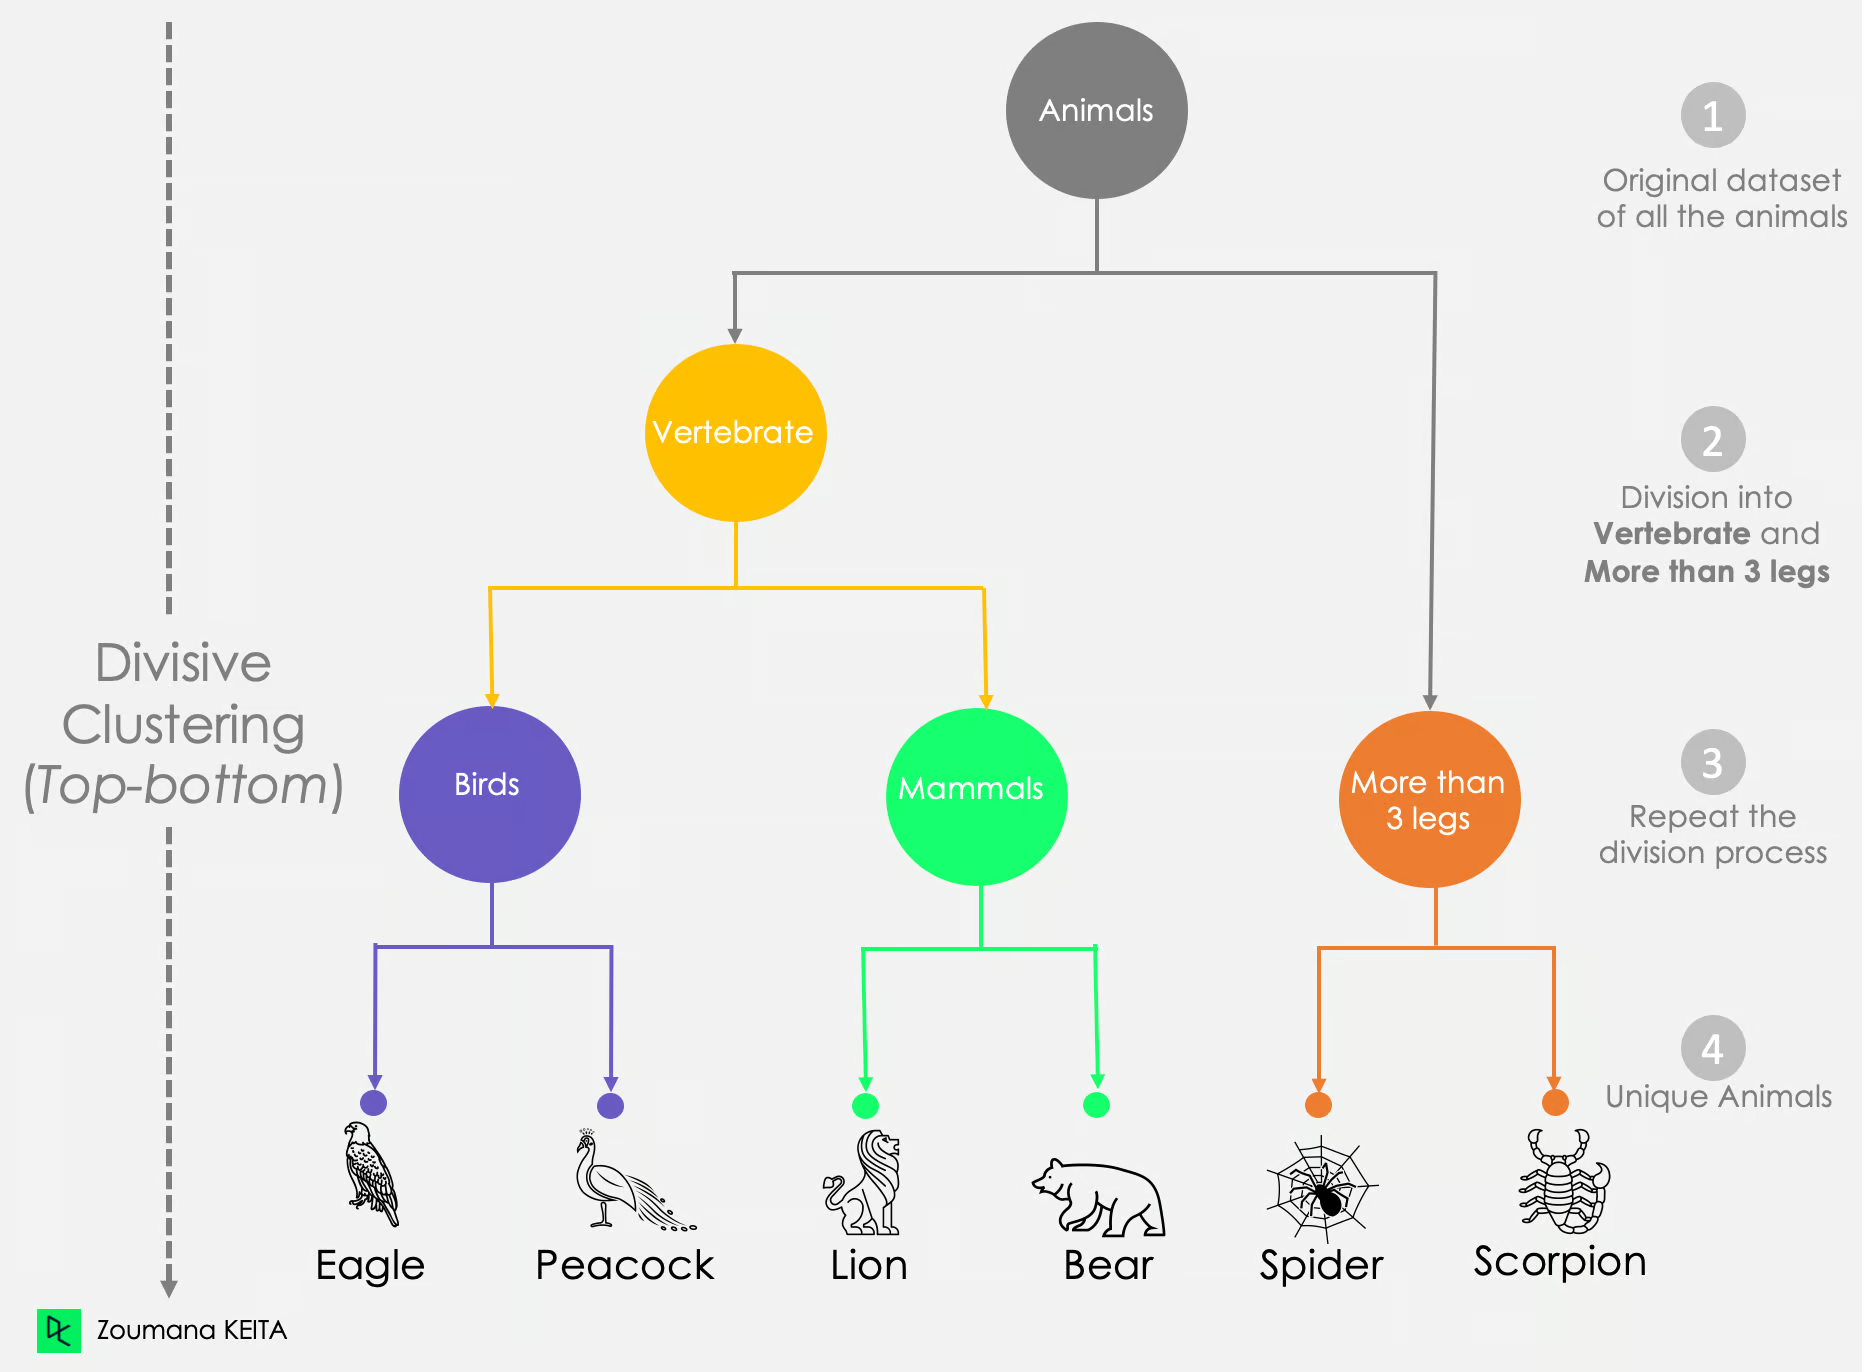
自顶向下(分裂式)
分裂式聚类是一种自顶向下的方法:所有观测最初属于一个簇,然后通过递归地进行划分,自上而下地构建层级结构。
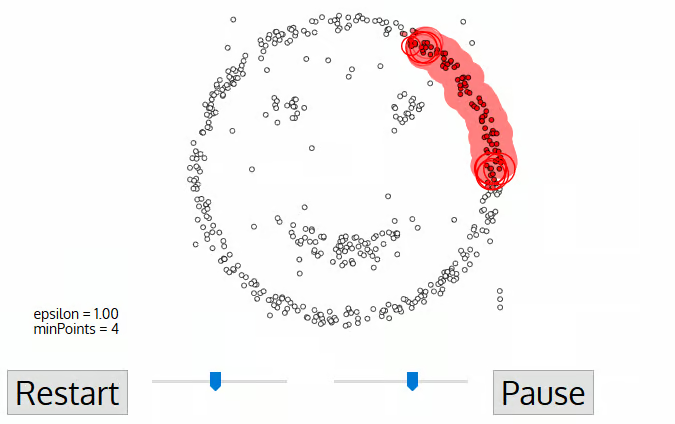
基于密度的具有噪声应用的聚类(Density-Based Spatial Clustering of Applications with Noise),简称 DBSCAN,其一大优势是对离群点的鲁棒性——它也是最知名的基于密度的聚类算法。
DBSCAN 假设簇是空间中的高密度区域,彼此由低密度区域分隔。与 K-Means 不同,DBSCAN 会根据数据来推断簇的数量,并能发现任意形状的簇,因此无需将簇数作为参数传入。
OPTICS 的全称是 Ordering Points to Identify the Clustering Structure。与 DBSCAN 一样,它是由同一研究团队开发的基于密度的算法。但 OPTICS 旨在克服 DBSCAN 的一大缺陷——在密度不均的数据中识别簇——方法是放弃对数据密度一致性的假设。
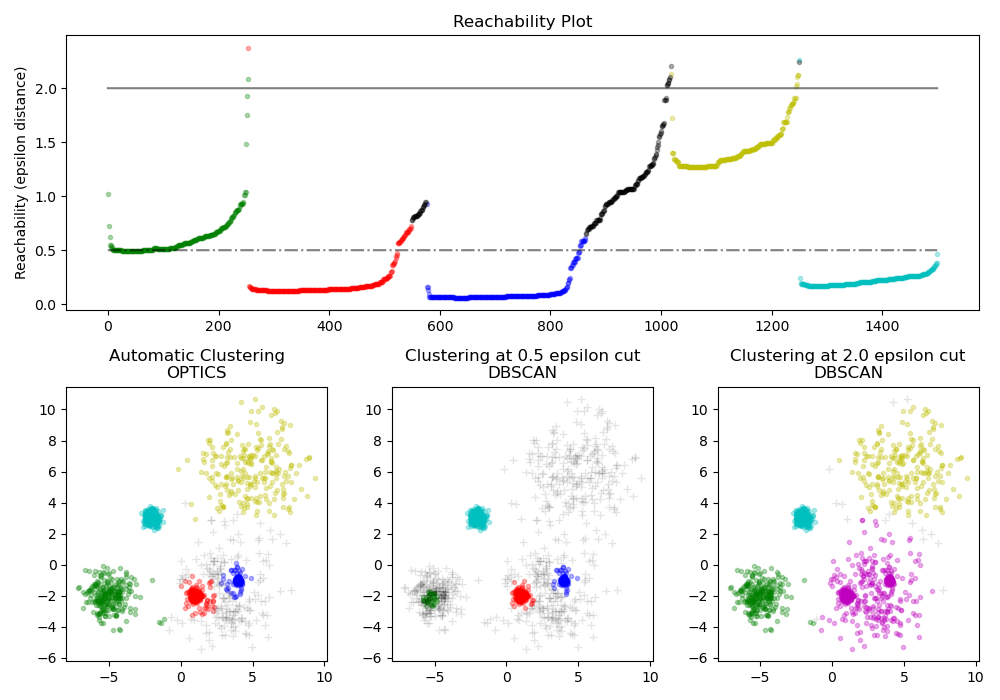
来源:Scikit-learn 的 OPTICS 聚类算法演示
分类属于监督学习。监督学习问题涉及学习一个函数,使其基于输入-输出样本对将输入映射到输出。相反,无监督学习任务采用诸如聚类之类的方法,在未标注数据中发现隐藏模式。
分类与聚类任务都需要训练数据来学习模式。然而,对于分类任务,准备测试数据来评估机器学习模型预测性能是一种良好实践。
聚类算法依赖输入数据去建模其潜在结构并发现洞见。换言之,没有“老师”告知算法正确答案——算法仅根据自身所学来划分。相反,分类算法需要输入与输出数据来学习映射函数,以便据此预测新输入数据的输出。
|
分类 |
聚类 |
|
|
监督式 |
是 |
否 |
|
有标签 |
是 |
否 |
|
目的 |
从一组输入(X)到离散输出(y)近似映射函数(f),以便用于预测新输入的输出。 |
学习输入(X)中的潜在模式,给出样本可能被划分到的群组建议。 |
|
算法 |
逻辑回归、K 近邻、决策树、随机森林、朴素贝叶斯 |
K-Means、凝聚式聚类、分裂式聚类、DBSCAN、OPTICS |
|
用例 |
客户流失、贷款审批、垃圾邮件过滤、人脸识别 |
市场细分、图像分割、社交网络分析、推荐引擎 |
尽管分类与聚类都旨在将样本划分为离散群组,但它们的方法本质上不同。分类依赖预先定义的标签与监督者来引导学习过程,适合客户流失预测或垃圾邮件过滤等任务。相对地,聚类在无监督下运行,更具探索性,常用于市场细分或推荐系统。理解这些细微差别,会显著影响您机器学习项目的成效。
想要更深入学习?查看这些 DataCamp 课程以提升您的理解与技能:
深入了解:分类与聚类导读
课程
课程
课程