

课程
理解 Prompt Engineering
1 小时
239.8K
实践并学习路径你的进步。
使用 Google 继续大多数 LLM 功能的测试方式都一样:试几个输入,目测输出,还行就上线。
您曾用这种方法测试邮件写作器。在聊天窗口里试了五个输入,看起来都不错。一周后,一半“轻松随意”的邮件听起来却像出自公司法务。没人发现,因为根本无从发现。提示词变了,但那五个手动测试并没有跟着变。
Promptfoo 是一个开源 CLI,可用结构化、可复现的评估替代上述流程。您定义“好输出”的标准,选好模型,然后自动运行所有组合。
OpenAI 已于 2026 年 3 月收购该项目,项目仍以 MIT 许可发布,并支持数十家提供商。超过 35 万名开发者在用,其中包括 25% 以上《财富》500 强公司的团队。
本教程将带您从零开始设置 Promptfoo,并构建您的第一个评估套件。我们将以邮件写作器为贯穿示例,在 GPT-5 与 Claude Sonnet 4.6 上测试,并在最后接入 GitHub Actions。
在开始用工具前,先理解 LLM 测试如何工作。它不同于常规代码测试。
测试函数时的套路是:给定输入,检查输出是否与预期一致。LLM 的输出不是这样。同一个提示词每次运行都可能生成不同文本,因此无法做精确匹配检查。
取而代之,您需要检查输出的“属性”:
这正是LLM 评估要做的事。它用一组输入运行您的提示词,并依据您定义的规则逐一检查输出。把它看作是“提示词”的测试套件,而非“代码”的测试套件。
本文将反复出现四个术语:
没有断言,您只能说“我觉得可以”;有了断言,您就有了可重复运行的“正确性”定义。
了解评估是什么之后,再看 Promptfoo 如何发挥作用。
您需要提供三样东西:
它会对每个测试用例,将每个提示词在每个模型上运行并打分。一个命令 promptfoo eval 即可跑完整套评估。
假设您有一个邮件写作提示词、两个模型(GPT-5 和 Claude Sonnet 4)以及三个测试用例(随意、正式、紧急)。Promptfoo 会跑完六种组合,并告诉您哪些通过、哪些失败。无需再逐个手动尝试。
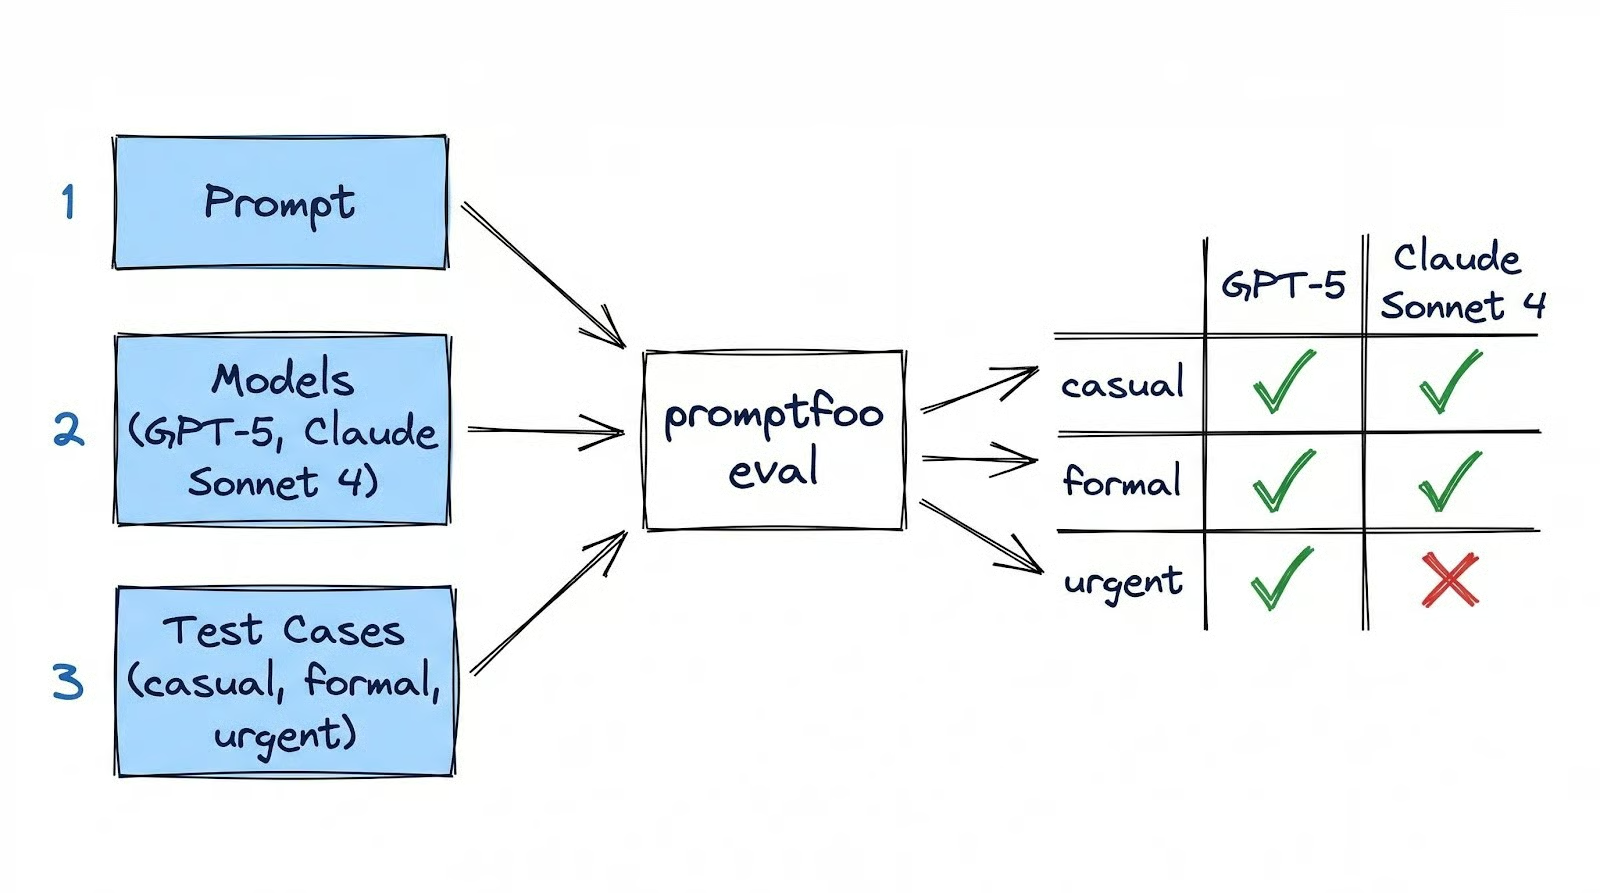
整个评估都写在一个名为 promptfooconfig.yaml 的 YAML 文件里,和代码一起纳入版本控制。Promptfoo 在本机运行:配置、结果和缓存都保留在本地。唯一的外部调用是到 OpenAI 或 Anthropic 等模型 API,不管有没有 Promptfoo,您都会发这些请求。
该领域还有其他工具,如 DeepEval(原生 Python、pytest 风格)、LangSmith(面向 LangChain 的生产监控)和 Braintrust(团队看板)。Promptfoo 是最佳起点,因为它免费、本地运行,并且能以最快速度让您从零到可用评估。
全局安装 Promptfoo 并初始化新项目:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
init 命令会引导交互式配置。它会询问您想做什么(选择 "Not sure yet"),以及使用哪个模型提供商(选择 "[OpenAI] GPT 5, GPT 4.1, ...")。
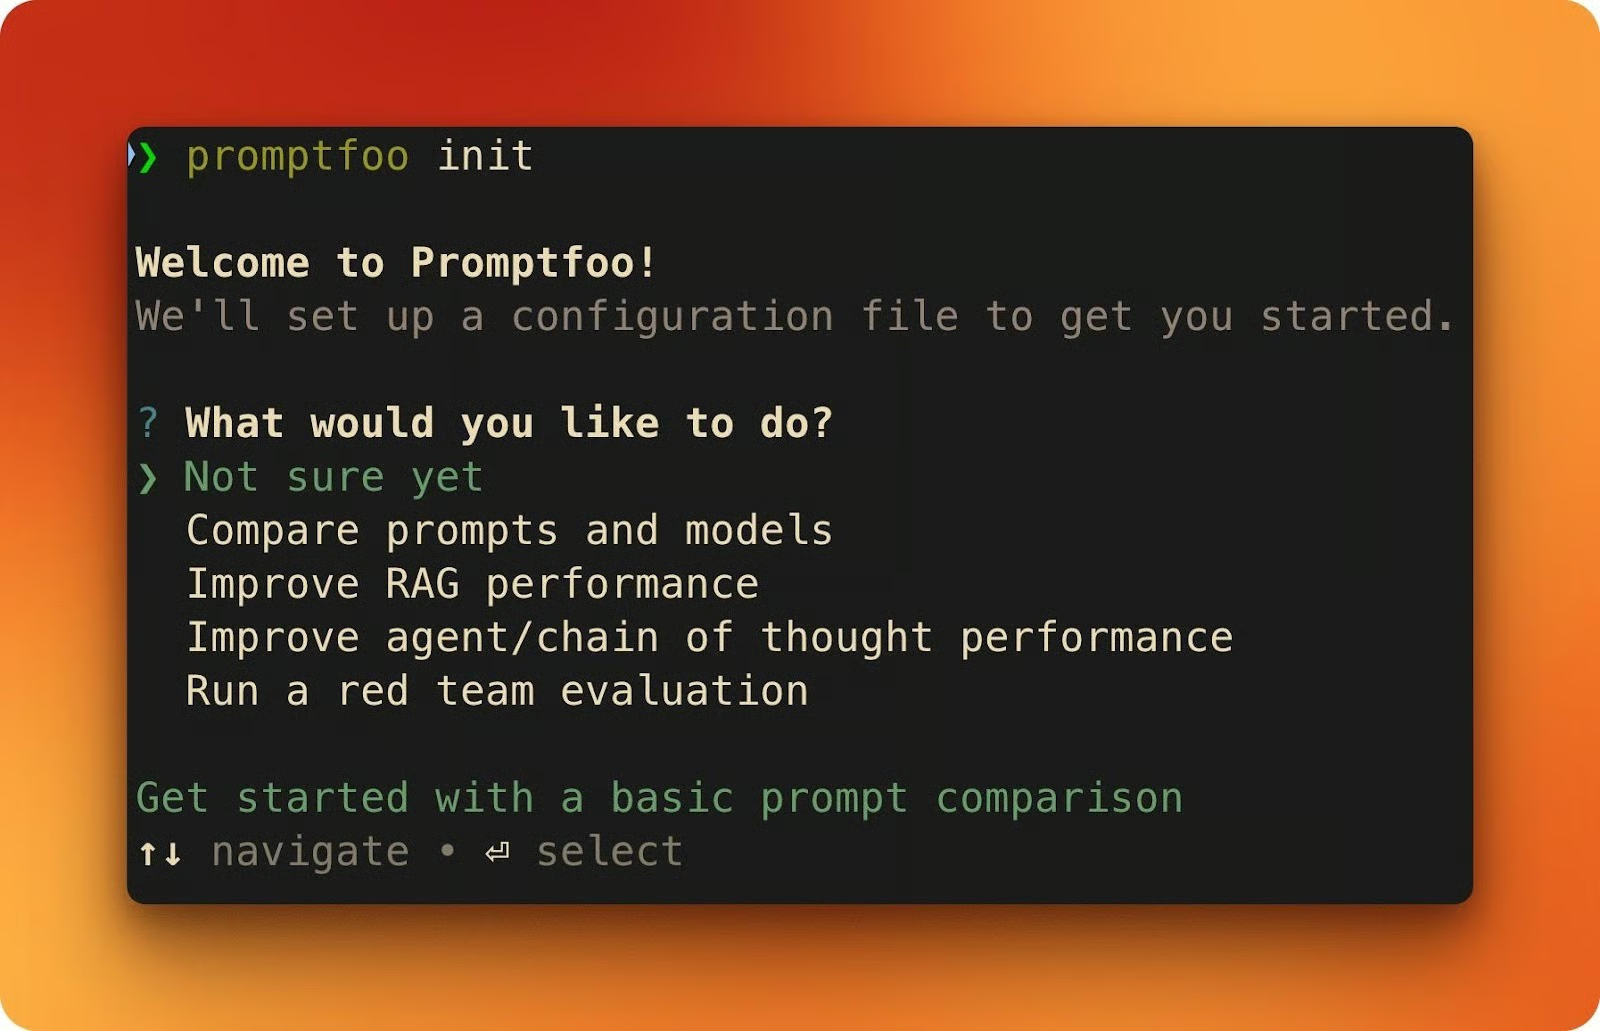
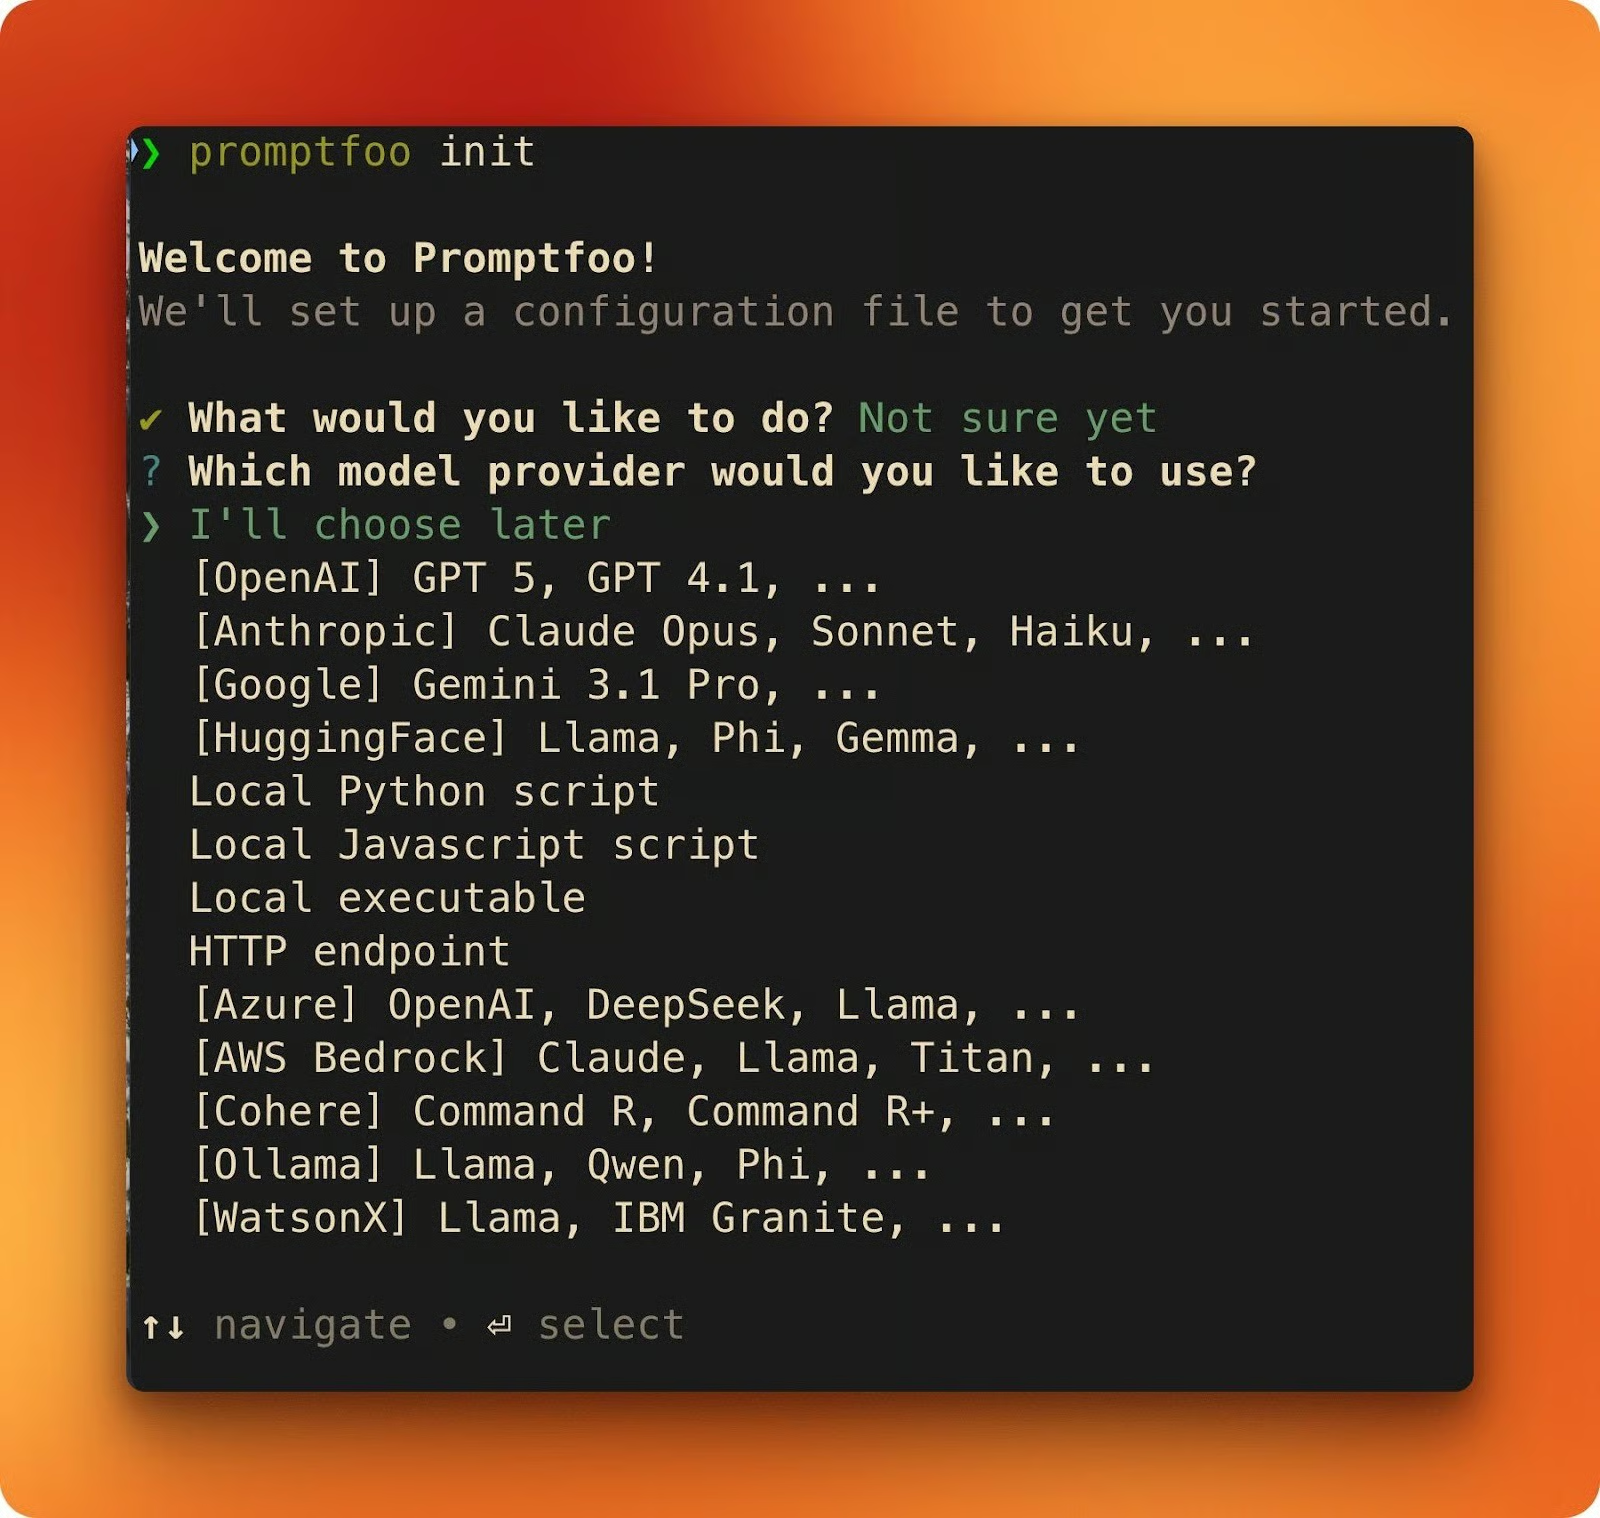
完成后,您将看到两份文件:一个示例 promptfooconfig.yaml 和一个 README.md。
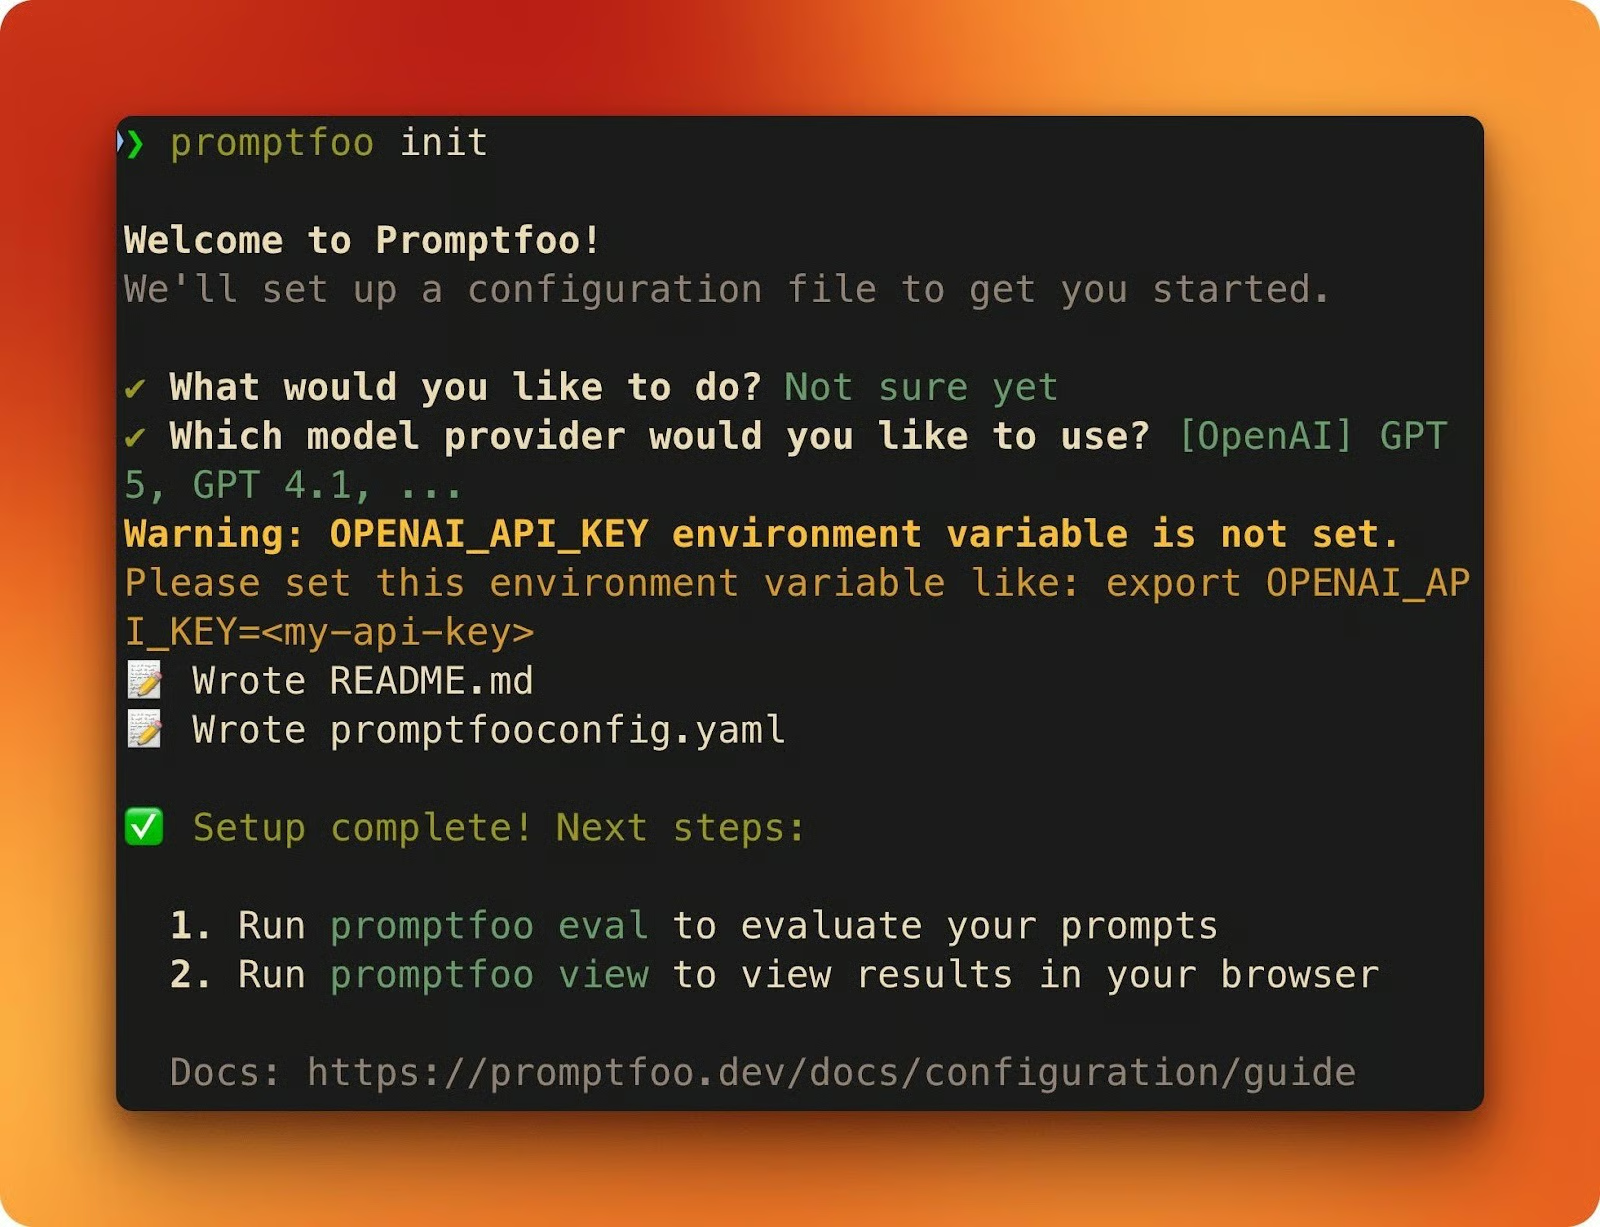
接下来设置 API 密钥。至少需要一个才能运行评估(若要完整跟随本教程,建议两者都配置):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
如果您只设置了 ANTHROPIC_API_KEY 而未配置 OpenAI,Promptfoo 会在 llm-rubric 等模型辅助断言中自动使用 Claude 作为评分提供商。
打开生成的 promptfooconfig.yaml。每个 Promptfoo 配置都有三大模块:
prompts 用于放置提示词模板。像 {{variable}} 这样的双花括号占位符会从各测试用例中填充。
providers 列出要测试的模型。
tests 定义输入以及判定输出通过/失败的断言。
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
这个示例配置只是起点。下一节我们将用一个真实评估替换它,并深入讲解 YAML 结构。
任务如下:给定要点和语气(随意、正式或紧急),写一封邮件。您将构建一个评估,在两个模型上测试这一需求。
如果想一次性查看完整配置,可在 Gist 获取。我们将在下文逐步搭建。
删除生成的示例,新建 promptfooconfig.yaml。从提示词与提供商开始:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
label: \"Claude Sonnet 4.6\"该提示词模板包含两个占位符:{{bullet_points}} 与 {{tone}}。每个测试用例会用不同值填充它们。每个提供商上的 label 字段用于在结果视图中显示可读的列标题,而不是原始模型 ID。
接着添加 defaultTest 模块。放在 defaultTest 中的断言会自动应用到所有测试用例,避免重复:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
该设置会判定任何超过 30 秒的响应为失败。类似 GPT-5 这样的前沿模型可能因推理 token 耗时,每次请求需要 10–20 秒,因此阈值需要留有余量。此处只需设置一次,所有测试都会继承。
现在添加测试用例。每个用例提供不同输入与其专属断言:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
每个测试用例都配有两类断言。
icontains 是简单的字符串检查:输出是否包含“mockups”(不区分大小写)?它快速、免费,也不调用任何 API。
llm-rubric 会将输出发送给另一个 LLM,请它依据您的评分标准对响应打分。它需要消耗 token,但能捕捉字符串匹配无法涵盖的内容,比如邮件是否真的听起来很随意。
运行评估:
promptfoo eval然后在浏览器中打开结果:
promptfoo view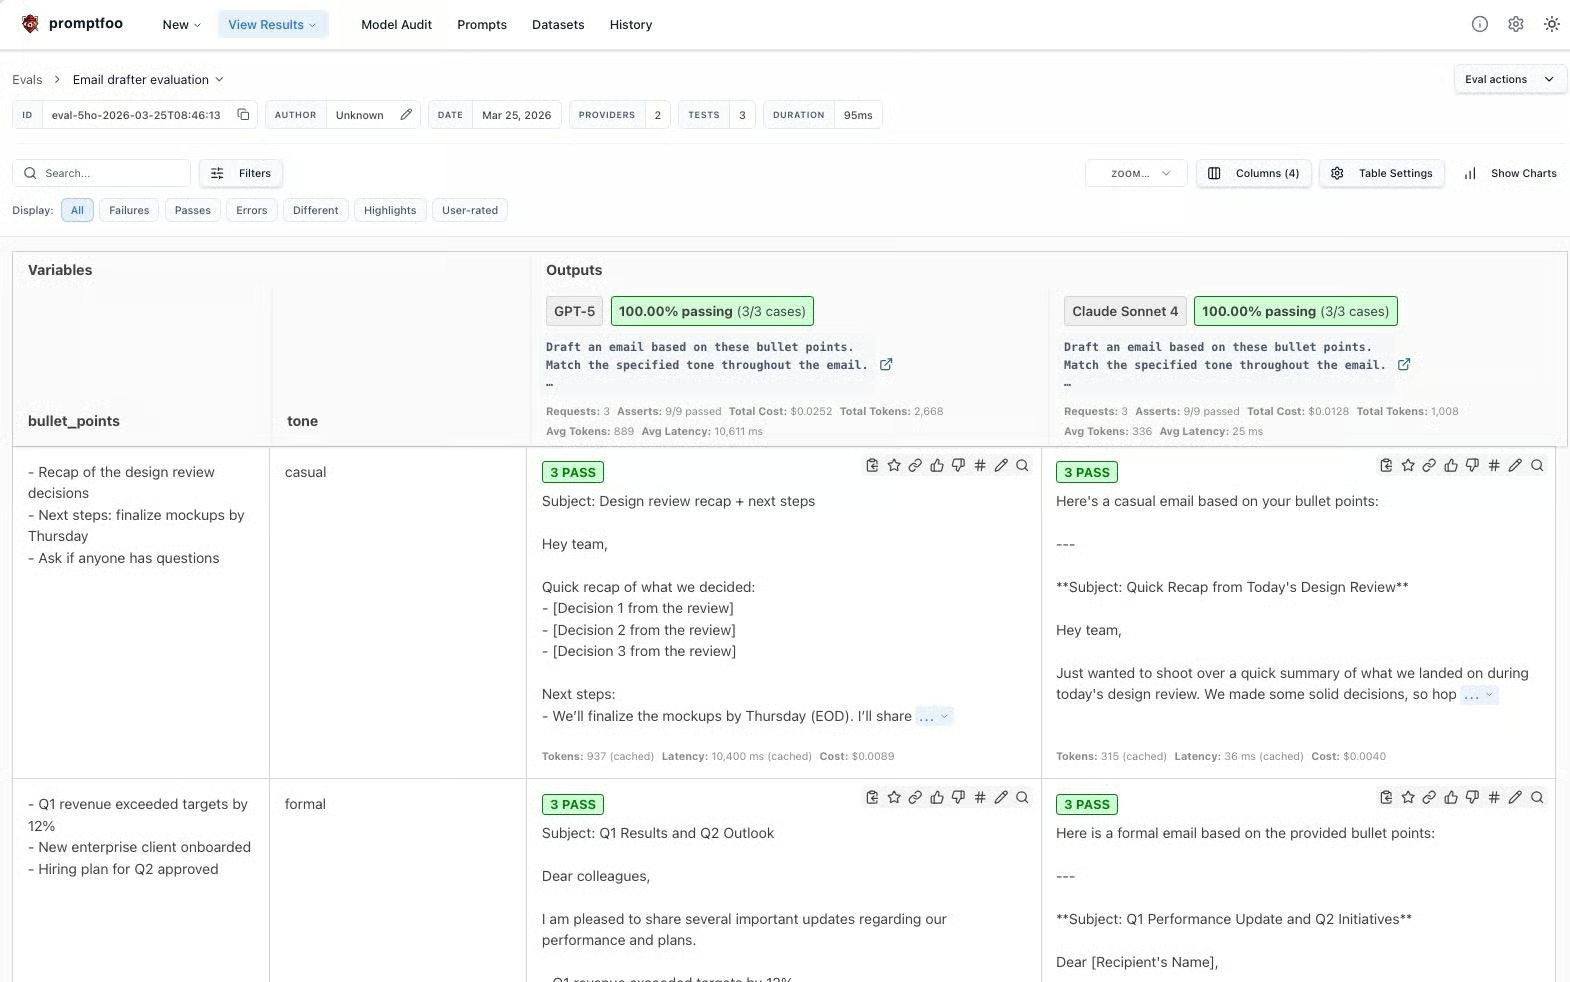
Web 界面以列展示提供商、以行展示测试用例。每个单元格显示各项断言的通过/失败,您可点击任意单元格查看完整输出与评分细节。
Promptfoo 默认将 API 响应缓存到磁盘(TTL 14 天),因此重复运行相同评估不再产生费用。需要全新响应时使用 --no-cache。
第一次评估用了 icontains 和 llm-rubric。它们只是 Promptfoo 支持的众多断言类型中的两个。本节将介绍主要类别,并在此过程中持续为邮件写作器配置添加断言。
这些断言本地运行、无需费用且即时返回结果。
|
类型 |
检查内容 |
|
|
输出是否包含某个子串(区分/不区分大小写) |
|
|
输出是否匹配某个模式(可用 |
|
|
输出不应包含的内容(模板残留、拒答、占位文本等) |
|
|
响应是否在 N 毫秒内返回 |
|
|
响应成本是否低于 $X |
您已使用过 icontains 与 latency。现在为“随意”用例添加 not-contains。若模型默认为正式语气,可能会用 “Dear” 开头,而非 “Hey” 这类随意用法。只需一行即可捕捉:
- type: not-contains
  value: \"Dear\"
把这行加入“随意”用例的 assert 列表并重跑。两个模型都应通过:GPT-5 常以 “Hey team,” 开头,Claude Sonnet 4 也是如此。若任一模型以 “Dear Colleagues,” 开头,该断言会立刻标红。
每种断言类型都支持 not- 前缀:如 not-regex、not-equals 等。
这些断言会消耗 token,但能判断字符串匹配无法判断的内容。您已在首次评估中使用了 llm-rubric。评分标准写得好坏,至关重要。
像“邮件听起来很专业”这样的笼统标准对评分毫无帮助。具体明确的标准才能提供可衡量依据:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
使用该评分标准重跑评估后,评分者的输出也会更具体:
评分标准越具体,评分就越一致、越有参考价值。
Promptfoo 还提供 answer-relevance(输出是否回答了问题?)与 similar(通过嵌入与参考答案做余弦相似度),两者都对 RAG 与搜索类应用很有用。
当内置类型无法覆盖您的逻辑时,可自行编写。对于邮件写作器,您可能想检查输出是否保持在合理长度。下面是一个内联断言:当邮件字数在 50 到 200 之间时通过:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
将其添加到“随意”用例并重跑。我这次运行中,两个模型都通过:GPT-5 为 54 个词,Claude Sonnet 4 为 187 个词。但请记住该断言,下一节它并非处处都通过。
若需更复杂的检查,将逻辑写入单独文件:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
在配置中用 type: python 与 value: file://assert_length.py 引用它。reason 字段会显示在结果 UI 中,便于查看测试通过或失败的具体原因。
下面是一个真实的失败示例。
将 Python 字数断言添加到三个用例并在两个模型上跑完整评估。在我的运行中,六个组合里有五个通过。Claude Sonnet 4.6 未通过“紧急”用例(由于 LLM 的非确定性,在您机器上可能不会复现)。
那次运行中,输出为 207 个词,超出上限 7 个。llm-rubric 其实是通过的,确认了邮件使用了“紧急、直接的语言”,并给出“清晰的行动项”。icontains 也通过了,因为输出包含 “Friday”。
但 Python 字数断言失败了。Claude 在正文前加了元说明(“Here is a draft email based on your bullet points with an urgent tone:”),把字数推高到了 200 以上。
这类问题靠目测很难抓。邮件本身读起来没问题:语气对、内容对。但因为模型额外添加了不属于正文的文字,输出过长。一个断言就能捕捉到,评估也会标记该用例失败。
修复有两种思路:调整提示词,明确禁止前言;或提高字数上限。无论哪种方式,都要重跑评估并确认通过。
此时,“随意”用例已有四个断言: icontains、not-contains、llm-rubric 与 Python 字数检查。它们的重要性并不相同。可用 weight 字段表达权重:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7每个断言的得分会乘以其权重,测试计算加权平均分。threshold 设置通过所需的最低分。此处语气评分(rubric)的权重是关键词检查的两倍,而字数检查是它们的一半。
用这些权重重跑“随意”用例,两个模型都得分 1.0 并通过。但如果 llm-rubric 失败(权重 2),而字数检查通过(权重 0.5),加权得分就会低于 0.7 的阈值,测试将失败。通过权重,您可以告诉 Promptfoo 哪些指标对您更重要。
配置里已经有两个提供商,因此 promptfoo eval 会在一次运行中同时测试 GPT-5 与 Claude Sonnet 4。打开 promptfoo view,您会看到它们在结果中分别以列显示,每个模型都对所有用例独立打分。
在我这次评估中,GPT-5 在三个用例的六项断言上全部通过。Claude Sonnet 4 通过了五项,但在“紧急”邮件的字数检查上失败。
这类差异用手动试几个提示词很难发现,但在结果矩阵中一目了然。您是在同一输入、同一断言下比较分数,而不是凭记忆判断哪个模型“感觉更好”。
不过 LLM 输出并非确定性。相同提示词在连续运行中可能产生不同结果,一次运行无法判断模型是稳定优秀还是偶然发挥。可用 --repeat 参数来应对:
promptfoo eval --repeat 3这会让每个提供商对每个用例运行三次。如果某模型在两次中通过语气断言、第三次却失败,那就是一次性运行难以察觉的稳定性信号。
开发期间在本地运行评估没问题,但这取决于修改提示词的人是否记得去跑。Promptfoo 提供官方的 GitHub Action,可在每个涉及提示词变更的拉取请求上自动运行评估套件,并将结果以评论形式发布。
设置方式:在仓库中创建工作流文件:
mkdir -p .github/workflows然后创建 .github/workflows/prompt-eval.yml,内容如下:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
在此之前,您需要在 GitHub 仓库的 Settings > Secrets and variables > Actions 中添加 OPENAI_API_KEY(可选添加 ANTHROPIC_API_KEY)为仓库密钥。
paths 过滤器意味着仅当 prompts/ 下的文件发生变更时才触发。checkout 步骤必需,因为该 Action 会在内部用 git 比较分支间的提示词文件差异。它将运行完整评估套件,并在 PR 中发布包含结果与 Web 查看器链接的评论。
若需更灵活的通过/失败逻辑,可直接解析 JSON 输出:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
从这里开始的工作流:
提示词的变更将与代码变更一样,合并前先测试。
开头提到的邮件写作器仍有语气问题,但现在有测试能在用户发现前将其拦下。您从一份空白 YAML 文件出发,最终搭建了跨两个模型并接入 CI 的评估套件。
同样的方法适用于您构建的任何 LLM 功能,无论是聊天机器人、摘要器,还是分类流水线。只要您能为“好输出”写出断言,就能自动化测试,而不是靠目测。
准备更进一步时,Promptfoo 文档覆盖了多个值得关注的方向:
红队对抗:promptfoo redteam run 可借助数十种攻击插件扫描提示注入与越狱
自定义 Python 提供商:用 file://my_provider.py 封装任意内部模型或微调端点
CSV 测试数据:当内联 YAML 难以维护时,使用 file://tests.csv 扩展测试套件规模
如果您想改进正在测试的提示词,我们的 Prompt Engineering with the OpenAI API 课程涵盖了许多可应用于各类 AI 开发的重要技巧。
提示工程课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续