
Last chance! 50% off DataCamp Premium
Sale ends in
Kebanyakan fitur LLM diuji dengan cara yang sama: coba beberapa input, lihat sekilas outputnya, lalu rilis.
Anda pernah melakukannya untuk penulis email. Lima input di jendela chat, output terlihat oke. Seminggu kemudian, setengah email berbahasa santai Anda terdengar seperti ditulis oleh pengacara korporat. Tidak ada yang menyadarinya karena memang tidak ada cara untuk mendeteksinya. Prompt berubah, tetapi lima tes manual itu tidak ikut bersama Anda.
Promptfoo adalah CLI open-source yang menggantikan proses tersebut dengan evaluasi yang terstruktur dan dapat diulang. Anda mendefinisikan seperti apa output yang baik, memilih model, dan menjalankan setiap kombinasi secara otomatis.
OpenAI mengakuisisi proyek ini pada Maret 2026, dan proyek ini tetap berlisensi MIT dengan dukungan untuk puluhan penyedia. Lebih dari 350.000 pengembang menggunakannya, termasuk tim di lebih dari 25% perusahaan Fortune 500.
Tutorial ini memandu Anda menyiapkan Promptfoo dan membangun suite evaluasi pertama Anda dari nol. Kita akan menggunakan penulis email sebagai contoh berjalan, mengujinya di GPT-5 dan Claude Sonnet 4.6, dan menyambungkannya ke GitHub Actions pada akhirnya.
Sebelum masuk ke alatnya, Anda perlu tahu cara kerja pengujian LLM. Ini berbeda dari menguji kode biasa.
Jika Anda pernah menguji sebuah fungsi, Anda tahu polanya: beri input, cek apakah output sesuai harapan. Output LLM tidak bekerja seperti itu. Prompt yang sama bisa menghasilkan teks berbeda setiap kali dijalankan, jadi Anda tidak bisa memeriksa kecocokan persis.
Sebagai gantinya, Anda memeriksa sifat dari output:
Itulah yang dilakukan sebuah evaluasi LLM. Evaluasi ini menjalankan prompt Anda pada sekumpulan input dan memeriksa setiap output terhadap aturan yang Anda tentukan. Anggap saja sebagai suite pengujian untuk prompt Anda, bukan untuk kode Anda.
Empat istilah akan sering muncul sepanjang artikel ini:
Tanpa asersi, Anda kembali ke "kelihatannya bagus buat saya." Dengan asersi, Anda punya definisi "benar" yang berjalan sama setiap kali.
Sekarang Anda tahu apa itu evaluasi, berikut yang dilakukan Promptfoo dengannya.
Anda memberi Promptfoo tiga hal:
Promptfoo menjalankan setiap prompt terhadap setiap model untuk setiap kasus uji dan memberi skor hasilnya. Satu perintah, promptfoo eval, menjalankan semuanya.
Misalnya Anda punya satu prompt penulisan email, dua model (GPT-5 dan Claude Sonnet 4), dan tiga kasus uji (santai, formal, mendesak). Promptfoo menjalankan semua enam kombinasi dan memberi tahu Anda mana yang lolos dan mana yang gagal. Tidak perlu lagi mencoba satu per satu secara manual.
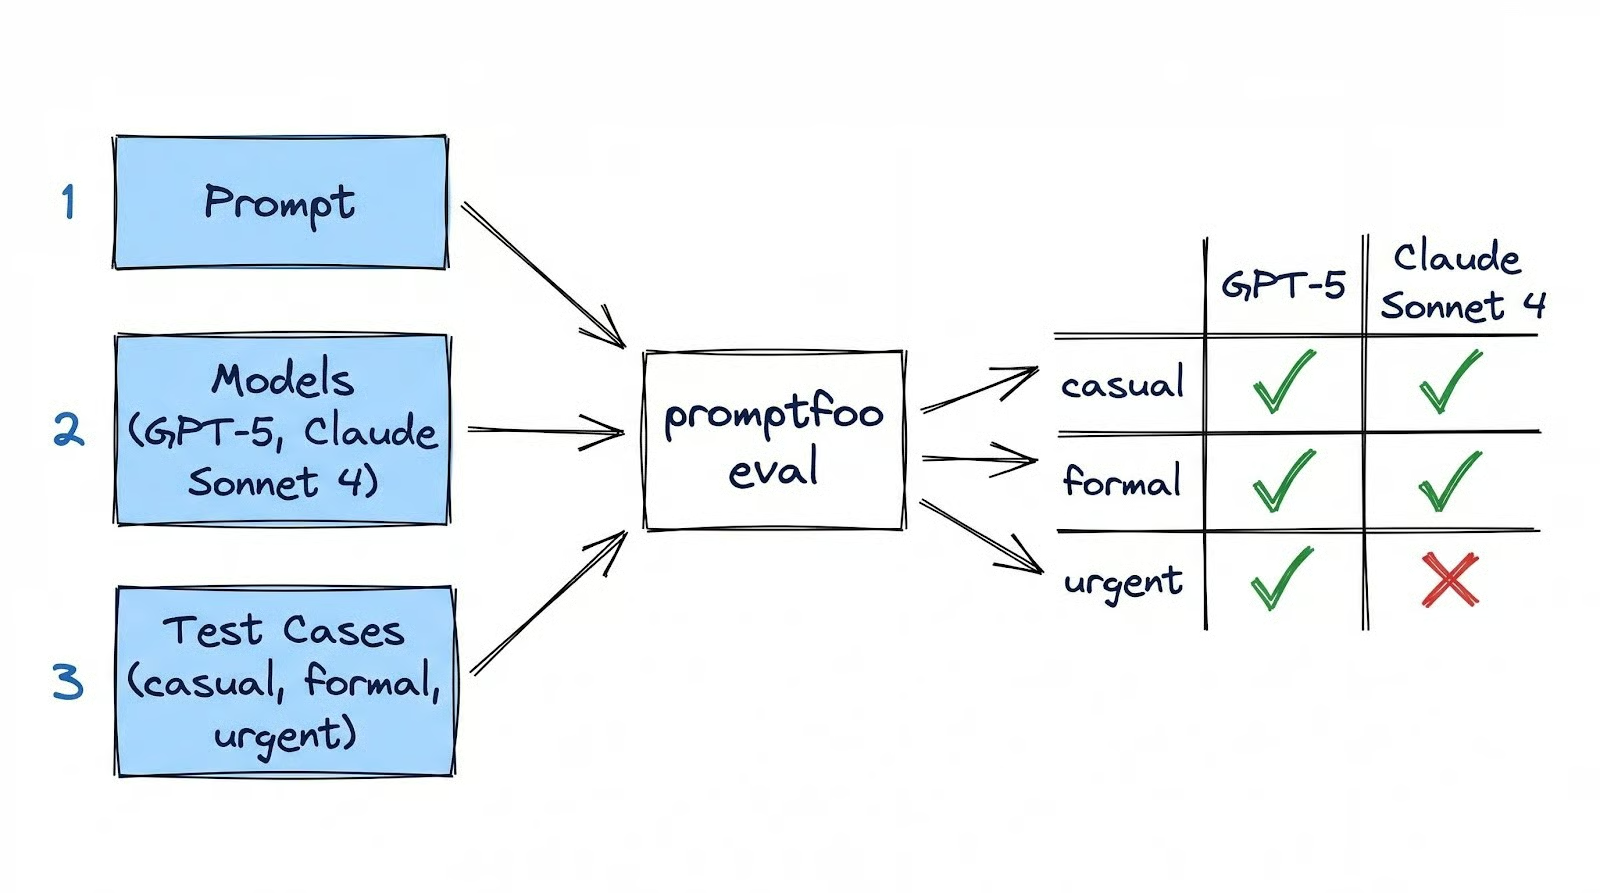
Seluruh evaluasi berada dalam satu file YAML bernama promptfooconfig.yaml yang Anda kelola versinya bersama kode Anda. Promptfoo berjalan di mesin Anda: konfigurasi, hasil, dan cache semuanya tetap lokal. Satu-satunya panggilan eksternal adalah ke API model seperti OpenAI atau Anthropic, yang akan Anda lakukan dengan atau tanpa Promptfoo.
Alat lain di ruang ini juga adat, seperti DeepEval (native Python, gaya pytest), LangSmith (pemantauan produksi untuk LangChain), dan Braintrust (dasbor tim). Promptfoo adalah titik awal terbaik karena gratis, berjalan lokal, dan membawa Anda dari nol ke evaluasi yang berfungsi lebih cepat daripada semuanya.
Instal Promptfoo secara global dan inisialisasi proyek baru:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
Perintah init memandu Anda melalui penyiapan interaktif. Ia menanyakan apa yang ingin Anda lakukan (pilih "Not sure yet") dan penyedia model mana yang akan digunakan (pilih "[OpenAI] GPT 5, GPT 4.1, ...").
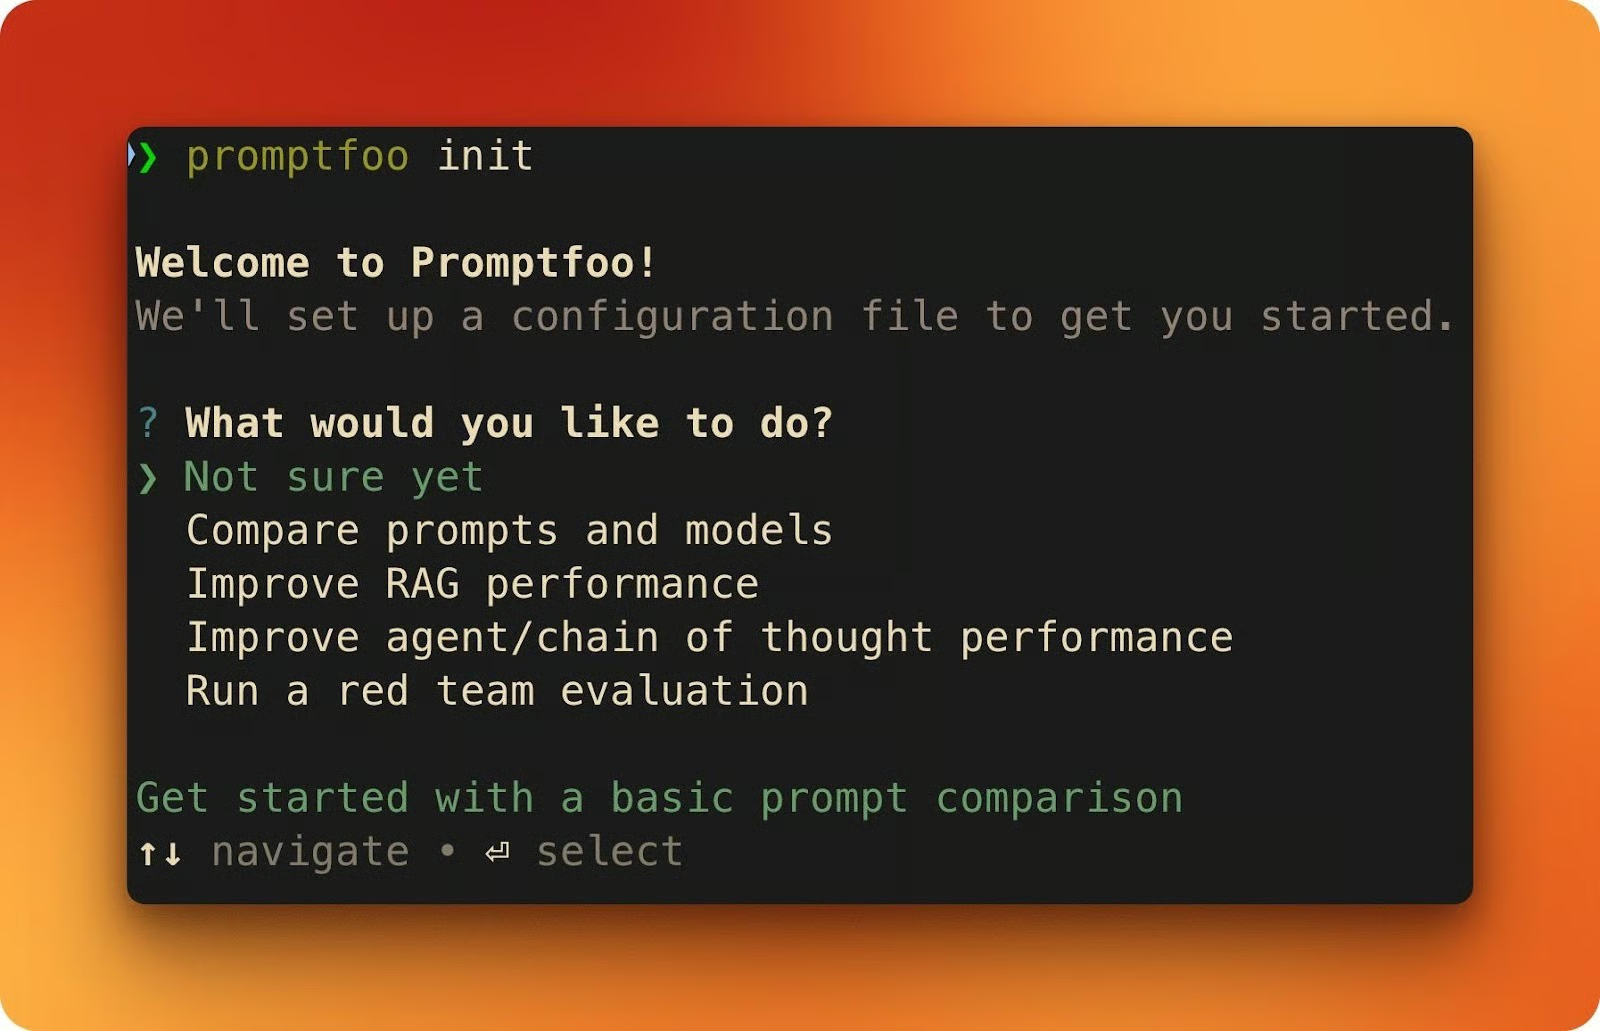
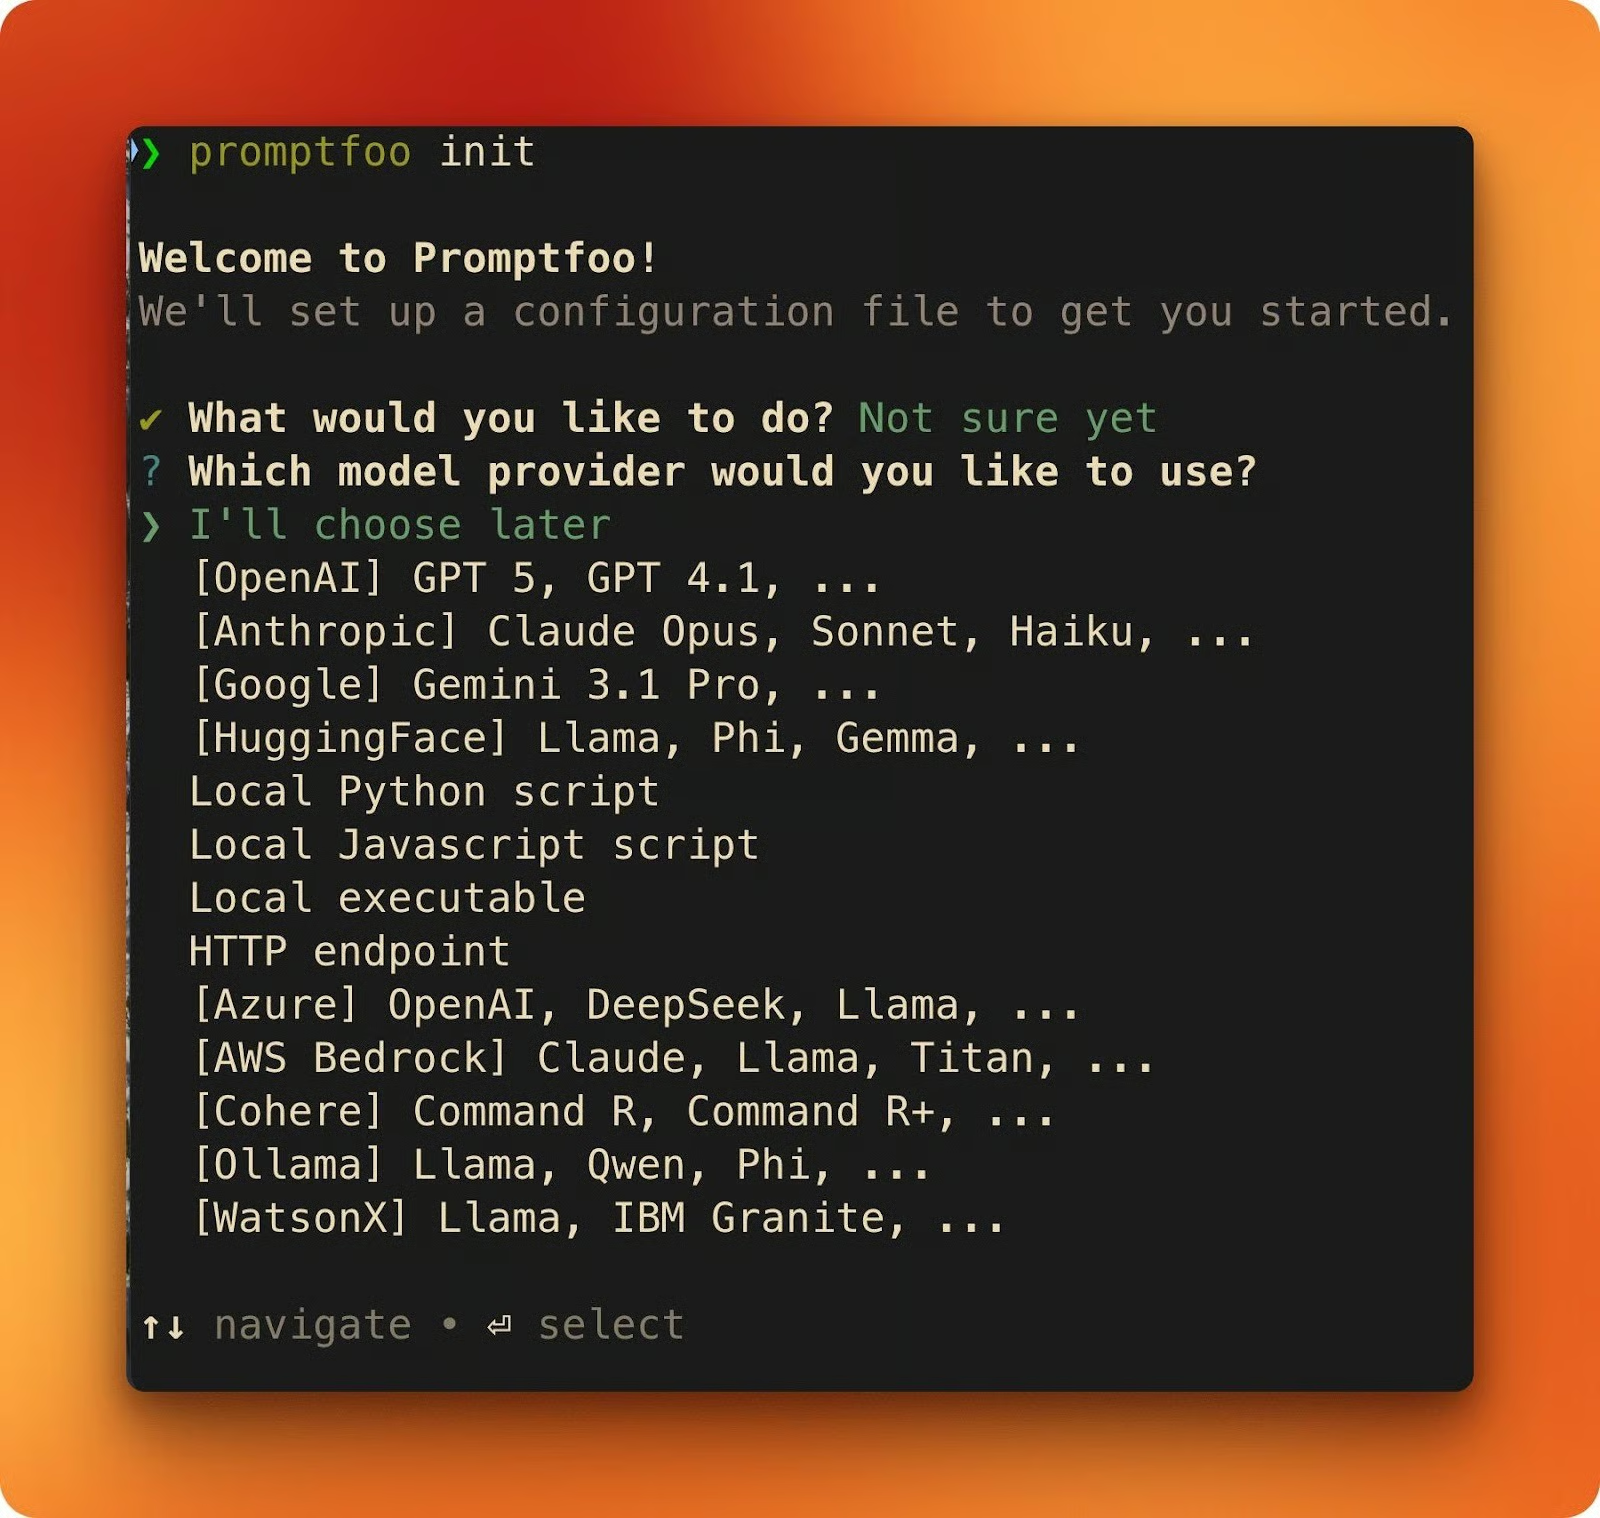
Saat selesai, Anda akan memiliki dua file: contoh promptfooconfig.yaml dan README.md.
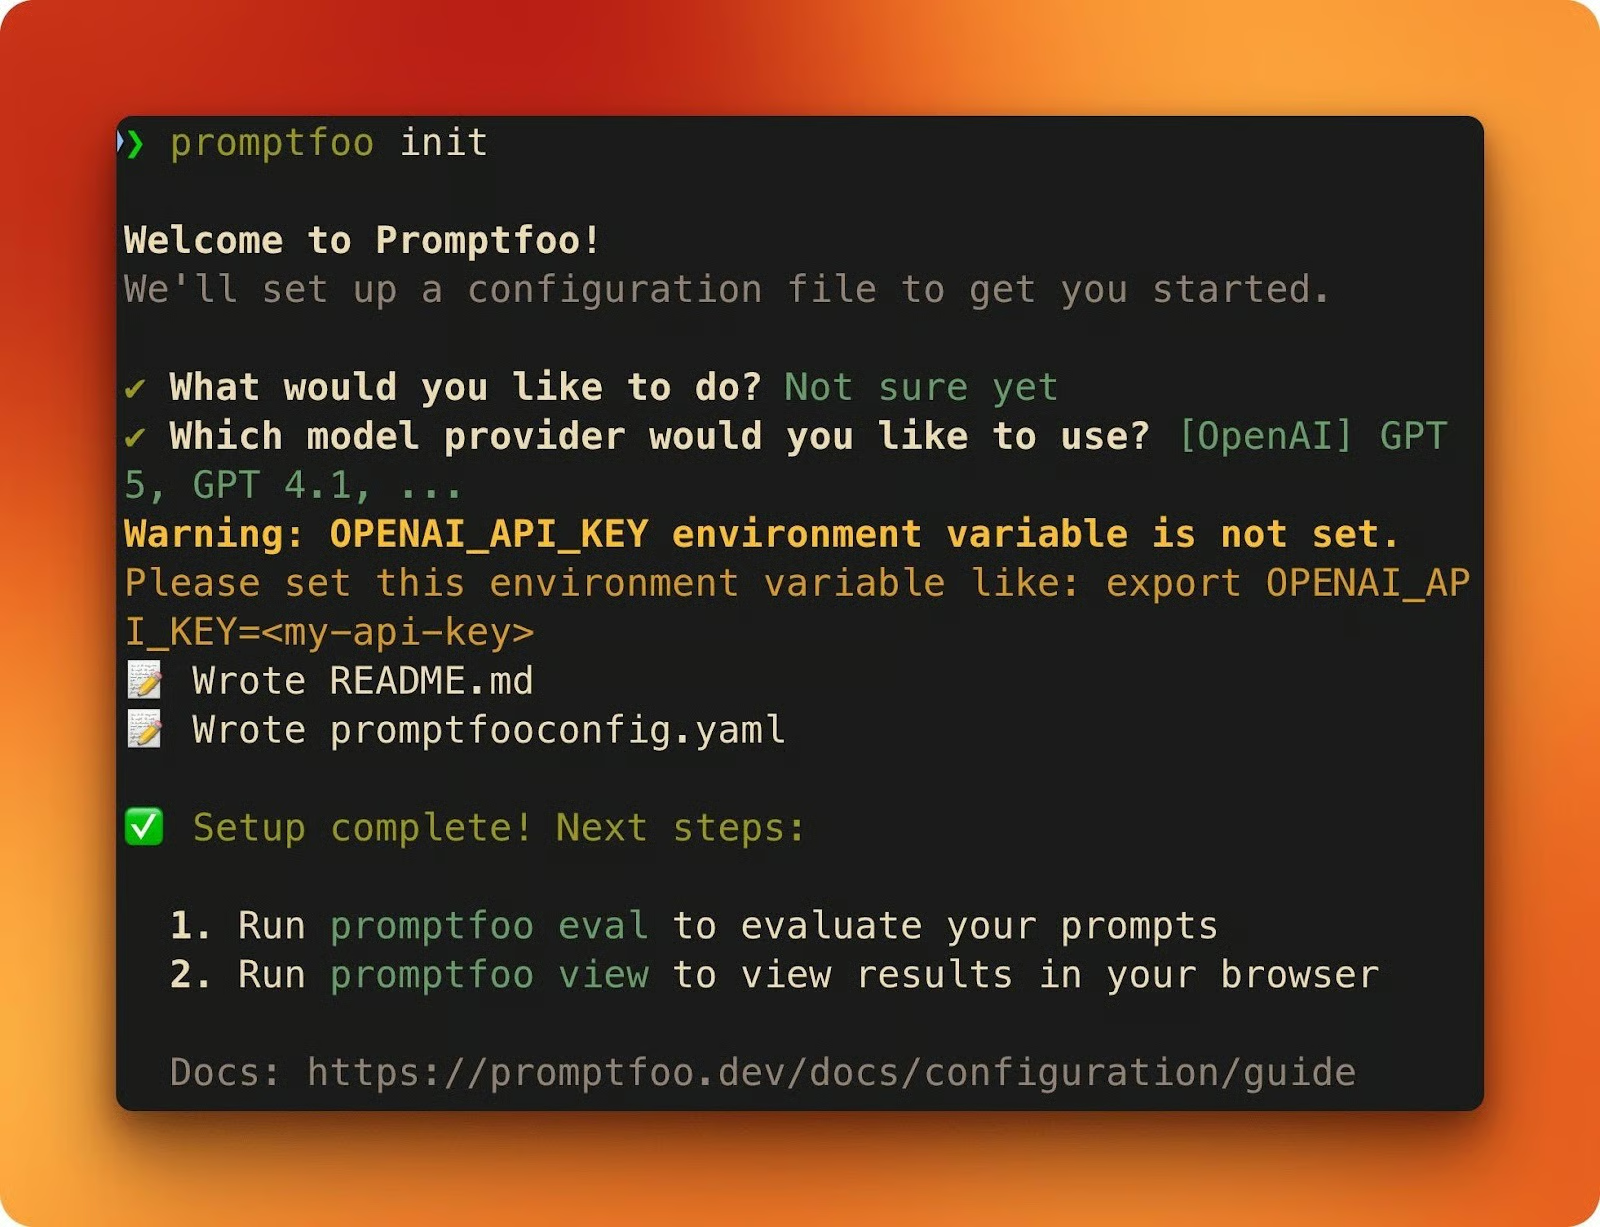
Selanjutnya, atur kunci API Anda. Anda memerlukan setidaknya satu untuk menjalankan evaluasi (punya keduanya agar bisa mengikuti tutorial ini):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Jika Anda hanya menetapkan ANTHROPIC_API_KEY dan melewati OpenAI, Promptfoo secara otomatis menggunakan Claude sebagai penyedia penilaian untuk asersi berbantuan model seperti llm-rubric.
Buka promptfooconfig.yaml yang dihasilkan. Setiap konfigurasi Promptfoo memiliki tiga blok bangunan:
prompts adalah tempat templat prompt Anda berada. Placeholder kurung ganda seperti {{variable}} diisi dari setiap kasus uji.
providers mencantumkan model yang ingin Anda uji.
tests mendefinisikan input dan asersi yang menentukan apakah setiap output lolos atau gagal.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Konfigurasi contoh ini adalah titik awal. Bagian berikut menggantinya dengan evaluasi nyata dan menjelaskan struktur YAML secara mendalam.
Berikut tugasnya: diberi butir-butir poin dan nada (santai, formal, atau mendesak), tulis sebuah email. Anda akan membangun evaluasi yang menguji ini di dua model.
Konfigurasi lengkap tersedia sebagai Gist jika Anda ingin melihat semuanya sekaligus. Kita akan membangunnya sedikit demi sedikit di bawah ini.
Hapus contoh yang dihasilkan dan buat promptfooconfig.yaml baru. Mulailah dengan prompt dan penyedia:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
Templat prompt memiliki dua placeholder: {{bullet_points}} dan {{tone}}. Setiap kasus uji mengisinya dengan nilai berbeda. Bidang label pada setiap penyedia memberi Anda header kolom yang mudah dibaca di tampilan hasil alih-alih ID model mentah.
Selanjutnya, tambahkan blok defaultTest. Asersi di dalam defaultTest berlaku otomatis untuk setiap kasus uji, sehingga Anda tidak mengulanginya:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Ini menggagalkan respons yang lebih lambat dari 30 detik. Model frontier seperti GPT-5 bisa membutuhkan 10–20 detik per permintaan karena token penalaran, jadi ambang batas perlu ruang. Anda menetapkannya sekali, dan itu mencakup setiap tes.
Sekarang tambahkan kasus uji. Masing-masing menyediakan input berbeda dan asersinya sendiri:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Setiap kasus uji memasangkan dua jenis asersi.
icontains adalah pemeriksaan string sederhana: apakah output menyertakan "mockups," tidak peka huruf besar/kecil? Ini cepat, gratis, dan tidak memanggil API apa pun.
llm-rubric mengirim output ke LLM lain dan memintanya menilai respons terhadap rubrik Anda. Ini memakan token, tetapi menangkap hal-hal yang tidak bisa dilakukan pencocokan string, seperti apakah sebuah email benar-benar terdengar santai.
Jalankan evaluasi:
promptfoo evalLalu buka hasilnya di browser Anda:
promptfoo view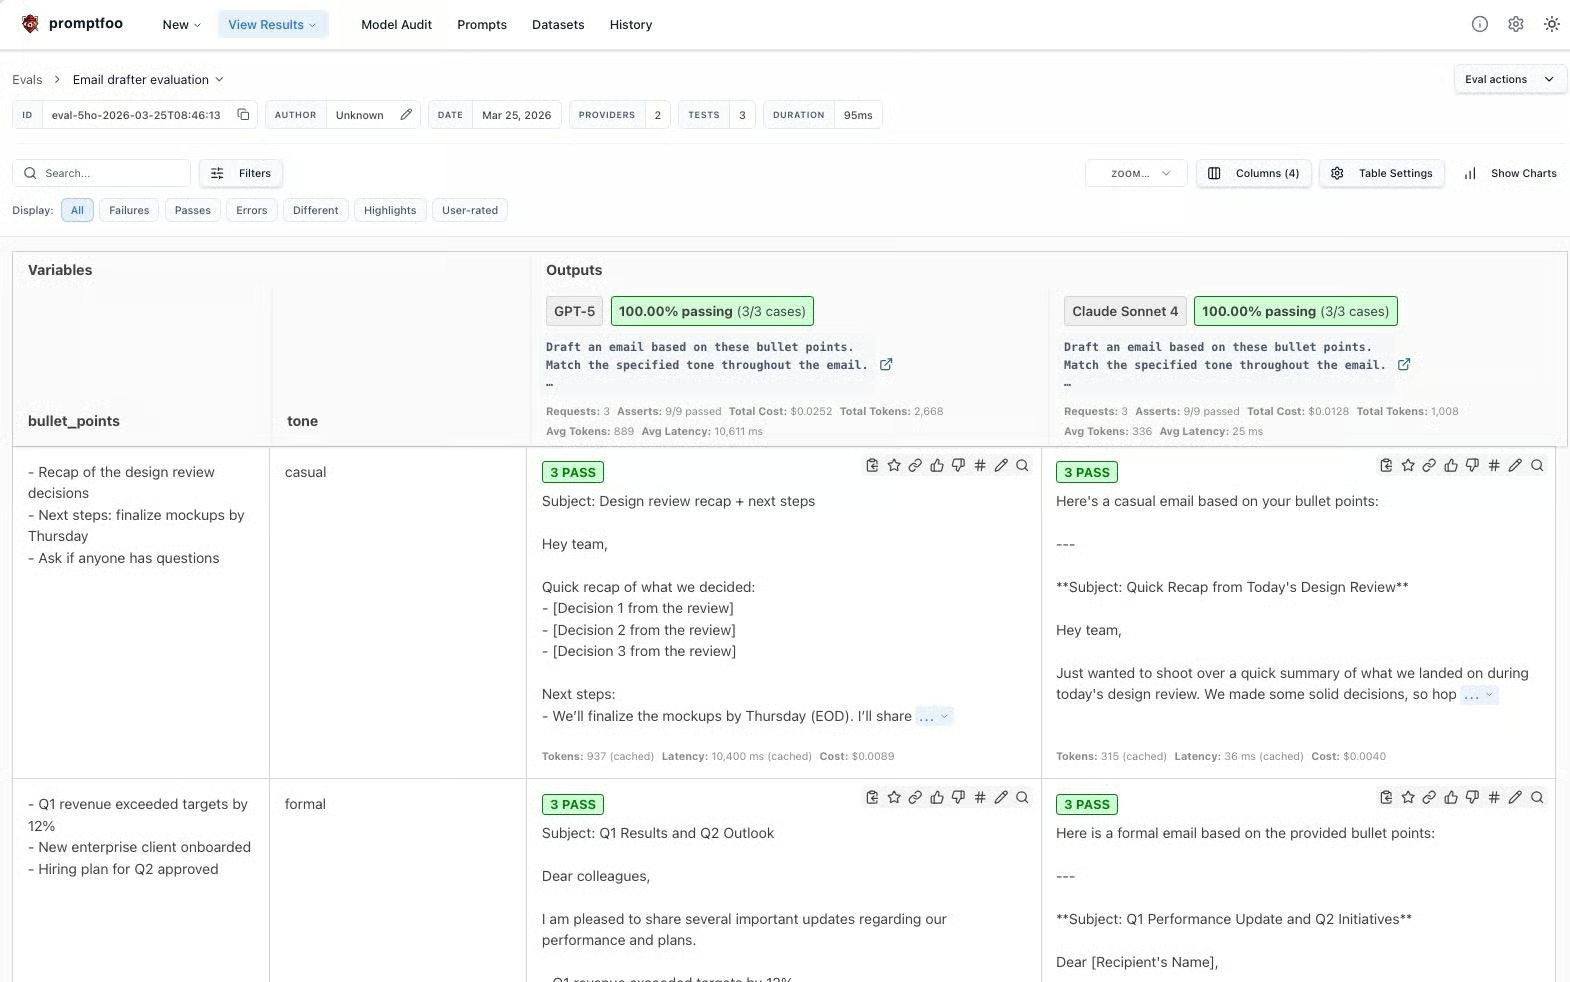
UI web menampilkan penyedia sebagai kolom dan kasus uji sebagai baris. Setiap sel menunjukkan lolos/gagal untuk setiap asersi, dan Anda bisa mengeklik sel mana pun untuk melihat output lengkap dan detail penilaian.
Promptfoo menyimpan cache respons API ke disk secara default (TTL 14 hari), jadi menjalankan ulang evaluasi yang sama tidak memakan biaya. Gunakan --no-cache ketika Anda menginginkan respons baru.
Evaluasi pertama menggunakan icontains dan llm-rubric. Itu dua dari banyak jenis asersi yang didukung Promptfoo. Bagian ini membahas kategori utama, dan kita akan terus menambahkan asersi ke konfigurasi penulis email seiring berjalan.
Jenis ini berjalan lokal, gratis, dan mengembalikan hasil seketika.
|
Jenis |
Apa yang diperiksa |
|
|
Output menyertakan substring (peka huruf besar/kecil atau tidak) |
|
|
Output cocok dengan pola (tangkap |
|
|
Output tidak menyertakan sesuatu (artefak templat, penolakan, teks placeholder) |
|
|
Respons tiba di bawah N milidetik |
|
|
Biaya respons kurang dari $X |
Anda sudah menggunakan icontains dan latency. Mari tambahkan not-contains ke kasus uji santai. Jika model secara default cenderung bahasa formal, ia mungkin mulai dengan "Dear" alih-alih sesuatu yang santai seperti "Hey." Menangkap itu cukup satu baris:
- type: not-contains
  value: \"Dear\"
Tambahkan ini ke daftar assert kasus uji santai dan jalankan ulang. Keduanya seharusnya lolos: GPT-5 sering membuka dengan "Hey team," dan Claude Sonnet 4 juga demikian. Jika salah satunya mulai dengan "Dear Colleagues," asersi ini akan menandainya seketika.
Setiap jenis asersi juga mendukung prefiks not-: not-regex, not-equals, dan seterusnya.
Jenis ini memakan token, tetapi bisa menilai hal-hal yang tidak bisa dilakukan pencocokan string. Anda sudah menggunakan llm-rubric pada evaluasi pertama. Rubrik yang Anda tulis menentukan kualitasnya.
Rubrik yang samar seperti "Email terdengar profesional" tidak memberi penilai informasi berguna. Rubrik yang spesifik memberi sesuatu untuk diukur:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
Saat Anda menjalankan ulang evaluasi dengan rubrik ini, output penilai juga menjadi spesifik:
Semakin spesifik rubrik Anda, semakin konsisten dan berguna penilaiannya.
Promptfoo juga menyediakan answer-relevance (apakah output menjawab pertanyaan?) dan similar (kemiripan kosinus terhadap referensi melalui embedding), keduanya berguna untuk RAG dan aplikasi pencarian.
Saat tipe bawaan tidak mencakup logika Anda, tulis sendiri. Untuk penulis email, Anda mungkin ingin memeriksa agar output tetap dalam panjang yang wajar. Berikut asersi inline yang lolos jika email berada antara 50 dan 200 kata:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Tambahkan ini ke kasus uji santai dan jalankan ulang. Pada percobaan saya, keduanya lolos: GPT-5 di 54 kata, Claude Sonnet 4 di 187. Namun ingat asersi ini untuk bagian berikutnya, karena tidak lolos di semua tempat.
Untuk pemeriksaan yang lebih kompleks, letakkan logika di file terpisah:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
Rujuk di konfigurasi Anda dengan type: python dan value: file://assert_length.py. Bidang reason muncul di UI hasil, sehingga Anda bisa melihat persis mengapa tes lolos atau gagal.
Berikut rupa kegagalan nyata.
Tambahkan asersi jumlah kata Python ke ketiga kasus uji dan jalankan evaluasi penuh di kedua model. Dalam kasus saya, lima dari enam kombinasi lolos. Claude Sonnet 4.6 tidak lolos pada kasus uji mendesak (ini bisa saja berbeda di mesin Anda, mengingat perilaku LLM yang tidak deterministik).
Pada percobaan itu, output berjumlah 207 kata, tujuh di atas batas. llm-rubric justru lolos, menegaskan email menggunakan "bahasa yang mendesak dan langsung" dengan "tindakan yang jelas." icontains juga lolos, karena "Friday" ada di output.
Namun asersi jumlah kata Python gagal. Claude menambahkan meta-komentar ("Here is a draft email based on your bullet points with an urgent tone:") sebelum email sebenarnya, mendorong jumlah kata melampaui 200.
Ini jenis hal yang tidak akan Anda tangkap hanya dengan melihat sekilas. Emailnya sendiri terbaca baik: nada tepat, konten tepat. Namun output terlalu panjang karena model menambahkan teks yang bukan bagian dari email. Satu asersi menangkapnya, dan evaluasi menandai seluruh kasus uji.
Perbaikannya bisa dua arah: sesuaikan prompt agar model tidak menyertakan pembuka, atau naikkan batas kata. Apa pun itu, Anda jalankan ulang evaluasi dan cek apakah lolos.
Pada titik ini, kasus uji santai memiliki empat asersi: icontains, not-contains, llm-rubric, dan jumlah kata Python. Tidak semuanya sama penting. Bidang weight memungkinkan Anda mengekspresikannya:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
Skor setiap asersi dikalikan dengan bobotnya, dan tes menghitung rata-rata berbobot. threshold menetapkan skor minimum untuk lolos. Di sini, rubrik nada dihitung dua kali lipat dari pemeriksaan kata kunci, dan jumlah kata dihitung setengahnya.
Menjalankan ulang kasus uji santai dengan bobot ini, kedua model mendapat skor 1,0 dan lolos. Namun jika llm-rubric gagal (bobot 2) sementara jumlah kata lolos (bobot 0,5), skor berbobot akan turun di bawah ambang 0,7, dan tes akan gagal. Bobot memungkinkan Anda memberi tahu Promptfoo apa yang paling Anda pedulikan.
Konfigurasi sudah memiliki dua penyedia, jadi promptfoo eval menguji GPT-5 dan Claude Sonnet 4 dalam satu kali jalan. Buka promptfoo view dan Anda melihatnya sebagai kolom terpisah di hasil, dengan setiap kasus uji diberi skor secara independen untuk setiap model.
Dalam percobaan evaluasi kita, GPT-5 meloloskan semua enam asersi di tiga kasus uji. Claude Sonnet 4 meloloskan lima tetapi gagal pada jumlah kata untuk email mendesak.
Itu jenis perbedaan yang tidak akan Anda sadari dengan mencoba beberapa prompt secara manual, tetapi muncul seketika di grid. Anda membandingkan skor terhadap asersi yang sama pada input yang sama, bukan ingatan Anda tentang model mana yang "terasa lebih baik" saat terakhir kali Anda mencobanya.
Namun output LLM tidak deterministik. Prompt yang sama dapat menghasilkan hasil berbeda pada eksekusi berurutan, dan satu kali jalan tidak akan memberi tahu Anda apakah sebuah model andal bagus atau hanya kebetulan. Flag --repeat mengakomodasi hal ini:
promptfoo eval --repeat 3Ini menjalankan setiap kasus uji tiga kali per penyedia. Jika sebuah model meloloskan asersi nada dua kali tetapi gagal pada percobaan ketiga, itu sinyal keandalan yang akan Anda lewatkan jika hanya sekali jalan.
Menjalankan evaluasi secara lokal berfungsi selama pengembangan, tetapi bergantung pada siapa pun yang mengubah prompt untuk ingat menjalankannya. Promptfoo memiliki GitHub Action resmi yang menghapus ketergantungan itu dengan menjalankan suite evaluasi Anda pada setiap pull request dan memposting hasilnya sebagai komentar.
Untuk menyiapkannya, buat file workflow di repo Anda:
mkdir -p .github/workflowsLalu buat .github/workflows/prompt-eval.yml dengan konten berikut:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Sebelum ini berfungsi, Anda perlu menambahkan OPENAI_API_KEY (dan opsional ANTHROPIC_API_KEY) sebagai secret repositori di repo GitHub Anda di Settings > Secrets and variables > Actions.
Filter paths berarti aksi hanya terpicu saat seseorang mengubah file di prompts/. Langkah checkout diperlukan karena aksi menggunakan git secara internal untuk membedakan file prompt antar cabang. Aksi menjalankan seluruh suite evaluasi dan memposting komentar PR berisi hasil dan tautan ke penampil web.
Untuk kontrol lebih atas logika lolos/gagal, Anda dapat mengurai output JSON secara langsung:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
Alur kerja dari sini:
Perubahan prompt mendapatkan perlakuan uji-sebelum-merge yang sama seperti perubahan kode.
Penulis email dari pembuka masih punya masalah nada, tetapi kini ada tes yang mendeteksinya sebelum pengguna melakukannya. Anda mulai dengan file YAML kosong dan berakhir dengan suite evaluasi yang berjalan di dua model dalam CI.
Pendekatan yang sama berlaku untuk fitur LLM apa pun yang Anda bangun, apakah itu chatbot, peringkas, atau pipeline klasifikasi. Selama Anda bisa menulis asersi untuk mendefinisikan "output yang baik", Anda bisa mengujinya secara otomatis alih-alih mengandalkannya pada pengamatan sekilas.
Saat siap melangkah lebih jauh, dokumentasi Promptfoo membahas beberapa area yang layak dilihat:
Red teaming: promptfoo redteam run memindai injeksi prompt dan jailbreak di puluhan plugin serangan
Penyedia Python kustom: Bungkus model internal atau endpoint fine-tuned apa pun dengan file://my_provider.py
Data uji CSV: Skalakan suite uji Anda dengan file://tests.csv ketika YAML inline menjadi merepotkan
Jika Anda ingin meningkatkan prompt yang sedang diuji, kursus Prompt Engineering with the OpenAI API kami mencakup banyak teknik penting yang dapat Anda terapkan pada berbagai bentuk pengembangan AI.
Kursus Prompt Engineering
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt





