
Kurs
So funktioniert Prompt Engineering
1 Std.
232.4K
Die meisten LLM-Features werden gleich getestet: ein paar Eingaben probieren, Ergebnisse überfliegen, ausliefern.
Genau so hast du es mit einem E-Mail-Generator gemacht. Fünf Eingaben im Chatfenster, die Ausgaben sahen gut aus. Eine Woche später klingen die Hälfte deiner Mails im lockeren Ton, als wären sie von einer Konzernjuristin verfasst. Niemand hat es gemerkt, weil es keine Möglichkeit gab, es zu merken. Die Prompts haben sich geändert, aber deine fünf manuellen Tests sind nicht mitgezogen.
Promptfoo ist ein Open-Source-CLI-Tool, das diesen Prozess durch strukturierte, reproduzierbare Evaluierungen ersetzt. Du definierst, wie gute Ausgaben aussehen, wählst deine Modelle und lässt jede Kombination automatisch laufen.
OpenAI hat das Projekt im März 2026 übernommen, und es bleibt unter MIT-Lizenz mit Support für Dutzende Provider. Über 350.000 Entwickler nutzen es, darunter Teams in mehr als 25% der Fortune-500-Unternehmen.
Dieses Tutorial führt dich durch das Setup von Promptfoo und baut Schritt für Schritt deine erste Eval-Suite. Wir nutzen einen E-Mail-Generator als durchgehendes Beispiel, testen ihn mit GPT-5 und Claude Sonnet 4.6 und binden zum Schluss alles in GitHub Actions ein.
Bevor wir ins Tool einsteigen, brauchst du ein Grundverständnis, wie LLM-Tests funktionieren. Es ist anders als das Testen von normalem Code.
Bei einer Funktion kennst du das Muster: Eingabe rein, prüfen, ob die Ausgabe exakt dem Erwarteten entspricht. LLM-Ausgaben funktionieren so nicht. Derselbe Prompt kann bei jedem Lauf einen anderen Text erzeugen, also kannst du nicht auf exakte Übereinstimmung testen.
Stattdessen prüfst du Eigenschaften der Ausgabe:
Genau das macht eine LLM-Eval. Sie führt deinen Prompt über eine Menge von Eingaben aus und prüft jede Ausgabe gegen Regeln, die du festlegst. Denk daran wie an eine Testsuite für deine Prompts statt für deinen Code.
Vier Begriffe tauchen im Artikel immer wieder auf:
Ohne Assertions bist du zurück bei „Sieht für mich gut aus“. Mit ihnen hast du eine Definition von „korrekt“, die jedes Mal gleich läuft.
Jetzt, wo du weißt, was eine Eval ist, hier ist, was Promptfoo damit macht.
Du gibst Promptfoo drei Dinge:
Es läuft jeden Prompt gegen jedes Modell für jeden Testfall und bewertet die Ergebnisse. Ein Befehl, promptfoo eval, startet alles.
Angenommen, du hast einen E-Mail-Prompt, zwei Modelle (GPT-5 und Claude Sonnet 4) und drei Testfälle (locker, formell, dringend). Promptfoo läuft alle sechs Kombinationen und zeigt dir, was bestanden hat und was nicht. Kein manuelles Durchklicken mehr.
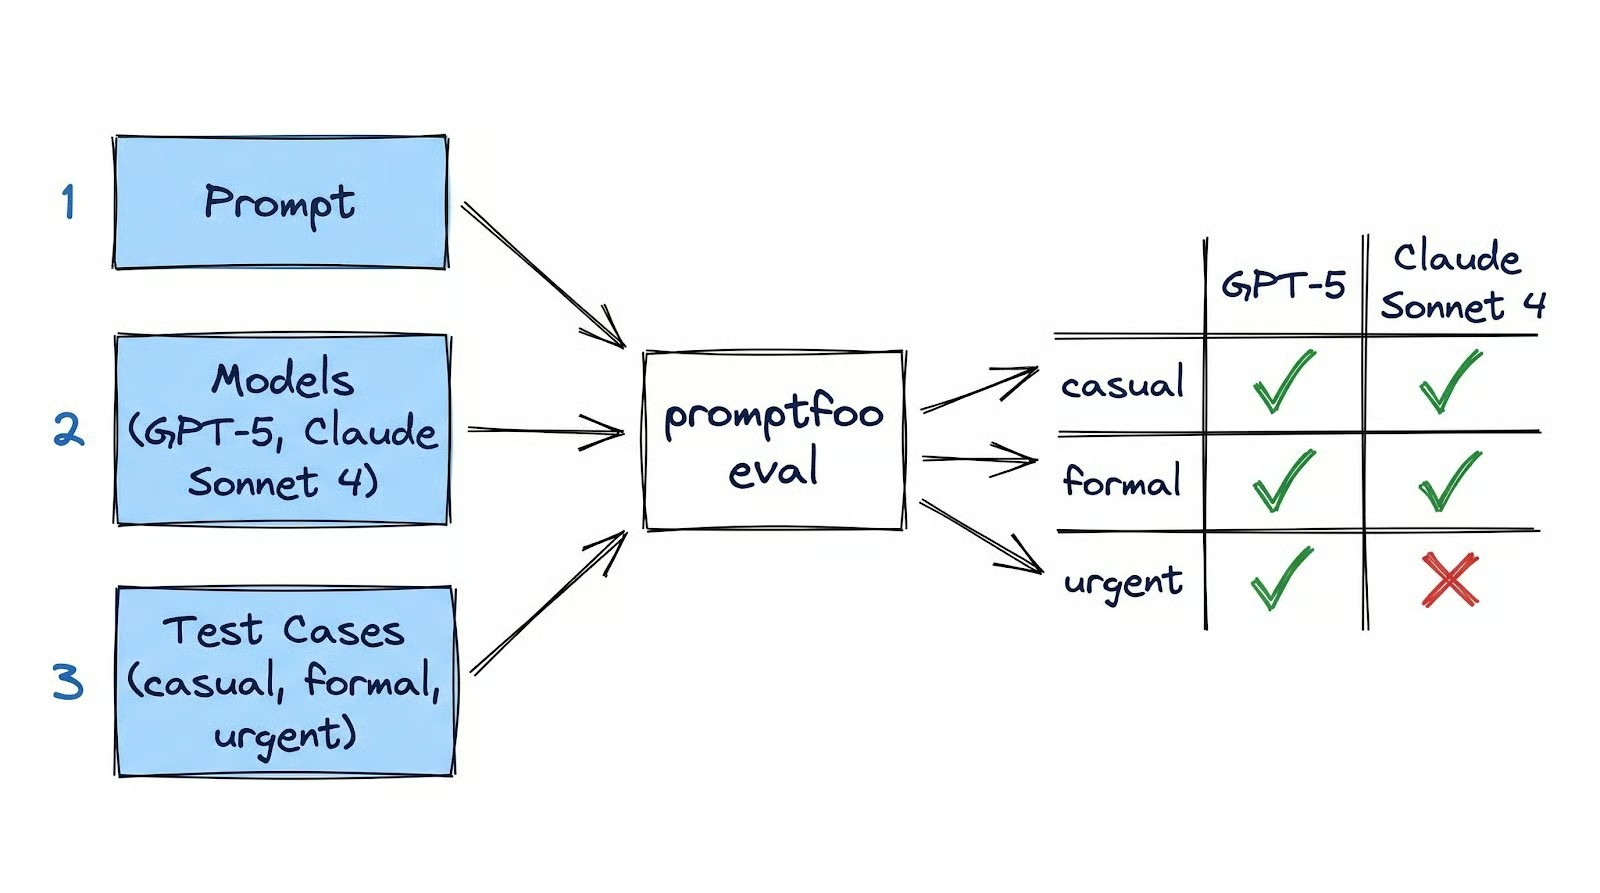
Die gesamte Eval liegt in einer einzigen YAML-Datei namens promptfooconfig.yaml, die du zusammen mit deinem Code versionierst. Promptfoo läuft auf deiner Maschine: Konfiguration, Ergebnisse und Cache bleiben lokal. Die einzigen externen Aufrufe gehen an Modell-APIs wie OpenAI oder Anthropic – die würdest du ohnehin machen, mit oder ohne Promptfoo.
Andere Tools in diesem Bereich gibt es, etwa DeepEval (Python-nativ, pytest-Stil), LangSmith (Produktions-Monitoring für LangChain) und Braintrust (Team-Dashboards). Promptfoo ist der beste Einstieg, weil es kostenlos ist, lokal läuft und dich schneller als alle anderen von null zur funktionierenden Eval bringt.
Installiere Promptfoo global und initialisiere ein neues Projekt:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
Der Befehl init führt dich interaktiv durch das Setup. Er fragt, was du tun möchtest (wähle "Not sure yet") und welchen Modellprovider du nutzen willst (wähle "[OpenAI] GPT 5, GPT 4.1, ...").
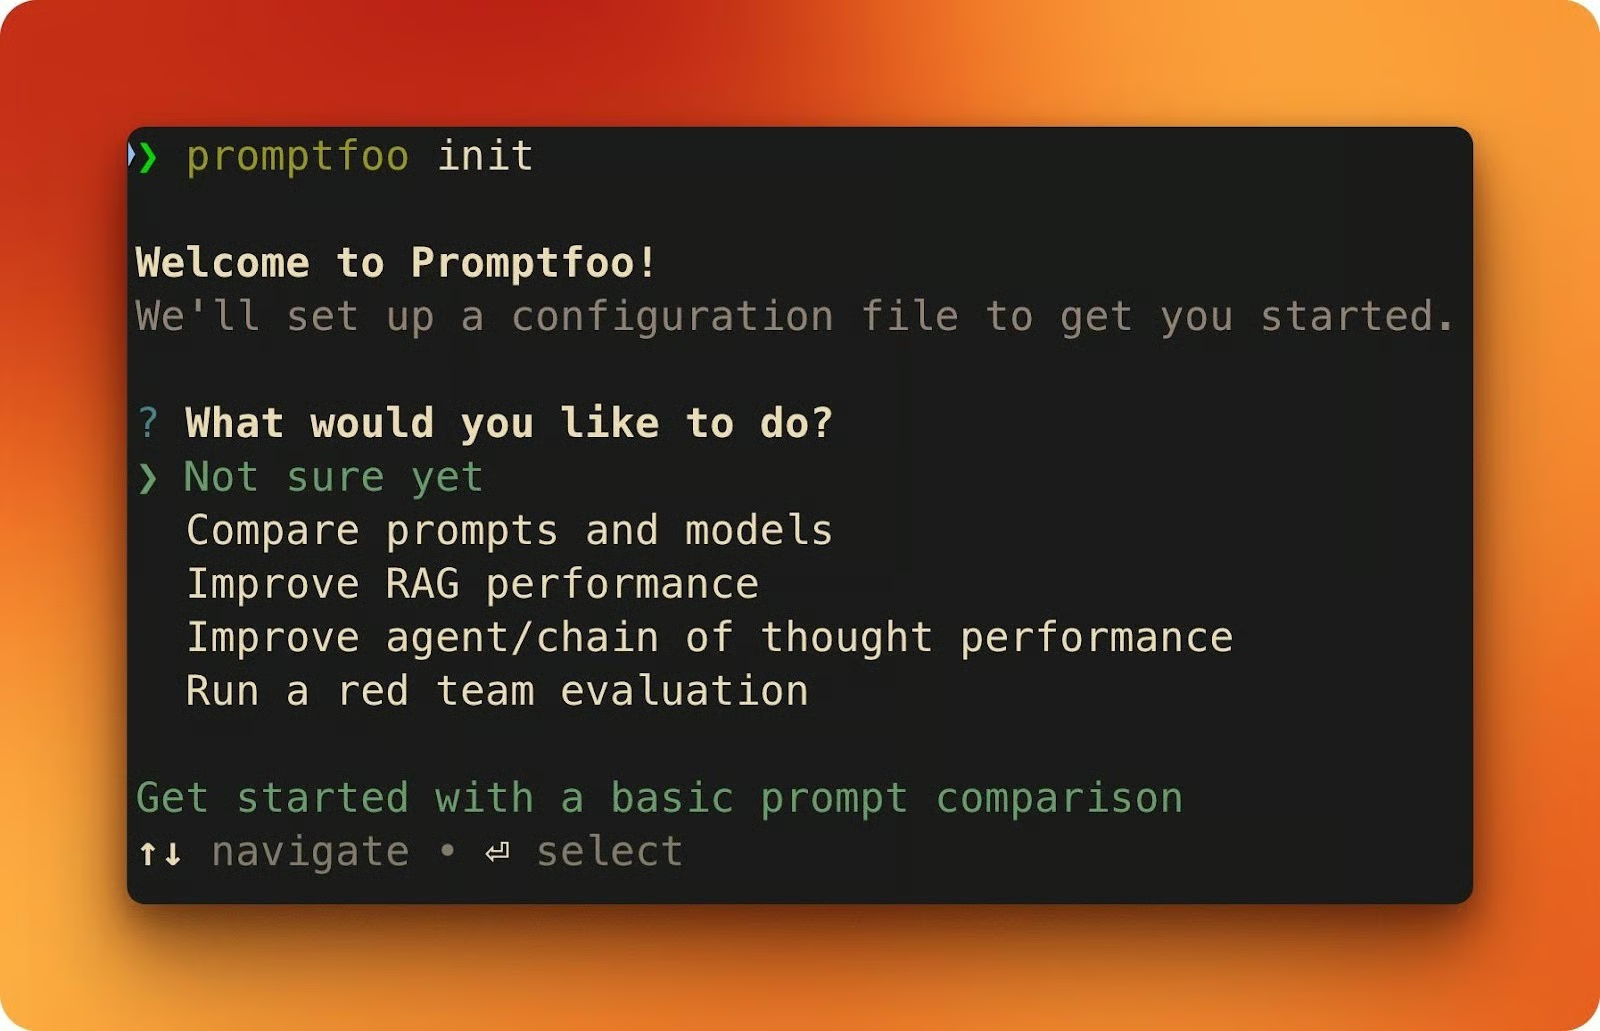
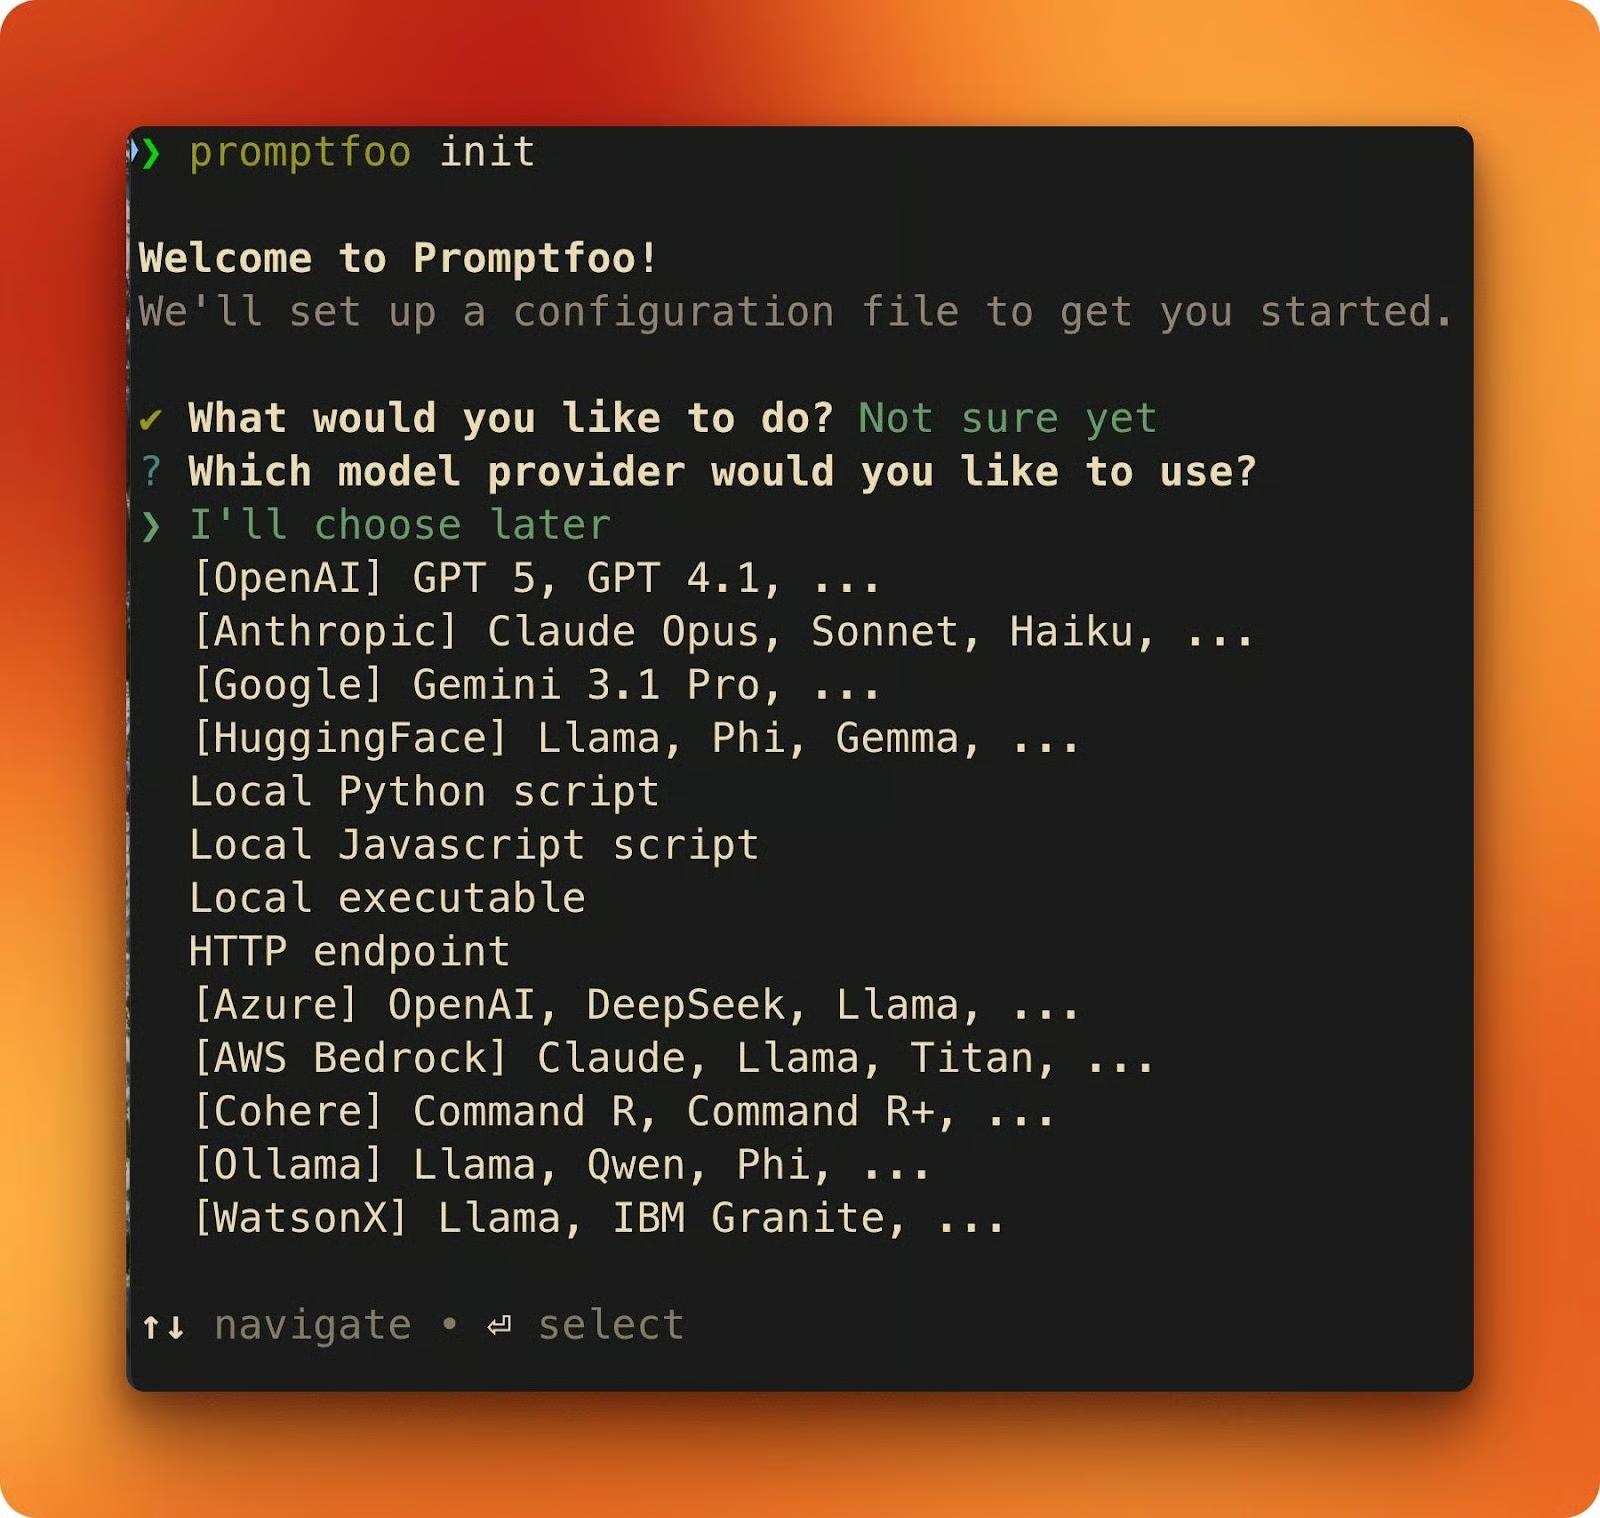
Nach Abschluss hast du zwei Dateien: ein Beispiel für promptfooconfig.yaml und ein README.md.
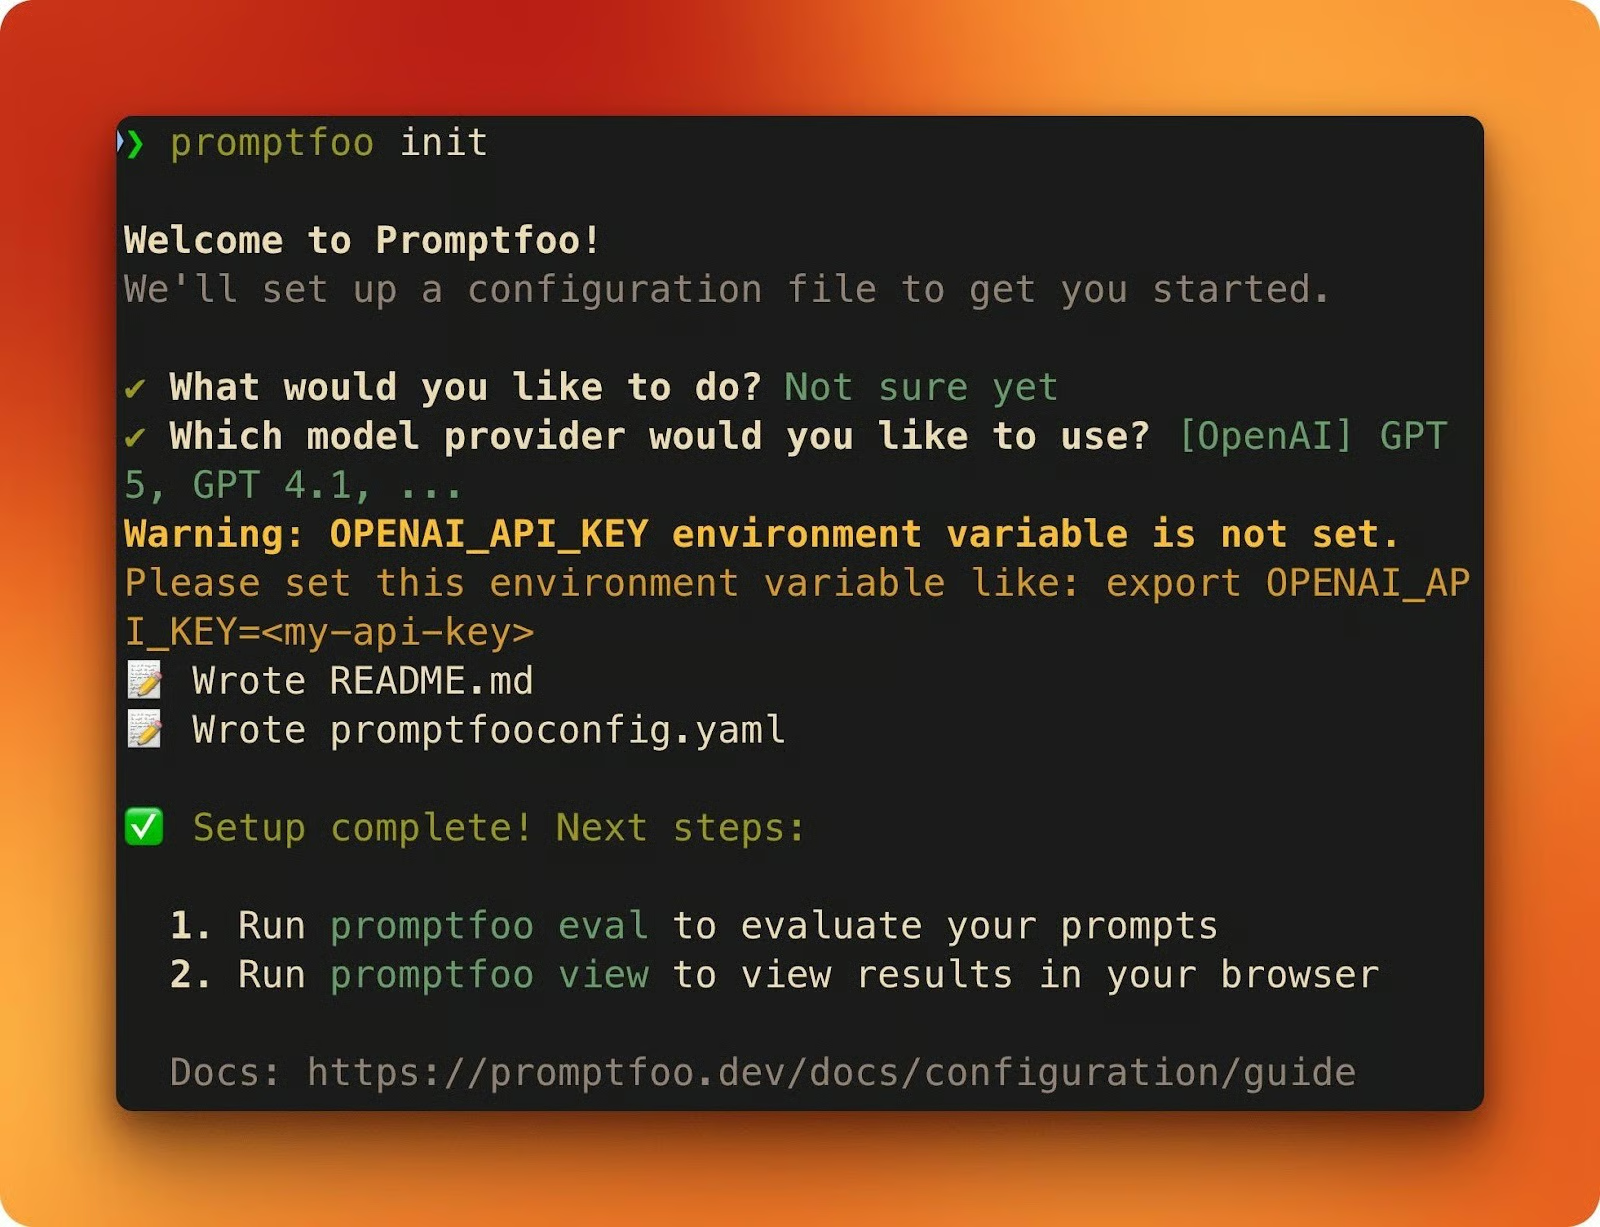
Als Nächstes setzt du deine API-Keys. Du brauchst mindestens einen, um Evals zu starten (für dieses Tutorial idealerweise beide):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Wenn du nur ANTHROPIC_API_KEY setzt und OpenAI auslässt, nutzt Promptfoo automatisch Claude als Bewertungsmodell für modellgestützte Assertions wie llm-rubric.
Öffne die generierte promptfooconfig.yaml. Jede Promptfoo-Konfiguration hat drei Bausteine:
prompts ist der Platz für deine Prompt-Templates. Platzhalter mit doppelten Klammern wie {{variable}} werden pro Testfall befüllt.
providers listet die Modelle, gegen die du testen willst.
tests definiert die Eingaben und die Assertions, die entscheiden, ob eine Ausgabe besteht oder nicht.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Diese Beispielkonfiguration ist ein Startpunkt. Im nächsten Abschnitt ersetzen wir sie durch eine echte Evaluierung und erklären die YAML-Struktur im Detail.
Die Aufgabe: Aus Stichpunkten und einem Ton (locker, formell oder dringend) eine E-Mail schreiben. Du baust eine Eval, die das über zwei Modelle testet.
Die komplette Konfiguration gibt es als Gist, wenn du alles auf einmal sehen willst. Unten bauen wir sie Schritt für Schritt.
Lösche das generierte Beispiel und lege eine neue promptfooconfig.yaml an. Starte mit Prompt und Providern:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
Das Prompt-Template hat zwei Platzhalter: {{bullet_points}} und {{tone}}. Jeder Testfall füllt diese mit anderen Werten. Das Feld label sorgt für lesbare Spaltenüberschriften in den Ergebnissen statt roher Modell-IDs.
Füge als Nächstes einen defaultTest-Block hinzu. Assertions in defaultTest gelten automatisch für jeden Testfall, damit du sie nicht wiederholst:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Das lässt jede Antwort durchfallen, die länger als 30 Sekunden braucht. Spitzenmodelle wie GPT-5 benötigen wegen Reasoning-Tokens teils 10–20 Sekunden pro Anfrage, daher braucht der Grenzwert etwas Luft. Einmal gesetzt, gilt er für alle Tests.
Jetzt kommen die Testfälle. Jeder liefert andere Eingaben und eigene Assertions:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Jeder Testfall kombiniert zwei Assertion-Typen.
icontains ist ein einfacher String-Check: Stand „mockups“ in der Ausgabe, ohne Beachtung der Groß-/Kleinschreibung? Schnell, kostenlos und ohne API-Call.
llm-rubric schickt die Ausgabe an ein weiteres LLM und lässt sie gegen deinen Rubric bewerten. Das kostet Tokens, fängt aber Dinge ab, die String-Matching nicht kann – etwa ob eine E-Mail wirklich locker klingt.
Starte die Evaluierung:
promptfoo evalÖffne anschließend die Ergebnisse im Browser:
promptfoo view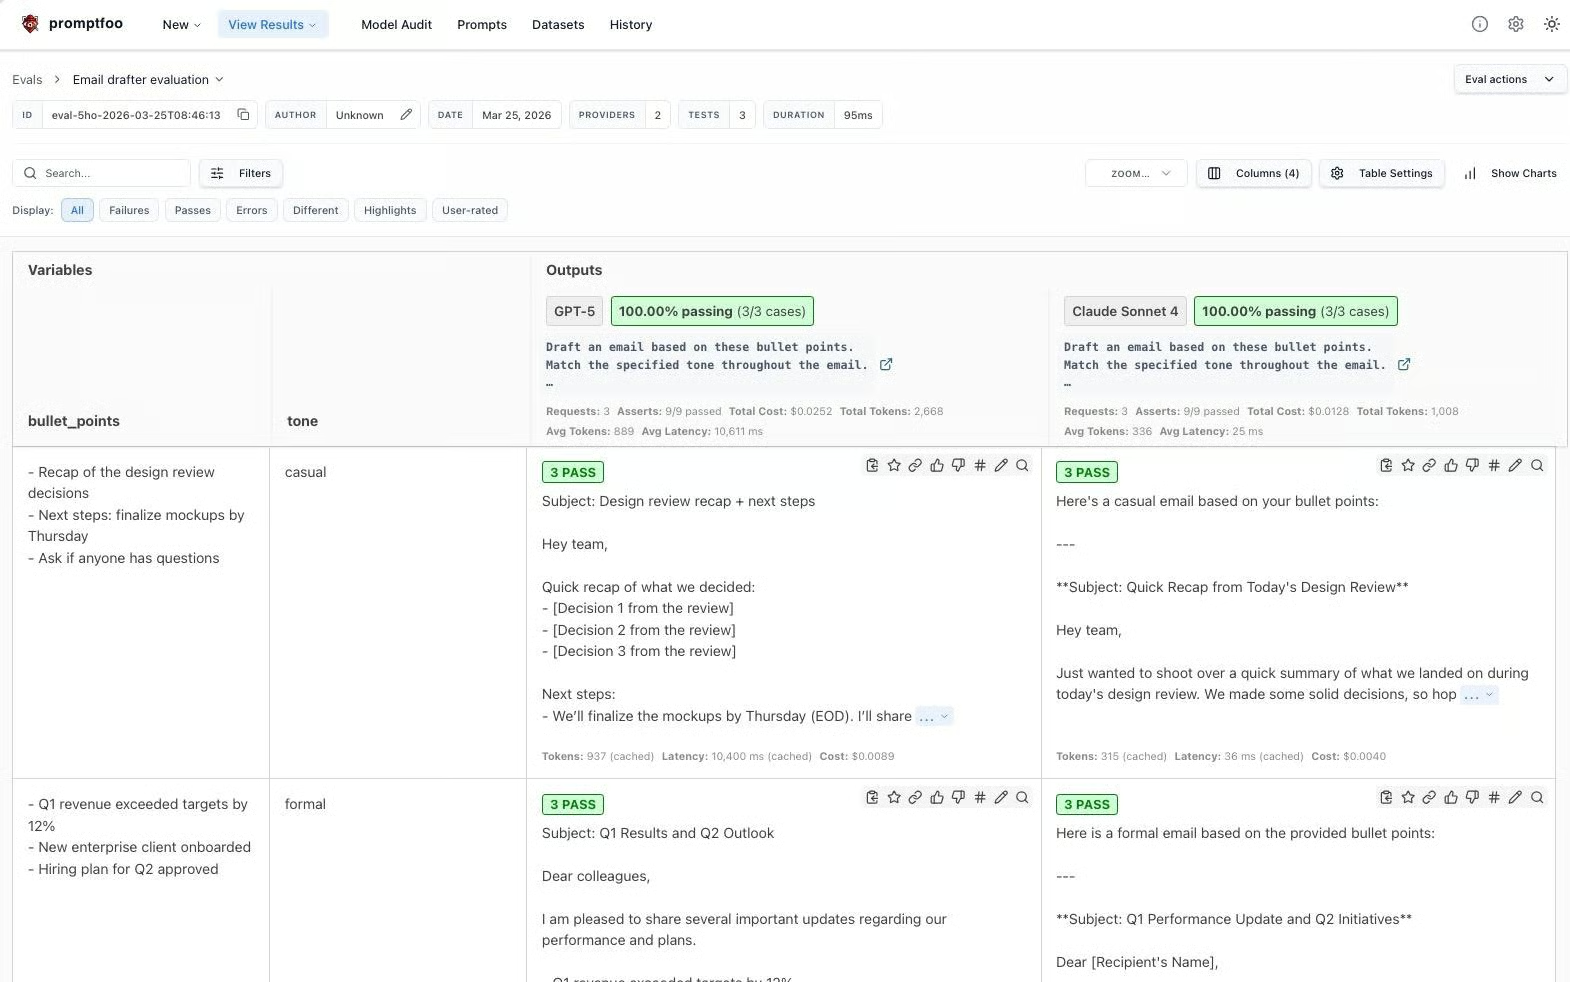
Die Web-UI zeigt Provider als Spalten und Testfälle als Zeilen. Jede Zelle zeigt Bestehen/Nichtbestehen pro Assertion, und du kannst in jede Zelle klicken, um die vollständige Ausgabe und Bewertungsdetails zu sehen.
Promptfoo cached API-Antworten standardmäßig auf der Platte (TTL 14 Tage), daher kostet das erneute Ausführen derselben Eval nichts. Nutze --no-cache, wenn du frische Antworten willst.
In der ersten Eval hast du icontains und llm-rubric verwendet. Das sind zwei von vielen unterstützten Assertion-Typen. In diesem Abschnitt gehen wir durch die Hauptkategorien und erweitern die E-Mail-Config Schritt für Schritt.
Diese laufen lokal, kosten nichts und liefern sofort Ergebnisse.
|
Typ |
Was geprüft wird |
|
|
Ausgabe enthält eine Teilzeichenkette (groß-/kleinsensitiv oder nicht) |
|
|
Ausgabe entspricht einem Muster (nicht befüllte |
|
|
Ausgabe schließt etwas aus (Template-Artefakte, Verweigerungen, Platzhaltertext) |
|
|
Antwort kommt unter N Millisekunden |
|
|
Antwort kostet weniger als $X |
Du hast bereits icontains und latency verwendet. Fügen wir not-contains zum lockeren Testfall hinzu. Wenn das Modell standardmäßig formell schreibt, startet es vielleicht mit „Dear“ statt etwas Lockerem wie „Hey“. Das fängst du mit einer Zeile ab:
- type: not-contains
  value: \"Dear\"
Füge das zur assert-Liste des lockeren Testfalls hinzu und starte neu. Beide Modelle sollten bestehen: GPT-5 beginnt oft mit „Hey team,“ und Claude Sonnet 4 ebenfalls. Hätte eines mit „Dear Colleagues,“ begonnen, wäre die Assertion sofort angeschlagen.
Jeder Assertion-Typ unterstützt auch ein not--Präfix: not-regex, not-equals und so weiter.
Diese kosten Tokens, können aber Dinge beurteilen, die String-Matching nicht erfasst. Du hast llm-rubric bereits genutzt. Der Rubric-Text entscheidet über die Qualität.
Ein vager Rubric wie „Die E-Mail klingt professionell“ hilft der Bewertung wenig. Ein spezifischer Rubric liefert messbare Kriterien:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
Wenn du die Eval mit diesem Rubric neu laufen lässt, werden auch die Begründungen des Bewerters konkreter:
Je konkreter dein Rubric, desto konsistenter und hilfreicher wird die Bewertung.
Promptfoo bringt außerdem answer-relevance (hat die Antwort die Frage adressiert?) und similar (Kosinus-Ähnlichkeit gegen eine Referenz via Embeddings) mit – beides praktisch für RAG- und Suchanwendungen.
Wenn eingebaute Typen deine Logik nicht abdecken, schreib deine eigenen. Für den E-Mail-Generator willst du vielleicht prüfen, dass Ausgaben eine sinnvolle Länge haben. Hier ist eine Inline-Assertion, die besteht, wenn die E-Mail zwischen 50 und 200 Wörtern hat:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Füge das dem lockeren Testfall hinzu und starte neu. In meinem Lauf haben beide Modelle bestanden: GPT-5 lag bei 54 Wörtern, Claude Sonnet 4 bei 187. Behalte diese Assertion für den nächsten Abschnitt im Hinterkopf, denn sie hat nicht überall bestanden.
Für komplexere Checks lege die Logik in eine separate Datei:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
Binde sie in deiner Konfiguration mit type: python und value: file://assert_length.py ein. Das Feld reason erscheint in der UI, damit du siehst, warum ein Test bestanden oder nicht bestanden hat.
So sieht ein echter Fehlschlag aus.
Füge die Python-Wortzähl-Assertion zu allen drei Testfällen hinzu und lass die volle Eval über beide Modelle laufen. In meinem Fall haben fünf von sechs Kombinationen bestanden. Claude Sonnet 4.6 hat den Dringlichkeits-Testfall nicht bestanden (das kann auf deiner Maschine anders sein, da LLMs nicht deterministisch sind).
In diesem Lauf lag die Ausgabe bei 207 Wörtern, sieben über dem Limit. Die llm-rubric hat tatsächlich bestanden und bestätigt, dass die E-Mail „dringende, direkte Sprache“ mit „klaren Aktionen“ nutzte. icontains hat auch bestanden, da „Friday“ enthalten war.
Aber die Python-Wortzähl-Assertion ist durchgefallen. Claude hat Meta-Kommentar vorangestellt („Here is a draft email based on your bullet points with an urgent tone:“) und damit den Umfang über 200 Wörter geschoben.
Das ist genau der Fall, den man beim Überfliegen nicht bemerkt. Die E-Mail selbst war in Ordnung: richtiger Ton, richtige Inhalte. Aber die Ausgabe war zu lang, weil das Modell Text ergänzt hat, der nicht zur E-Mail gehörte. Eine Assertion hat es gefunden, und die Eval hat den ganzen Testfall markiert.
Die Lösung kann in zwei Richtungen gehen: Prompt anpassen und klar sagen, dass kein Vorspann erlaubt ist, oder das Wortlimit anheben. In jedem Fall: Eval neu laufen lassen und prüfen, dass sie besteht.
Im lockeren Testfall hast du nun vier Assertions: icontains, not-contains, llm-rubric und die Python-Wortzahl. Nicht alle sind gleich wichtig. Mit weight drückst du das aus:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
Der Score jeder Assertion wird mit ihrem Gewicht multipliziert, der Test bildet daraus einen gewichteten Durchschnitt. Der threshold legt den Mindestscore zum Bestehen fest. Hier zählt der Ton-Rubric doppelt so viel wie die Keyword-Checks, und die Wortzahl halb so viel.
Mit diesen Gewichten erreichen beide Modelle im lockeren Test 1,0 und bestehen. Wäre die llm-rubric (Gewicht 2) durchgefallen, während die Wortzahl (Gewicht 0,5) bestanden hätte, fiele der gewichtete Score unter die 0,7-Schwelle – der Test würde scheitern. Mit Gewichten sagst du Promptfoo, was dir wirklich am wichtigsten ist.
In der Config stehen schon zwei Provider, daher testet promptfoo eval GPT-5 und Claude Sonnet 4 in einem Durchlauf. In promptfoo view siehst du sie als separate Spalten, jeder Testfall wird pro Modell unabhängig bewertet.
In meinem Lauf hat GPT-5 alle sechs Assertions über die drei Testfälle bestanden. Claude Sonnet 4 hat fünf bestanden und ist bei der Wortzahl der dringenden E-Mail durchgefallen.
Solche Unterschiede würdest du beim manuellen Ausprobieren kaum bemerken – in der Matrix siehst du sie sofort. Du vergleichst Scores gegen dieselben Assertions auf denselben Inputs, nicht dein Bauchgefühl, welches Modell sich „besser angefühlt“ hat.
LLM-Ausgaben sind aber nicht deterministisch. Derselbe Prompt kann hintereinander verschiedene Ergebnisse liefern, und ein einzelner Durchlauf zeigt nicht, ob ein Modell zuverlässig gut ist oder nur Glück hatte. Das Flag --repeat hilft hier:
promptfoo eval --repeat 3Damit läuft jeder Testfall pro Provider dreimal. Wenn ein Modell den Ton zweimal trifft, beim dritten Lauf aber nicht, ist das ein Zuverlässigkeitssignal, das dir in einem Einzel-Durchlauf entgeht.
Lokale Evals sind in der Entwicklung hilfreich, hängen aber davon ab, dass die Person mit Prompt-Änderung daran denkt, sie zu starten. Promptfoo hat eine offizielle GitHub Action, die diese Abhängigkeit eliminiert, indem sie deine Eval-Suite bei jedem Pull-Request ausführt und die Ergebnisse als Kommentar postet.
Lege dafür eine Workflow-Datei in deinem Repo an:
mkdir -p .github/workflowsErstelle dann .github/workflows/prompt-eval.yml mit folgendem Inhalt:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Bevor das funktioniert, musst du deinen OPENAI_API_KEY (optional auch ANTHROPIC_API_KEY) als Repository-Secrets in deinem GitHub-Repo unter Settings > Secrets and variables > Actions hinterlegen.
Der paths-Filter sorgt dafür, dass die Action nur triggert, wenn jemand Dateien in prompts/ ändert. Der Checkout-Schritt ist nötig, weil die Action intern git nutzt, um Prompt-Dateien zwischen Branches zu diffen. Sie führt die komplette Eval-Suite aus und postet einen PR-Kommentar mit Ergebnissen und Link zum Web-Viewer.
Für mehr Kontrolle über Bestehen/Nichtbestehen kannst du die JSON-Ausgabe direkt parsen:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
Der Workflow ab hier:
Prompt-Änderungen bekommen dieselbe Test-vor-Merge-Behandlung wie Code-Änderungen.
Der E-Mail-Generator aus dem Intro hat immer noch ein Ton-Problem, aber jetzt gibt es einen Test, der es findet, bevor Nutzer es merken. Du hast mit einer leeren YAML-Datei begonnen und mit einer Eval-Suite geendet, die über zwei Modelle in CI läuft.
Der gleiche Ansatz gilt für jedes LLM-Feature – ob Chatbot, Zusammenfasser oder Klassifikationspipeline. Solange du eine Assertion dafür schreiben kannst, was „gute Ausgabe“ heißt, kannst du es automatisch testen statt nach Gefühl.
Wenn du weiter einsteigen willst, decken die Promptfoo-Dokumente einige lohnende Bereiche ab:
Red Teaming: promptfoo redteam run scannt mit Dutzenden Attack-Plugins nach Prompt-Injection und Jailbreaks
Eigene Python-Provider: Wickle jedes interne Modell oder Fine-Tuning-Endpoint mit file://my_provider.py ein
CSV-Testdaten: Skaliere deine Testsuite mit file://tests.csv, wenn Inline-YAML unhandlich wird
Wenn du die Prompts verbessern willst, die du testest, deckt unser Kurs Prompt Engineering with the OpenAI API viele Techniken ab, die du in jeder Art von KI-Entwicklung anwenden kannst.
Prompt-Engineering-Kurse
Kurs
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Zoumana Keita
15 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.


