
कोर्स
Prompt Engineering को समझना
1 घंटा
235.8K
अधिकांश LLM फीचर्स का परीक्षण एक ही तरीके से होता है: कुछ इनपुट आज़माएं, आउटपुट पर नज़र डालें, और जारी कर दें।
आपने यह एक ईमेल राइटर के साथ किया। चैट विंडो में पाँच इनपुट, आउटपुट ठीक लगे। एक हफ्ते बाद, आपके आधे कैज़ुअल-टोन ईमेल ऐसे लगते हैं जैसे किसी कॉर्पोरेट वकील ने लिखे हों। किसी ने पकड़ नहीं पाया क्योंकि पकड़ने का कोई तरीका ही नहीं था। प्रॉम्प्ट बदल गए, लेकिन वे पाँच मैनुअल टेस्ट साथ नहीं आए।
Promptfoo एक ओपन-सोर्स CLI है जो इस प्रक्रिया को संरचित, दोहराए जा सकने वाले मूल्यांकनों से बदल देता है। आप तय करते हैं कि अच्छा आउटपुट कैसा दिखता है, अपने मॉडल चुनते हैं, और हर संयोजन स्वचालित रूप से चलाते हैं।
OpenAI ने मार्च 2026 में इस प्रोजेक्ट का अधिग्रहण किया, और यह MIT-लाइसेंस प्राप्त बना हुआ है, दर्जनों प्रोवाइडर्स के समर्थन के साथ। 3,50,000 से अधिक डेवलपर्स इसे उपयोग करते हैं, जिनमें Fortune 500 कंपनियों के 25% से अधिक की टीमें शामिल हैं।
यह ट्यूटोरियल आपको Promptfoo सेटअप करने और शुरू से अपना पहला इवाल सूट बनाने तक लेकर जाएगा। हम एक ईमेल राइटर को रनिंग उदाहरण के रूप में उपयोग करेंगे, इसे GPT-5 और Claude Sonnet 4.6 पर टेस्ट करेंगे, और अंत तक सब कुछ GitHub Actions में जोड़ देंगे।
टूल में जाने से पहले, यह समझें कि LLM टेस्टिंग कैसे काम करती है। यह सामान्य कोड टेस्टिंग से अलग है।
अगर आपने पहले कोई फ़ंक्शन टेस्ट किया है, तो पैटर्न जानते हैं: इनपुट दें, देखें कि आउटपुट उम्मीद के मुताबिक है या नहीं। LLM आउटपुट ऐसे नहीं चलते। वही प्रॉम्प्ट हर रन में अलग टेक्स्ट दे सकता है, इसलिए आप एक्सैक्ट मैच नहीं देख सकते।
इसके बजाय, आप आउटपुट के गुणों की जाँच करते हैं:
यही एक LLM इवाल करता है। यह आपके प्रॉम्प्ट को इनपुट्स के सेट पर चलाता है और हर आउटपुट को आपकी परिभाषित नियमों के खिलाफ जाँचता है। इसे अपने कोड की बजाय अपने प्रॉम्प्ट्स के लिए टेस्ट सूट समझें।
इस लेख में चार शब्द बार-बार आएंगे:
असर्शन के बिना, आप फिर "मुझे ठीक लग रहा है" पर लौट आते हैं। इनके साथ, आपके पास "सही" की एक परिभाषा होती है जो हर बार एक ही तरीके से चलती है।
अब जबकि आप जानते हैं कि इवाल क्या है, देखें Promptfoo इसके साथ क्या करता है।
आप Promptfoo को तीन चीजें देते हैं:
यह हर टेस्ट केस के लिए हर प्रॉम्प्ट को हर मॉडल पर चलाकर परिणामों को स्कोर करता है। एक कमांड, promptfoo eval, पूरी प्रक्रिया चला देता है।
मान लें आपके पास एक ईमेल लिखने का प्रॉम्प्ट है, दो मॉडल (GPT-5 और Claude Sonnet 4) हैं, और तीन टेस्ट केस (कैज़ुअल, फॉर्मल, अर्जेंट) हैं। Promptfoo सभी छह संयोजनों को चलाता है और बताता है कौन से पास हुए और कौन से फेल। अब हर एक को हाथ से आज़माने की ज़रूरत नहीं।
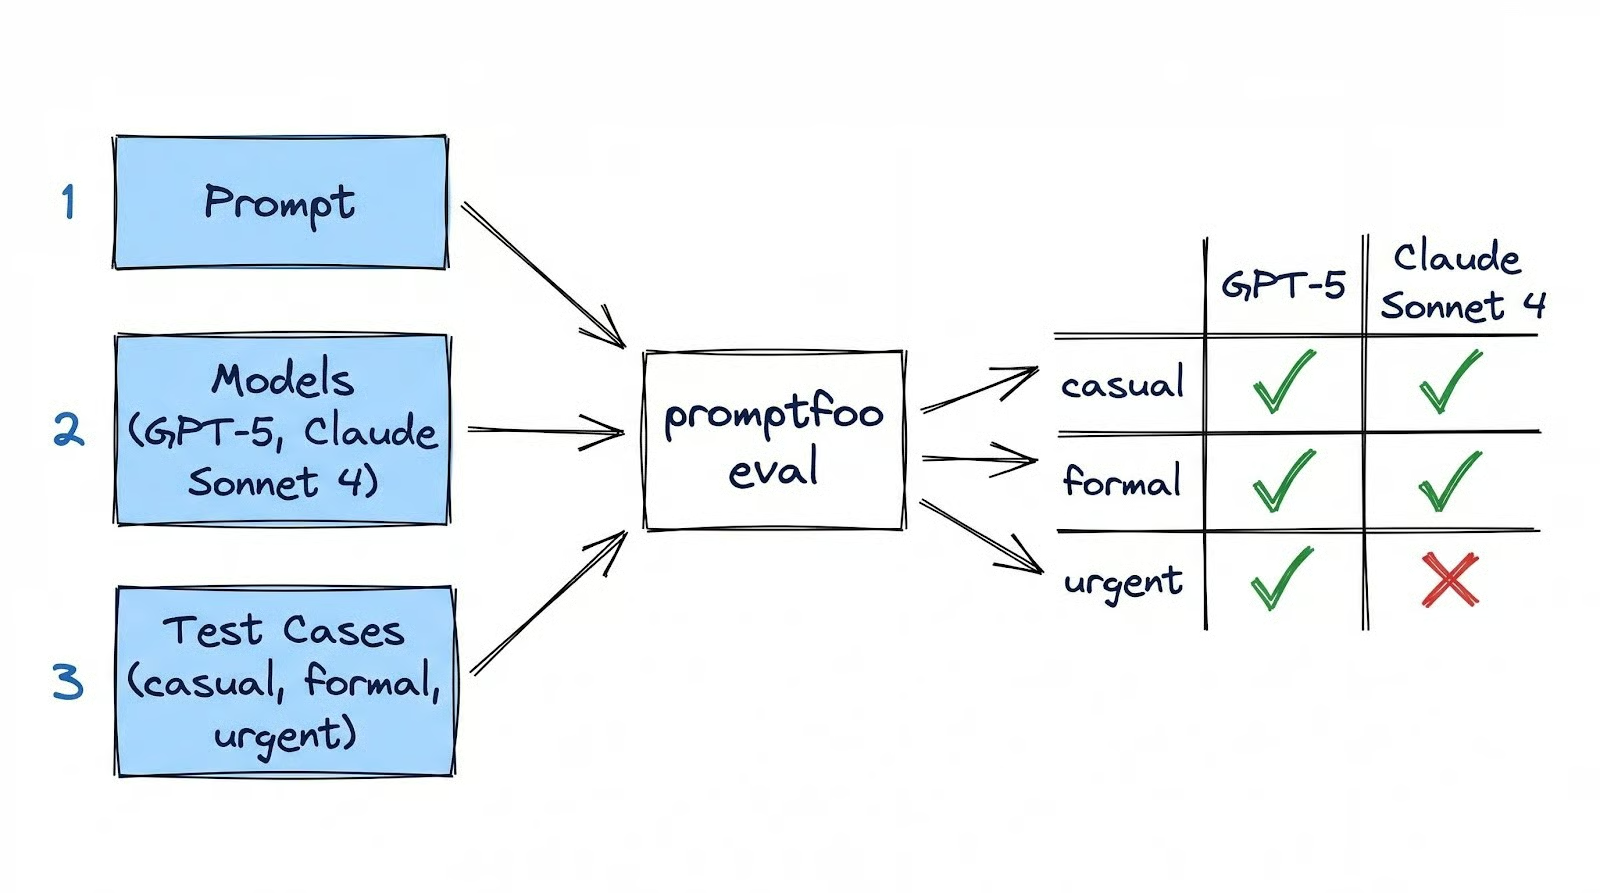
पूरा इवाल एक YAML फाइल promptfooconfig.yaml में रहता है, जिसे आप अपने कोड के साथ वर्शन-कंट्रोल करते हैं। Promptfoo आपकी मशीन पर चलता है: आपका कॉन्फ़िग, परिणाम, और कैश सब स्थानीय रहते हैं। बाहरी कॉल सिर्फ मॉडल APIs (जैसे OpenAI या Anthropic) को जाती हैं, जिन्हें आप Promptfoo के साथ या बिना वैसे भी कॉल करते।
इस क्षेत्र में अन्य टूल भी मौजूद हैं, जैसे DeepEval (Python-नेटिव, pytest-स्टाइल), LangSmith (LangChain के लिए प्रोडक्शन मॉनिटरिंग), और Braintrust (टीम डैशबोर्ड्स)। Promptfoo शुरुआत के लिए बेहतरीन है क्योंकि यह मुफ़्त है, लोकली चलता है, और आपको शून्य से काम करने वाले इवाल तक सबसे तेज़ पहुँचाता है।
Promptfoo को ग्लोबल इंस्टॉल करें और एक नया प्रोजेक्ट इनिशियलाइज़ करें:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
यह init कमांड आपको एक इंटरैक्टिव सेटअप से गुज़ारती है। यह पूछती है कि आप क्या करना चाहेंगे ("Not sure yet" चुनें) और किस मॉडल प्रोवाइडर का उपयोग करना है ("[OpenAI] GPT 5, GPT 4.1, ..." चुनें)।
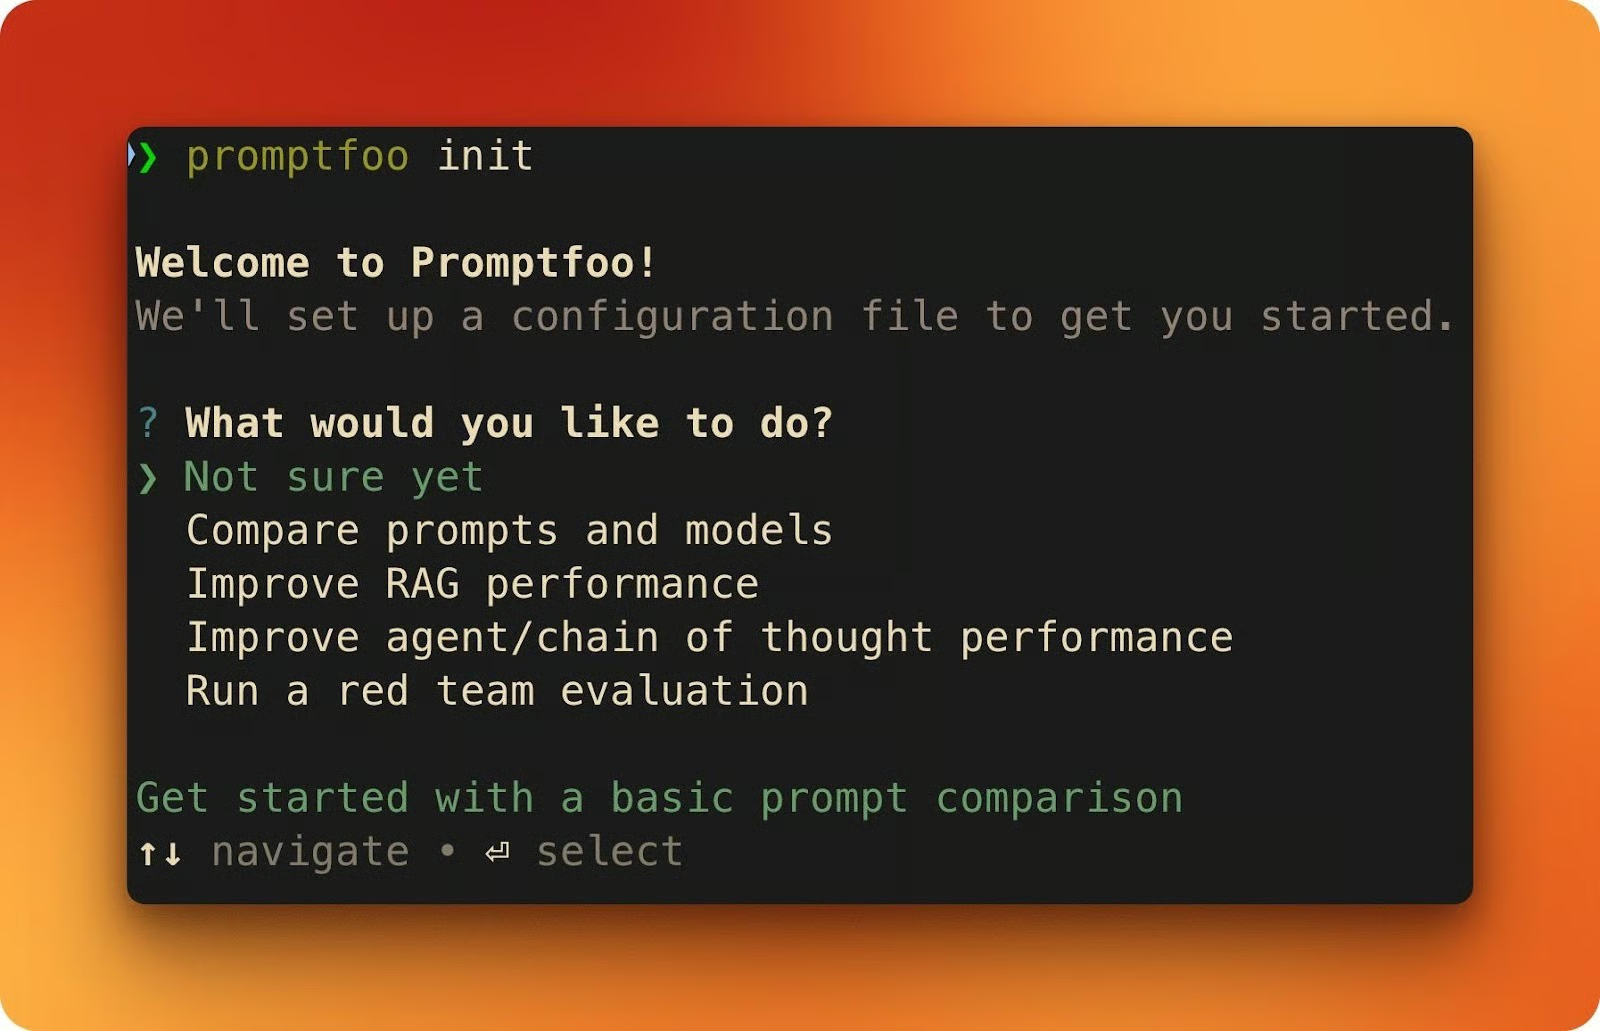
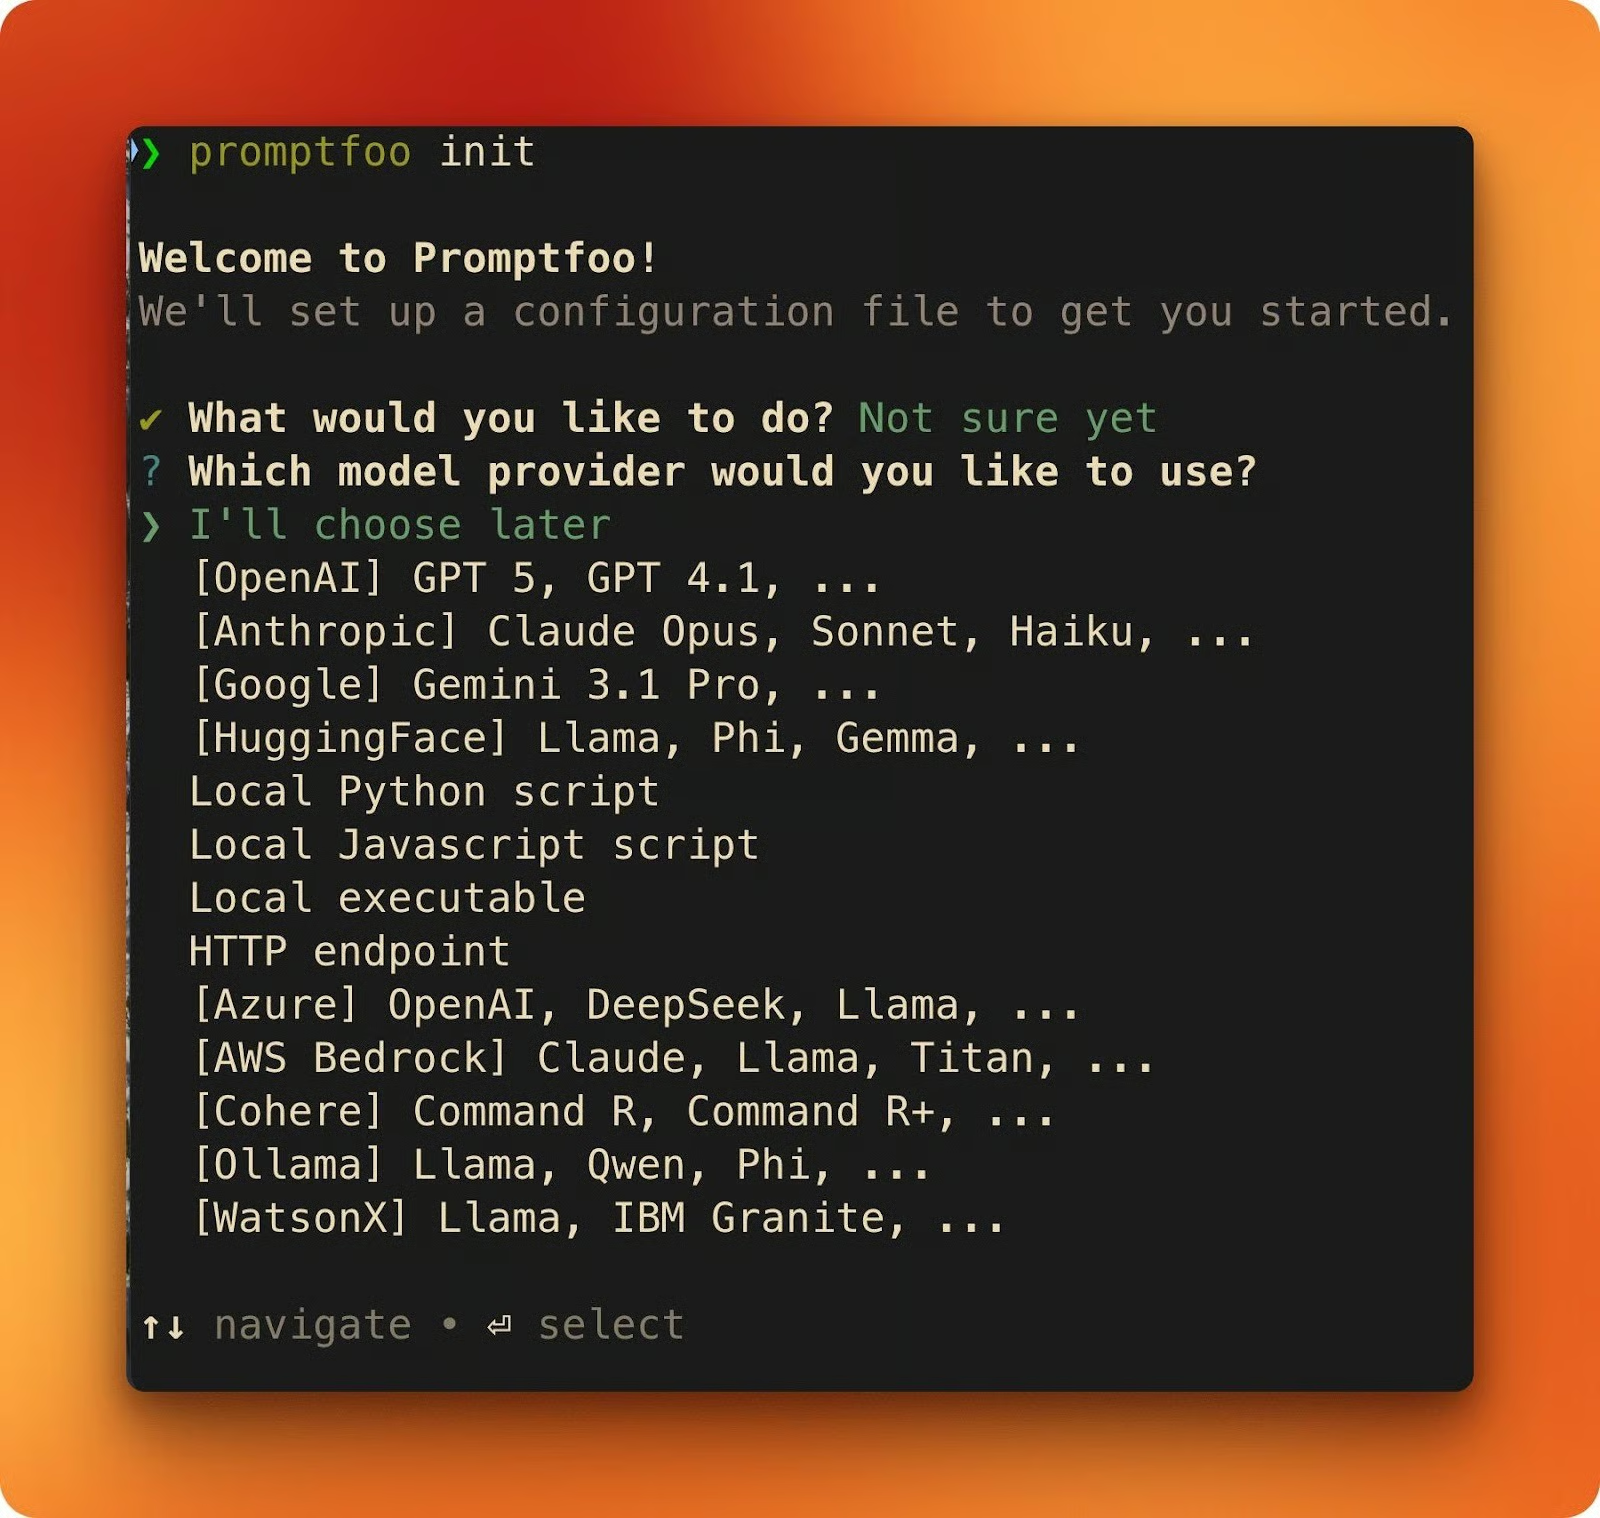
पूरा होने पर, आपके पास दो फाइलें होंगी: एक सैंपल promptfooconfig.yaml और एक README.md।
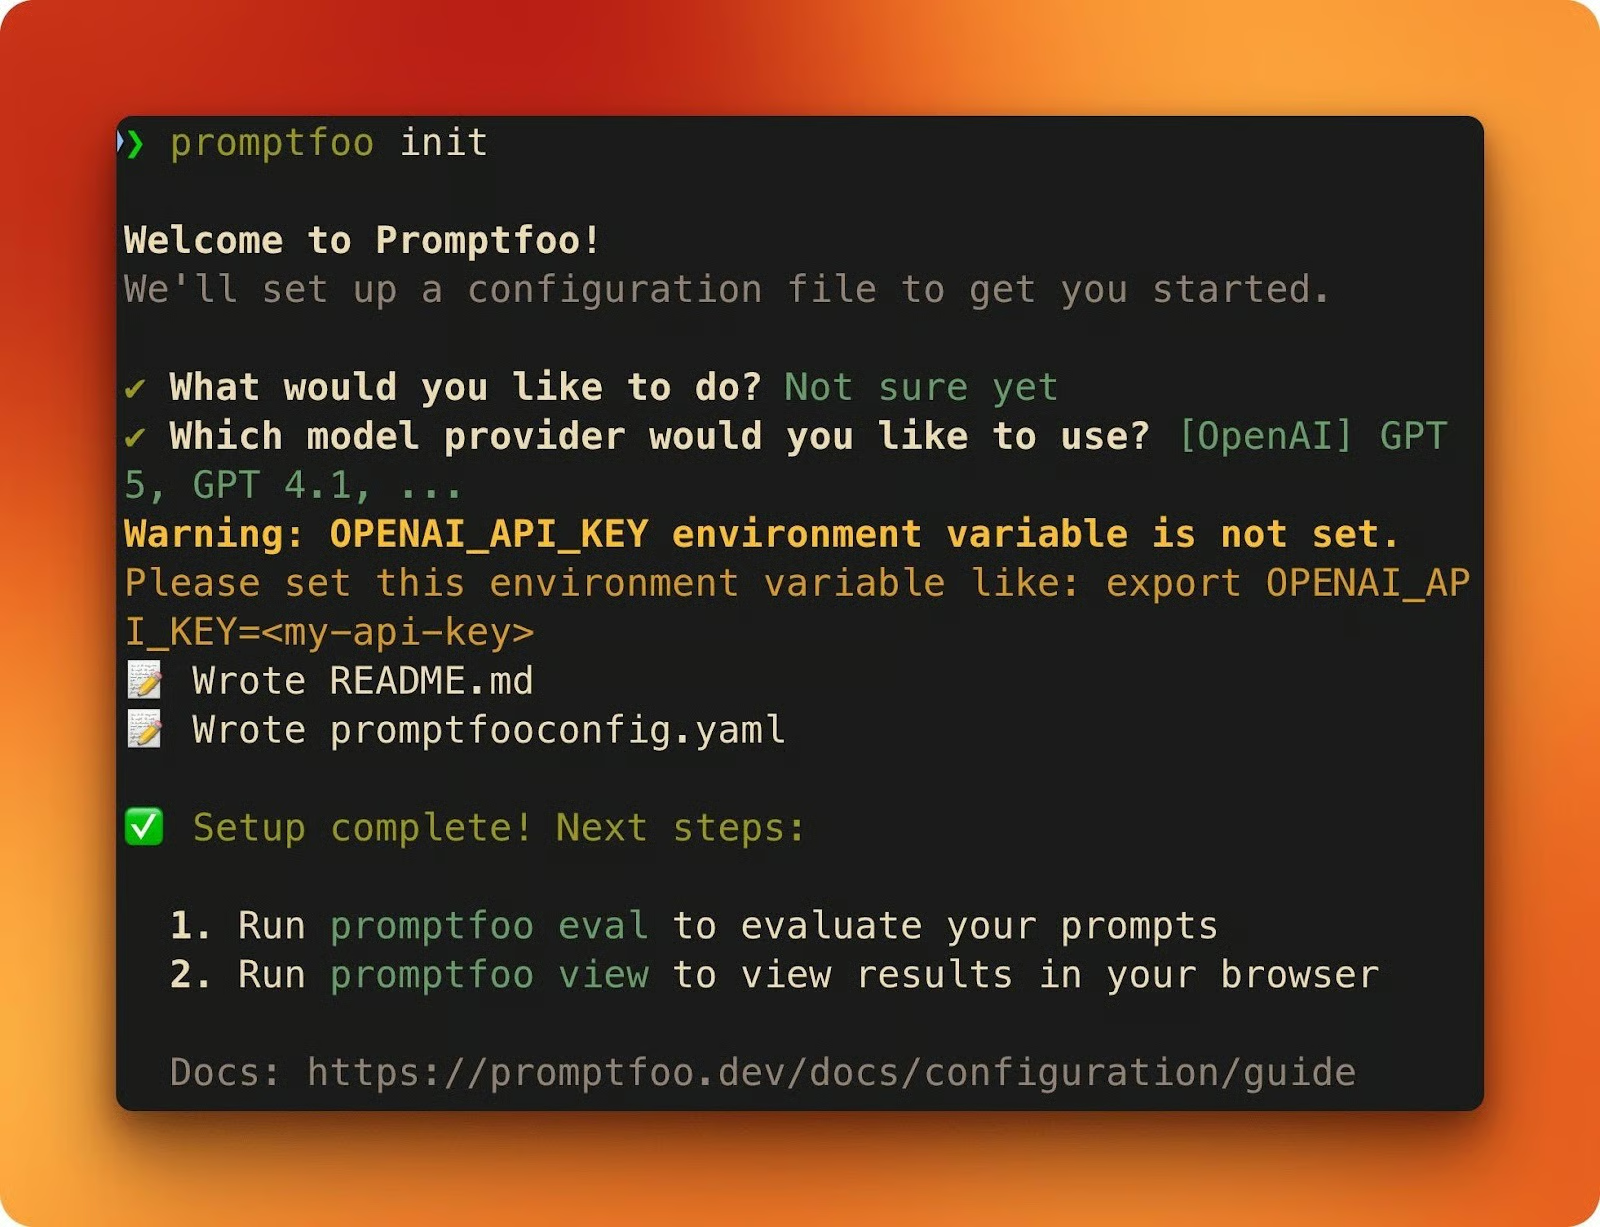
अब अपने API कीज़ सेट करें। इवाल चलाने के लिए आपको कम से कम एक की चाहिए (इस ट्यूटोरियल के साथ चलने के लिए दोनों रखें):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
यदि आप केवल ANTHROPIC_API_KEY सेट करते हैं और OpenAI को छोड़ देते हैं, तो Promptfoo स्वचालित रूप से llm-rubric जैसी मॉडल-असिस्टेड असर्शन्स के लिए ग्रेडिंग प्रोवाइडर के रूप में Claude का उपयोग करता है।
जेनरेटेड promptfooconfig.yaml खोलें। हर Promptfoo कॉन्फ़िग में तीन बिल्डिंग ब्लॉक्स होते हैं:
prompts वह जगह है जहाँ आपके प्रॉम्प्ट टेम्पलेट्स जाते हैं। डबल-ब्रेस प्लेसहोल्डर जैसे {{variable}} हर टेस्ट केस से भरे जाते हैं।
providers उन मॉडलों को सूचीबद्ध करता है जिनके खिलाफ आप टेस्ट करना चाहते हैं।
tests उन इनपुट्स और असर्शन्स को परिभाषित करता है जो तय करते हैं कि हर आउटपुट पास होगा या फेल।
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
यह सैंपल कॉन्फ़िग एक शुरुआती बिंदु है। अगला सेक्शन इसे वास्तविक मूल्यांकन से बदल देगा और YAML संरचना को विस्तार से समझाएगा।
कार्य यह है: बुलेट पॉइंट्स और एक टोन (कैज़ुअल, फॉर्मल, या अर्जेंट) दिए जाने पर, एक ईमेल लिखें। आप एक इवाल बनाएंगे जो इसे दो मॉडलों पर टेस्ट करेगा।
यदि आप पूरी कॉन्फ़िग एक साथ देखना चाहते हैं, तो यह Gist के रूप में उपलब्ध है। नीचे हम इसे हिस्सों में बनाएंगे।
जेनरेटेड सैंपल हटाएं और एक नया promptfooconfig.yaml बनाएं। प्रॉम्प्ट और प्रोवाइडर्स से शुरू करें:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
प्रॉम्प्ट टेम्पलेट में दो प्लेसहोल्डर हैं: {{bullet_points}} और {{tone}}। हर टेस्ट केस इन्हें अलग-अलग मानों से भरता है। हर प्रोवाइडर पर label फील्ड आपको रिजल्ट्स व्यू में कच्चे मॉडल IDs की बजाय पठनीय कॉलम हेडर देता है।
अब defaultTest ब्लॉक जोड़ें। defaultTest के अंदर लिखे असर्शन हर टेस्ट केस पर अपने-आप लागू होते हैं, ताकि आपको उन्हें दोहराना न पड़े:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
यह 30 सेकंड से धीमी किसी भी प्रतिक्रिया को फेल कर देता है। GPT-5 जैसे फ्रंटियर मॉडल रीजनिंग टोकन्स के कारण प्रति रिक्वेस्ट 10–20 सेकंड ले सकते हैं, इसलिए थ्रेशहोल्ड में जगह चाहिए। इसे एक बार सेट करें, और यह हर टेस्ट को कवर करता है।
अब टेस्ट केस जोड़ें। हर केस अलग इनपुट देता है और अपने असर्शन रखता है:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
हर टेस्ट केस दो तरह के असर्शन जोड़ता है।
icontains एक साधारण स्ट्रिंग जाँच है: क्या आउटपुट में "mockups" शामिल है, केस-इन्सेंसिटिव? यह तेज़, मुफ़्त है, और कोई API कॉल नहीं करता।
llm-rubric आउटपुट को दूसरे LLM को भेजता है और आपकी रूब्रिक के मुकाबले प्रतिक्रिया को ग्रेड करने को कहता है। इसमें टोकन्स लगते हैं, लेकिन यह वे चीजें पकड़ता है जो स्ट्रिंग-मैचिंग नहीं पकड़ सकती, जैसे कि क्या ईमेल वाकई कैज़ुअल लगता है।
इवाल चलाएं:
promptfoo evalफिर अपने ब्राउज़र में परिणाम खोलें:
promptfoo view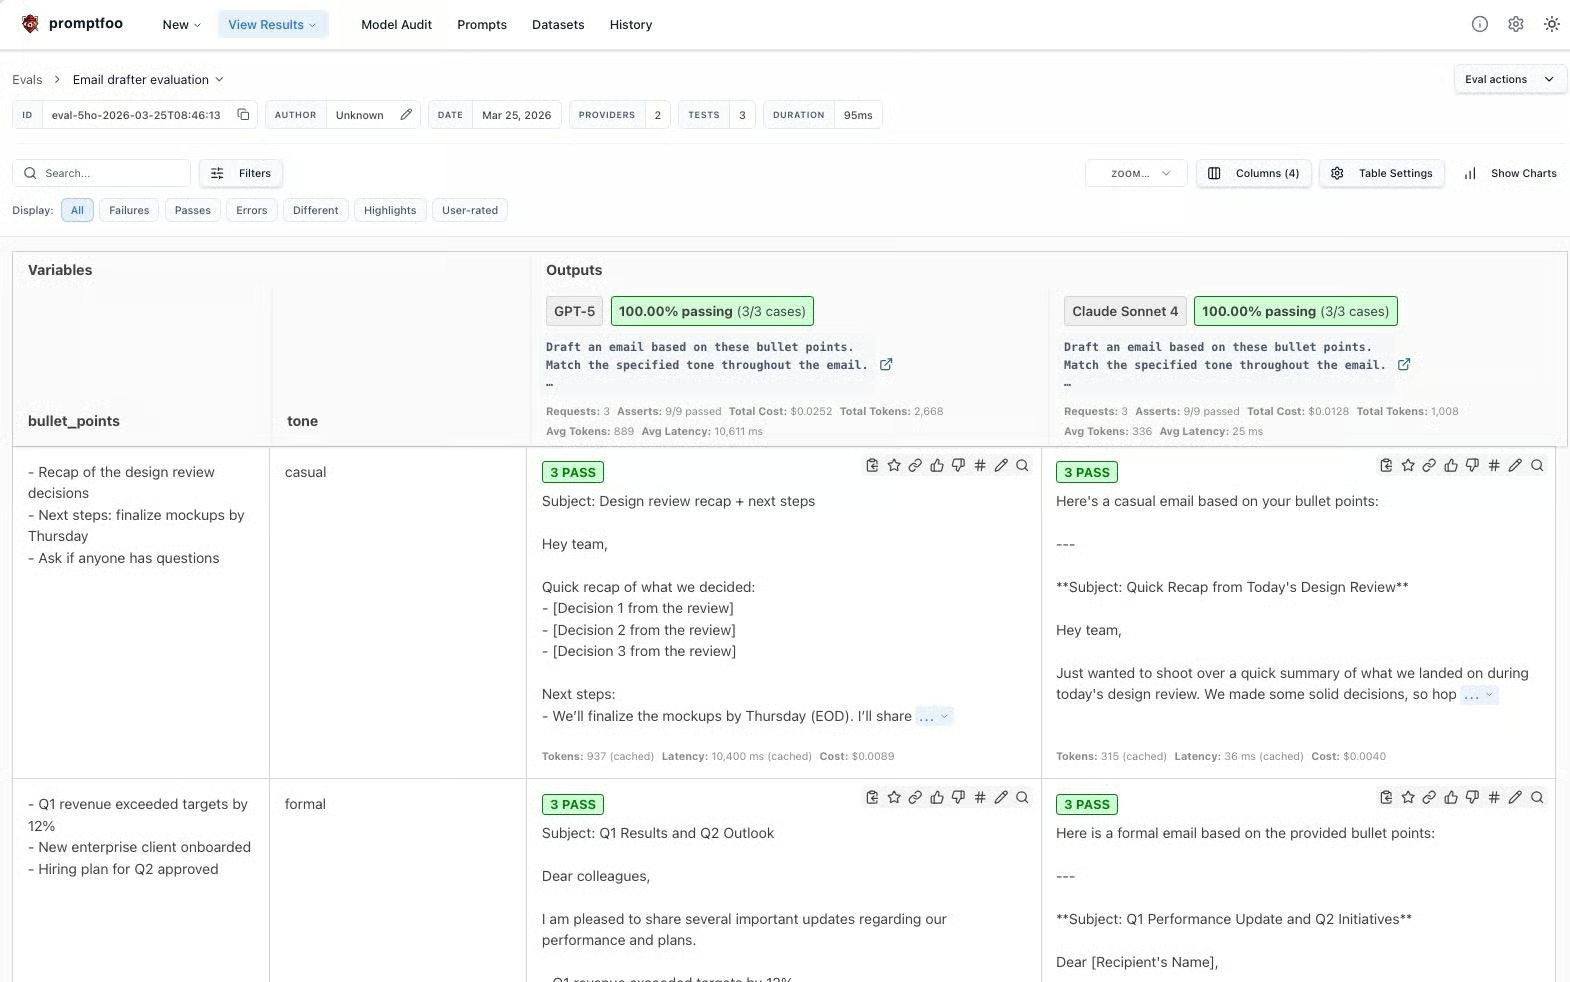
वेब UI में प्रोवाइडर्स कॉलम के रूप में और टेस्ट केस पंक्तियों के रूप में दिखते हैं। हर सेल हर असर्शन के पास/फेल को दिखाती है, और आप किसी भी सेल पर क्लिक करके पूरा आउटपुट और ग्रेडिंग विवरण देख सकते हैं।
Promptfoo डिफ़ॉल्ट रूप से (14-दिन TTL) API प्रतिक्रियाओं को डिस्क पर कैश करता है, इसलिए वही इवाल दोबारा चलाने में कोई लागत नहीं आती। जब आपको नए जवाब चाहिए हों तो --no-cache का उपयोग करें।
पहले इवाल में आपने icontains और llm-rubric का उपयोग किया। ये Promptfoo द्वारा समर्थित कई असर्शन प्रकारों में से दो हैं। यह सेक्शन मुख्य श्रेणियों से गुजरता है, और हम चलते-चलते ईमेल राइटर कॉन्फ़िग में असर्शन जोड़ते रहेंगे।
ये लोकली चलते हैं, कोई लागत नहीं लगती, और तुरंत परिणाम देते हैं।
|
प्रकार |
क्या जाँचता है |
|
|
आउटपुट में कोई सबस्ट्रिंग शामिल है (केस-सेंसिटिव या नहीं) |
|
|
आउटपुट किसी पैटर्न से मेल खाता है (अनफिल्ड |
|
|
आउटपुट किसी चीज़ को बाहर रखता है (टेम्पलेट आर्टिफैक्ट्स, रिफ्यूज़ल, प्लेसहोल्डर टेक्स्ट) |
|
|
प्रतिक्रिया N मिलीसेकंड से कम समय में आई |
|
|
प्रतिक्रिया की लागत $X से कम है |
आपने पहले ही icontains और latency का उपयोग किया है। चलिए कैज़ुअल टेस्ट केस में not-contains जोड़ते हैं। यदि मॉडल डिफ़ॉल्ट रूप से औपचारिक भाषा अपनाता है, तो वह "Dear" से शुरू कर सकता है, जबकि कैज़ुअल में "Hey" जैसा कुछ होना चाहिए। इसे पकड़ना एक पंक्ति में:
- type: not-contains
  value: \"Dear\"
इसे कैज़ुअल टेस्ट केस की assert सूची में जोड़ें और फिर चलाएं। दोनों मॉडल पास होने चाहिए: GPT-5 अक्सर "Hey team," से खुलता है, और Claude Sonnet 4 भी। अगर किसी ने "Dear Colleagues," से शुरू किया होता, तो यह असर्शन तुरंत फ़्लैग कर देता।
हर असर्शन प्रकार not- प्रीफ़िक्स को भी सपोर्ट करता है: not-regex, not-equals, आदि।
इनमें टोकन्स की लागत आती है, लेकिन ये वे चीजें जज कर सकते हैं जो स्ट्रिंग-मैचिंग नहीं कर सकती। आपने पहले इवाल में llm-rubric का उपयोग किया है। आपकी लिखी रूब्रिक ही इसे सफल या असफल बनाती है।
"ईमेल प्रोफेशनल लगता है" जैसी अस्पष्ट रूब्रिक ग्रेडर को कुछ उपयोगी नहीं बताती। एक विशिष्ट रूब्रिक उसे मापने के लिए कुछ देती है:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
जब आप इस रूब्रिक के साथ इवाल दोबारा चलाते हैं, तो ग्रेडर का आउटपुट भी विशिष्ट हो जाता है:
जितनी विशिष्ट आपकी रूब्रिक, उतना ही सुसंगत और उपयोगी ग्रेडिंग।
Promptfoo में answer-relevance (क्या आउटपुट ने सवाल का जवाब दिया?) और similar (एम्बेडिंग्स के जरिए किसी संदर्भ के साथ कोसाइन सिमिलैरिटी) भी आते हैं, जो RAG और सर्च एप्लिकेशन्स के लिए उपयोगी हैं।
जब बिल्ट-इन प्रकार आपकी लॉजिक को कवर नहीं करते, तो अपने खुद के लिखें। ईमेल राइटर के लिए, आप यह जाँचना चाह सकते हैं कि आउटपुट्स एक उचित लंबाई के भीतर रहें। यहाँ एक इनलाइन असर्शन है जो पास करता है यदि ईमेल 50 से 200 शब्दों के बीच है:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
इसे कैज़ुअल टेस्ट केस में जोड़ें और फिर चलाएं। मेरे रन में, दोनों मॉडल पास हुए: GPT-5 54 शब्दों पर आया, Claude Sonnet 4 187 पर। लेकिन इसे अगले सेक्शन के लिए याद रखें, क्योंकि यह हर जगह पास नहीं हुआ।
और जटिल जाँचों के लिए, लॉजिक को अलग फाइल में रखें:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
अपनी कॉन्फ़िग में इसे type: python और value: file://assert_length.py के साथ संदर्भित करें। reason फील्ड परिणाम UI में दिखता है, ताकि आप ठीक-ठीक देख सकें कि कोई टेस्ट क्यों पास या फेल हुआ।
यहाँ देखें कि वास्तविक विफलता कैसी दिखती है।
Python वर्ड काउंट असर्शन को तीनों टेस्ट केस में जोड़ें और दोनों मॉडलों पर पूरा इवाल चलाएं। मेरे मामले में, छह में से पाँच संयोजन पास हुए। Claude Sonnet 4.6 ने अर्जेंसी टेस्ट केस पास नहीं किया (LLMs के गैर-नियतात्मक व्यवहार के चलते यह आपके मशीन पर हो भी सकता है और नहीं भी)।
उस रन में, आउटपुट 207 शब्दों पर आया, यानी सीमा से सात अधिक। llm-rubric वास्तव में पास हुआ, पुष्टि करते हुए कि ईमेल ने "अर्जेंट, डायरेक्ट भाषा" के साथ "स्पष्ट कार्य" उपयोग किए। icontains भी पास हुआ, क्योंकि "Friday" आउटपुट में था।
लेकिन Python वर्ड काउंट असर्शन फेल हुआ। Claude ने वास्तविक ईमेल से पहले मेटा-कमेंट्री जोड़ी ("Here is a draft email based on your bullet points with an urgent tone:"), जिसने वर्ड काउंट को 200 से ऊपर धकेल दिया।
यह वह चीज़ है जिसे आप आंखों-देखी से नहीं पकड़ते। ईमेल खुद ठीक पढ़ा: सही टोन, सही कंटेंट। लेकिन आउटपुट लंबा हो गया क्योंकि मॉडल ने ईमेल का हिस्सा न होने वाला टेक्स्ट जोड़ दिया। एक असर्शन ने इसे पकड़ा, और इवाल ने पूरे टेस्ट केस को फ़्लैग कर दिया।
समाधान दो तरह जा सकता है: प्रॉम्प्ट को समायोजित करें ताकि मॉडल प्रीएम्बल न जोड़े, या वर्ड लिमिट बढ़ाएँ। किसी भी तरह, आप इवाल फिर चलाते हैं और जाँचते हैं कि यह पास होता है।
इस बिंदु पर, कैज़ुअल टेस्ट केस में चार असर्शन हैं: icontains, not-contains, llm-rubric, और Python वर्ड काउंट। सभी समान रूप से महत्वपूर्ण नहीं हैं। weight फील्ड आपको यह व्यक्त करने देता है:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
हर असर्शन के स्कोर को उसके वेट से गुणा किया जाता है, और टेस्ट वेटेड एवरेज निकालता है। threshold पास होने के लिए न्यूनतम स्कोर सेट करता है। यहाँ, टोन रूब्रिक की गिनती कीवर्ड जाँचों से दोगुनी है, और वर्ड काउंट आधी।
इन वेट्स के साथ कैज़ुअल टेस्ट दोबारा चलाने पर, दोनों मॉडल 1.0 स्कोर करते हैं और पास होते हैं। लेकिन यदि llm-rubric फेल हो जाता (वेट 2) जबकि वर्ड काउंट पास होता (वेट 0.5), तो वेटेड स्कोर 0.7 थ्रेशहोल्ड से नीचे चला जाता, और टेस्ट फेल हो जाता। वेट्स आपको Promptfoo को बताने देते हैं कि आप किस चीज़ की सबसे ज्यादा परवाह करते हैं।
कॉन्फ़िग में पहले से दो प्रोवाइडर हैं, इसलिए promptfoo eval ने एक ही पास में GPT-5 और Claude Sonnet 4 को टेस्ट किया। promptfoo view खोलें और आप उन्हें रिज़ल्ट्स में अलग कॉलम के रूप में देखते हैं, हर टेस्ट केस हर मॉडल के लिए स्वतंत्र रूप से स्कोर किया गया।
हमारे इवाल के मेरे रन में, GPT-5 ने तीनों टेस्ट केस में सभी छह असर्शन पास किए। Claude Sonnet 4 ने पाँच पास किए लेकिन अर्जेंट ईमेल पर वर्ड काउंट फेल हुआ।
यह वह अंतर है जिसे आप कुछ प्रॉम्प्ट्स मैन्युअली आज़माकर कभी नहीं देखेंगे, लेकिन यह ग्रिड में तुरंत दिखता है। आप एक जैसे इनपुट्स पर एक जैसी असर्शन्स के खिलाफ स्कोर्स की तुलना कर रहे हैं, न कि अपनी याददाश्त के सहारे कि पिछली बार कौन सा मॉडल "बेहतर लगा" था।
हालाँकि, LLM आउटपुट नियतात्मक नहीं हैं। वही प्रॉम्प्ट लगातार रन में अलग परिणाम दे सकता है, और एक बार का पास आपको नहीं बताएगा कि कोई मॉडल भरोसेमंद रूप से अच्छा है या बस किस्मत से। --repeat फ़्लैग इसी का ध्यान रखता है:
promptfoo eval --repeat 3यह हर प्रोवाइडर पर हर टेस्ट केस को तीन बार चलाता है। यदि कोई मॉडल टोन असर्शन को दो बार पास करता है लेकिन तीसरी रन पर फेल, तो यह एक विश्वसनीयता संकेत है जिसे आप सिंगल पास में चूक जाते।
डेवलपमेंट के दौरान लोकली इवाल चलाना ठीक है, लेकिन यह इस पर निर्भर करता है कि जो भी प्रॉम्प्ट बदलता है वह उन्हें चलाना याद रखे। Promptfoo में आधिकारिक GitHub Action है जो हर पुल रिक्वेस्ट पर आपका इवाल सूट चलाकर और परिणामों को कमेंट के रूप में पोस्ट करके इस निर्भरता को हटा देता है।
इसे सेट करने के लिए, अपने रिपो में एक वर्कफ़्लो फाइल बनाएं:
mkdir -p .github/workflowsफिर .github/workflows/prompt-eval.yml निम्न कंटेंट के साथ बनाएं:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
इसके काम करने से पहले, आपको अपने GitHub रिपो में OPENAI_API_KEY (और वैकल्पिक रूप से ANTHROPIC_API_KEY) को Settings > Secrets and variables > Actions में रिपोजिटरी सीक्रेट्स के रूप में जोड़ना होगा।
यहाँ paths फ़िल्टर का मतलब है कि एक्शन तभी ट्रिगर होता है जब कोई prompts/ में फाइलें बदलता है। चेकआउट स्टेप ज़रूरी है क्योंकि एक्शन अंदरूनी तौर पर ब्रांचों के बीच प्रॉम्प्ट फाइलों का डिफ निकालने के लिए git का उपयोग करता है। यह पूरा इवाल सूट चलाता है और रिज़ल्ट्स के साथ PR कमेंट पोस्ट करता है, वेब व्यूअर के लिंक सहित।
पास/फेल लॉजिक पर अधिक नियंत्रण के लिए, आप JSON आउटपुट को सीधे पार्स कर सकते हैं:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
यहाँ से वर्कफ़्लो:
प्रॉम्प्ट बदलावों को कोड बदलावों की तरह ही मर्ज से पहले टेस्ट करने का व्यवहार मिलता है।
इंट्रो का ईमेल राइटर अब भी टोन समस्या से जूझ रहा है, लेकिन अब एक टेस्ट है जो यूज़र्स से पहले उसे पकड़ लेता है। आपने एक खाली YAML फाइल से शुरुआत की और CI में दो मॉडलों पर चलने वाले इवाल सूट के साथ समाप्त किया।
यही तरीका किसी भी LLM फीचर पर लागू होता है जिसे आप बनाते हैं, चाहे वह चैटबॉट हो, समरीज़र हो, या क्लासिफिकेशन पाइपलाइन। जब तक आप "अच्छे आउटपुट" का असर्शन लिख सकते हैं, आप उसे आंखों-देखी के बजाय स्वतः टेस्ट कर सकते हैं।
जब आप आगे बढ़ने के लिए तैयार हों, तो Promptfoo डॉक्यूमेंटेशन कुछ क्षेत्रों को कवर करता है जिन्हें देखना उपयोगी है:
रेड टीमिंग: promptfoo redteam run दर्जनों अटैक प्लगइन्स के जरिए प्रॉम्प्ट इंजेक्शन और जेलब्रेक्स के लिए स्कैन करता है
कस्टम Python प्रोवाइडर्स: किसी भी आंतरिक मॉडल या फाइन-ट्यूनड एंडपॉइंट को file://my_provider.py से रैप करें
CSV टेस्ट डेटा: जब इनलाइन YAML भारी हो जाए, तो file://tests.csv के साथ अपने टेस्ट सूट को स्केल करें
यदि आप उन प्रॉम्प्ट्स को बेहतर बनाना चाहते हैं जिनका आप परीक्षण कर रहे हैं, तो हमारा Prompt Engineering with the OpenAI API कोर्स कई महत्वपूर्ण तकनीकों को कवर करता है जिन्हें आप किसी भी तरह के AI डेवलपमेंट में लागू कर सकते हैं।
प्रॉम्प्ट इंजीनियरिंग कोर्स
कोर्स
कोर्स
कोर्स