
Last chance! 50% off DataCamp Premium
Sale ends in
Çoğu LLM özelliği aynı şekilde test edilir: birkaç girdi dener, çıktılara göz atar, yayına alırsınız.
Bunu bir e-posta yazarıyla yaptınız. Sohbet penceresine beş girdi, çıktılar fena değildi. Bir hafta sonra, rahat tonda olması gereken e-postaların yarısı kurumsal bir avukatın elinden çıkmış gibi duruyor. Kimse fark etmedi çünkü fark edilmesinin bir yolu yoktu. Promptlar değişti ama o beş manuel test sizinle gelmedi.
Promptfoo, bu sürecin yerine yapılandırılmış ve tekrarlanabilir değerlendirmeler getiren açık kaynaklı bir CLI’dır. İyi çıktı nasıl görünür tanımlarsınız, modellerinizi seçersiniz ve tüm kombinasyonları otomatik olarak çalıştırırsınız.
OpenAI, projeyi Mart 2026’da satın aldı ve proje MIT lisansıyla, onlarca sağlayıcı desteğiyle devam ediyor. 350.000’den fazla geliştirici kullanıyor; Fortune 500 şirketlerinin %25’inden fazlasındaki ekipler de dahil.
Bu eğitim, Promptfoo’yu kurmaktan sıfırdan ilk değerlendirme paketini oluşturmaya kadar sizi adım adım yönlendirecek. Örnek olarak bir e-posta yazarı kullanacağız; GPT-5 ve Claude Sonnet 4.6 üzerinden test edecek ve en sonda her şeyi GitHub Actions’a bağlayacağız.
Araca girmeden önce LLM testinin nasıl çalıştığını bilmeniz gerekiyor. Normal kod testinden farklıdır.
Daha önce bir fonksiyon test ettiyseniz deseni bilirsiniz: girdi verirsiniz, çıktının beklediğinizle eşleştiğini kontrol edersiniz. LLM çıktıları böyle işlemez. Aynı promptu her çalıştırdığınızda farklı metin üretebilir; dolayısıyla birebir eşleşme arayamazsınız.
Bunun yerine, çıktının özelliklerini kontrol edersiniz:
Bir LLM değerlendirmesi tam olarak bunu yapar. Promptunuzu bir girdi setine karşı çalıştırır ve her çıktıyı sizin tanımladığınız kurallara göre kontrol eder. Bunu, kodunuz yerine promptlarınız için bir test paketi gibi düşünün.
Bu yazı boyunca dört terim geçecek:
Doğrulamalar olmadan yine "bana iyi görünüyor" noktasına dönersiniz. Onlarla ise her seferinde aynı şekilde çalışan bir "doğru" tanımınız olur.
Artık bir değerlendirme nedir biliyorsunuz; Promptfoo bununla ne yapar bakalım.
Promptfoo’ya üç şey verirsiniz:
Her promptu, her modelde, her test vakasına karşı çalıştırır ve sonuçları puanlar. Tek komutla, promptfoo eval, tüm işlem yürür.
Diyelim bir e-posta yazma promptunuz, iki modeliniz (GPT-5 ve Claude Sonnet 4) ve üç test vakanız (rahat, resmi, acil) var. Promptfoo tüm altı kombinasyonu çalıştırır ve hangileri geçti, hangileri kaldı söyler. Artık her birini tek tek denemek yok.
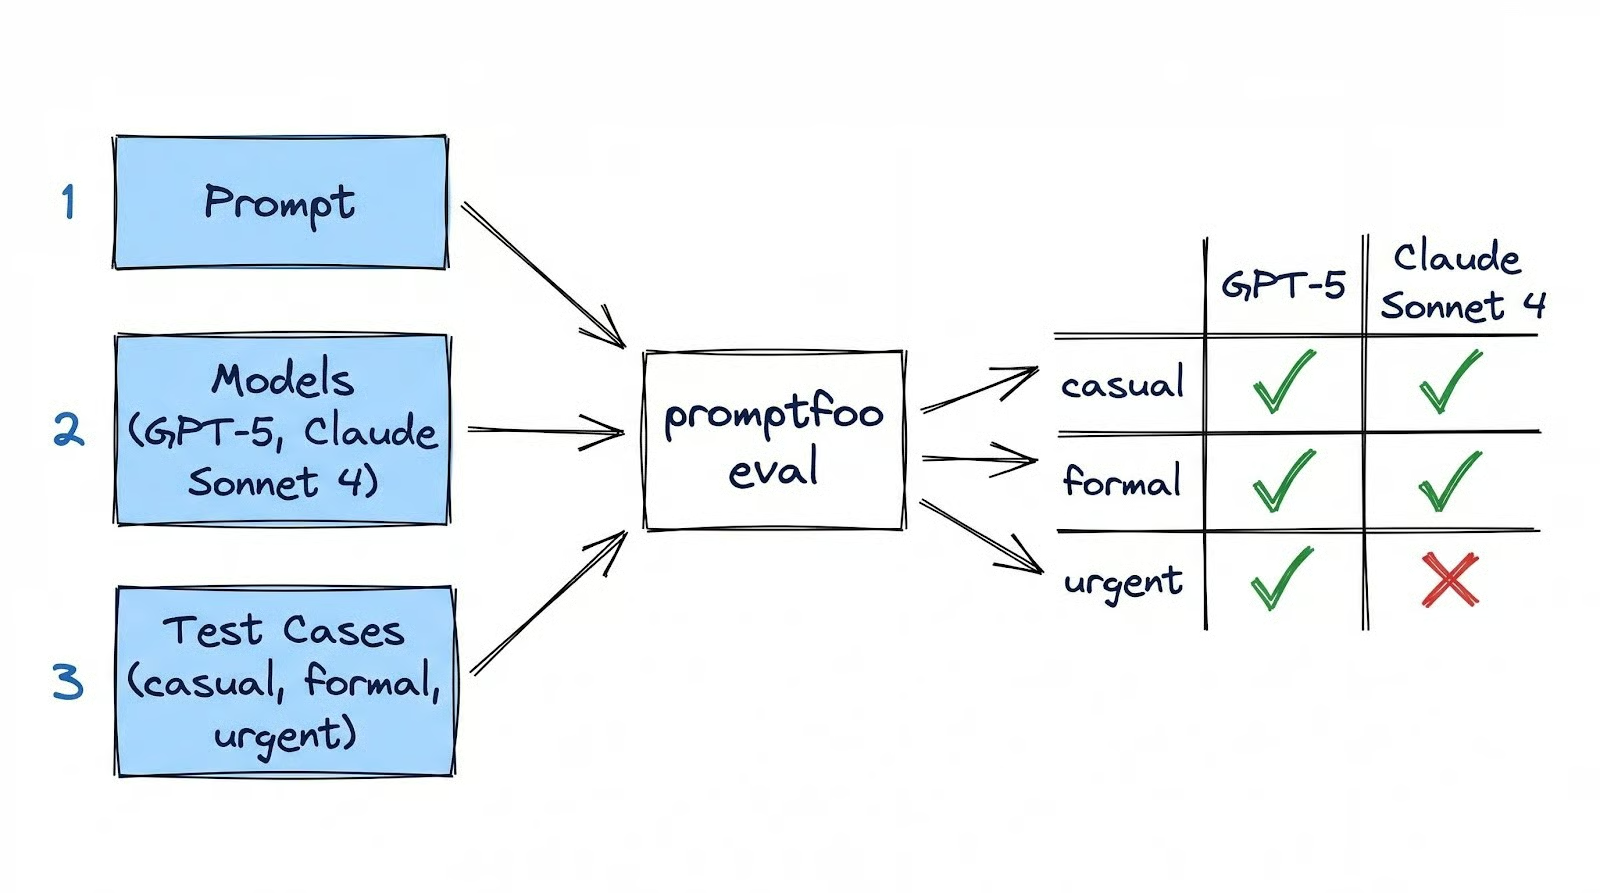
Tüm değerlendirme, promptfooconfig.yaml adlı tek bir YAML dosyasında yaşar ve kodunuzla birlikte sürüm kontrolüne girer. Promptfoo makinenizde çalışır: yapılandırmanız, sonuçlar ve önbellek yereldir. Harici çağrılar yalnızca OpenAI veya Anthropic gibi model API’lerinedir; Promptfoo olsun olmasın zaten yapacağınız çağrılar.
Bu alanda başka araçlar da mevcudur; örneğin DeepEval (Python-native, pytest tarzı), LangSmith (LangChain için üretim izleme) ve Braintrust (ekip panoları). Promptfoo, ücretsiz olması, yerelde çalışması ve sizi sıfırdan çalışan bir değerlendirmeye en hızlı şekilde götürmesi nedeniyle en iyi başlangıç noktasıdır.
Promptfoo’yu global kurun ve yeni bir proje başlatın:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
init komutu sizi etkileşimli bir kurulumdan geçirir. Ne yapmak istediğinizi sorar ("Henüz emin değilim" seçin) ve hangi model sağlayıcısını kullanacağınızı sorar ("[OpenAI] GPT 5, GPT 4.1, ..." seçin).
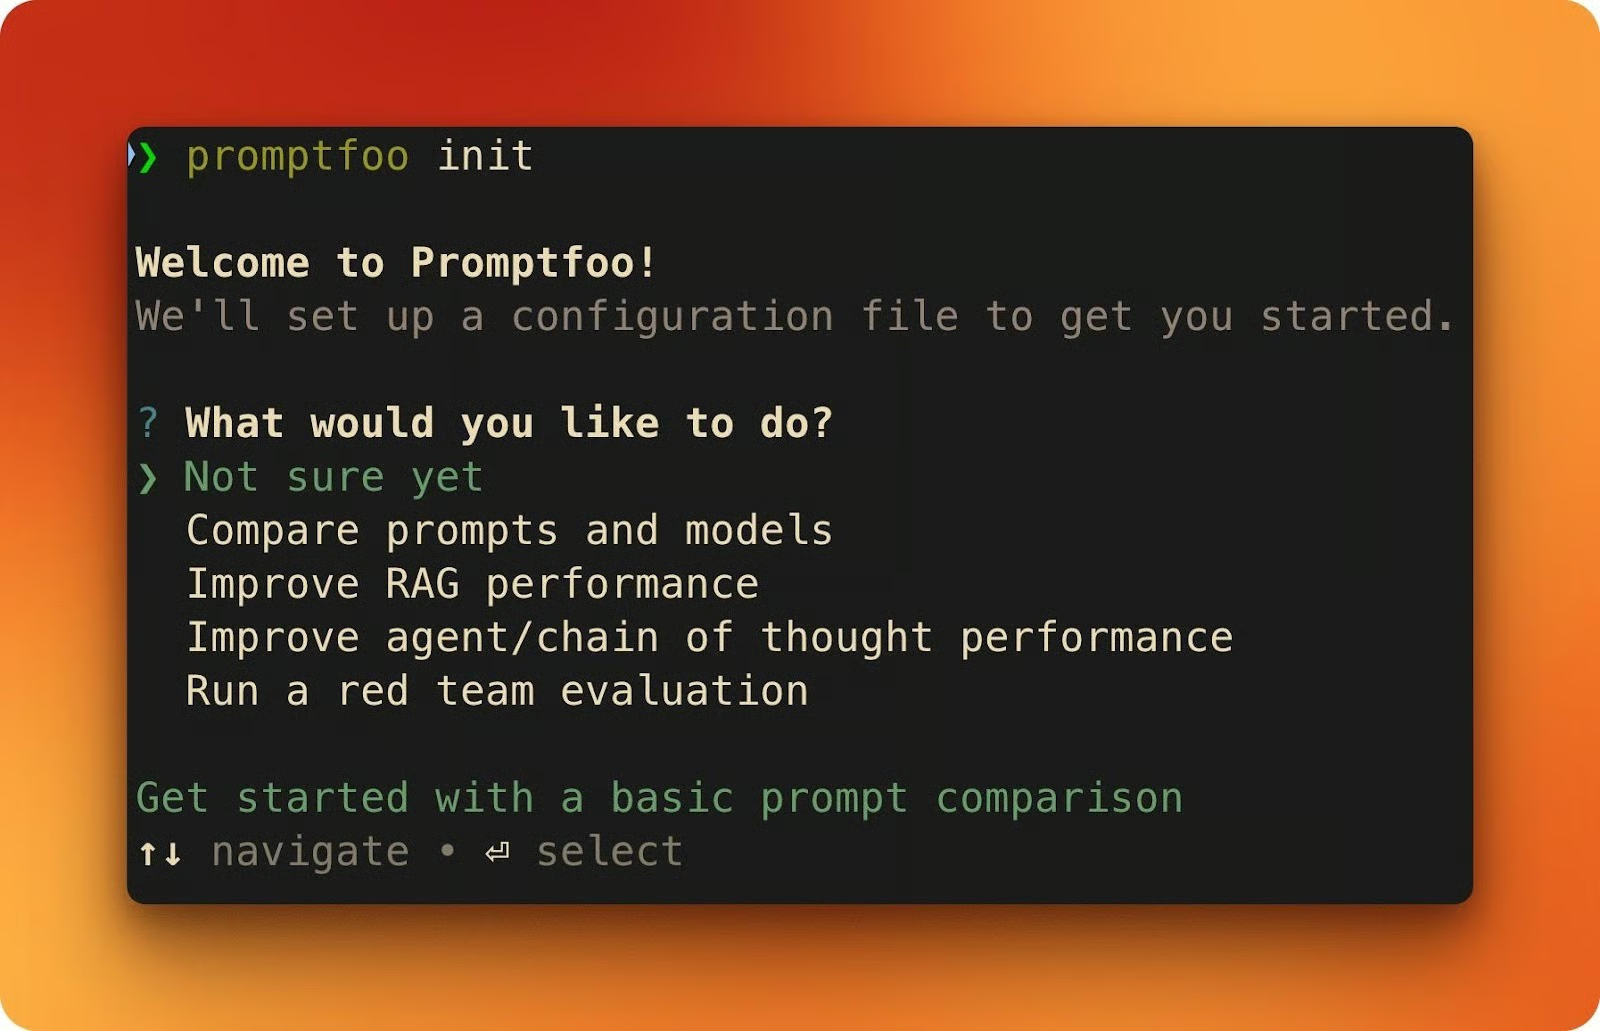
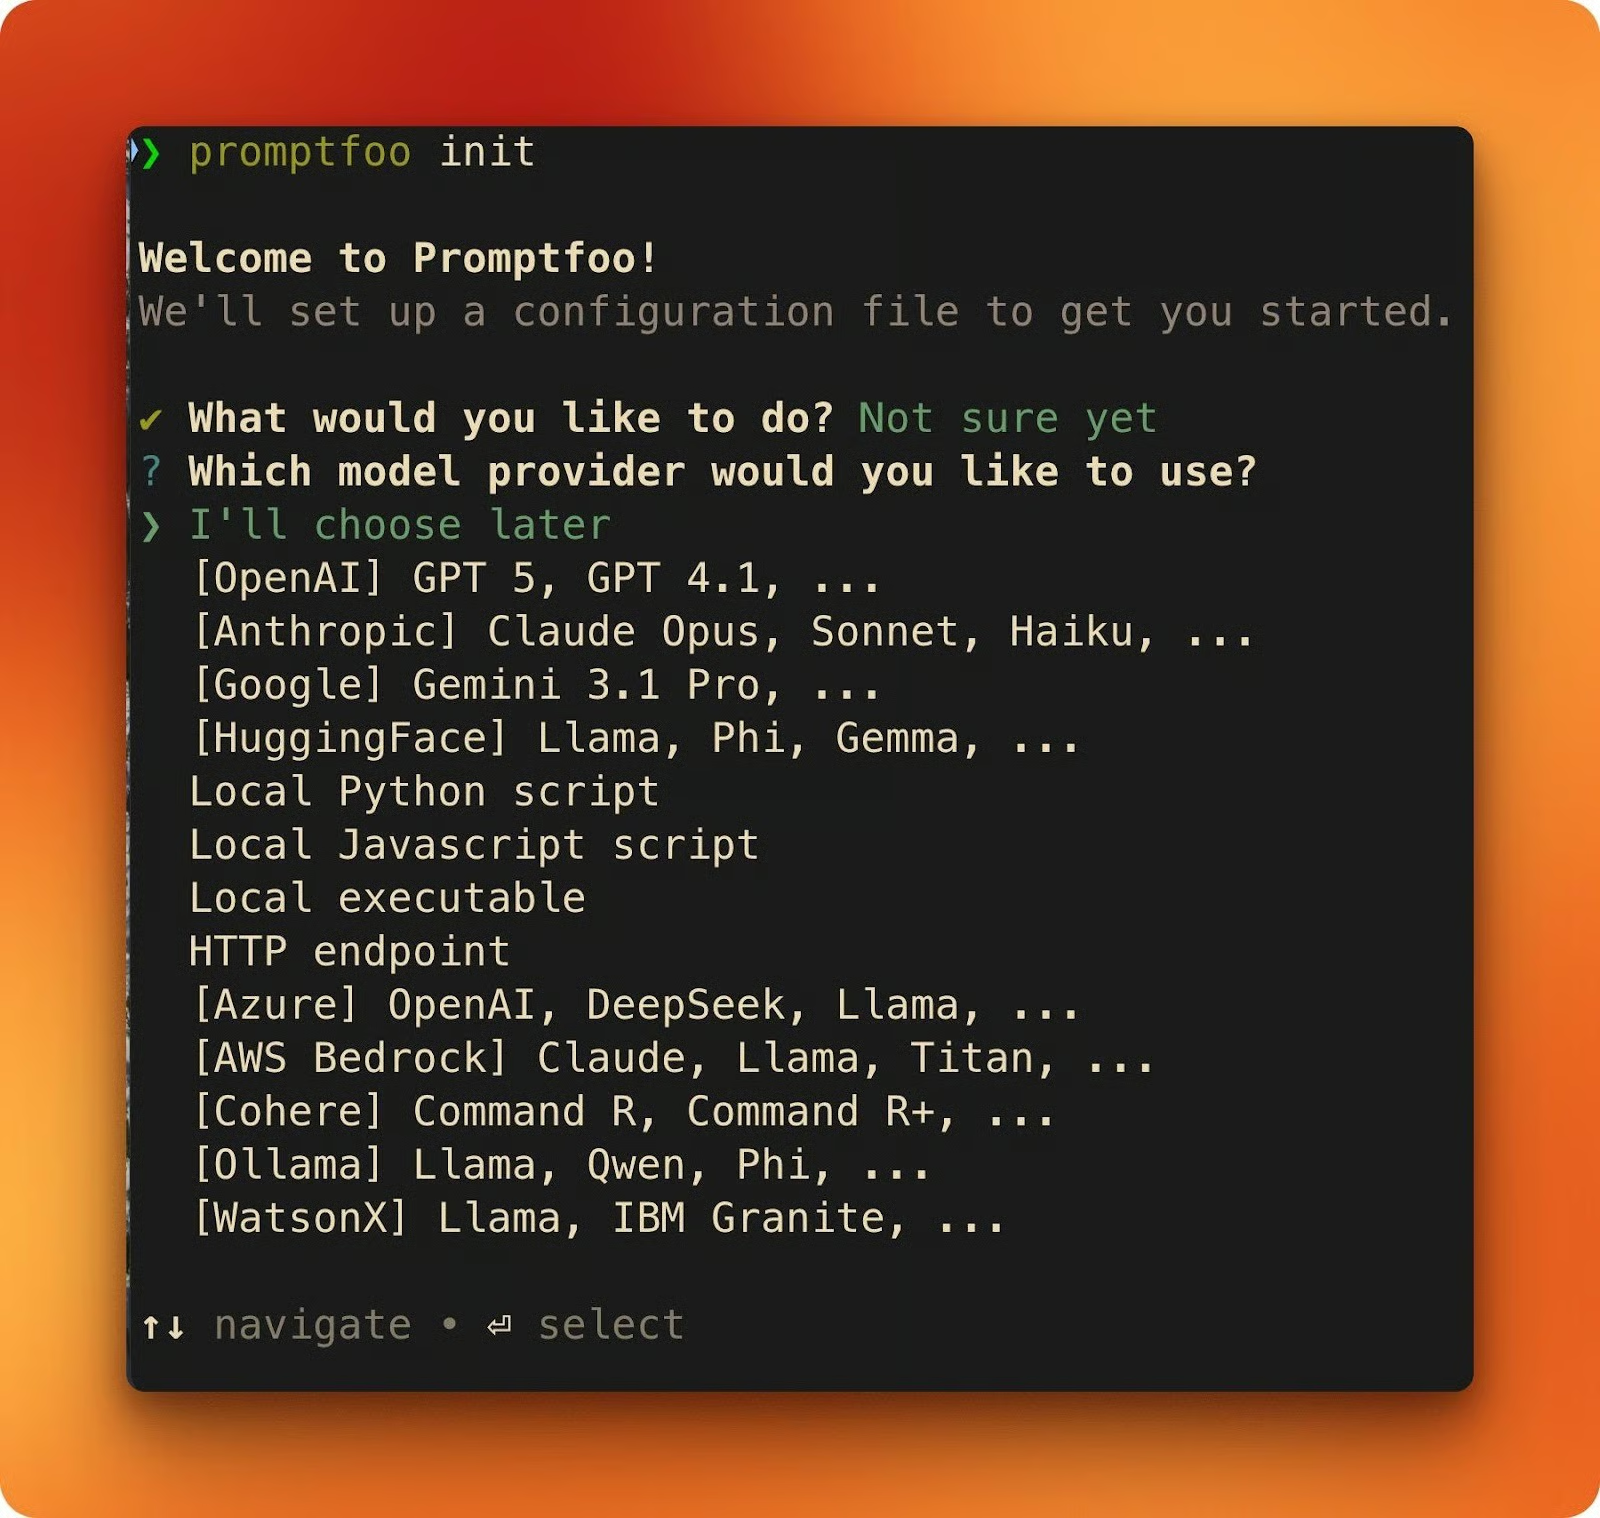
Bittiğinde iki dosyanız olacak: örnek bir promptfooconfig.yaml ve bir README.md.
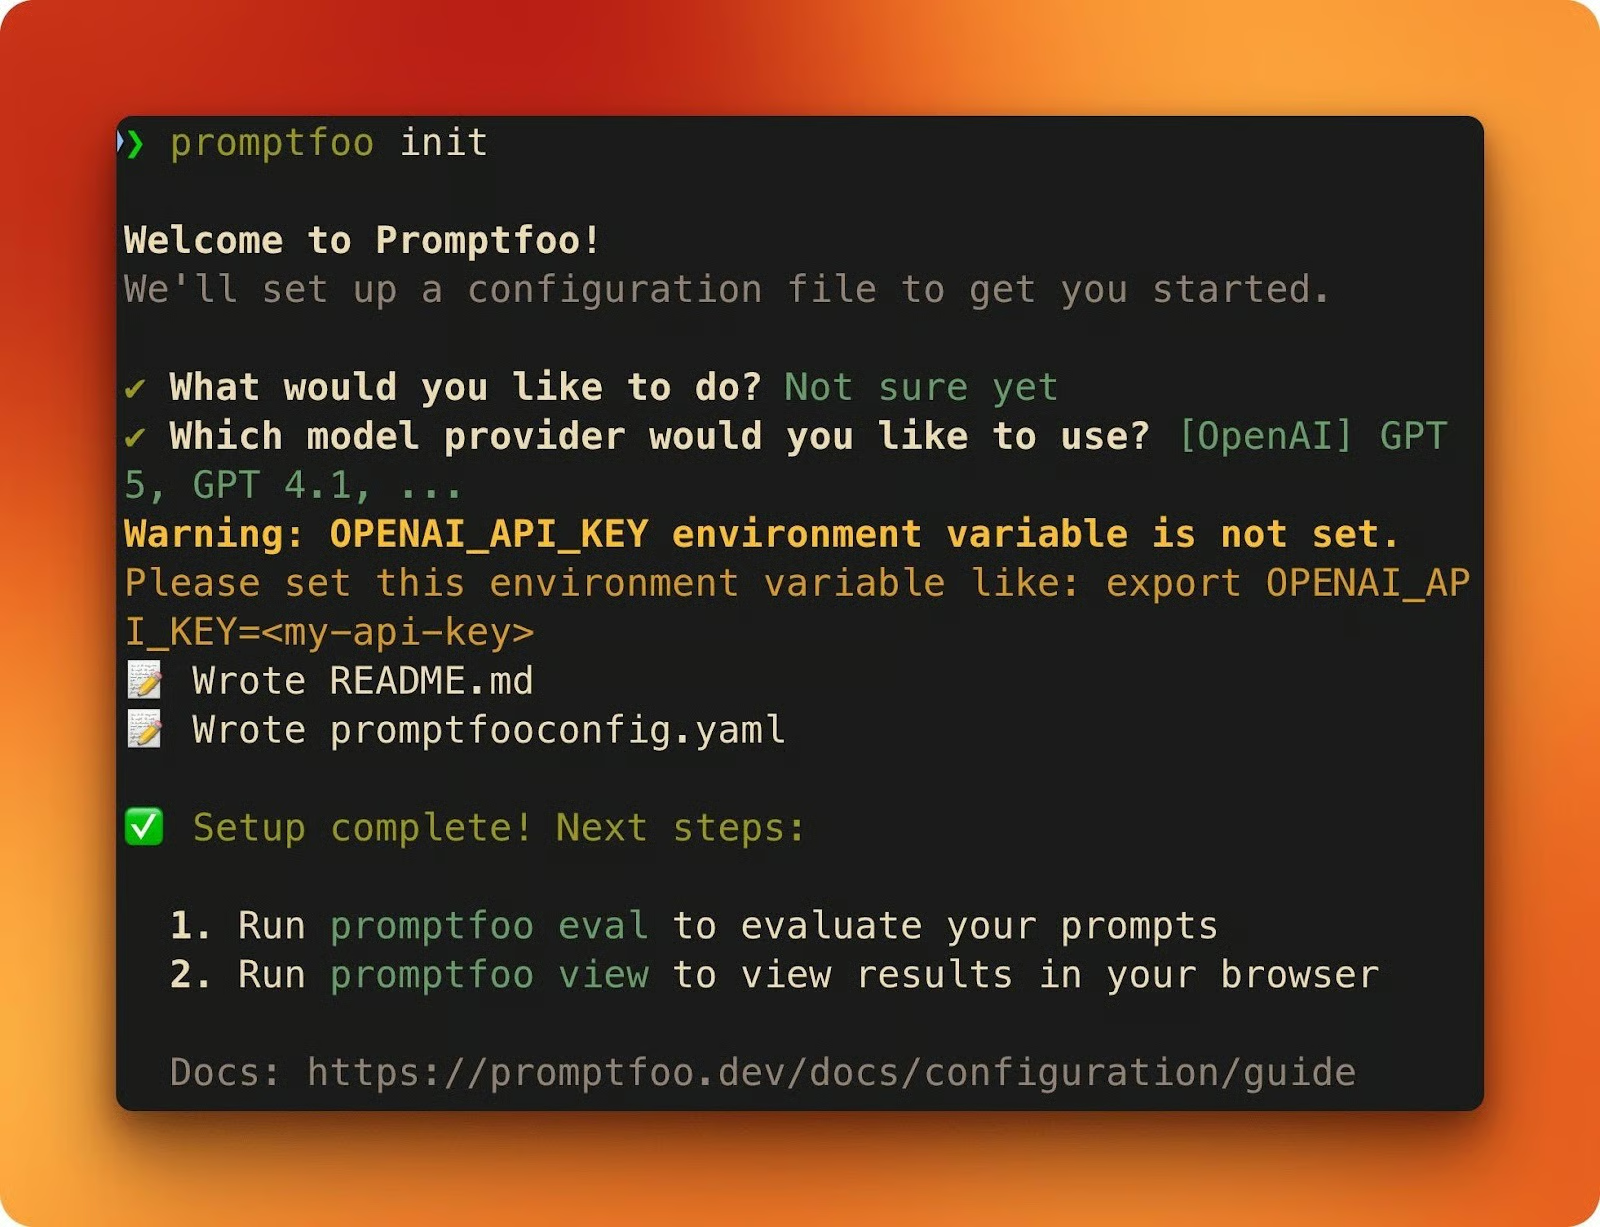
Sırada API anahtarlarınızı ayarlamak var. Değerlendirme çalıştırmak için en az bir tanesine ihtiyacınız var (bu eğitimle birebir ilerlemek için ikisini de edinin):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Yalnızca ANTHROPIC_API_KEY ayarlayıp OpenAI’yi atladıysanız, Promptfoo llm-rubric gibi model destekli doğrulamalar için notlandırma sağlayıcısı olarak otomatikman Claude’u kullanır.
Oluşturulan promptfooconfig.yaml dosyasını açın. Her Promptfoo yapılandırmasının üç yapı taşı vardır:
prompts, prompt şablonlarınızı koyduğunuz yerdir. {{variable}} gibi çift süslü yer tutucular her test vakasından doldurulur.
providers, karşı test etmek istediğiniz modelleri listeler.
tests, girdileri ve her çıktının geçip geçmediğine karar veren doğrulamaları tanımlar.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Bu örnek yapılandırma bir başlangıç noktasıdır. Sonraki bölüm bunu gerçek bir değerlendirmeyle değiştirir ve YAML yapısını ayrıntılı biçimde açıklar.
Görev şu: madde işaretleri ve bir ton (rahat, resmi veya acil) verildiğinde bir e-posta yazmak. Bunu iki modelde test eden bir değerlendirme oluşturacaksınız.
Tüm yapılandırma, hepsini tek parçada görmek isterseniz, bir Gist olarak mevcut. Aşağıda parça parça inşa edeceğiz.
Oluşturulan örneği silin ve yeni bir promptfooconfig.yaml oluşturun. Prompt ve sağlayıcılarla başlayın:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
Prompt şablonunda iki yer tutucu var: {{bullet_points}} ve {{tone}}. Her test vakası bunları farklı değerlerle doldurur. Her sağlayıcıdaki label alanı, sonuçlar görünümünde ham model kimlikleri yerine okunabilir sütun başlıkları verir.
Şimdi bir defaultTest bloğu ekleyin. defaultTest içindeki doğrulamalar tüm test vakalarına otomatik olarak uygulanır; tekrar etmezsiniz:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Bu, 30 saniyeden yavaş gelen tüm yanıtları başarısız kılar. GPT-5 gibi sınır modeller, muhakeme token’ları nedeniyle istek başına 10-20 saniye sürebilir, bu yüzden eşik pay bırakmalı. Bunu bir kez ayarlarsınız, tüm testleri kapsar.
Şimdi test vakalarını ekleyin. Her biri farklı girdiler ve kendi doğrulamalarını sağlar:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Her test vakası iki tür doğrulamayı eşler.
icontains basit bir dize kontrolüdür: çıktı, büyük/küçük harfe duyarsız olarak \"mockups\" içeriyor mu? Hızlıdır, ücretsizdir ve herhangi bir API çağırmaz.
llm-rubric çıktıyı başka bir LLM’e gönderir ve yanıtı rubriğinize göre notlamasını ister. Token maliyeti olur ama dize eşleştirmenin yakalayamadığı şeyleri yakalar; örneğin bir e-postanın gerçekten rahat tonda olup olmadığı gibi.
Değerlendirmeyi çalıştırın:
promptfoo evalArdından sonuçları tarayıcınızda açın:
promptfoo view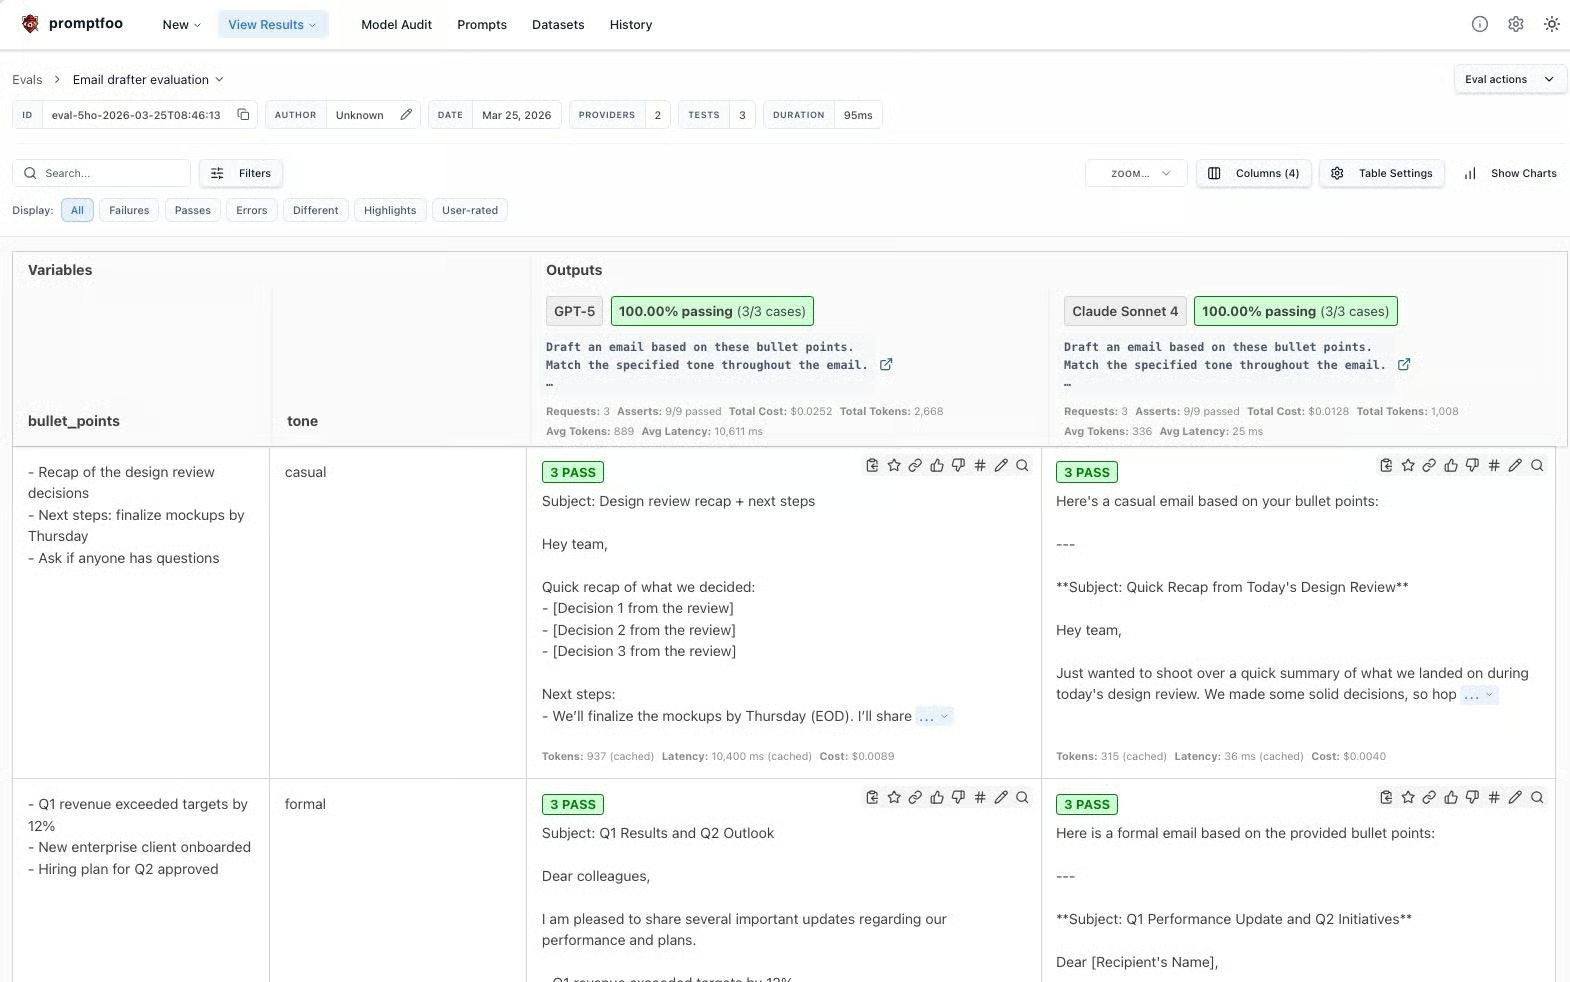
Web arayüzü, sağlayıcıları sütunlar, test vakalarını satırlar olarak gösterir. Her hücrede her doğrulama için geçiş/kalış görünür ve herhangi bir hücreye tıklayarak tam çıktıyı ve notlama ayrıntılarını görebilirsiniz.
Promptfoo, API yanıtlarını varsayılan olarak diskte önbelleğe alır (14 gün TTL), bu nedenle aynı değerlendirmeyi tekrar çalıştırmak maliyetsizdir. Taze yanıtlar istediğinizde --no-cache kullanın.
İlk değerlendirmede icontains ve llm-rubric kullandınız. Bunlar, Promptfoo’nun desteklediği pek çok doğrulama türünden ikisi. Bu bölüm ana kategorileri ele alır; ilerledikçe e-posta yazarı yapılandırmasına doğrulamalar eklemeye devam edeceğiz.
Bunlar yerelde çalışır, maliyetsizdir ve anında sonuç verir.
|
Tür |
Ne kontrol eder |
|
|
Çıktı, bir alt dize içeriyor mu (büyük/küçük harf duyarlı ya da değil) |
|
|
Çıktı bir kalıpla eşleşiyor mu (doldurulmamış |
|
|
Çıktı bir şeyi dışlıyor mu (şablon artıkları, retler, yer tutucu metin) |
|
|
Yanıt N milisaniyenin altında geldi mi |
|
|
Yanıt maliyeti $X’ten az mı |
Daha önce icontains ve latency kullandınız. Şimdi rahat test vakasına not-contains ekleyelim. Model resmi dile yatkınsa, rahat bir "Hey" yerine "Dear" ile başlayabilir. Bunu yakalamak tek satır:
- type: not-contains
  value: \"Dear\"
Bunu rahat test vakasının assert listesine ekleyin ve yeniden çalıştırın. Her iki model de geçmeli: GPT-5 genellikle "Hey team," ile açar, Claude Sonnet 4 da öyle. Eğer herhangi biri "Dear Colleagues," ile başlasaydı, bu doğrulama anında işaretlerdi.
Her doğrulama türü ayrıca bir not- öneki de destekler: not-regex, not-equals vb.
Bunların token maliyeti vardır ancak dize eşleştirmenin yapamadığı yargıları verebilir. İlk değerlendirmede zaten llm-rubric kullandınız. Yazdığınız rubrik işi kurtarır ya da batırır.
"E-posta profesyonel duyuluyor" gibi muğlak bir rubrik değerlendiriciye işe yarar bir şey söylemez. Spesifik bir rubrik ölçülebilir bir şey sunar:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
Bu rubrikle değerlendirmeyi yeniden çalıştırdığınızda, değerlendiricinin çıktısı da spesifikleşir:
Rubriğiniz ne kadar spesifikse, notlama o kadar tutarlı ve faydalı olur.
Promptfoo ayrıca answer-relevance (çıktı soruyu yanıtlıyor mu?) ve similar (gömmeler aracılığıyla bir referansa kosinüs benzerliği) ile birlikte gelir; ikisi de RAG ve arama uygulamaları için faydalıdır.
Yerleşik türler mantığınızı karşılamadığında kendi doğrulamanızı yazın. E-posta yazarı için çıktının makul bir uzunlukta kaldığını kontrol etmek isteyebilirsiniz. İşte 50 ile 200 kelime arasında ise geçen satır içi bir doğrulama:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Bunu rahat test vakasına ekleyin ve yeniden çalıştırın. Benim çalıştırmamda her iki model de geçti: GPT-5 54 kelimede, Claude Sonnet 4 ise 187’de kaldı. Ancak bunu bir sonraki bölüm için aklınızda tutun; çünkü her yerde geçmedi.
Daha karmaşık kontroller için mantığı ayrı bir dosyaya koyun:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
type: python ve value: file://assert_length.py ile yapılandırmanızda referans verin. reason alanı sonuçlar arayüzünde görünür; böylece bir testin neden geçip kaldığını net olarak görürsünüz.
Gerçek bir başarısızlık böyle görünür.
Python kelime sayımı doğrulamasını üç test vakasının hepsine ekleyin ve değerlendirmeyi iki model genelinde çalıştırın. Benim durumda altı kombinasyonun beşi geçti. Claude Sonnet 4.6 aciliyet test vakasını geçmedi (LLM’lerin deterministik olmayan davranışı nedeniyle sizde olabilir ya da olmayabilir).
O çalıştırmada çıktı 207 kelime geldi; sınırı yedi aştı. llm-rubric aslında geçti; e-postanın "acil, doğrudan dil" ve "net eylemler" kullandığını teyit etti. icontains da geçti; çünkü çıktıda "Friday" vardı.
Ama Python kelime sayımı doğrulaması kaldı. Claude, asıl e-postanın öncesine meta bir yorum ("İşte acil tonda, madde işaretlerinize dayalı bir e-posta taslağı:") ekledi ve kelime sayısını 200’ün üstüne itti.
Bu, göz kararıyla asla yakalayamayacağınız türden bir durumdur. E-postanın kendisi düzgün görünüyordu: doğru ton, doğru içerik. Ama model e-postanın parçası olmayan metin eklediği için çıktı fazla uzundu. Tek bir doğrulama bunu yakaladı ve değerlendirme tüm test vakasını işaretledi.
Düzeltme iki yoldan gidebilir: modele önsöz eklememesini söyleyecek şekilde promptu ayarlamak ya da kelime sınırını yükseltmek. Her iki durumda da değerlendirmeyi yeniden çalıştırır ve geçtiğini kontrol edersiniz.
Bu noktada rahat test vakasında dört doğrulama var: icontains, not-contains, llm-rubric ve Python kelime sayımı. Hepsi eşit derecede önemli değil. weight alanı bunu ifade etmenizi sağlar:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
Her doğrulamanın puanı ağırlığıyla çarpılır ve test ağırlıklı bir ortalama hesaplar. threshold geçmek için gereken asgari puanı belirler. Burada ton rubriği, anahtar kelime kontrollerinin iki katı ağırlıkta; kelime sayımı ise yarım ağırlıkta.
Bu ağırlıklarla rahat testi yeniden çalıştırdığınızda her iki model de 1.0 puan alır ve geçer. Ancak llm-rubric (ağırlık 2) kalsaydı ve kelime sayımı (ağırlık 0.5) geçseydi, ağırlıklı puan 0.7 eşiğinin altına düşer ve test kalırdı. Ağırlıklar, Promptfoo’ya en çok neye önem verdiğinizi anlatmanızı sağlar.
Yapılandırmada zaten iki sağlayıcı var; dolayısıyla promptfoo eval GPT-5 ve Claude Sonnet 4’ü tek geçişte test etti. promptfoo view’u açtığınızda sonuçlarda ayrı sütunlar olarak görürsünüz; her test vakası her model için bağımsız puanlanır.
Bizim değerlendirmemizde GPT-5 üç test vakasındaki altı doğrulamanın tamamını geçti. Claude Sonnet 4 beşini geçti, acil e-postadaki kelime sayımında kaldı.
Bu, birkaç promptu elle denerken fark edilmeyecek bir farktır ama ızgarada anında görünür. Aynı girdilerde, aynı doğrulamalara karşı puanları karşılaştırıyorsunuz; "geçen sefer daha iyi hissettirmişti" gibi bellek kırıntılarını değil.
Ancak LLM çıktıları deterministik değildir. Aynı prompt ardışık çalıştırmalarda farklı sonuçlar üretebilir; tek geçiş bir modelin güvenilirce iyi mi yoksa şanslı mı olduğunu söylemez. --repeat bayrağı bunu hesaba katar:
promptfoo eval --repeat 3Bu, test başına sağlayıcı başına üç kez çalıştırır. Bir model ton doğrulamasını iki kez geçip üçüncü çalıştırmada kalıyorsa, tek geçişte kaçıracağınız bir güvenilirlik sinyalidir.
Değerlendirmeleri yerelde çalıştırmak geliştirme sırasında işe yarar ama promptu değiştiren kişinin çalıştırmayı hatırlamasına bağlıdır. Promptfoo’nun resmi bir GitHub Action’ı vardır; her pull request’te değerlendirme paketini çalıştırıp sonuçları yorum olarak paylaşarak bu bağımlılığı kaldırır.
Kurmak için deponuzda bir iş akışı dosyası oluşturun:
mkdir -p .github/workflowsSonra .github/workflows/prompt-eval.yml dosyasını aşağıdaki içerikle oluşturun:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Bunun çalışması için, GitHub deponuzda OPENAI_API_KEY (ve isteğe bağlı olarak ANTHROPIC_API_KEY) anahtarınızı Settings > Secrets and variables > Actions altında depo gizli anahtarı olarak eklemeniz gerekir.
paths filtresi, işlem yalnızca prompts/ içindeki dosyalar değiştirildiğinde tetiklensin demektir. Checkout adımı gereklidir çünkü eylem, dallar arasında prompt dosyalarını karşılaştırmak için dahili olarak git kullanır. Tüm değerlendirme paketini çalıştırır ve sonuçlarla, web görüntüleyici bağlantısını içeren bir PR yorumu paylaşır.
Geçiş/kalış mantığında daha fazla kontrol için JSON çıktısını doğrudan ayrıştırabilirsiniz:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
Buradan iş akışı:
Prompt değişiklikleri, kod değişiklikleriyle aynı "birleştirmeden önce test et" muamelesini görür.
Girişteki e-posta yazarı hâlâ bir ton sorunu yaşıyor olabilir ama artık kullanıcılar fark etmeden önce bunu yakalayan bir test var. Boş bir YAML dosyasıyla başladınız; CI’da iki model genelinde çalışan bir değerlendirme paketiyle bitirdiniz.
Aynı yaklaşım, bir sohbet botu, özetleyici veya sınıflandırma hattı olsun, geliştirdiğiniz herhangi bir LLM özelliğine uygulanır. "İyi çıktı"nın ne olduğuna dair bir doğrulama yazabildiğiniz sürece, gözle kontrol etmek yerine otomatik test edebilirsiniz.
Daha ileri gitmeye hazır olduğunuzda Promptfoo dokümantasyonu bakmaya değer birkaç alanı kapsar:
Red teaming: promptfoo redteam run çok sayıda saldırı eklentisi genelinde prompt enjeksiyonu ve jailbreak taraması yapar
Özel Python sağlayıcılar: Herhangi bir dahili modeli veya ince ayarlı uç noktayı file://my_provider.py ile sarmalayın
CSV test verisi: Satır içi YAML hantal hale geldiğinde file://tests.csv ile test paketinizi ölçekleyin
Test ettiğiniz promptları iyileştirmek istiyorsanız, OpenAI API ile Prompt Mühendisliği kursumuz, her tür yapay zeka geliştirmeye uygulayabileceğiniz birçok önemli tekniği kapsar.
Prompt Mühendisliği Kursları
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.





