Curso
Comprender la ingeniería de prompts
1 h
232.4K
La mayoría de funciones con LLM se prueban igual: pruebas un par de entradas, echas un vistazo a las salidas y lo lanzas.
Lo hiciste con un redactor de emails. Cinco entradas en una ventana de chat, las salidas parecían correctas. Una semana después, la mitad de tus correos de tono informal suenan como si los hubiera escrito un abogado corporativo. Nadie lo detectó porque no había forma de hacerlo. Cambiaste los prompts, pero esas cinco pruebas manuales no se fueron contigo.
Promptfoo es una CLI de código abierto que sustituye ese proceso por evaluaciones estructuradas y repetibles. Defines cómo es una buena salida, eliges tus modelos y ejecutas todas las combinaciones de forma automática.
OpenAI adquirió el proyecto en marzo de 2026, y sigue con licencia MIT y compatibilidad con decenas de proveedores. Más de 350.000 desarrolladores lo usan, incluidos equipos de más del 25% de las empresas Fortune 500.
Este tutorial te guía para configurar Promptfoo y crear tu primera suite de evaluación desde cero. Usaremos un redactor de emails como ejemplo continuo, probándolo con GPT-5 y Claude Sonnet 4.6, y dejaremos todo conectado a GitHub Actions al final.
Antes de entrar en la herramienta, necesitas entender cómo funcionan las pruebas con LLM. Es distinto a probar código normal.
Si has probado una función, conoces el patrón: le das una entrada y verificas que la salida sea exactamente lo esperado. Con los LLM no funciona así. El mismo prompt puede generar textos distintos en cada ejecución, así que no puedes comprobar una coincidencia exacta.
En su lugar, compruebas propiedades de la salida:
Eso es lo que hace una evaluación de LLM. Ejecuta tu prompt con un conjunto de entradas y valida cada salida contra reglas que defines. Piénsalo como una suite de tests para tus prompts en lugar de para tu código.
Cuatro términos aparecerán a lo largo del artículo:
Sin aserciones, vuelves al "a mí me parece bien". Con ellas, tienes una definición de "correcto" que se ejecuta igual cada vez.
Ahora que sabes qué es una evaluación, esto es lo que hace Promptfoo con ella.
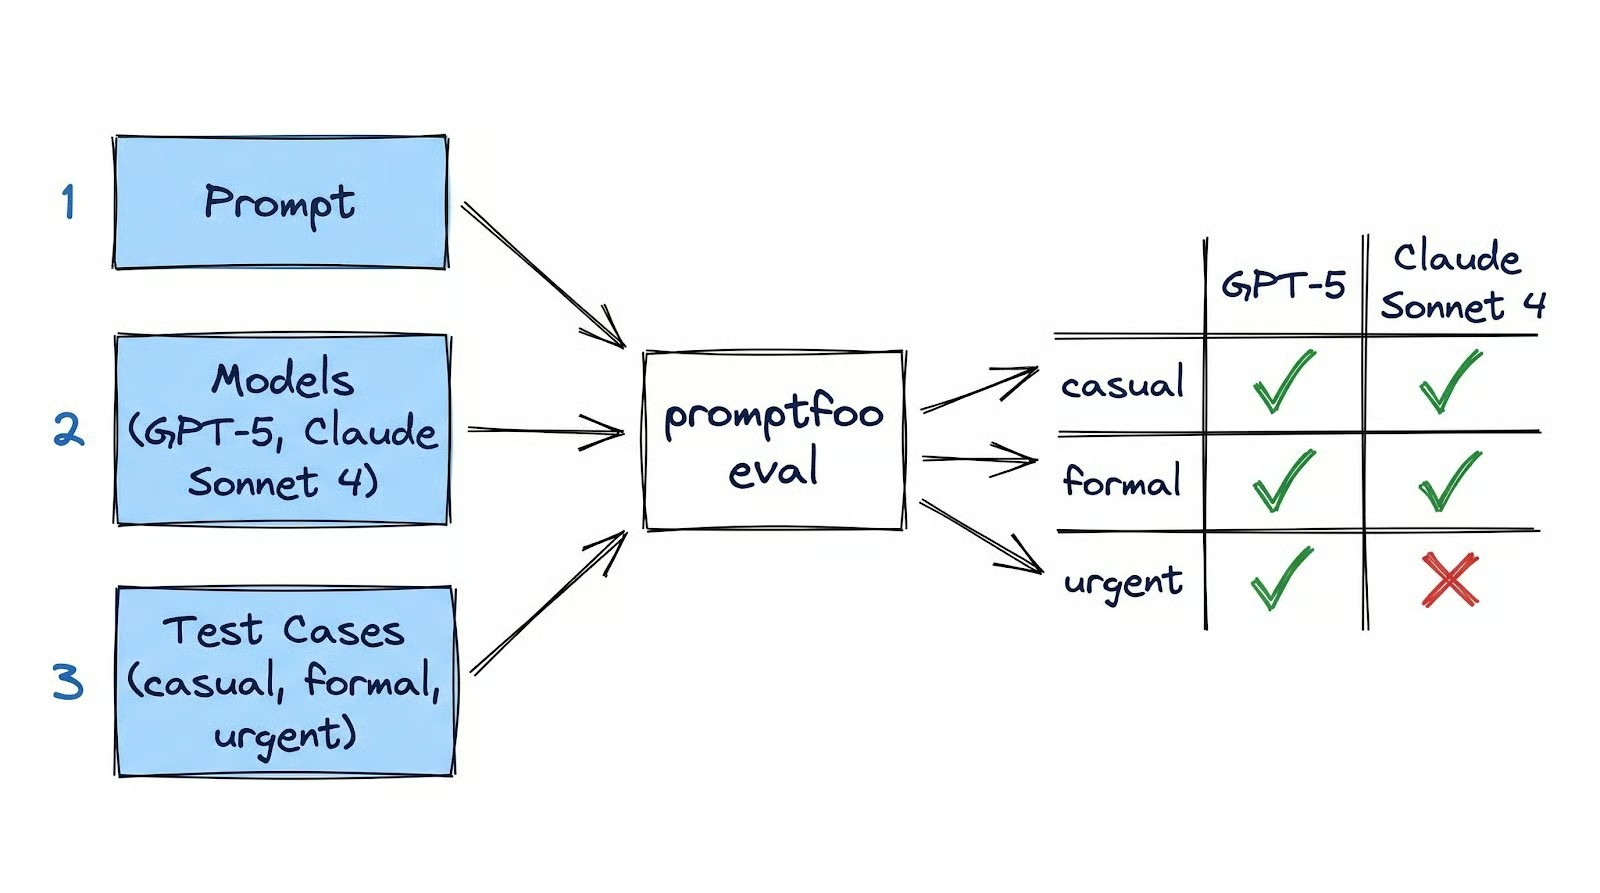
Le das a Promptfoo tres cosas:
Ejecuta cada prompt con cada modelo para cada caso de prueba y puntúa los resultados. Un solo comando, promptfoo eval, lo hace todo.
Imagina que tienes un prompt para redactar emails, dos modelos (GPT-5 y Claude Sonnet 4) y tres casos de prueba (informal, formal y urgente). Promptfoo ejecuta las seis combinaciones y te dice cuáles pasan y cuáles fallan. Se acabó ir probando a mano.
Toda la evaluación vive en un único archivo YAML llamado promptfooconfig.yaml que versionas junto a tu código. Promptfoo se ejecuta en tu máquina: tu configuración, resultados y caché permanecen locales. Las únicas llamadas externas son a APIs de modelos como OpenAI o Anthropic, que harías con o sin Promptfoo.
Existen otras herramientas en este espacio, como DeepEval (nativa en Python, estilo pytest), LangSmith (monitorización en producción para LangChain) y Braintrust (paneles de equipo). Promptfoo es el mejor punto de partida porque es gratis, corre en local y te lleva de cero a una evaluación funcionando más rápido que ninguna.
Instala Promptfoo de forma global e inicializa un proyecto nuevo:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
El comando init te guía por una configuración interactiva. Pregunta qué te gustaría hacer (elige "Not sure yet") y qué proveedor de modelo usar (elige "[OpenAI] GPT 5, GPT 4.1, ...").
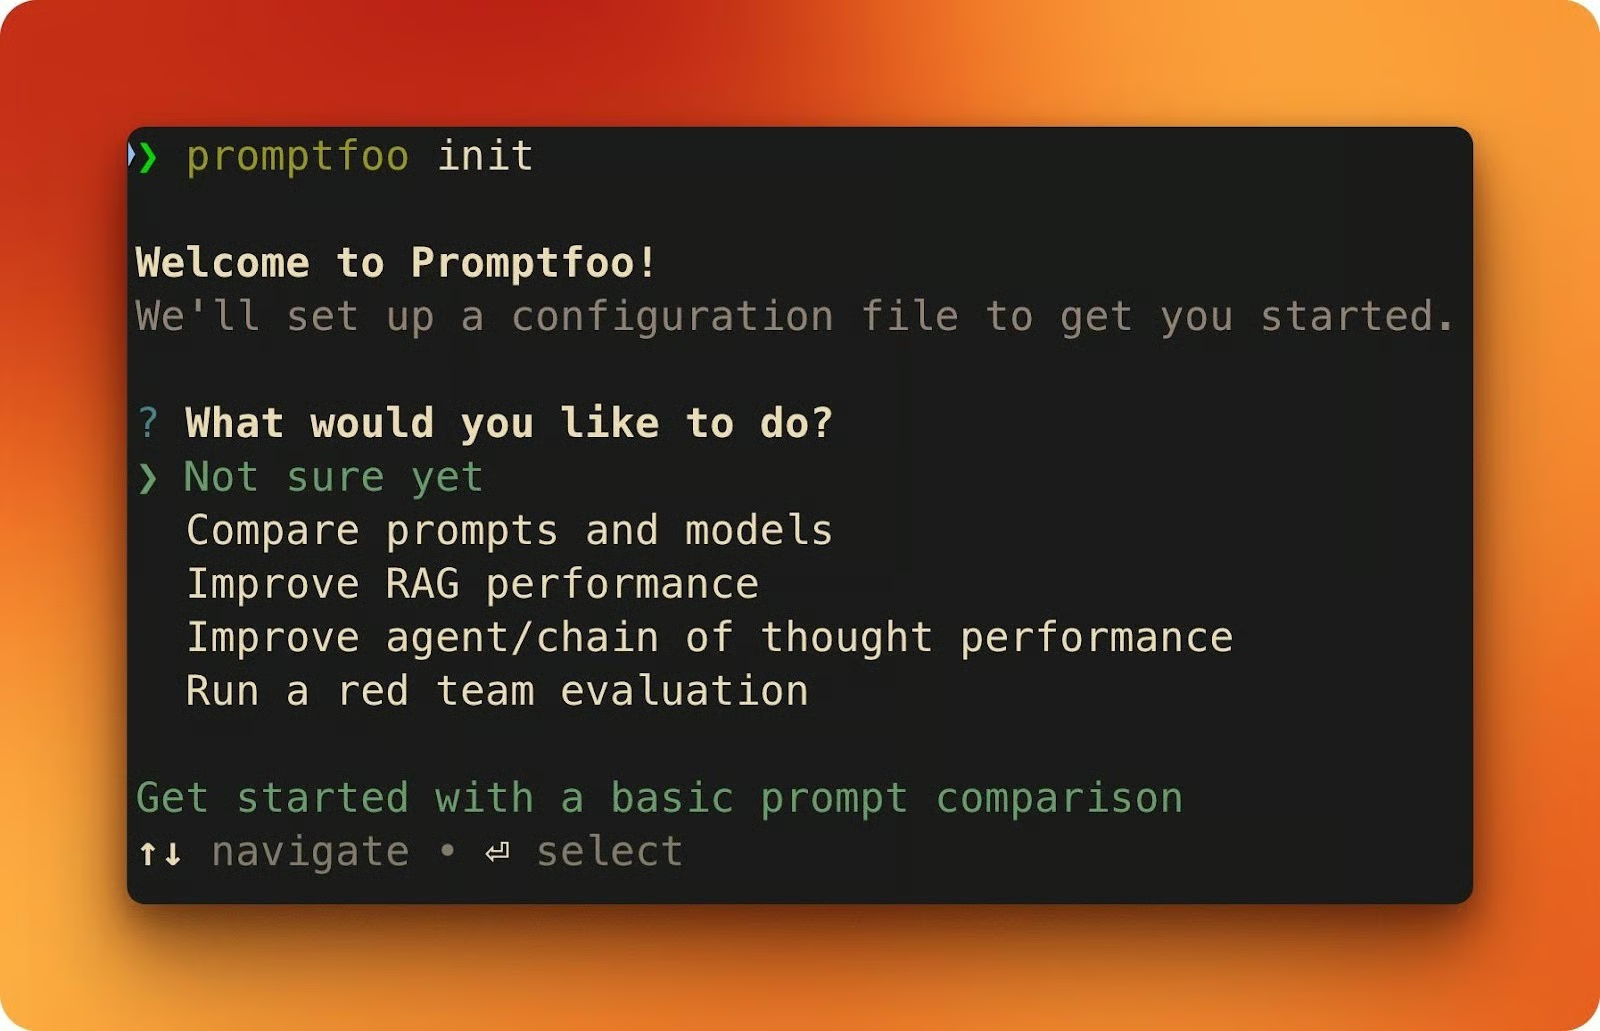
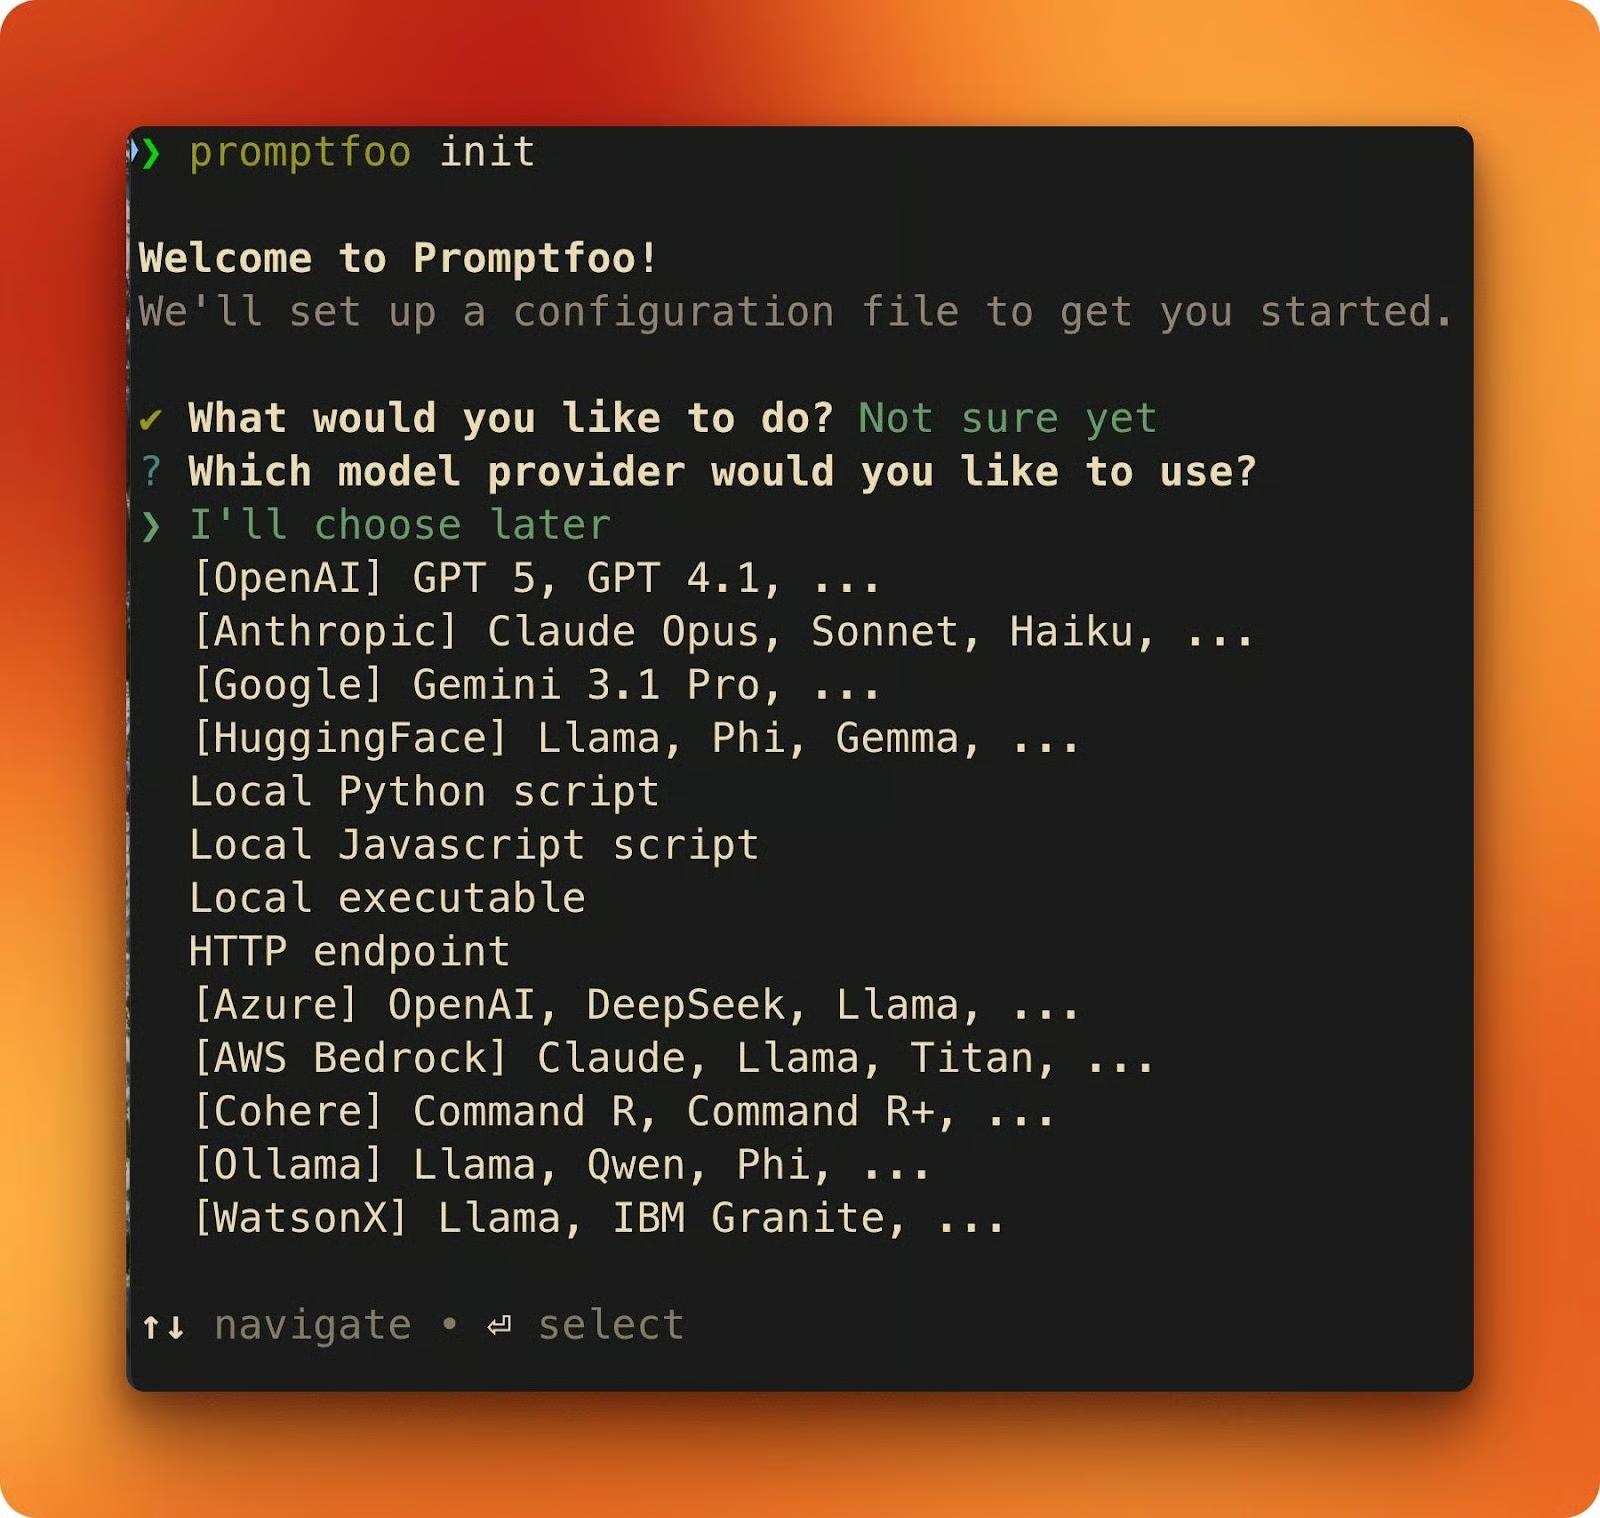
Al terminar, tendrás dos archivos: un promptfooconfig.yaml de ejemplo y un README.md.
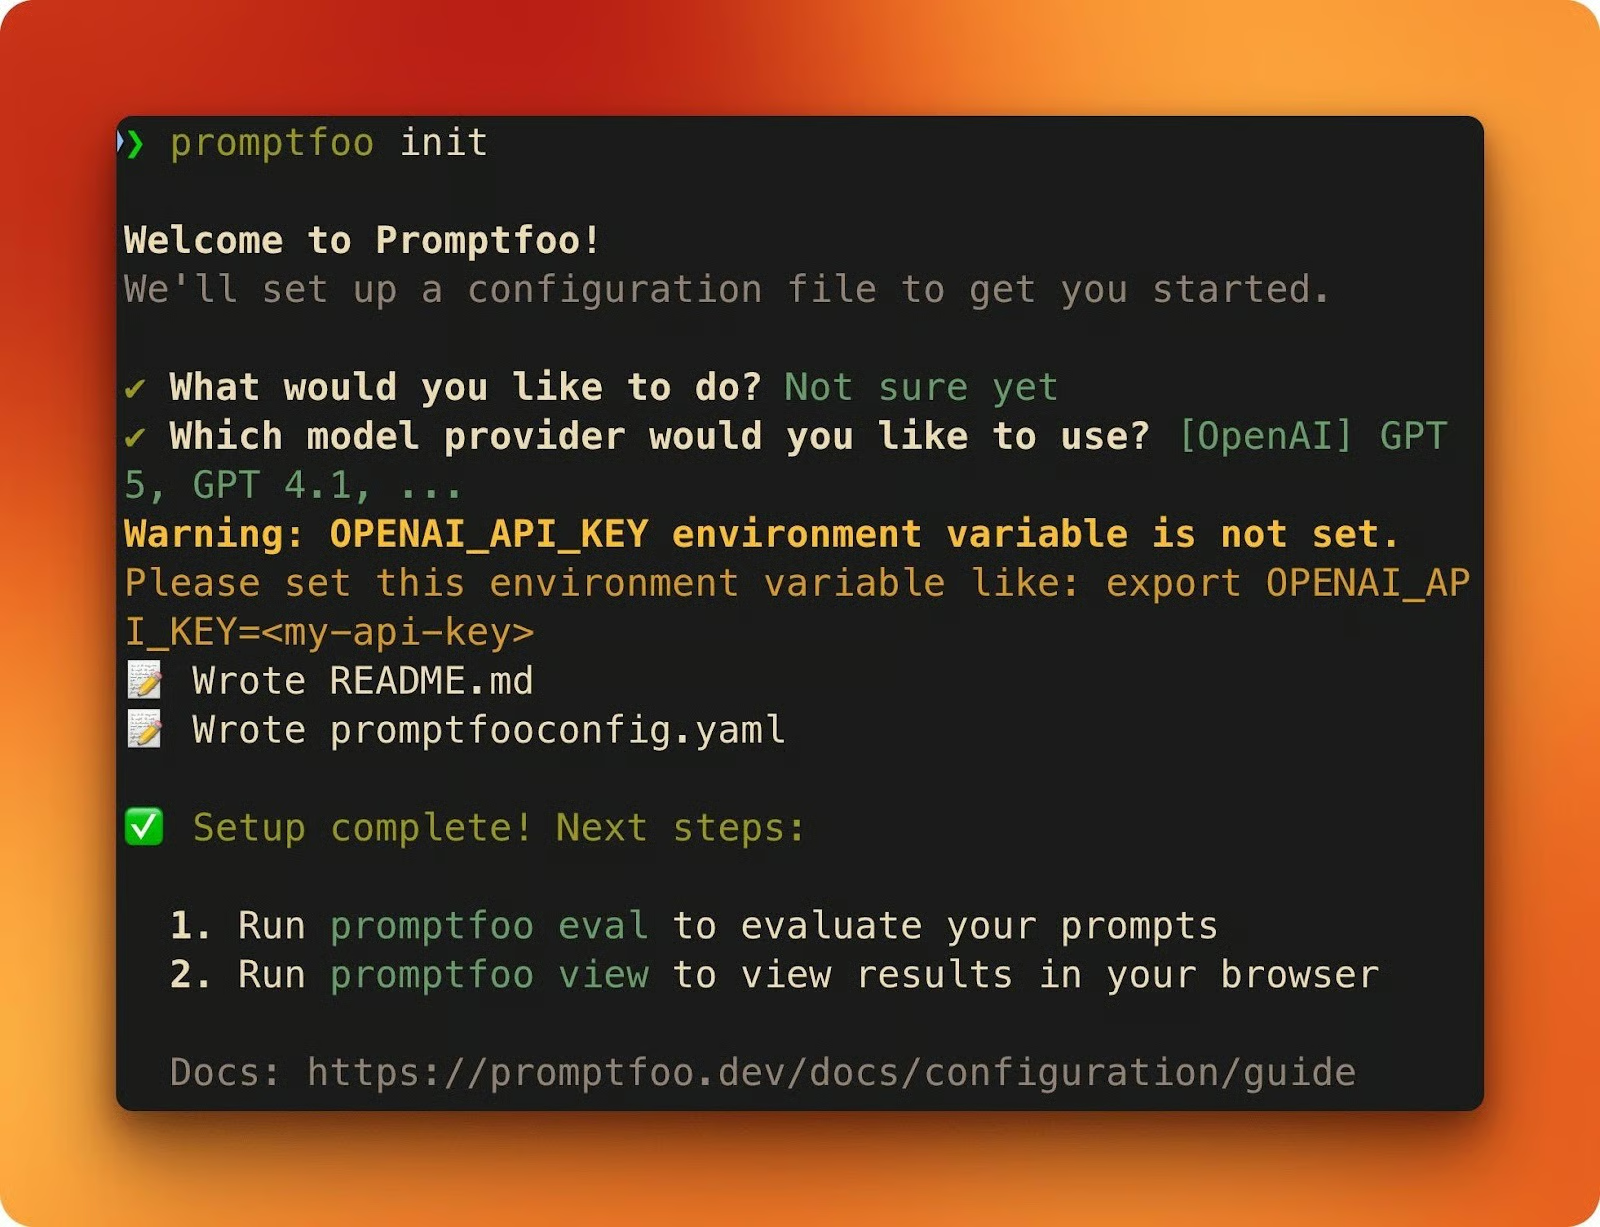
Después, configura tus claves de API. Necesitas al menos una para ejecutar evaluaciones (mejor ambas para seguir este tutorial):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Si solo estableces ANTHROPIC_API_KEY y omites OpenAI, Promptfoo usa automáticamente Claude como proveedor de evaluación para aserciones asistidas por modelo como llm-rubric.
Abre el promptfooconfig.yaml generado. Toda configuración de Promptfoo tiene tres bloques:
prompts es donde van tus plantillas de prompt. Los marcadores con doble llave como {{variable}} se rellenan desde cada caso de prueba.
providers lista los modelos contra los que quieres probar.
tests define las entradas y las aserciones que deciden si cada salida pasa o falla.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Esta configuración de ejemplo es un punto de partida. En la siguiente sección la sustituimos por una evaluación real y explicamos la estructura YAML en detalle.
La tarea es esta: dados unos puntos clave y un tono (informal, formal o urgente), redacta un email. Construirás una evaluación que pruebe esto con dos modelos.
La configuración completa está disponible como Gist si quieres verla de una vez. Aquí la montamos por partes.
Elimina el ejemplo generado y crea un nuevo promptfooconfig.yaml. Empieza con el prompt y los proveedores:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
La plantilla de prompt tiene dos marcadores: {{bullet_points}} y {{tone}}. Cada caso de prueba los rellena con valores distintos. El campo label en cada proveedor te da cabeceras legibles en la vista de resultados en lugar de IDs de modelo.
Añade ahora un bloque defaultTest. Las aserciones dentro de defaultTest se aplican automáticamente a todos los casos de prueba, sin repetirlas:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Esto falla cualquier respuesta más lenta de 30 segundos. Los modelos punteros como GPT-5 pueden tardar 10-20 segundos por petición por los tokens de razonamiento, así que conviene margen. Lo defines una vez y cubre todos los tests.
Ahora añade los casos de prueba. Cada uno aporta entradas distintas y sus propias aserciones:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Cada caso de prueba combina dos tipos de aserciones.
icontains es una comprobación sencilla de cadena: ¿incluye la salida "mockups" sin distinguir mayúsculas? Es rápida, gratis y no llama a ninguna API.
llm-rubric envía la salida a otro LLM y le pide que la valore según tu rúbrica. Consume tokens, pero capta cosas que la coincidencia de cadenas no, como si un email realmente suena informal.
Ejecuta la evaluación:
promptfoo evalLuego abre los resultados en tu navegador:
promptfoo view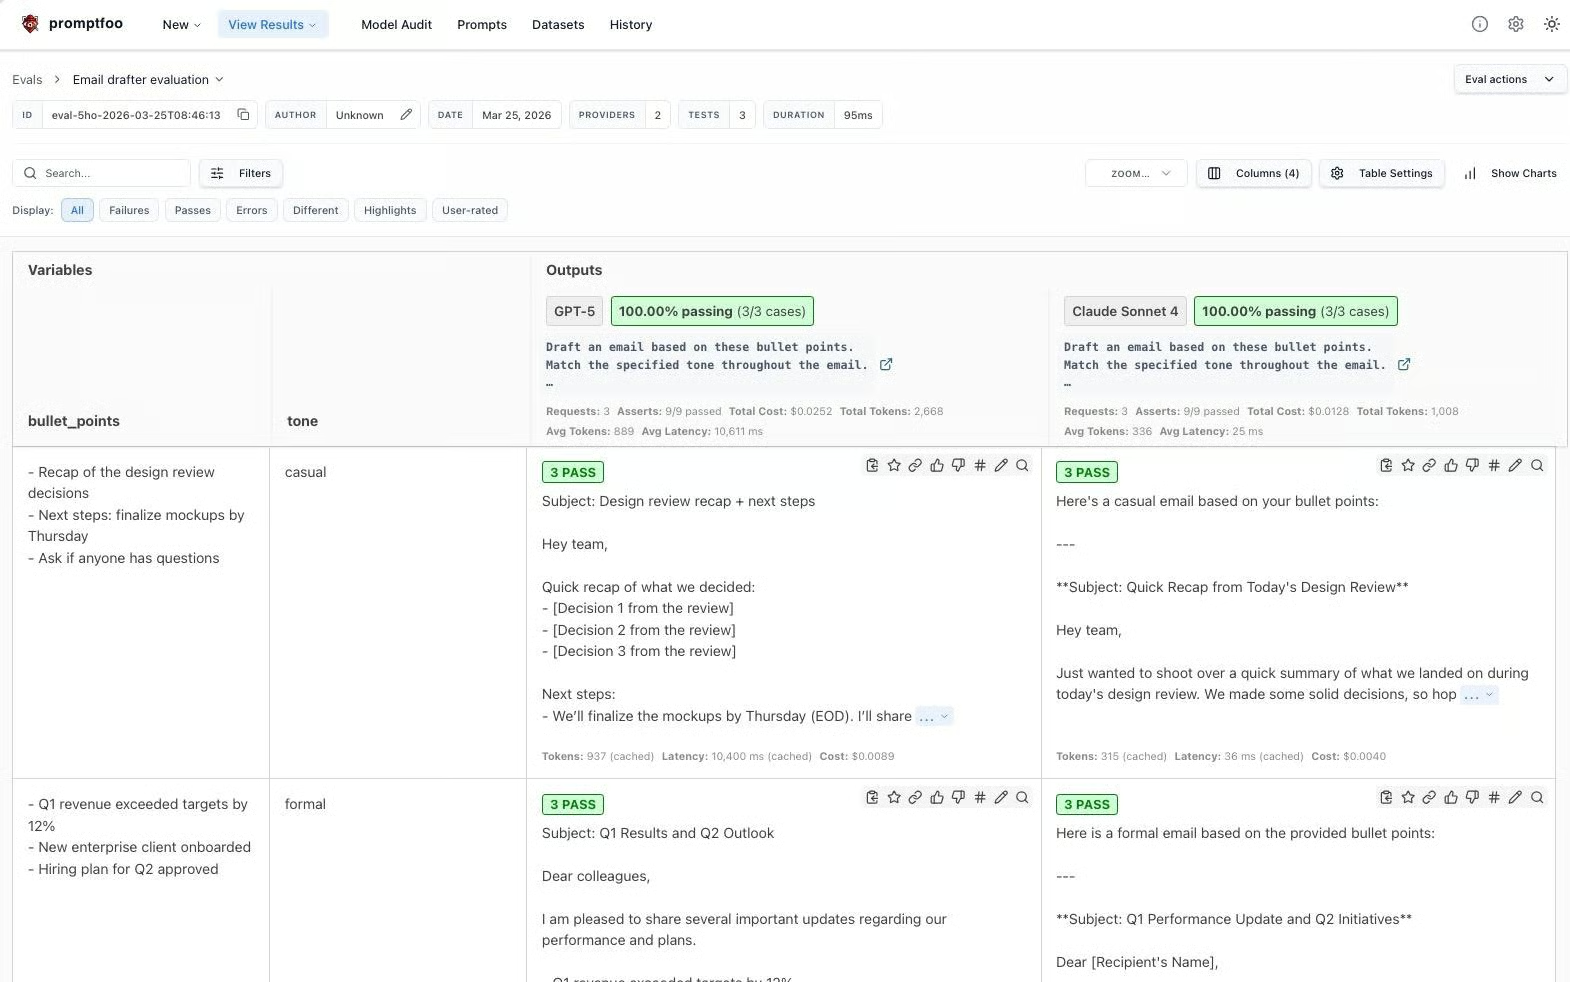
La interfaz web muestra los proveedores como columnas y los casos de prueba como filas. Cada celda indica aprobado/suspenso para cada aserción, y puedes hacer clic para ver la salida completa y los detalles de la evaluación.
Promptfoo guarda en caché por defecto las respuestas de las APIs en disco (TTL de 14 días), así que volver a ejecutar la misma evaluación no cuesta nada. Usa --no-cache cuando quieras respuestas nuevas.
En la primera evaluación usamos icontains y llm-rubric. Son dos de muchos tipos de aserciones que admite Promptfoo. Esta sección repasa las categorías principales, y añadiremos aserciones a la configuración del redactor de emails sobre la marcha.
Se ejecutan en local, no cuestan y dan resultados al instante.
|
Tipo |
Qué comprueba |
|
|
La salida incluye una subcadena (sensible o no a mayúsculas) |
|
|
La salida coincide con un patrón (detecta |
|
|
La salida excluye algo (artefactos de plantilla, negativas, texto de marcador) |
|
|
La respuesta llegó en menos de N milisegundos |
|
|
La respuesta cuesta menos de $X |
Ya has usado icontains y latency. Añadamos not-contains al caso informal. Si el modelo tiende al lenguaje formal, puede empezar con "Dear" en lugar de algo más informal como "Hey". Detectarlo es una línea:
- type: not-contains
  value: \"Dear\"
Añádelo a la lista assert del caso informal y vuelve a ejecutar. Ambos modelos deberían pasar: GPT-5 suele abrir con "Hey team," y Claude Sonnet 4 también. Si alguno hubiese empezado con "Dear Colleagues", la aserción lo marcaría al instante.
Cada tipo de aserción también admite el prefijo not-: not-regex, not-equals, etc.
Consumen tokens, pero juzgan aspectos que la coincidencia de cadenas no. Ya usaste llm-rubric en la primera evaluación. La rúbrica que escribas lo es todo.
Una rúbrica vaga como "El email suena profesional" no da nada útil al evaluador. Una específica le da algo que medir:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
Al reejecutar con esta rúbrica, la salida del evaluador también se vuelve específica:
Cuanto más específica sea tu rúbrica, más consistente y útil será la evaluación.
Promptfoo también incluye answer-relevance (¿la salida responde a la pregunta?) y similar (similaridad coseno contra una referencia vía embeddings), ambas útiles para RAG y aplicaciones de búsqueda.
Cuando los tipos incorporados no cubren tu lógica, escribe las tuyas. Para el redactor, quizá quieras comprobar que las salidas se mantengan dentro de una longitud razonable. Aquí tienes una aserción en línea que aprueba si el email tiene entre 50 y 200 palabras:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Añádela al caso informal y vuelve a ejecutar. En mi ejecución, ambos modelos pasan: GPT-5 con 54 palabras y Claude Sonnet 4 con 187. Pero recuerda esta aserción para la siguiente sección, porque no pasó en todas partes.
Para comprobaciones más complejas, pon la lógica en un archivo aparte:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
Haz referencia en tu configuración con type: python y value: file://assert_length.py. El campo reason aparece en la interfaz de resultados para que veas exactamente por qué pasó o falló.
Así se ve un fallo real.
Añade la aserción de recuento de palabras en Python a los tres casos de prueba y ejecuta la evaluación completa en ambos modelos. En mi caso, cinco de seis combinaciones pasaron. Claude Sonnet 4.6 no pasó el caso de urgencia (puede que en tu máquina no ocurra, dado el carácter no determinista de los LLM).
En esa ejecución, la salida tenía 207 palabras, siete por encima del límite. La llm-rubric sí pasó, confirmando que el email usaba "lenguaje urgente y directo" con "acciones claras". La icontains también, porque "Friday" estaba en la salida.
Pero la aserción de palabras en Python falló. Claude añadió un preámbulo ("Here is a draft email based on your bullet points with an urgent tone:") antes del email en sí, superando las 200 palabras.
Esto es lo que no captarías a simple vista. El email sonaba bien: tono y contenido correctos. Pero la salida era demasiado larga porque el modelo añadió texto que no formaba parte del email. Una aserción lo detectó y la evaluación marcó el caso completo.
La solución puede ser doble: ajustar el prompt para indicar que no incluya preámbulos, o subir el límite de palabras. En ambos casos, vuelves a ejecutar y compruebas que pasa.
A estas alturas, el caso informal tiene cuatro aserciones: icontains, not-contains, llm-rubric y la de palabras en Python. No todas importan igual. El campo weight te deja expresarlo:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
La puntuación de cada aserción se multiplica por su peso y el test calcula una media ponderada. El threshold marca la nota mínima para aprobar. Aquí, la rúbrica de tono cuenta el doble que los chequeos de palabras clave, y el recuento de palabras la mitad.
Al reejecutar el caso informal con estos pesos, ambos modelos puntúan 1,0 y aprueban. Pero si llm-rubric hubiese fallado (peso 2) mientras el recuento de palabras pasaba (peso 0,5), la media ponderada caería por debajo de 0,7 y el test fallaría. Los pesos te permiten decirle a Promptfoo qué te importa más.
La configuración ya tiene dos proveedores, así que promptfoo eval probó GPT-5 y Claude Sonnet 4 en una sola pasada. Abre promptfoo view y los verás como columnas separadas en los resultados, con cada caso puntuado de forma independiente por modelo.
En mi ejecución, GPT-5 pasó las seis aserciones en los tres casos. Claude Sonnet 4 pasó cinco pero falló el recuento de palabras en el email urgente.
Es el típico matiz que no verías probando unos cuantos prompts a mano, pero que aparece de inmediato en la cuadrícula. Estás comparando puntuaciones contra las mismas aserciones y entradas, no tu recuerdo de qué modelo “parecía mejor” la última vez.
Las salidas de LLM no son deterministas. El mismo prompt puede producir resultados distintos en ejecuciones consecutivas, y una sola pasada no te dice si un modelo es consistentemente bueno o tuvo suerte. La bandera --repeat ayuda con esto:
promptfoo eval --repeat 3Esto ejecuta cada caso tres veces por proveedor. Si un modelo pasa la aserción de tono dos veces y falla en la tercera, es una señal de fiabilidad que te perderías en una sola pasada.
Ejecutar evaluaciones en local funciona durante el desarrollo, pero depende de que quien cambie el prompt se acuerde de ejecutarlas. Promptfoo tiene una GitHub Action oficial que elimina esa dependencia: ejecuta tu suite en cada pull request y publica los resultados como comentario.
Para configurarlo, crea un workflow en tu repo:
mkdir -p .github/workflowsDespués crea .github/workflows/prompt-eval.yml con este contenido:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Antes de que funcione, debes añadir tu OPENAI_API_KEY (y opcionalmente ANTHROPIC_API_KEY) como secretos del repositorio en tu repo de GitHub, en Settings > Secrets and variables > Actions.
El filtro paths hace que la action solo se dispare cuando alguien cambia archivos en prompts/. El paso de checkout es necesario porque la action usa git internamente para hacer diff de los prompts entre ramas. Ejecuta la suite completa y publica un comentario en el PR con los resultados y un enlace al visor web.
Para más control sobre la lógica de aprobado/fallo, puedes parsear el JSON directamente:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
El flujo a partir de aquí:
Los cambios en prompts reciben el mismo trato de pruebas antes de fusionar que los cambios de código.
El redactor de emails del inicio sigue con problemas de tono, pero ahora hay una prueba que los detecta antes que tus usuarios. Empezaste con un YAML en blanco y terminaste con una suite de evaluación ejecutándose en dos modelos y en CI.
El mismo enfoque aplica a cualquier funcionalidad con LLM que construyas, sea un chatbot, un resumidor o un pipeline de clasificación. Mientras puedas escribir una aserción para definir qué es una "buena salida", puedes probarlo automáticamente en lugar de a ojo.
Cuando quieras ir más allá, la documentación de Promptfoo cubre varias áreas interesantes:
Red teaming: promptfoo redteam run busca inyección de prompts y jailbreaks con decenas de plugins de ataque
Proveedores personalizados en Python: Envuelve cualquier modelo interno o endpoint afinado con file://my_provider.py
Datos de prueba en CSV: Escala tu suite con file://tests.csv cuando el YAML en línea se vuelva inmanejable
Si quieres mejorar los prompts que estás evaluando, nuestro curso Prompt Engineering with the OpenAI API cubre muchas técnicas clave aplicables a cualquier desarrollo de IA.
Cursos de prompt engineering
Curso
Curso
Curso
blog
Matt Crabtree
15 min
blog
Stanislav Karzhev
9 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min