
Cours
Comprendre l'ingénierie des prompts
1 h
232.4K
La plupart des fonctionnalités LLM sont testées de la même façon : on essaie quelques entrées, on parcourt les sorties à l’œil, puis on met en production.
Vous avez fait cela avec un rédacteur d’e-mails. Cinq entrées dans une fenêtre de chat, les sorties semblaient correctes. Une semaine plus tard, la moitié de vos e-mails au ton décontracté sonnent comme s’ils avaient été rédigés par un avocat d’entreprise. Personne ne l’a vu venir, parce qu’il n’y avait aucun moyen de le détecter. Les prompts ont changé, mais ces cinq tests manuels ne vous ont pas suivi.
Promptfoo est un CLI open source qui remplace ce processus par des évaluations structurées et reproductibles. Vous définissez ce qu’est une bonne sortie, vous choisissez vos modèles et vous exécutez automatiquement toutes les combinaisons.
OpenAI a acquis le projet en mars 2026, et il reste sous licence MIT avec la prise en charge de dizaines de fournisseurs. Plus de 350 000 développeurs l’utilisent, dont des équipes de plus de 25 % des entreprises du Fortune 500.
Ce tutoriel vous guide pour configurer Promptfoo et créer votre première suite d’évaluation de zéro. Nous utiliserons un rédacteur d’e-mails comme fil rouge, le testerons sur GPT-5 et Claude Sonnet 4.6, puis nous brancherons le tout à GitHub Actions à la fin.
Avant d’entrer dans l’outil, il faut comprendre comment fonctionne le test d’un LLM. C’est différent du test de code classique.
Quand vous testez une fonction, le schéma est simple : vous fournissez une entrée et vous vérifiez que la sortie correspond à l’attendu. Les sorties d’un LLM ne se prêtent pas à cela. Le même prompt peut produire un texte différent à chaque exécution ; vous ne pouvez pas vérifier une correspondance exacte.
À la place, vous vérifiez des propriétés de la sortie :
C’est ce que fait une évaluation LLM. Elle exécute votre prompt sur un jeu d’entrées et contrôle chaque sortie selon des règles que vous définissez. Voyez cela comme une suite de tests pour vos prompts plutôt que pour votre code.
Quatre termes reviendront tout au long de l’article :
Sans assertions, vous en restez à « ça me semble bon ». Avec elles, vous avez une définition du « correct » qui s’exécute de manière identique à chaque fois.
Maintenant que vous savez ce qu’est une évaluation, voilà ce que Promptfoo en fait.
Vous fournissez à Promptfoo trois éléments :
Il exécute chaque prompt sur chaque modèle pour chaque cas de test et note les résultats. Une seule commande, promptfoo eval, lance l’ensemble.
Supposons que vous ayez un prompt de rédaction d’e‑mail, deux modèles (GPT‑5 et Claude Sonnet 4) et trois cas de test (décontracté, formel, urgent). Promptfoo exécute les six combinaisons et vous indique lesquelles passent et lesquelles échouent. Plus besoin d’essayer manuellement chaque variante.
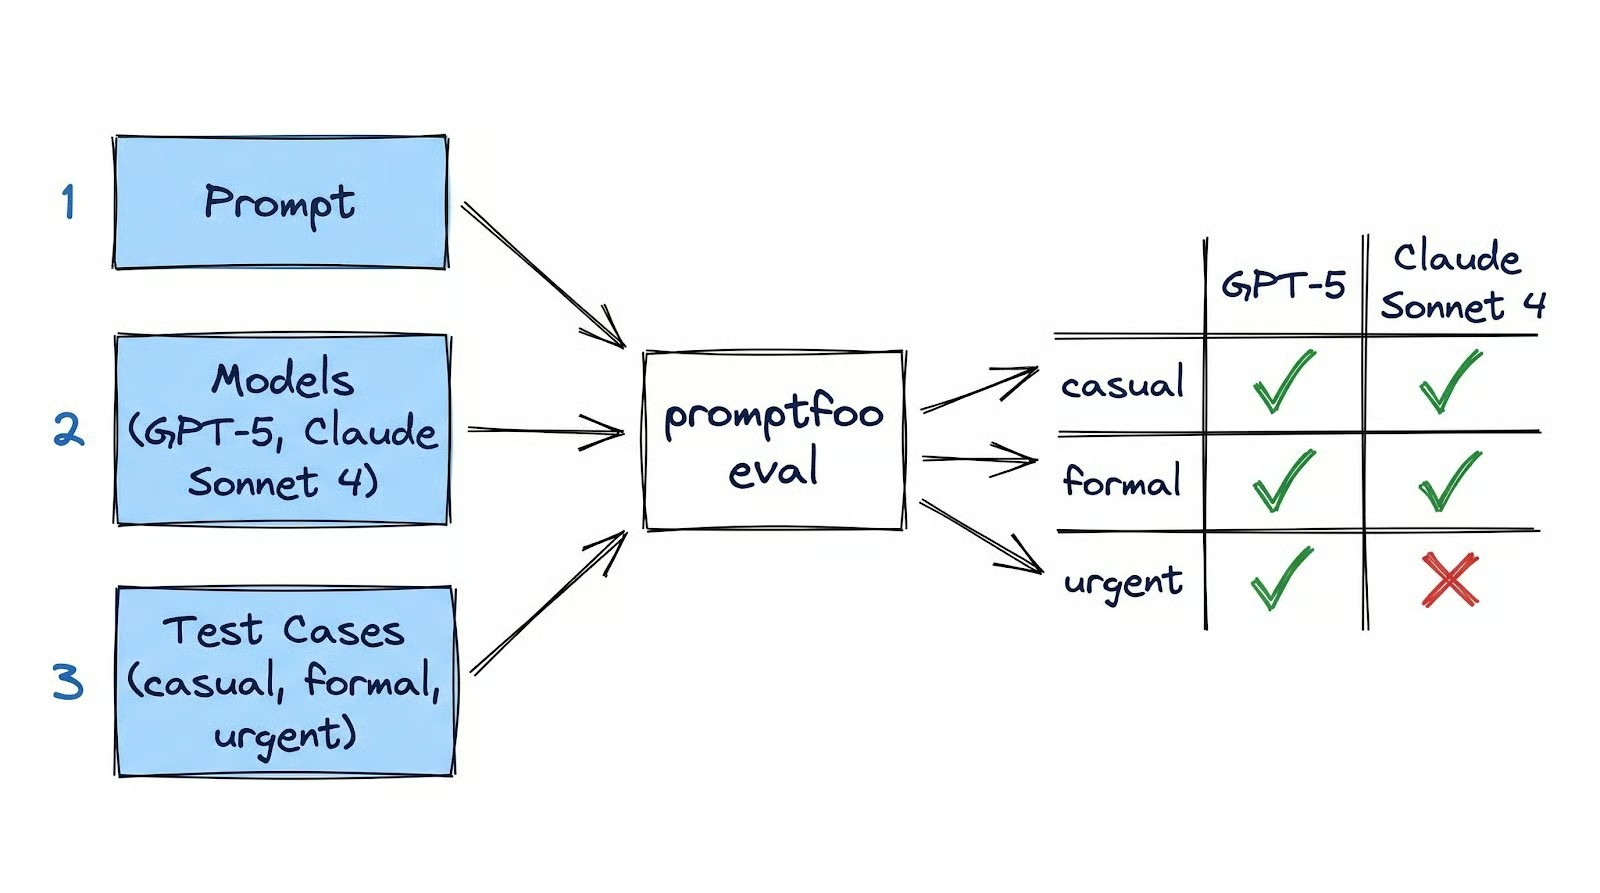
Toute l’évaluation tient dans un seul fichier YAML nommé promptfooconfig.yaml, que vous versionnez avec votre code. Promptfoo s’exécute sur votre machine : votre configuration, vos résultats et le cache restent locaux. Les seuls appels externes vont vers les API des modèles comme OpenAI ou Anthropic, que vous utiliseriez de toute façon avec ou sans Promptfoo.
D’autres outils existent sur ce créneau : DeepEval (Python natif, style pytest), LangSmith (monitoring en production pour LangChain) et Braintrust (tableaux de bord d’équipe). Promptfoo est le meilleur point de départ : gratuit, local et le plus rapide pour passer de zéro à une évaluation opérationnelle.
Installez Promptfoo globalement et initialisez un nouveau projet :
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
La commande init vous guide via un assistant interactif. Elle demande ce que vous souhaitez faire (choisissez « Not sure yet ») et quel fournisseur de modèle utiliser (choisissez « [OpenAI] GPT 5, GPT 4.1, ... »).
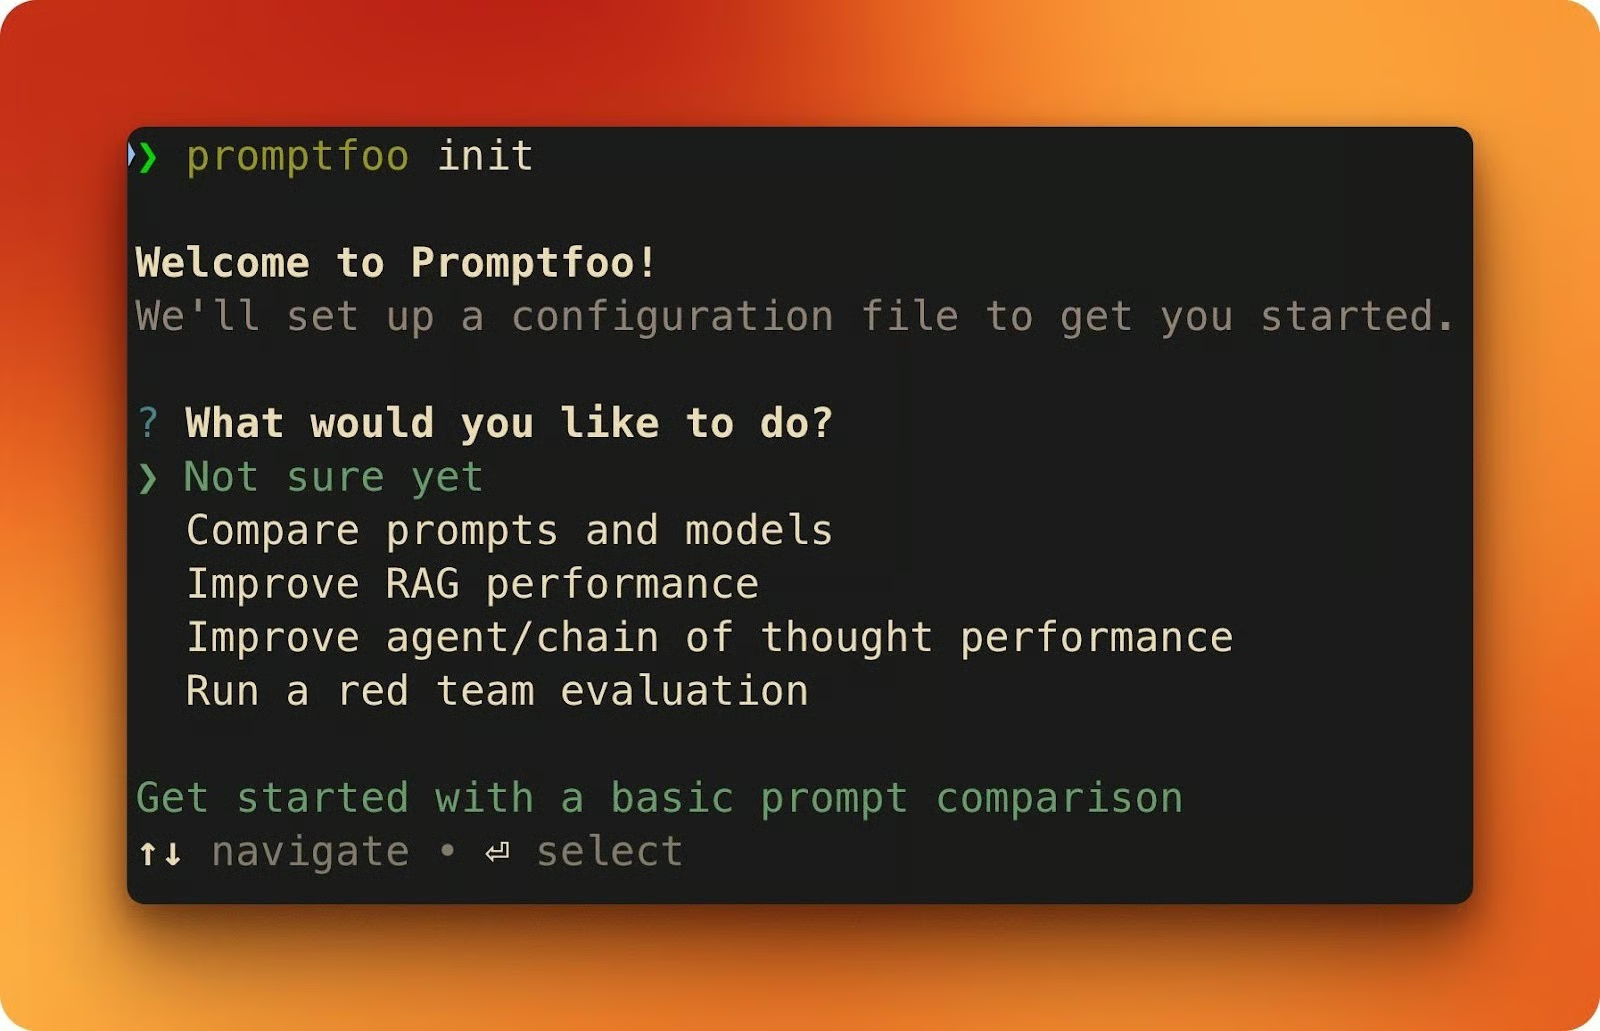
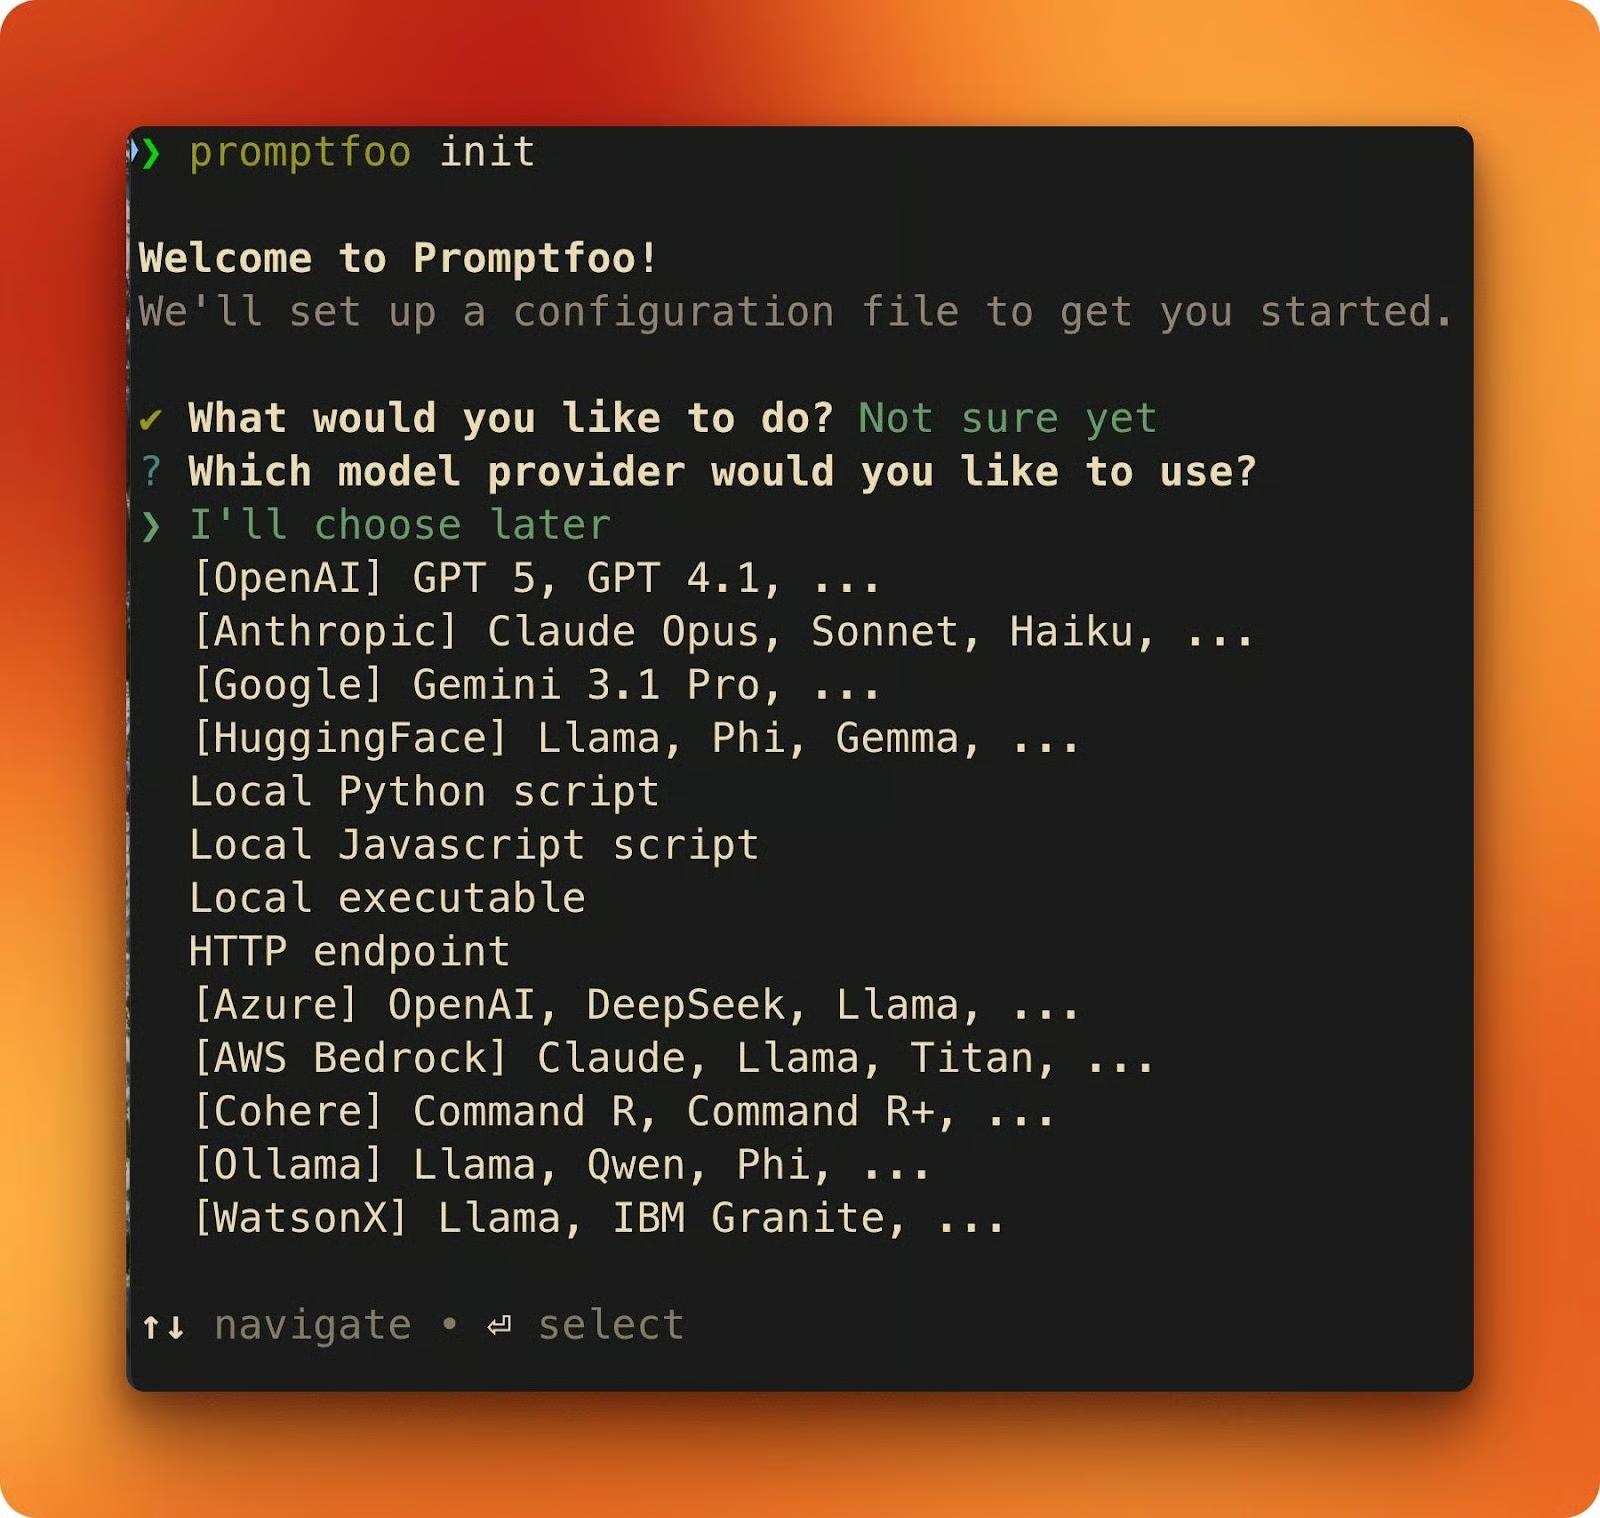
À la fin, vous obtiendrez deux fichiers : un promptfooconfig.yaml d’exemple et un README.md.
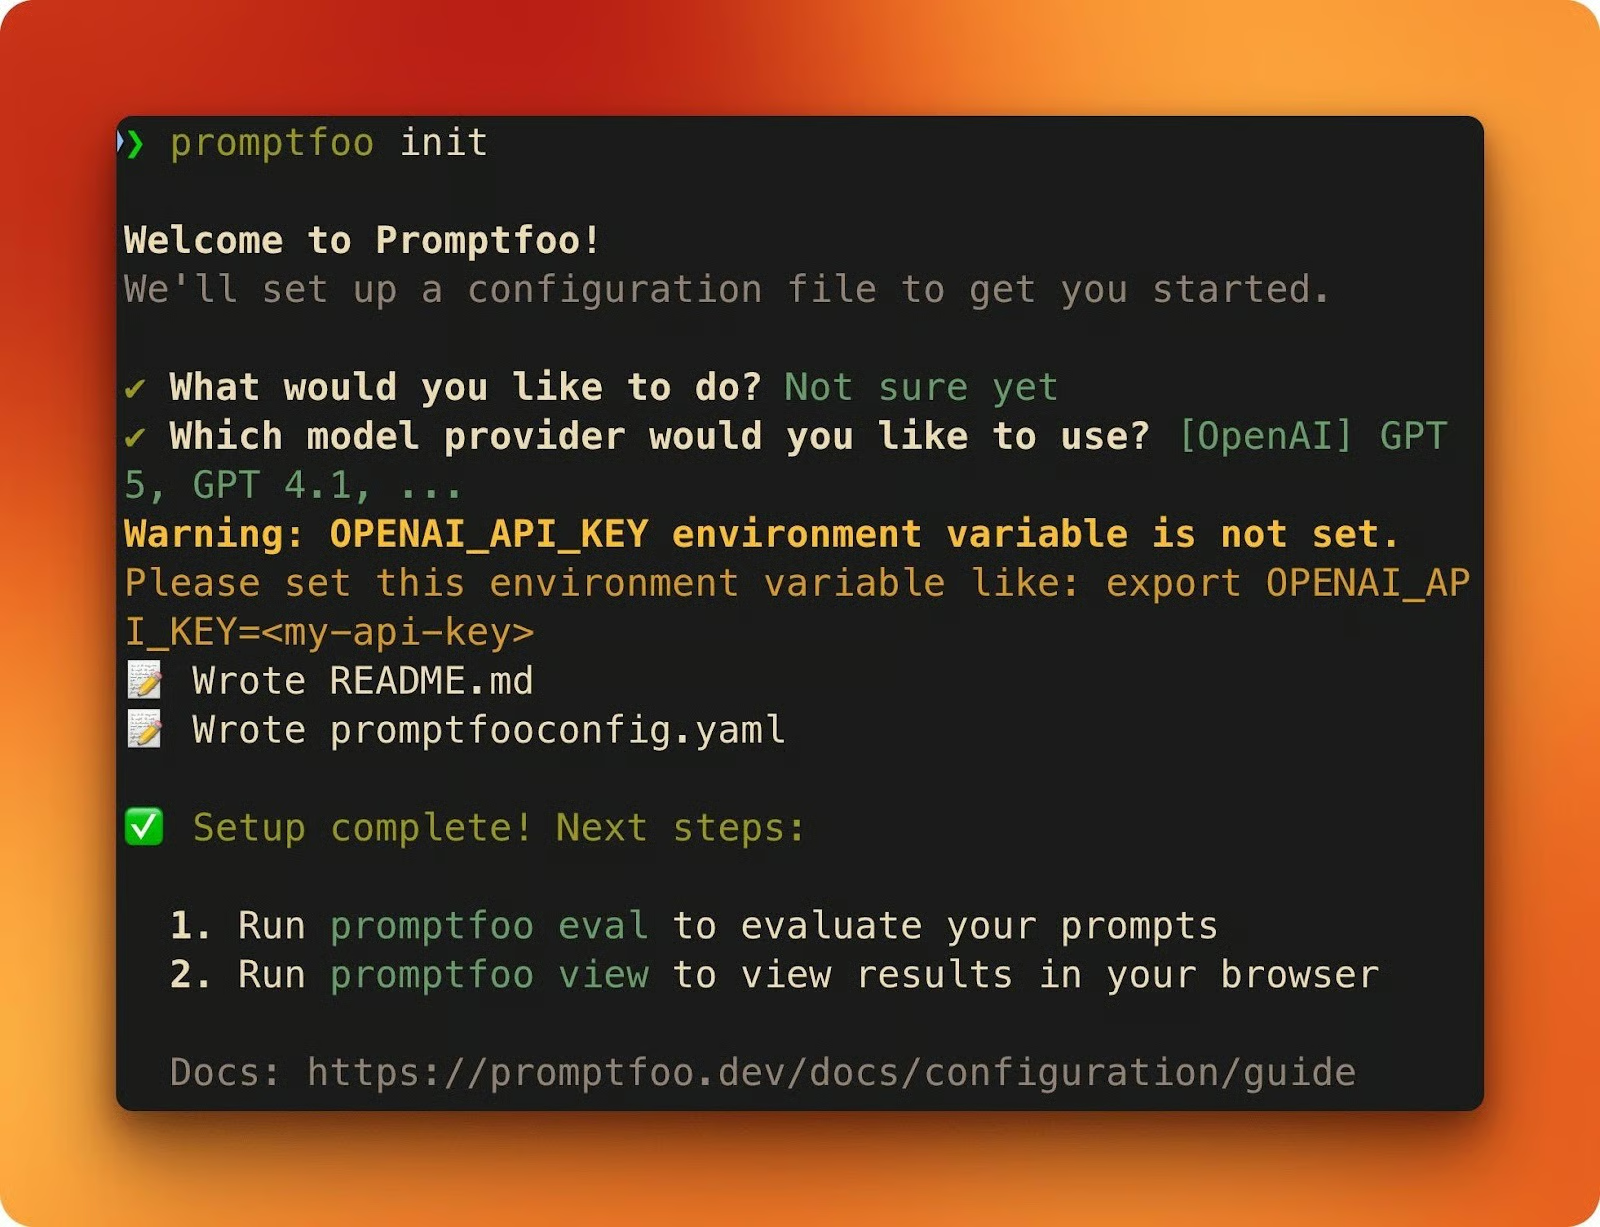
Ensuite, définissez vos clés API. Vous en avez besoin d’au moins une pour exécuter des évaluations (prenez les deux pour suivre ce tutoriel) :
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Si vous ne définissez que ANTHROPIC_API_KEY et ignorez OpenAI, Promptfoo utilise automatiquement Claude comme moteur de notation pour les assertions assistées par modèle, comme llm-rubric.
Ouvrez le promptfooconfig.yaml généré. Toute configuration Promptfoo repose sur trois blocs :
prompts contient vos modèles de prompts. Les espaces réservés entre doubles accolades comme {{variable}} sont remplis à partir de chaque cas de test.
providers liste les modèles contre lesquels vous souhaitez tester.
tests définit les entrées et les assertions qui déterminent si chaque sortie passe ou échoue.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Cet exemple de configuration sert de point de départ. La section suivante le remplace par une véritable évaluation et explique en détail la structure YAML.
La tâche : à partir de puces et d’un ton (décontracté, formel ou urgent), rédiger un e‑mail. Vous allez créer une évaluation qui teste cela sur deux modèles.
La configuration complète est disponible sur Gist si vous voulez tout voir d’un coup. Nous allons la construire pas à pas.
Supprimez l’exemple généré et créez un nouveau promptfooconfig.yaml. Commencez par le prompt et les providers :
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
Le modèle de prompt contient deux espaces réservés : {{bullet_points}} et {{tone}}. Chaque cas de test les renseigne avec des valeurs différentes. Le champ label sur chaque provider vous donne des en‑têtes de colonnes lisibles dans les résultats, plutôt que des identifiants de modèles bruts.
Ajoutez ensuite un bloc defaultTest. Les assertions dans defaultTest s’appliquent automatiquement à chaque cas de test pour éviter les répétitions :
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Cela fait échouer toute réponse au‑delà de 30 secondes. Les modèles de pointe comme GPT‑5 peuvent prendre 10 à 20 secondes par requête à cause des tokens de raisonnement, donc laissez de la marge. Vous le définissez une fois, et cela couvre tous les tests.
Ajoutez maintenant les cas de test. Chacun fournit des entrées différentes et ses propres assertions :
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Chaque cas de test associe deux types d’assertions.
icontains est un contrôle de chaîne simple : la sortie inclut‑elle « mockups », sans tenir compte de la casse ? C’est rapide, gratuit et sans appel d’API.
llm-rubric envoie la sortie à un autre LLM et lui demande de la noter selon votre rubric. Cela consomme des tokens, mais détecte ce que la comparaison de chaînes ne peut pas, comme vérifier si un e‑mail sonne vraiment décontracté.
Lancez l’évaluation :
promptfoo evalPuis ouvrez les résultats dans votre navigateur :
promptfoo view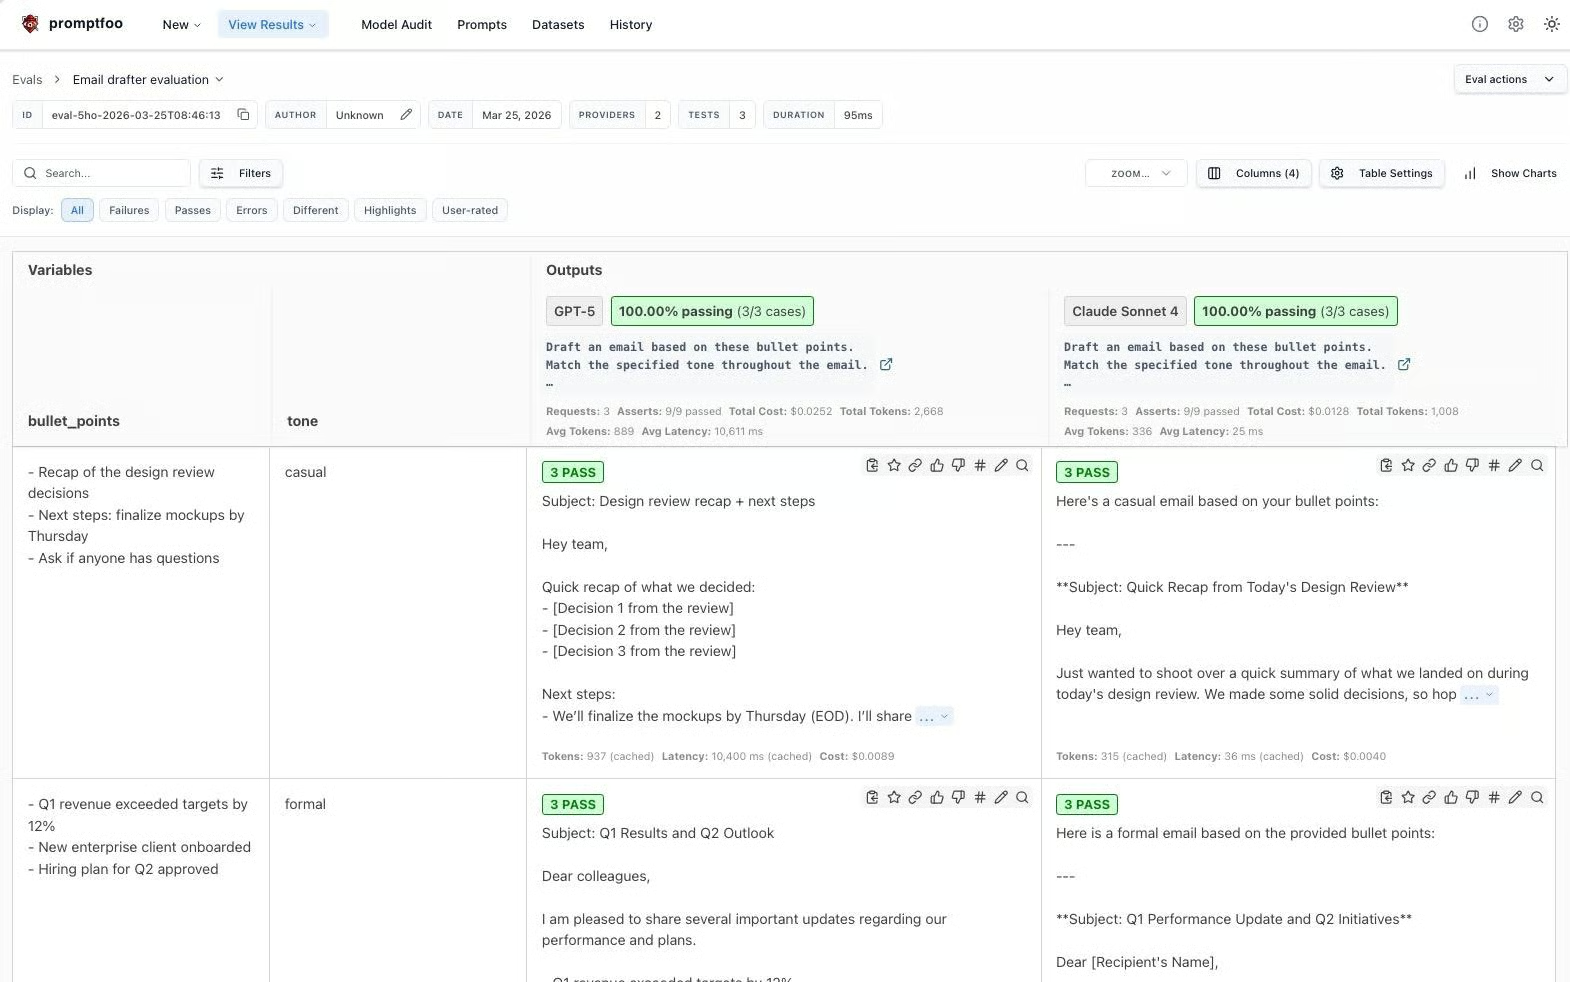
L’interface web affiche les providers en colonnes et les cas de test en lignes. Chaque cellule indique la réussite/échec pour chaque assertion, et vous pouvez cliquer pour voir la sortie complète et les détails de notation.
Promptfoo met en cache par défaut les réponses d’API sur disque (TTL de 14 jours), donc relancer la même évaluation ne coûte rien. Utilisez --no-cache quand vous voulez des réponses fraîches.
Dans la première évaluation, vous avez utilisé icontains et llm-rubric. Ce ne sont que deux des nombreux types d’assertions pris en charge par Promptfoo. Cette section passe en revue les grandes catégories et nous continuerons d’ajouter des assertions à la configuration du rédacteur d’e‑mails au fur et à mesure.
Elles s’exécutent localement, ne coûtent rien et rendent un résultat instantanément.
|
Type |
Ce que cela vérifie |
|
|
La sortie inclut une sous‑chaîne (sensible à la casse ou non) |
|
|
La sortie correspond à un motif (détectez les |
|
|
La sortie exclut un élément (artefacts de template, refus, texte factice) |
|
|
La réponse arrive en moins de N millisecondes |
|
|
La réponse coûte moins de X $ |
Vous avez déjà utilisé icontains et latency. Ajoutons not-contains au cas « décontracté ». Si le modèle a tendance à prendre un ton formel, il pourrait commencer par « Dear » au lieu d’un « Hey » plus informel. Le détecter tient en une ligne :
- type: not-contains
  value: \"Dear\"
Ajoutez ceci à la liste assert du cas décontracté et relancez. Les deux modèles devraient passer : GPT‑5 commence souvent par « Hey team, » et Claude Sonnet 4 aussi. Si l’un avait commencé par « Dear Colleagues, », cette assertion l’aurait signalé immédiatement.
Chaque type d’assertion accepte aussi un préfixe not- : not-regex, not-equals, etc.
Elles consomment des tokens, mais évaluent ce que la comparaison de chaînes ne peut pas. Vous avez déjà utilisé llm-rubric dans la première évaluation. La qualité de votre rubric fait toute la différence.
Un rubric vague comme « L’e‑mail paraît professionnel » n’aide pas le correcteur. Un rubric précis lui donne des critères mesurables :
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
En relançant l’évaluation avec ce rubric, la notation devient elle aussi précise :
Plus votre rubric est spécifique, plus la notation devient cohérente et utile.
Promptfoo fournit aussi answer-relevance (la sortie répond‑elle à la question ?) et similar (similarité cosinus avec une référence via des embeddings), tous deux utiles pour RAG et les applications de recherche.
Quand les types intégrés ne couvrent pas votre logique, écrivez la vôtre. Pour le rédacteur d’e‑mails, vous pourriez vouloir vérifier que les sorties restent dans une longueur raisonnable. Voici une assertion inline qui passe si l’e‑mail contient entre 50 et 200 mots :
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Ajoutez‑la au cas décontracté et relancez. Dans mon exécution, les deux modèles passent : GPT‑5 à 54 mots, Claude Sonnet 4 à 187. Gardez toutefois cette assertion en tête pour la section suivante, car elle n’a pas tout passé.
Pour des contrôles plus complexes, mettez la logique dans un fichier séparé :
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
Référencez‑le dans votre configuration avec type: python et value: file://assert_length.py. Le champ reason apparaît dans l’interface de résultats pour expliquer précisément pourquoi un test a réussi ou échoué.
Voici à quoi ressemble un échec réel.
Ajoutez l’assertion Python sur le nombre de mots aux trois cas de test et exécutez l’évaluation complète sur les deux modèles. Dans mon cas, cinq combinaisons sur six ont passé. Claude Sonnet 4.6 n’a pas validé le cas « urgent » (cela peut varier chez vous, les LLM n’étant pas déterministes).
Lors de cette exécution, la sortie faisait 207 mots, soit sept de trop. Le llm-rubric a pourtant validé, confirmant un « langage urgent et direct » avec « des actions claires ». L’assertion icontains est également passée, puisque « Friday » était bien présent.
Mais l’assertion Python sur la longueur a échoué. Claude avait ajouté un préambule (« Here is a draft email based on your bullet points with an urgent tone: ») avant l’e‑mail proprement dit, faisant dépasser les 200 mots.
C’est le genre de chose que vous ne repéreriez pas à l’œil nu. L’e‑mail en lui‑même lisait bien : bon ton, bon contenu. Mais la sortie était trop longue car le modèle a ajouté du texte hors e‑mail. Une assertion l’a détecté et l’évaluation a signalé le cas complet.
Deux options pour corriger : ajuster le prompt pour interdire tout préambule, ou relever la limite de mots. Dans les deux cas, vous relancez l’évaluation pour vérifier que tout passe.
À ce stade, le cas « décontracté » a quatre assertions : icontains, not-contains, llm-rubric et l’assertion Python sur la longueur. Elles n’ont pas toutes la même importance. Le champ weight vous permet de l’exprimer :
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
Le score de chaque assertion est multiplié par son poids, puis le test calcule une moyenne pondérée. Le threshold définit le score minimal pour réussir. Ici, le ton pèse deux fois plus que les vérifications de mots‑clés, et le nombre de mots pèse moitié moins.
En relançant le cas décontracté avec ces poids, les deux modèles obtiennent 1,0 et passent. Mais si llm-rubric avait échoué (poids 2) alors que la longueur passait (poids 0,5), le score pondéré serait tombé sous le seuil de 0,7 et le test aurait échoué. Les poids vous permettent d’indiquer à Promptfoo ce qui compte le plus pour vous.
La configuration inclut déjà deux providers, donc promptfoo eval a testé GPT‑5 et Claude Sonnet 4 en un seul passage. Ouvrez promptfoo view et vous les verrez en colonnes distinctes, avec chaque cas de test noté indépendamment pour chaque modèle.
Dans mon exécution, GPT‑5 a validé les six assertions sur les trois cas. Claude Sonnet 4 en a validé cinq mais a échoué sur la longueur pour l’e‑mail urgent.
C’est le genre d’écart que vous ne remarqueriez pas en testant quelques prompts à la main, mais qui saute aux yeux dans la grille. Vous comparez des scores sur les mêmes assertions et les mêmes entrées, pas votre souvenir du modèle qui « semblait meilleur » la dernière fois.
Les sorties de LLM ne sont toutefois pas déterministes. Le même prompt peut produire des résultats différents d’une exécution à l’autre, et un seul passage ne dit pas si un modèle est fiablement bon ou juste chanceux. L’option --repeat répond à cela :
promptfoo eval --repeat 3Chaque cas de test s’exécute alors trois fois par provider. Si un modèle valide deux fois l’assertion de ton mais échoue à la troisième, c’est un signal de fiabilité que vous rateriez sur un seul passage.
Exécuter des évaluations en local fonctionne en développement, mais cela dépend du fait que la personne qui modifie le prompt pense à les lancer. Promptfoo propose une GitHub Action officielle qui supprime cette dépendance en exécutant votre suite d’évaluation à chaque pull request et en publiant les résultats en commentaire.
Pour la configurer, créez un fichier de workflow dans votre dépôt :
mkdir -p .github/workflowsCréez ensuite .github/workflows/prompt-eval.yml avec le contenu suivant :
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Avant que cela ne fonctionne, vous devez ajouter votre OPENAI_API_KEY (et éventuellement ANTHROPIC_API_KEY) en tant que secrets du dépôt dans votre repo GitHub, sous Settings > Secrets and variables > Actions.
Le filtre paths signifie que l’action ne se déclenche que lorsque des fichiers dans prompts/ changent. L’étape de checkout est requise car l’action utilise git en interne pour différencier les prompts entre branches. Elle exécute la suite d’évaluation complète et publie un commentaire sur la PR avec les résultats et un lien vers l’interface web.
Pour plus de contrôle sur la logique de réussite/échec, vous pouvez parser la sortie JSON directement :
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
Le flux de travail ensuite :
Les changements de prompts bénéficient du même passage par les tests avant fusion que le code.
Le rédacteur d’e‑mails de l’intro a toujours un problème de ton, mais il y a désormais un test qui le détecte avant vos utilisateurs. Vous êtes parti d’un YAML vierge pour arriver à une suite d’évaluation exécutée sur deux modèles, intégrée au CI.
La même approche s’applique à n’importe quelle fonctionnalité LLM : chatbot, résumeur, pipeline de classification… Tant que vous pouvez écrire une assertion sur ce qu’est une « bonne sortie », vous pouvez la tester automatiquement plutôt que de vous fier à l’œil.
Quand vous voudrez aller plus loin, la documentation Promptfoo couvre plusieurs sujets à explorer :
Red teaming : promptfoo redteam run scanne les injections de prompt et jailbreaks via des dizaines de plugins d’attaque
Providers Python personnalisés : Encapsulez un modèle interne ou un endpoint fine‑tuned avec file://my_provider.py
Données de test en CSV : Faites passer à l’échelle votre suite avec file://tests.csv quand le YAML inline devient ingérable
Si vous voulez améliorer les prompts que vous testez, notre cours Prompt Engineering with the OpenAI API couvre de nombreuses techniques clés applicables à tout développement en IA.
Cours de prompt engineering
Cours
Cours
Cours