
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
De meeste LLM-features worden op dezelfde manier getest: probeer een paar inputs, bekijk de outputs globaal, verzend het.
Dat deed je met een e-mailgenerator. Vijf inputs in een chatvenster, outputs zagen er prima uit. Een week later klinkt de helft van je informele e-mails alsof ze door een bedrijfsjurist zijn geschreven. Niemand merkte het op omdat er geen manier was om het te merken. De prompts veranderden, maar die vijf handmatige tests gingen niet met je mee.
Promptfoo is een open-source CLI die dat proces vervangt door gestructureerde, herhaalbare evaluaties. Je definieert hoe goede output eruitziet, kiest je modellen en draait automatisch elke combinatie.
OpenAI nam het project over in maart 2026, en het blijft MIT-gelicentieerd met ondersteuning voor tientallen providers. Meer dan 350.000 ontwikkelaars gebruiken het, waaronder teams bij meer dan 25% van de Fortune 500-bedrijven.
Deze tutorial loodst je door het instellen van Promptfoo en het vanaf nul bouwen van je eerste evalsuite. We gebruiken een e-mailgenerator als doorlopend voorbeeld, testen deze op GPT-5 en Claude Sonnet 4.6, en koppelen alles aan GitHub Actions tegen het einde.
Voordat we in de tool duiken, moet je weten hoe LLM-testen werkt. Het is anders dan het testen van gewone code.
Als je eerder een functie hebt getest, ken je het patroon: geef een input, controleer of de output overeenkomt met wat je verwacht. LLM-outputs werken niet zo. Dezelfde prompt kan elke keer andere tekst opleveren, dus je kunt niet op een exacte match controleren.
In plaats daarvan check je eigenschappen van de output:
Dat is wat een LLM-eval doet. Het draait je prompt tegen een set inputs en controleert elke output aan de hand van regels die jij definieert. Zie het als een testsuite voor je prompts in plaats van je code.
Vier termen komen in dit artikel steeds terug:
Zonder asserties ben je terug bij "ziet er goed uit voor mij". Met asserties heb je een definitie van "correct" die elke keer op dezelfde manier draait.
Nu je weet wat een eval is, dit is wat Promptfoo ermee doet.
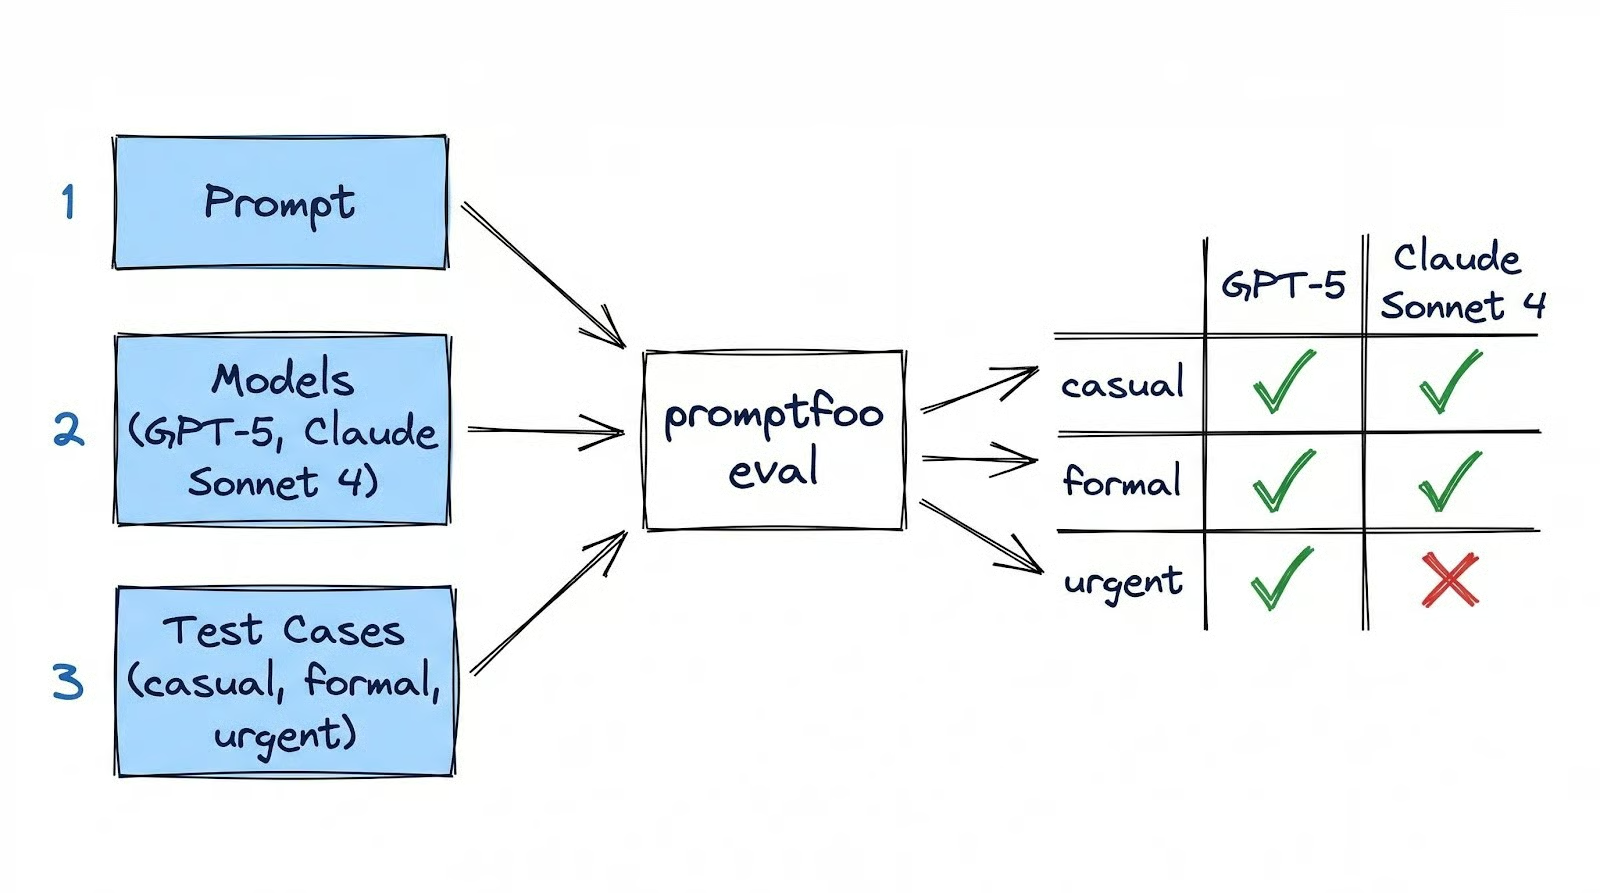
Je geeft Promptfoo drie dingen:
Het draait elke prompt tegen elk model voor elk testgeval en scoort de resultaten. Eén commando, promptfoo eval, draait alles.
Stel, je hebt één e-mailprompt, twee modellen (GPT-5 en Claude Sonnet 4) en drie testgevallen (informeel, formeel, urgent). Promptfoo draait alle zes combinaties en vertelt je welke geslaagd zijn en welke niet. Niet meer alles handmatig proberen.
De hele eval staat in één YAML-bestand genaamd promptfooconfig.yaml dat je samen met je code versiebeheert. Promptfoo draait op je machine: je config, resultaten en cache blijven lokaal. De enige externe calls gaan naar model-API's zoals OpenAI of Anthropic, die je mét of zonder Promptfoo toch al zou doen.
Andere tools in dit domein bestaant, zoals DeepEval (Python-native, pytest-stijl), LangSmith (productiemonitoring voor LangChain) en Braintrust (teamdashboards). Promptfoo is het beste startpunt omdat het gratis is, lokaal draait en je sneller dan welke dan ook van nul naar een werkende eval brengt.
Installeer Promptfoo globaal en initialiseer een nieuw project:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
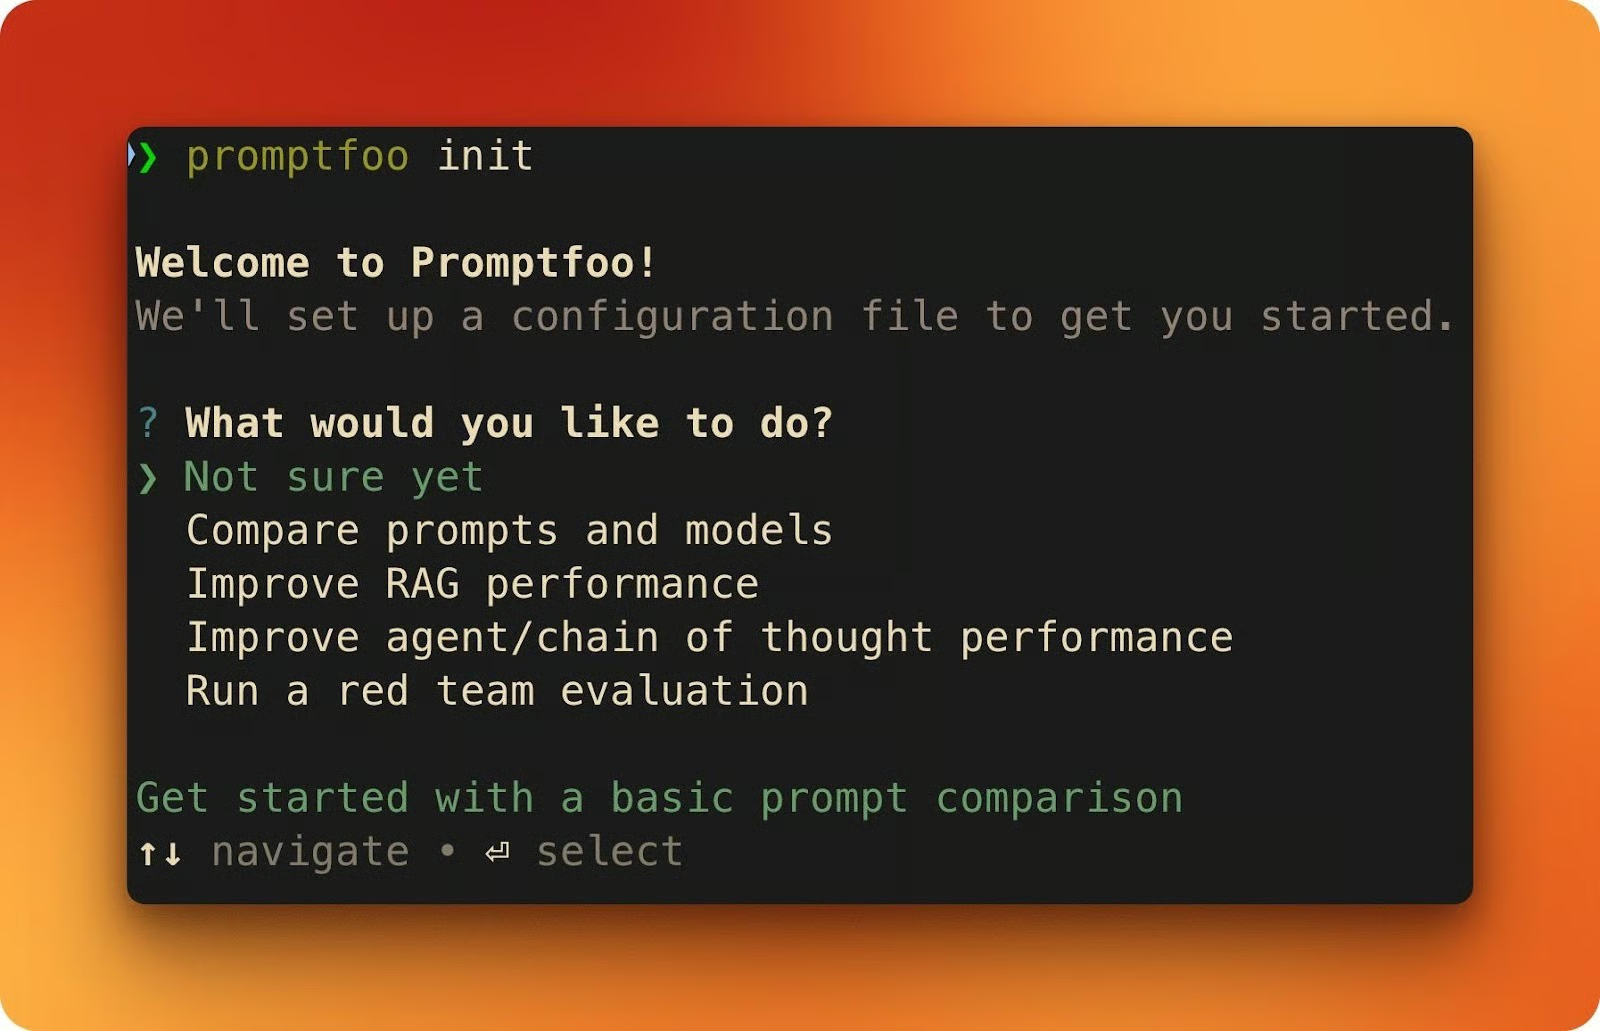
promptfoo init
Het init-commando loodst je door een interactieve setup. Het vraagt wat je wilt doen (kies "Not sure yet") en welke modelprovider je wilt gebruiken (kies "[OpenAI] GPT 5, GPT 4.1, ...").
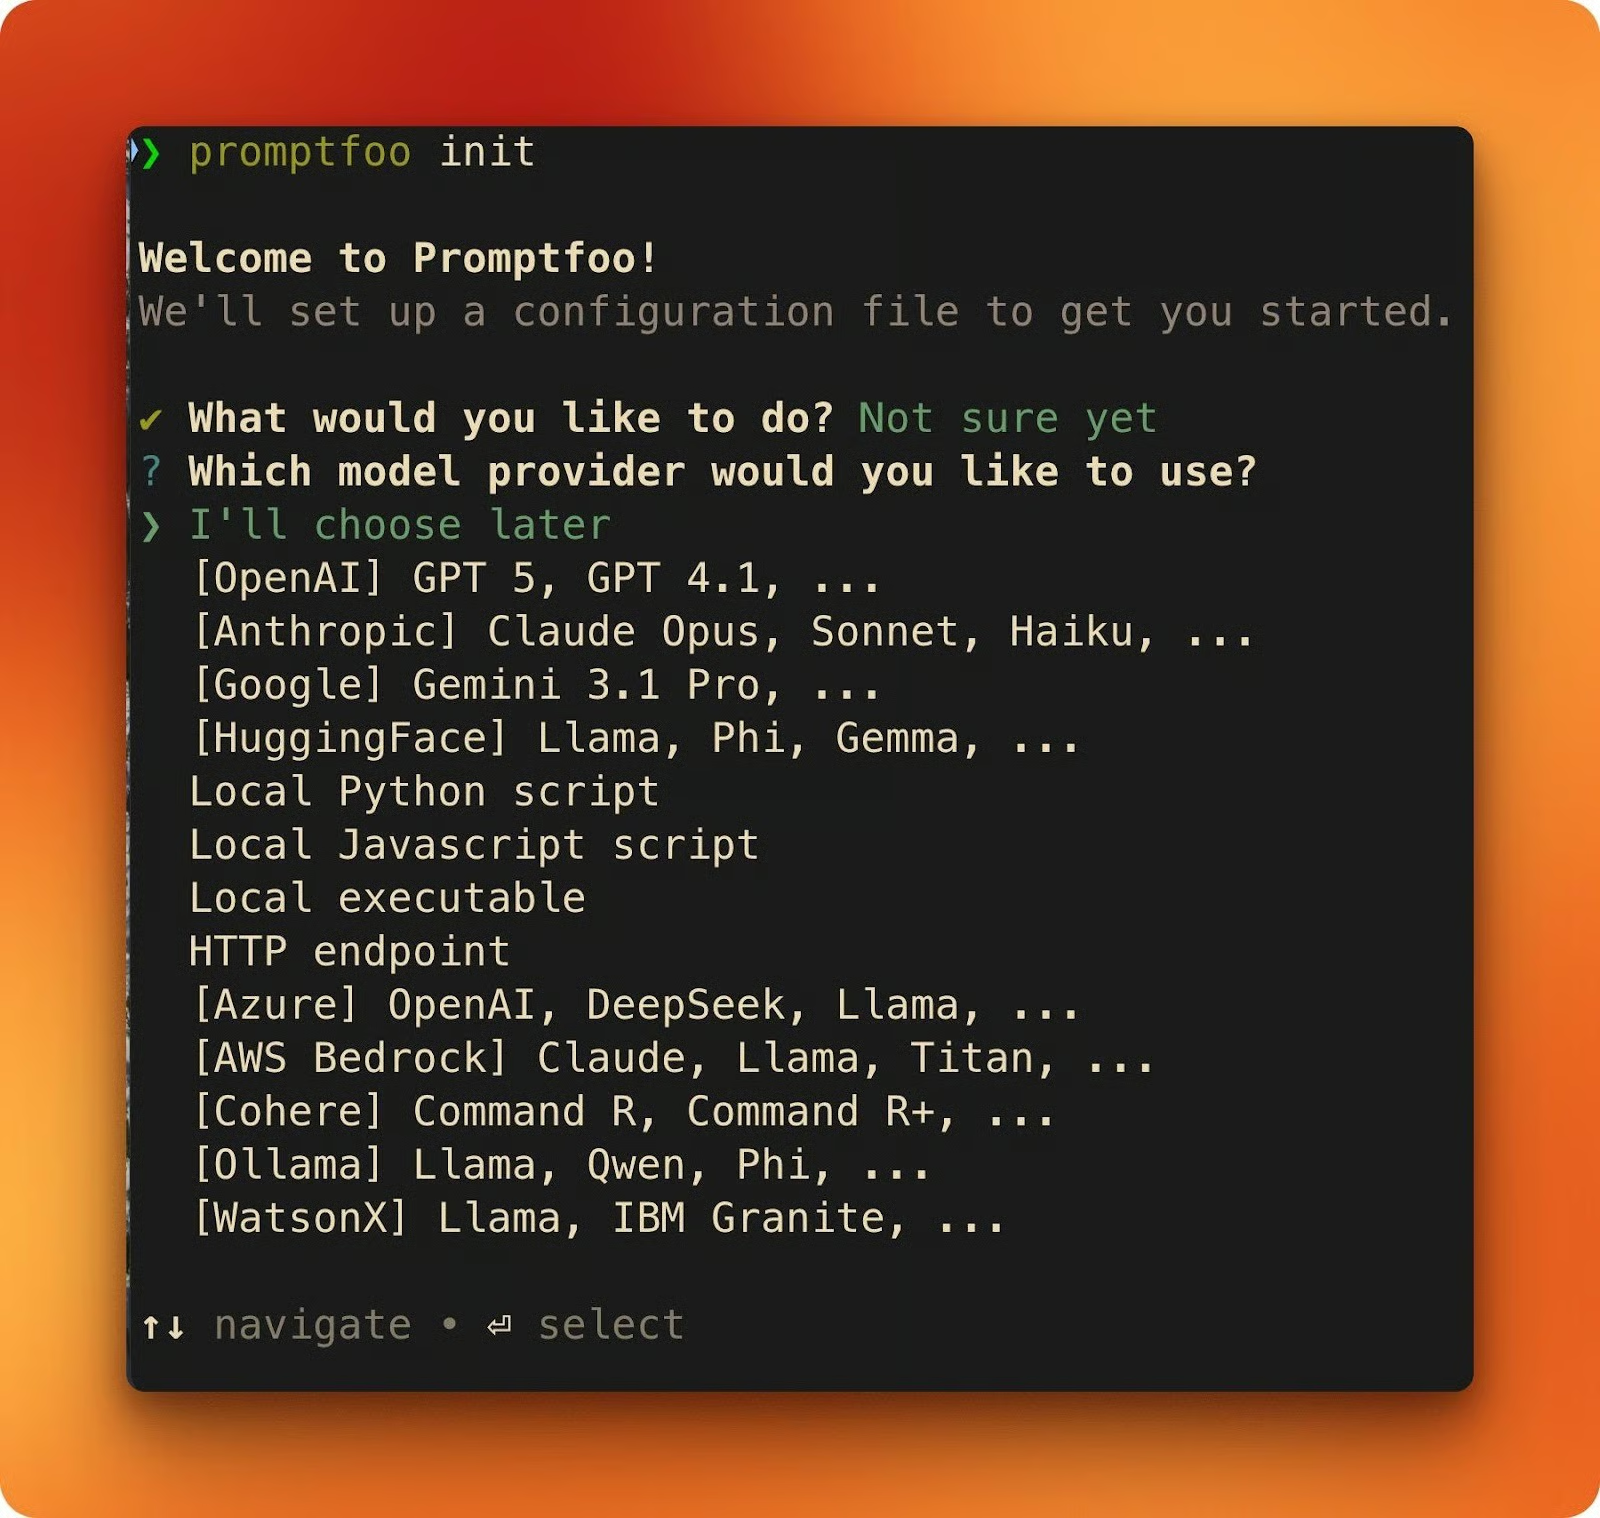
Na afloop heb je twee bestanden: een voorbeeld van promptfooconfig.yaml en een README.md.
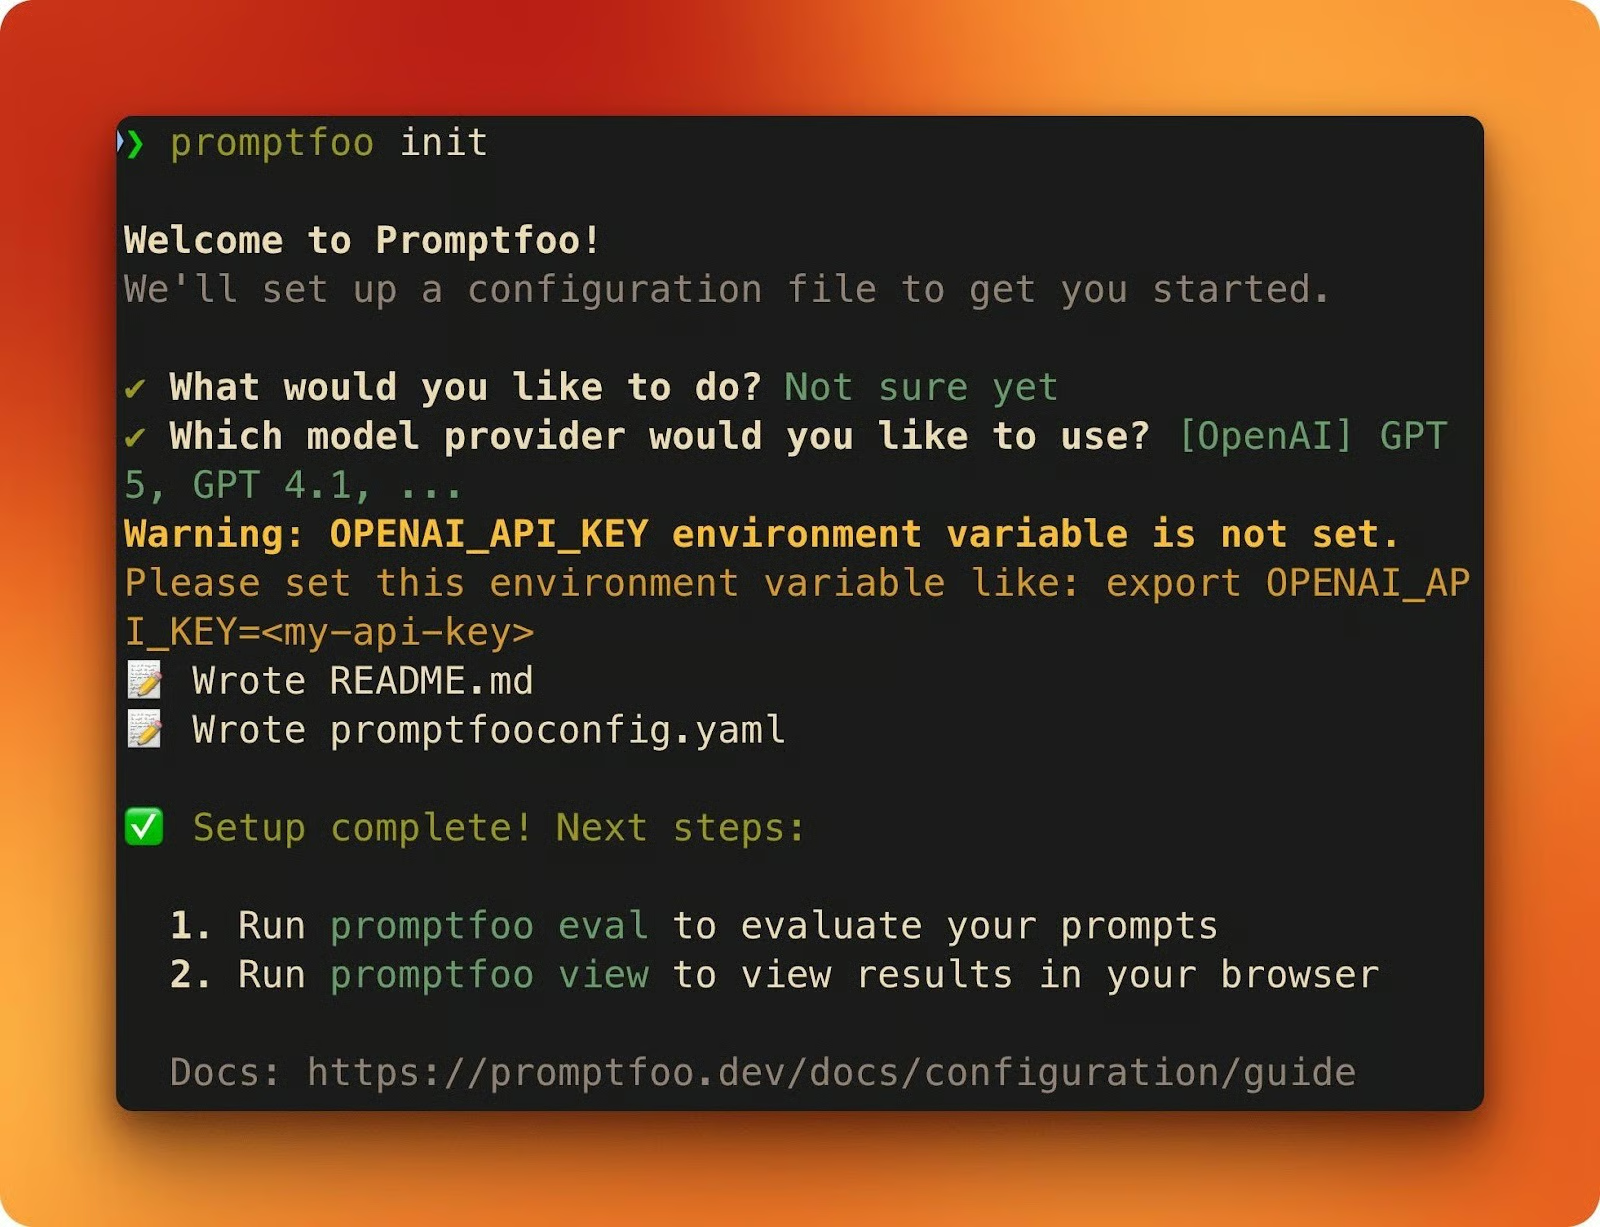
Stel daarna je API-sleutels in. Je hebt er minimaal één nodig om evals te draaien (heb ze allebei om deze tutorial te volgen):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Als je alleen ANTHROPIC_API_KEY instelt en OpenAI overslaat, gebruikt Promptfoo automatisch Claude als gradingprovider voor modelgeassisteerde asserties zoals llm-rubric.
Open het gegenereerde promptfooconfig.yaml. Elke Promptfoo-config heeft drie bouwstenen:
prompts is waar je prompttemplates komen. Plaatshouders met dubbele accolades zoals {{variable}} worden gevuld vanuit elk testgeval.
providers bevat de modellen waartegen je wilt testen.
tests definieert de inputs en de asserties die bepalen of elke output slaagt of faalt.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Deze voorbeeldconfig is een startpunt. In de volgende sectie vervangen we deze door een echte evaluatie en leggen we de YAML-structuur grondig uit.
De taak: schrijf een e-mail op basis van bullet points en een toon (informeel, formeel of urgent). Je bouwt een eval die dit over twee modellen test.
De volledige config is beschikbaar als Gist als je alles in één keer wilt zien. We bouwen hem hieronder stap voor stap op.
Verwijder het gegenereerde voorbeeld en maak een nieuwe promptfooconfig.yaml. Begin met de prompt en de providers:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
De prompttemplate heeft twee plaatshouders: {{bullet_points}} en {{tone}}. Elk testgeval vult deze met andere waarden. Het veld label op elke provider geeft je leesbare kolomkoppen in de resultaatweergave in plaats van ruwe model-ID's.
Voeg vervolgens een defaultTest-blok toe. Asserties in defaultTest gelden automatisch voor elk testgeval, zodat je ze niet herhaalt:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Dit laat elke reactie die langzamer is dan 30 seconden falen. Frontiermodellen zoals GPT-5 kunnen per request 10-20 seconden kosten door reasoning-tokens, dus de drempel heeft ruimte nodig. Je stelt dit één keer in en het dekt elke test.
Voeg nu de testgevallen toe. Elk levert andere inputs en eigen asserties:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Elk testgeval combineert twee soorten asserties.
icontains is een simpele stringcheck: stond \"mockups\" in de output, hoofdletterongevoelig? Het is snel, gratis en doet geen API-call.
llm-rubric stuurt de output naar een andere LLM en vraagt die om de reactie te beoordelen tegen jouw rubric. Het kost tokens, maar het vangt zaken die stringmatching niet kan, zoals of een e-mail echt informeel klinkt.
Draai de evaluatie:
promptfoo evalOpen daarna de resultaten in je browser:
promptfoo view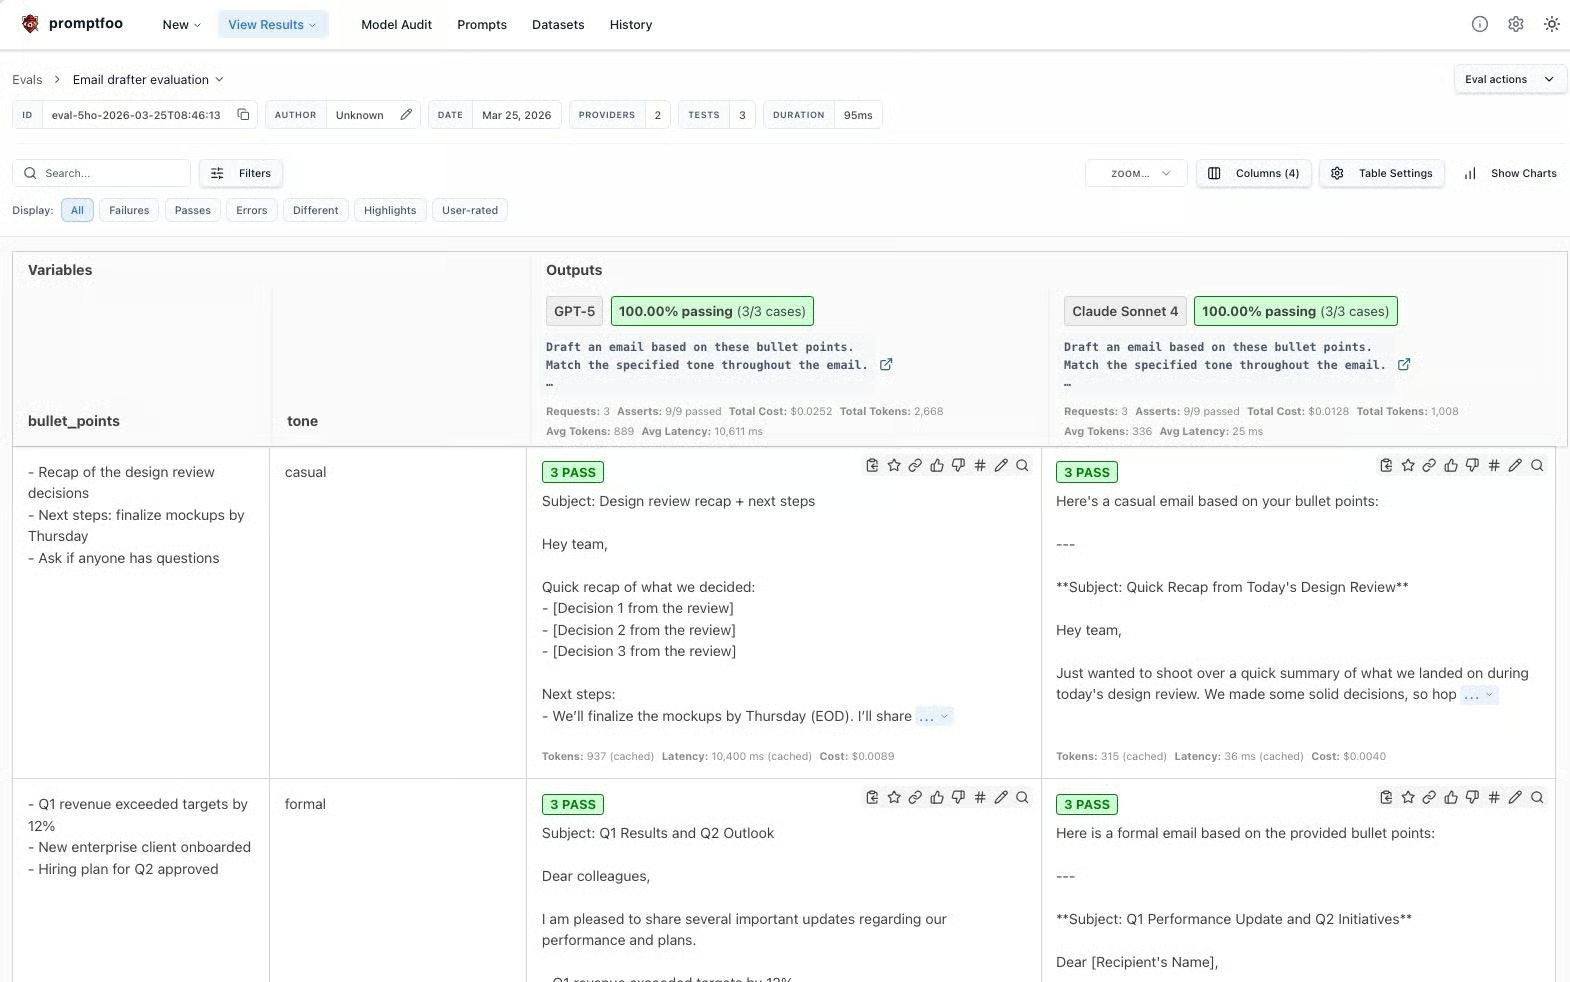
De web-UI toont providers als kolommen en testgevallen als rijen. Elke cel laat pass/fail zien voor elke assertie, en je kunt in elke cel doorklikken om de volledige output en beoordelingsdetails te bekijken.
Promptfoo cachet API-responses standaard op schijf (TTL van 14 dagen), dus dezelfde eval opnieuw draaien kost niets. Gebruik --no-cache wanneer je verse responses wilt.
De eerste eval gebruikte icontains en llm-rubric. Dat zijn twee van de vele assertietypes die Promptfoo ondersteunt. Deze sectie behandelt de hoofd-categorieën en we blijven asserties toevoegen aan de e-mailconfig terwijl we doorgaan.
Deze draaien lokaal, kosten niets en leveren direct resultaten op.
|
Type |
Wat het controleert |
|
|
Output bevat een substring (hoofdlettergevoelig of niet) |
|
|
Output matcht een patroon (vang ongevulde |
|
|
Output sluit iets uit (template-artifacts, weigeringen, placeholdertekst) |
|
|
Reactie kwam binnen N milliseconden |
|
|
Reactie kost minder dan $X |
Je hbt al icontains en latency gebruikt. Laten we not-contains toevoegen aan het informele testgeval. Als het model standaard formele taal gebruikt, begint het misschien met "Dear" in plaats van iets informeels als "Hey". Dat vangen is één regel:
- type: not-contains
  value: \"Dear\"
Voeg dit toe aan de assert-lijst van het informele testgeval en draai opnieuw. Beide modellen zouden moeten slagen: GPT-5 opent vaak met "Hey team," en Claude Sonnet 4 ook. Als een van beide met "Dear Colleagues" was begonnen, had deze assertie het direct gemarkeerd.
Elk assertietype ondersteunt ook een not--prefix: not-regex, not-equals, enzovoort.
Deze kosten tokens, maar kunnen dingen beoordelen die stringmatching niet kan. Je hebt in de eerste eval al llm-rubric gebruikt. De rubric die je schrijft, maakt of breekt het.
Een vage rubric als "De e-mail klinkt professioneel" vertelt de beoordelaar niets nuttigs. Een specifieke rubric geeft iets om te meten:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
Als je de eval met deze rubric opnieuw draait, wordt de output van de grader ook specifieker:
Hoe specifieker je rubric, hoe consistenter en nuttiger de beoordeling wordt.
Promptfoo levert ook answer-relevance (behandelde de output de vraag?) en similar (cosinesimilariteit met een referentie via embeddings), beide nuttig voor RAG en zoektoepassingen.
Als ingebouwde types je logica niet afdekken, schrijf je die zelf. Voor de e-mailgenerator wil je misschien controleren dat outputs binnen een redelijke lengte blijven. Hier is een inline-assertie die slaagt als de e-mail tussen 50 en 200 woorden is:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Voeg dit toe aan het informele testgeval en draai opnieuw. In mijn run slagen beide modellen: GPT-5 kwam uit op 54 woorden, Claude Sonnet 4 op 187. Maar onthoud deze assertie voor de volgende sectie, want hij slaagde niet overal.
Voor complexere checks zet je de logica in een apart bestand:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
Verwijs er in je config naar met type: python en value: file://assert_length.py. Het veld reason verschijnt in de resultaten-UI, zodat je precies ziet waarom een test slaagde of faalde.
Zo ziet een echte fout eruit.
Voeg de Python-woordentelassertie toe aan alle drie de testgevallen en draai de volledige eval over beide modellen. In mijn geval slaagden vijf van de zes combinaties. Claude Sonnet 4.6 slaagde niet voor het urgentie-testgeval (dit gebeurt mogelijk wel of niet op jouw machine, gezien het niet-deterministische gedrag van LLM's).
In die run kwam de output uit op 207 woorden, zeven boven de limiet. De llm-rubric slaagde juist en bevestigde dat de e-mail "urgente, directe taal" met "duidelijke acties" gebruikte. De icontains slaagde ook, want "Friday" stond in de output.
Maar de Python-woordentelassertie faalde. Claude zette meta-commentaar ervoor ("Here is a draft email based on your bullet points with an urgent tone:") vóór de eigenlijke e-mail, waardoor het aantal woorden boven de 200 kwam.
Dit is het soort ding dat je nooit vangt door te oogballen. De e-mail zelf las prima: juiste toon, juiste inhoud. Maar de output was te lang omdat het model tekst toevoegde die niet bij de e-mail hoorde. Eén assertie ving het, en de eval markeerde het hele testgeval.
De fix kan twee kanten op: pas de prompt aan om het model te vertellen geen inleiding toe te voegen, of verhoog de woordlimiet. Hoe dan ook, je draait de eval opnieuw en checkt dat hij slaagt.
Op dit punt heeft het informele testgeval vier asserties: icontains, not-contains, llm-rubric en de Python-woordentelling. Niet allemaal zijn even belangrijk. Met het veld weight kun je dat aangeven:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
De score van elke assertie wordt vermenigvuldigd met het gewicht, en de test berekent een gewogen gemiddelde. De threshold zet de minimumscore om te slagen. Hier telt de toonscore dubbel zo zwaar als de keywordchecks, en de woordentelling half zo zwaar.
Als je het informele testgeval met deze gewichten opnieuw draait, scoren beide modellen 1,0 en slagen. Maar als de llm-rubric had gefaald (gewicht 2) terwijl de woordentelling slaagde (gewicht 0,5), zou de gewogen score onder de drempel van 0,7 zakken en zou de test falen. Met gewichten vertel je Promptfoo waar je het meest om geeft.
De config heeft al twee providers, dus promptfoo eval testte GPT-5 en Claude Sonnet 4 in één run. Open promptfoo view en je ziet ze als aparte kolommen in de resultaten, met elk testgeval onafhankelijk gescoord per model.
In mijn run van onze eval slaagde GPT-5 voor alle zes asserties over de drie testgevallen. Claude Sonnet 4 slaagde voor vijf, maar faalde op de woordentelling bij de urgente e-mail.
Dat is het soort verschil dat je niet zou zien door een paar prompts handmatig te proberen, maar het verschijnt direct in de grid. Je vergelijkt scores tegen dezelfde asserties op dezelfde inputs, niet je geheugen van welk model "beter aanvoelde" de vorige keer.
LLM-outputs zijn echter niet deterministisch. Dezelfde prompt kan bij opeenvolgende runs verschillende resultaten geven, en één run vertelt je niet of een model betrouwbaar goed is of gewoon geluk had. De --repeat-vlag houdt hier rekening mee:
promptfoo eval --repeat 3Dit draait elk testgeval drie keer per provider. Als een model twee keer slaagt voor de toonassertie maar faalt bij de derde run, is dat een betrouwbaarheidsignaal dat je met één run zou missen.
Evals lokaal draaien werkt tijdens ontwikkeling, maar het hangt ervan af dat degene die de prompt wijzigt eraan denkt om ze te draaien. Promptfoo heeft een officiële GitHub Action die die afhankelijkheid weghaalt door je evalsuite op elke pull request te draaien en de resultaten als een comment te posten.
Om dit in te stellen, maak je een workflowbestand in je repo:
mkdir -p .github/workflowsMaak daarna .github/workflows/prompt-eval.yml aan met de volgende inhoud:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Voordat dit werkt, moet je je OPENAI_API_KEY (en optioneel ANTHROPIC_API_KEY) toevoegen als repositorysecrets in je GitHub-repo onder Settings > Secrets and variables > Actions.
De paths-filter betekent dat de action alleen triggert wanneer iemand bestanden in prompts/ wijzigt. De checkoutstap is vereist omdat de action intern git gebruikt om promptbestanden tussen branches te diffen. Hij draait de volledige evalsuite en plaatst een PR-comment met de resultaten en een link naar de webviewer.
Voor meer controle over pass/fail-logica kun je de JSON-output direct parsen:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
De workflow vanaf hier:
Promptwijzigingen krijgen dezelfde test-voor-mergebehandeling als codewijzigingen.
De e-mailgenerator uit de intro heeft nog steeds een toonprobleem, maar nu is er een test die het opvangt voordat gebruikers dat doen. Je begon met een leeg YAML-bestand en eindigde met een evalsuite die over twee modellen in CI draait.
Dezelfde aanpak geldt voor elke LLM-feature die je bouwt, of het nu een chatbot, een samenvatter of een classificatiepijplijn is. Zolang je een assertie kunt schrijven voor wat "goede output" betekent, kun je er automatisch op testen in plaats van het op het oog te beoordelen.
Als je verder wilt gaan, behandelen de Promptfoo-docs een paar interessante gebieden:
Red teaming: promptfoo redteam run scant op promptinjection en jailbreaks over tientallen aanvalplugins
Aangepaste Python-providers: Wikkel elk intern model of fijn-afgesteld endpoint met file://my_provider.py
CSV-testdata: Schaal je testsuite met file://tests.csv wanneer inline YAML onhandelbaar wordt
Wil je de prompts verbeteren waartegen je test, dan behandelt onze cursus Prompt Engineering met de OpenAI API veel belangrijke technieken die je op elk type AI-ontwikkeling kunt toepassen.
Cursussen Prompt Engineering
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


