
Corso
Comprendere l'ingegneria del prompt
1 ore
235.5K
La maggior parte delle funzionalità LLM viene testata allo stesso modo: provi qualche input, dai un'occhiata ai risultati al volo e pubblichi.
L'hai fatto con un generatore di email. Cinque input in una finestra di chat, output sembrati a posto. Una settimana dopo, metà delle tue email in tono informale suonano come scritte da un avvocato aziendale. Nessuno se n'è accorto perché non c'era modo di accorgersene. I prompt sono cambiati, ma quei cinque test manuali non sono venuti con te.
Promptfoo è una CLI open source che sostituisce quel processo con valutazioni strutturate e ripetibili. Definisci come deve essere un buon output, scegli i modelli e fai eseguire automaticamente ogni combinazione.
OpenAI ha acquisito il progetto nel marzo 2026, e rimane con licenza MIT con supporto per dozzine di provider. Oltre 350.000 sviluppatori lo usano, inclusi team in più del 25% delle aziende Fortune 500.
Questo tutorial ti guida all'installazione di Promptfoo e alla creazione da zero della tua prima suite di valutazione. Useremo un generatore di email come esempio ricorrente, testandolo su GPT-5 e Claude Sonnet 4.6, e collegheremo il tutto a GitHub Actions alla fine.
Prima di entrare nello strumento, è utile capire come funziona il testing degli LLM. È diverso dal testare il codice normale.
Se hai già testato una funzione, conosci lo schema: le dai un input, controlli che l'output corrisponda a ciò che ti aspetti. Con gli LLM non funziona così. Lo stesso prompt può produrre testi diversi ogni volta che lo esegui, quindi non puoi verificare una corrispondenza esatta.
Invece, verifichi proprietà dell'output:
È ciò che fa una valutazione LLM. Esegue il tuo prompt su un set di input e controlla ogni output rispetto a regole che definisci tu. Pensala come una suite di test per i tuoi prompt invece che per il tuo codice.
Quattro termini ricorreranno in tutto l'articolo:
Senza asserzioni, torni a "a me sembra ok". Con le asserzioni, hai una definizione di "corretto" che gira allo stesso modo ogni volta.
Ora che sai cos'è una valutazione, ecco cosa ci fai con Promptfoo.
Dai a Promptfoo tre cose:
Esegue ogni prompt su ogni modello per ogni caso di test e assegna un punteggio ai risultati. Un solo comando, promptfoo eval, fa girare tutto.
Metti che tu abbia un prompt per scrivere email, due modelli (GPT-5 e Claude Sonnet 4) e tre casi di test (informale, formale, urgente). Promptfoo esegue tutte e sei le combinazioni e ti dice quali sono passate e quali no. Niente più prove a mano una per una.
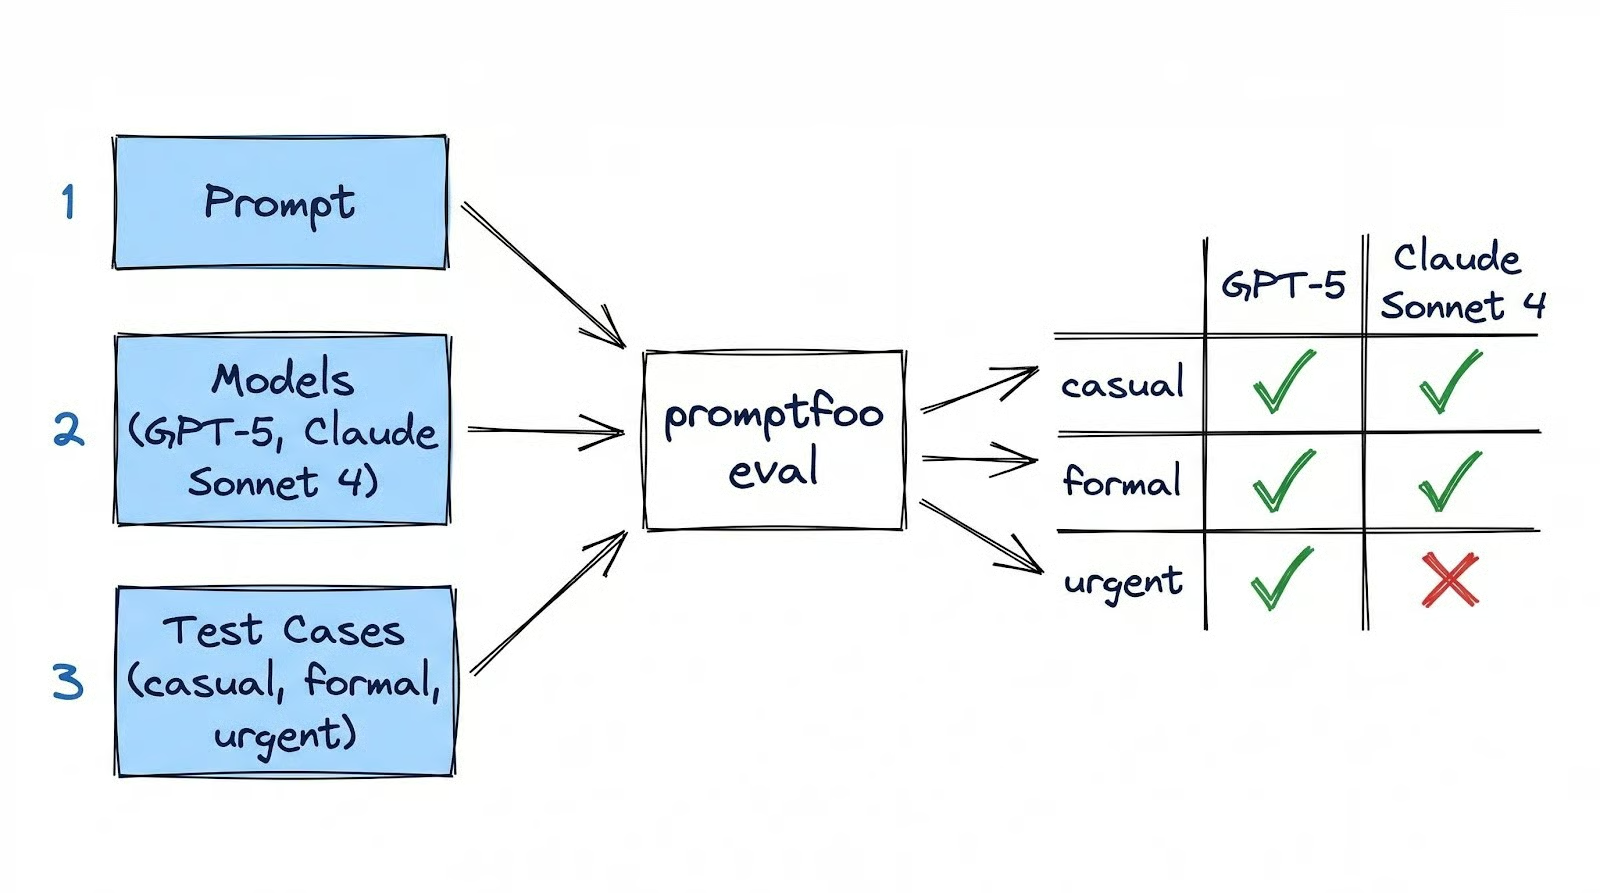
L'intera valutazione vive in un singolo file YAML chiamato promptfooconfig.yaml che versioni insieme al codice. Promptfoo gira sulla tua macchina: configurazione, risultati e cache restano locali. Le uniche chiamate esterne sono alle API dei modelli come OpenAI o Anthropic, che faresti comunque con o senza Promptfoo.
Esistono anche altri strumenti in questo ambito, come DeepEval (nativo Python, stile pytest), LangSmith (monitoraggio in produzione per LangChain) e Braintrust (dashboard per team). Promptfoo è il punto di partenza migliore perché è gratuito, gira in locale e ti porta da zero a una valutazione funzionante più velocemente di tutti.
Installa Promptfoo globalmente e inizializza un nuovo progetto:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
Il comando init ti guida in una configurazione interattiva. Chiede cosa vuoi fare (scegli "Not sure yet") e quale provider di modelli usare (scegli "[OpenAI] GPT 5, GPT 4.1, ...").
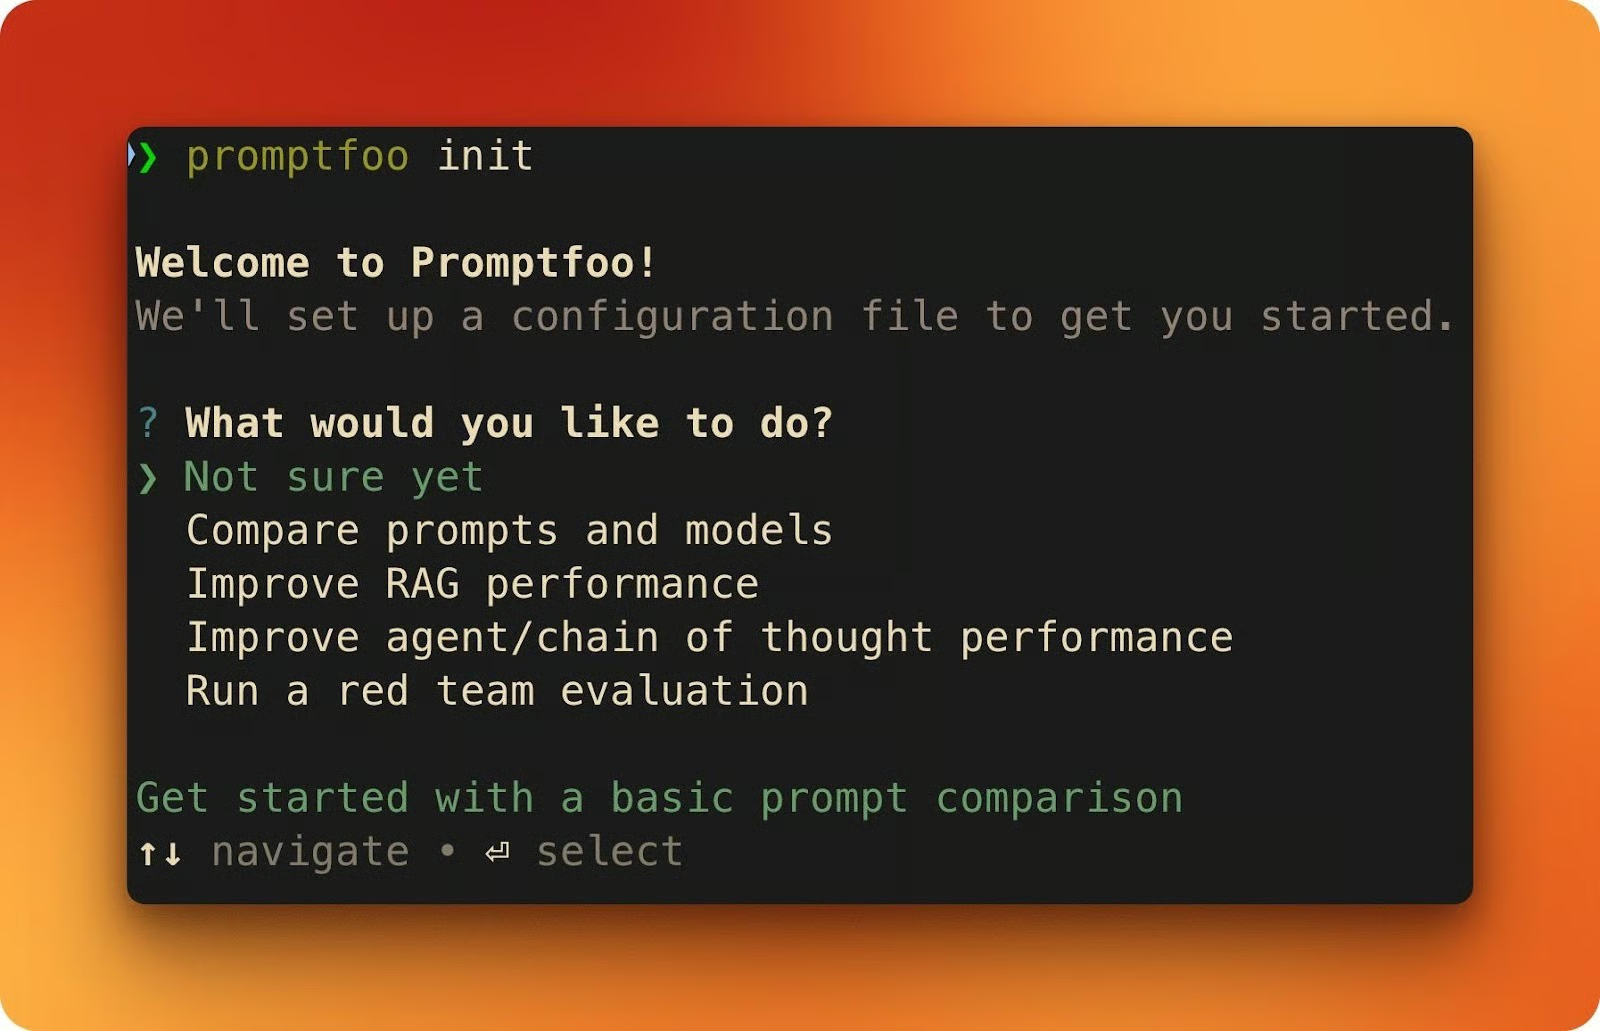
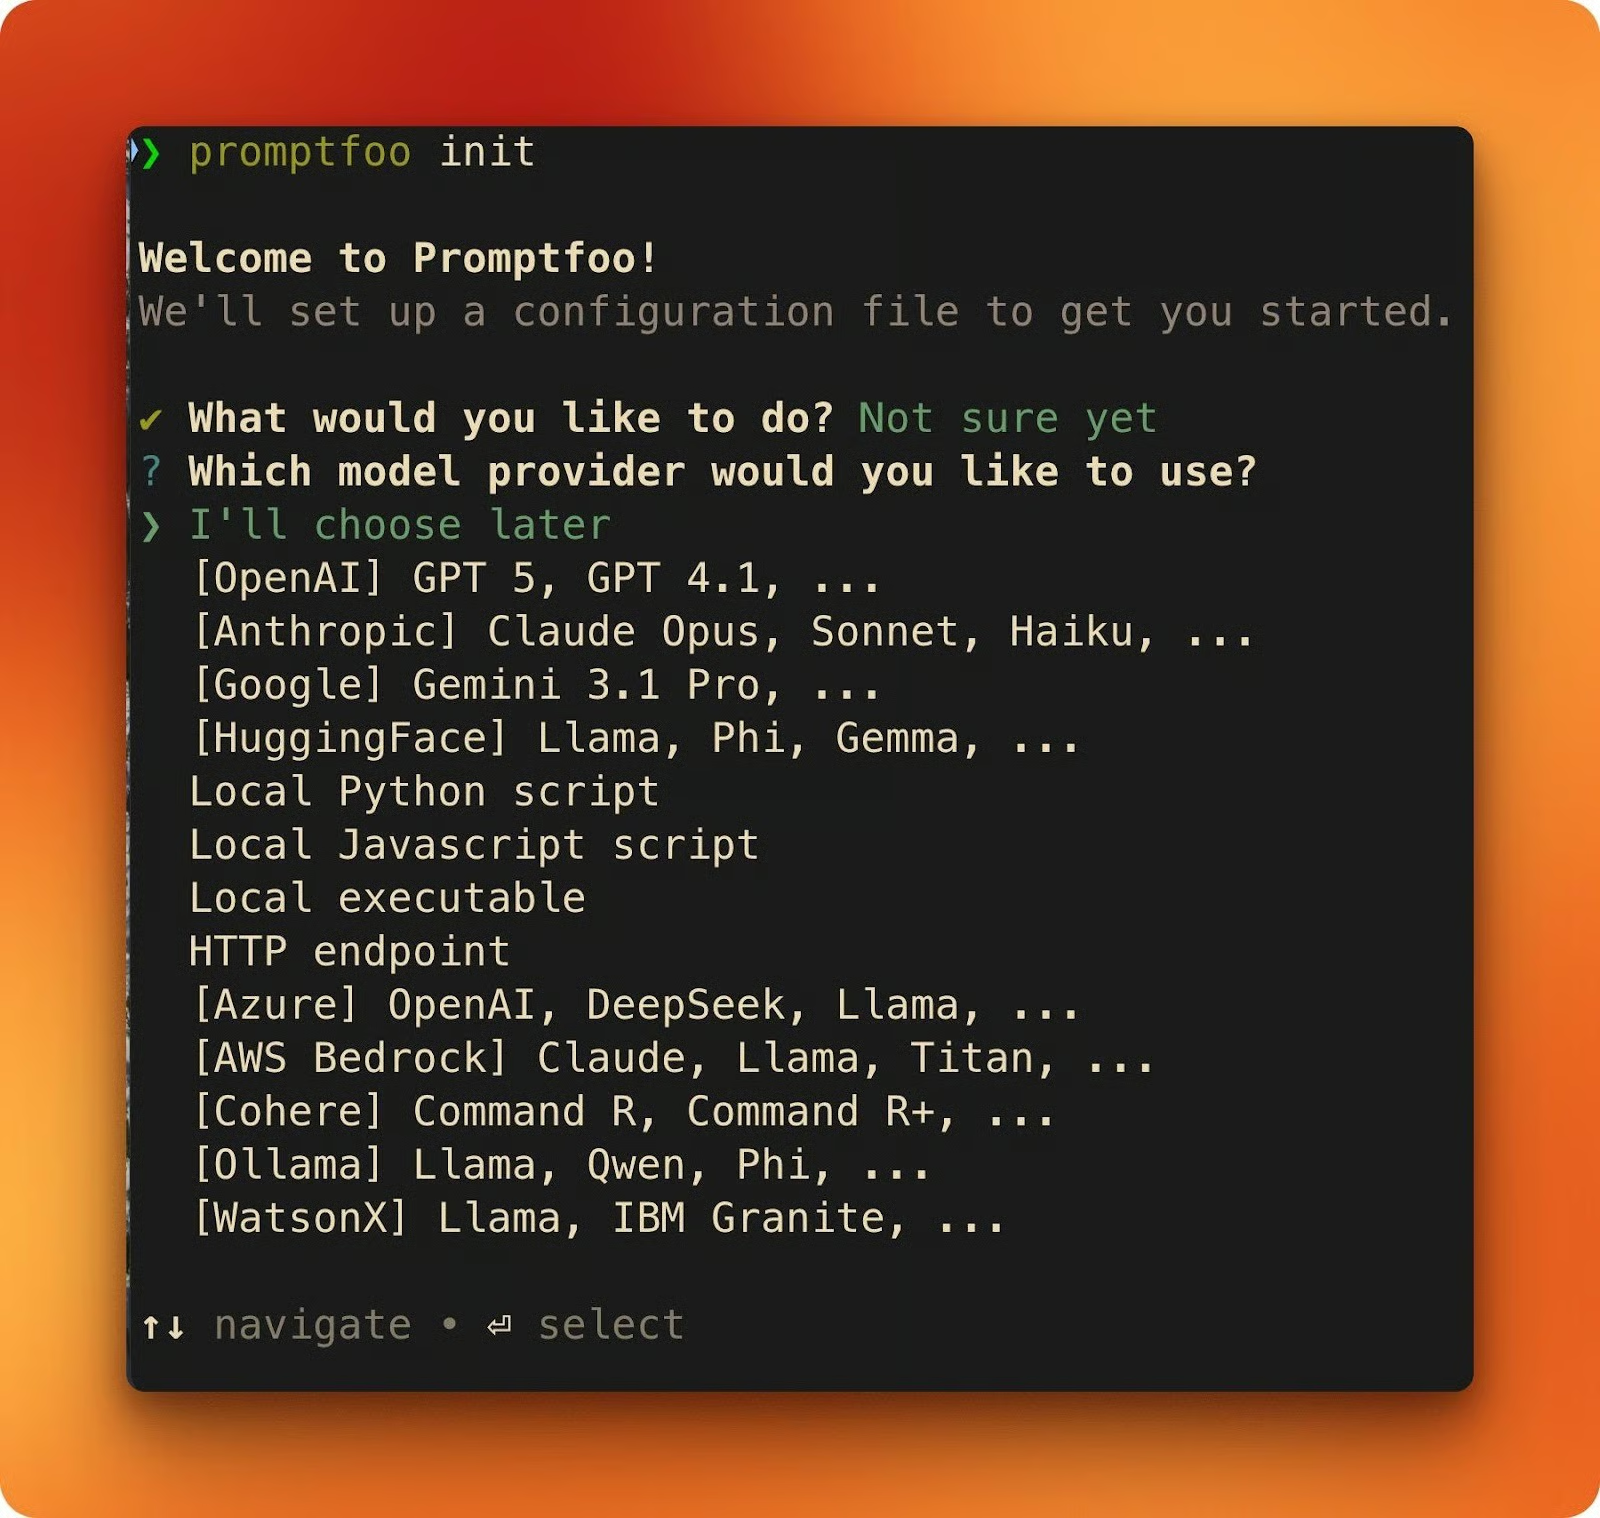
Al termine, avrai due file: un promptfooconfig.yaml di esempio e un README.md.
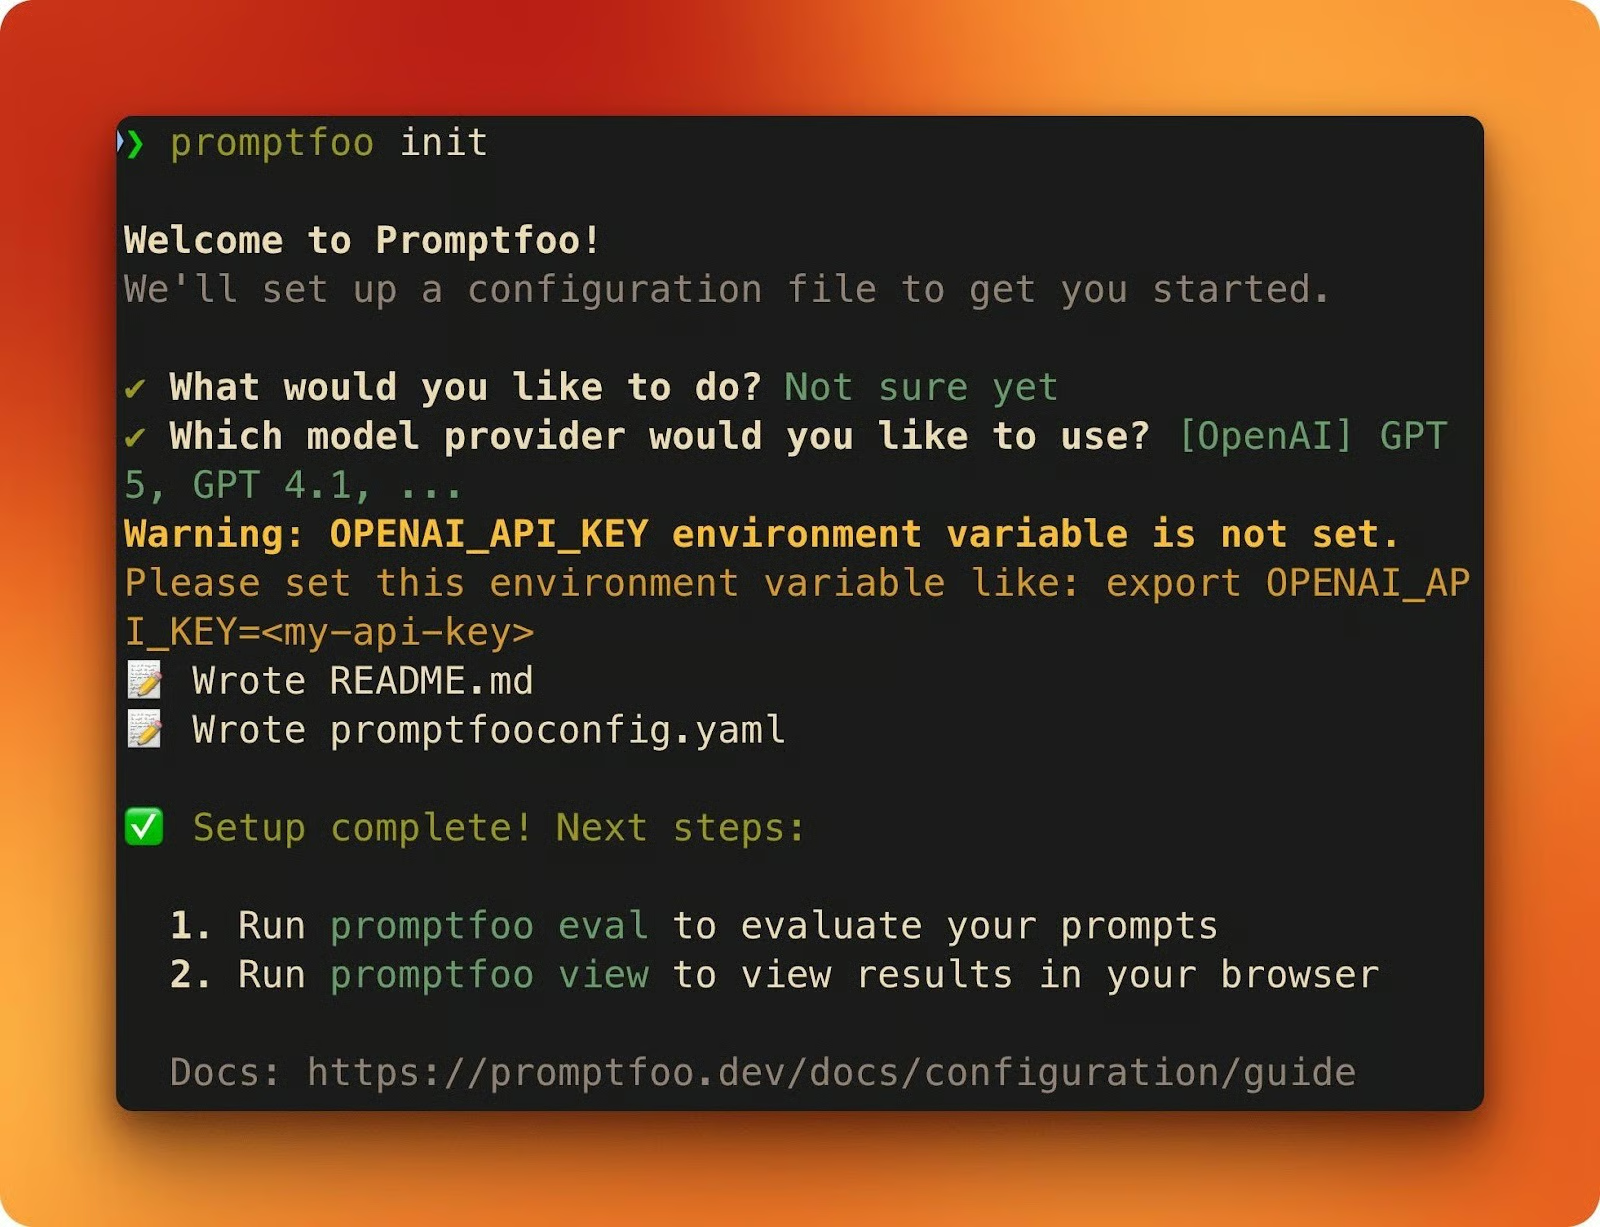
Poi imposta le tue chiavi API. Te ne serve almeno una per eseguire le valutazioni (meglio entrambe per seguire questo tutorial):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Se imposti solo ANTHROPIC_API_KEY e salti OpenAI, Promptfoo usa automaticamente Claude come provider di valutazione per le asserzioni assistite dal modello come llm-rubric.
Apri il promptfooconfig.yaml generato. Ogni configurazione Promptfoo ha tre blocchi fondamentali:
prompts è dove metti i tuoi template di prompt. I segnaposto tra doppie parentesi come {{variable}} vengono riempiti da ciascun caso di test.
providers elenca i modelli contro cui vuoi testare.
tests definisce gli input e le asserzioni che decidono se ogni output passa o fallisce.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Questa configurazione di esempio è un punto di partenza. Nella prossima sezione la sostituiremo con una valutazione reale e spiegheremo in dettaglio la struttura dello YAML.
Ecco il compito: dati dei punti elenco e un tono (informale, formale o urgente), scrivere un'email. Costruirai una valutazione che testa questo su due modelli.
La configurazione completa è disponibile come Gist se vuoi vederla tutta insieme. La costruiremo passo passo qui sotto.
Elimina l'esempio generato e crea un nuovo promptfooconfig.yaml. Parti dal prompt e dai provider:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
Il template del prompt ha due segnaposto: {{bullet_points}} e {{tone}}. Ogni caso di test li riempie con valori diversi. Il campo label su ciascun provider ti dà intestazioni di colonna leggibili nella vista dei risultati invece di ID di modello grezzi.
Poi aggiungi un blocco defaultTest. Le asserzioni dentro defaultTest si applicano automaticamente a ogni caso di test, così non le ripeti:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Questo fa fallire qualsiasi risposta più lenta di 30 secondi. I modelli di frontiera come GPT-5 possono impiegare 10–20 secondi per richiesta a causa dei token di ragionamento, quindi la soglia deve essere generosa. La imposti una volta e copre ogni test.
Ora aggiungi i casi di test. Ognuno fornisce input diversi e le proprie asserzioni:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Ogni caso di test abbina due tipi di asserzioni.
icontains è un semplice controllo di stringa: l'output include "mockups", senza distinzione fra maiuscole e minuscole? È veloce, gratis e non chiama alcuna API.
llm-rubric invia l'output a un altro LLM e gli chiede di valutarlo rispetto alla tua rubrica. Costa token, ma coglie aspetti che il confronto di stringhe non può, come se un'email suoni davvero informale.
Esegui la valutazione:
promptfoo evalPoi apri i risultati nel browser:
promptfoo view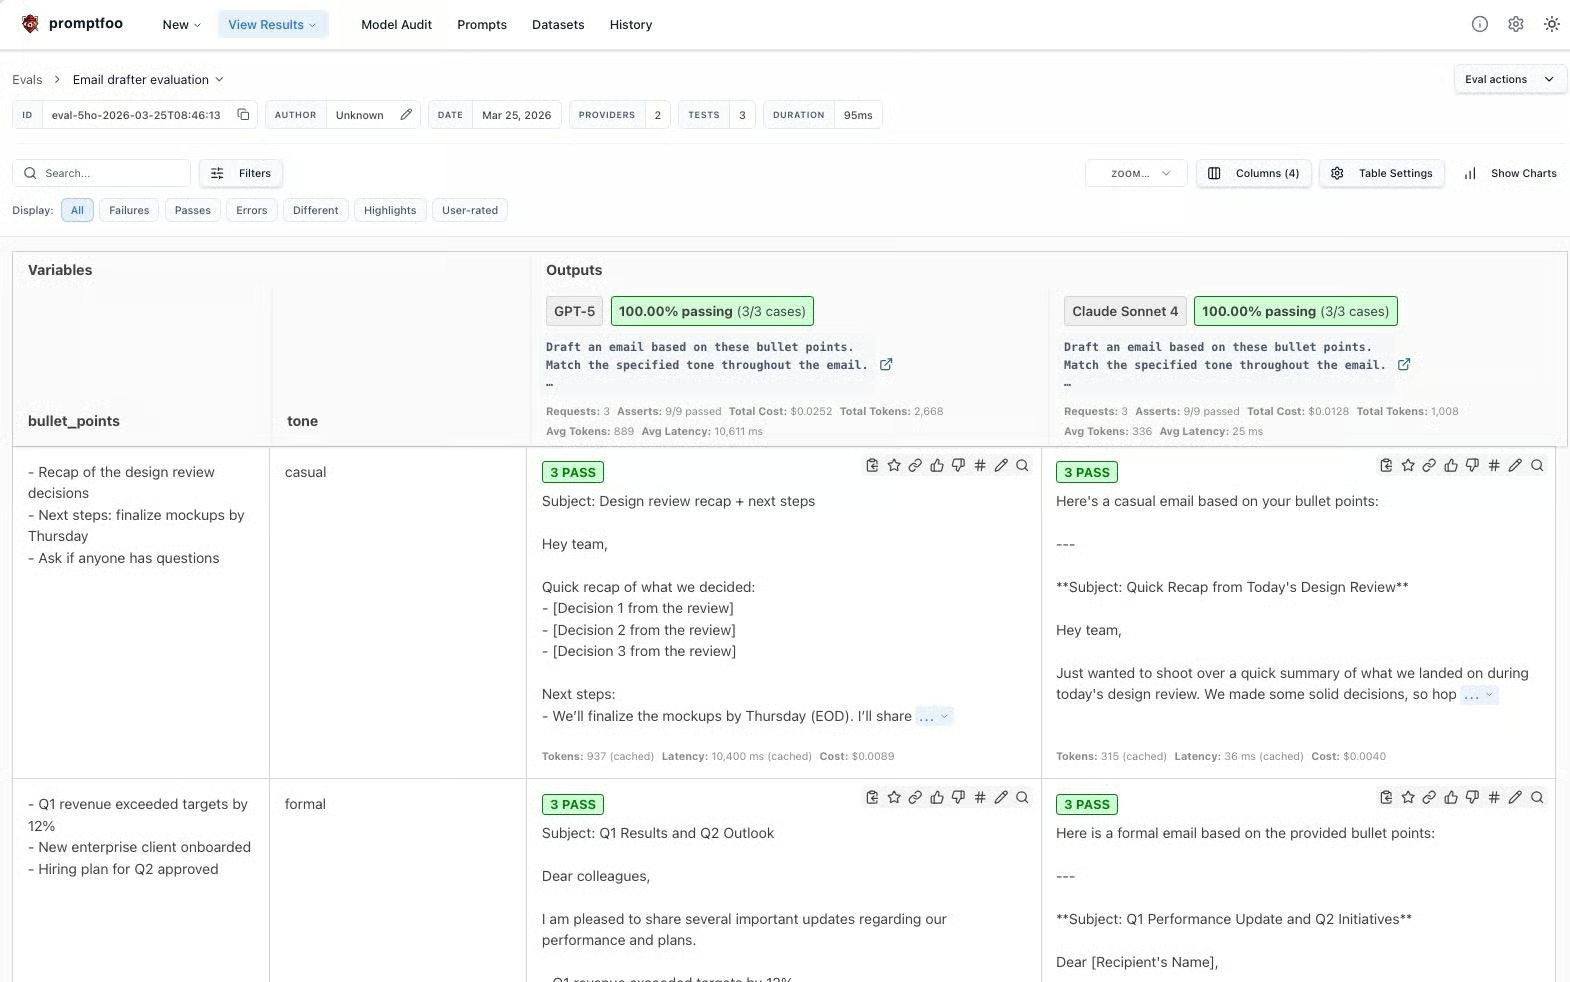
La UI web mostra i provider come colonne e i casi di test come righe. Ogni cella mostra pass/fail per ogni asserzione, e puoi cliccare in una cella per vedere l'output completo e i dettagli della valutazione.
Promptfoo memorizza nella cache su disco le risposte API per impostazione predefinita (TTL di 14 giorni), quindi rieseguire la stessa valutazione non costa nulla. Usa --no-cache quando vuoi risposte fresche.
Nella prima valutazione hai usato icontains e llm-rubric. Questi sono due dei molti tipi di asserzioni supportati da Promptfoo. Questa sezione passa in rassegna le principali categorie, e aggiungeremo via via asserzioni alla configurazione del generatore di email.
Queste girano in locale, non costano nulla e restituiscono risultati istantaneamente.
|
Tipo |
Cosa verifica |
|
|
L'output include una sottostringa (sensibile o meno alle maiuscole) |
|
|
L'output corrisponde a un pattern (intercetta |
|
|
L'output esclude qualcosa (artefatti di template, rifiuti, testo segnaposto) |
|
|
La risposta arriva sotto N millisecondi |
|
|
La risposta costa meno di $X |
Hai già usato icontains e latency. Aggiungiamo not-contains al caso di test informale. Se il modello predefinisce un linguaggio formale, potrebbe iniziare con "Dear" invece di qualcosa di informale come "Hey". Per intercettarlo basta una riga:
- type: not-contains
  value: \"Dear\"
Aggiungila alla lista assert del caso di test informale e riesegui. Entrambi i modelli dovrebbero passare: GPT-5 spesso apre con "Hey team," e anche Claude Sonnet 4. Se uno dei due avesse iniziato con "Dear Colleagues," questa asserzione l'avrebbe segnalato subito.
Ogni tipo di asserzione supporta anche il prefisso not-: not-regex, not-equals e così via.
Queste costano token, ma sanno giudicare aspetti che il confronto di stringhe non può. Hai già usato llm-rubric nella prima valutazione. La rubrica che scrivi fa la differenza.
Una rubrica vaga come "L'email suona professionale" non dice nulla di utile al valutatore. Una specifica gli dà qualcosa da misurare:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
Quando riesegui la valutazione con questa rubrica, anche l'output del valutatore diventa specifico:
Più la rubrica è specifica, più la valutazione diventa coerente e utile.
Promptfoo include anche answer-relevance (l'output ha risposto alla domanda?) e similar (similarità coseno rispetto a un riferimento via embedding), entrambi utili per RAG e applicazioni di ricerca.
Quando i tipi integrati non coprono la tua logica, scrivi le tue. Per il generatore di email, potresti voler controllare che gli output restino entro una lunghezza ragionevole. Ecco un'asserzione inline che passa se l'email è tra 50 e 200 parole:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Aggiungila al caso di test informale e riesegui. Nella mia esecuzione, entrambi i modelli sono passati: GPT-5 a 54 parole, Claude Sonnet 4 a 187. Ma tieni a mente questa asserzione per la prossima sezione, perché non è passata ovunque.
Per controlli più complessi, metti la logica in un file separato:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
Fai riferimento nel config con type: python e value: file://assert_length.py. Il campo reason compare nella UI dei risultati, così vedi esattamente perché un test è passato o fallito.
Ecco come appare un fallimento reale.
Aggiungi l'asserzione Python sul conteggio parole a tutti e tre i casi di test ed esegui la valutazione completa su entrambi i modelli. Nel mio caso, cinque delle sei combinazioni sono passate. Claude Sonnet 4.6 non ha superato il caso di test di urgenza (può o meno succedere sulla tua macchina, dato il comportamento non deterministico degli LLM).
In quell'esecuzione, l'output era di 207 parole, sette oltre il limite. La llm-rubric è passata, confermando che l'email usava "linguaggio urgente e diretto" con "azioni chiare". Anche icontains è passata, dato che "Friday" era presente nell'output.
Ma l'asserzione Python sul conteggio parole è fallita. Claude ha anteposto meta-commento ("Here is a draft email based on your bullet points with an urgent tone:") prima della vera email, spingendo il conteggio oltre 200.
Questo è il genere di cosa che non noteresti a occhio. L'email in sé era a posto: tono giusto, contenuto giusto. Ma l'output era troppo lungo perché il modello ha aggiunto testo che non faceva parte dell'email. Un'asserzione l'ha intercettato e la valutazione ha segnalato l'intero caso di test.
La correzione può andare in due direzioni: adeguare il prompt per dire al modello di non includere preamboli, oppure alzare il limite di parole. In ogni caso, riesegui la valutazione e controlli che passi.
A questo punto, il caso di test informale ha quattro asserzioni: icontains, not-contains, llm-rubric e l'asserzione Python sul conteggio parole. Non hanno tutte la stessa importanza. Il campo weight ti permette di esprimerlo:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
Il punteggio di ciascuna asserzione viene moltiplicato per il suo peso, e il test calcola una media pesata. La threshold imposta il punteggio minimo per passare. Qui, la rubrica sul tono conta il doppio dei controlli per parola chiave, e il conteggio parole conta la metà.
Rieseguendo il test informale con questi pesi, entrambi i modelli ottengono 1,0 e passano. Ma se la llm-rubric fosse fallita (peso 2) mentre il conteggio parole fosse passato (peso 0,5), il punteggio pesato scenderebbe sotto la soglia 0,7 e il test fallirebbe. I pesi ti permettono di dire a Promptfoo cosa ti interessa di più.
La configurazione ha già due provider, quindi promptfoo eval ha testato GPT-5 e Claude Sonnet 4 in un'unica passata. Apri promptfoo view e li vedi come colonne separate nei risultati, con ogni caso di test valutato indipendentemente per ciascun modello.
Nella mia esecuzione, GPT-5 ha superato tutte e sei le asserzioni sui tre casi di test. Claude Sonnet 4 ne ha superate cinque ma ha fallito il conteggio parole sull'email urgente.
È il tipo di differenza che non noteresti provando qualche prompt a mano, ma che appare subito nella griglia. Stai confrontando punteggi rispetto alle stesse asserzioni sugli stessi input, non il ricordo di quale modello "ti era sembrato meglio" l'ultima volta.
Gli output degli LLM non sono deterministici, però. Lo stesso prompt può produrre risultati diversi in esecuzioni consecutive, e una singola passata non ti dice se un modello è affidabilmente buono o ha avuto fortuna. Il flag --repeat tiene conto di questo:
promptfoo eval --repeat 3Esegue ogni caso di test tre volte per provider. Se un modello supera due volte l'asserzione sul tono ma fallisce alla terza, è un segnale di affidabilità che ti perderesti con una sola passata.
Eseguire valutazioni in locale funziona in sviluppo, ma dipende dal fatto che chi modifica il prompt si ricordi di farle girare. Promptfoo ha una GitHub Action ufficiale che elimina questa dipendenza eseguendo la tua suite di valutazione su ogni pull request e pubblicando i risultati come commento.
Per configurarla, crea un file di workflow nel tuo repo:
mkdir -p .github/workflowsPoi crea .github/workflows/prompt-eval.yml con il contenuto seguente:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Prima che funzioni, devi aggiungere la tua OPENAI_API_KEY (e opzionalmente ANTHROPIC_API_KEY) come secret del repository nel tuo repo GitHub sotto Settings > Secrets and variables > Actions.
Il filtro paths significa che l'azione si attiva solo quando qualcuno modifica file in prompts/. Lo step di checkout è necessario perché l'action usa git internamente per fare il diff dei file di prompt tra i branch. Esegue l'intera suite di valutazione e pubblica un commento sulla PR con i risultati e un link al visualizzatore web.
Per un controllo più fine della logica di pass/fail, puoi analizzare direttamente l'output JSON:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
Il flusso di lavoro da qui:
Le modifiche ai prompt ricevono lo stesso trattamento test-prima-del-merge delle modifiche al codice.
Il generatore di email dell'introduzione ha ancora un problema di tono, ma ora c'è un test che lo intercetta prima degli utenti. Sei partito da un file YAML vuoto e sei arrivato a una suite di valutazione che gira su due modelli in CI.
Lo stesso approccio vale per qualsiasi funzione LLM tu costruisca, che sia un chatbot, un riassuntore o una pipeline di classificazione. Finché puoi scrivere un'asserzione su cosa significa "buon output", puoi testarlo automaticamente invece di andare a occhio.
Quando sei pronto a proseguire, la documentazione di Promptfoo copre alcune aree da esplorare:
Red teaming: promptfoo redteam run scansiona per prompt injection e jailbreak su dozzine di plugin d'attacco
Provider Python personalizzati: Incapsula qualsiasi modello interno o endpoint fine-tuned con file://my_provider.py
Dati di test CSV: Scala la tua suite di test con file://tests.csv quando lo YAML inline diventa ingestibile
Se vuoi migliorare i prompt che stai testando, il nostro corso Prompt Engineering with the OpenAI API copre molte tecniche importanti che puoi applicare a qualsiasi tipo di sviluppo AI.
Corsi di Prompt Engineering
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



