Curso
Noções Básicas de Engenharia de Prompts.
1 h
232.4K
A maioria dos recursos com LLM é testada do mesmo jeito: tenta alguns inputs, dá uma olhada no resultado e coloca no ar.
Você fez isso com um gerador de e-mails. Cinco inputs na janela do chat, os outputs pareceram ok. Uma semana depois, metade dos e-mails com tom casual soa como se tivessem sido escritos por um advogado corporativo. Ninguém percebeu porque não havia como perceber. Os prompts mudaram, mas aqueles cinco testes manuais não foram com você.
Promptfoo é um CLI open source que substitui esse processo por avaliações estruturadas e repetíveis. Você define o que é um bom output, escolhe os modelos e roda todas as combinações automaticamente.
A OpenAI adquiriu o projeto em março de 2026, e ele continua sob licença MIT com suporte a dezenas de provedores. Mais de 350 mil desenvolvedores usam a ferramenta, incluindo times em mais de 25% das empresas da Fortune 500.
Este tutorial mostra como configurar o Promptfoo e criar sua primeira suíte de avaliações do zero. Vamos usar um redator de e-mails como exemplo, testando no GPT-5 e no Claude Sonnet 4.6, e integrando tudo ao GitHub Actions no final.
Antes de falar da ferramenta, vale entender como funciona o teste de LLM. É diferente de testar código comum.
Se você já testou uma função, conhece o padrão: dá um input e confere se o output bate com o esperado. Com LLMs não é assim. O mesmo prompt pode gerar textos diferentes a cada execução, então você não consegue verificar por igualdade exata.
Em vez disso, você verifica propriedades do output:
É isso que um eval de LLM faz. Ele roda seu prompt contra um conjunto de inputs e verifica cada output com base em regras que você define. Pense como uma suíte de testes para prompts, não para código.
Quatro termos vão aparecer ao longo do artigo:
Sem assertions, você volta ao "pra mim está bom". Com elas, você tem uma definição de "correto" que roda igual sempre.
Agora que você sabe o que é um eval, aqui vai o que o Promptfoo faz com ele.
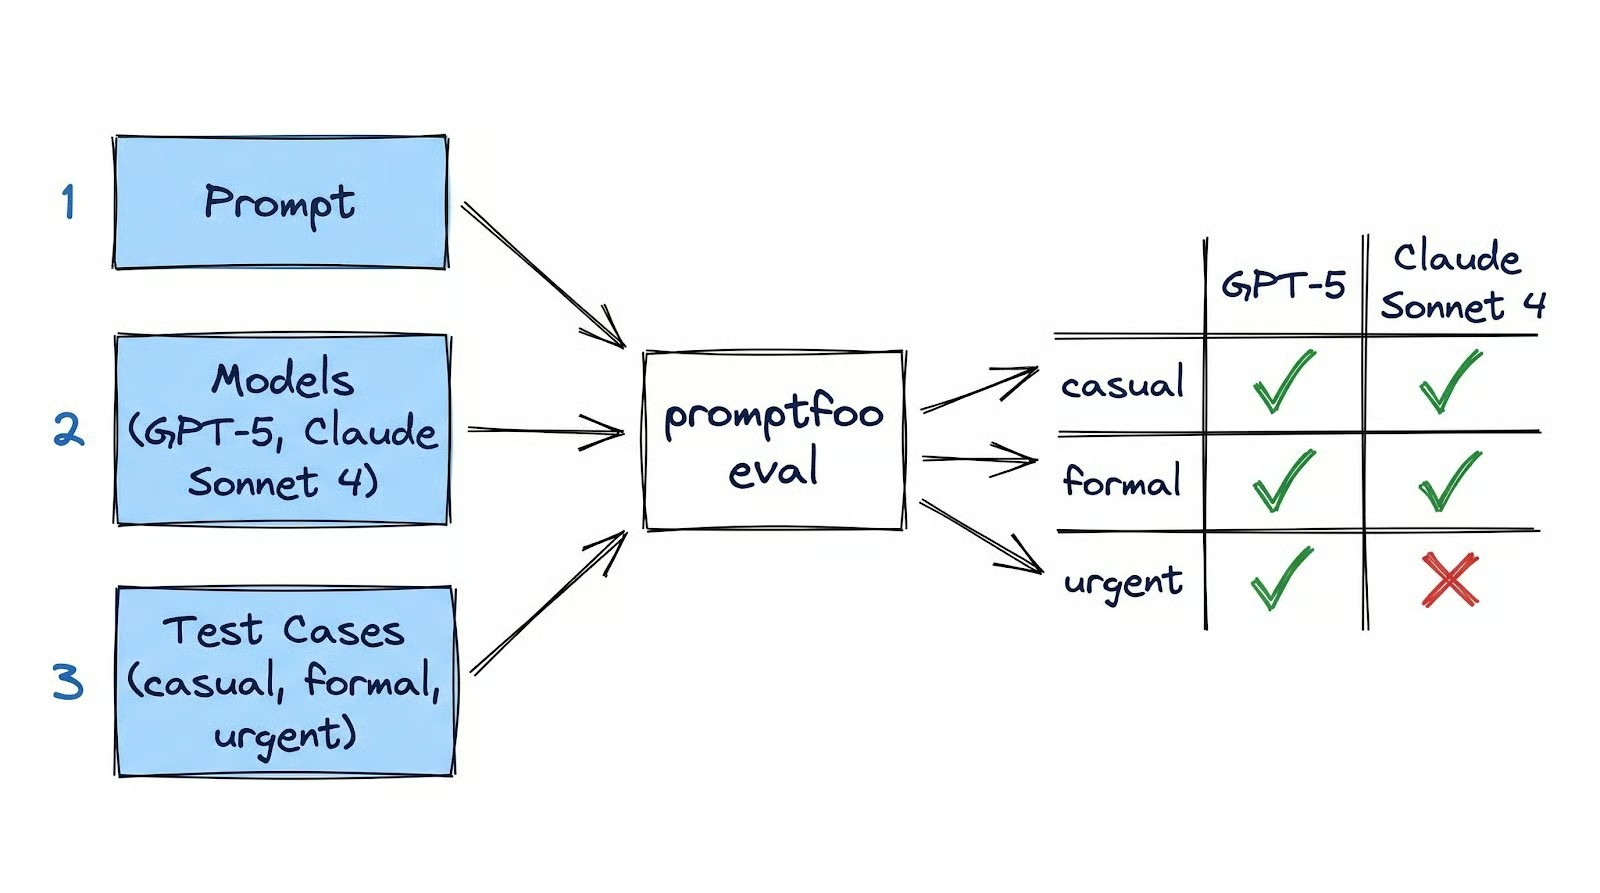
Você entrega três coisas ao Promptfoo:
Ele roda cada prompt em cada modelo para cada caso de teste e pontua os resultados. Um comando, promptfoo eval, executa tudo.
Suponha que você tenha um prompt de e-mail, dois modelos (GPT-5 e Claude Sonnet 4) e três casos (casual, formal, urgente). O Promptfoo roda as seis combinações e informa o que passou e o que falhou. Chega de testar um por um na mão.
Todo o eval vive em um único arquivo YAML chamado promptfooconfig.yaml que você versiona junto com o código. O Promptfoo roda na sua máquina: seu config, resultados e cache ficam locais. As únicas chamadas externas são para as APIs de modelo como OpenAI ou Anthropic — que você faria com ou sem o Promptfoo.
Há outras ferramentas nesse espaço, como DeepEval (nativa em Python, estilo pytest), LangSmith (monitoramento em produção para LangChain) e Braintrust (dashboards para times). O Promptfoo é o melhor ponto de partida porque é gratuito, roda localmente e leva você do zero a um eval funcionando mais rápido que todos eles.
Instale o Promptfoo globalmente e inicialize um novo projeto:
npm install -g promptfoo
mkdir email-writer-eval
cd email-writer-eval
promptfoo init
O comando init guia você por uma configuração interativa. Ele pergunta o que você quer fazer (escolha "Not sure yet") e qual provider de modelo usar (escolha "[OpenAI] GPT 5, GPT 4.1, ...").
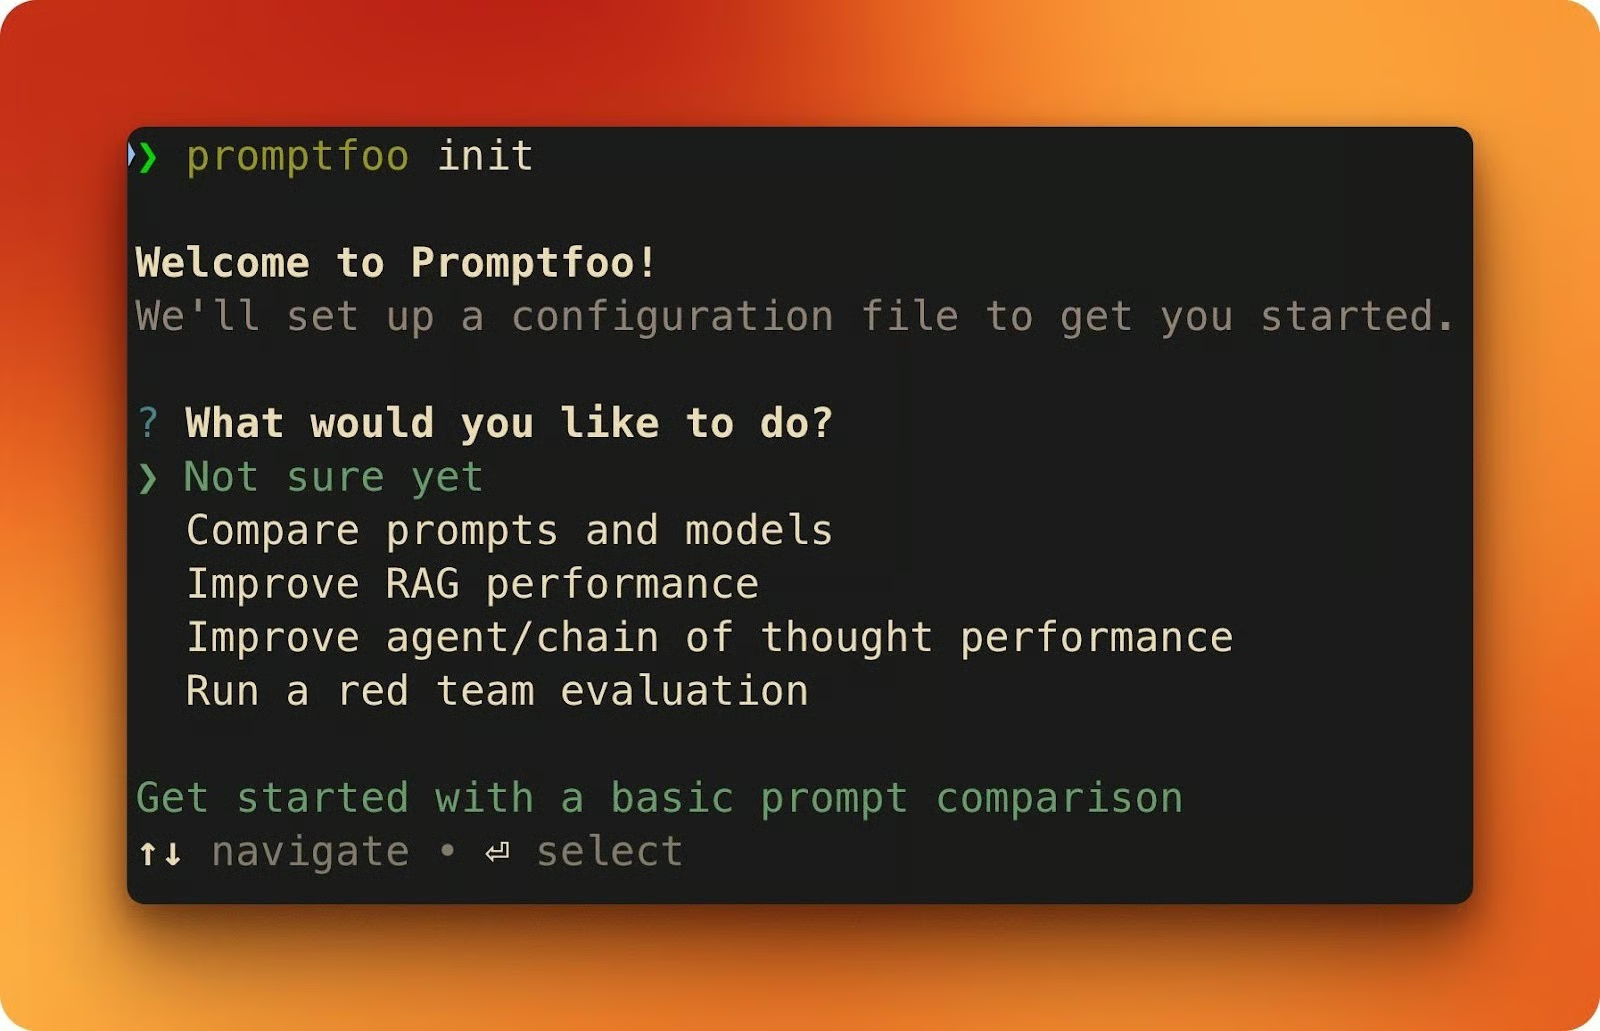
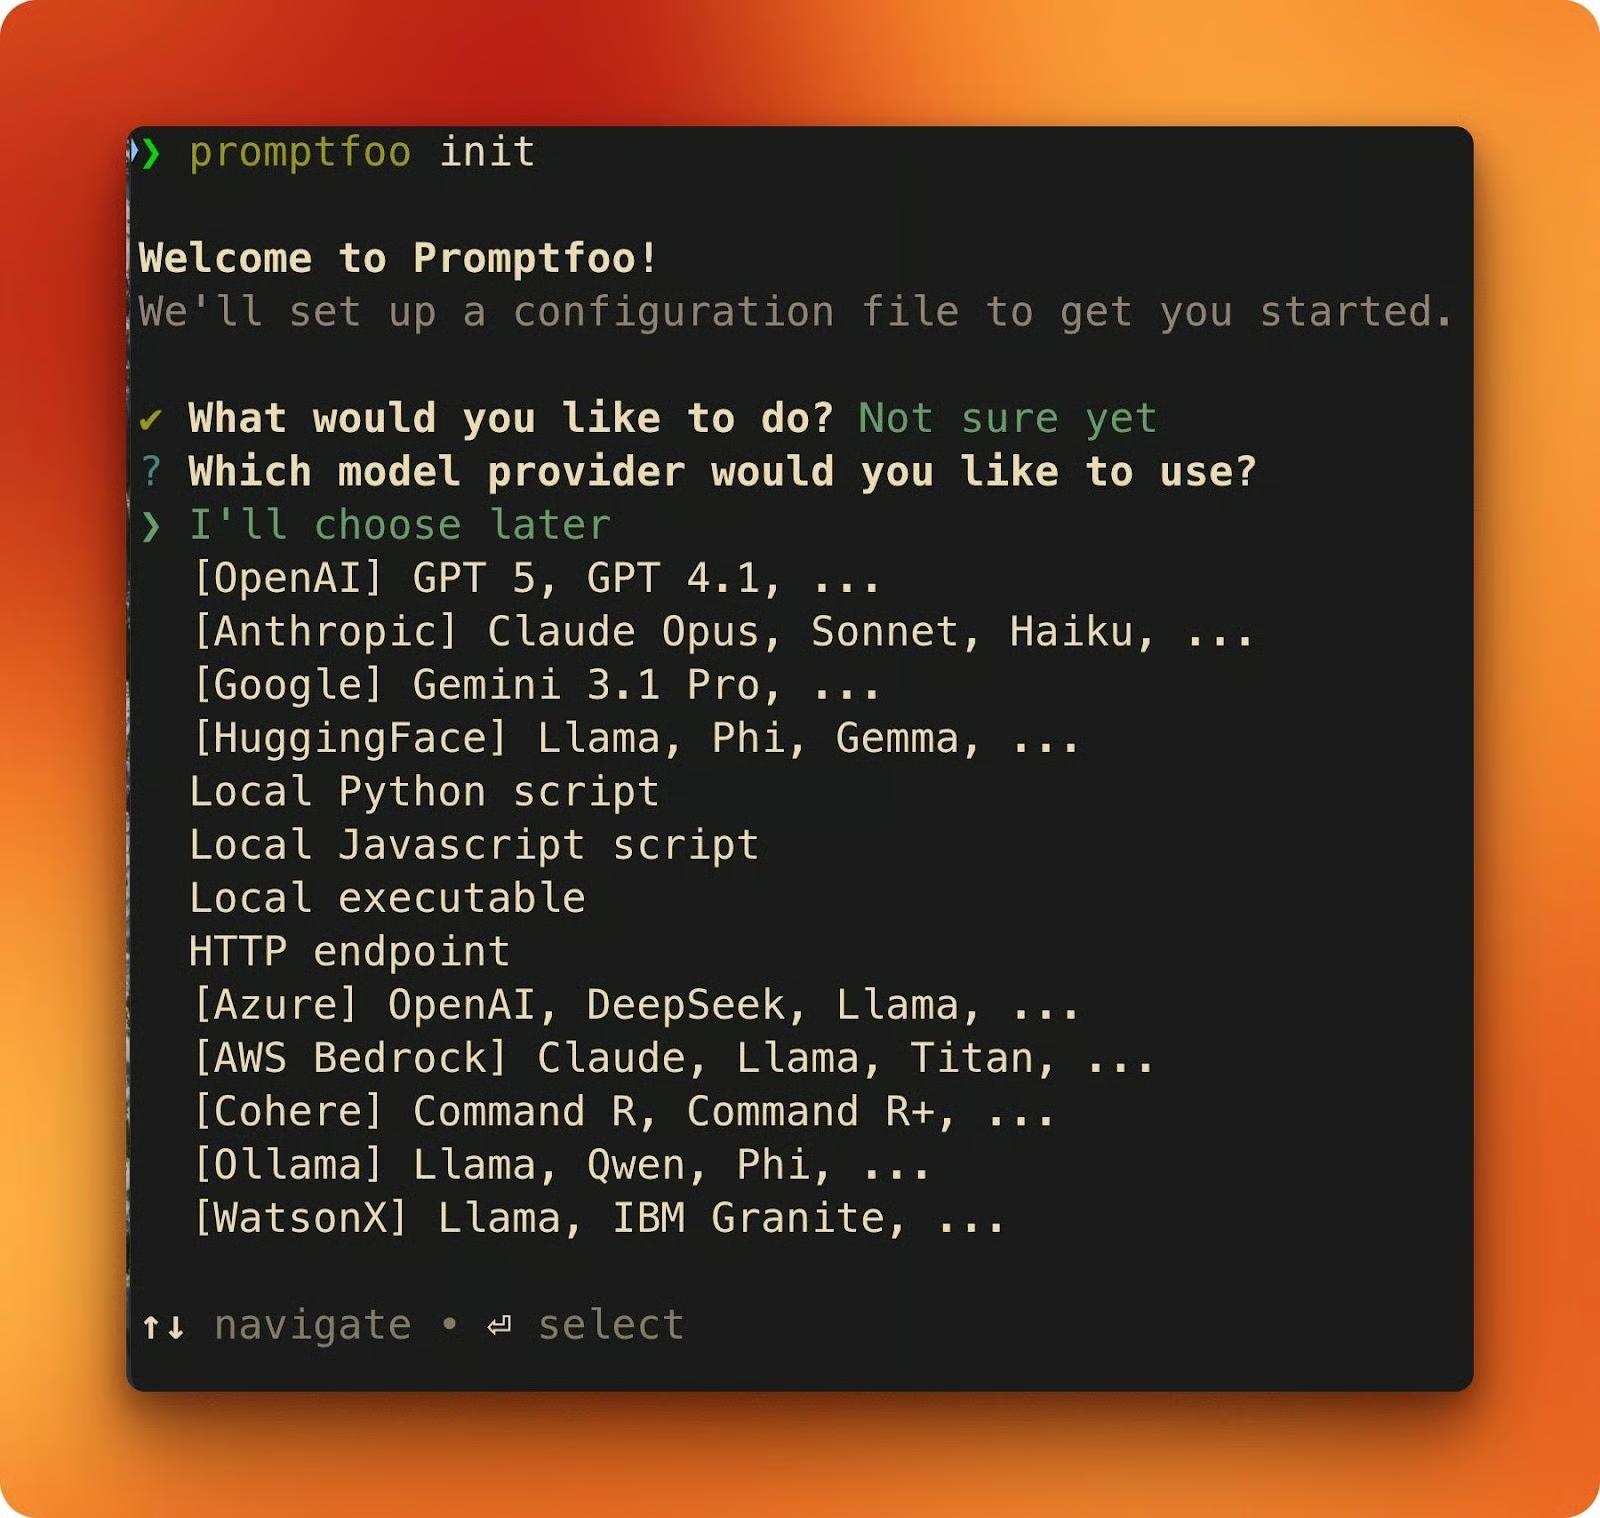
Ao finalizar, você terá dois arquivos: um promptfooconfig.yaml de exemplo e um README.md.
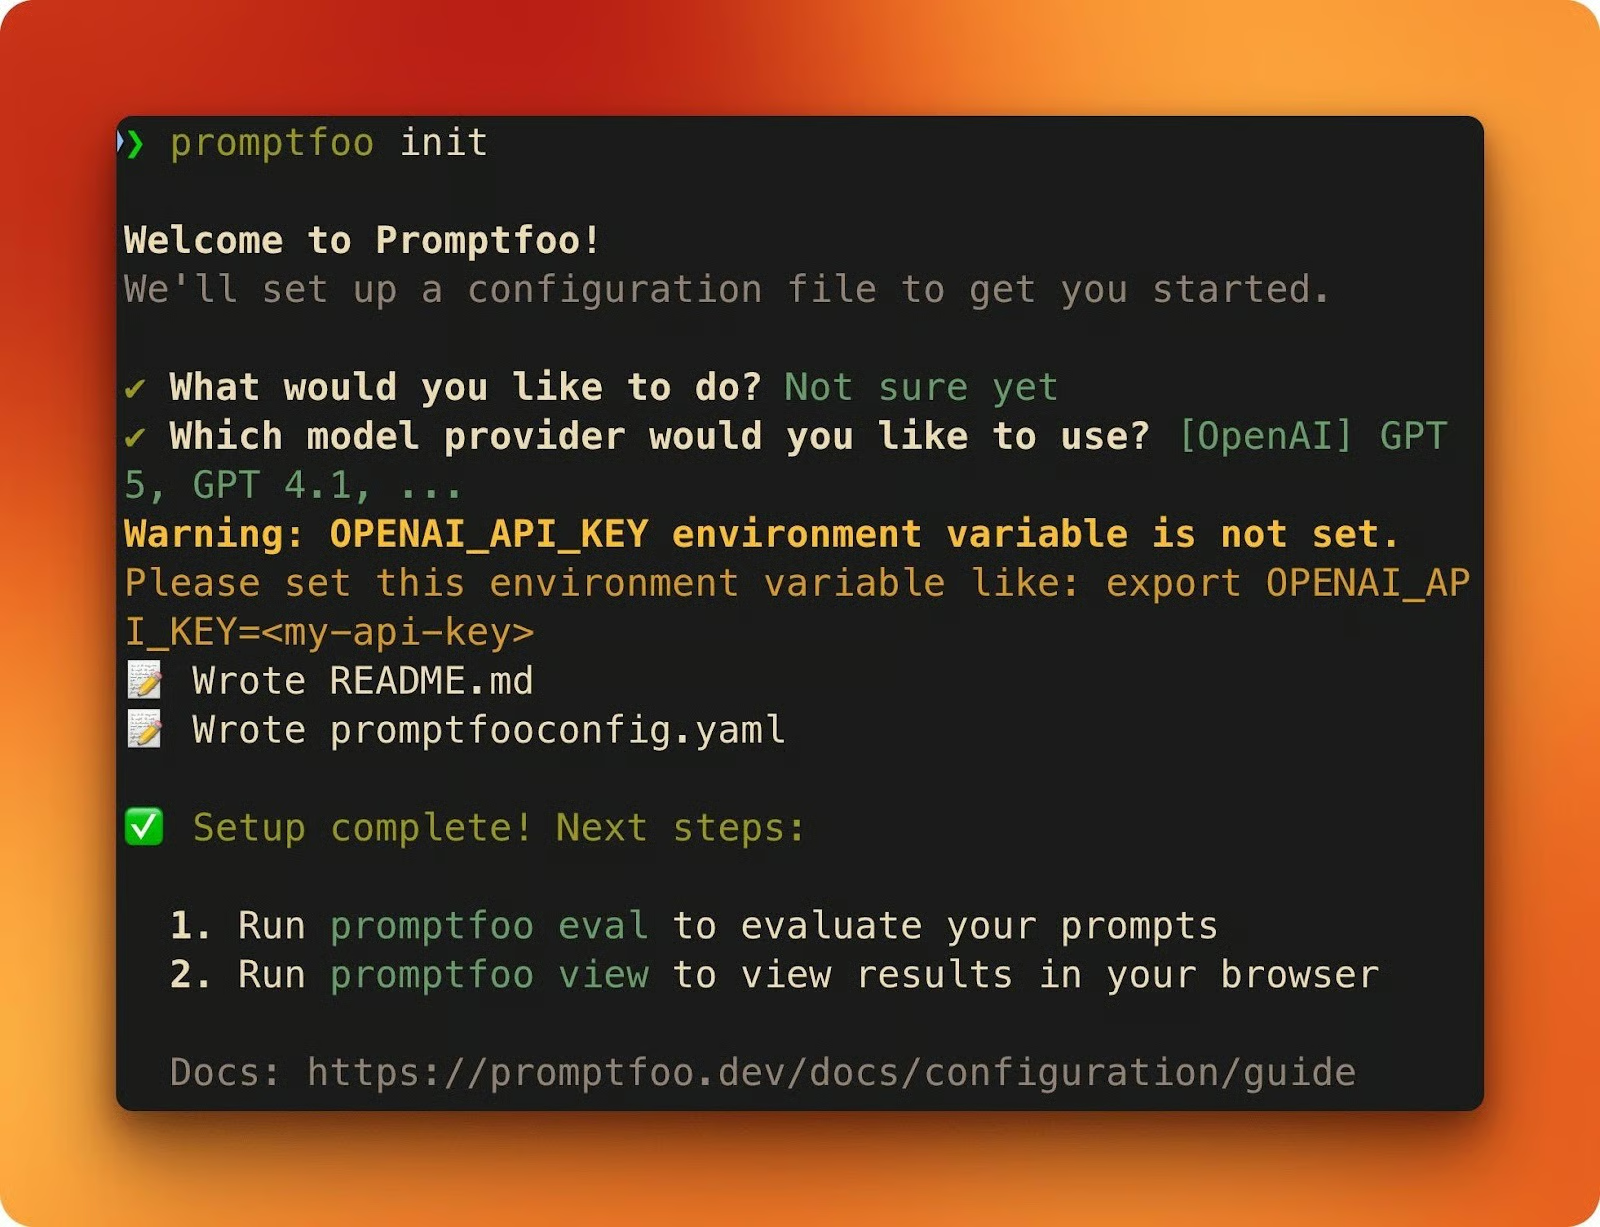
Em seguida, defina suas chaves de API. Você precisa de pelo menos uma para rodar os evals (tenha as duas para acompanhar este tutorial):
export OPENAI_API_KEY=sk-...
export ANTHROPIC_API_KEY=sk-ant-...
Se você definir apenas ANTHROPIC_API_KEY e pular a OpenAI, o Promptfoo usa automaticamente o Claude como provedor de avaliação para assertions assistidas por modelo como llm-rubric.
Abra o promptfooconfig.yaml gerado. Todo config do Promptfoo tem três blocos básicos:
prompts é onde entram seus templates de prompt. Espaços reservados com chaves duplas como {{variable}} são preenchidos por cada caso de teste.
providers lista os modelos contra os quais você quer testar.
tests define os inputs e as assertions que decidem se cada output passa ou falha.
prompts:
  - \"Your prompt template with {{variable}}\"
...

providers:
  - openai:chat:gpt-5
...

tests:
  - vars:
      variable: \"test input\"
    assert:
      - type: contains
        value: \"expected substring\"
Esse config de exemplo é só um ponto de partida. Na próxima seção, vamos substituí-lo por uma avaliação real e explicar a estrutura do YAML em detalhes.
A tarefa é: dado um conjunto de bullet points e um tom (casual, formal ou urgente), escrever um e-mail. Você vai criar um eval que testa isso em dois modelos.
O config completo está disponível como um Gist se quiser ver tudo de uma vez. Vamos montar parte por parte abaixo.
Apague o exemplo gerado e crie um novo promptfooconfig.yaml. Comece pelo prompt e pelos providers:
description: \"Email writer evaluation\"

prompts:
  - |
    Draft an email based on these bullet points.
    Match the specified tone throughout the email.

    Bullet points:
    {{bullet_points}}

    Tone: {{tone}}

providers:
  - id: openai:chat:gpt-5
    label: \"GPT-5\"
  - id: anthropic:messages:claude-sonnet-4-6
    label: \"Claude Sonnet 4.6\"
O template de prompt tem dois placeholders: {{bullet_points}} e {{tone}}. Cada caso de teste preenche esses campos com valores diferentes. O campo label em cada provider gera cabeçalhos de coluna legíveis nos resultados, em vez de IDs crus de modelo.
Agora, adicione um bloco defaultTest. As assertions dentro de defaultTest valem automaticamente para todos os casos de teste, evitando repetição:
defaultTest:
  assert:
    - type: latency
      threshold: 30000
Isso reprova qualquer resposta mais lenta que 30 segundos. Modelos de fronteira como o GPT-5 podem levar 10–20 segundos por requisição devido a tokens de raciocínio, então o limite precisa de folga. Você define uma vez e cobre todos os testes.
Agora adicione os casos de teste. Cada um traz inputs diferentes e suas próprias assertions:
tests:
  - vars:
      bullet_points: |
        - Recap of the design review decisions
        - Next steps: finalize mockups by Thursday
        - Ask if anyone has questions
      tone: \"casual\"
    assert:
      - type: icontains
        value: \"mockups\"
      - type: llm-rubric
        value: \"The email uses a casual tone with contractions and short sentences\"

  - vars:
      bullet_points: |
        - Q1 revenue exceeded targets by 12%
        - New enterprise client onboarded
        - Hiring plan for Q2 approved
      tone: \"formal\"
    assert:
      - type: icontains
        value: \"Q1\"
      - type: llm-rubric
        value: \"The email maintains a formal, professional tone throughout\"

  - vars:
      bullet_points: |
        - API migration deadline is Friday at 5pm
        - Three endpoints still need updating
        - Downtime window is Saturday 2-6am
      tone: \"urgent\"
    assert:
      - type: icontains
        value: \"Friday\"
      - type: llm-rubric
        value: \"The email conveys urgency with direct language and clear action items\"
Cada caso de teste combina dois tipos de assertions.
icontains é uma checagem simples de string: o output incluiu "mockups", sem diferenciar maiúsculas/minúsculas? É rápido, gratuito e não chama API.
llm-rubric envia o output para outro LLM e pede que ele faça a avaliação com base na sua rubrica. Custa tokens, mas pega coisas que matching de string não pega, como se um e-mail realmente soa casual.
Rode a avaliação:
promptfoo evalDepois, abra os resultados no navegador:
promptfoo view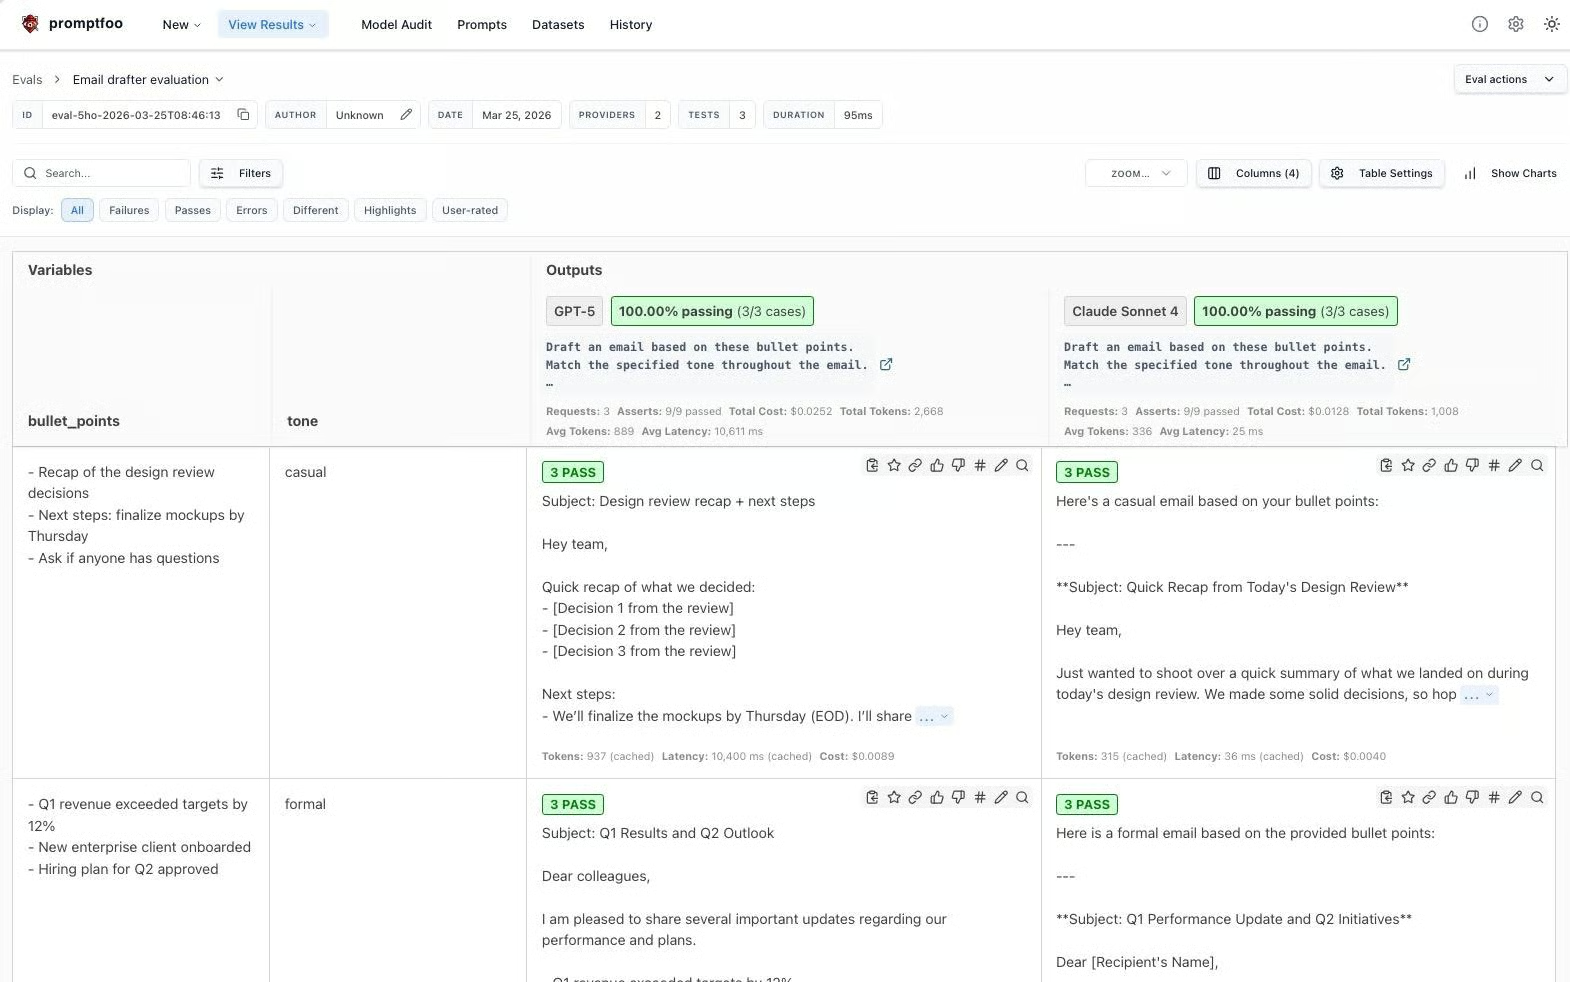
A interface web mostra os providers como colunas e os casos de teste como linhas. Cada célula exibe o status de aprovação/reprovação de cada assertion, e você pode clicar para ver o output completo e os detalhes da avaliação.
Por padrão, o Promptfoo faz cache das respostas de API em disco (TTL de 14 dias), então reexecutar o mesmo eval não custa nada. Use --no-cache quando quiser respostas novas.
No primeiro eval usamos icontains e llm-rubric. Esses são dois entre muitos tipos de assertions compatíveis com o Promptfoo. Nesta seção, vamos passar pelas principais categorias e continuar adicionando assertions ao config do redator de e-mails.
Elas rodam localmente, não custam nada e retornam resultados instantaneamente.
|
Tipo |
O que verifica |
|
|
Se o output inclui um substring (com ou sem diferenciar maiúsculas) |
|
|
Se o output casa um padrão (capture |
|
|
Se o output exclui algo (artefatos de template, recusas, texto de placeholder) |
|
|
Se a resposta chegou em menos de N milissegundos |
|
|
Se a resposta custou menos de US$ X |
Você já usou o icontains e latency. Vamos adicionar not-contains ao caso casual. Se o modelo tender ao formal, pode começar com "Dear" em vez de algo casual como "Hey". Para pegar isso, basta uma linha:
- type: not-contains
  value: \"Dear\"
Adicione isso à lista assert do teste casual e rode de novo. Ambos os modelos devem passar: o GPT-5 costuma abrir com "Hey team," e o Claude Sonnet 4 também. Se algum tivesse começado com "Dear Colleagues", essa assertion sinalizaria na hora.
Todo tipo de assertion também aceita o prefixo not-: not-regex, not-equals etc.
Elas consomem tokens, mas conseguem julgar o que matching de string não consegue. Você já usou llm-rubric no primeiro eval. A rubrica que você escreve é decisiva.
Uma rubrica vaga como "O e-mail soa profissional" não ajuda o avaliador. Uma específica dá o que medir:
- type: llm-rubric
  value: \"The email uses a casual tone: contractions like 'we'll' and 'don't',
    sentences under 20 words, no corporate jargon like 'synergy' or 'circle back',
    and opens with a greeting like 'Hey' or 'Hi team'\"
Quando você reexecuta o eval com essa rubrica, a saída do avaliador também fica específica:
Quanto mais específica a rubrica, mais consistente e útil fica a avaliação.
O Promptfoo também traz answer-relevance (o output respondeu à pergunta?) e similar (similaridade de cosseno contra uma referência via embeddings), ambos úteis para RAG e aplicações de busca.
Quando os tipos nativos não cobrem sua lógica, escreva a sua. No redator de e-mails, você pode querer verificar se o output fica dentro de um tamanho razoável. Aqui vai uma assertion inline que aprova se o e-mail tem entre 50 e 200 palavras:
- type: python
  value: \"50 <= len(output.split()) <= 200\"
Adicione isso ao caso casual e rode. No meu teste, ambos os modelos passaram: o GPT-5 ficou em 54 palavras e o Claude Sonnet 4 em 187. Mas guarde essa assertion para a próxima seção, porque ela não passou em todos os lugares.
Para checagens mais complexas, coloque a lógica em um arquivo separado:
# assert_length.py
def get_assert(output, context):
    word_count = len(output.split())
    in_range = 50 <= word_count <= 200
    return {
        \"pass\": in_range,
        \"score\": 1.0 if in_range else 0.0,
        \"reason\": f\"Word count: {word_count} (target: 50-200)\"
    }
Referencie no seu config com type: python e value: file://assert_length.py. O campo reason aparece na UI de resultados para você ver exatamente por que um teste passou ou falhou.
Veja como é uma falha real.
Adicione a assertion em Python de contagem de palavras aos três casos e rode o eval completo nos dois modelos. No meu caso, cinco das seis combinações passaram. O Claude Sonnet 4.6 não passou no caso de urgência (isso pode ou não acontecer aí, dado o comportamento não determinístico dos LLMs).
Nessa execução, o output ficou com 207 palavras, sete acima do limite. O llm-rubric passou, confirmando que o e-mail usou "linguagem urgente e direta" com "ações claras". O icontains também passou, já que "Friday" estava no output.
Mas a assertion em Python de contagem de palavras falhou. O Claude colocou um preâmbulo ("Here is a draft email based on your bullet points with an urgent tone:") antes do e-mail em si, empurrando a contagem acima de 200.
Esse é o tipo de coisa que você não pegaria só batendo o olho. O e-mail em si parecia ótimo: tom certo, conteúdo certo. Mas o output ficou longo demais porque o modelo adicionou um texto que não fazia parte do e-mail. Uma assertion pegou isso e o eval sinalizou o caso inteiro.
A correção pode seguir dois caminhos: ajustar o prompt para pedir que o modelo não inclua preâmbulo, ou aumentar o limite de palavras. De qualquer forma, você reexecuta o eval e confere se passou.
Neste ponto, o caso casual tem quatro assertions: icontains, not-contains, llm-rubric e a de contagem de palavras em Python. Nem todas têm o mesmo peso. O campo weight permite expressar isso:
assert:
  - type: icontains
    value: \"mockups\"
    weight: 1
  - type: not-contains
    value: \"Dear\"
    weight: 1
  - type: llm-rubric
    value: \"The email uses a casual tone with contractions and short sentences\"
    weight: 2
  - type: python
    value: \"50 <= len(output.split()) <= 200\"
    weight: 0.5
threshold: 0.7
A pontuação de cada assertion é multiplicada pelo seu peso, e o teste calcula uma média ponderada. O threshold define a nota mínima para passar. Aqui, a rubrica de tom vale o dobro dos checks por palavra-chave, e a contagem de palavras vale metade.
Reexecutando o teste casual com esses pesos, os dois modelos fazem 1,0 e passam. Mas se o llm-rubric falhasse (peso 2) enquanto a contagem de palavras passasse (peso 0,5), a pontuação ponderada cairia abaixo de 0,7, e o teste falharia. Os pesos permitem dizer ao Promptfoo o que mais importa para você.
O config já tem dois providers, então promptfoo eval testou GPT-5 e Claude Sonnet 4 em uma única passada. Abra promptfoo view e você os verá como colunas separadas nos resultados, com cada caso de teste pontuado independentemente por modelo.
Na minha execução, o GPT-5 passou nas seis assertions dos três casos. O Claude Sonnet 4 passou em cinco e falhou na contagem de palavras do e-mail urgente.
Esse é o tipo de diferença que você não notaria testando alguns prompts manualmente, mas que aparece na hora na grade. Você está comparando notas contra as mesmas assertions nos mesmos inputs — não sua memória de qual modelo "pareceu melhor" da última vez.
Mas outputs de LLMs não são determinísticos. O mesmo prompt pode gerar resultados diferentes em execuções consecutivas, e uma passada só não diz se um modelo é confiável ou apenas deu sorte. A flag --repeat ajuda nisso:
promptfoo eval --repeat 3Isso roda cada caso de teste três vezes por provider. Se um modelo passa a assertion de tom duas vezes e falha na terceira, é um sinal de confiabilidade que passaria batido numa passada única.
Rodar evals localmente funciona no desenvolvimento, mas depende de quem alterou o prompt lembrar de rodá-los. O Promptfoo tem uma GitHub Action oficial que elimina essa dependência ao executar sua suíte de evals em todo pull request e publicar os resultados como comentário.
Para configurar, crie um workflow no seu repositório:
mkdir -p .github/workflowsDepois crie .github/workflows/prompt-eval.yml com o conteúdo a seguir:
name: 'Prompt Evaluation'
on:
  pull_request:
    paths:
      - 'prompts/**'
jobs:
  evaluate:
    runs-on: ubuntu-latest
    permissions:
      contents: read
      pull-requests: write
    steps:
      - uses: actions/checkout@v4

      - name: Set up promptfoo cache
        uses: actions/cache@v4
        with:
          path: |
            ~/.promptfoo/cache
            .promptfoo-cache
          key: ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-${{ github.sha }}
          restore-keys: |
            ${{ runner.os }}-promptfoo-${{ hashFiles('prompts/**') }}-
            ${{ runner.os }}-promptfoo-

      - name: Run promptfoo evaluation
        uses: promptfoo/promptfoo-action@v1
        with:
          openai-api-key: ${{ secrets.OPENAI_API_KEY }}
          github-token: ${{ secrets.GITHUB_TOKEN }}
          config: 'promptfooconfig.yaml'
          cache-path: '.promptfoo-cache'
Antes de funcionar, você precisa adicionar sua OPENAI_API_KEY (e opcionalmente ANTHROPIC_API_KEY) como secrets do repositório no seu GitHub, em Settings > Secrets and variables > Actions.
O filtro paths faz a action disparar apenas quando alguém altera arquivos em prompts/. O checkout é necessário porque a action usa git internamente para fazer diff dos arquivos de prompt entre branches. Ela roda a suíte inteira e publica um comentário no PR com os resultados e um link para o visualizador web.
Se quiser mais controle sobre a lógica de aprovação/reprovação, você pode analisar o JSON diretamente:
promptfoo eval -c config.yaml -o results.json
FAILURES=$(jq '.results.stats.failures' results.json)
if [ \"$FAILURES\" -gt 0 ]; then exit 1; fi
O fluxo a partir daqui:
Mudanças de prompt recebem o mesmo tratamento de testar-antes-de-fazer-merge que mudanças de código.
O redator de e-mails do início ainda tem problema de tom, mas agora existe um teste que pega isso antes dos usuários. Você começou com um YAML em branco e terminou com uma suíte de evals rodando em dois modelos no CI.
A mesma abordagem vale para qualquer recurso com LLM que você construir — chatbot, sumarizador, pipeline de classificação. Se você consegue escrever uma assertion do que é "um bom output", dá para testar automaticamente em vez de só bater o olho.
Quando quiser ir além, a documentação do Promptfoo cobre áreas que valem a pena explorar:
Red teaming: promptfoo redteam run verifica injeção de prompt e jailbreaks em dezenas de plugins de ataque
Providers personalizados em Python: Encapsule qualquer modelo interno ou endpoint fine-tunado com file://my_provider.py
Dados de teste em CSV: Escalone sua suíte com file://tests.csv quando o YAML inline ficar pesado
Se quiser melhorar os prompts que você está testando, nosso curso Prompt Engineering with the OpenAI API cobre várias técnicas importantes aplicáveis a qualquer desenvolvimento em IA.
Cursos de prompt engineering
Curso
Curso
Curso
blog
Stanislav Karzhev
9 min
blog
Abid Ali Awan
10 min
Tutorial
Matt Crabtree
6 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
12 min