

Q-Q प्लॉट्स और अन्य डायग्नॉस्टिक प्लॉट्स
यदि आप लिनीयर मॉडल डायग्नॉस्टिक प्लॉट्स से परिचित हैं, तो आप यह भी जानते होंगे कि मॉडल फिट का आकलन करने के लिए कई विकल्प मौजूद हैं। यह समझने के लिए कि Q-Q प्लॉट वास्तव में क्या दिखा रहा है, आइए कुछ अन्य डायग्नॉस्टिक्स को देखें। इससे हमें बेहतर समझ आएगी कि Q-Q प्लॉट क्या कर रहा है और कौन से अन्य प्लॉट इसे पूरक कर सकते हैं।
- फिटेड वैल्यूज़ बनाम अवशेष: यह प्लॉट भविष्यवाणी किए गए मानों (फिटेड वैल्यूज़) और अवशेषों के बीच संबंध दिखाता है, जो अवलोकित और भविष्यवाणी किए गए मानों के अंतर होते हैं।
- अवशेषों का हिस्टोग्राम: यह प्लॉट अवशेषों का वितरण दिखाता है।
- स्केल-लोकेशन प्लॉट: यह प्लॉट अवशेषों और फिटेड वैल्यूज़ के बीच संबंध दिखाता है।
- लेवरेज बनाम स्टैन्डर्डाइज़्ड अवशेष: यह प्लॉट दर्शाता है कि प्रिडिक्टर स्पेस में कोई डेटा बिंदु कितना दूर है और मॉडल उसे अच्छा या खराब फिट करता है। हम अवशेषों को मानकीकृत करते हैं ताकि लेवरेज के साथ उनके संबंध का आकलन एकसमान स्केल पर किया जा सके।
- ऑब्ज़र्वेशन नंबर बनाम कुक्स डिस्टेंस: यह प्लॉट लेवरेज और अवशेष के आकार को जोड़कर मॉडल पर सर्वाधिक समग्र प्रभाव वाले विशिष्ट डेटा बिंदुओं की पहचान करता है। x-अक्ष पर ऑब्ज़र्वेशन नंबर प्रत्येक डेटा बिंदु के लिए पहचानकर्ता का काम करता है.
- लेवरेज बनाम कुक्स डिस्टेंस: यह प्लॉट किसी बिंदु की मॉडल को प्रभावित करने की संभावित क्षमता की तुलना उसके वास्तविक समग्र प्रभाव से करता है।
मैं आपको जल्दी से दिखाऊँगा कि tidyverse तरीकों का उपयोग करके प्रत्येक प्लॉट कैसे बनाया जाए। यहाँ उद्देश्य हमारे “कार्स इन जॉर्डन” डेटासेट से हर डायग्नॉस्टिक के लिए लिनीयर मॉडल की व्याख्या करना नहीं है। बल्कि, मैं अन्य डायग्नॉस्टिक प्लॉट्स दिखाना चाहता हूँ ताकि आप उन्हें पहचान सकें, ज़रूरत हो तो कोड का उपयोग कर सकें, और इस लेख के मकसद से, Q-Q प्लॉट को अन्य डायग्नॉस्टिक प्लॉट्स के बीच बेहतर ढंग से रख सकें। इस तरह, आप बेहतर समझेंगे कि Q-Q प्लॉट क्या दिखाता है और क्या नहीं, यह कैसे सहायक है और इसमें क्या कमियाँ हैं।
fitted_values_vs_residuals <- ggplot(data = car_linear_model, aes(x = .fitted, y = .resid)) +
geom_point(color = '#203147') +
geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) +
xlab("fitted values") +
ylab("residuals") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Fitted Values vs Residuals")
histogram_of_residuals <- ggplot(data = car_linear_model, aes(x = .resid)) +
geom_histogram(color = '#01ef63') +
xlab("residuals") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Histogram of Residuals")
scale_location <- ggplot(car_linear_model, aes(.fitted, sqrt(abs(.stdresid)))) +
geom_point(color = '#203147', na.rm=TRUE) +
stat_smooth(method="loess", na.rm = TRUE, color = '#01ef63', size = 1, se = FALSE) +
xlab("Fitted Value") +
ylab(expression(sqrt("|Standardized residuals|"))) +
labs(title = "Cars in Jordan") +
labs(subtitle = "Scale-Location")
leverage_vs_standardized_residuals <- ggplot(data = car_linear_model, aes(.hat, .stdresid)) +
geom_point(aes(size = .cooksd), color = '#203147') +
stat_smooth(method="loess", na.rm=TRUE, color = '#01ef63', size = 1) +
xlab("Leverage") +
ylab("Standardized Residuals") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Residuals vs Leverage") +
scale_size_continuous("Cook's Distance", range=c(1,5)) +
theme(legend.title = element_blank()) +
theme(legend.position= "none")
observation_number_vs_cooks_distance <- ggplot(car_linear_model, aes(seq_along(.cooksd), .cooksd)) +
geom_bar(stat="identity", position="identity", color = '#01ef63', size = 1) +
xlab("Obs. Number") +
ylab("Cook's distance") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Cook's distance")
leverage_vs_cooks_distance <- ggplot(car_linear_model, aes(.hat, .cooksd))+geom_point(na.rm=TRUE) +
stat_smooth(method="loess", na.rm=TRUE, color = '#01ef63', size = 1) +
xlab("Leverage hii")+
ylab("Cook's Distance") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Cook's dist vs Leverage hii/(1-hii)") +
geom_abline(slope=seq(0,3,0.5), color = "gray", linetype = "dotdash")
library(patchwork)
fitted_values_vs_residuals + histogram_of_residuals
library(patchwork)
scale_location + leverage_vs_standardized_residuals
library(patchwork)
observation_number_vs_cooks_distance + leverage_vs_cooks_distance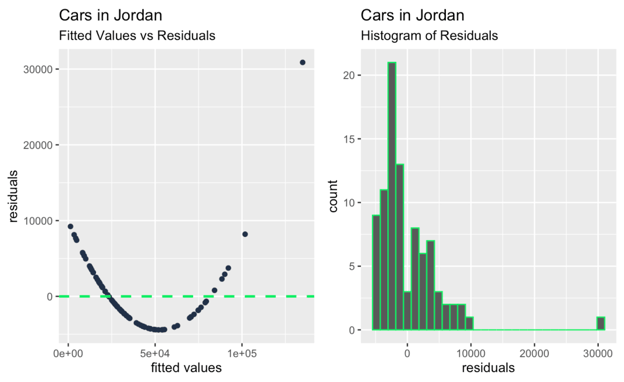
फिटेड वैल्यूज़ बनाम अवशेष; अवशेषों का हिस्टोग्राम। चित्र: लेखक द्वारा
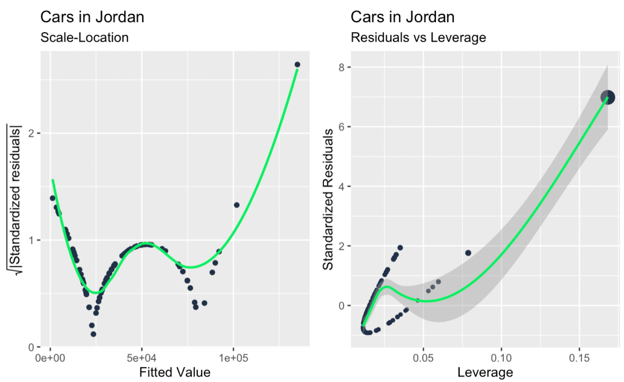
स्केल-लोकेशन प्लॉट; लेवरेज बनाम स्टैन्डर्डाइज़्ड अवशेष। चित्र: लेखक द्वारा
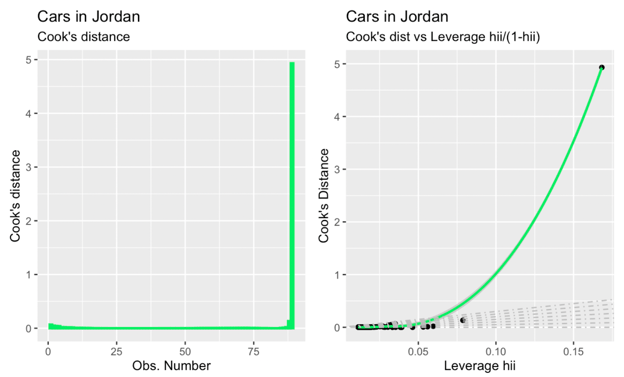
ऑब्ज़र्वेशन नंबर बनाम कुक्स डिस्टेंस; कुक्स डिस्टेंस बनाम लेवरेज। चित्र: लेखक द्वारा
शायद ऊपर दिए गए अतिरिक्त डायग्नॉस्टिक प्लॉट्स पर एक नज़र डालने से मुख्य संदेश यह है कि एक-दो बड़े आउट्लायर्स हैं जिनका रिग्रेशन रेखा की ढाल पर बड़ा प्रभाव पड़ रहा है, और ये आउट्लायर्स केवल Q-Q प्लॉट पर नज़र डालने से इतने स्पष्ट नहीं होते। तो हमारे उदाहरण में Q-Q प्लॉट अपना काम—अवशेषों की नॉर्मलिटी की जाँच—तो करता है, और साथ ही एक सीमा भी उजागर करता है, जो यह है कि यह स्वतंत्रता, होमोस्स्केडैस्टिसिटी, या आउट्लायर्स को संबोधित नहीं करता।
अतिरिक्त संदर्भ के लिए, मैं यहाँ एक उच्च-स्तरीय तालिका शामिल कर रहा हूँ जो दिखाती है कि प्रत्येक डायग्नॉस्टिक प्लॉट से किस लिनीयर मॉडल मान्यता की जाँच होती है, और मैं यह भी सुझा रहा हूँ कि अन्य डायग्नॉस्टिक प्लॉट्स Q-Q प्लॉट के साथ मिलकर कैसे काम कर सकते हैं। ध्यान रखें कि, डेटा के आधार पर, अलग-अलग प्रकार के पैटर्न अलग-अलग डायग्नॉस्टिक प्लॉट्स से उजागर हो सकते हैं, और कुछ बातें संयोजन में ही प्रकट हो सकती हैं। उदाहरण के लिए, एक Q-Q प्लॉट नॉर्मलिटी की पुष्टि कर सकता है, जबकि स्केल-लोकेशन प्लॉट हेटेरोस्स्केडैस्टिसिटी की पहचान कर सकता है, और आप केवल दोनों प्लॉट्स का उपयोग करके नॉर्मलिटी और हेटेरोस्स्केडैस्टिसिटी दोनों देख पाएँगे।
| डायग्नॉस्टिक प्लॉट प्रकार | किसमें मदद करता है | Q-Q प्लॉट के साथ कैसे काम करता है |
|---|---|---|
| Q-Q प्लॉट | अवशेषों की नॉर्मलिटी | |
| अवशेषों का हिस्टोग्राम | अवशेषों की नॉर्मलिटी | सममिति और फैलाव का त्वरित दृश्य और सामान्य धारणा देता है। |
| फिटेड वैल्यूज़ बनाम अवशेष | लिनियरिटी, त्रुटियों की स्वतंत्रता | पैटर्न और नॉन-लिनियरिटी को उजागर करता है, Q-Q प्लॉट की नॉर्मलिटी जाँच को पूरक करता है। |
| स्केल-लोकेशन प्लॉट | होमोस्स्केडैस्टिसिटी | अवशेष फैलाव की स्थिरता को हाईलाइट करता है, नॉर्मलिटी जाँच के लिए Q-Q प्लॉट का पूरक। |
| लेवरेज बनाम अवशेष प्लॉट | त्रुटियों की स्वतंत्रता | उच्च-लेवरेज बिंदुओं पर फोकस करता है, जिन्हें Q-Q प्लॉट संबोधित नहीं करता। |
| ऑब्ज़र्वेशन नंबर बनाम कुक्स डिस्टेंस | प्रभावशाली बिंदुओं की पहचान | उच्च प्रभाव वाले आउट्लायर्स का पता लगाकर Q-Q प्लॉट का पूरक। |
| लेवरेज बनाम कुक्स डिस्टेंस प्लॉट | उच्च-लेवरेज बिंदुओं की पहचान | प्रभावशाली ऑब्ज़र्वेशंस को हाईलाइट करता है, जबकि Q-Q प्लॉट नॉर्मलिटी को मान्य करता है। |
अंतिम विचार
आशा है कि आप नॉर्मलिटी का आकलन करने के उपयोगी साधन के रूप में Q-Q प्लॉट्स के लिए एक नई सराहना लेकर जा रहे हैं और लिनीयर रिग्रेशन में अवशेषों की नॉर्मलिटी का आकलन करने में इसके सामान्य उपयोग को बेहतर समझते हैं। मुझे यह भी उम्मीद है कि आप सामान्य रूप से लिनीयर मॉडल डायग्नॉस्टिक्स के विचार और महत्व के लिए नई सराहना विकसित करेंगे।
लिनीयर रिग्रेशन के बारे में सीखना जारी रखें हमारे Multiple Linear Regression in R: Tutorial With Examples के साथ, जो मल्टिपल प्रिडिक्टर्स वाले अधिक जटिल मॉडलों को कवर करता है, जिसमें रिग्रेशन में मल्टिकॉलीनियरिटी के विचार शामिल हैं। मैं दृढ़ता से सलाह देता हूँ कि हमारे पूर्ण और व्यापक करियर ट्रैक Machine Learning Scientist in Python में नामांकन करें, ताकि आप मॉडल-बिल्डिंग वर्कफ़्लो के बारे में, सुपरवाइज़्ड और अनसुपरवाइज़्ड लर्निंग सहित, सब कुछ सीख सकें।

लेखक
Josef Waples
मैं एक डेटा साइंस संपादक हूँ और वैज्ञानिक पत्रिकाओं में प्रकाशित शोध लेखों में योगदान दे चुका/चुकी हूँ। मुझे विशेष रूप से रैखिक बीजगणित, सांख्यिकी, R, और इसी तरह के विषयों में रुचि है।
Q-Q प्लॉट FAQs
Q-Q प्लॉट क्या है?
Q-Q प्लॉट, या Quantile-Quantile प्लॉट, एक दृश्य उपकरण है जिसका उपयोग किसी डेटासेट के वितरण की तुलना किसी सैद्धांतिक वितरण, जैसे नॉर्मल वितरण, से करने के लिए किया जाता है।
क्या Q-Q प्लॉट और नॉर्मल Q-Q प्लॉट एक ही हैं?
नॉर्मल Q-Q प्लॉट, Q-Q प्लॉट का एक प्रकार है जिसमें एक डेटासेट की तुलना निर्दिष्ट पैरामीटर्स वाले नॉर्मल वितरण से की जाती है। इसका उपयोग यह आकलन करने के लिए किया जाता है कि कोई डेटासेट नॉर्मल वितरण का पालन करता है या नहीं। इसलिए, सभी नॉर्मल Q-Q प्लॉट्स Q-Q प्लॉट्स होते हैं, लेकिन सभी Q-Q प्लॉट्स नॉर्मल Q-Q प्लॉट्स नहीं होते।
लिनीयर रिग्रेशन मॉडल्स का उपयोग सांख्यिकी और मशीन लर्निंग में इनपुट फीचर्स के आधार पर संख्यात्मक मानों की भविष्यवाणी करने और चर के बीच संबंध को समझने के लिए व्यापक रूप से किया जाता है। हालांकि, केवल इसलिए कि आप अपने डेटा के बीच एक रेखा फिट कर सकते हैं, इसका अर्थ यह नहीं है कि आपको करना ही चाहिए। हमें यह भी परखना होता है कि फिट की गुणवत्ता कैसी है, ताकि यह तय किया जा सके कि मॉडल डेटा के लिए उपयुक्त है या उसे परिष्कृत करने की आवश्यकता है।
मॉडल की जाँच के कई तरीके हैं, जिनमें ट्रेन/टेस्ट वर्कफ़्लो का उपयोग करके मॉडल का मूल्यांकन करना और एडजस्टेड R-स्क्वेर्ड जैसे मॉडल आँकड़ों को देखना शामिल है। इस लेख में, मैं एक विशिष्ट डायग्नॉस्टिक प्लॉट, जिसे Q-Q प्लॉट कहते हैं, को कैसे बनाते हैं और कैसे समझते हैं, उस पर ध्यान दूँगा, और R प्रोग्रामिंग भाषा में इसे बनाने के कुछ अलग तरीकों को दिखाऊँगा। रिग्रेशन तकनीकों में महारत जारी रखने के लिए, अपनी सुविधा के स्तर के अनुसार Introduction to Regression in R या Intermediate Regression in R लें, या Python के लिए Introduction to Regression in Python या Intermediate Regression in Python लें।
Q-Q प्लॉट क्या है?
Q-Q (Quantile-Quantile) प्लॉट का उपयोग यह देखने के लिए किया जाता है कि कोई डेटासेट किसी विशेष सैद्धांतिक वितरण का पालन करता है या नहीं। यह अवलोकित डेटा के क्वांटाइल्स की तुलना उस अन्य वितरण के क्वांटाइल्स से करके काम करता है। मैंने सटीकता से ‘सैद्धांतिक वितरण’ कहा, लेकिन अक्सर जब हम Q-Q प्लॉट बनाते हैं, तो हम विशेष रूप से नॉर्मल या गॉसियन वितरण के बारे में सोचते हैं, और इसे नॉर्मल Q-Q प्लॉट कहते हैं। हालांकि, Q-Q प्लॉट का उपयोग डेटा की तुलना अन्य वितरणों से करने के लिए भी किया जा सकता है, जैसे एक्सपोनेंशियल, यूनिफॉर्म, काई-स्क्वेर्ड, t-वितरण, पॉइसन वितरण, या अन्य, संदर्भ के आधार पर।
उदाहरण से समझना उपयोगी रहता है। यहाँ, मैंने 10 संख्याएँ बनाई हैं। नॉर्मल Q-Q प्लॉट बनाने के लिए, मैं पहले संख्याओं को क्रम में रखता हूँ। फिर, मैं इस समीकरण से प्रायिकता की गणना करता हूँ: q = (i– 0.5)/n। इसके बाद, मैं स्टैन्डर्ड नॉर्मल वितरण के प्रतिशत-बिंदु फ़ंक्शन (PPF) (
qnorm()फ़ंक्शन) का उपयोग करके उस रैंक के लिए सम्बंधित मान निकाल सकता हूँ। (आप शायद समष्टि वितरण फ़ंक्शन (CDF) से अधिक परिचित होंगे, जो हमें किसी मान x तक की प्रायिकता बताता है। PPF इसका उलटा जैसा होता है: यह दी गई प्रायिकता के लिए x-मूल्य देता है।)अंत में, ग्राफ बनाने के लिए, हम अपने अवलोकित मानों के क्वांटाइल्स को सैद्धांतिक क्वांटाइल्स के विरुद्ध प्लॉट करते हैं (इसीलिए Q-Q प्लॉट में दो Q होते हैं)। रेखा का निर्माण अवलोकित और सैद्धांतिक दोनों वितरणों के प्रथम और तृतीय क्वार्टाइल्स का उपयोग करके ढाल और इंटरसेप्ट की गणना करके किया जाता है।
दर्शनीय Q-Q प्लॉट। चित्र: लेखक द्वारा
Q-Q प्लॉट का उपयोग क्यों करें?
Q-Q प्लॉट वितरण-संबंधी मान्यताओं की जाँच करने का एक अच्छा दृश्य तरीका है। यह जाँचने के अन्य तरीके भी हैं कि डेटा नॉर्मल वितरण का पालन करता है या नहीं, जैसे शापिरो-विल्क परीक्षण, लेकिन मेरी राय में, Q-Q प्लॉट जितना दृश्य और कहानी को इतना स्पष्ट बनाने वाला कोई और तरीका नहीं है।
किसी चीज़ का वितरण जानना कई तरीकों से महत्वपूर्ण है। एक तो यह कि हमें केंद्र और फैलाव के सर्वोत्तम माप जानने होंगे। साथ ही, जब हम लिनीयर रिग्रेशन बनाते हैं, तो हम विशेष रूप से यह जानना चाहते हैं कि हमारा आश्रित चर नॉर्मल वितरण का अनुसरण करता है या नहीं, और हम यह भी देखना चाहते हैं कि हमारे मॉडल से निकलने वाले अवशेष (residuals) नॉर्मल रूप से वितरित हैं या नहीं, ताकि हमारे आकलनों पर भरोसा बेहतर हो। तो मूल रूप से, मुझे लगता है कि Q-Q प्लॉट दो सामान्य कारणों से उपयोगी हैं: हमारे डेटा की नमूना वितरणों से तुलना करना और नॉर्मलिटी की जाँच करना।
R में Q-Q प्लॉट कैसे बनाएँ
अब देखते हैं कि R में Q-Q प्लॉट कैसे बनाया जाए। इस खंड में, मैं तीन अलग-अलग तरीकों से गुजरूँगा: बेस R,
carपैकेज, और tidyverse तरीके। आप देखेंगे कि मुझे tidyverse तरीके अधिक पसंद हैं क्योंकि वे आपको ग्राफ को बेहतर दिखाने के लिए अधिक लचीलापन देते हैं और अन्य पैकेजों के साथ अधिक विस्तारशीलता रखते हैं।प्रत्येक तरीके के लिए, मैं एक साधारण लिनीयर रिग्रेशन के अवशेषों पर Q-Q प्लॉट बनाऊँगा, जो Q-Q प्लॉट का सबसे सामान्य—यदि सबसे अधिक सामान्य नहीं—उपयोग है। हालाँकि, आप लिनीयर रिग्रेशन बनाने से पहले ही चर के वितरण की जाँच के लिए Q-Q प्लॉट बना सकते हैं। आपको केवल एक चर का वितरण और तुलना के लिए एक सैद्धांतिक वितरण चाहिए।
यदि आप साथ चलना चाहते हैं, तो आप वह Kaggle डेटासेट डाउनलोड कर सकते हैं जिसका मैं उपयोग कर रहा हूँ: Car Prices Jordan 2023।
बेस R में Q-Q प्लॉट बनाना
पहले बेस R में Q-Q प्लॉट बनाते हैं, यानी हम कोई अतिरिक्त पैकेज इंस्टॉल नहीं करेंगे बल्कि केवल बिल्ट-इन फ़ंक्शंस का उपयोग करेंगे।
car पैकेज का उपयोग करके Q-Q प्लॉट बनाना
अब,
carपैकेज का उपयोग करके Q-Q प्लॉट बनाते हैं। मेरी राय में, विज़ुअलाइज़ेशन की गुणवत्ता बहुत अलग नहीं है, लेकिन इस Q-Q प्लॉट का लाभ यह है कि यह एक कॉन्फिडेंस एन्वेलप दिखाता है, जो उस क्षेत्र को परिभाषित करता है जिसके भीतर हमारे डेटा पॉइंट्स आने की अपेक्षा होती है यदि नॉर्मलिटी की मॉडल मान्यता सही हो।ggplot2 का उपयोग करके Q-Q प्लॉट बनाना
अब अधिक लचीलापन और बेहतर रूप के लिए tidyverse तरीकों से Q-Q प्लॉट बनाना देखते हैं। इस बार, मैं Q-Q प्लॉट को अपने मूल स्कैटरप्लॉट के बगल में एक पैनल के रूप में रखूँगा।
ggplot2 में बनाई गई लिनीयर रिग्रेशन और अवशेषों का Q-Q प्लॉट। चित्र: लेखक द्वारा
Q-Q प्लॉट हमें क्या बताता है
Q-Q प्लॉट में, अवलोकित डेटा के क्वांटाइल्स को सैद्धांतिक क्वांटाइल्स के विरुद्ध प्लॉट किया जाता है। यदि डेटा सैद्धांतिक वितरण का क़रीबी अनुसरण करता है, तो Q-Q प्लॉट के बिंदु एक तिरछी रेखा पर आएँगे। इस रेखा से विचलन अपेक्षित वितरण से दूरी को दर्शाते हैं। रेखा से ऊपर या नीचे गिरने वाले बिंदु स्क्यूनेस या आउट्लायर्स का संकेत देते हैं, और वक्र या s-आकार जैसे पैटर्न व्यवस्थित भिन्नताओं की ओर इशारा करते हैं, जैसे भारी या हल्की टेल्स।
हम आम तौर पर तीन चीज़ें देखते हैं।
आइए, प्रत्येक के लिए एक उदाहरण के साथ दिखाएँ:
तीन Q-Q प्लॉट्स: एक सीधी रेखा वाला; एक वक्र वाला; एक भारी टेल वाला। चित्र: लेखक द्वारा
पहले मामले में, Q-Q रेखा डेटा बिंदुओं से मेल खाती है, इसलिए वितरण वास्तव में नॉर्मल है। दूसरे मामले में, हम एक मुड़ा हुआ पैटर्न देखते हैं, इसलिए डेटा या तो नॉर्मल नहीं है या स्क्यूड है। आखिरी मामले में, हम एक तरह का ‘s’ आकार देखते हैं, इसलिए वितरण में भारी टेल्स या अधिक चरम मान हैं।
लिनीयर रिग्रेशन में Q-Q प्लॉट्स
कुछ अलग-अलग लिनीयर मॉडल मान्यताएँ होती हैं, जिनमें लिनियरिटी (कि चर के बीच संबंध लिनीयर है), त्रुटियों की स्वतंत्रता (कि त्रुटियाँ एक-दूसरे से सहसंबद्ध नहीं हैं), होमोस्स्केडैस्टिसिटी (कि अवशेषों का वैरिएंस स्थिर होना चाहिए), और अवशेषों की नॉर्मलिटी (कि अवशेष नॉर्मल वितरण का पालन करते हैं) शामिल हैं। Q-Q प्लॉट विशेष रूप से चौथी मान्यता—अवशेषों की नॉर्मलिटी—में मदद करता है।
यहाँ बताया गया है कि अलग-अलग पैटर्न हमारे मॉडल की व्याख्या और विश्वसनीयता को कैसे प्रभावित करते हैं:
सीधी रेखा का संरेखण
मुड़े हुए पैटर्न
भारी या हल्की टेल्स