
course
Finansiell handel i Python
4 timmar
21.6K
Statistisk arbitrage, ofta förkortat stat arb, är en familj av kvantitativa handelsstrategier som använder statistiska samband mellan värdepapper för att identifiera potentiella affärsmöjligheter. Den centrala idén är inte att förutse om en aktie stiger eller faller i isolering. Det handlar om att upptäcka relativ felprissättning: när två historiskt sammanlänkade värdepapper tillfälligt avviker från sin förväntade relation och att satsa på att de konvergerar igen.
En förtydligande punkt direkt: statistisk arbitrage är inte riskfri arbitrage. Möjligheterna är sannolikhetsbaserade, och relationerna som ligger till grund för en strategi kan helt bryta samman. Jag såg detta på nära håll när jag förvaltade positioner på asiatiska kapitalmarknader på BlueCrest, där en affär som såg statistiskt sund ut på papper kunde rämna i samma stund som det makroekonomiska läget skiftade.
Den här artikeln går igenom hur stat arb fungerar via pairs trading och medelåtergång, varför kointegration betyder mer än korrelation, och hur de verkliga riskerna ser ut i praktiken.
Statistisk arbitrage använder historisk och realtidsdata för att identifiera statistiska relationer mellan värdepapper. När dessa relationer avviker från sitt förväntade läge tar en handlare utjämnande långa och korta positioner, köper det relativt undervärderade värdepappret och blankar det relativt övervärderade, och väntar sedan på att relationen ska normaliseras.
Strukturen med long/short är det som minskar exponeringen mot breda marknadsrörelser. Om marknaden faller 5% påverkas båda benen ungefär lika, så vinsten eller förlusten kommer från den relativa rörelsen mellan de två värdepapperen, inte från marknadsriktningen.
Det generella arbetsflödet: identifiera relaterade värdepapper, modellera deras historiska relation, detektera när den aktuella spreaden avviker från historiska normer, öppna utjämnande långa och korta positioner och vänta sedan på konvergens eller på att en exit-signal utlöses.
Ett enkelt exempel: Om Pepsi plötsligt handlas med en ovanligt stor rabatt mot Coke utan någon uppenbar fundamental anledning, köper en stat arb-strategi Pepsi och blankar Coke, i förhoppning om att spreaden återgår. Vinsten kommer av att spreaden smalnar, inte av att någon av aktierna rör sig i en viss riktning.
Med det grundläggande arbetsflödet i åtanke är pairs trading det mest intuitiva sättet att se det i praktiken. Du väljer två historiskt relaterade värdepapper, konstruerar en spread mellan deras priser och handlar när den spreaden rör sig ovanligt långt från sitt historiska beteende: köper det billiga, blankar det dyra och stänger om spreaden konvergerar.
Värt att betona: korrelation i sig etablerar inte en stabil, handlingsbar relation. Två aktier kan vara starkt korrelerade och ändå glida isär permanent. Det är precis vad nästa avsnitt handlar om.
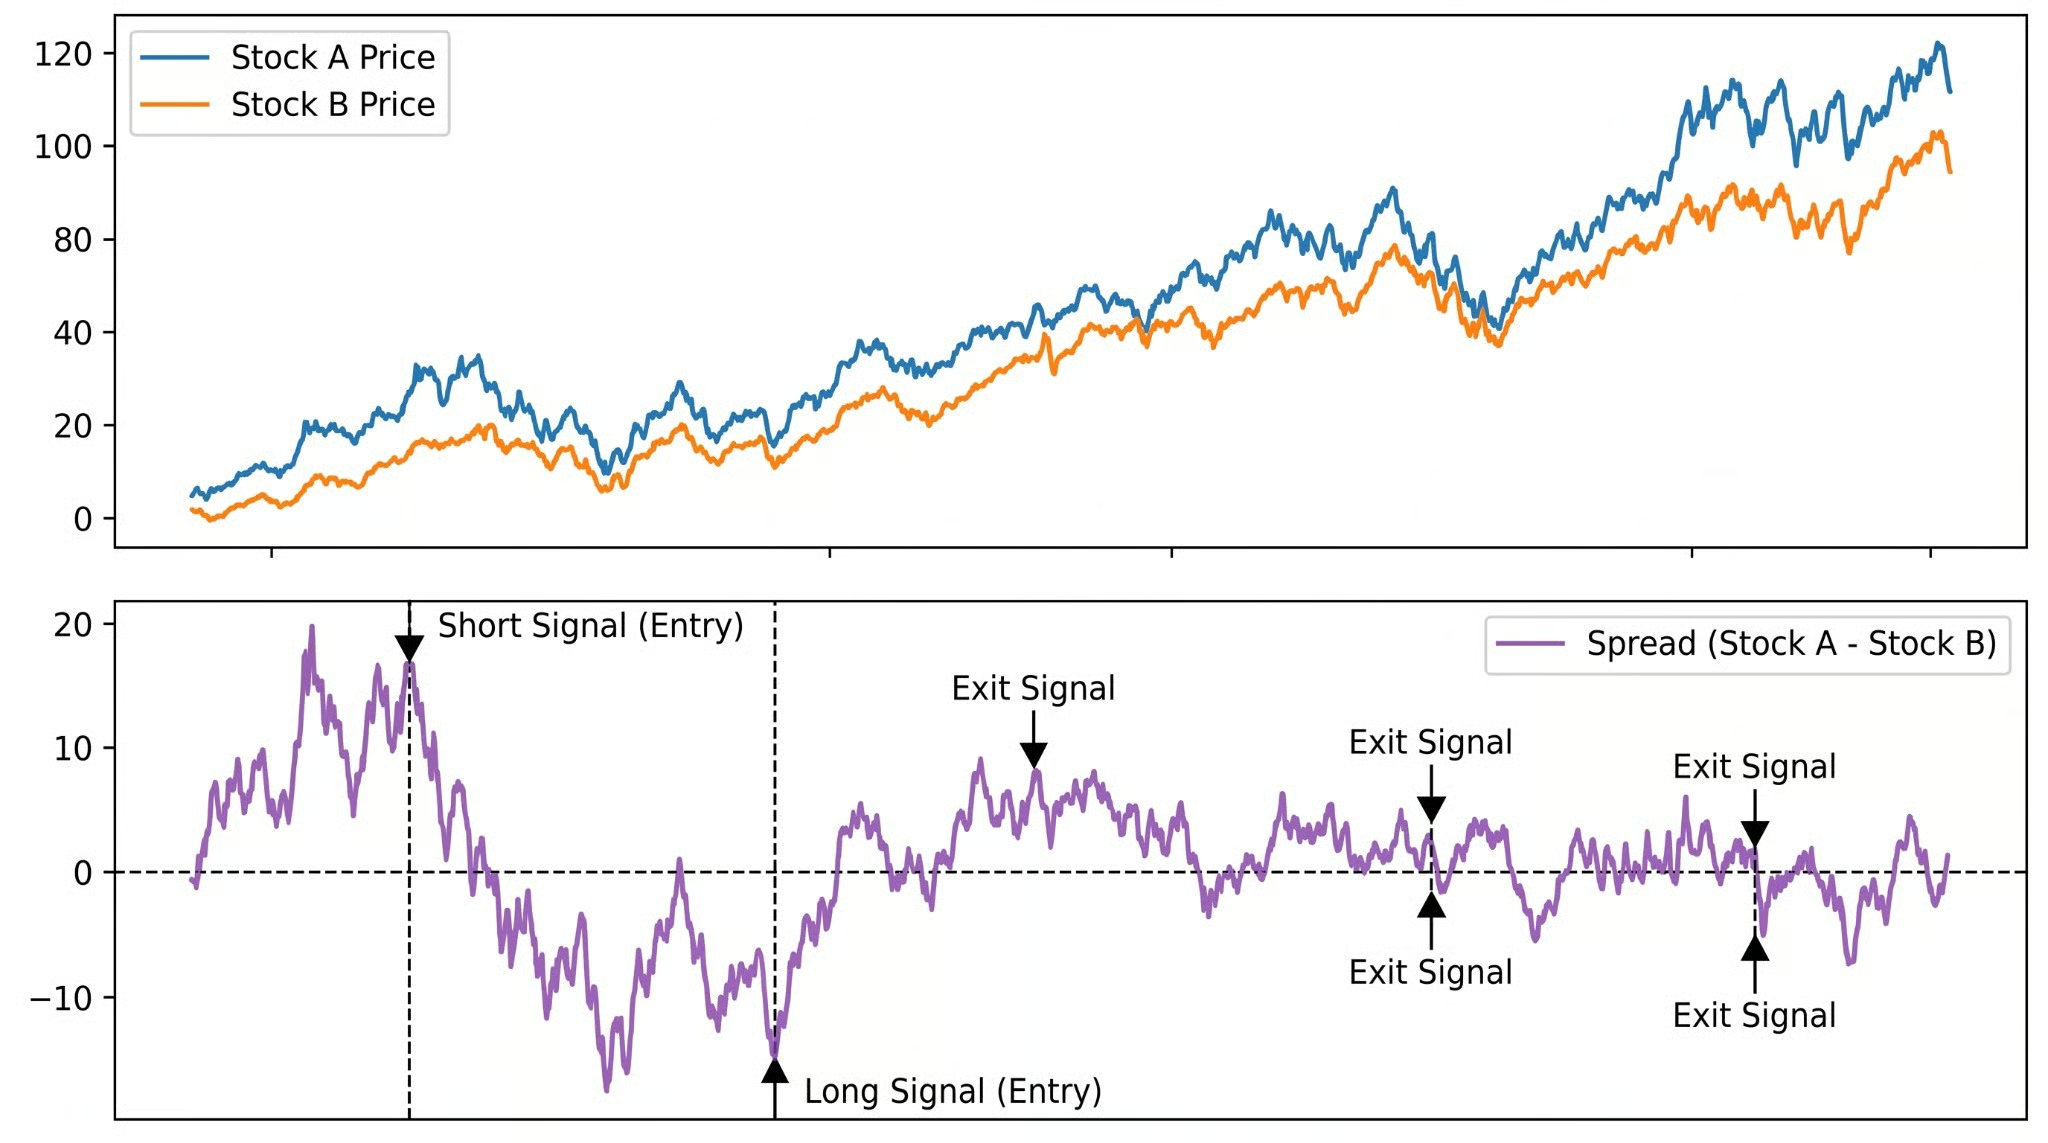
Aktie A och Aktie B-priser (överst) och deras spread (nederst), med in- och utgångssignaler markerade vid viktiga återgångspunkter. Bild av författaren.
Pairs trading fungerar, när det fungerar, tack vare medelåtergång: tendensen för en spread som vandrar bort från sitt historiska medel att så småningom återvända. Nyckelmåttet är z-poängen: (aktuell spread − rörligt medel) / standardavvikelse. En z-poäng på +2 visar att spreaden ligger två standardavvikelser över sitt historiska normalläge, en ovanlig avläsning som vissa strategier tolkar som en kortsignal.
Z-poängen är användbar eftersom den standardiserar signalen. I stället för att fråga ”Är den här spreaden bred?” frågar du ”Är den här spreaden ovanligt bred relativt hur den brukar bete sig?” Det är den fråga en medelåtergångsstrategi faktiskt försöker besvara.
Medelåtergång ger oss handelslogiken, men väcker en obekväm fråga: hur vet du att en spread faktiskt kommer att återgå snarare än att glida isär permanent? Det är här korrelation och kointegration går skilda vägar. Detta förtjänar uppmärksamhet:
Korrelation mäter styrkan i det linjära sambandet mellan två variabler. Två aktier kan ha en korrelation på 0,9 och ändå vara en dålig pairs trade, eftersom korrelation inte säger något om huruvida spreaden mellan dem är stabil eller medelåtergående.
Kointegration beskriver en mer långsiktig jämviktsrelation mellan icke-stationära tidsserier. Två prisserier är kointegrerade om någon linjär kombination av dem är stationär, fluktuerar kring ett stabilt medel i stället för att driva i väg. Det är den egenskap du faktiskt behöver.
Båda aktierna kan trenda uppåt tillsammans i åratal för att sedan divergera permanent. Hög korrelation, ingen kointegration, ingen tillförlitlig affär. Att testa för kointegration med Engle–Granger-testet eller Johansen-proceduren ger en mer försvarbar grund för att anta att spreaden återgår. Notera att PCA är en annan historia här, och inget jag går in på i den här artikeln.
Att förstå teorin är en sak; att översätta den till en fungerande strategi är en annan. Att gå från intuition till ett realistiskt kvantitativt arbetsflöde innebär fem steg, och att hoppa över något av dem tenderar att ge strategier som ser bra ut på papper men faller isär i praktiken.
Enkel pairs trading är startpunkten, inte taket. När du behärskar kärnmekaniken brukar angreppssättet expandera i två riktningar.
Multi-tillgångsmetoder modellerar relationer mellan korgar av värdepapper i stället för enskilda par. Faktorbaserade metoder rensar bort systematiska avkastningar med hjälp av vanliga marknads- eller sektorfaktorer och handlar sedan på den residuala felprissättningen. PCA skalar detta över hundratals tillgångar: identifiera de huvudsakliga källorna till gemensam variation och handla avkastningen som dessa komponenter inte förklarar.
Underliggande är vadet detsamma (residuala felprissättningar återgår), men den statistiska ramen för att hitta dem är annorlunda. Du testar inte längre om två serier är kointegrerade. Du dekomponerar ett helt tvärsnitt av avkastningar och satsar på att det som blir över som brus är tillfälligt.
ML har blivit en del av verktygslådan för att upptäcka relationer, generera signaler och identifiera regimskiften. Det förbättrar inte automatiskt avkastningen och introducerar sin egen modellrisk. Strategierna bygger fortfarande på medelåtergång. ML är ett mer komplext sätt att leta efter samma signal.
Mer sofistikerade strategier eliminerar inte de underliggande riskerna. De gör dem ofta bara svårare att se förrän det är för sent. Detta är felmoderna som är värda att förstå innan du kör någon stat arb-strategi.
Den historiska relation du byggde din strategi på är en beskrivning av det förflutna. Bransch-konsolidering, regleringsförändringar, ett skifte i ett företags affärsmodell: allt detta kan permanent förändra relationen. När det händer återgår inte spreaden. Den fortsätter att gå emot dig.
Varje stat arb-strategi vilar på statistiska antaganden. Om spreaden inte faktiskt är stationär, om hedge-kvoten är felaktigt skattad, om återblicksfönstret är dåligt valt, genererar modellen missvisande signaler. Och även när modellen har rätt urholkar transaktionskostnader avkastningen på sätt som sällan syns i naiva backtester.
En strategi som ser lönsam ut före kostnader kan bli olönsam efter dem. Jag har sett detta även inom räntor. Den teoretiska affären är ren, den faktiska är det inte.
Blankning är inte gratis. Värdepappersutlåningsavgifter och risken att bli inlöst av en mäklare innebär verkliga kostnader. Slippage mellan modellerade och faktiska avslutspriser ackumuleras över hundratals affärer. Och när många fonder kör liknande strategier exponeras de för varandras beteende.
Quant-raset i augusti 2007 inträffade just för att alltför många aktiestat arb-fonder likviderade samtidigt, och den resulterande kaskaden hade inget att göra med de underliggande relationerna som strategierna byggde på.
Stat arb-modeller kalibreras för en viss marknadsmiljö (en volatilitetregim, en räntecykel, en korrelationsstruktur). När den miljön skiftar flyttar sig alla antaganden samtidigt.
Det är inte ett par som bryter samman; det är hela portföljen som beter sig illa eftersom de statistiska egenskaper den byggdes på inte längre gäller. Spreaddynamik som såg stationär ut i en lågvolatilitetsregim kan bli instabil över en natt när volatiliteten rusar, och historiska återblicksfönster kommer inte att varna dig i förväg.
Den mest lömska risken. Med tillräckligt många parametrar och historisk data kan du anpassa en strategi till nästan vilken tidigare period som helst, och den försämras kraftigt i live-handel. Testning utanför urval är minsta skydd, och inte ens det räcker alltid.
Stat arb blandas ofta ihop med flera angränsande strategier.
Traditionell arbitrage utnyttjar närmast mekaniska prisskillnader: samma tillgång handlas till olika priser på två börser. Vinsten är nästan säker om du kan exekvera tillräckligt snabbt. Statistisk arbitrage satsar på sannolik konvergens. Helt olika riskprofiler.
Pairs trading är en typ av statistisk arbitrage, inte en synonym för området. Termerna används omväxlande, men stat arb omfattar faktormodeller, PCA-baserade strategier och maskininlärningsmetoder över stora portföljer. Pairs trading är där de flesta börjar.
Algoritmisk handel är en bredare kategori som beskriver all automatiserad execution. Statistisk arbitrage är en specifik familj inom den. Högfrekvent market making och trendföljning är också algoritmiska, men inget av dem är stat arb.
Statistisk arbitrage är i grunden ett vad om att relationer består. Du hittar två värdepapper som historiskt rört sig tillsammans, väntar på att de divergerar och positionerar dig för att gapet ska stängas. Matematiken formaliserar den intuitionen, men intuitionen är det som håller dig ärlig när matematiken säger att du ska hålla och marknaden säger att du ska springa.
Det som gör stat arb genuint svårt är inte statistiken. Det är att relationerna du handlar konkurrerar med alla andra som hittat samma relationer. När de fungerar lockar de kapital. När de lockar för mycket kapital slutar de fungera, ibland gradvis och ibland på en gång, som 2007 visade.
För de statistiska grunderna, stationaritetstestning och tidsseriemodellering är kursen Time Series Analysis in Python rätt nästa steg. För backtesting och kvantitativa arbetsflöden täcker Financial Trading in Python-kursen hur man implementerar och utvärderar handelsstrategier i praktiken.
Lär dig med DataCamp
course
course
course