L’arbitrage statistique, souvent abrégé en stat arb, regroupe des stratégies de trading quantitatives qui exploitent des relations statistiques entre titres pour déceler des opportunités. L’idée centrale n’est pas de prédire isolément la hausse ou la baisse d’une action, mais d’identifier une mauvaise valorisation relative : quand deux titres historiquement liés s’écartent temporairement de leur relation attendue, et parier sur leur reconvergence.
Précision importante : l’arbitrage statistique n’est pas un arbitrage sans risque. Les opportunités sont probabilistes et les relations à la base d’une stratégie peuvent s’effondrer. Je l’ai vu de près en gérant des positions sur les marchés de capitaux asiatiques chez BlueCrest : une opération éprouvée sur le papier pouvait se défaire dès que le régime macro évoluait.
Cet article explique le fonctionnement du stat arb via le pairs trading et le retour à la moyenne, pourquoi la cointégration compte davantage que la corrélation, et à quoi ressemblent vraiment les risques sur le terrain.
Qu’est-ce que l’arbitrage statistique ?
L’arbitrage statistique utilise des données historiques et en temps réel pour identifier des relations statistiques entre titres. Quand ces relations dévient de leur état attendu, un trader prend des positions longues et courtes opposées : il achète le titre relativement sous-évalué et vend à découvert le titre relativement surévalué, puis attend que la relation se normalise.
La structure long/short réduit l’exposition aux mouvements généraux du marché. Si le marché baisse de 5 %, les deux jambes sont affectées à peu près également ; le résultat provient donc du mouvement relatif entre les deux titres, non du sens du marché.
Le flux opérationnel général : identifier des titres liés, modéliser leur relation historique, détecter quand l’écart courant dévie des normes historiques, ouvrir des positions longues et courtes opposées, puis attendre la convergence ou un signal de sortie.
Exemple simple : si Pepsi se met soudain à coter avec une décote inhabituellement forte par rapport à Coke sans raison fondamentale évidente, une stratégie de stat arb achète Pepsi et vend Coke à découvert, en anticipant un retour de l’écart à la normale. Le profit vient du resserrement de cet écart, pas du mouvement directionnel de l’une ou l’autre action.
Pairs trading : un exemple simple d’arbitrage statistique
Avec ce schéma en tête, le pairs trading est la façon la plus intuitive de voir le concept à l’œuvre. Vous sélectionnez deux titres liés historiquement, construisez un écart entre leurs prix et intervenez quand cet écart s’éloigne anormalement de son comportement historique : achat du moins cher, vente à découvert du plus cher, fermeture si l’écart converge.
Point crucial : la corrélation seule n’établit pas une relation stable et exploitable. Deux actions peuvent être très corrélées et pourtant diverger définitivement. C’est justement l’objet de la section suivante.
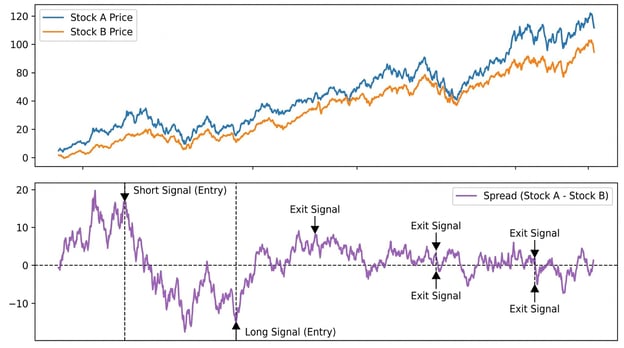
Prix des actions A et B (haut) et leur écart (bas), avec des signaux d’entrée et de sortie marqués aux points clés de retour à la moyenne. Image réalisée par l’auteur.
Retour à la moyenne et arbitrage statistique
Le pairs trading fonctionne, quand il fonctionne, grâce au retour à la moyenne : la tendance d’un écart à revenir vers sa moyenne historique après s’en être éloigné. La mesure clé est le z-score : (spread actuel − moyenne mobile) / écart-type. Un z-score de +2 indique un écart deux écarts-types au-dessus de sa norme historique, une lecture inhabituelle que certaines stratégies traitent comme un signal de vente.
Le z-score est utile car il standardise le signal. Plutôt que de demander « Cet écart est-il large ? », vous demandez : « Cet écart est-il inhabituellement large par rapport à son comportement habituel ? » C’est exactement la question qu’une stratégie de retour à la moyenne cherche à répondre.
Cointégration vs corrélation en arbitrage statistique
Le retour à la moyenne fournit la logique de trading, mais soulève une question délicate : comment savoir si un écart reviendra vraiment à la moyenne plutôt que de dériver définitivement ? C’est là que la corrélation et la cointégration divergent. Cela mérite votre attention :
Corrélation
La corrélation mesure l’intensité de la relation linéaire entre deux variables. Deux actions peuvent avoir une corrélation de 0,9 et constituer un mauvais pair trade, car la corrélation ne dit rien de la stabilité ni du caractère retour à la moyenne de l’écart entre elles.
Cointégration
La cointégration décrit une relation d’équilibre à plus long terme entre des séries temporelles non stationnaires. Deux séries de prix sont cointégrées si une combinaison linéaire d’entre elles est stationnaire, fluctuant autour d’une moyenne stable plutôt que de dériver. C’est la propriété dont vous avez réellement besoin.
Deux actions peuvent tendre ensemble à la hausse pendant des années, puis diverger durablement. Corrélation élevée, pas de cointégration, pas de trade fiable. Tester la cointégration via le test d’Engle-Granger ou la procédure de Johansen offre une base plus solide pour supposer un retour de l’écart. Notez que la ACP relève d’une autre logique, que je ne développerai pas ici.
Comprendre la théorie est une chose ; la traduire en stratégie opérationnelle en est une autre. Passer de l’intuition à un flux quantitatif réaliste implique cinq étapes ; en ignorer une seule aboutit souvent à des stratégies brillantes sur le papier mais décevantes en pratique.
- Démarrer par une logique économique : secteurs communs, fournisseurs partagés, moteurs de revenus similaires. Un filtrage basé uniquement sur des corrélations historiques sans rationalité fondamentale génère des relations fallacieuses.
- Tester la relation avec un test de Dickey-Fuller augmenté sur l’écart lui-même. S’il est non stationnaire, il dérive et ne revient pas à la moyenne.
- Construire l’écart avec un ratio de couverture, pas une hypothèse 1 pour 1. Estimé par régression, le ratio de couverture détermine combien d’unités d’un titre détenir par unité de l’autre. Mal l’évaluer et le couple n’est plus neutre au marché.
- Définir des règles d’entrée et de sortie autour de seuils de z-score. Entrer à ±2,0, sortir lorsque l’écart revient vers z 0, couper à ±3,0. Un écart qui dépasse durablement ±3 signale généralement une relation qui se défait, pas un meilleur point d’entrée. Une durée maximale de détention compte aussi : si l’écart n’a pas reverti dans un délai donné, mieux vaut fermer la position que d’attendre indéfiniment un retour hypothétique.
- Dimensionner pour une neutralité en dollars, backtester sur données historiques avec des coûts de transaction réalistes, et anticiper une performance en réel inférieure au backtest (plutôt que l’inverse).
Le pairs trading est un point d’entrée, pas un plafond. Une fois à l’aise avec les mécaniques de base, l’approche s’élargit généralement dans deux directions.
Arbitrage statistique multi-actifs et modèles de facteurs
Les approches multi-actifs modélisent les relations entre des paniers de titres plutôt qu’entre des paires isolées. Les approches par facteurs extraient les rendements systématiques à l’aide de facteurs de marché ou sectoriels, puis exploitent les mauvaises valorisations résiduelles. L’ACP décline cela sur des centaines d’actifs : identifier les principales sources de variation commune, puis trader les rendements non expliqués par ces composantes.
Le pari sous-jacent reste le même (les mauvaises valorisations résiduelles se corrigent), mais le cadre statistique pour les trouver change. Vous ne testez plus la cointégration de deux séries ; vous décomposez une section transversale de rendements et misez sur le caractère temporaire du bruit résiduel.
Approches de machine learning
Le ML s’est invité pour découvrir des relations, générer des signaux et détecter des régimes. Il n’améliore pas automatiquement les performances et introduit son propre risque de modèle. Les stratégies reposent toujours sur le retour à la moyenne ; le ML n’est qu’une façon plus sophistiquée de chercher le même signal.
Risques et limites de l’arbitrage statistique
Des stratégies plus avancées n’éliminent pas les risques sous-jacents ; elles les rendent souvent simplement plus difficiles à déceler avant qu’il ne soit trop tard. Voici les modes d’échec qu’il faut comprendre avant de déployer une stratégie de stat arb.
Les relations peuvent se rompre
La relation historique sur laquelle vous avez bâti votre stratégie décrit le passé. Consolidation sectorielle, changements réglementaires, évolution du modèle d’affaires : autant de facteurs susceptibles de modifier durablement la relation. Dans ce cas, l’écart ne revient pas ; il continue de se creuser contre vous.
Risque de modèle et coûts de transaction
Toute stratégie de stat arb repose sur des hypothèses statistiques. Si l’écart n’est pas vraiment stationnaire, si le ratio de couverture est mal estimé, si la fenêtre historique est mal choisie, le modèle produit des signaux trompeurs. Et même quand le modèle a raison, les coûts de transaction grignotent les rendements d’une façon qui apparaît rarement dans des backtests naïs.
Une stratégie apparemment rentable avant coûts peut devenir déficitaire après coûts. Je l’ai aussi observé sur le marché obligataire : le trade théorique est limpide, le trade réel l’est beaucoup moins.
Frottements d’exécution et engorgement des positions
La vente à découvert n’est pas gratuite. Les frais d’emprunt de titres et le risque de rachat forcé par un courtier coûtent réellement. Le glissement entre les prix modélisés et les exécutions effectives s’accumule sur des centaines d’opérations. Et quand de nombreux fonds déploient des stratégies similaires, ils deviennent interdépendants.
La panique de l’été 2007 sur les fonds quantitatifs est survenue précisément parce que trop de fonds equity stat arb ont liquidé simultanément, déclenchant une cascade sans rapport avec les relations fondamentales sur lesquelles ces stratégies reposaient.
Changements de régime
Les modèles de stat arb sont calibrés pour un environnement de marché donné (régime de volatilité, cycle de taux, structure de corrélation). Quand cet environnement bascule, toutes les hypothèses bougent en même temps.
Ce n’est pas une seule paire qui se détraque ; c’est tout le portefeuille qui dévie, parce que les propriétés statistiques fondatrices ne tiennent plus. Des dynamiques d’écart apparemment stationnaires en régime de faible volatilité peuvent devenir instables du jour au lendemain quand la volatilité explose, et les fenêtres historiques n’en avertissent pas à l’avance.
Surajustement des backtests
Le risque le plus insidieux. Avec assez de paramètres et d’historique, on peut ajuster une stratégie à presque n’importe quelle période passée ; elle se dégrade ensuite nettement en conditions réelles. Des tests hors échantillon sont un minimum, et même cela ne suffit pas toujours.
Arbitrage statistique vs stratégies de trading apparentées
Le stat arb est souvent confondu avec des stratégies voisines.
Arbitrage statistique vs arbitrage traditionnel
L’arbitrage traditionnel exploite des écarts de prix quasi mécaniques : le même actif traité à des prix différents sur deux places. Le gain est presque certain si l’exécution est assez rapide. L’arbitrage statistique parie sur une convergence probabiliste. Les profils de risque n’ont rien à voir.
Arbitrage statistique vs pairs trading
Le pairs trading est une forme particulière d’arbitrage statistique, pas un synonyme. Les termes se mêlent souvent, mais le stat arb englobe les modèles multifactoriels, les stratégies basées sur l’ACP et des approches de machine learning à l’échelle de grands portefeuilles. Le pairs trading est là où la plupart commencent.
Arbitrage statistique vs trading algorithmique
Le trading algorithmique désigne plus largement toute stratégie d’exécution automatisée. L’arbitrage statistique est une famille spécifique en son sein. Le market making haute fréquence et le suivi de tendance sont aussi algorithmiques, mais ne relèvent pas du stat arb.
Conclusion
Au fond, l’arbitrage statistique est un pari sur la persistance des relations. Vous repérez deux titres qui ont historiquement évolué de concert, attendez leur divergence et vous positionnez pour la fermeture de l’écart. Les maths formalisent cette intuition, mais c’est l’intuition qui vous garde lucide quand les maths disent de tenir et que le marché dit de fuir.
Ce qui rend le stat arb vraiment ardu, ce ne sont pas les statistiques. C’est que les relations que vous tradez sont convoitées par tous ceux qui les ont également trouvées. Quand elles fonctionnent, elles attirent du capital. Quand elles en attirent trop, elles cessent de fonctionner, parfois progressivement, parfois d’un coup, comme 2007 l’a montré.
Pour les fondements statistiques, les tests de stationnarité et la modélisation de séries temporelles, le cours Time Series Analysis in Python est la prochaine étape idéale. Pour le backtesting et les workflows quantitatifs, le cours Financial Trading in Python montre comment implémenter et évaluer concrètement des stratégies de trading.







L’arbitrage statistique, souvent abrégé en stat arb, regroupe des stratégies de trading quantitatives qui exploitent des relations statistiques entre titres pour déceler des opportunités. L’idée centrale n’est pas de prédire isolément la hausse ou la baisse d’une action, mais d’identifier une mauvaise valorisation relative : quand deux titres historiquement liés s’écartent temporairement de leur relation attendue, et parier sur leur reconvergence.
Précision importante : l’arbitrage statistique n’est pas un arbitrage sans risque. Les opportunités sont probabilistes et les relations à la base d’une stratégie peuvent s’effondrer. Je l’ai vu de près en gérant des positions sur les marchés de capitaux asiatiques chez BlueCrest : une opération éprouvée sur le papier pouvait se défaire dès que le régime macro évoluait.
Cet article explique le fonctionnement du stat arb via le pairs trading et le retour à la moyenne, pourquoi la cointégration compte davantage que la corrélation, et à quoi ressemblent vraiment les risques sur le terrain.
Qu’est-ce que l’arbitrage statistique ?
L’arbitrage statistique utilise des données historiques et en temps réel pour identifier des relations statistiques entre titres. Quand ces relations dévient de leur état attendu, un trader prend des positions longues et courtes opposées : il achète le titre relativement sous-évalué et vend à découvert le titre relativement surévalué, puis attend que la relation se normalise.
La structure long/short réduit l’exposition aux mouvements généraux du marché. Si le marché baisse de 5 %, les deux jambes sont affectées à peu près également ; le résultat provient donc du mouvement relatif entre les deux titres, non du sens du marché.
Comment fonctionne l’arbitrage statistique
Le flux opérationnel général : identifier des titres liés, modéliser leur relation historique, détecter quand l’écart courant dévie des normes historiques, ouvrir des positions longues et courtes opposées, puis attendre la convergence ou un signal de sortie.
Exemple simple : si Pepsi se met soudain à coter avec une décote inhabituellement forte par rapport à Coke sans raison fondamentale évidente, une stratégie de stat arb achète Pepsi et vend Coke à découvert, en anticipant un retour de l’écart à la normale. Le profit vient du resserrement de cet écart, pas du mouvement directionnel de l’une ou l’autre action.
Pairs trading : un exemple simple d’arbitrage statistique
Avec ce schéma en tête, le pairs trading est la façon la plus intuitive de voir le concept à l’œuvre. Vous sélectionnez deux titres liés historiquement, construisez un écart entre leurs prix et intervenez quand cet écart s’éloigne anormalement de son comportement historique : achat du moins cher, vente à découvert du plus cher, fermeture si l’écart converge.
Point crucial : la corrélation seule n’établit pas une relation stable et exploitable. Deux actions peuvent être très corrélées et pourtant diverger définitivement. C’est justement l’objet de la section suivante.
Prix des actions A et B (haut) et leur écart (bas), avec des signaux d’entrée et de sortie marqués aux points clés de retour à la moyenne. Image réalisée par l’auteur.
Retour à la moyenne et arbitrage statistique
Le pairs trading fonctionne, quand il fonctionne, grâce au retour à la moyenne : la tendance d’un écart à revenir vers sa moyenne historique après s’en être éloigné. La mesure clé est le z-score : (spread actuel − moyenne mobile) / écart-type. Un z-score de +2 indique un écart deux écarts-types au-dessus de sa norme historique, une lecture inhabituelle que certaines stratégies traitent comme un signal de vente.
Le z-score est utile car il standardise le signal. Plutôt que de demander « Cet écart est-il large ? », vous demandez : « Cet écart est-il inhabituellement large par rapport à son comportement habituel ? » C’est exactement la question qu’une stratégie de retour à la moyenne cherche à répondre.
Cointégration vs corrélation en arbitrage statistique
Le retour à la moyenne fournit la logique de trading, mais soulève une question délicate : comment savoir si un écart reviendra vraiment à la moyenne plutôt que de dériver définitivement ? C’est là que la corrélation et la cointégration divergent. Cela mérite votre attention :
Corrélation
La corrélation mesure l’intensité de la relation linéaire entre deux variables. Deux actions peuvent avoir une corrélation de 0,9 et constituer un mauvais pair trade, car la corrélation ne dit rien de la stabilité ni du caractère retour à la moyenne de l’écart entre elles.
Cointégration
La cointégration décrit une relation d’équilibre à plus long terme entre des séries temporelles non stationnaires. Deux séries de prix sont cointégrées si une combinaison linéaire d’entre elles est stationnaire, fluctuant autour d’une moyenne stable plutôt que de dériver. C’est la propriété dont vous avez réellement besoin.
Deux actions peuvent tendre ensemble à la hausse pendant des années, puis diverger durablement. Corrélation élevée, pas de cointégration, pas de trade fiable. Tester la cointégration via le test d’Engle-Granger ou la procédure de Johansen offre une base plus solide pour supposer un retour de l’écart. Notez que la ACP relève d’une autre logique, que je ne développerai pas ici.
Comment construire une stratégie d’arbitrage statistique
Comprendre la théorie est une chose ; la traduire en stratégie opérationnelle en est une autre. Passer de l’intuition à un flux quantitatif réaliste implique cinq étapes ; en ignorer une seule aboutit souvent à des stratégies brillantes sur le papier mais décevantes en pratique.
Comment les stratégies d’arbitrage statistique gagnent en sophistication
Le pairs trading est un point d’entrée, pas un plafond. Une fois à l’aise avec les mécaniques de base, l’approche s’élargit généralement dans deux directions.
Arbitrage statistique multi-actifs et modèles de facteurs
Les approches multi-actifs modélisent les relations entre des paniers de titres plutôt qu’entre des paires isolées. Les approches par facteurs extraient les rendements systématiques à l’aide de facteurs de marché ou sectoriels, puis exploitent les mauvaises valorisations résiduelles. L’ACP décline cela sur des centaines d’actifs : identifier les principales sources de variation commune, puis trader les rendements non expliqués par ces composantes.
Le pari sous-jacent reste le même (les mauvaises valorisations résiduelles se corrigent), mais le cadre statistique pour les trouver change. Vous ne testez plus la cointégration de deux séries ; vous décomposez une section transversale de rendements et misez sur le caractère temporaire du bruit résiduel.
Approches de machine learning
Le ML s’est invité pour découvrir des relations, générer des signaux et détecter des régimes. Il n’améliore pas automatiquement les performances et introduit son propre risque de modèle. Les stratégies reposent toujours sur le retour à la moyenne ; le ML n’est qu’une façon plus sophistiquée de chercher le même signal.
Risques et limites de l’arbitrage statistique
Des stratégies plus avancées n’éliminent pas les risques sous-jacents ; elles les rendent souvent simplement plus difficiles à déceler avant qu’il ne soit trop tard. Voici les modes d’échec qu’il faut comprendre avant de déployer une stratégie de stat arb.
Les relations peuvent se rompre
La relation historique sur laquelle vous avez bâti votre stratégie décrit le passé. Consolidation sectorielle, changements réglementaires, évolution du modèle d’affaires : autant de facteurs susceptibles de modifier durablement la relation. Dans ce cas, l’écart ne revient pas ; il continue de se creuser contre vous.
Risque de modèle et coûts de transaction
Toute stratégie de stat arb repose sur des hypothèses statistiques. Si l’écart n’est pas vraiment stationnaire, si le ratio de couverture est mal estimé, si la fenêtre historique est mal choisie, le modèle produit des signaux trompeurs. Et même quand le modèle a raison, les coûts de transaction grignotent les rendements d’une façon qui apparaît rarement dans des backtests naïs.
Une stratégie apparemment rentable avant coûts peut devenir déficitaire après coûts. Je l’ai aussi observé sur le marché obligataire : le trade théorique est limpide, le trade réel l’est beaucoup moins.
Frottements d’exécution et engorgement des positions
La vente à découvert n’est pas gratuite. Les frais d’emprunt de titres et le risque de rachat forcé par un courtier coûtent réellement. Le glissement entre les prix modélisés et les exécutions effectives s’accumule sur des centaines d’opérations. Et quand de nombreux fonds déploient des stratégies similaires, ils deviennent interdépendants.
La panique de l’été 2007 sur les fonds quantitatifs est survenue précisément parce que trop de fonds equity stat arb ont liquidé simultanément, déclenchant une cascade sans rapport avec les relations fondamentales sur lesquelles ces stratégies reposaient.
Changements de régime
Les modèles de stat arb sont calibrés pour un environnement de marché donné (régime de volatilité, cycle de taux, structure de corrélation). Quand cet environnement bascule, toutes les hypothèses bougent en même temps.
Ce n’est pas une seule paire qui se détraque ; c’est tout le portefeuille qui dévie, parce que les propriétés statistiques fondatrices ne tiennent plus. Des dynamiques d’écart apparemment stationnaires en régime de faible volatilité peuvent devenir instables du jour au lendemain quand la volatilité explose, et les fenêtres historiques n’en avertissent pas à l’avance.
Surajustement des backtests
Le risque le plus insidieux. Avec assez de paramètres et d’historique, on peut ajuster une stratégie à presque n’importe quelle période passée ; elle se dégrade ensuite nettement en conditions réelles. Des tests hors échantillon sont un minimum, et même cela ne suffit pas toujours.
Arbitrage statistique vs stratégies de trading apparentées
Le stat arb est souvent confondu avec des stratégies voisines.
Arbitrage statistique vs arbitrage traditionnel
L’arbitrage traditionnel exploite des écarts de prix quasi mécaniques : le même actif traité à des prix différents sur deux places. Le gain est presque certain si l’exécution est assez rapide. L’arbitrage statistique parie sur une convergence probabiliste. Les profils de risque n’ont rien à voir.
Arbitrage statistique vs pairs trading
Le pairs trading est une forme particulière d’arbitrage statistique, pas un synonyme. Les termes se mêlent souvent, mais le stat arb englobe les modèles multifactoriels, les stratégies basées sur l’ACP et des approches de machine learning à l’échelle de grands portefeuilles. Le pairs trading est là où la plupart commencent.
Arbitrage statistique vs trading algorithmique
Le trading algorithmique désigne plus largement toute stratégie d’exécution automatisée. L’arbitrage statistique est une famille spécifique en son sein. Le market making haute fréquence et le suivi de tendance sont aussi algorithmiques, mais ne relèvent pas du stat arb.
Conclusion
Au fond, l’arbitrage statistique est un pari sur la persistance des relations. Vous repérez deux titres qui ont historiquement évolué de concert, attendez leur divergence et vous positionnez pour la fermeture de l’écart. Les maths formalisent cette intuition, mais c’est l’intuition qui vous garde lucide quand les maths disent de tenir et que le marché dit de fuir.
Ce qui rend le stat arb vraiment ardu, ce ne sont pas les statistiques. C’est que les relations que vous tradez sont convoitées par tous ceux qui les ont également trouvées. Quand elles fonctionnent, elles attirent du capital. Quand elles en attirent trop, elles cessent de fonctionner, parfois progressivement, parfois d’un coup, comme 2007 l’a montré.
Pour les fondements statistiques, les tests de stationnarité et la modélisation de séries temporelles, le cours Time Series Analysis in Python est la prochaine étape idéale. Pour le backtesting et les workflows quantitatifs, le cours Financial Trading in Python montre comment implémenter et évaluer concrètement des stratégies de trading.