Cursus
Financieel traden in Python
4 Hr
21.6K
Statistische arbitrage, vaak afgekort tot stat arb, is een familie van kwantitatieve handelsstrategieën die statistische relaties tussen effecten gebruiken om potentiële handelsmogelijkheden te vinden. Het gaat niet primair om het voorspellen of een aandeel op zichzelf stijgt of daalt. Het draait om het spotten van relatieve misprijzing: wanneer twee historisch verbonden effecten tijdelijk afwijken van hun verwachte relatie, en inzetten op hun convergentie.
Eén verduidelijking vooraf: statistische arbitrage is geen risicovrije arbitrage. De kansen zijn probabilistisch, en de relaties waarop een strategie steunt kunnen volledig uit elkaar vallen. Dat zag ik van dichtbij toen ik Aziatische kapitaalmarktposities beheerde bij BlueCrest, waar een trade die er statistisch solide uitzag op papier kon ontrafelen zodra het macroregime verschoof.
Dit artikel behandelt hoe stat arb werkt via pairs trading en mean reversion, waarom co-integratie belangrijker is dan correlatie, en hoe de echte risico’s er in de praktijk uitzien.
Statistische arbitrage gebruikt historische en realtime data om statistische relaties tussen effecten te identificeren. Wanneer die relaties afwijken van hun verwachte toestand, neemt een trader tegengestelde long- en shortposities in: de relatief ondergewaardeerde kopen en de relatief overgewaardeerde shorten, en vervolgens wachten tot de relatie normaliseert.
De long/short-structuur is wat de blootstelling aan brede marktbewegingen verkleint. Als de markt 5% daalt, worden beide benen grofweg evenveel geraakt, dus komt de winst of het verlies uit de relatieve beweging tussen de twee effecten, niet uit de marktrichting.
De algemene workflow: gerelateerde effecten identificeren, hun historische relatie modelleren, detecteren wanneer de huidige spread afwijkt van historische normen, tegengestelde long- en shortposities openen, en vervolgens wachten op convergentie of een exitconditie.
Een simpel voorbeeld: als Pepsi ineens met een ongewoon grote korting ten opzichte van Coke handelt zonder duidelijke fundamentele reden, koopt een stat-arb-strategie Pepsi en short Coke, in de verwachting dat de spread terugveert. De winst komt van het versmallen van die spread, niet van een specifieke richting van een van beide aandelen.
Met die basisworkflow in gedachten is pairs trading de meest intuïtieve manier om het in actie te zien. Je kiest twee historisch gerelateerde effecten, construeert een spread tussen hun prijzen en handelt wanneer die spread ongewoon ver van zijn historische gedrag afwijkt: de goedkope kopen, de dure shorten, sluiten als de spread convergeert.
Belangrijk om te benadrukken: correlatie op zichzelf bewijst geen stabiele, verhandelbare relatie. Twee aandelen kunnen sterk gecorreleerd zijn en toch permanent uit elkaar drijven. Precies dat behandelt de volgende sectie.
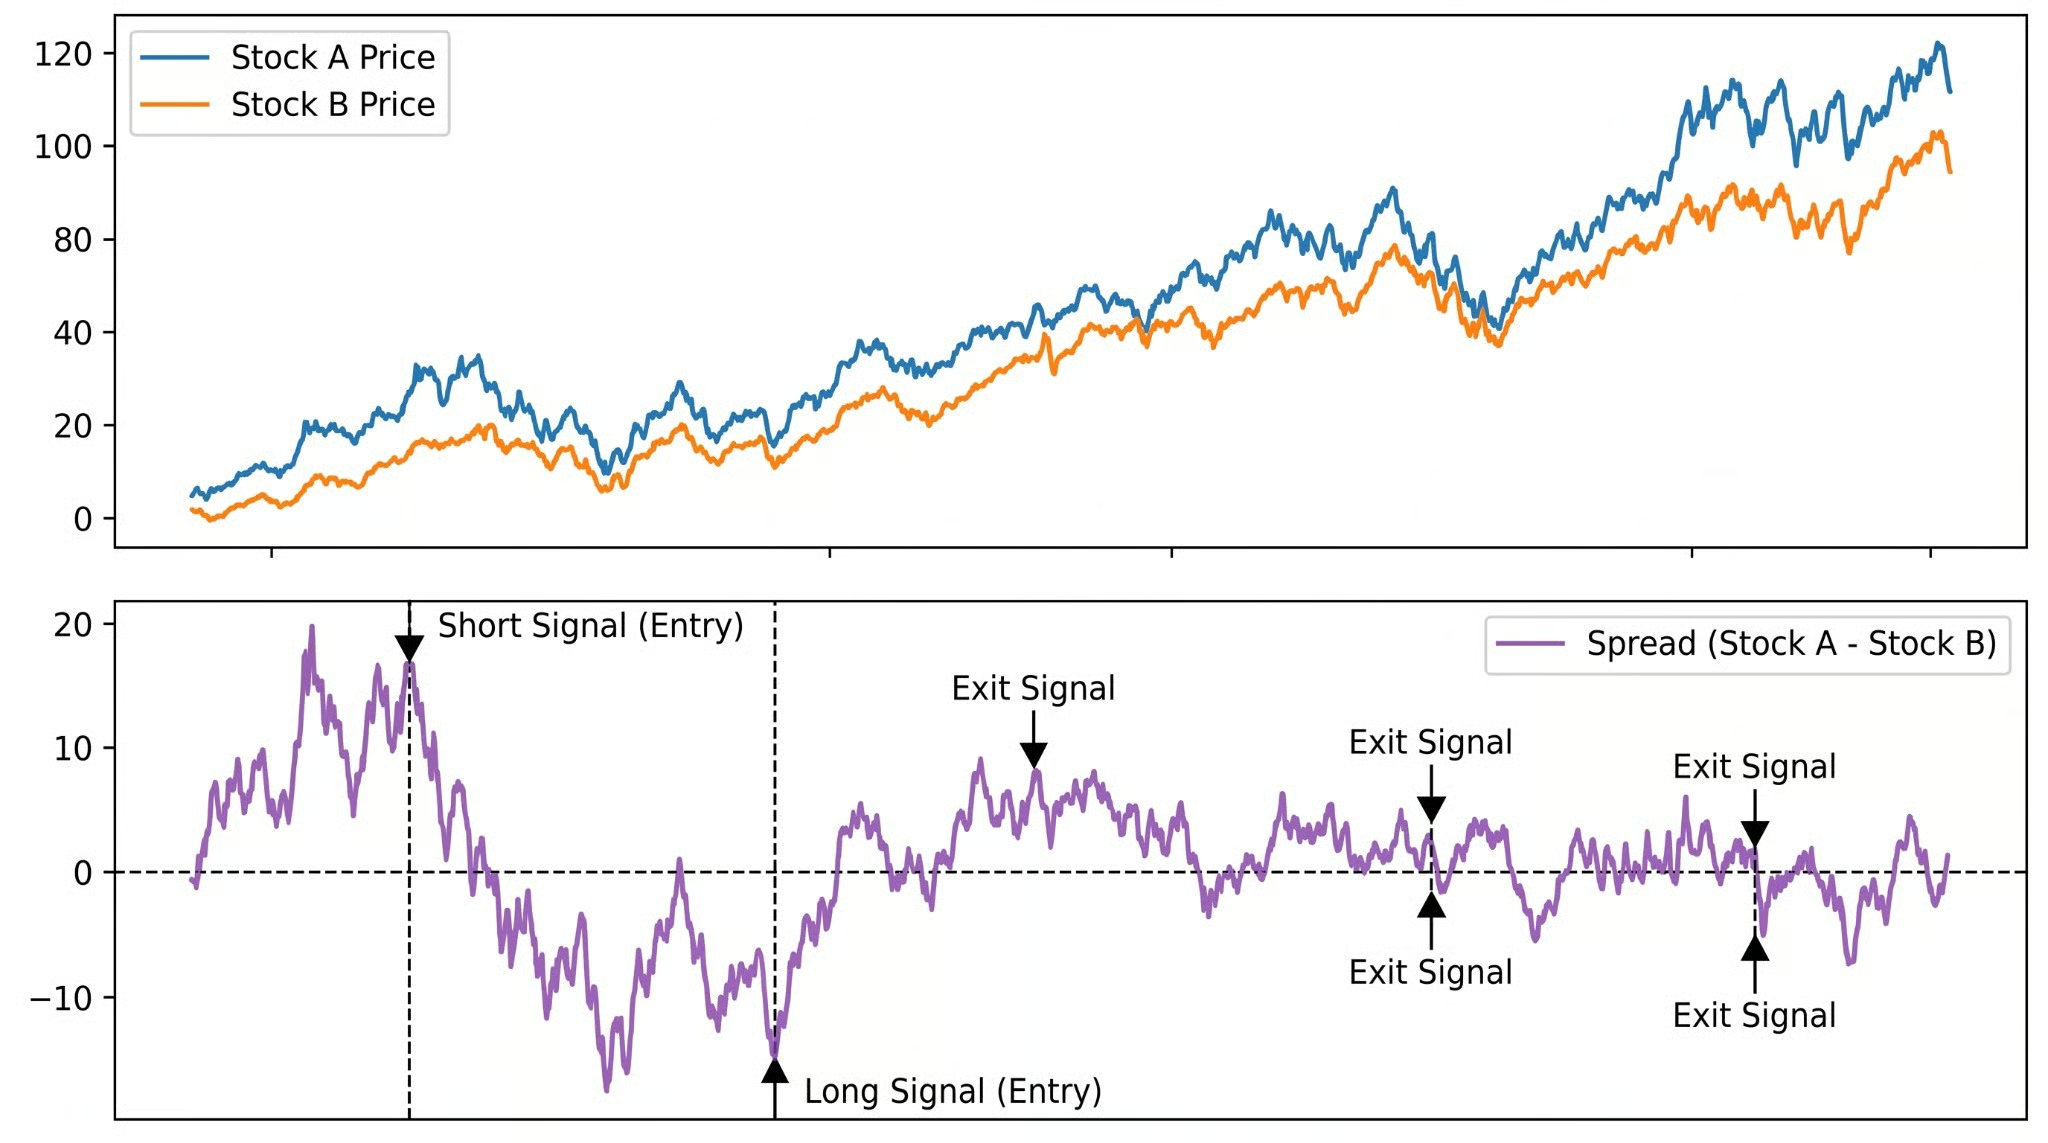
Prijzen van Aandeel A en Aandeel B (boven) en hun spread (onder), met in- en uitstapsignalen gemarkeerd op belangrijke reversion-punten. Afbeelding door auteur.
Pairs trading werkt, wanneer het werkt, dankzij mean reversion: de neiging van een spread die van zijn historisch gemiddelde afdwaalt om uiteindelijk terug te keren. De sleutelmaat is de z-score: (huidige spread − voortschrijdend gemiddelde) / standaardafwijking. Een z-score van +2 vertelt je dat de spread twee standaardafwijkingen boven zijn historische norm ligt, een ongebruikelijke waarde die sommige strategieën als shortsignaal zien.
De z-score is nuttig omdat hij het signaal standaardiseert. In plaats van te vragen "Is deze spread wijd?" vraag je "Is deze spread ongewoon wijd ten opzichte van zijn normale gedrag?" Dat is de vraag die een mean-reversion-strategie in feite probeert te beantwoorden.
Mean reversion geeft ons de handelslogica, maar roept een ongemakkelijke vraag op: hoe weet je dat een spread echt terugkeert in plaats van permanent uit elkaar te lopen? Daar scheiden correlatie en co-integratie de wegen. Dit verdient aandacht:
Correlatie meet de sterkte van de lineaire relatie tussen twee variabelen. Twee aandelen kunnen een correlatie van 0,9 hebben en toch een slechte pairs trade zijn, omdat correlatie niets zegt over of de spread ertussen stabiel of mean-reverting is.
Co-integratie beschrijft een evenwichtsrelatie op langere termijn tussen niet-stationaire tijdreeksen. Twee prijseries zijn co- geïntegreerd als een lineaire combinatie ervan stationair is, dus rond een stabiel gemiddelde schommelt in plaats van weg te driften. Dat is de eigenschap die je echt nodig hebt.
Beide aandelen kunnen jarenlang samen opwaarts trenden en daarna permanent uiteenlopen. Hoge correlatie, geen co-integratie, geen betrouwbare trade. Testen op co-integratie met de Engle-Granger-test of de Johansen-procedure geeft je een beter verdedigbare basis om aan te nemen dat de spread zal terugkeren. Let op dat PCA hier een ander verhaal is, en daar ga ik in dit artikel niet op in.
De theorie begrijpen is één ding; haar vertalen naar een werkende strategie is iets anders. De stap van intuïtie naar een realistische kwantitatieve workflow omvat vijf stappen, en het overslaan ervan leidt vaak tot strategieën die op papier geweldig lijken maar in de praktijk instorten.
Simpel pairs trading is het instapniveau, niet het plafond. Als je de kernmechaniek beheerst, breidt de aanpak meestal in twee richtingen uit.
Multi-asset-benaderingen modelleren relaties tussen mandjes met effecten in plaats van individuele paren. Factorbenaderingen strippen systematische rendementen eruit met algemene markt- of sectorfactoren en verhandelen vervolgens de resterende misprijzing. PCA schaalt dit over honderden assets: identificeer de belangrijkste bronnen van gemeenschappelijke variatie en verhandel dan de rendementen die die componenten niet verklaren.
De onderliggende weddenschap is dezelfde (residuele misprijzingen keren terug), maar het statistische raamwerk om ze te vinden verschilt. Je test niet langer of twee reeksen co- geïntegreerd zijn. Je decomponeert een hele doorsnede van rendementen en zet in op het resterende ‘lawaai’ als tijdelijk fenomeen.
ML maakt deel uit van de toolkit voor het ontdekken van relaties, signaalgeneratie en regimedetectie. Het verbetert rendementen niet automatisch en introduceert eigen modelrisico. De strategieën blijven afhankelijk van mean reversion. ML is een complexere manier om naar hetzelfde signaal te zoeken.
Meer geavanceerde strategieën elimineren de onderliggende risico’s niet. Ze maken die risico’s vaak alleen moeilijker zichtbaar tot het te laat is. Dit zijn de faalmodi die je moet begrijpen voordat je een stat-arb-strategie draait.
De historische relatie waarop je je strategie hebt gebouwd, is een beschrijving van het verleden. Brancheconsolidatie, regelgeving, een verschuiving in het bedrijfsmodel: elk daarvan kan de relatie permanent veranderen. Dan keert de spread niet terug. Hij blijft tegen je in bewegen.
Elke stat-arb-strategie rust op statistische aannames. Als de spread niet echt stationair is, als de hedge ratio verkeerd is ingeschat, als het lookback-venster slecht is gekozen, genereert het model misleidende signalen. En zelfs als het model klopt, knagen transactiekosten aan de rendementen op manieren die zelden zichtbaar zijn in naïeve backtests.
Een strategie die vóór kosten winstgevend lijkt, kan erna onrendabel zijn. Ik heb dit ook in fixed income zien gebeuren. De theoretische trade is netjes, de daadwerkelijke trade niet.
Short gaan is niet gratis. Uitleenkosten voor effecten en het risico dat een broker je terugkoopt, voegen reële kosten toe. Slippage tussen gemodelleerde en daadwerkelijke fill-prijzen stapelt zich op over honderden trades. En wanneer veel fondsen vergelijkbare strategieën draaien, worden ze blootgesteld aan elkaars gedrag.
De quant-meltdown van augustus 2007 gebeurde precies omdat te veel equity-stat-arb-fondsen tegelijkertijd liquideerden, en de resulterende kettingreactie niets te maken had met de onderliggende relaties waarop die strategieën waren gebouwd.
Stat-arb-modellen zijn gekalibreerd op een bepaalde marktomgeving (een volatiliteitsregime, een rentecyclus, een correlatiestructuur). Als die omgeving verschuift, bewegen alle aannames tegelijk.
Het is niet één paar dat uit elkaar valt; het is de hele portefeuille die zich misdraagt omdat de statistische eigenschappen waarop hij is gebouwd niet meer gelden. Spreaddynamiek die in een laagvolatiel regime stationair leek, kan van de ene op de andere dag instabiel worden wanneer de volatiliteit oploopt, en historische lookback-vensters waarschuwen je daar niet vooraf voor.
Het meest verraderlijke risico. Met genoeg parameters en historische data kun je een strategie bijna op elke periode fitten, waarna ze in live trading sterk verslechtert. Out-of-sample testing is het minimale vangnet, en zelfs dat is niet altijd genoeg.
Stat arb wordt vaak verward met enkele aanpalende strategieën.
Traditionele arbitrage benut bijna mechanische prijsverschillen: hetzelfde activum dat op twee beurzen tegen verschillende prijzen handelt. De winst is bijna zeker als je snel genoeg kunt uitvoeren. Statistische arbitrage zet in op probabilistische convergentie. Volledig andere risicoprofielen.
Pairs trading is één type statistische arbitrage, niet een synoniem voor het veld. De termen worden door elkaar gebruikt, maar stat arb omvat factormodellen, PCA-gebaseerde strategieën en machinelearning-benaderingen over grote portefeuilles. Pairs trading is waar de meesten beginnen.
Algoritmische handel is een bredere categorie die elke geautomatiseerde uitvoeringsstrategie beschrijft. Statistische arbitrage is daarbinnen een specifieke familie. High-frequency market making en trendvolgen zijn ook algoritmisch, maar geen stat arb.
Statistische arbitrage is in de kern een weddenschap dat relaties blijven bestaan. Je vindt twee effecten die historisch samen bewogen, wacht tot ze afwijken en positioneert voor het dichten van de kloof. De wiskunde formaliseert die intuïtie, maar de intuïtie is wat je eerlijk houdt wanneer de wiskunde zegt vasthouden en de markt zegt rennen.
Wat stat arb echt lastig maakt, is niet de statistiek. Het is dat de relaties waarop je handelt concurreren met iedereen die dezelfde heeft gevonden. Als ze werken, trekken ze kapitaal aan. Als ze te veel kapitaal aantrekken, werken ze niet meer, soms geleidelijk en soms in één keer, zoals 2007 liet zien.
Voor de statistische basis, stationariteitstesten en tijdreeksmodellering is de cursus Time Series Analysis in Python de juiste volgende stap. Voor backtesten en kwantitatieve workflows behandelt de cursus Financial Trading in Python het implementeren en evalueren van handelsstrategieën in de praktijk.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min