
Courses
Pythonで学ぶ金融トレーディング
4時間
21.6K
統計的裁定取引(statistical arbitrage、略して stat arb)は、証券間の統計的な関係性を用いて潜在的な売買機会を見つける、定量的取引戦略の総称です。中心となる考え方は、個別銘柄が単独で上がるか下がるかを当てることではありません。歴史的に結びつきのある2つの証券が、期待される関係から一時的に乖離した局面を捉え、いずれ再び収れんする方に賭ける、という相対的なミスプライシングの発見にあります。
最初に一つ明確にしておくと、統計的裁定取引はリスクのない裁定取引ではありません。機会は確率的であり、戦略を支える関係性が完全に崩れることもあります。私は BlueCrest でアジアの資本市場ポジションを管理していた際にこれを目の当たりにしました。紙の上では統計的に妥当な取引に見えても、マクロのレジームが変わった瞬間に崩れることがあるのです。
本記事では、ペアトレードと平均回帰による stat arb の仕組み、相関よりコインテグレーションが重要な理由、そして実務での実際のリスクの姿について解説します。
統計的裁定取引は、過去およびリアルタイムのデータを使って証券間の統計的関係を特定します。その関係が期待状態から逸脱したとき、相殺的なロング・ショートのポジションを取り、相対的に割安な証券を買い、相対的に割高な証券を空売りして、関係が正常化するのを待ちます。
このロング/ショート構造によって、市場全体の動きへのエクスポージャーが抑えられます。市場が5%下落しても両サイドがほぼ同程度に影響を受けるため、損益は市場方向ではなく、2つの証券間の相対的な動きから生じます。
一般的なワークフローは次のとおりです。関連する証券を特定し、歴史的な関係をモデル化し、現在のスプレッドが過去の常態から逸脱したときに検知し、相殺的なロングとショートを建て、収れんまたは出口条件の発動を待ちます。
簡単な例を挙げましょう。明確なファンダメンタル要因がないのに、ペプシがコカ・コーラに対して異常に大きなディスカウントで取引され始めたら、stat arb 戦略はペプシを買ってコカ・コーラを空売りし、スプレッドが元に戻ると見込みます。利益は、どちらか一方の株価方向ではなく、そのスプレッドが縮小することから生まれます。
この基本的な流れを踏まえると、ペアトレードが最も直感的な実例になります。歴史的に関連する2つの証券を選び、両者の価格からスプレッドを構築し、そのスプレッドが過去の挙動から異常に離れたときに売買します。割安を買い、割高を売り、スプレッドが収れんしたらクローズします。
強調しておきたいのは、相関だけでは安定し、取引可能な関係を示さないという点です。2つの株が高い相関を示していても、恒久的に乖離していく場合があります。次のセクションがまさにその話です。
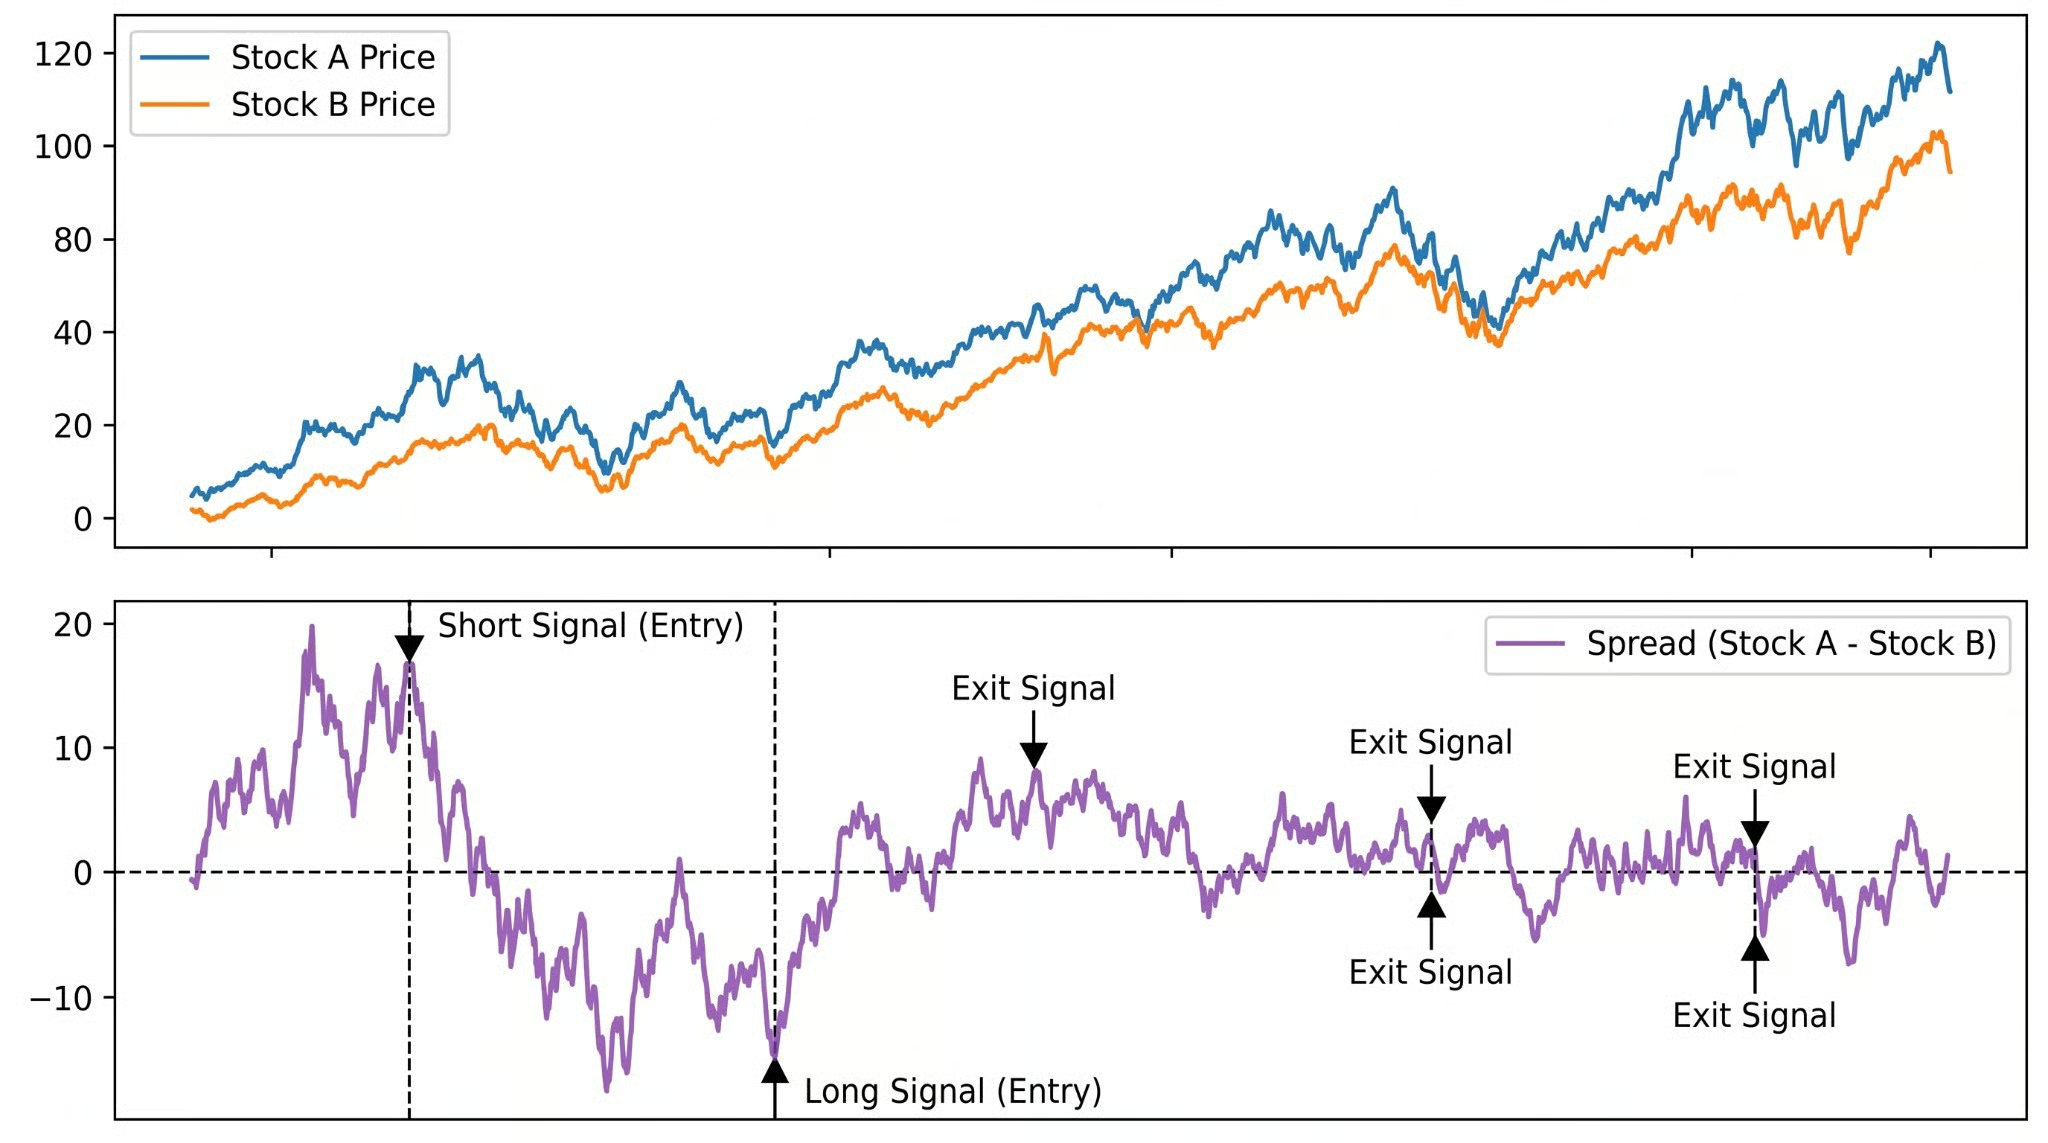
株式Aと株式Bの価格(上)とそのスプレッド(下)。主要な回帰点でエントリー/イグジットシグナルを表示。画像:著者作成。
ペアトレードが機能するときに機能するのは、平均回帰があるからです。すなわち、歴史的な平均から離れたスプレッドは、やがて平均に戻る傾向があるというものです。鍵となる指標は z スコア です:(現在のスプレッド − 移動平均)/標準偏差。z スコアが +2 なら、そのスプレッドは過去の常態より2標準偏差ぶん広がっているということになり、一部の戦略ではショートシグナルと解釈します。
z スコアが有用なのは、シグナルを標準化してくれるからです。「このスプレッドは広いか?」ではなく、「通常の挙動に比べて異常に広いか?」と問えるようになります。平均回帰戦略が本当に答えようとするのはその問いです。
平均回帰は取引ロジックを与えてくれますが、厄介な疑問も生じます。スプレッドが本当に回帰するのか、それとも恒久的に乖離していくのか、どう見分けるのか。ここで相関とコインテグレーションが分かれます。注意深く見るべきポイントです。
相関は2つの変数間の線形関係の強さを測ります。相関が0.9あってもペアトレードとして不適切な場合はあり得ます。相関は、両者のスプレッドが安定的か、平均回帰するかについては何も教えてくれないからです。
コインテグレーションは、非定常な時系列同士の長期的な均衡関係を表します。2つの価格系列のある線形結合が定常(ドリフトせず安定した平均の周りで変動)であれば、両者はコインテグレートしていると言えます。まさに必要なのはこの性質です。
両銘柄が何年も一緒に上昇トレンドを描いた後、恒久的に乖離することもあります。高い相関、コインテグレーションなし、信頼できる取引なし、というわけです。Engle–Granger 検定や Johansen 手法でコインテグレーションを検定すれば、スプレッドが回帰すると仮定する根拠がより堅固になります。なお、PCA はここでは別物で、本記事では扱いません。
理論を理解することと、それを機能する戦略に落とし込むことは別物です。直感から現実的な定量ワークフローへ移すには5つのステップが必要で、どれかを省くと、紙の上では優秀でも実運用で崩れる戦略になりがちです。
シンプルなペアトレードは入口であって到達点ではありません。コアの仕組みに慣れてくると、アプローチは概して2つの方向に広がります。
マルチアセットの手法は、個別のペアではなく証券のバスケット間の関係をモデル化します。ファクターモデルの手法は、市場やセクターといった共通因子を用いてシステマティックなリターンを取り除き、残差のミスプライシングを取引します。PCA はこれを数百資産にスケールさせます。共通変動の主な源を特定し、それらの成分で説明されないリターンを取引します。
根底の賭けは同じ(残差のミスプライシングは回帰する)が、それを見つける統計的枠組みは異なります。2つの系列がコインテグレートしているかを検定するのではなく、リターンのクロスセクション全体を分解し、残ったノイズは一時的だと賭けるのです。
ML は関係性の発見、シグナル生成、レジーム検出のための道具箱に加わりました。自動的にリターンが改善するわけではなく、独自のモデルリスクも伴います。戦略は結局、平均回帰に依存します。ML は同じシグナルを探す、より複雑な方法にすぎません。
高度な戦略になっても根本的なリスクはなくなりません。多くの場合、それらのリスクを手遅れになるまで見えにくくするだけです。stat arb を実行する前に理解しておくべき失敗パターンは次のとおりです。
戦略の基礎にした歴史的関係は、過去の記述にすぎません。業界再編、規制変更、企業のビジネスモデルの転換など、いずれも関係を恒久的に変え得ます。そうなるとスプレッドは回帰せず、逆方向に進み続けます。
あらゆる stat arb 戦略は統計的仮定に依存しています。スプレッドが実は定常でなかったり、ヘッジ比率の推定が誤っていたり、ルックバック期間の選択が不適切だったりすると、モデルは誤解を招くシグナルを出します。モデルが正しくても、取引コストがリターンを削り、素朴なバックテストでは見えにくい形で影響します。
コスト前には有望に見えた戦略が、コスト後には不採算になることもあります。これは債券でも見てきました。理論上は綺麗な取引でも、実際の取引はそうではありません。
空売りは無料ではありません。証券貸借料やブローカーによる買い戻しリスクは実質的なコストを生みます。モデル上の価格と実際の約定価格のスリッページは、何百回もの取引で蓄積します。さらに多くのファンドが類似戦略を走らせると、互いの行動に晒されます。
2007年8月のクオンツ・メルトダウンは、まさに多くの株式 stat arb ファンドが同時に解消売りを行ったことが原因で起こり、その連鎖は戦略が基づいていた根本関係とは無関係でした。
stat arb のモデルは特定の市場環境(ボラティリティ・レジーム、金利サイクル、相関構造)に合わせてキャリブレーションされています。その環境が変わると、すべての前提が一度に動きます。
崩れるのは一つのペアではありません。統計的性質がもはや成立しないため、ポートフォリオ全体の挙動がおかしくなるのです。低ボラ環境で定常に見えていたスプレッドのダイナミクスが、ボラティリティ急騰で一夜にして不安定化することもあり、過去のルックバックでは事前に警告してくれません。
最も厄介なリスクです。十分なパラメータと過去データがあれば、ほぼどんな過去期間にも戦略を当てはめられますが、実運用では急激に劣化します。アウト・オブ・サンプル検証は最低限の防波堤ですが、それでも不十分なことがあります。
stat arb は隣接するいくつかの戦略と混同されがちです。
伝統的な裁定取引は、ほぼ機械的な価格差(同一資産が2つの市場で異なる価格で取引されるなど)を突きます。十分に迅速に執行できれば利益はほぼ確実です。統計的裁定取引は確率的な収れんに賭けます。リスクプロファイルはまったく異なります。
ペアトレードは統計的裁定取引の一形態であり、分野全体の同義語ではありません。用語は入れ替えて使われがちですが、stat arb にはマルチファクターモデル、PCA ベースの戦略、機械学習アプローチを用いた大規模ポートフォリオが含まれます。ペアトレードは多くの人が最初に取り組むものです。
アルゴリズム取引は、あらゆる自動執行戦略を指すより広いカテゴリーです。統計的裁定取引はその一部に属する特定のファミリーです。高頻度のマーケットメイクやトレンドフォローもアルゴリズム取引ですが、stat arb ではありません。
統計的裁定取引の核心は、関係性が持続するという前提に賭けることです。歴史的に共に動いてきた2つの証券を見つけ、乖離を待ち、そのギャップが閉じる方向にポジションを取ります。数学はその直感を形式化しますが、数学が「ホールド」と言って市場が「逃げろ」と言うときに、自らを正直に保つのはその直感です。
stat arb を本当に難しくしているのは統計ではありません。取引しようとする関係性が、同じ関係を見つけた他者と資本を奪い合っていることです。うまくいくと資金が集まります。 資金が集まり過ぎると機能しなくなり、時に緩やかに、時に一気に止まります。2007年がそれを示しました。
統計の基礎、定常性の検定、時系列モデリングについては、Time Series Analysis in Python コースが次の最適ステップです。バックテストと定量ワークフローについては、Financial Trading in Python コースが、取引戦略の実装と評価を実務的に扱っています。
DataCampで学ぶ
Courses
Courses
Courses