

एंट्रोपी को समझना
क्रॉस-एंट्रोपी की संकल्पना सूचना सिद्धांत से आती है, जहाँ सूचना की एंट्रोपी (शैनन एंट्रोपी) को 1948 में क्लॉड शैनन ने “A Mathematical Theory of Communication” शीर्षक वाले शोधपत्र में औपचारिक रूप से प्रस्तुत किया था। क्रॉस-एंट्रोपी पर आने से पहले, एंट्रोपी को समझते हैं।
एंट्रोपी किसी तंत्र में अनियमितता या अव्यवस्था की मात्रा को गणितीय रूप से व्यक्त करती है। सूचना सिद्धांत में, किसी रैंडम वेरिएबल की एंट्रोपी उसके संभावित परिणामों में निहित औसत अनिश्चितता, आश्चर्य, या सूचना को दर्शाती है। सरल शब्दों में, यह किसी घटना की अनिश्चितता को मापती है।
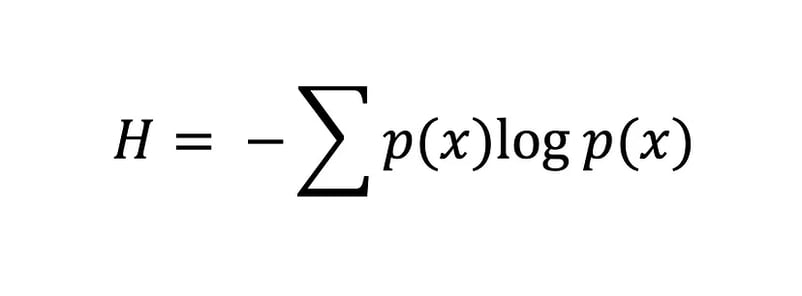
शैनन एंट्रोपी का समीकरण
एंट्रोपी H(x) का मान जितना अधिक होगा, प्रायिकता वितरण में अनिश्चितता उतनी ही अधिक होगी; और मान कम होने पर अनिश्चितता कम होगी।
क्रॉस-एंट्रोपी क्या है?
क्रॉस-एंट्रोपी, जिसे लॉगरिद्मिक लॉस या लॉग लॉस भी कहते हैं, मशीन लर्निंग में वर्गीकरण मॉडल के प्रदर्शन को मापने के लिए प्रचलित लॉस फ़ंक्शन है।
यह किसी एक प्रायिकता वितरण p से किसी घटना की पहचान करने के लिए दूसरे प्रायिकता वितरण q के लिए बनाए गए सर्वोत्कृष्ट कोड का उपयोग करते हुए औसतन कितने बिट्स चाहिए, यह मापती है। दूसरे शब्दों में, क्रॉस-एंट्रोपी किसी वर्गीकरण मॉडल के निकले हुए प्रायिकता वितरण और उसके पूर्वानुमानित मानों के बीच फर्क को मापती है।
क्रॉस-एंट्रोपी लॉस फ़ंक्शन का उपयोग प्रशिक्षण के दौरान मॉडल के वज़नों को समायोजित कर सर्वोत्कृष्ट हल खोजने के लिए किया जाता है। उद्देश्य वास्तविक और पूर्वानुमानित परिणामों के बीच त्रुटि को न्यूनतम करना होता है। क्रॉस-एंट्रोपी का मान जितना कम, प्रदर्शन उतना बेहतर। यह ऑप्टिमाइज़ेशन ग्रेडिएंट डिसेंट के माध्यम से होता है, जहाँ लॉस फ़ंक्शन के ग्रेडिएंट पैरामीटर अपडेट का मार्गदर्शन करते हैं।
यदि आप Kullback–Leibler (KL) Divergence से परिचित हैं, तो आप पूछ सकते हैं, “क्रॉस-एंट्रोपी और KL डाइवर्जेंस में क्या अंतर है?” यह उचित प्रश्न है। दोनों ही अवधारणाएँ प्रायिकता वितरणों के बीच अंतर या समानता को मापने में व्यापक रूप से प्रयुक्त होती हैं। कुछ समानताएँ होने के बावजूद, इनके उद्देश्य अलग हैं।
जैसा ऊपर बताया गया, क्रॉस-एंट्रोपी इस बात को मापती है कि प्रायिकता वितरण P से किसी घटना की पहचान करने के लिए प्रायिकता वितरण Q के सर्वोत्कृष्ट कोड के साथ औसतन कितने बिट्स चाहिए; और इसे आमतौर पर मशीन लर्निंग में मॉडल के प्रदर्शन का आकलन करने में उपयोग किया जाता है, जहाँ उद्देश्य पूर्वानुमानित प्रायिकता वितरण और वास्तविक वितरण के बीच त्रुटि को न्यूनतम करना होता है।
इसके विपरीत, KL डाइवर्जेंस दो प्रायिकता वितरणों P और Q के बीच अंतर को मापती है। विशेष रूप से, KL डाइवर्जेंस यह परिमाणित करती है कि जब Q के माध्यम से P का सन्निकटन किया जाता है, तो सूचना की कितनी हानि होती है। यह अनसुपर्वाइज़्ड लर्निंग कार्यों में अत्यंत उपयोगी है, जहाँ उद्देश्य वास्तविक और सीखे गए डेटा वितरणों के बीच डाइवर्जेंस को घटाकर डेटा में संरचना को समझना होता है।
लॉस फ़ंक्शन के रूप में क्रॉस-एंट्रोपी
मशीन लर्निंग में, लॉस फ़ंक्शन मॉडल को यह समझने में मदद करते हैं कि वह कितना गलत है और उसी के आधार पर स्वयं को बेहतर करें। ये गणितीय फ़ंक्शन हैं जो किसी मॉडल में पूर्वानुमानित और वास्तविक मानों के बीच अंतर को परिमाणित करते हैं, और यही इनका एकमात्र काम नहीं है।
लॉस फ़ंक्शन से निकली त्रुटि का परिमाण ऑप्टिमाइज़ेशन प्रक्रिया में भी मार्गदर्शक का काम करता है, क्योंकि यह मॉडल को यह फीडबैक देता है कि वह डेटा के अनुरूप कितना बैठ रहा है। इसलिए, अधिकांश मशीन लर्निंग मॉडल ऑप्टिमाइज़ेशन चरण के दौरान कोई न कोई लॉस फ़ंक्शन लागू करते हैं, जहाँ मॉडल के पैरामीटर इस तरह चुने जाते हैं कि त्रुटि न्यूनतम हो और एक सर्वोत्कृष्ट हल मिले — त्रुटि जितनी कम, मॉडल उतना बेहतर।
हम दो प्रायिकता वितरणों के बीच त्रुटि को क्रॉस-एंट्रोपी लॉस फ़ंक्शन से माप सकते हैं। उदाहरण के लिए, मान लीजिए हम एक बाइनरी क्लासिफिकेशन कार्य कर रहे हैं (दो वर्गों 0 और 1 वाला कार्य)।
इस स्थिति में हमें बाइनरी क्रॉस-एंट्रोपी का उपयोग करना होगा, जो सभी डेटा सैंपलों पर औसत क्रॉस-एंट्रोपी है:
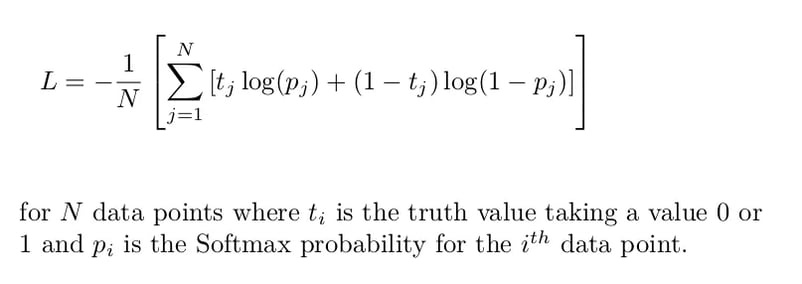
बाइनरी क्रॉस-एंट्रोपी का सूत्र [स्रोत: Cross-Entropy Loss Function]
यदि हम किसी एक डेटा पॉइंट का लॉस निकालें, जहाँ सही मान y=1 है, तो हमारा समीकरण इस प्रकार होगा:
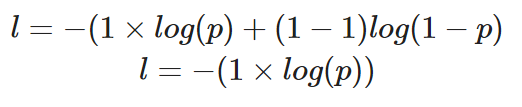
एक उदाहरण के लिए बाइनरी क्रॉस-एंट्रोपी की गणना, जहाँ वास्तविक मान 1 है
पूर्वानुमानित प्रायिकता p, लॉस l के मान को निर्धारित करती है। यदि p का मान अधिक है, तो सही पूर्वानुमान के लिए मॉडल को पुरस्कृत किया जाएगा — यह लॉस l के कम मान से दिखाई देगा।
वहीं, p का मान कम होने पर यह दर्शाता है कि मॉडल गलत था, और बाइनरी क्रॉस-एंट्रोपी लॉस फ़ंक्शन l के मान को बढ़ाकर इसे दर्शाएगा।
मल्टी-क्लास क्लासिफिकेशन कार्य के लिए, क्रॉस-एंट्रोपी (या जिसे प्रायः कैटेगॉरिकल क्रॉस-एंट्रोपी कहा जाता है) को निम्न प्रकार बढ़ाया जा सकता है। इस स्थिति में, आउटपुट लेयर आमतौर पर softmax activation function का उपयोग करती है ताकि सभी वर्गों पर प्रायिकता वितरण प्राप्त हो:
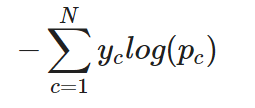
एक उदाहरण के लिए कैटेगॉरिकल क्रॉस-एंट्रोपी
अर्थात, मल्टी-क्लास क्लासिफिकेशन में क्रॉस-एंट्रोपी लागू करते समय, हर वर्ग के लिए लॉस अलग से निकाला जाता है और फिर जोड़कर कुल लॉस प्राप्त किया जाता है।
क्रॉस-एंट्रोपी लॉस कब इस्तेमाल करें
क्रॉस-एंट्रोपी लॉस वर्गीकरण कार्यों के लिए मानक विकल्प है, लेकिन किस वैरिएंट का उपयोग कब करना है, यह समझना बेहतर मॉडल बनाने में मदद करता है:
| लॉस फ़ंक्शन | उपयोग का परिदृश्य | आउटपुट एक्टिवेशन | उदाहरण |
|---|---|---|---|
| बाइनरी क्रॉस-एंट्रोपी | दो वर्ग (0 या 1) | Sigmoid | स्पैम डिटेक्शन, चिकित्सीय निदान |
| कैटेगॉरिकल क्रॉस-एंट्रोपी | एक-दूसरे को निष्कासित करने वाले अनेक वर्ग | Softmax | इमेज क्लासिफिकेशन, सेंटिमेंट विश्लेषण |
| बाइनरी क्रॉस-एंट्रोपी (मल्टी-लेबल) | प्रत्येक सैंपल पर अनेक लेबल | Sigmoid (प्रति आउटपुट) | इमेज टैगिंग, दस्तावेज़ वर्गीकरण |
PyTorch और TensorFlow में क्रॉस-एंट्रोपी लॉस लागू करना
ट्यूटोरियल के इस भाग में, हम TensorFlow और PyTorch में क्रॉस-एंट्रोपी लॉस फ़ंक्शन का उपयोग करना सीखेंगे।
आइए डेटासेट बनाकर शुरू करते हैं। हम Scikit-learn की make_classification फ़ंक्शन का उपयोग करेंगे:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
# Create training data
X, y = make_classification(
n_samples=10000,
n_informative=10,
random_state=2022
)
# split into train and test
X_new, X_test = X[:9000, :], X[9000:, ]
y_new, y_test = y[:9000], y[9000:]
X_train, X_val, y_train, y_val = train_test_split(
X_new, y_new,
test_size=0.3
)
print(f"Train data: {X_train.shape}\n\
Train labels: {y_train.shape}\n\
Test data: {X_test.shape}\n\
Test labels: {y_test.shape}")
"""
Train data: (6300, 20)
Train labels: (6300,)
Test data: (1000, 20)
Test labels: (1000,)
"""TensorFlow में क्रॉस-एंट्रोपी
हम जो मॉडल बनाएँगे, उसमें एक इनपुट लेयर, एक हिडन लेयर और एक आउटपुट लेयर होगी।
चूँकि यह एक बाइनरी क्लासिफिकेशन कार्य है, हम लॉस फ़ंक्शन के रूप में बाइनरी क्रॉस-एंट्रोपी का उपयोग करेंगे। आउटपुट लेयर sigmoid activation function का उपयोग करेगी ताकि 0 और 1 के बीच प्रायिकताएँ उत्पन्न हों।
import tensorflow as tf
# Build and train model
model = tf.keras.Sequential([
tf.keras.layers.Dense(10,
input_shape=(X_train.shape[1],),
activation="relu"),
tf.keras.layers.Dense(10,
activation="relu"),
tf.keras.layers.Dense(1, activation="sigmoid")
])
model.compile(
loss="binary_crossentropy", # loss function here
optimizer="adam",
metrics=["accuracy"])
history = model.fit(X_train, y_train, epochs=20, validation_data=[X_val, y_val], verbose=0)अगला कदम, हम लॉस को प्लॉट करेंगे ताकि देखें कि मॉडल सुधर रहा है या नहीं — यानी प्रत्येक epoch के साथ त्रुटि कम हो रही है, जब तक कि वह और न सुधर सके।
# plotting the loss of the models
fig, ax = plt.subplots(figsize=(8,5))
plt.plot(history.history['loss'])
plt.plot(history.history['val_loss'])
plt.title('model loss')
plt.ylabel('loss')
plt.xlabel('epoch')
plt.xticks(np.arange(0,20, step=1))
plt.legend(['train', 'test'], loc='upper right')
plt.show()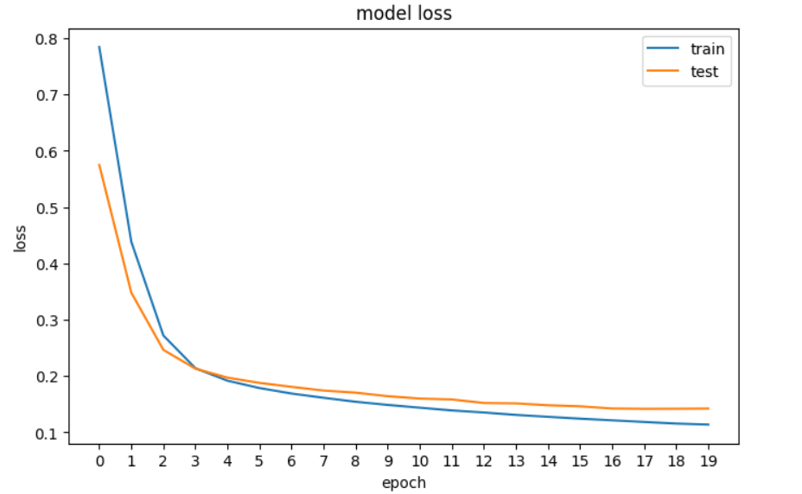
TensorFlow में हमारे न्यूरल नेटवर्क के लॉस का प्लॉट।
PyTorch में क्रॉस-एंट्रोपी
PyTorch में, मॉडल के इनपुट, आउटपुट और पैरामीटर टेन्सर के रूप में एन्कोड किए जाते हैं, इसलिए हमें अपने Numpy ऐरे को टेन्सर में बदलना होगा। नीचे दिए गए कोड में हम सबसे पहले यही करते हैं, फिर न्यूरल नेटवर्क बनाते हैं और उसके आयाम प्रिंट करते हैं।
import torch
import torch.nn as nn
import torch.optim as optim
# Convert numpy arrays to tensors
X_train_tensor = torch.tensor(X_train, dtype=torch.float32)
X_val_tensor = torch.tensor(X_val, dtype=torch.float32)
y_train_tensor = torch.tensor(y_train, dtype=torch.float32).reshape(-1, 1)
y_val_tensor = torch.tensor(y_val, dtype=torch.float32).reshape(-1, 1)
# Build the model
input_dim = X_train.shape[1]
hidden_dim = 10
output_dim = 1
model = nn.Sequential(
nn.Linear(input_dim, hidden_dim),
nn.ReLU(),
nn.Linear(hidden_dim, hidden_dim),
nn.ReLU(),
nn.Linear(hidden_dim, output_dim),
nn.Sigmoid()
)
print(model)
"""
Sequential(
(0): Linear(in_features=20, out_features=10, bias=True)
(1): ReLU()
(2): Linear(in_features=10, out_features=10, bias=True)
(3): ReLU()
(4): Linear(in_features=10, out_features=1, bias=True)
(5): Sigmoid()
)
"""अब हम बाइनरी क्रॉस-एंट्रोपी लॉस फ़ंक्शन और ऑप्टिमाइज़र परिभाषित करते हैं:
loss_fn = nn.BCELoss() # binary cross entropy
optimizer = optim.Adam(model.parameters(), lr=0.001)अब मॉडल को ट्रेन करना है। यह रहा प्रशिक्षण लूप:
# Training loop
n_epochs = 20
train_loss = []
val_loss = []
for epoch in range(n_epochs):
# Training
model.train()
y_pred = model(X_train_tensor)
loss = loss_fn(y_pred, y_train_tensor)
optimizer.zero_grad()
loss.backward()
optimizer.step()
train_loss.append(loss.item())
# Validation
model.eval()
with torch.no_grad():
y_val_pred = model(X_val_tensor)
v_loss = loss_fn(y_val_pred, y_val_tensor)
val_loss.append(v_loss.item())और अब लॉस को प्लॉट करते हैं:
# plotting the loss of the models
fig, ax = plt.subplots(figsize=(8,5))
plt.plot(train_loss)
plt.plot(val_loss)
plt.title('model loss')
plt.ylabel('loss')
plt.xlabel('epoch')
plt.xticks(np.arange(0,20, step=1))
plt.legend(['train', 'test'], loc='upper right')
plt.show()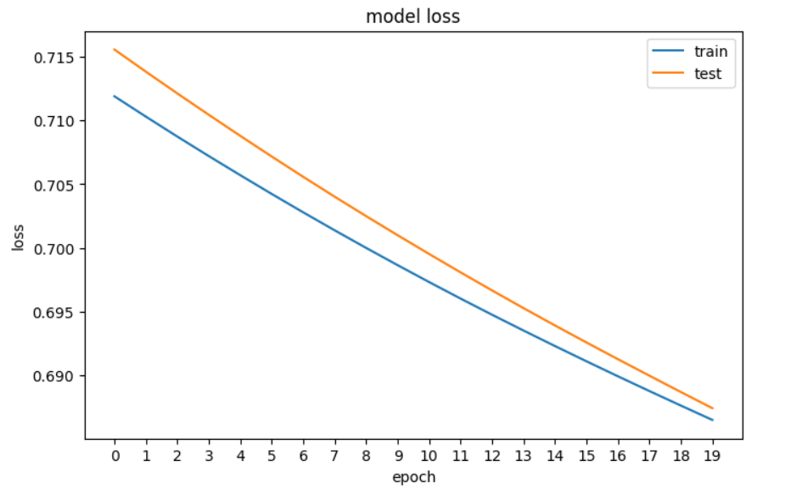
PyTorch में हमारे न्यूरल नेटवर्क के लॉस का प्लॉट
मुख्य निष्कर्ष
क्रॉस-एंट्रोपी लॉस के बारे में हमने जो सीखा है, उसका एक त्वरित पुनरावलोकन:
- एंट्रोपी किसी प्रणाली में यादृच्छिकता या अव्यवस्था की डिग्री की गणना करती है ताकि किसी घटना की अनिश्चितता को मापा जा सके। यदि परिणाम निश्चित है, तो एंट्रोपी का मान कम होगा।
- क्रॉस-एंट्रोपी मशीन लर्निंग में एक लोकप्रिय लॉस फ़ंक्शन है, जिसका उपयोग किसी वर्गीकरण मॉडल के प्रदर्शन को मापने के लिए किया जाता है। यह किसी वर्गीकरण मॉडल द्वारा खोजी गई संभावना वितरण और भविष्यवाणी किए गए मानों के बीच के अंतर को मापता है। बाइनरी क्लासिफिकेशन कार्यों पर लागू होने पर, इसे आमतौर पर लॉग लॉस कहा जाता है।
- बाइनरी क्रॉस-एंट्रोपी का उपयोग बाइनरी क्लासिफिकेशन में किया जाता है, और कैटेगोरिकल क्रॉस-एंट्रोपी का उपयोग मल्टी-क्लास क्लासिफिकेशन में होता है।
- क्रॉस-एंट्रोपी KL डाइवर्जेंस के समान है, लेकिन उनका उद्देश्य अलग है: क्रॉस-एंट्रोपी आमतौर पर मशीन लर्निंग में किसी मॉडल के प्रदर्शन का आकलन करने के लिए उपयोग की जाती है, जहाँ लक्ष्य भविष्यवाणी की गई संभावना वितरण और वास्तविक वितरण के बीच त्रुटि को न्यूनतम करना होता है; जबकि KL असUPERVISED लर्निंग कार्यों में अधिक उपयोगी है, जहाँ लक्ष्य वास्तविक और सीखी गई डेटा वितरणों के बीच विचलन को न्यूनतम करके डेटा की संरचना का पता लगाना होता है।
अपनी सीख जारी रखने के लिए, हमारे संसाधन देखें:

क्रॉस-एंट्रोपी FAQs
मशीन लर्निंग में क्रॉस-एंट्रोपी क्या है?
क्रॉस-एंट्रोपी, जिसे लॉगरिदमिक लॉस या लॉग लॉस भी कहा जाता है, मशीन लर्निंग में एक लोकप्रिय लॉस फ़ंक्शन है जो किसी वर्गीकरण मॉडल के प्रदर्शन को मापने के लिए उपयोग होता है। यह भविष्यवाणी की गई संभावना वितरण और वास्तविक वितरण के बीच अंतर को मापता है।
एंट्रोपी क्रॉस-एंट्रोपी से कैसे संबंधित है?
एंट्रोपी किसी प्रणाली में यादृच्छिकता या अव्यवस्था की डिग्री की गणना करती है और किसी घटना की अनिश्चितता को मापती है। क्रॉस-एंट्रोपी इस अवधारणा पर आधारित है और यह मापती है कि एक संभावना वितरण के लिए अनुकूलित कोड का उपयोग करके किसी अन्य वितरण से घटना की पहचान करने के लिए औसतन कितने बिट्स की आवश्यकता होगी।
शैनन एंट्रोपी समीकरण क्या है?
शैनन एंट्रोपी समीकरण किसी यादृच्छिक चर की एंट्रोपी की गणना करता है, जिससे संभावित परिणामों में अंतर्निहित औसत अनिश्चितता या सूचना की मात्रा मापी जाती है। अधिक एंट्रोपी मान अधिक अनिश्चितता को दर्शाता है।
क्रॉस-एंट्रोपी KL डाइवर्जेंस से कैसे भिन्न है?
क्रॉस-एंट्रोपी का उपयोग किसी वर्गीकरण मॉडल के प्रदर्शन का आकलन करने के लिए किया जाता है, जिसमें भविष्यवाणी और वास्तविक वितरणों के बीच त्रुटि को न्यूनतम किया जाता है। KL डाइवर्जेंस यह मापता है कि जब एक वितरण दूसरे का अनुमान लगाता है, तो सूचना का कितना नुकसान होता है। KL डाइवर्जेंस का उपयोग अक्सर असUPERVISED लर्निंग कार्यों में किया जाता है।
बाइनरी क्रॉस-एंट्रोपी क्या है?
बाइनरी क्रॉस-एंट्रोपी का उपयोग बाइनरी क्लासिफिकेशन कार्यों के लिए किया जाता है। यह सभी डेटा सैंपल्स पर औसत क्रॉस-एंट्रोपी की गणना करता है।
कैटेगोरिकल क्रॉस-एंट्रोपी बाइनरी क्रॉस-एंट्रोपी से कैसे अलग है?
कैटेगोरिकल क्रॉस-एंट्रोपी बाइनरी क्रॉस-एंट्रोपी का विस्तार है, जिसका उपयोग मल्टी-क्लास क्लासिफिकेशन कार्यों में किया जाता है।
मशीन लर्निंग में लॉस फ़ंक्शन महत्वपूर्ण क्यों हैं?
लॉस फ़ंक्शन मशीन लर्निंग मॉडल में भविष्यवाणी और वास्तविक मानों के बीच अंतर को परिमाणित करते हैं। वे अनुकूलन प्रक्रिया का मार्गदर्शन करते हैं, यह फीडबैक देकर कि मॉडल डेटा पर कितना अच्छा फिट बैठता है। अधिक जानने के लिए हमारा गाइड Loss Functions in Machine Learning Explained पढ़ें।
मशीन लर्निंग में और किस प्रकार के लॉस फ़ंक्शन होते हैं?
मशीन लर्निंग में अन्य लॉस फ़ंक्शन में रिग्रेशन कार्यों के लिए मीन स्क्वेयर्ड एरर (MSE) और मीन एब्सोल्यूट एरर (MAE), सपोर्ट वेक्टर मशीन्स के लिए हिंज लॉस, रोबस्ट रिग्रेशन के लिए Huber लॉस, काउंट डेटा रिग्रेशन के लिए Poisson लॉस, और वेक्टर समानताओं से संबंधित कार्यों के लिए कोसाइन प्रॉक्सिमिटी शामिल हैं। लॉस फ़ंक्शन्स और मशीन लर्निंग में उनकी भूमिका के बारे में अधिक जानने के लिए हमारा पोस्ट What is Deep Learning? A Tutorial for Beginners पढ़ें।
PyTorch में क्रॉस-एंट्रोपी लॉस फ़ंक्शन कैसे लागू किया जाता है?
PyTorch में, क्रॉस-एंट्रोपी लॉस फ़ंक्शन को बाइनरी क्लासिफिकेशन कार्यों के लिए nn.BCELoss क्लास का उपयोग करके लागू किया जाता है। मॉडल को nn.Sequential के साथ परिभाषित लेयर्स द्वारा बनाया जाता है, और ऑप्टिमाइज़र को optim.Adam का उपयोग करके सेट किया जाता है। प्रशिक्षण के दौरान लॉस की गणना की जाती है ताकि मॉडल पैरामीटर्स को अपडेट किया जा सके।
आज हम जिन अधिकांश ऐप्लिकेशनों का उपयोग करते हैं, वे किसी न किसी रूप में मशीन लर्निंग को शामिल करते हैं ताकि किसी व्यावसायिक प्रक्रिया को बेहतर या स्वचालित किया जा सके।
हालाँकि, इन मॉडलों को सीधे लाइव वातावरण में नहीं तैनात किया जा सकता — खासकर उच्च जोखिम वाले संदर्भों में (जैसे यह भविष्यवाणी करना कि किसी को कैंसर है या नहीं)। प्रोडक्शन में जाने से पहले इन्हें कुशल और प्रभावी ढंग से काम करने के लिए ऑप्टिमाइज़ करना आवश्यक है। इसका अर्थ है कि मॉडल पैरामीटर्स को फाइन-ट्यून किया जाए ताकि वे बेहतर ग्राहक अनुभव में योगदान दें।
प्रैक्टिशनर्स आमतौर पर ट्रेनिंग के दौरान अपने मशीन लर्निंग मॉडल के लिए सर्वोत्तम समाधान खोजने हेतु लॉस/कॉस्ट फ़ंक्शंस का उपयोग करते हैं। क्रॉस-एंट्रॉपी, लॉस फ़ंक्शंस में से एक लोकप्रिय विधि है, जिसका उपयोग क्लासीफिकेशन मॉडलों को ऑप्टिमाइज़ करने के लिए किया जाता है।
इस लेख में, हम विस्तार से देखेंगे:
संक्षेप में
nn.BCELoss, TensorFlow मेंbinary_crossentropy) का उपयोग करें