

指数函数与对数函数
我们来看看两类密切相关的函数:指数函数与对数函数。
指数函数
假设您存入 100 美元到一个每年复利 10% 的储蓄账户。
- 第 0 年(尚未过一年),f(0) = $100。
- 第 1 年,f(1) = $100 x 1.10 = $110。
- 第 2 年,f(2) = $110 x 1.10 = ($100 x 1.10) x 1.10 = $100 x 1.102 = $121。
- 第 3 年,f(3) = $121 x 1.10 = ($100 x 1.10 x 1.10) x 1.10 = $100 x 1.103 = $133.10
- 第 x 年,f(x) = $100 * 1.10x。
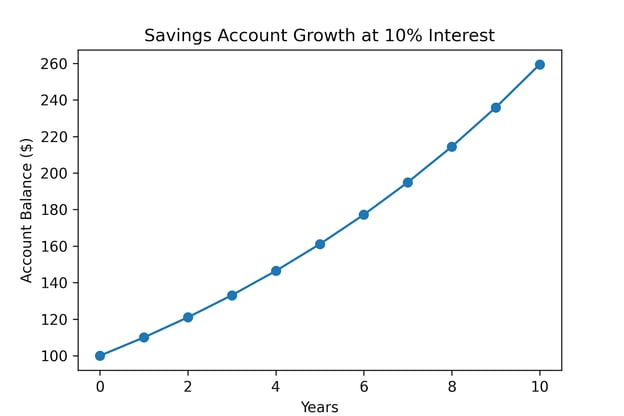
这是指数增长的例子。每一步都把前一步乘以一个固定量。指数增长的一般形式是 y = A bx,其中 y 为输出,x 为输入(通常是时间),A 为初始量,b 为每单位 x 的增长因子。
在数据科学中,指数模型常见于复合增长过程,如用户增长或收入增长、概率模型以及许多其他应用。
对数函数
对数函数把问题反过来。现在,您不再问经过 x 段时间后金额是多少,而是假设复利因子为 10%,想知道需要多长时间才能让钱变成 200 美元。
- 建立方程:200 = 100 * 1.10x
- 两边同时除以 100:2 = 1 * 1.10x
现在我们需要知道 1.10 自乘多少次才能得到 2。这正是对数要回答的问题。
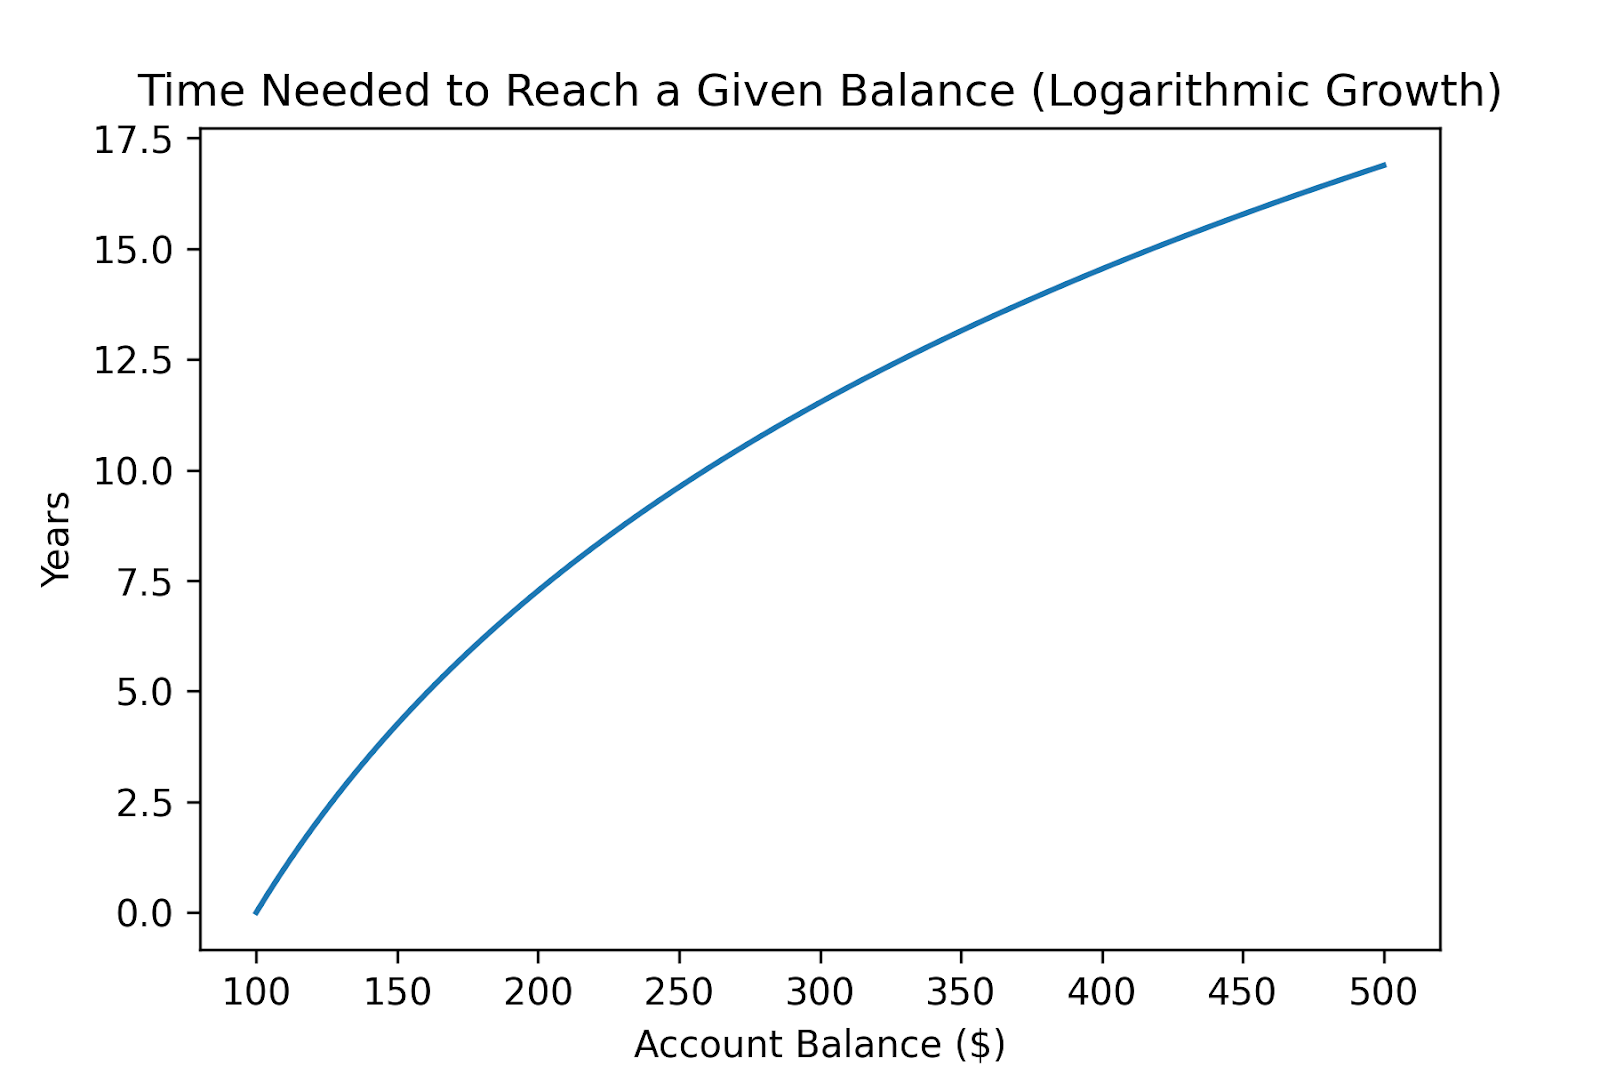
从图上看,我们的钱翻倍需要略多于 7 年。
正如我们推导的那样,对数函数是指数函数的反函数。指数模型问的是:经过 x 个月,增长到了多少?对数模型问的是:给定一个增长倍数,花了多少个月才达到?
数据科学家常用对数来让偏态分布更易处理。例如,收入分布通常极度右偏:少数高收入者把分布上端拉得很长,而大多数人聚集在低端。
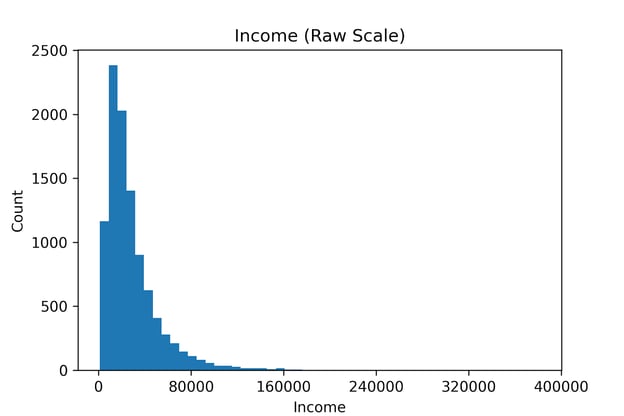
您可以通过对每个数据点取对数来变换数据:
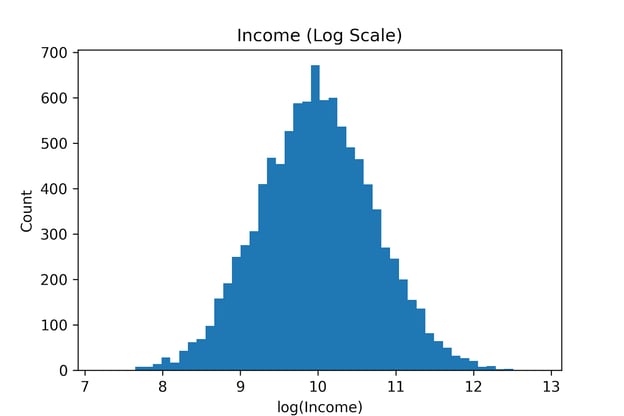
较大的收入被压缩,而其他收入被拉开。对数变换把问题从绝对差异转为相对差异。结果是长长的右尾收缩,分布往往变得大致正态。此时方差更稳定,我们可以应用线性回归。
对数在二分类中最常用的损失函数之一中居于核心地位,即交叉熵损失或对数损失,其对单一样本的定义为:
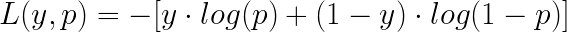
这里,二元变量 y(0 或 1)是该样本的真实标签,p 是预测为类别 1 的概率。
- 如果 y 为 1,则损失为 -log(p),p 越接近 0,惩罚越大。
- 如果 y 为 0,则损失为 -log(1-p),p 越接近 1,惩罚越大。
对数损失会对自信但错误的预测施以强烈惩罚。当真实标签为 1 而您预测的概率接近 0(反之亦然)时,会产生巨大的惩罚;而不确定的预测惩罚较小。这使得对数损失非常适合训练概率分类器,例如逻辑回归。
非线性激活函数
激活函数用于神经网络中,以确保每一层的输出是非线性的。常见的激活函数有 sigmoid 与 ReLU。
Sigmoid 函数
Sigmoid 函数是一条平滑的 S 形曲线,其定义如下:
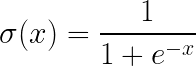
它可以接收任意实数作为输入,并输出严格处于 0 与 1 之间的值。它常用于将原始分数转换为概率。
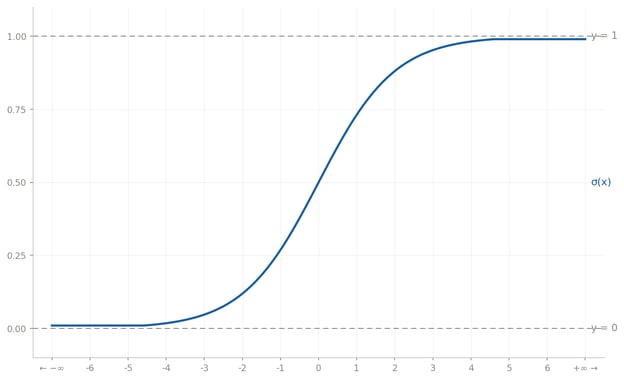
sigmoid 函数的一个常见用例是用于二分类的逻辑回归。逻辑回归对输入做线性组合以得到一个分数,然后用 sigmoid 函数将该分数转换为概率。高于某个阈值(通常为 0.5)的概率被归为 1,低于阈值的被归为 0。
更多内容请参阅我们的 Python 逻辑回归 和 R 中的逻辑回归 教程。
ReLU(线性整流单元)
线性整流单元(ReLU)函数将负数转为 0,而保持正数不变。其定义为:
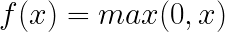
当取值大于 0 时,它与恒等函数相同,正如下图所示:
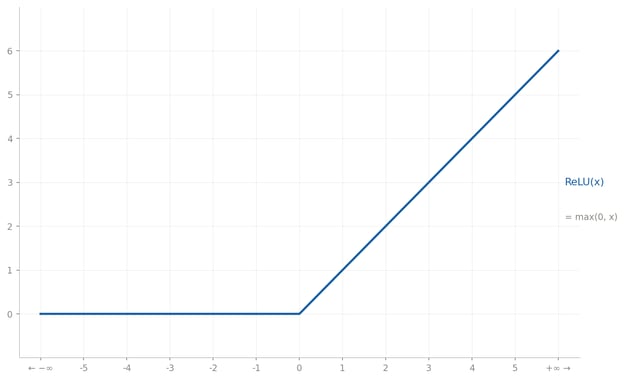
与 sigmoid 函数类似,它作为 神经网络隐藏层中的非线性激活函数发挥作用。然而它的计算非常简单,只需一次取最大运算,而 sigmoid 需要代价更高的指数函数调用。
由于 ReLU 会把所有负值设为 0,它会在网络中产生稀疏性,许多神经元被清零。这可以降低噪声,并带来更高效的表示。
将决策树视为分段函数
非线性函数的另一种形态可见于决策树。决策树通过对特征与阈值进行划分,递归地把输入空间分割为更小的区域,直到满足停止条件。
每个最终的叶节点都会被赋予一个预测值。因此,决策树可以被视为一个分段函数,其中定义域的每个区域都映射到一个常数预测值。通过把许多局部规则拼接起来,决策树能够捕捉复杂模式。
例如,您可能会看到如下对二维区域的划分:
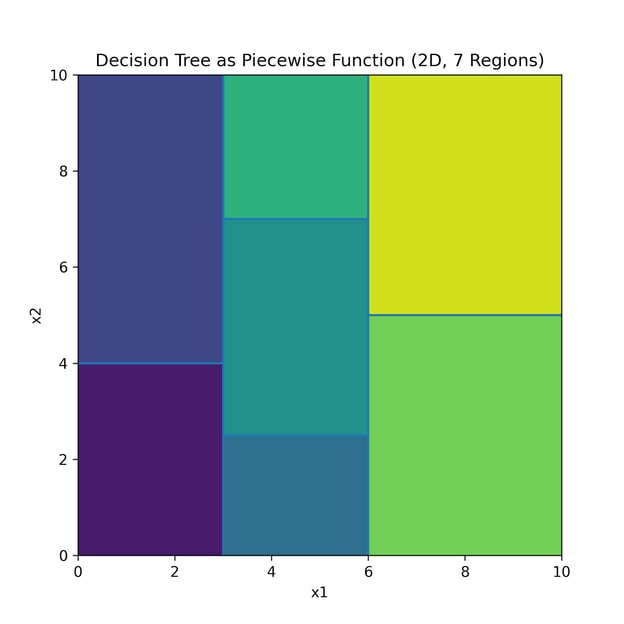
这个热力图对应如下区域:
|
区域 |
定义域片段 |
函数值 |
|
1 |
x1 < 3 且 x2 < 4 |
1 |
|
2 |
x1 < 3 且 x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 且 x2 < 2.5 |
3 |
|
4 |
3 ≤ x1 < 6 且 2.5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 且 x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 且 x2 < 5 |
6 |
|
7 |
x1 ≥ 6 且 x2 ≥ 5 |
7 |
函数优化
函数优化是寻找能使函数取到极大或极小的输入值的过程。例如,您可能想最大化利润函数,或最小化误差函数。对函数优化的研究称为“运筹学”,这是一个庞大且持续发展的数学理论体系。
优化与函数的局部与全局“极值”(最大或最小点)密切相关。“局部最小”是在某个范围内的最小值,而“全局最小”是函数整体的最小值。
例如,考虑函数 f(x) = x4 - 3x2 + x。
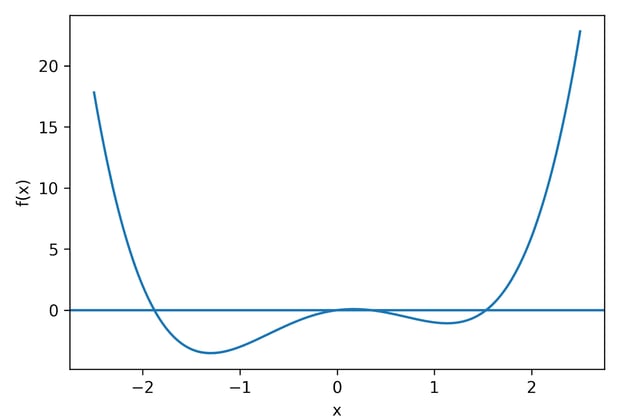
它有两个局部最小值:当 x 约为 -1.30 时一个,当 x 约为 1.13 时另一个。当 y 值更低的是 x = -1.30 处,因此这是该函数的全局最小值。
对于像在一元定价模型中寻找最大化利润的最佳价格这类简单优化任务,只需对函数求导、令导数为零并解出 x 即可。对于训练深度神经网络,事情没那么简单,但原理类似。
对深度学习而言,最重要的优化方法是梯度下降。梯度是斜率在多维上的推广,告诉我们损失相对于各个参数如何变化。
它通过反复沿着函数最陡下降的方向移动来工作。每一步,它用梯度决定往哪个方向走,用步长决定走多远。随着时间推移,这个过程会收敛到一个局部最小值。
结语
函数在数学、编程和数据科学中无处不在。机器学习中的“学习”,本质上就是寻找将输入映射到输出的最佳函数(及其参数)。既然您已了解函数,不妨用 Python 或您偏爱的编程语言写些代码实践一下!
若想了解这些理念如何融入真实的机器学习工作流,您可以继续学习 Understanding Machine Learning 课程。
Mathematical Functions FAQs
数学中的函数是什么?
数学函数是一条把每个输入精确映射到一个输出的规则。
为什么数学函数只有一个输出?
否则该规则按定义就不是函数,因为会产生歧义。
编程函数与数学函数相同吗?
不完全相同。编程函数可能有副作用,甚至不返回有用的值,而数学函数不允许这样。
为什么函数在数据科学中很重要?
因为模型就是函数。模型将特征映射到预测、概率或分数。
函数的定义域与陪域是什么?
定义域是有效输入的集合。陪域是有效输出的集合。

Mark Pedigo(博士)是一位在医疗数据科学、编程与教育领域具有深厚专长的资深数据科学家。Mark 拥有数学博士学位、计算机科学学士学位以及人工智能专业证书,兼具扎实的技术底蕴与务实的解决问题能力。他的职业经历涵盖欺诈检测、婴儿死亡率预测与财务预测,并参与了 NASA 成本估算软件的研发。作为教育工作者,他曾在 DataCamp 和圣路易斯华盛顿大学任教,并指导初级程序员。在闲暇时间,Mark 与妻子 Mandy 和爱犬 Harley 一起享受明尼苏达的户外时光,并演奏爵士钢琴。
立志成为数据科学家或初入行的从业者常会看到“函数”一词,但其含义并不总是清晰。
本文将带您了解什么是数学函数、它的输入与输出由哪些集合描述,以及连续值与离散值的区别。您将探索函数在技术中的用法、数据科学中的常见函数,以及它们如何被优化。过程中,您还会看到用于操作与绘图的 Python 代码。
如果您想练习在 Python 中编写并使用自己的函数,推荐学习我们的 Writing Functions in Python 课程。
数学中的函数是什么?
在数学中,函数将每个输入映射到唯一的输出。每个有效输入只能对应一个且仅一个输出。一个输入不可能对应多个输出。
例如,华氏 32 度等于摄氏 0 度。某个华氏温度对应某个摄氏温度;而且只对应一个值。您不可能让一个有效输入(华氏温度)得到两个不同的输出(摄氏温度)。
其他例子还有工资核算:您按小时计酬。如果您每小时 20 美元,工作 40 小时,就赚 20 x 40 = 800 美元。
并非所有规则都是函数。在某些情况下,让一个输入对应多个输出在逻辑上是合理的。例如,用姓名匹配一个人并不是函数。名字 “John Smith” 可能对应许多同名的人。
在数学中,规则通常被设置为每个有效输入只有一个输出。很多时候,这正是世界的运作方式(如工资核算)。在另一些情况下,之所以把问题表述为函数,是因为这样问题更易处理。模型会被设置为:每个输入不能有多个输出,从而避免输入输出的“意大利面条式”纠缠。
您可以把函数想象成一台“机器”,它接收一个输入(常记为 x),以某种方式处理后,输出一个结果(常记为 y)。
这里,一台机器从左侧传送带接收输入,进行处理,并在右侧产出一个愉快的绿色对勾。
多变量函数接收多个输入的集合,但只输出一个结果。您可以把这理解为传入一行包含若干变量或特征的数据,并映射到一个单一输出。
函数记号与术语
如何把等式写下来?在温度换算的例子中,我们可以把公式写作 y = f(x) = (5/9) (x - 32),其中 x 为华氏温度,y 为摄氏温度。要理解这个记号,请从左到右解析。
左边的 y 是输出。记号 f(x) 表示您在使用一个名为 f 的函数,它接收一个输入 x。注意在这里,f(x) 并不表示某个值 f 与另一个值 x 的乘积。
右边是公式。它说的是:取输入 x,减去 32,然后把结果乘以 5/9。
定义域、陪域与值域
假设您每天记录一次室外温度,并已收集了 k 个观测,记为(x1, x2, …, xk)。您希望有一个函数,在过去 n 天后返回当年迄今为止的平均气温。定义一个函数,它接收一个不超过 k 的正整数 n ,并返回前 n 个温度的平均值,这是一个实数。该函数的记号为 f: {1, 2, …, k} → ℝ.
为了描述函数中的这些集合,使用一些专门术语会很有帮助,即定义域、陪域和值域。
现在来看值域。考虑一个简单的二次函数:y = f(x) = x2。要指定定义域与陪域,写作 f: ℝ → ℝ.
现在您知道,这表示定义域(输入集合)与陪域(输出集合)都是实数。然而,稍作思考,您会意识到输出集合不可能是所有实数。
因为任意数的平方都不为负,所以实际能取到的输出集合不是全部实数,而是非负实数。用于描述这种情况的术语是值域。我们说该函数的值域是所有非负实数。
所谓陪域是潜在的输出集合;而值域是实际产生的输出集合。您选择陪域是为了反映您打算得到的输出类型,而值域则是经由函数实际产生的输出值集合。
连续与离散变量
这把我们引向连续变量与离散变量的区分:
例如,区间 [0, 1] 上的连续变量可以取 0、0.5、0.4141 或该范围内任意实数。连续变量常用于输出在理论上可为任意值的模型中,如回归。
然而,在二分类中,您只关心两个值:0 和 1。例如,一张图片要么包含猫,要么不包含。在多类分类问题中,您仍然只有有限多个取值,比如 0 表示狗,1 表示猫,2 表示马。
您要解决的问题决定了您感兴趣的函数类型。分类问题产生离散值;回归问题产生连续函数。
向量记号
有时您需要向函数传入多个变量。例如,您可能会将一行特征传入一个机器学习函数。在这种情况下,您可以把这些特征组合进一个容器再传入。将数据这样组合到一个容器的一种方式是使用向量。模型接收一个输入向量x = [x1, x2, x3],并输出一个目标 y。
在 Python 中,您通常使用 NumPy 数组来表示向量。
这段代码接收一个由 3、4 和 7.1 组成的向量,并返回其平均值。
对于一组向量,一个常用的方法是使用 pandas 库的 DataFrame 数据结构。
这段代码返回一个包含各行平均值的 pandas Series,每行一个数值。本例中为:
技术中的函数
函数这一概念在技术领域无处不在。出于实用考虑,请注意“函数”在技术中的定义并不总像数学那样严格。例如,编程函数可能有副作用,会改变除输出之外的变量值,而数学函数不会。
电子表格
函数在电子表格中被广泛使用,例如在Excel 公式中。您可能想要计算一列数字的和、均值或中位数。对于电子表格,函数遵循与先前介绍的数学定义相同的含义。
电子表格的一大强项(双关语)是条件函数:它们允许您使用诸如
IF()之类的函数构建更复杂的条件结构。例如,您可能想找出一年中支付给房贷公司的总额。为此,您很可能会使用电子表格的
SUM()函数。编程语言
函数在编程语言中也无处不在。根据不同编程语言,“函数”的定义可能比数学函数更加宽松。有些语言允许一个函数返回多个值,甚至不返回任何值。
例如,一个函数可能接收一些值并打印一句话,但不显式返回一个值。一个 Python 函数 看起来像这样:
这段代码输出:“My name is Mark and my favorite color is blue.” 函数并未显式返回数学意义上的值。
许多主流语言(如 Python)中的代码还可能在函数内产生其他副作用,比如改变全局变量的值。尽管副作用是可能且被允许的,但并不鼓励。副作用会使程序更难测试、调试和推理。
出于这些原因,一些“函数式”语言,例如 Scala 和 Haskell,更严格地围绕函数这一理念构建。
机器学习
在机器学习背景下,输入是特征,函数是模型,输出是模型的预测。此类模型常被称为“黑箱”,因为并不一定清楚输入特征是如何被处理以得到输出预测的,这也使得我们先前的“机器”比喻更加贴切:
在这幅图中,特征被送入模型这台“机器”,经由某种处理后输出一个预测。与更简单、确定性的函数(如温度换算)相比,机器内部发生的事情更难描述。
在机器学习中,定义域是特征向量;陪域可能是概率、类别或实值预测。
在深度学习领域,函数通常并不直接作用于一组输入,而是通过代价函数来评估模型的正确性。代价函数是度量模型在训练集上“错误程度”的指标。它把预测与真实标签或取值进行比较,并将误差汇总为一个数。
数据科学中的常见函数
在数据科学中,有些函数几乎无处不在。这些函数包括线性函数、对数函数与指数函数,以及用于深度学习的非线性激活函数。
线性函数
让我们从经典示例——线性函数——开始。
斜率
假设您很想吃苹果。您去一家超市,苹果按磅计价,每磅 0.75 美元。所以 1 磅苹果要 0.75 美元,2 磅要 2 x 0.75 = 1.50 美元,3 磅要 3 x 0.75 = 2.25 美元。每增加一磅,都会给总价增加一个固定金额。
用函数记号,您可以把公式写作 f(x) = 0.75 x。数字 0.75 是该线性函数的斜率。斜率表示输出相对于输入每增加一个单位时的变化率。
要绘制这样的函数,您可以使用类似如下的代码:
这类函数被称为线性函数。每当输入 x 增加一个单位,都会为输出 y 增加相同的固定量。顾名思义,将线性函数画出来就是一条直线。
截距
现在,假设您喜欢让超市配送。超市有 2.00 美元的固定配送费。此时,苹果的费用函数是 f(x) = 0.75 x + 2。与之前一样,0.75 是斜率。数字 2,即图像与 y 轴的交点,被称为“y 截距”。它是当输入为 0 时的输出值。
总费用等于苹果的花费加上配送费。一般地,一元线性函数可写为 f(x) = mx + b,其中 m 称为斜率,b 称为y 截距。
多元线性函数
您可能不只想吃苹果。假设您还想买些面包和花生酱。苹果每磅 0.75 美元,一条面包 2.50 美元,一罐花生酱 3.00 美元。现在,您的购物账单函数是:
这个函数依然被视为线性的,因为它对每个变量都是线性的。一般地,线性函数的形式为:
这相当于把各项数量分别乘以它们的权重(在此语境下,斜率的另一种说法)并相加,再加上截距。
用向量记号,该函数写作:
这里的 T 表示“转置”,这是进行 w 与 x 的向量乘法所必需的。
线性回归
考虑燃油效率与车速。您怀疑车速越快,燃油效率越低。您在 45 到 65 英里/小时之间收集了 50 个数据点,看到如下模式:
若把每个数据点连起来,会得到一条弯弯曲曲、难以阅读且无甚帮助的“模型”。但在这个范围内,数据的总体趋势近似线性。若把速度记为 x,这个图的函数是:
要找到这样一条最能拟合数据的直线,您会使用一种称为简单线性回归的数学过程。
您可以使用Matplotlib 和 Seaborn在 Python 中计算这样的直线:
线性回归也适用于多个变量。假设您想为速度(x)、车辆重量(y)和发动机排量(z)定义一个线性回归模型。对应 多元线性回归 的公式是:
此时,每个变量的系数代表该特征的权重或重要性,同时保持其他变量不变。
反函数
现在,让我们“反过来”思考买苹果的问题:如果您在苹果上花了 2.25 美元,您买了多少磅?答案是 2.25 / 0.75 = 3,所以您买了 3 磅。这种对函数的“反转”称为函数的反函数。在没有截距的例子中,反函数为:
注意,在这个记号中,“-1” 表示取函数的反函数,而非倒数。
需要注意的一点是,定义域可能会改变。例如,假设原函数是:
该函数在除 2 之外的所有实数上有定义,因为分母不能为 0。它的反函数是
出于同样的原因,反函数在除 0 之外的所有输入上有定义。
另一个要留意的问题是,得到的反式可能不是函数,因为它会对同一输入产生多个输出。考虑函数 y = x2。它的反向因此为:
如您从正负号可见,反式对一个输入有两个输出,因此除非我们限制定义域(例如令 x ≥ 0),否则它不是一个函数。
从图像上看,一个函数及其反函数(若存在)关于直线 y=x 对称。考虑函数 y = x3。该函数及其反函数的图像如下: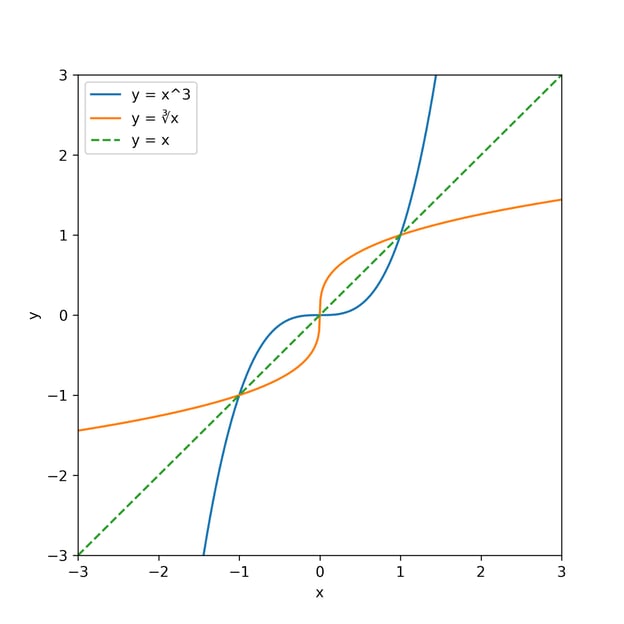
原函数(蓝色)有一个反函数(橙色),它是关于直线 y = x的镜像。