

Fonctions exponentielles et logarithmiques
Voyons deux types de fonctions étroitement liées : les fonctions exponentielles et logarithmiques.
Fonctions exponentielles
Supposons que vous déposiez 100 $ sur un compte d'épargne rémunéré à 10 % d'intérêt composés annuellement.
- À l'année 0 (avant qu'une année ne s'écoule), f(0) = 100 $.
- Après 1 an, f(1) = 100 $ x 1,10 = 110 $.
- Après 2 ans, f(2) = 110 $ x 1,10 = (100 $ x 1,10) x 1,10 = 100 $ x 1,102 = 121 $.
- Après 3 ans, f(3) = 121 $ x 1,10 = (100 $ x 1,10 x 1,10) x 1,10 = 100 $ x 1,103 = 133,10 $
- Après x ans, f(x) = 100 $ * 1,10x.
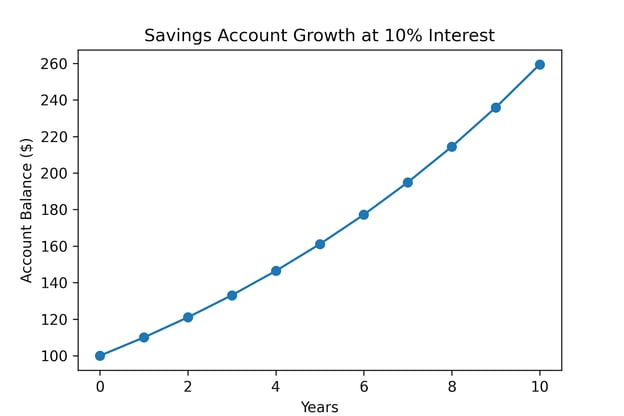
Ceci illustre une croissance exponentielle : chaque étape multiplie la précédente par un facteur fixe. La forme générale d'une croissance exponentielle est y = A bx, où y est la sortie, x l'entrée (souvent le temps), A le montant initial, et b le facteur de croissance par unité de x.
En data science, les modèles exponentiels apparaissent dans les processus de croissance composés tels que la croissance des utilisateurs ou du chiffre d'affaires, dans des modèles probabilistes, et bien d'autres cas.
Fonctions logarithmiques
Les fonctions logarithmiques posent la question inverse. Au lieu de demander le montant après x années, supposons que vous vouliez savoir combien de temps il faut laisser fructifier votre argent pour atteindre 200 $, avec un facteur de composition de 10 %.
- Posons l'équation : 200 = 100 * 1,10x
- Divisez chaque côté par 100 : 2 = 1 * 1,10x
Il faut maintenant déterminer combien de fois 1,10 doit être multiplié par lui‑même pour obtenir 2. C'est précisément ce à quoi répond le logarithme.
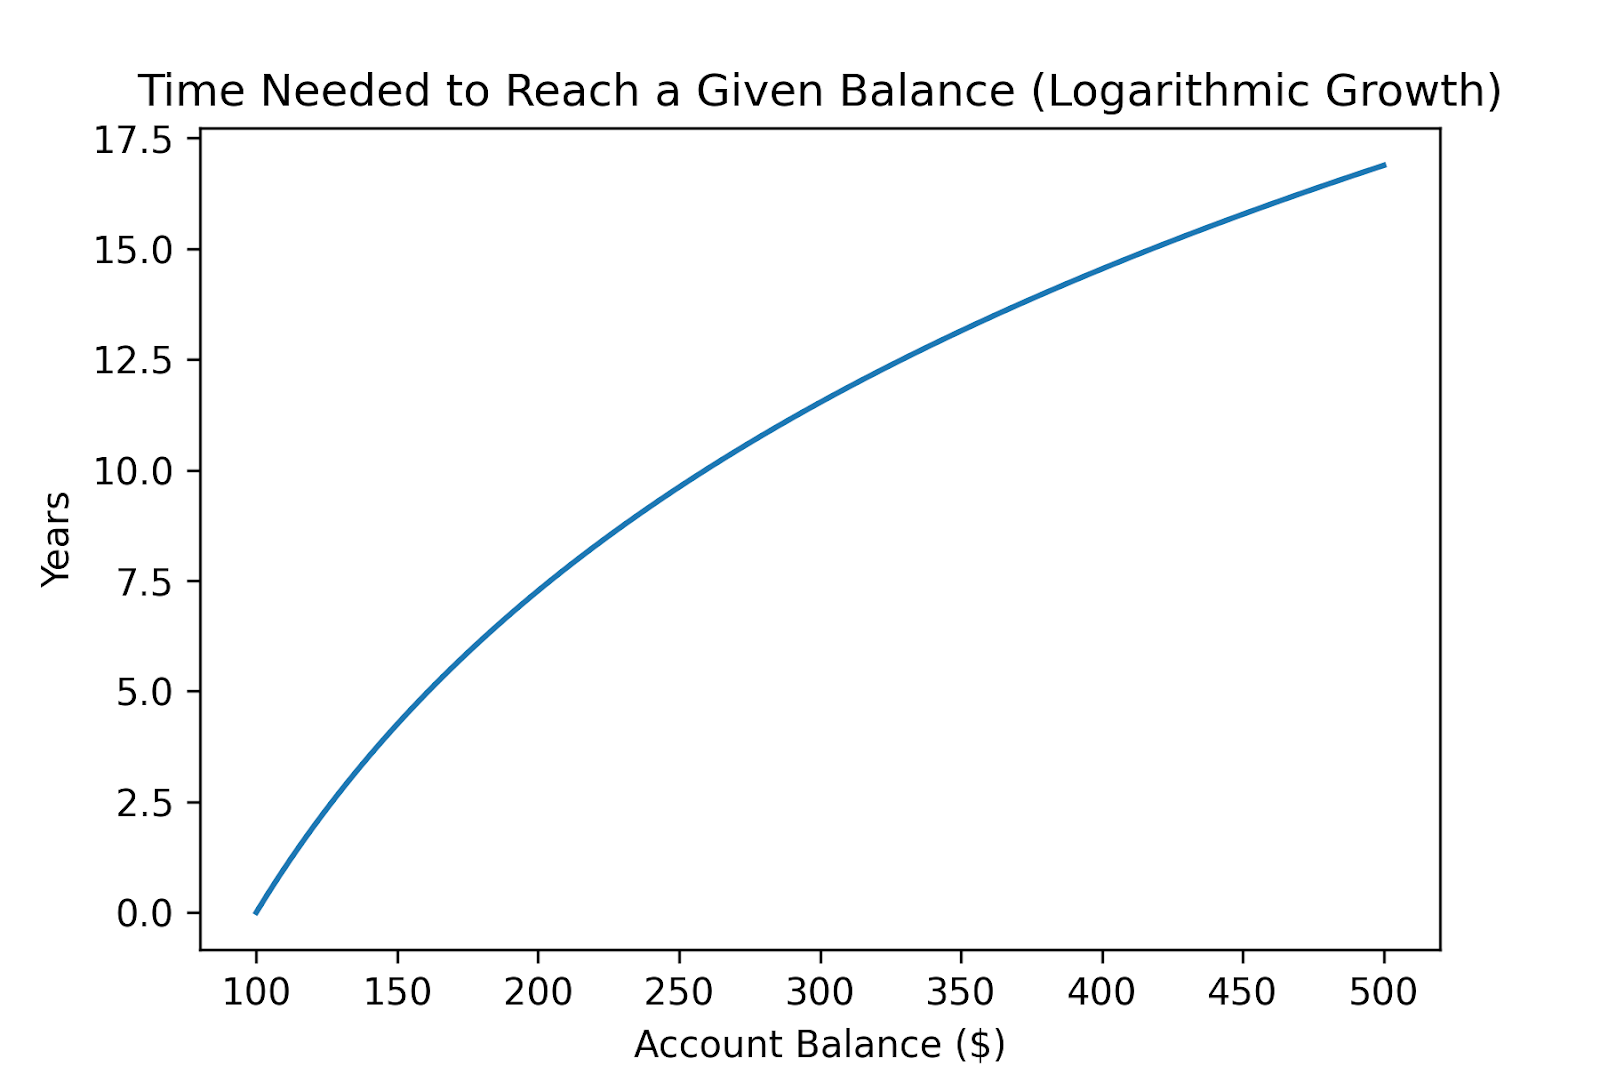
D'après le graphe, il faut un peu plus de 7 ans pour doubler la mise.
Comme nous l'avons vu, les fonctions logarithmiques sont l'inverse des fonctions exponentielles. Les modèles exponentiels posent des questions du type : après x mois, quel est le montant ? Les modèles logarithmiques demandent : étant donné un montant, combien de mois a‑t‑il fallu pour l'atteindre ?
Les data scientists utilisent souvent les logarithmes pour rendre une distribution asymétrique plus gérable. Par exemple, les revenus sont généralement très asymétriques à droite : quelques très hauts revenus étirent la queue supérieure, tandis que la majorité se concentre en bas.
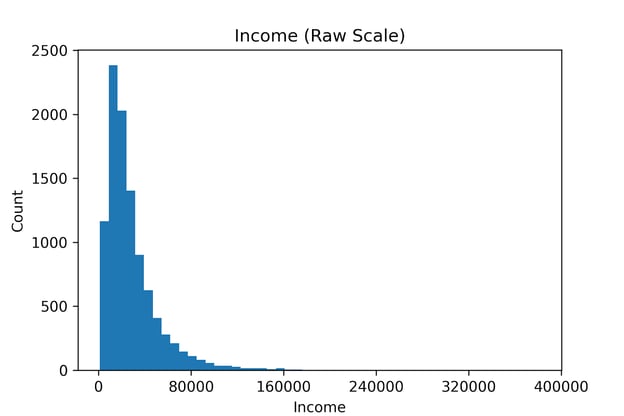
Vous pouvez transformer les données en prenant le logarithme de chaque valeur :
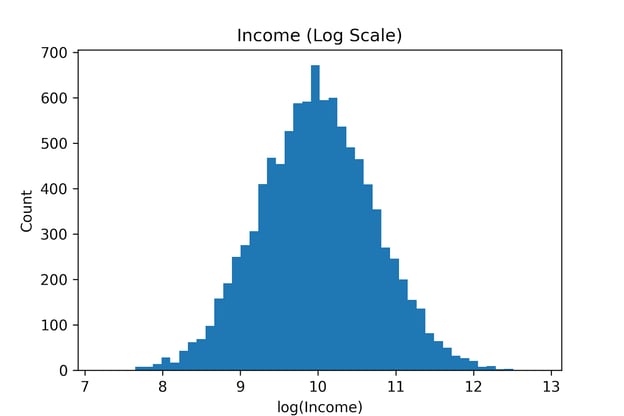
Les revenus élevés sont compressés tandis que les autres sont étalés. La transformation logarithmique fait passer la question des différences absolues aux différences relatives. Résultat : la longue queue de droite s'effondre et la distribution devient souvent approximativement normale. La variance est plus stable, et l'on peut appliquer une régression linéaire.
Le logarithme joue un rôle central dans l'une des fonctions de perte les plus utilisées en classification binaire, dite perte par entropie croisée ou log loss, définie pour un échantillon comme :
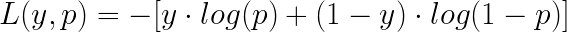
Ici, la variable binaire y (0 ou 1) est la vraie valeur pour un échantillon, et p est la probabilité prédite que y soit de classe 1.
- Si y vaut 1, la perte est -log(p), qui vous pénalise d'autant plus que p est proche de 0.
- Si y vaut 0, la perte est -log(1-p), qui vous pénalise d'autant plus que p est proche de 1.
Le log loss pénalise fortement les prédictions très confiantes mais erronées. Prédire une probabilité proche de 0 quand la vraie étiquette vaut 1 (ou l'inverse) entraîne une forte pénalité, tandis que des prédictions incertaines sont moins sanctionnées. Cela rend le log loss particulièrement adapté à l'entraînement de classificateurs probabilistes tels que la régression logistique.
Fonctions d'activation non linéaires
Les fonctions d'activation sont utilisées dans les réseaux de neurones pour garantir la non‑linéarité de la sortie de chaque couche. Les plus courantes sont la sigmoïde et la ReLU.
Fonction sigmoïde
La fonction sigmoïde est une fonction lisse en forme de S, définie par la formule suivante :
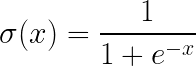
Elle accepte tout nombre réel en entrée et produit une valeur strictement comprise entre 0 et 1. Elle sert à convertir des scores bruts en probabilités.
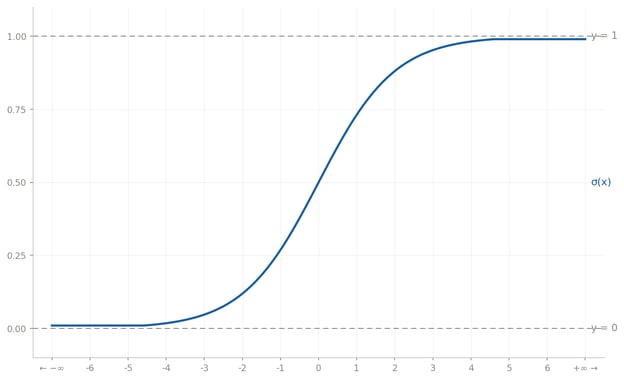
Un cas d'usage courant de la sigmoïde est la régression logistique pour la classification binaire. La régression logistique calcule une combinaison linéaire des entrées pour produire un score, ensuite converti en probabilité via la sigmoïde. Les probabilités au‑dessus d'un seuil (généralement 0,5) sont classées 1, celles en‑dessous 0.
Pour aller plus loin, consultez nos tutoriels Python Logistic Regression et Logistic Regression in R.
ReLU (rectified linear unit)
La fonction Rectified Linear Unit (ReLU) convertit les nombres négatifs en 0 et laisse les nombres positifs inchangés. Elle est définie ainsi :
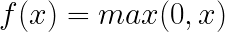
Pour les valeurs supérieures à 0, elle se confond avec l'identité, comme le montre son graphe :
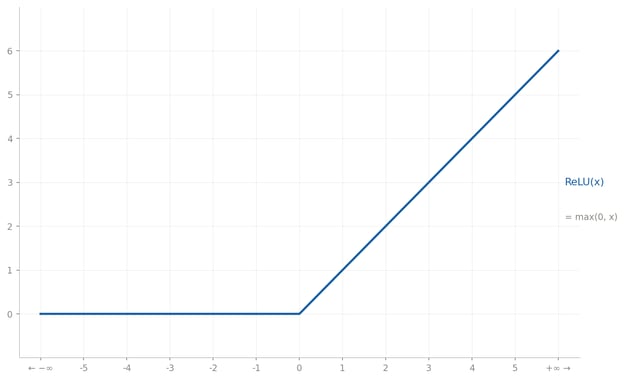
Comme la sigmoïde, elle sert de fonction d'activation non linéaire dans les couches cachées d'un réseau de neurones. Cependant, elle est computationnellement simple, ne nécessitant qu'une opération de maximum, alors que la sigmoïde requiert un appel exponentiel coûteux.
Parce qu'une ReLU fixe toutes les valeurs négatives à 0, elle induit de la parcimonie dans le réseau, où de nombreux neurones sont annulés. Cela peut réduire le bruit et mener à des représentations plus efficientes.
Arbres de décision comme fonctions par morceaux
Autre forme de fonctions non linéaires : les arbres de décision, qui partitionnent récursivement l'espace d'entrée en régions plus petites en scindant selon des caractéristiques et des seuils jusqu'à un critère d'arrêt.
Chaque feuille se voit assigner une valeur de prédiction. Un arbre de décision peut ainsi être vu comme une fonction par morceaux, où chaque région du domaine est associée à une valeur de prédiction constante. En juxtaposant de nombreuses règles locales, les arbres capturent des schémas complexes.
Par exemple, voici comment une région bidimensionnelle peut être partitionnée :
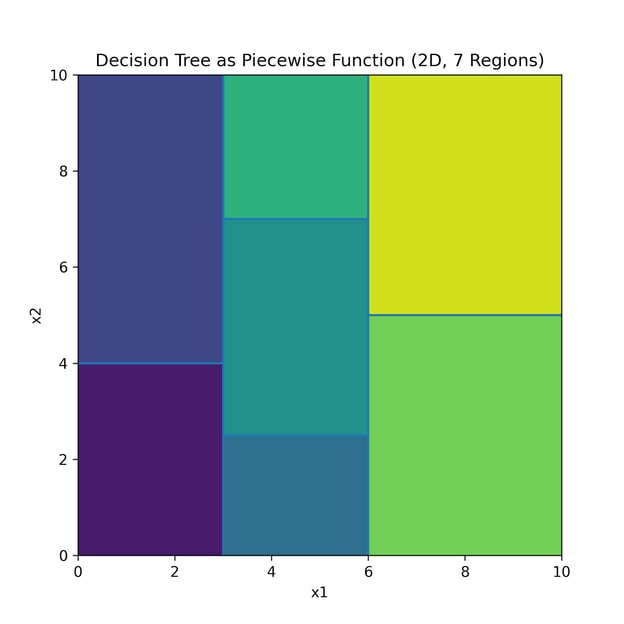
Cette carte de chaleur correspond aux régions suivantes :
|
Région |
Partie du domaine |
Valeur de la fonction |
|
1 |
x1 < 3 et x2 < 4 |
1 |
|
2 |
x1 < 3 et x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 et x2 < 2,5 |
3 |
|
4 |
3 ≤ x1 < 6 et 2,5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 et x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 et x2 < 5 |
6 |
|
7 |
x1 ≥ 6 et x2 ≥ 5 |
7 |
Optimisation de fonctions
L'optimisation de fonctions consiste à trouver les entrées qui maximisent ou minimisent une fonction. Par exemple, maximiser une fonction de profit ou minimiser une fonction d'erreur. L'étude de l'optimisation, dite "recherche opérationnelle", constitue un vaste corpus théorique en constante évolution.
L'optimisation est étroitement liée aux "extréma" locaux et globaux (points de maximum ou minimum). Un "minimum local" est un minimum dans une zone donnée, et un "minimum global" est le minimum de la fonction sur tout son domaine.
Par exemple, considérez la fonction f(x) = x4 - 3x2 + x.
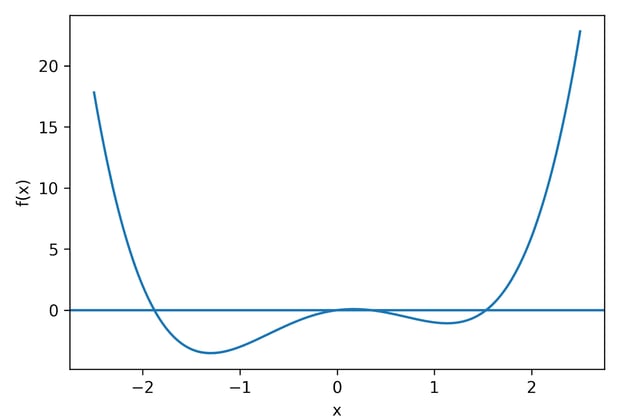
Elle possède deux minima locaux : l'un pour x environ -1,30 et un autre pour x environ 1,13. La valeur de y étant plus basse à x = -1,30, c'est le minimum global de la fonction.
Pour des tâches simples, comme trouver le meilleur prix pour maximiser le profit dans un modèle à une variable, il suffit de dériver la fonction, d'égaliser à zéro, puis de résoudre pour x. Pour entraîner des réseaux de neurones profonds, ce n'est pas aussi simple, mais l'idée est similaire.
La méthode d'optimisation la plus importante pour le Deep Learning est la descente de gradient. Le gradient est la généralisation multidimensionnelle de la pente ; il indique comment la perte varie par rapport à chaque paramètre.
Le principe : se déplacer de manière itérative dans la direction où la fonction décroît le plus vite. À chaque étape, on utilise le gradient pour choisir la direction et une taille de pas pour la distance. Au fil des itérations, on converge vers un minimum local.
Conclusion
Les fonctions sont omniprésentes en mathématiques, en programmation et en data science. L'"apprentissage" en machine learning consiste à trouver la meilleure fonction (et ses paramètres) pour faire correspondre entrées et sorties. Maintenant que vous maîtrisez les fonctions, implémentez‑en en Python ou dans votre langage favori !
Pour voir comment ces idées s'intègrent à des workflows ML concrets, poursuivez avec le cours Understanding Machine Learning.
Foire aux questions sur les fonctions mathématiques
Qu'est-ce qu'une fonction en mathématiques ?
Une fonction mathématique est une règle qui associe à chaque entrée exactement une sortie.
Pourquoi une fonction mathématique n'a-t-elle qu'une seule sortie ?
Sinon, par définition, la règle ne serait pas une fonction, car elle serait ambiguë.
Les fonctions en programmation sont-elles les mêmes que les fonctions mathématiques ?
Pas exactement. Les fonctions en programmation peuvent avoir des effets de bord ou même ne renvoyer aucune valeur utile, ce qui n'est pas autorisé pour les fonctions mathématiques.
Pourquoi les fonctions sont-elles importantes en data science ?
Parce que les modèles sont des fonctions. Ils associent des caractéristiques à des prédictions, des probabilités ou des scores.
Quels sont le domaine et le codomaine d'une fonction ?
Le domaine est l'ensemble des entrées valides. Le codomaine est l'ensemble des sorties visées.

Mark Pedigo, PhD, est un éminent scientifique des données, spécialisé dans la science des données de santé, la programmation et l'éducation. Titulaire d'un doctorat en mathématiques, d'une licence en informatique et d'un certificat professionnel en intelligence artificielle, Mark allie connaissances techniques et résolution de problèmes pratiques. Au cours de sa carrière, il a joué un rôle dans la détection des fraudes, la prédiction de la mortalité infantile et les prévisions financières, et a contribué au logiciel d'estimation des coûts de la NASA. En tant qu'éducateur, il a enseigné à DataCamp et à l'université Washington de St. Louis et a encadré des programmeurs juniors. Pendant son temps libre, Mark profite de la nature du Minnesota avec sa femme Mandy et son chien Harley, et joue du piano jazz.




Les data scientists débutants voient souvent le terme "fonction", sans que sa signification soit toujours limpide.
Dans cet article, vous allez découvrir ce qu'est une fonction mathématique, quels ensembles décrivent ses valeurs d'entrée et de sortie, et la différence entre valeurs continues et discrètes. Vous verrez comment les fonctions sont utilisées en technologie, les fonctions courantes en data science et comment on les optimise. Au fil du texte, vous trouverez du code Python pour manipuler et tracer des fonctions.
Si vous souhaitez vous exercer à écrire et utiliser vos propres fonctions en Python, nous vous recommandons le cours Writing Functions in Python.
Qu'est-ce qu'une fonction en mathématiques ?
En mathématiques, une fonction associe à chaque entrée une unique sortie. Chaque entrée valide est envoyée vers une et une seule sortie. Une même entrée ne peut pas avoir plusieurs sorties.
Par exemple, 32 degrés Fahrenheit correspondent à 0 degré Celsius. La valeur en Fahrenheit correspond à une valeur en Celsius, et à une seule. Vous ne pouvez pas avoir deux valeurs de sortie (Celsius) différentes pour une même entrée valide (Fahrenheit).
Autre exemple : la paie, où vous êtes rémunéré·e à l'heure. Si vous gagnez 20 $ de l'heure et travaillez 40 heures, vous touchez 20 x 40 = 800 $.
Toutes les règles ne sont pas des fonctions. Il arrive qu'il soit logique d'avoir plusieurs sorties pour une seule entrée. Par exemple, associer un nom à une personne n'est pas une fonction : le nom "John Smith" peut désigner plusieurs personnes portant ce nom.
En mathématiques, on formule souvent les règles de manière à n'avoir qu'une sortie par entrée valide. Parfois, c'est tout simplement ainsi que le monde fonctionne (la paie). D'autres fois, on reformule les problèmes en termes de fonctions pour les rendre traitables : plutôt qu'un écheveau d'entrées et de sorties, on impose que chaque entrée n'ait pas plusieurs sorties.
Vous pouvez voir une fonction comme une "machine" qui accepte une entrée (souvent notée x), la traite d'une certaine manière, et produit une sortie (souvent notée y).
Ici, une machine reçoit une entrée par le tapis roulant à gauche, la traite, puis produit à droite une coche verte réjouie.
Multivariées, les fonctions acceptent plusieurs entrées mais ne renvoient qu'une seule sortie. Vous pouvez les voir comme une ligne de données composée de plusieurs variables (ou caractéristiques) mappée vers une sortie unique.
Notation et terminologie des fonctions
Comment écrire l'équation ? Dans l'exemple de conversion de température, on peut écrire la formule y = f(x) = (5/9) (x - 32), avec x la température en Fahrenheit et y en Celsius. Pour comprendre cette notation, lisez-la de gauche à droite.
À gauche, vous voyez y, la sortie. La notation f(x) indique que vous utilisez une fonction, appelée f, qui prend en entrée x. Notez que dans ce contexte, f(x) ne signifie pas f multiplié par x.
À droite se trouve la formule : prenez l'entrée x, soustrayez 32, puis multipliez le résultat par 5/9.
Domaine, codomaine et image
Supposons que vous releviez la température extérieure une fois par jour et que vous ayez collecté k mesures, notées (x1, x2, …, xk). Vous souhaitez une fonction qui renvoie la température moyenne depuis le début de l'année après n jours. Définissez une fonction qui prend un entier positif n inférieur ou égal à k et renvoie la moyenne des n premières températures, qui est un nombre réel. La notation pour une telle fonction est f: {1, 2, …, k} → ℝ.
Il est utile de disposer d'un jargon pour décrire les ensembles liés à la fonction : d'où les notions de domaine, codomaine et image.
Regardons maintenant l'image. Prenez une fonction quadratique simple : y = f(x) = x2. Pour préciser le domaine et le codomaine, on écrit f: ℝ → ℝ.
Vous savez désormais que cela signifie que le domaine (ensemble des entrées) comme le codomaine (ensemble des sorties) sont des nombres réels. Toutefois, en y réfléchissant, vous noterez que l'ensemble des sorties ne peut pas être tous les réels.
Puisque tout nombre au carré est non négatif, l'ensemble des sorties effectivement obtenues n'est pas l'ensemble des réels, mais seulement les réels non négatifs. Le terme pour décrire cette situation est image (range). On dit que l'image de cette fonction est l'ensemble des réels non négatifs.
Le codomaine est l'ensemble des sorties potentielles ; l'image est l'ensemble des sorties effectivement réalisées. Vous choisissez le codomaine selon le type de sortie visé, tandis que vous découvrez l'image, c'est-à-dire les valeurs réellement obtenues.
Variables continues et discrètes
Cela nous amène à la distinction entre variables continues et discrètes :
Par exemple, une variable continue dans [0, 1] peut valoir 0, 0,5, 0,4141, ou tout autre réel de l'intervalle. Les variables continues sont courantes lorsque la sortie peut théoriquement prendre n'importe quelle valeur, comme en régression.
En revanche, en classification binaire, seules deux valeurs comptent : 0 et 1. Par exemple, une image contient un chat ou non. En classification multiclasse, vous n'avez toujours qu'un nombre fini de valeurs, par exemple 0 pour un chien, 1 pour un chat, 2 pour un cheval.
Le problème à résoudre dicte le type de fonction qui vous intéresse. Les problèmes de classification produisent des valeurs discrètes ; les problèmes de régression produisent des fonctions continues.
Notation vectorielle
Parfois, vous devez passer plusieurs variables à une fonction. Par exemple, vous pouvez fournir une ligne de caractéristiques à un modèle de machine learning. Dans ce cas, vous pouvez regrouper les caractéristiques dans un conteneur et le passer en entrée. Une manière de regrouper des données ainsi est d'utiliser un vecteur. Le modèle prend un vecteur d'entrée x = [x1, x2, x3] et renvoie une cible y.
En Python, on utilise généralement un tableau NumPy pour représenter un vecteur.
Ce code prend un vecteur composé des nombres 3, 4 et 7,1 et renvoie leur moyenne.
Pour une collection de vecteurs, une méthode populaire consiste à utiliser la structure de données DataFrame de la bibliothèque pandas.
Ce code renvoie une Series pandas contenant les moyennes par ligne, une valeur par ligne. Dans ce cas :
Les fonctions en technologie
La notion de fonction est omniprésente en technologie. D'un point de vue pratique, retenez que "fonction" n'est pas toujours définie aussi rigoureusement en technologie qu'en mathématiques. Par exemple, les fonctions en programmation peuvent avoir des effets de bord qui modifient des variables autres que la sortie, ce qui n'existe pas en mathématiques.
Tableurs
Les fonctions sont largement utilisées dans les tableurs, par exemple via les formules Excel. Vous pouvez vouloir calculer la somme, la moyenne ou la médiane d'une colonne de nombres. Dans les tableurs, les fonctions suivent la même définition que celle introduite en mathématiques.
L'un des points forts des tableurs (jeu de mots assumé) est les fonctions conditionnelles : elles permettent de construire des structures conditionnelles plus complexes via des fonctions comme
IF().Par exemple, vous pouvez vouloir totaliser les paiements effectués à votre organisme de prêt immobilier sur une année. Pour cela, vous utiliserez probablement la fonction
SUM()de votre tableur.Langages de programmation
Les fonctions sont omniprésentes dans les langages de programmation. Selon le langage, la définition de "fonction" peut être plus souple qu'en mathématiques. Certains langages permettent à une fonction de renvoyer plusieurs valeurs, ou aucune valeur explicite.
Par exemple, une fonction peut prendre des valeurs et afficher un message, sans renvoyer explicitement de valeur. Une fonction Python ressemble à ceci :
Ce code produit la sortie : "My name is Mark and my favorite color is blue." Aucune valeur mathématique n'est explicitement renvoyée par la fonction.
Dans de nombreux langages courants comme Python, le code peut également avoir d'autres effets de bord dans une fonction, comme la modification d'une variable globale. Même si ces effets sont possibles et autorisés, ils sont déconseillés : ils rendent les programmes plus difficiles à tester, déboguer et raisonner.
Pour ces raisons, certains langages "fonctionnels", tels que Scala et Haskell, s'appuient plus rigoureusement sur l'idée de fonction.
Apprentissage automatique
En Machine Learning, les entrées sont les caractéristiques, la fonction est le modèle, et la sortie est la prédiction du modèle. Un tel modèle est souvent décrit comme une "boîte noire" car il n'est pas nécessairement clair comment les caractéristiques d'entrée sont traitées pour produire la prédiction, d'où la pertinence de notre métaphore de la "machine" :
Dans cette illustration, les caractéristiques sont injectées dans la "machine" modèle, qui les traite d'une certaine manière et produit une prédiction. Comparé à des fonctions déterministes plus simples comme la conversion de température, ce qui se passe à l'intérieur est plus difficile à décrire.
En ML, le domaine est l'ensemble des vecteurs de caractéristiques ; le codomaine peut être des probabilités, des classes ou des prédictions réelles.
En Deep Learning, les fonctions ne s'appliquent généralement pas directement à un ensemble d'entrées ; on évalue plutôt la justesse du modèle à l'aide d'une fonction de coût. Une fonction de coût est une mesure de l'erreur du modèle sur l'ensemble d'entraînement. Elle compare les prédictions aux vraies étiquettes ou valeurs et agrège les erreurs en un seul nombre.
Fonctions courantes en data science
Certaines fonctions reviennent presque partout en data science : fonctions linéaires, logarithmiques et exponentielles, ainsi que des fonctions d'activation non linéaires pour le deep learning.
Fonctions linéaires
Commençons par l'exemple classique : les fonctions linéaires.
Pente
Supposons que vous ayez envie de pommes. Vous allez dans une épicerie qui vend les pommes à 0,75 $ la livre. Une livre coûte donc 0,75 $, 2 livres coûtent 2 x 0,75 $ = 1,50 $, et 3 livres 3 x 0,75 $ = 2,25 $. Chaque livre achetée ajoute un montant fixe au coût total.
En notation fonctionnelle, vous pouvez écrire la formule f(x) = 0,75 x. Le nombre 0,75 est la pente de la fonction linéaire. La pente est le taux de variation de la sortie pour une unité de variation de l'entrée.
Pour tracer une telle fonction, vous pouvez utiliser un code similaire au suivant :
On parle de fonctions linéaires. Chaque augmentation de l'entrée x contribue d'un montant fixe à la sortie y. Comme son nom l'indique, la représentation graphique d'une fonction linéaire est une droite.
Ordonnée à l'origine
Supposons maintenant que vous souhaitiez être livré·e. L'épicerie facture des frais de livraison fixes de 2,00 $. La fonction pour vos pommes devient alors f(x) = 0,75 x + 2. Comme précédemment, 0,75 est la pente. Le nombre 2, point d'intersection avec l'axe des ordonnées, est l'"ordonnée à l'origine" : la valeur de sortie lorsque l'entrée est 0.
Le coût total est la somme du prix des pommes et des frais de livraison. En général, une fonction linéaire univariée s'écrit f(x) = mx + b, où m est la pente et b l'ordonnée à l'origine.
Fonction linéaire multivariée
Vous ne mangerez sans doute pas que des pommes. Supposons que vous achetiez aussi du pain et du beurre de cacahuète. Les pommes coûtent 0,75 $ la livre, une miche de pain coûte 2,50 $, et un pot de beurre de cacahuète 3,00 $. Votre fonction de panier de courses devient :
Cette fonction est toujours linéaire car elle l'est dans chacune des variables. En général, une fonction linéaire prend la forme :
Cela revient à additionner chacune de vos quantités multipliée par son poids (autre terme pour pente dans ce contexte), plus l'ordonnée à l'origine.
En notation vectorielle, cette fonction s'écrit :
Le T indique la "transposée", nécessaire pour effectuer la multiplication vectorielle de w et x.
Régression linéaire
Considérons le lien entre consommation de carburant et vitesse. Vous soupçonnez qu'en roulant plus vite, l'efficacité diminue. Vous collectez cinquante points de données entre 45 et 65 miles par heure et observez le schéma suivant :
Relier chaque point donnerait un tracé sinueux, illisible et peu utile. Mais la tendance générale est approximativement linéaire sur cet intervalle. Si l'on appelle x la vitesse, la fonction pour ce graphe est :
Pour trouver une droite qui s'ajuste au mieux aux données, on utilise un procédé mathématique appelé régression linéaire simple.
Vous pouvez calculer une telle droite en Python à l'aide de Matplotlib et Seaborn :
La régression linéaire fonctionne avec plusieurs variables. Supposons que vous vouliez définir un modèle de régression linéaire pour la vitesse (x), le poids du véhicule (y) et la cylindrée (z). La formule résultante pour la régression linéaire multivariée est :
Dans ce cas, le coefficient de chaque variable représente le poids ou l'importance de cette caractéristique, les autres variables étant maintenues constantes.
Fonctions réciproques (inverses)
Inversions de perspective : si vous avez dépensé 2,25 $ en pommes, combien de livres avez-vous achetées ? La réponse est 2,25 / 0,75 = 3, donc trois livres. Ce type de "renversement" d'une fonction est appelé inverse de la fonction. Dans l'exemple sans ordonnée à l'origine, l'inverse est :
Notez que dans cette notation, le "-1" indique l'inverse d'une fonction, et non un réciproque.
Attention : le domaine peut changer. Supposons, par exemple, que votre fonction initiale soit :
Cette fonction est définie pour tous les réels sauf 2, car le dénominateur ne peut pas être nul. L'inverse de cette fonction est
Pour la même raison, la fonction réciproque est définie pour toutes les entrées sauf 0.
Autre écueil : l'inverse obtenu peut ne pas être une fonction, car il aurait plusieurs sorties pour une seule entrée. Prenez la fonction y = x2. Son renversement serait :
Comme le montre le signe plus/moins, l'inverse a deux sorties pour une entrée, ce n'est donc pas une fonction sauf à restreindre le domaine (par exemple à x ≥ 0)
Graphiquement, une fonction et son inverse (s'il existe) sont des images miroir par rapport à la droite y = x. Prenez la fonction y = x3. Le graphe de cette fonction et de son inverse est :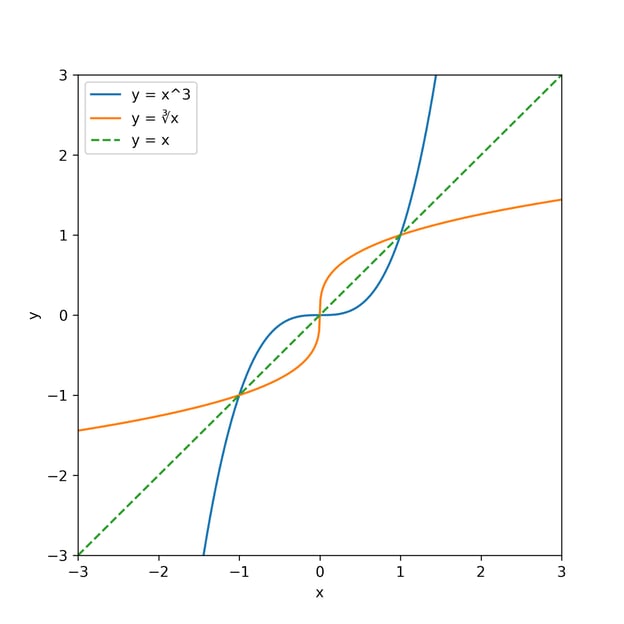
La fonction d'origine (en bleu) a un inverse (en orange) réfléchi par rapport à la droite y = x.