

Hàm mũ và hàm lôgarit
Hãy xem hai loại hàm có liên hệ chặt chẽ: hàm mũ và hàm lôgarit.
Hàm mũ
Giả sử bạn gửi $100 vào tài khoản tiết kiệm trả lãi 10%, ghép lãi hằng năm.
- Năm 0 (trước khi qua một năm), f(0) = $100.
- Sau năm 1, f(1) = $100 x 1.10 = $110.
- Sau năm 2, f(2) = $110 x 1.10 = ($100 x 1.10) x 1.10 = $100 x 1.102 = $121.
- Sau năm 3, f(3) = $121 x 1.10 = ($100 x 1.10 x 1.10) x 1.10 = $100 x 1.103 = $133.10
- Sau năm x, f(x) = $100 * 1.10x.
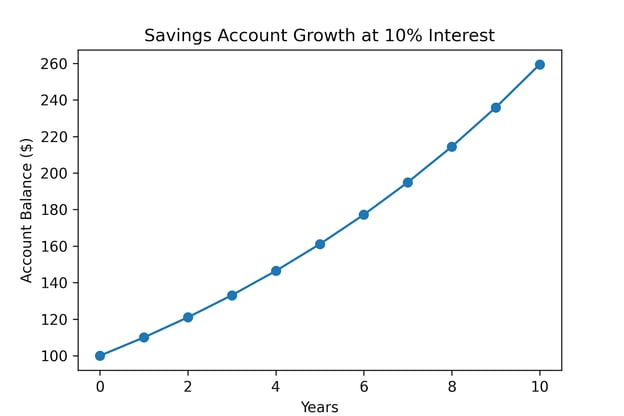
Đây là ví dụ về tăng trưởng mũ. Mỗi bước nhân với một lượng cố định so với bước trước. Hàm tổng quát cho tăng trưởng mũ là y = A bx, trong đó y là đầu ra, x là đầu vào (thường là thời gian), A là lượng ban đầu, và b là hệ số tăng trưởng theo mỗi đơn vị x.
Trong khoa học dữ liệu, mô hình mũ xuất hiện trong các quá trình tăng trưởng ghép lãi như tăng trưởng người dùng hoặc doanh thu, trong các mô hình xác suất, và nhiều ứng dụng khác.
Hàm lôgarit
Hàm lôgarit đảo ngược câu hỏi này. Giờ thay vì hỏi lượng tiền sau x thời gian, giả sử bạn muốn biết cần để tiền bao lâu để đạt $200, nếu giả định hệ số ghép lãi 10%.
- Thiết lập phương trình: 200 = 100 * 1.10x
- Chia hai vế cho 100: 2 = 1 * 1.10x
Giờ ta cần biết 1.10 được nhân với chính nó bao nhiêu lần để được 2. Đây là câu hỏi lôgarit trả lời.
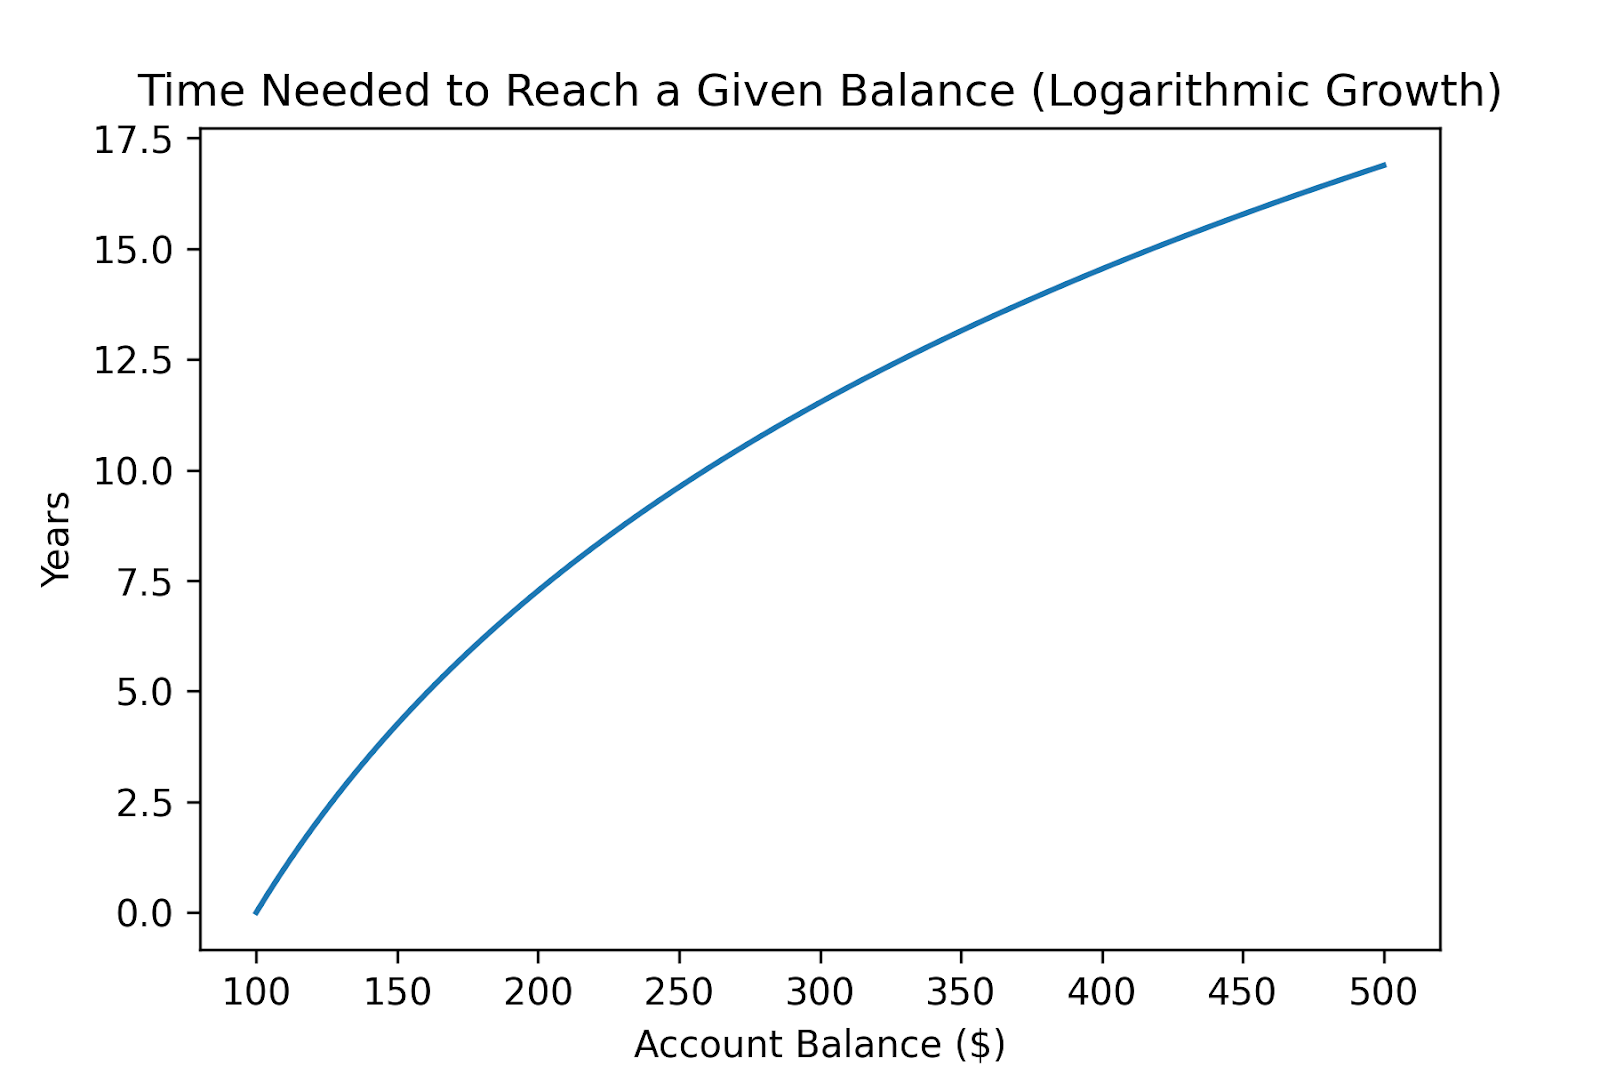
Nhìn vào đồ thị, ta thấy sẽ mất hơn 7 năm một chút để tiền của chúng ta tăng gấp đôi.
Như ta đã thấy, hàm lôgarit là nghịch đảo của hàm mũ. Mô hình mũ hỏi các câu như: sau x tháng, tốc độ tăng là bao nhiêu? Mô hình lôgarit hỏi: với một tốc độ tăng trưởng đã cho, mất bao nhiêu tháng để đạt tới đó?
Các nhà khoa học dữ liệu thường dùng lôgarit để làm cho một phân phối lệch dễ xử lý hơn. Ví dụ, phân phối thu nhập thường lệch phải rất mạnh: một số ít người thu nhập cao kéo dài đuôi phải của phân phối, trong khi đa số tập trung ở đầu thấp.
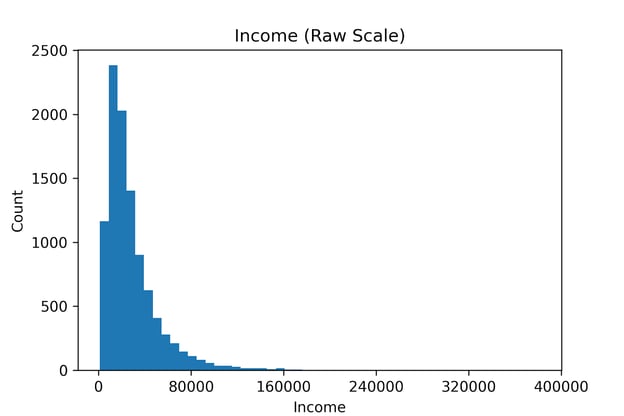
Bạn có thể biến đổi dữ liệu bằng cách lấy lôgarit của từng điểm dữ liệu:
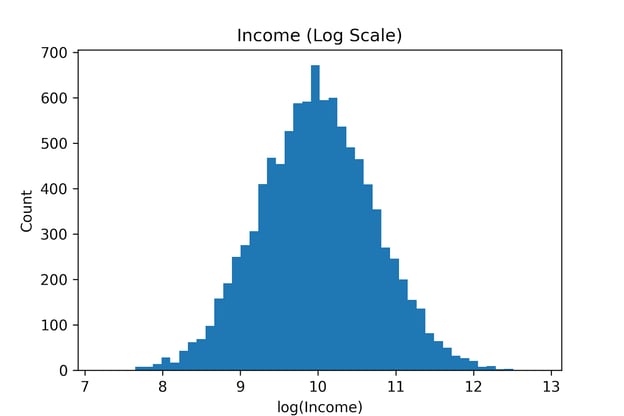
Các mức thu nhập lớn bị nén lại trong khi các mức khác được giãn ra. Biến đổi log chuyển câu hỏi từ chênh lệch tuyệt đối sang chênh lệch tương đối. Kết quả là đuôi phải dài co lại, và phân phối thường trở nên xấp xỉ chuẩn. Lúc này, phương sai ổn định hơn, và ta có thể áp dụng hồi quy tuyến tính.
Lôgarit đóng vai trò trung tâm trong một trong những hàm mất mát được dùng phổ biến nhất trong phân loại nhị phân, được gọi là Hàm mất mát Cross-Entropy hay log loss, được định nghĩa cho một mẫu đơn lẻ như sau:
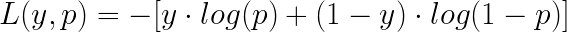
Ở đây, biến nhị phân y (0 hoặc 1) là giá trị thật cho một mẫu, và p là xác suất dự đoán rằng y là lớp 1.
- Nếu y là 1, mất mát là -log(p), phạt nặng hơn khi p càng gần 0.
- Nếu y là 0, mất mát là -log(1-p), phạt nặng hơn khi p càng gần 1.
Log loss phạt rất nặng các dự đoán tự tin nhưng sai. Dự đoán xác suất gần 0 khi nhãn thật là 1 (hoặc ngược lại) dẫn tới mức phạt lớn, trong khi dự đoán không chắc chắn sẽ chịu phạt nhỏ hơn. Điều này khiến log loss phù hợp để huấn luyện các bộ phân loại xác suất như Hồi quy Logistic.
Các hàm kích hoạt phi tuyến
Các hàm kích hoạt được dùng trong mạng nơ-ron để đảm bảo đầu ra của mỗi tầng là phi tuyến. Các hàm kích hoạt phổ biến là sigmoid và ReLU.
Hàm sigmoid
Hàm Sigmoid là một hàm mịn, hình chữ S, được định nghĩa bởi công thức sau:
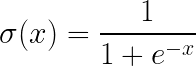
Nó nhận bất kỳ số thực nào làm đầu vào và cho ra một giá trị nằm giữa 0 và 1. Nó được dùng để chuyển điểm số thô thành xác suất.
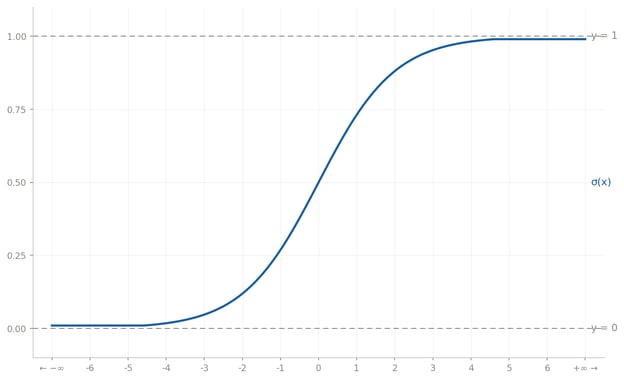
Một trường hợp sử dụng phổ biến của hàm sigmoid là trong hồi quy logistic cho phân loại nhị phân. Hồi quy logistic tính một tổ hợp tuyến tính của các đầu vào để tạo ra một điểm số. Điểm số đó sau đó được chuyển thành xác suất bằng hàm sigmoid. Các xác suất trên một ngưỡng (thường là 0.5) được phân loại là 1, và những giá trị dưới ngưỡng được phân loại là 0.
Để tìm hiểu thêm, hãy tham khảo các hướng dẫn Python Logistic Regression và Logistic Regression in R của chúng tôi.
ReLU (đơn vị tuyến tính chỉnh lưu)
Hàm Rectified Linear Unit (ReLU) chuyển các số âm thành 0 và giữ nguyên các số dương. Nó được định nghĩa như sau:
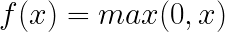
Với các giá trị lớn hơn 0, nó giống hệt hàm đồng nhất, như bạn có thể thấy từ đồ thị của nó:
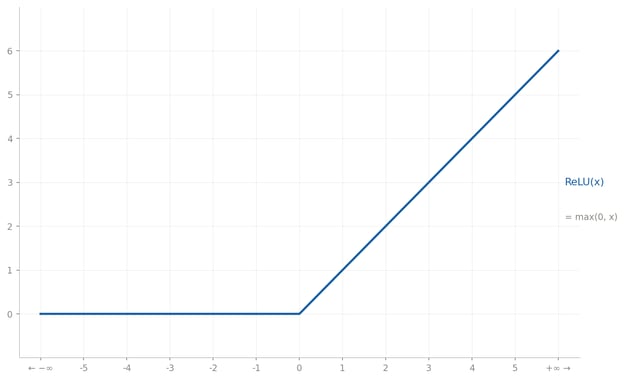
Giống như hàm sigmoid, nó đóng vai trò là hàm kích hoạt phi tuyến trong các tầng ẩn của một Mạng nơ-ron. Tuy nhiên, nó đơn giản về tính toán, chỉ cần một phép lấy cực đại, trong khi sigmoid cần một lời gọi hàm mũ tốn kém.
Vì ReLU đặt tất cả giá trị âm về 0, nó tạo ra tính thưa trong mạng, nơi nhiều nơ-ron bị đưa về 0. Điều này có thể giảm nhiễu và dẫn tới các biểu diễn hiệu quả hơn.
Cây quyết định như các hàm từng phần
Một dạng hàm phi tuyến khác có thể thấy ở cây quyết định, vốn phân hoạch đệ quy không gian đầu vào thành các vùng nhỏ hơn bằng cách tách theo đặc trưng và ngưỡng cho tới khi đạt tiêu chí dừng.
Mỗi nút lá thu được được gán một giá trị dự đoán. Do đó, một cây quyết định có thể được xem như một hàm từng phần, trong đó mỗi vùng của miền ánh xạ tới một giá trị dự đoán hằng. Bằng cách ghép nhiều quy tắc cục bộ, cây quyết định có thể nắm bắt các mẫu phức tạp.
Ví dụ, bạn có thể thấy một vùng hai chiều được phân hoạch như sau:
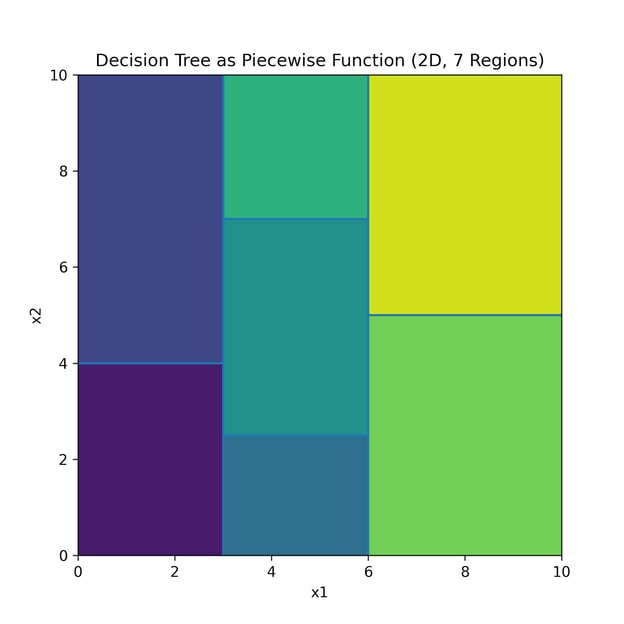
Bản đồ nhiệt này tương ứng với các vùng sau:
|
Vùng |
Phần miền |
Giá trị hàm |
|
1 |
x1 < 3 và x2 < 4 |
1 |
|
2 |
x1 < 3 và x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 và x2 < 2.5 |
3 |
|
4 |
3 ≤ x1 < 6 và 2.5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 và x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 và x2 < 5 |
6 |
|
7 |
x1 ≥ 6 và x2 ≥ 5 |
7 |
Tối ưu hóa hàm
Tối ưu hóa hàm là quá trình tìm các giá trị đầu vào làm cực đại hoặc cực tiểu một hàm. Ví dụ, bạn có thể muốn cực đại hóa một hàm lợi nhuận hoặc cực tiểu hóa một hàm lỗi. Nghiên cứu về tối ưu hóa hàm được gọi là "nghiên cứu tác nghiệp" và là một khối lý thuyết toán học đồ sộ, liên tục phát triển.
Tối ưu các hàm gắn liền chặt chẽ với các "điểm cực trị" cục bộ và toàn cục (điểm cực đại hoặc cực tiểu). "Cực tiểu cục bộ" là cực tiểu trong một khoảng nhất định, còn "cực tiểu toàn cục" là cực tiểu của toàn bộ hàm.
Ví dụ, xét hàm f(x) = x4 - 3x2 + x.
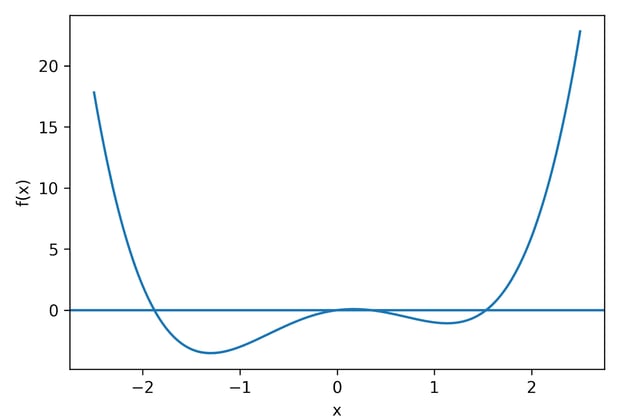
Có hai cực tiểu cục bộ: một khi x xấp xỉ -1.30 và một khi x xấp xỉ 1.13. Giá trị y thấp hơn khi x bằng -1.30, nên đó là cực tiểu toàn cục của hàm.
Với các tác vụ tối ưu hóa đơn giản như tìm mức giá tốt nhất để tối đa hóa lợi nhuận trong một mô hình định giá một biến, chỉ cần lấy đạo hàm của hàm, cho bằng không, và giải x. Với việc huấn luyện mạng nơ-ron sâu, không đơn giản vậy, nhưng hoạt động theo cách tương tự.
Phương pháp tối ưu quan trọng nhất cho Học sâu là Gradient Descent. Gradient là sự khái quát đa chiều của hệ số góc, cho ta biết mất mát thay đổi như thế nào theo từng tham số.
Nó hoạt động bằng cách lặp lại việc di chuyển theo hướng dốc xuống nhanh nhất của một hàm. Ở mỗi bước, nó dùng gradient để quyết định hướng đi và một kích thước bước để quyết định đi bao xa. Theo thời gian, quá trình này dẫn tới một cực tiểu cục bộ.
Kết luận
Hàm số hiện diện khắp nơi trong toán học, lập trình và khoa học dữ liệu. "Học" trong máy học thực ra chỉ là tìm hàm tốt nhất (và các tham số của nó) để ánh xạ đầu vào sang đầu ra. Giờ bạn đã hiểu về hàm, hãy viết một vài hàm trong Python hoặc ngôn ngữ lập trình ưa thích của bạn!
Để xem những ý tưởng này khớp vào quy trình máy học thực tế như thế nào, bạn có thể tiếp tục với khóa học Understanding Machine Learning.
Câu hỏi thường gặp về Hàm số
Hàm trong toán học là gì?
Hàm số toán học là một quy tắc ánh xạ mỗi đầu vào tới đúng một đầu ra.
Tại sao một hàm số toán học chỉ có một đầu ra?
Nếu không, quy tắc đó sẽ không phải là một hàm theo định nghĩa, vì sẽ mơ hồ.
Hàm trong lập trình có giống hàm trong toán học không?
Không hẳn. Hàm trong lập trình có thể có tác dụng phụ hoặc thậm chí không trả về giá trị hữu ích nào, điều không được phép ở hàm số toán học.
Tại sao hàm lại quan trọng trong khoa học dữ liệu?
Bởi vì mô hình chính là các hàm. Mô hình ánh xạ đặc trưng tới dự đoán, xác suất, hoặc điểm số.
Miền xác định và đối miền của một hàm là gì?
Miền xác định là tập các đầu vào hợp lệ. Đối miền là tập các đầu ra hợp lệ.

Mark Pedigo, PhD, là một nhà khoa học dữ liệu xuất sắc với chuyên môn về khoa học dữ liệu trong y tế, lập trình và giáo dục. Với bằng Tiến sĩ Toán học, Cử nhân Khoa học Máy tính và Chứng chỉ Chuyên nghiệp về AI, Mark kết hợp hiểu biết kỹ thuật với khả năng giải quyết vấn đề thực tiễn. Sự nghiệp của anh bao gồm các vai trò trong phát hiện gian lận, dự đoán tử vong ở trẻ sơ sinh và dự báo tài chính, cùng với những đóng góp cho phần mềm ước tính chi phí của NASA. Là một nhà giáo dục, anh đã giảng dạy tại DataCamp và Đại học Washington ở St. Louis, đồng thời cố vấn cho các lập trình viên trẻ. Trong thời gian rảnh, Mark thích hoạt động ngoài trời ở Minnesota cùng vợ là Mandy và chú chó Harley, và chơi piano jazz.


Những nhà khoa học dữ liệu mới vào nghề thường gặp thuật ngữ "function" (hàm), nhưng không phải lúc nào cũng rõ ý nghĩa thực sự của nó.
Trong bài viết này, bạn sẽ học hàm số toán học là gì, những tập hợp nào mô tả giá trị đầu vào và đầu ra của nó, cũng như sự khác nhau giữa giá trị liên tục và rời rạc. Bạn sẽ khám phá cách hàm được dùng trong công nghệ, các hàm thường gặp trong khoa học dữ liệu, và cách chúng được tối ưu hóa. Trong quá trình đó, bạn sẽ thấy mã Python để thao tác và vẽ đồ thị hàm số.
Nếu bạn muốn luyện viết và sử dụng các hàm của riêng mình trong Python, tôi khuyến nghị khóa học Writing Functions in Python của chúng tôi.
Hàm số trong Toán học là gì?
Trong toán học, một hàm số ánh xạ mỗi đầu vào tới đúng một đầu ra. Mỗi đầu vào hợp lệ chỉ được gửi tới một và chỉ một đầu ra. Một đầu vào không thể có nhiều đầu ra.
Ví dụ, 32 độ Fahrenheit là 0 độ Celsius. Giá trị Fahrenheit tương ứng với một giá trị Celsius; và nó chỉ tương ứng với một giá trị. Bạn không thể có hai giá trị đầu ra (Celsius) khác nhau cho một đầu vào hợp lệ (Fahrenheit).
Ví dụ khác gồm tính lương, nơi bạn được trả theo số tiền mỗi giờ. Nếu bạn kiếm $20/giờ và làm 40 giờ, bạn được 20 x 40 = $800.
Không phải mọi quy tắc đều là hàm. Đôi khi, về mặt logic có thể có nhiều đầu ra cho một đầu vào. Ví dụ, ghép một tên với một con người không phải là hàm. Tên "John Smith" có thể ứng với nhiều người khác nhau, tất cả đều trùng tên này.
Trong toán học, các quy tắc thường được thiết lập sao cho mỗi đầu vào hợp lệ chỉ có một đầu ra. Nhiều khi, đó chính xác là cách thế giới vận hành (tính lương). Ở trường hợp khác, bài toán được phát biểu dưới dạng hàm vì như vậy bài toán trở nên khả giải. Thay vì theo đuổi một mớ rối đầu vào–đầu ra, mô hình được thiết lập sao cho mỗi đầu vào không thể có nhiều đầu ra.
Bạn có thể hình dung một hàm như một "cỗ máy" nhận đầu vào (thường ký hiệu x), xử lý theo một cách nào đó, và cho ra đầu ra (thường ký hiệu y).
Ở đây, một cỗ máy nhận đầu vào từ băng chuyền bên trái, xử lý nó, và tạo ra dấu kiểm xanh vui vẻ ở bên phải.
Hàm đa biến nhận một tập hợp gồm nhiều đầu vào nhưng chỉ cho ra một đầu ra. Bạn có thể nghĩ là truyền vào một hàng dữ liệu gồm nhiều biến hoặc đặc trưng ánh xạ tới một đầu ra duy nhất.
Ký hiệu và thuật ngữ về hàm
Viết phương trình thế nào? Trong ví dụ đổi nhiệt độ, ta có thể viết công thức y = f(x) = (5/9) (x - 32), với x là nhiệt độ theo Fahrenheit và y theo Celsius. Để hiểu ký hiệu này, hãy đọc từ trái sang phải.
Bên trái là y, tức đầu ra. Ký hiệu f(x) cho biết bạn đang dùng một hàm, gọi là f, nhận đầu vào x. Lưu ý trong ngữ cảnh này, f(x) không có nghĩa là một giá trị f nhân với một giá trị x khác.
Bên phải là công thức. Nó bảo lấy đầu vào x, trừ đi 32, rồi nhân kết quả này với 5/9.
Miền xác định, đối miền và giá trị hàm
Giả sử bạn ghi lại nhiệt độ ngoài trời mỗi ngày và đã thu thập k phép đo, ký hiệu (x1, x2, …, xk). Bạn muốn một hàm trả về nhiệt độ trung bình từ đầu năm đến hiện tại sau khi đã qua n ngày. Hãy định nghĩa một hàm nhận một số nguyên dương n nhỏ hơn hoặc bằng k và trả về trung bình của n nhiệt độ đầu tiên, là một số thực. Ký hiệu cho hàm như vậy là f: {1, 2, …, k} → ℝ.
Có một số thuật ngữ hữu ích để mô tả các tập trong hàm, dẫn tới khái niệm miền xác định, đối miền và giá trị hàm.
Bây giờ, hãy xét tới giá trị hàm. Xét một hàm bậc hai đơn giản: y = f(x) = x2. Để chỉ rõ miền xác định và đối miền, viết f: ℝ → ℝ.
Bạn biết rằng điều này chỉ ra cả miền xác định (tập đầu vào) và đối miền (tập đầu ra) đều là các số thực. Tuy nhiên, nếu suy nghĩ, bạn sẽ nhận ra tập đầu ra không thể là toàn bộ các số thực.
Vì bất kỳ số nào bình phương cũng không âm, nên tập các giá trị đầu ra thực tế không phải là toàn bộ số thực, mà chỉ là các số thực không âm. Thuật ngữ mô tả tình huống này là giá trị hàm. Ta nói giá trị hàm của hàm này là tất cả các số thực không âm.
Đối miền là tập đầu ra tiềm năng; giá trị hàm là tập các đầu ra thực tế. Bạn chọn đối miền để phản ánh kiểu đầu ra bạn dự định, và bạn khám phá giá trị hàm, tức tập các giá trị đầu ra thực sự đạt được.
Biến liên tục và rời rạc
Điều này dẫn ta tới phân biệt giữa biến liên tục và rời rạc:
Chẳng hạn, một biến liên tục trong [0, 1] có thể nhận các giá trị 0, 0.5, 0.4141, hoặc bất kỳ giá trị thực nào trong khoảng. Biến liên tục thường dùng trong các mô hình mà đầu ra về mặt lý thuyết có thể là bất kỳ giá trị nào, như hồi quy.
Tuy nhiên, trong phân loại nhị phân, bạn chỉ quan tâm hai giá trị: 0 và 1. Ví dụ, một bức ảnh hoặc có mèo hoặc không. Trong bài toán phân loại đa lớp, bạn vẫn chỉ có một số hữu hạn giá trị, ví dụ 0 cho chó, 1 cho mèo, 2 cho ngựa.
Bài toán bạn đang giải quyết quyết định kiểu hàm bạn quan tâm. Bài toán phân loại cho ra giá trị rời rạc; bài toán hồi quy cho ra hàm liên tục.
Ký hiệu vectơ
Đôi khi bạn cần truyền nhiều biến vào một hàm. Ví dụ, bạn có thể truyền một hàng đặc trưng vào một hàm học máy. Khi đó, bạn có thể gom các đặc trưng vào một "bộ chứa" và truyền vào. Một cách để gom dữ liệu như vậy là qua một vectơ. Mô hình nhận một vectơ đầu vào x = [x1, x2, x3] và cho ra một mục tiêu y.
Trong Python, bạn thường dùng mảng NumPy để biểu diễn một vectơ.
Đoạn mã này lấy một vectơ gồm các số 3, 4 và 7.1 và trả về giá trị trung bình.
Với một tập các vectơ, một phương pháp phổ biến là dùng cấu trúc dữ liệu DataFrame từ thư viện pandas.
Đoạn mã này trả về một Series của pandas chứa trung bình theo hàng, mỗi hàng một giá trị. Trong trường hợp này:
Hàm trong Công nghệ
Khái niệm hàm xuất hiện khắp nơi trong công nghệ. Vì lý do thực tiễn, hãy lưu ý rằng "hàm" không phải lúc nào cũng được định nghĩa chặt chẽ như trong toán học. Ví dụ, hàm trong lập trình có thể có tác dụng phụ làm thay đổi giá trị của các biến khác ngoài đầu ra, trong khi hàm số toán học thì không.
Bảng tính
Hàm được dùng rộng rãi trong bảng tính, ví dụ trong Công thức Excel. Bạn có thể muốn tính tổng, trung bình hoặc trung vị của một cột số. Với bảng tính, hàm tuân theo định nghĩa giống với hàm toán học đã giới thiệu trước đó.
Một điều bảng tính làm rất tốt là các Hàm Có điều kiện: Chúng cho phép bạn xây dựng các cấu trúc điều kiện phức tạp hơn bằng những hàm như
IF().Chẳng hạn, bạn có thể muốn tìm tổng các khoản thanh toán đã trả cho công ty thế chấp của bạn trong một năm. Để làm vậy, bạn có thể sẽ dùng hàm
SUM()của bảng tính.Ngôn ngữ lập trình
Hàm hiện diện ở khắp các ngôn ngữ lập trình. Tùy ngôn ngữ, định nghĩa "hàm" có thể lỏng hơn so với hàm toán học. Một số ngôn ngữ cho phép một hàm trả về nhiều giá trị, hoặc không trả về giá trị nào.
Ví dụ, một hàm có thể nhận giá trị và in ra một câu, nhưng không trả về giá trị rõ ràng. Một Hàm Python trông như thế này:
Đoạn mã này tạo ra đầu ra: "My name is Mark and my favorite color is blue." Không có giá trị toán học nào được hàm trả về một cách tường minh.
Mã trong nhiều ngôn ngữ phổ biến, như Python, cũng có thể có các tác dụng phụ khác trong hàm, như thay đổi giá trị của biến toàn cục. Dù tác dụng phụ là có thể và được phép, chúng bị khuyến cáo hạn chế. Tác dụng phụ khiến chương trình khó kiểm thử, gỡ lỗi và suy luận hơn.
Vì những lý do này, một số ngôn ngữ "hàm" như h Scala và Haskell được xây dựng chặt chẽ hơn quanh ý tưởng về hàm.
Máy học
Trong bối cảnh Máy học, đầu vào là các đặc trưng, hàm là mô hình, và đầu ra là dự đoán của mô hình. Mô hình như vậy thường được mô tả là "hộp đen" vì không nhất thiết rõ ràng cách các đặc trưng đầu vào được xử lý để cho ra dự đoán đầu ra, đó là lý do ẩn dụ ”cỗ máy” trước đó càng phù hợp hơn:
Trong minh họa này, các đặc trưng được đưa vào "cỗ máy" mô hình, mô hình xử lý theo một cách nào đó và cho ra một dự đoán. So với các hàm đơn giản, tất định như ví dụ đổi nhiệt độ, những gì xảy ra bên trong cỗ máy khó mô tả hơn.
Trong ML, miền xác định là các vectơ đặc trưng; đối miền có thể là xác suất, lớp, hoặc các dự đoán giá trị thực.
Trong lĩnh vực Học sâu, các hàm thường không áp dụng trực tiếp lên một tập đầu vào, mà độ đúng đắn của mô hình được đánh giá bằng hàm chi phí. Hàm Chi phí là thước đo độ sai của mô hình trên tập huấn luyện. Nó so sánh dự đoán với nhãn hoặc giá trị thật và gộp các lỗi thành một con số duy nhất.
Các hàm thường gặp trong Khoa học dữ liệu
Một số hàm xuất hiện gần như ở khắp nơi trong khoa học dữ liệu. Bao gồm các hàm tuyến tính, lôgarit và mũ, cũng như các hàm kích hoạt phi tuyến cho học sâu.
Hàm tuyến tính
Bắt đầu với ví dụ kinh điển: hàm tuyến tính.
Hệ số góc
Giả sử bạn thèm táo. Bạn tới cửa hàng tạp hóa bán táo với giá cố định $0.75 mỗi pound. Vậy 1 pound táo giá $0.75, 2 pound giá 2 x $0.75 = $1.50, và 3 pound giá 3 x $0.75 = $2.25. Mỗi pound bạn mua cộng thêm một lượng cố định vào tổng chi phí.
Theo ký hiệu hàm, bạn có thể viết công thức f(x) = 0.75 x. Con số 0.75 là hệ số góc của hàm tuyến tính. Hệ số góc là tốc độ thay đổi của đầu ra theo mỗi đơn vị thay đổi của đầu vào.
Để vẽ đồ thị một hàm như vậy, bạn có thể dùng đoạn mã tương tự sau:
Những hàm như vậy được gọi là hàm tuyến tính. Mỗi mức tăng của đầu vào x đóng góp cùng một lượng cố định vào đầu ra y. Như tên gọi gợi ý, khi vẽ, hàm tuyến tính cho ra một đường thẳng.
Giao điểm
Bây giờ, giả sử bạn thích giao hàng tạp hóa tận nơi. Cửa hàng có phí giao hàng cố định $2.00. Khi đó, hàm cho số táo của bạn là f(x) = 0.75 x + 2. Như trước, 0.75 là hệ số góc. Con số 2, nơi đồ thị cắt trục y, được gọi là "giao điểm y". Đó là giá trị đầu ra khi đầu vào bằng 0.
Tổng chi phí là tổng của táo và phí giao hàng. Nói chung, một hàm tuyến tính một biến có thể viết là f(x) = mx + b, trong đó m là hệ số góc và b là giao điểm y.
Hàm tuyến tính đa biến
Có lẽ bạn sẽ muốn ăn nhiều thứ hơn táo. Giả sử bạn muốn mua thêm bánh mì và bơ đậu phộng. Táo giá $0.75 mỗi pound, một ổ bánh mì $2.50, và một hũ bơ đậu phộng $3.00. Lúc này, hàm hóa đơn tạp hóa của bạn là:
Hàm này vẫn được coi là tuyến tính vì tuyến tính theo từng biến. Nói chung, một hàm tuyến tính có dạng:
Điều này tương đương cộng mỗi lượng bạn mua nhân với trọng số của chúng (một từ khác cho hệ số góc trong ngữ cảnh này), cộng với hằng số tự do.
Theo ký hiệu vectơ, hàm này được viết như sau:
Chữ T ở đây là viết tắt của “chuyển vị”, cần thiết để thực hiện phép nhân vectơ giữa w và x.
Hồi quy tuyến tính
Xét hiệu suất nhiên liệu theo tốc độ. Bạn nghi ngờ rằng khi lái xe nhanh hơn, hiệu suất nhiên liệu giảm. Bạn thu thập năm mươi điểm dữ liệu giữa các tốc độ 45 và 65 dặm/giờ và thấy mẫu sau:
Nối từng điểm dữ liệu sẽ cho bạn một đường ngoằn ngoèo, khó đọc, vô ích. Nhưng xu hướng chung của dữ liệu xấp xỉ tuyến tính trong khoảng này. Nếu ta gọi tốc độ là x, hàm cho đồ thị này là:
Để tìm một đường như vậy khớp dữ liệu tốt nhất, bạn dùng một quy trình toán học gọi là Hồi quy tuyến tính đơn.
Bạn có thể tính một đường như vậy trong Python bằng Matplotlib và Seaborn:
Hồi quy tuyến tính làm việc với nhiều biến. Giả sử bạn muốn định nghĩa một mô hình hồi quy tuyến tính cho tốc độ (x), khối lượng xe (y), và dung tích động cơ (z). Công thức thu được cho Hồi quy tuyến tính đa biến là:
Trong trường hợp này, hệ số của mỗi biến biểu thị trọng số hay mức độ quan trọng của đặc trưng đó, trong khi giữ các biến khác cố định.
Hàm nghịch đảo
Giờ hãy "đảo ngược" câu hỏi mua táo: nếu bạn đã chi $2.25 cho táo, bạn đã mua bao nhiêu pound? Câu trả lời là 2.25 / 0.75 = 3, vậy bạn đã mua ba pound. Kiểu "đảo" một hàm này được gọi là hàm nghịch đảo của hàm. Trong ví dụ không có hằng số tự do, nghịch đảo là:
Lưu ý trong ký hiệu này, "-1" chỉ việc bạn đang lấy nghịch đảo của một hàm, không phải nghịch đảo của một số.
Một điều cần chú ý là miền xác định có thể thay đổi. Ví dụ, giả sử hàm gốc của bạn là:
Hàm này được xác định cho mọi số thực trừ 2, vì mẫu số không thể bằng không. Hàm nghịch đảo của nó là
Vì lý do tương tự, hàm nghịch đảo được xác định cho mọi đầu vào trừ 0.
Một điều dễ mắc nữa là nghịch đảo thu được có thể không phải là một hàm do có nhiều đầu ra cho một đầu vào. Xét hàm y = x2. Phép đảo của nó sẽ là:
Như bạn thấy qua dấu cộng/trừ, nghịch đảo có hai đầu ra cho một đầu vào, vì vậy nó không phải là một hàm trừ khi ta hạn chế miền xác định (ví dụ, với x ≥ 0)
Về đồ thị, một hàm và nghịch đảo của nó (nếu tồn tại) là ảnh gương qua đường y=x. Xét hàm y = x3. Đồ thị của hàm này và nghịch đảo của nó là: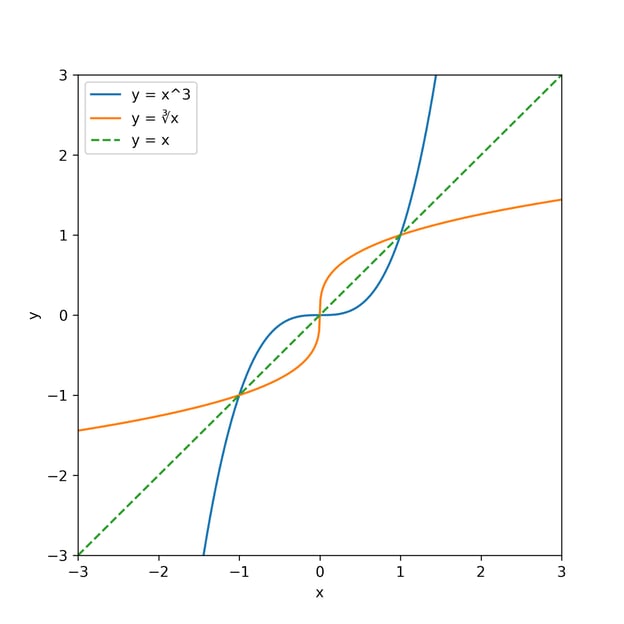
Hàm gốc (màu xanh) có một hàm nghịch đảo (màu cam) là ảnh phản xạ qua đường y = x.