
Curso
Álgebra Linear para Data Science em R
4 h
21.7K
Profissionais iniciantes em ciência de dados costumam ver o termo "função", mas nem sempre fica claro o que ele realmente significa.
Neste artigo, você vai aprender o que é uma função matemática, quais conjuntos descrevem seus valores de entrada e de saída e como valores contínuos e discretos se diferenciam. Vamos explorar como as funções são usadas em tecnologia, funções comuns em ciência de dados e como elas são otimizadas. No caminho, você verá código em Python para manipular e plotar funções.
Se quiser praticar a escrita e o uso de suas próprias funções em Python, recomendo o nosso curso Writing Functions in Python.
Em matemática, uma função associa cada entrada a uma saída única. Toda entrada válida é enviada para uma e apenas uma saída. Uma mesma entrada não pode ter múltiplas saídas.
Por exemplo, 32 graus Fahrenheit equivalem a 0 Celsius. O valor em Fahrenheit corresponde a um valor em Celsius — e corresponde a apenas um valor. Você não pode ter duas saídas diferentes (Celsius) para uma única entrada válida (Fahrenheit).
Outros exemplos incluem folha de pagamento: você recebe um valor por hora. Se ganha US$ 20 por hora e trabalha 40 horas, recebe 20 x 40 = US$ 800.
Nem toda regra é uma função. Em alguns casos, faz sentido lógico ter múltiplas saídas para uma única entrada. Por exemplo, relacionar um nome a uma pessoa não é uma função. O nome "John Smith" pode corresponder a várias pessoas que compartilham esse nome.
Em matemática, as regras costumam ser estruturadas de modo que exista apenas uma saída por entrada válida. Em muitos casos, isso reflete explicitamente como o mundo funciona (folha de pagamento). Em outros, formulamos problemas em termos de funções porque isso torna o problema tratável. Em vez de seguir um emaranhado de entradas e saídas, o modelo é montado de forma que cada entrada não possa ter múltiplas saídas.
Você pode pensar em uma função como uma "máquina" que recebe uma entrada (geralmente indicada por x), processa de algum jeito e produz uma saída (geralmente indicada por y).
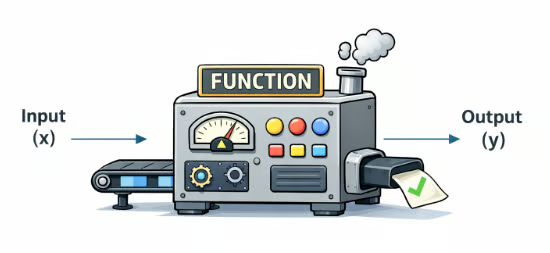
Aqui, uma máquina recebe entradas na esteira do lado esquerdo, processa e produz um vistoso check verde à direita.
Funções multivariadas aceitam um conjunto de múltiplas entradas, mas retornam uma única saída. Você pode imaginar isso como passar uma linha de dados composta por várias variáveis ou features que mapeiam para um único resultado.
Como escrever a equação? No exemplo de conversão de temperatura, podemos escrever a fórmula como y = f(x) = (5/9) (x - 32), com x sendo a temperatura em Fahrenheit e y em Celsius. Para entender essa notação, leia da esquerda para a direita.
À esquerda, você vê y, que é a saída. A notação f(x) indica que você está usando uma função, chamada f, que recebe uma entrada x. Observe que, nesse contexto, f(x) não significa algum valor f multiplicado por outro valor x.
À direita está a fórmula. Ela diz para pegar a entrada x, subtrair 32 e multiplicar o resultado por 5/9.
Suponha que você registre a temperatura externa uma vez por dia e tenha coletado k medições, denotadas por (x1, x2, …, xk). Você quer uma função que retorne a média do ano até a data após n dias decorridos. Defina uma função que receba um inteiro positivo n menor ou igual a k que retorne a média das primeiras n temperaturas, que é um número real. A notação para tal função é f: {1, 2, …, k} → ℝ.
É útil ter jargões para descrever os conjuntos na função, o que nos leva a domínio, contradomínio e imagem.
Agora, vamos olhar para a imagem. Considere uma função quadrática simples: y = f(x) = x2. Para especificar domínio e contradomínio, escreva f: ℝ → ℝ.
Isso indica que tanto o domínio (conjunto de entradas) quanto o contradomínio (conjunto de saídas) são os números reais. No entanto, pensando um pouco, você percebe que o conjunto de saídas não pode ser todos os números reais.
Como qualquer número ao quadrado é não negativo, o conjunto de saídas realmente obtidas não são todos os números reais, mas apenas os números reais não negativos. O termo para descrever essa situação é imagem. Dizemos que a imagem dessa função são todos os números reais não negativos.
O contradomínio é o conjunto potencial de saídas; a imagem é o conjunto de saídas efetivamente produzidas. Você escolhe o contradomínio para refletir o tipo de saída desejada e descobre a imagem, que é o conjunto de valores realmente obtidos.
Isso nos leva à distinção entre variáveis contínuas e discretas:
Por exemplo, uma variável contínua em [0, 1] pode assumir os valores 0, 0,5, 0,4141 ou qualquer outro valor real no intervalo. Variáveis contínuas são comuns em modelos em que a saída pode, teoricamente, ser qualquer valor, como em regressão.
Já em classificação binária, você só se importa com dois valores: 0 e 1. Por exemplo, uma imagem contém um gato ou não. Em um problema de classificação multiclasse, você ainda tem um número finito de valores, como 0 para cachorro, 1 para gato, 2 para cavalo.
O problema que você quer resolver dita o tipo de função de interesse. Problemas de classificação geram valores discretos; problemas de regressão geram funções contínuas.
Às vezes é preciso passar múltiplas variáveis para uma função. Por exemplo, você pode passar uma linha de features para uma função de machine learning. Nesse caso, você pode agrupar as features em um contêiner e passá-lo. Uma forma de agrupar dados assim é via um vetor. O modelo recebe um vetor de entrada x = [x1, x2, x3] e retorna um alvo y.
Em Python, você normalmente usa um array do NumPy para representar um vetor.
import numpy as np

def f(x):
    result = (x[0] + x[1] + x[2]) / 3
    return result

x = [3, 4, 7.1]
print(f(x))4.7Esse código recebe um vetor com os números 3, 4 e 7,1 e retorna a média.
Para um conjunto de vetores, uma forma popular é usar a estrutura de dados DataFrame da biblioteca pandas.
import pandas as pd

def row_averages(df):
    return df.mean(axis=1).round(1)

df = pd.DataFrame({
    "A": [1, 5, 2],
    "B": [9, 3, 6],
    "C": [7, 8, 10]
})

print(row_averages(df))
Esse código retorna uma Series do pandas com as médias por linha, um valor por linha. Neste caso:
0    5.7
1    5.3
2 6.0O conceito de função é onipresente em tecnologia. Na prática, saiba que "função" nem sempre é definida com o mesmo rigor da matemática. Por exemplo, funções de programação podem ter efeitos colaterais que alteram valores de variáveis além da saída, enquanto funções matemáticas não têm.
Funções são amplamente usadas em planilhas, como nas fórmulas do Excel. Você pode querer calcular a soma, a média ou a mediana de uma coluna de números. Em planilhas, as funções seguem a mesma definição matemática apresentada antes.
Uma coisa em que as planilhas são ótimas (trocadilho intencional) é em funções condicionais: elas permitem construir estruturas condicionais mais complexas com funções como IF().
Por exemplo, você pode querer encontrar o total de pagamentos feitos ao seu financiamento imobiliário durante um ano. Para isso, provavelmente usaria a função SUM() da sua planilha.
Funções são onipresentes em linguagens de programação. Dependendo da linguagem, a definição de "função" pode ser mais flexível do que a matemática. Algumas linguagens permitem que uma função retorne múltiplos valores ou nenhum valor.
Por exemplo, uma função pode receber valores e imprimir uma mensagem, mas não retornar explicitamente um valor. Uma função em Python fica assim:
def print_me(name, color):
       print(f"My name is {name} and my favorite color is {color}.")

name = "Mark"
color = "blue"
print_me(name, color)
Esse código gera a saída: "My name is Mark and my favorite color is blue." Nenhum valor matemático é explicitamente retornado da função.
Códigos em muitas linguagens mainstream, como Python, também podem ter outros efeitos colaterais em uma função, como alterar o valor de uma variável global. Mesmo que efeitos colaterais sejam possíveis e permitidos, eles são desencorajados. Eles tornam programas mais difíceis de testar, depurar e raciocinar.
Por esses motivos, algumas linguagens "funcionais", como Scala e Haskell, são mais rigorosamente baseadas na ideia de função.
Em machine learning, as entradas são as features, a função é o modelo e a saída é a previsão do modelo. Esse modelo costuma ser descrito como uma "caixa‑preta", pois nem sempre é claro como as features de entrada foram processadas para gerar a previsão — por isso a nossa metáfora de "máquina" se encaixa ainda melhor:
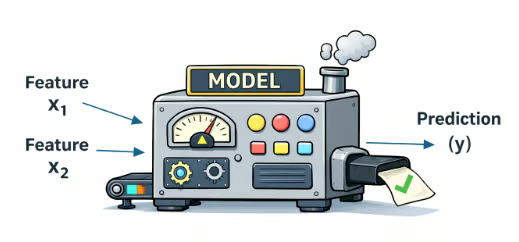
Nesta ilustração, as features entram na "máquina" modelo, que as processa de algum modo e gera uma previsão. Em comparação com funções determinísticas mais simples, como o exemplo de conversão de temperatura, o que acontece dentro da máquina é mais difícil de descrever.
Em ML, o domínio são vetores de features; o contradomínio pode ser probabilidades, classes ou previsões com valores reais.
Em deep learning, as funções geralmente não são aplicadas diretamente a um conjunto de entradas, mas a correção do modelo é avaliada usando uma função de custo. Uma cost function é uma medida de quão errado um modelo está no conjunto de treino. Ela compara previsões com rótulos ou valores verdadeiros e agrega os erros em um único número.
Algumas funções aparecem praticamente em todo lugar na ciência de dados. Entre elas estão funções lineares, logarítmicas e exponenciais, além de funções de ativação não lineares para deep learning.
Vamos começar com o clássico: funções lineares.
Suponha que você esteja com vontade de comprar maçãs. No mercado, o preço é fixo: US$ 0,75 por libra. Assim, uma libra sai por US$ 0,75; 2 libras custam 2 x US$ 0,75 = US$ 1,50; e 3 libras custam 3 x US$ 0,75 = US$ 2,25. Cada libra adiciona um valor fixo ao custo total.
Em notação de função, você pode escrever a fórmula como f(x) = 0,75 x. O número 0,75 é a inclinação da função linear. A inclinação é a taxa de variação da saída a cada unidade de variação na entrada.
Para grafar essa função, você pode usar um código como o seguinte:
import numpy as np
import matplotlib.pyplot as plt

def cost_of_apples(x, m):
    result = m * x
    return result

# Define x and y
x = np.linspace(0, 5, 100)
y = cost_of_apples(x, 0.75)

# Plot
plt.figure()
plt.plot(x, y)
plt.xlabel("Pounds of Apples")
plt.ylabel("Total Cost ($)")
plt.title("Cost of Apples")
plt.show()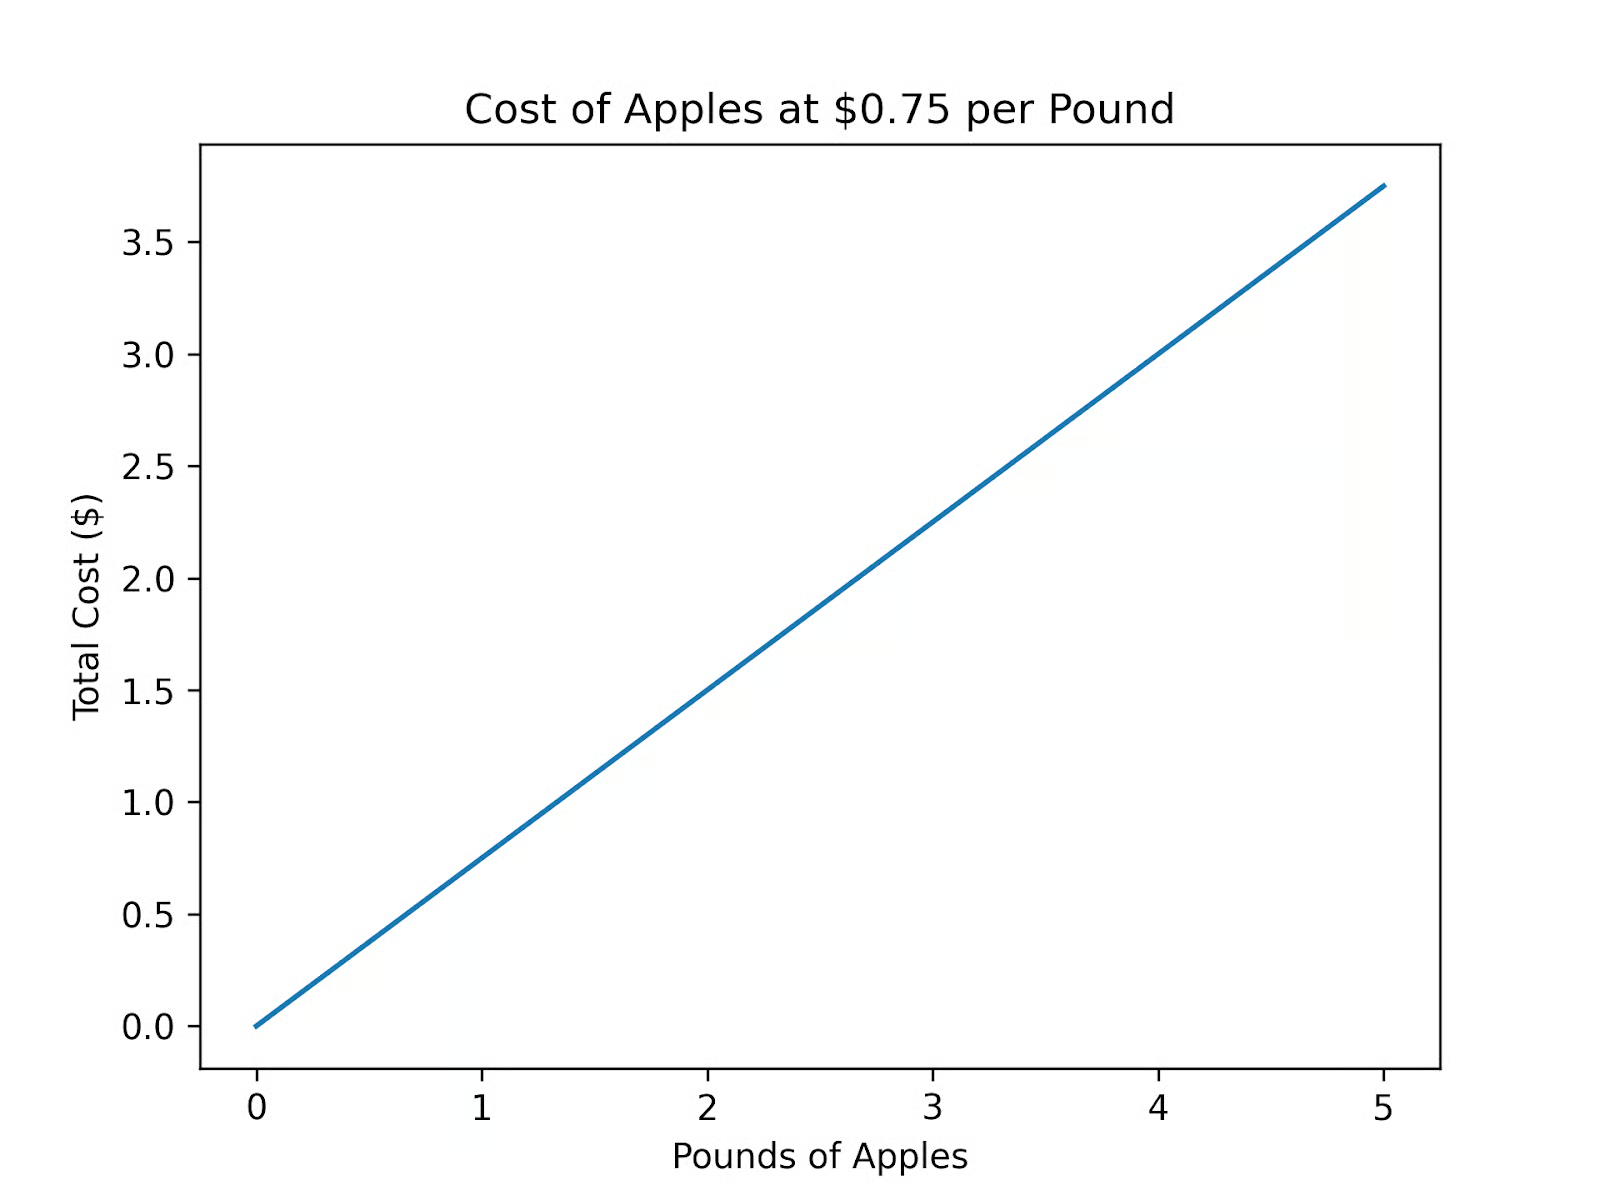
Essas funções são chamadas de funções lineares. Cada aumento na entrada x adiciona o mesmo valor fixo à saída y. Como o nome sugere, ao serem representadas em um gráfico, produzem uma linha.
Agora, suponha que você prefira receber as compras em casa. A loja cobra uma taxa fixa de entrega de US$ 2,00. Nesse caso, a função do custo das maçãs é f(x) = 0,75 x + 2. Como antes, 0,75 é a inclinação. O número 2, onde o gráfico cruza o eixo y, é o "intercepto em y". É o valor da saída quando a entrada é 0.
O custo total é a soma das maçãs com a taxa de entrega. Em geral, uma função linear univariada pode ser escrita como f(x) = mx + b, onde m é a inclinação e b é o intercepto em y.
Você provavelmente vai querer mais do que maçãs. Suponha que também compre pão e pasta de amendoim. Maçãs custam US$ 0,75 por libra, um pão custa US$ 2,50 e um pote de pasta custa US$ 3,00. Agora, a sua função de compras é:
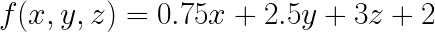
Essa função ainda é considerada linear porque é linear em cada variável. Em geral, uma função linear assume a forma:
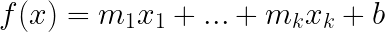
Isso equivale a somar cada quantidade multiplicada por seu peso (outro termo para inclinação neste contexto), mais o intercepto.
Em notação vetorial, essa função é escrita assim:
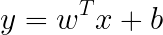
O T aqui significa "transposta", necessário para realizar a multiplicação vetorial de w e x.
Considere a eficiência de combustível versus velocidade. Você suspeita que, ao dirigir mais rápido, a eficiência caia. Você coleta cinquenta pontos entre 45 e 65 milhas por hora e vê o padrão a seguir:
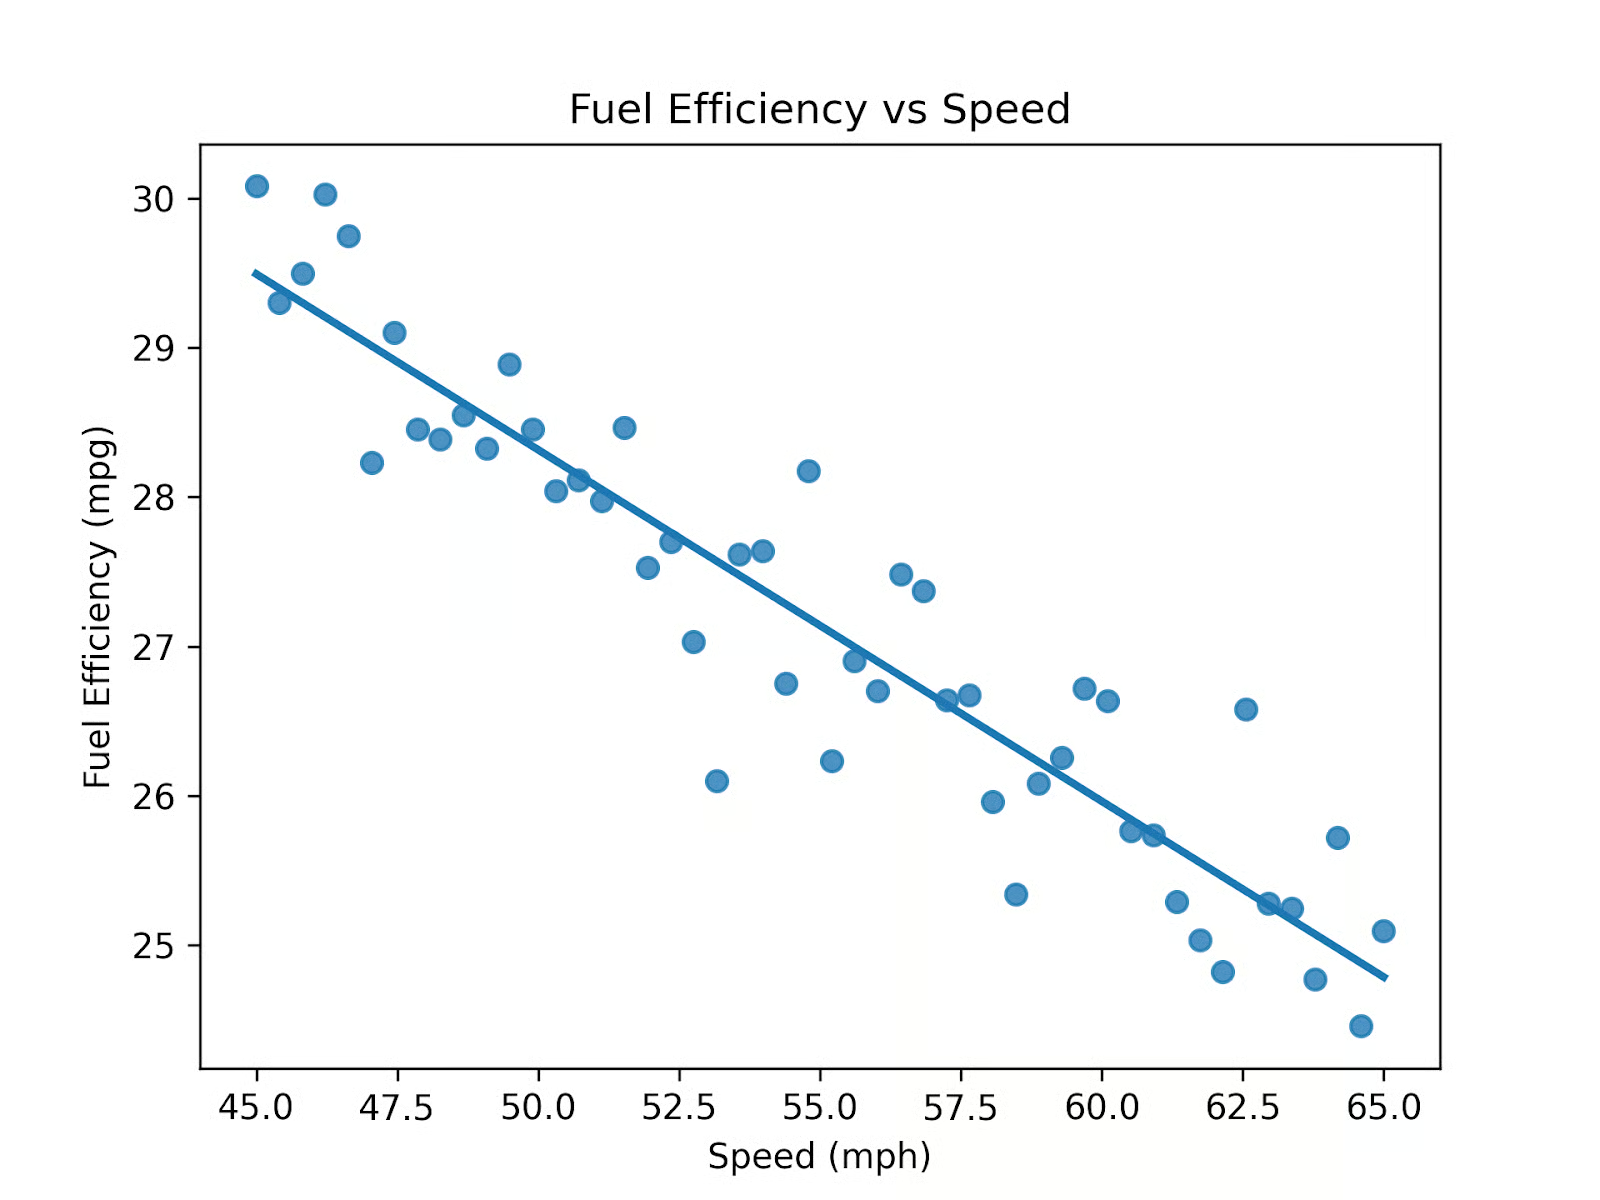
Ligar cada ponto daria um zigue-zague difícil de ler e pouco útil. Mas a tendência geral é aproximadamente linear nesse intervalo. Se chamarmos a velocidade de x, a função para esse gráfico é:
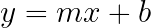
Para encontrar a melhor reta que se ajusta aos dados, você usa um processo matemático chamado regressão linear simples.
Você pode calcular uma reta assim em Python usando Matplotlib e Seaborn:
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# Reproducibility
np.random.seed(0)

# Create dataset
speed = np.linspace(45, 65, 50)
mpg = 38 - 0.2 * speed + 0.002 * (speed - 55)**2 + np.random.normal(0, 0.5, size=50)

df = pd.DataFrame({
    "speed": speed,
    "mpg": mpg
})

# Plot with regression line
sns.regplot(data=df, x="speed", y="mpg", ci=None)

plt.xlabel("Speed (mph)")
plt.ylabel("Fuel Efficiency (mpg)")
plt.title("Fuel Efficiency vs Speed")
plt.show()
A regressão linear funciona com múltiplas variáveis. Suponha que você queira definir um modelo de regressão linear para velocidade (x), peso do veículo (y) e tamanho do motor (z). A fórmula resultante para regressão linear multivariada é:
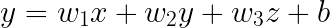
Nesse caso, o coeficiente de cada variável representa o peso ou importância daquela feature, mantendo as demais fixas.
Agora, vamos "inverter" a questão das maçãs: se você gastou US$ 2,25 em maçãs, quantas libras comprou? A resposta é 2,25 / 0,75 = 3, então você comprou três libras. Esse tipo de "inversão" de uma função é a inversa da função. No exemplo sem intercepto, a inversa é:
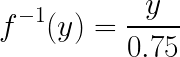
Note que, nessa notação, o "-1" indica que você está tomando a inversa de uma função, não o recíproco.
Um ponto de atenção é que o domínio pode mudar. Por exemplo, suponha que sua função original seja:
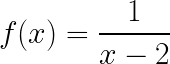
Essa função está definida para todos os números reais, exceto 2, pois o denominador não pode ser zero. A inversa dessa função é
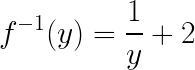
Pelo mesmo motivo, a função inversa está definida para todas as entradas, exceto 0.
Outro cuidado é que a inversa resultante pode não ser uma função por ter múltiplas saídas para uma única entrada. Considere a função y = x2. Sua "reversão" seria:
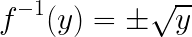
Como você pode ver pelo mais/menos, a inversa tem duas saídas para uma entrada, então não é uma função a menos que restrinjamos o domínio (por exemplo, a x ≥ 0)
Graficamente, uma função e sua inversa (se existir) são imagens espelhadas em relação à linha y=x. Considere a função y = x3. O gráfico dessa função e de sua inversa é: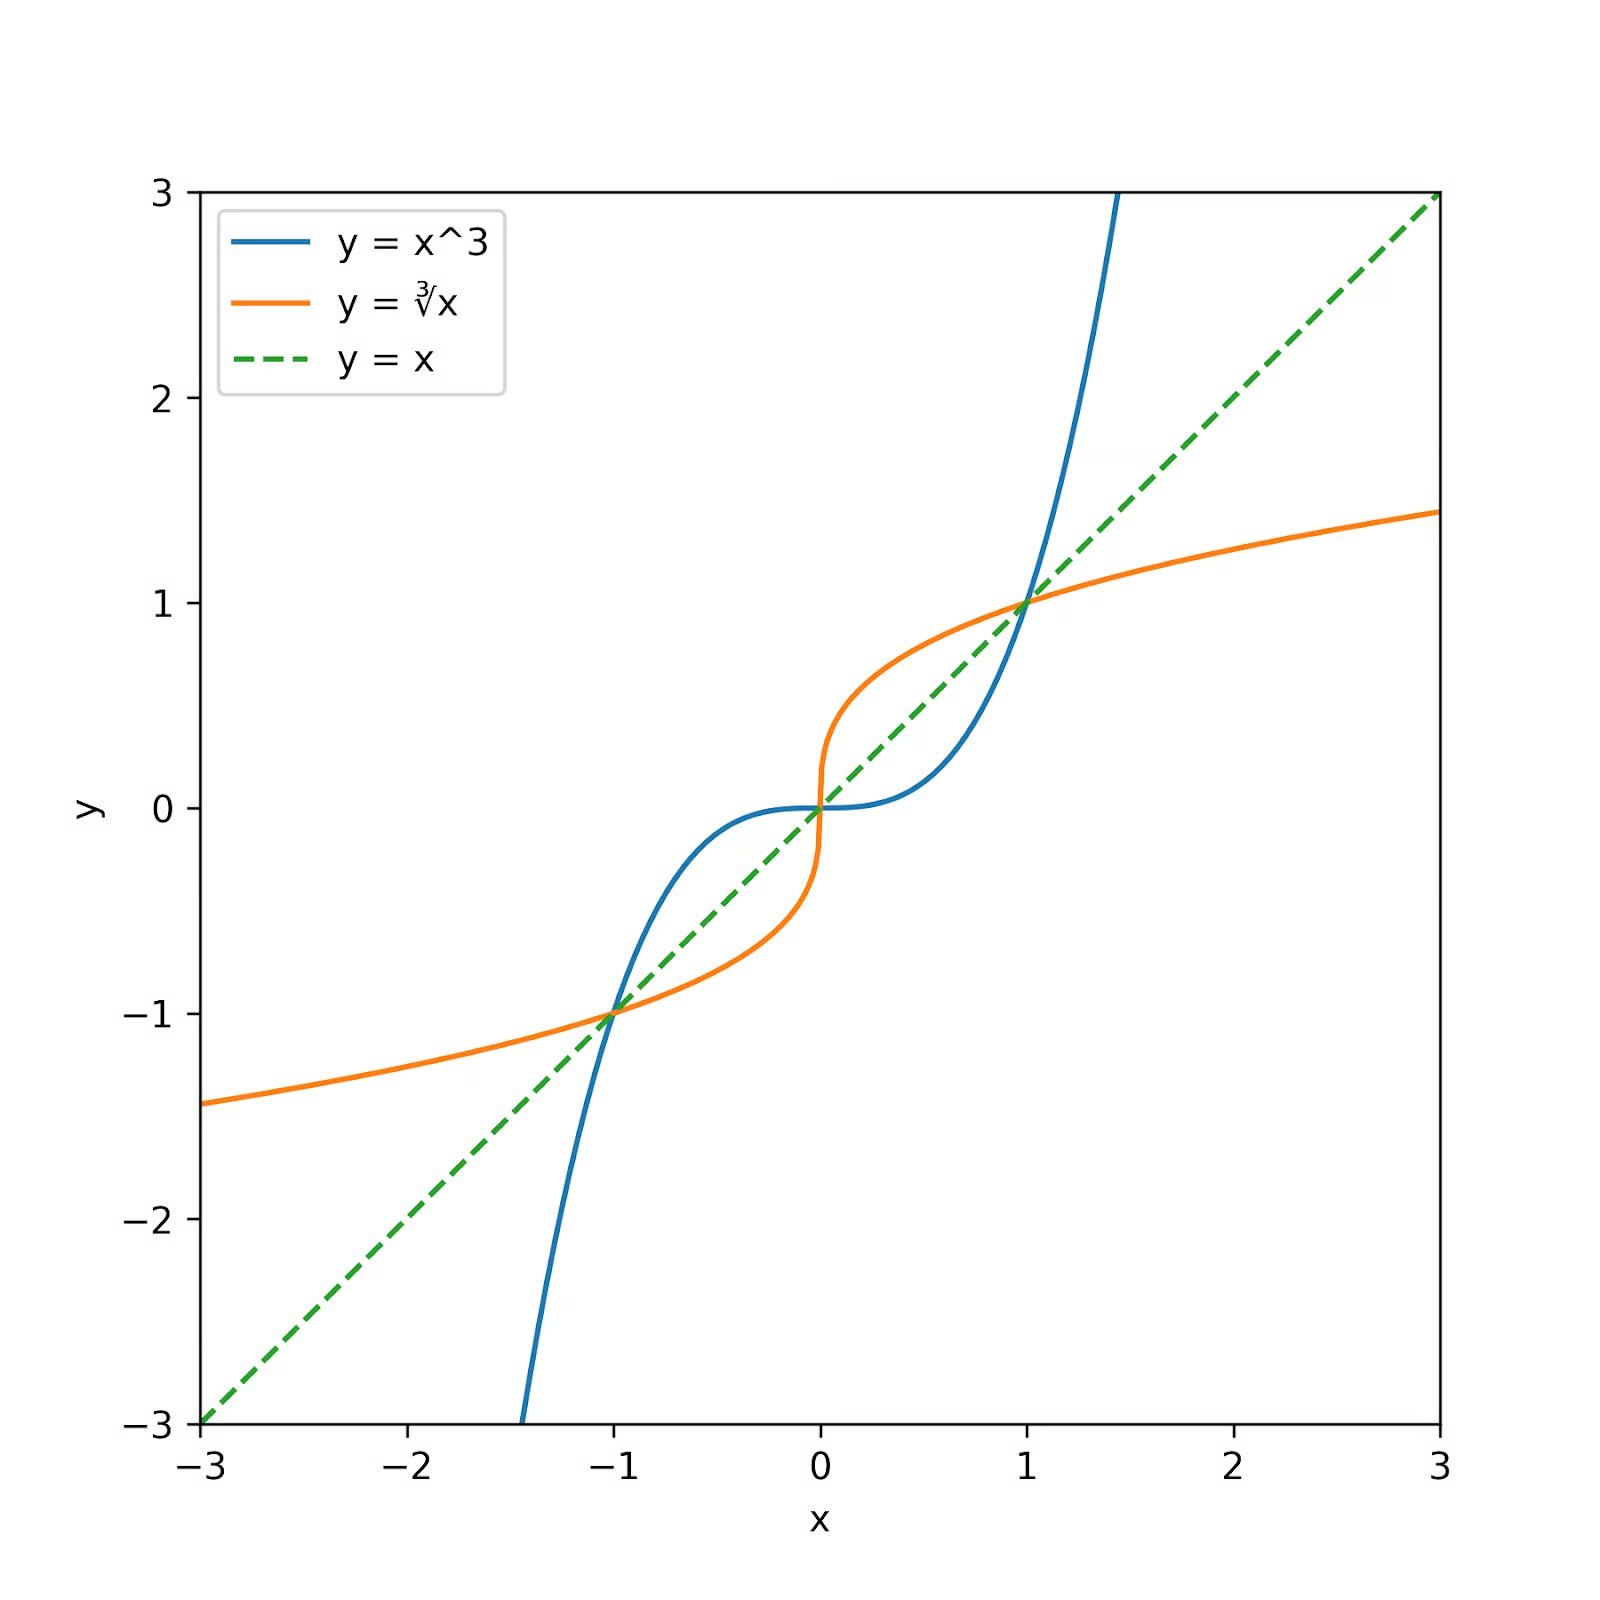
A função original (em azul) tem uma inversa (em laranja) refletida em relação à linha y = x.
Vamos ver dois tipos de funções estreitamente relacionados: exponenciais e logarítmicas.
Suponha que você deposite US$ 100 em uma poupança que paga 10% de juros compostos ao ano.
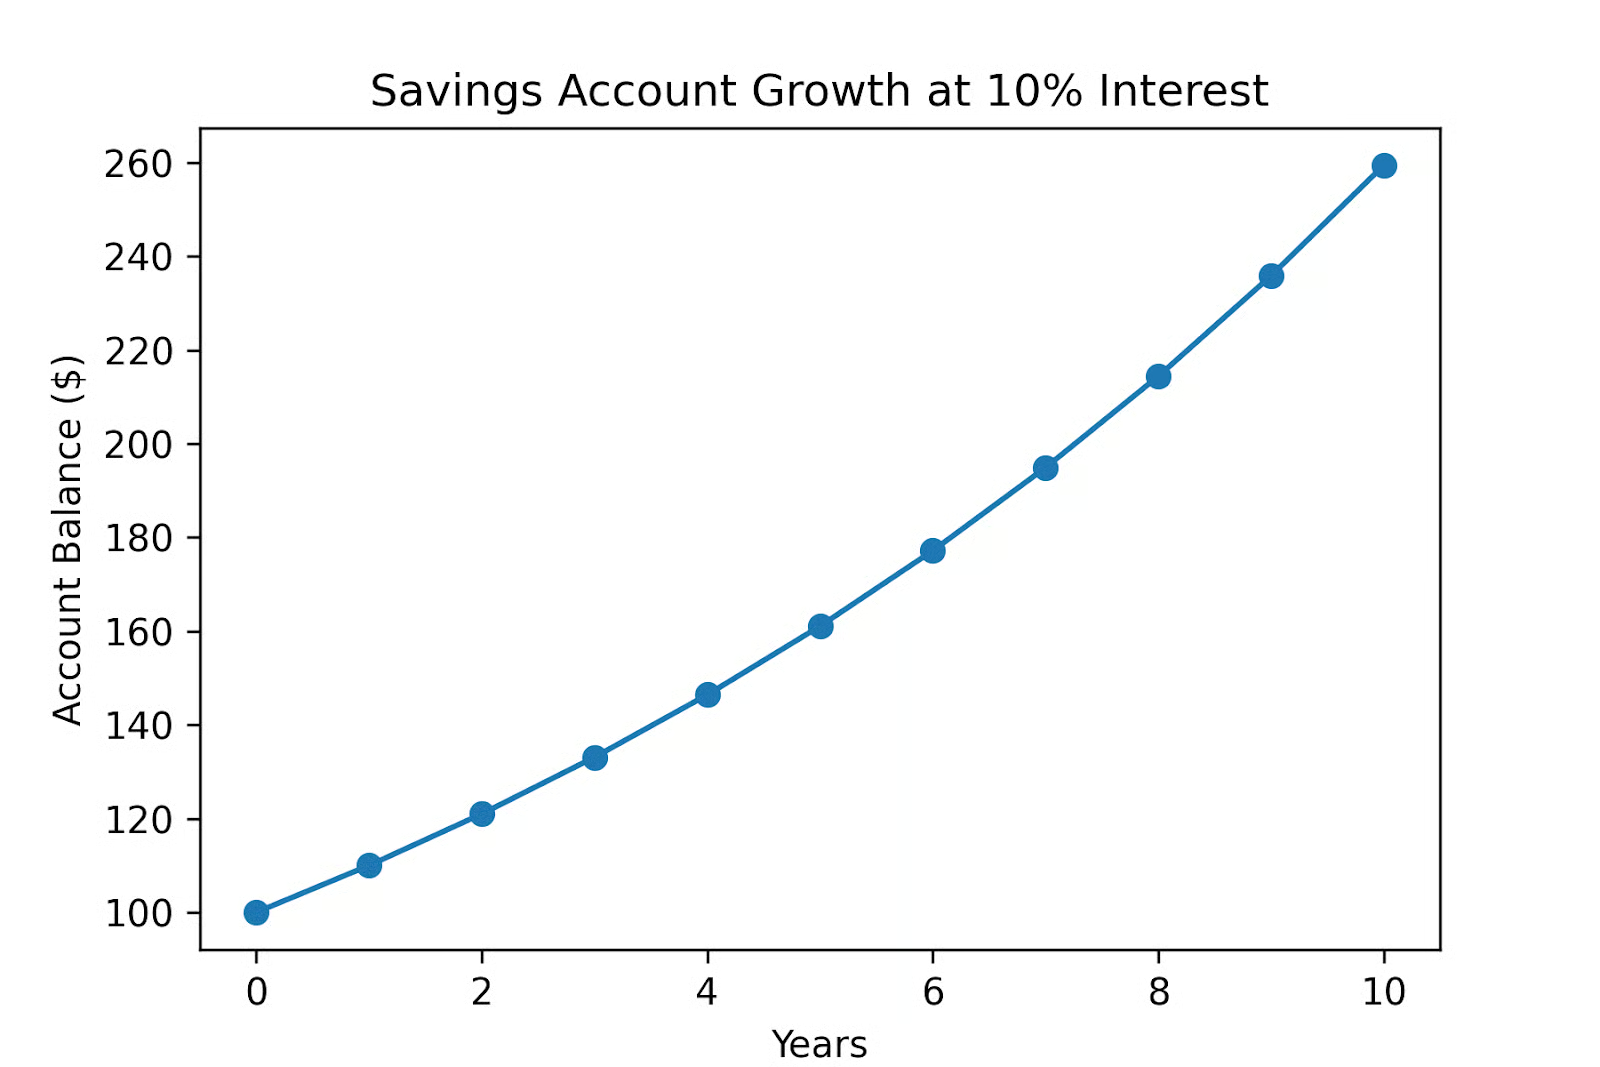
Este é um exemplo de crescimento exponencial. Cada passo multiplica o valor anterior por uma quantidade fixa. A função geral para crescimento exponencial é y = A bx, onde y é a saída, x é a entrada (muitas vezes, o tempo), A é o valor inicial e b é o fator de crescimento por unidade de x.
Em ciência de dados, modelos exponenciais aparecem em processos de crescimento composto, como crescimento de usuários ou de receita, em modelos de probabilidade e muitas outras aplicações.
Funções logarítmicas invertem a pergunta. Agora, em vez de perguntar o valor após x anos, suponha que você queira saber quanto tempo precisa para o dinheiro chegar a US$ 200, assumindo fator de 10% ao ano.
Agora precisamos saber quantas vezes 1,10 é multiplicado por si mesmo para chegar a 2. É essa a pergunta que os logaritmos respondem.
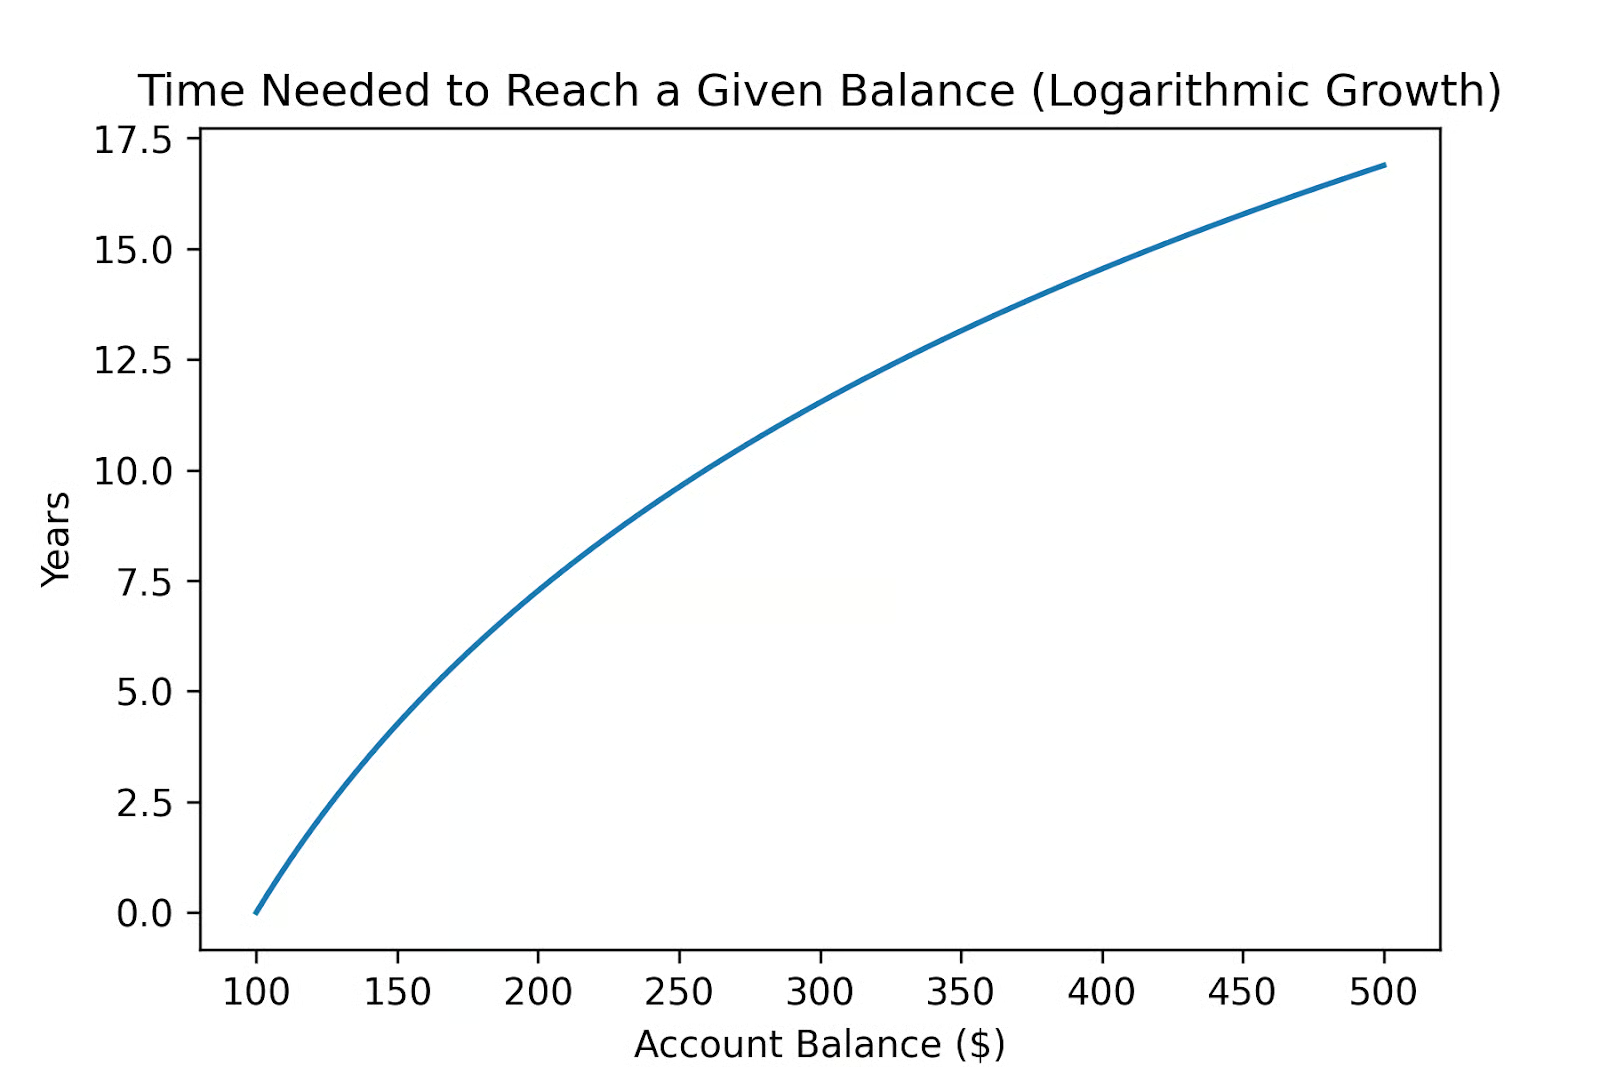
Olhando o gráfico, vemos que levará um pouco mais de 7 anos para o dinheiro dobrar.
Como vimos, funções logarítmicas são a inversa das exponenciais. Modelos exponenciais perguntam: após x meses, qual é o valor? Modelos logarítmicos perguntam: dado um valor, quantos meses levou para chegar lá?
Cientistas de dados costumam usar logaritmos para tornar uma distribuição assimétrica mais manejável. Por exemplo, rendas tendem a ser fortemente enviesadas à direita: poucos salários muito altos esticam a cauda superior, enquanto a maioria se concentra na base.
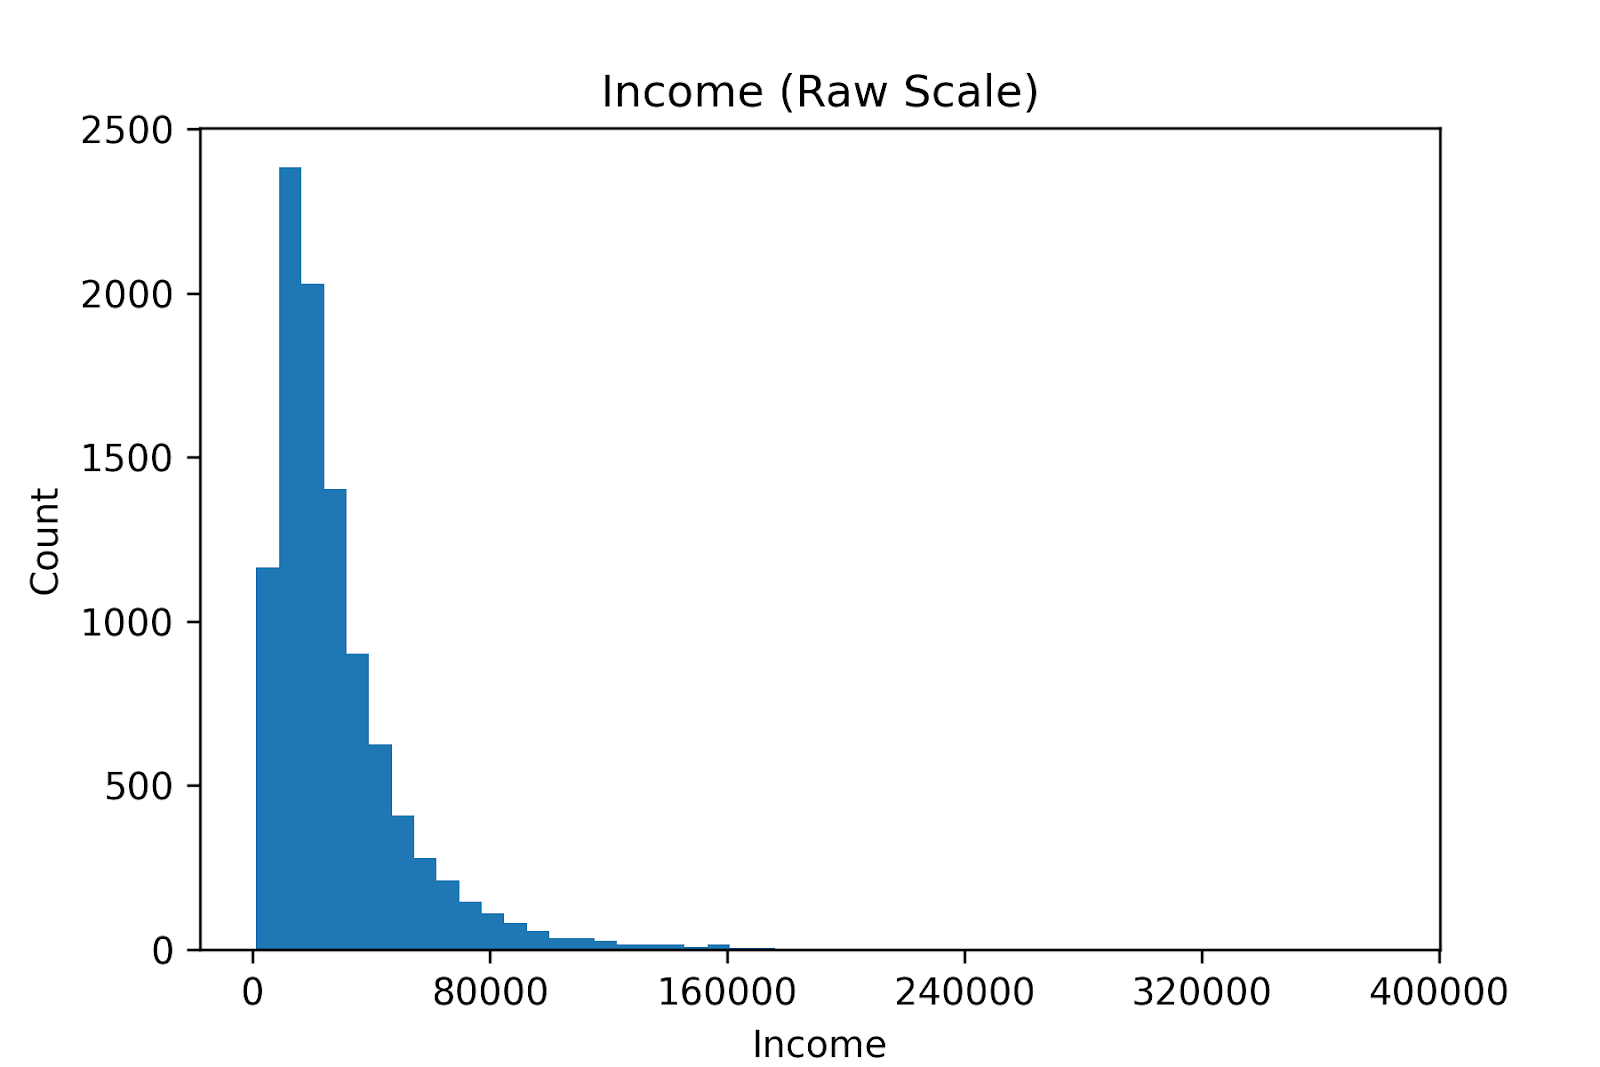
Você pode transformar os dados tomando o logaritmo de cada ponto:
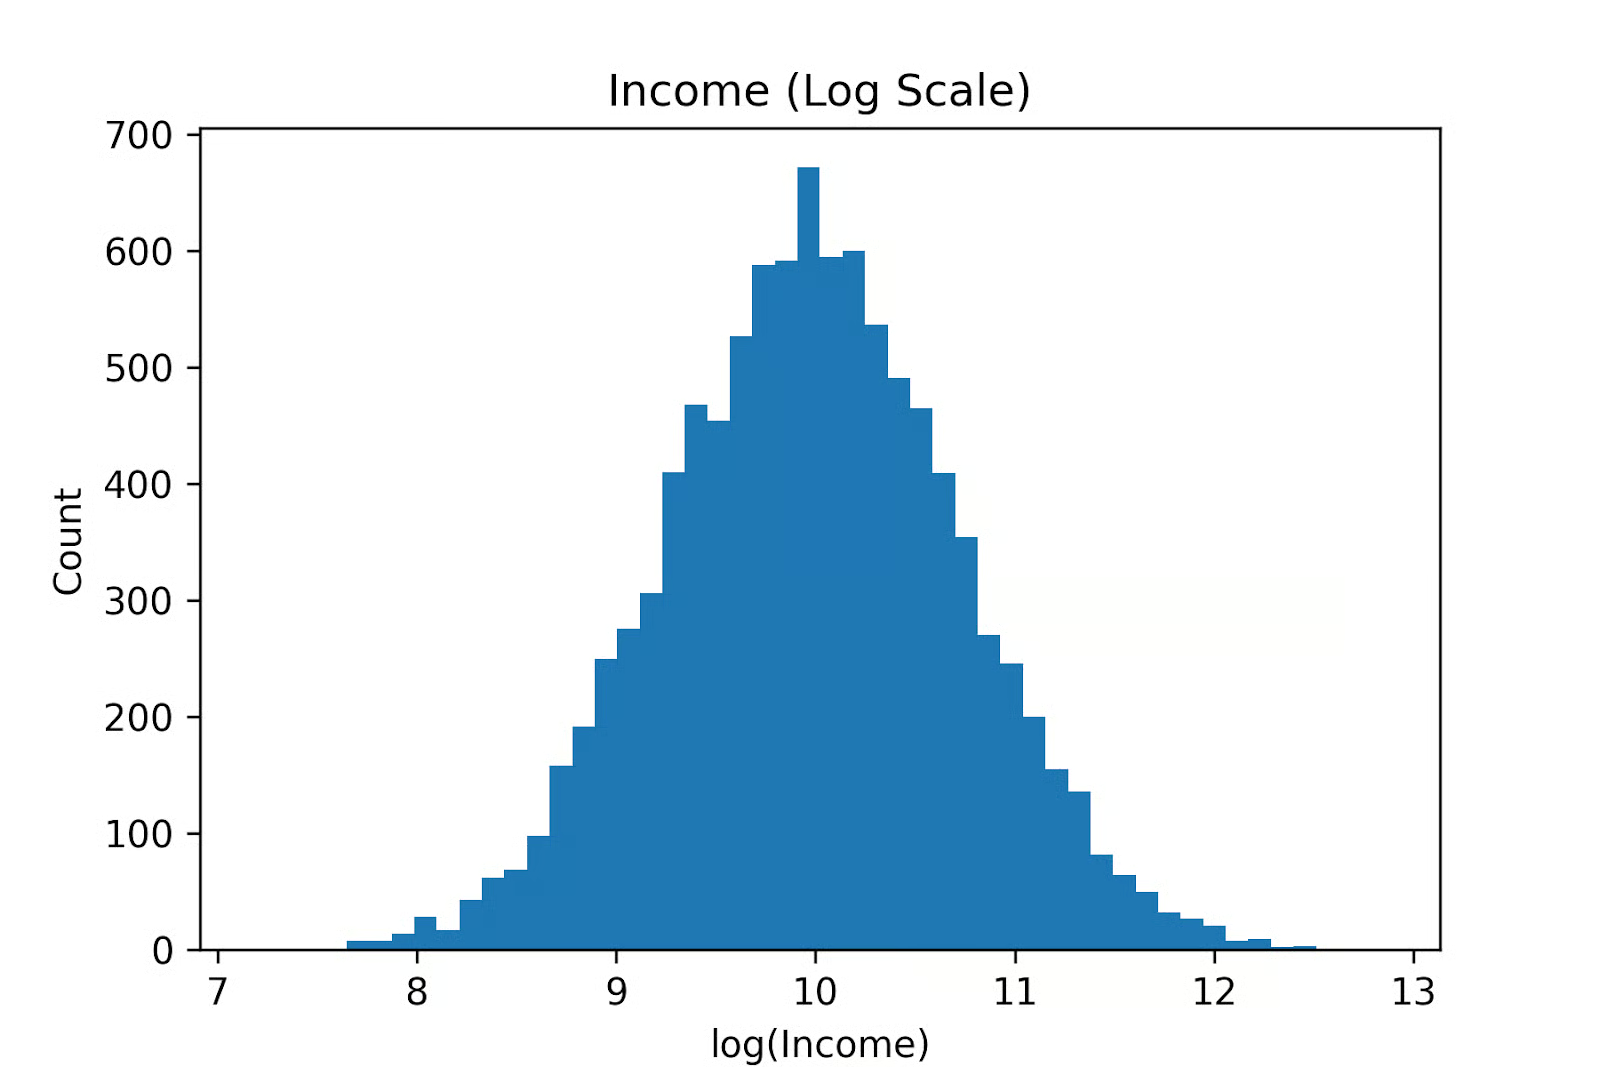
Rendas muito altas são comprimidas enquanto as demais são mais espaçadas. Transformações log mudam a pergunta de diferenças absolutas para diferenças relativas. Como resultado, a longa cauda direita colapsa e a distribuição muitas vezes se torna aproximadamente normal. Agora, a variância fica mais estável e podemos aplicar regressão linear.
O logaritmo tem papel central em uma das funções de perda mais usadas em classificação binária, conhecida como Cross-Entropy Loss ou log loss, definida para uma única amostra como:
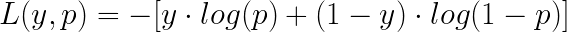
Aqui, a variável binária y (0 ou 1) é o valor verdadeiro da amostra, e p é a probabilidade prevista de que y seja da classe 1.
O log loss penaliza fortemente previsões confiantes porém incorretas. Prever probabilidade próxima de 0 quando o rótulo verdadeiro é 1 (ou vice-versa) resulta em grande penalidade, enquanto previsões incertas geram penalidades menores. Isso torna o log loss muito adequado para treinar classificadores probabilísticos como logistic regression.
Funções de ativação são usadas em redes neurais para garantir que a saída de cada camada seja não linear. As mais comuns são as funções sigmoid e ReLU.
A sigmoid function é uma função suave em forma de S, definida pela seguinte fórmula:
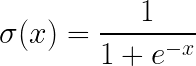
Ela recebe qualquer número real como entrada e retorna um valor estritamente entre 0 e 1. É usada para converter escores brutos em probabilidades.
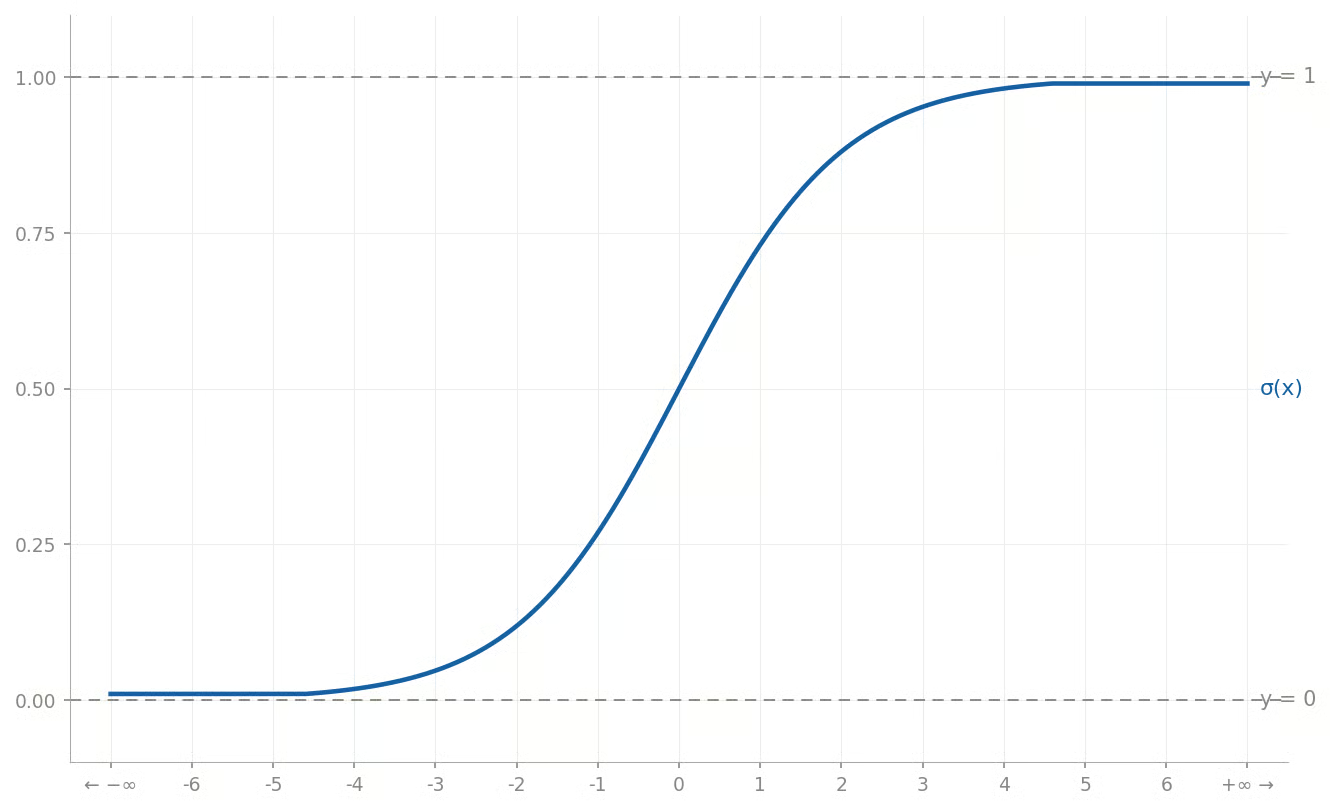
Um uso comum da função sigmoid é na regressão logística para classificação binária. A regressão logística calcula uma combinação linear das entradas para produzir um score. Esse score é convertido em probabilidade com a sigmoid. Probabilidades acima de um limiar (geralmente 0,5) são classificadas como 1; abaixo do limiar, como 0.
Para saber mais, confira nossos tutoriais Python Logistic Regression e Logistic Regression in R.
A função Rectified Linear Unit (ReLU) converte números negativos em 0 e deixa números positivos inalterados. Ela é definida como:
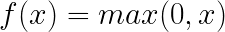
Para valores acima de 0, ela é igual à função identidade, como se vê no gráfico:
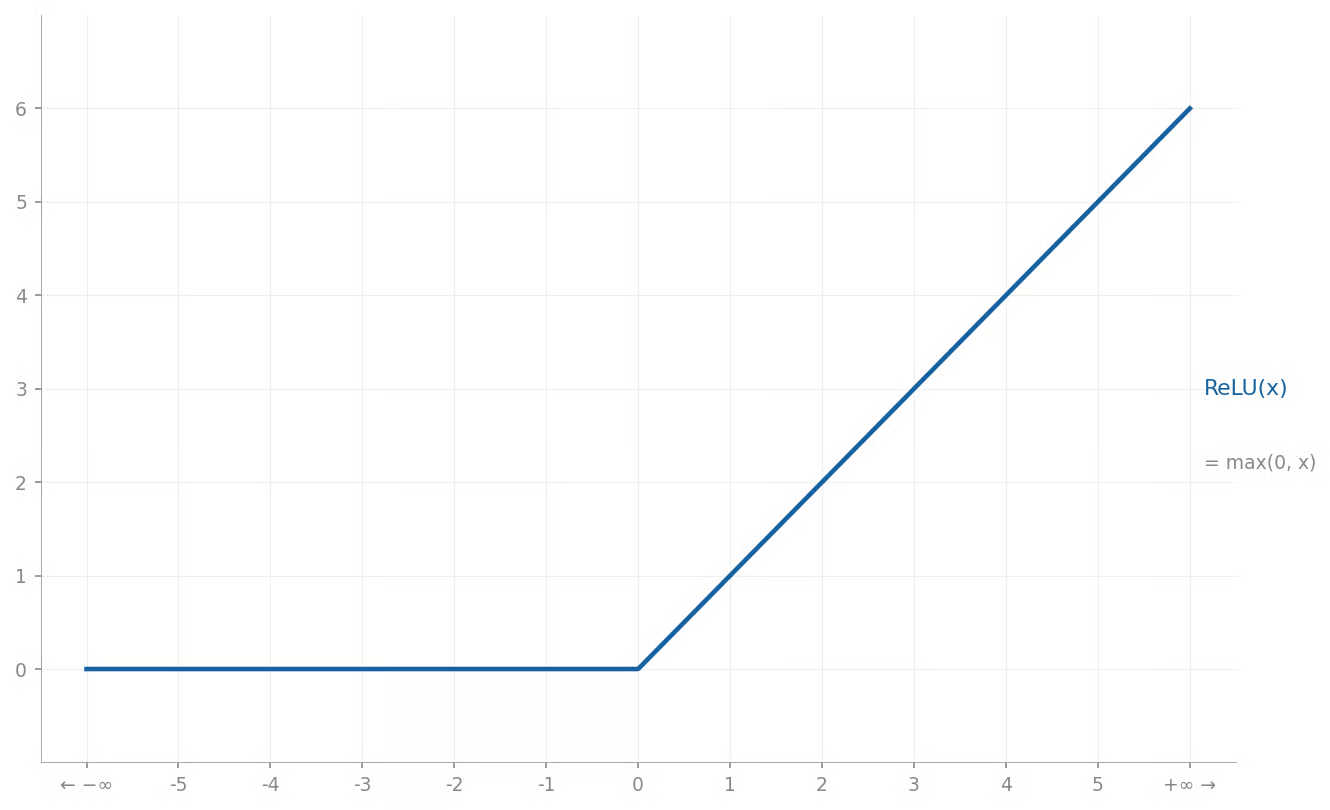
Assim como a sigmoid, ela atua como função de ativação não linear nas camadas ocultas de uma neural network. Porém, é computacionalmente simples, exigindo apenas uma operação de máximo, enquanto a sigmoid requer uma chamada exponencial mais custosa.
Como a ReLU zera todos os valores negativos, ela produz esparsidade na rede, onde muitos neurônios ficam zerados. Isso pode reduzir ruído e levar a representações mais eficientes.
Outro formato de função não linear aparece nas árvores de decisão, que particionam recursivamente o espaço de entrada em regiões menores dividindo por features e limiares até atender a um critério de parada.
Cada nó folha resultante recebe um valor de previsão. Assim, uma árvore de decisão pode ser vista como uma função por partes, em que cada região do domínio mapeia para um valor constante de previsão. Ao combinar várias regras locais, árvores de decisão capturam padrões complexos.
Por exemplo, você pode ver uma região bidimensional particionada assim:
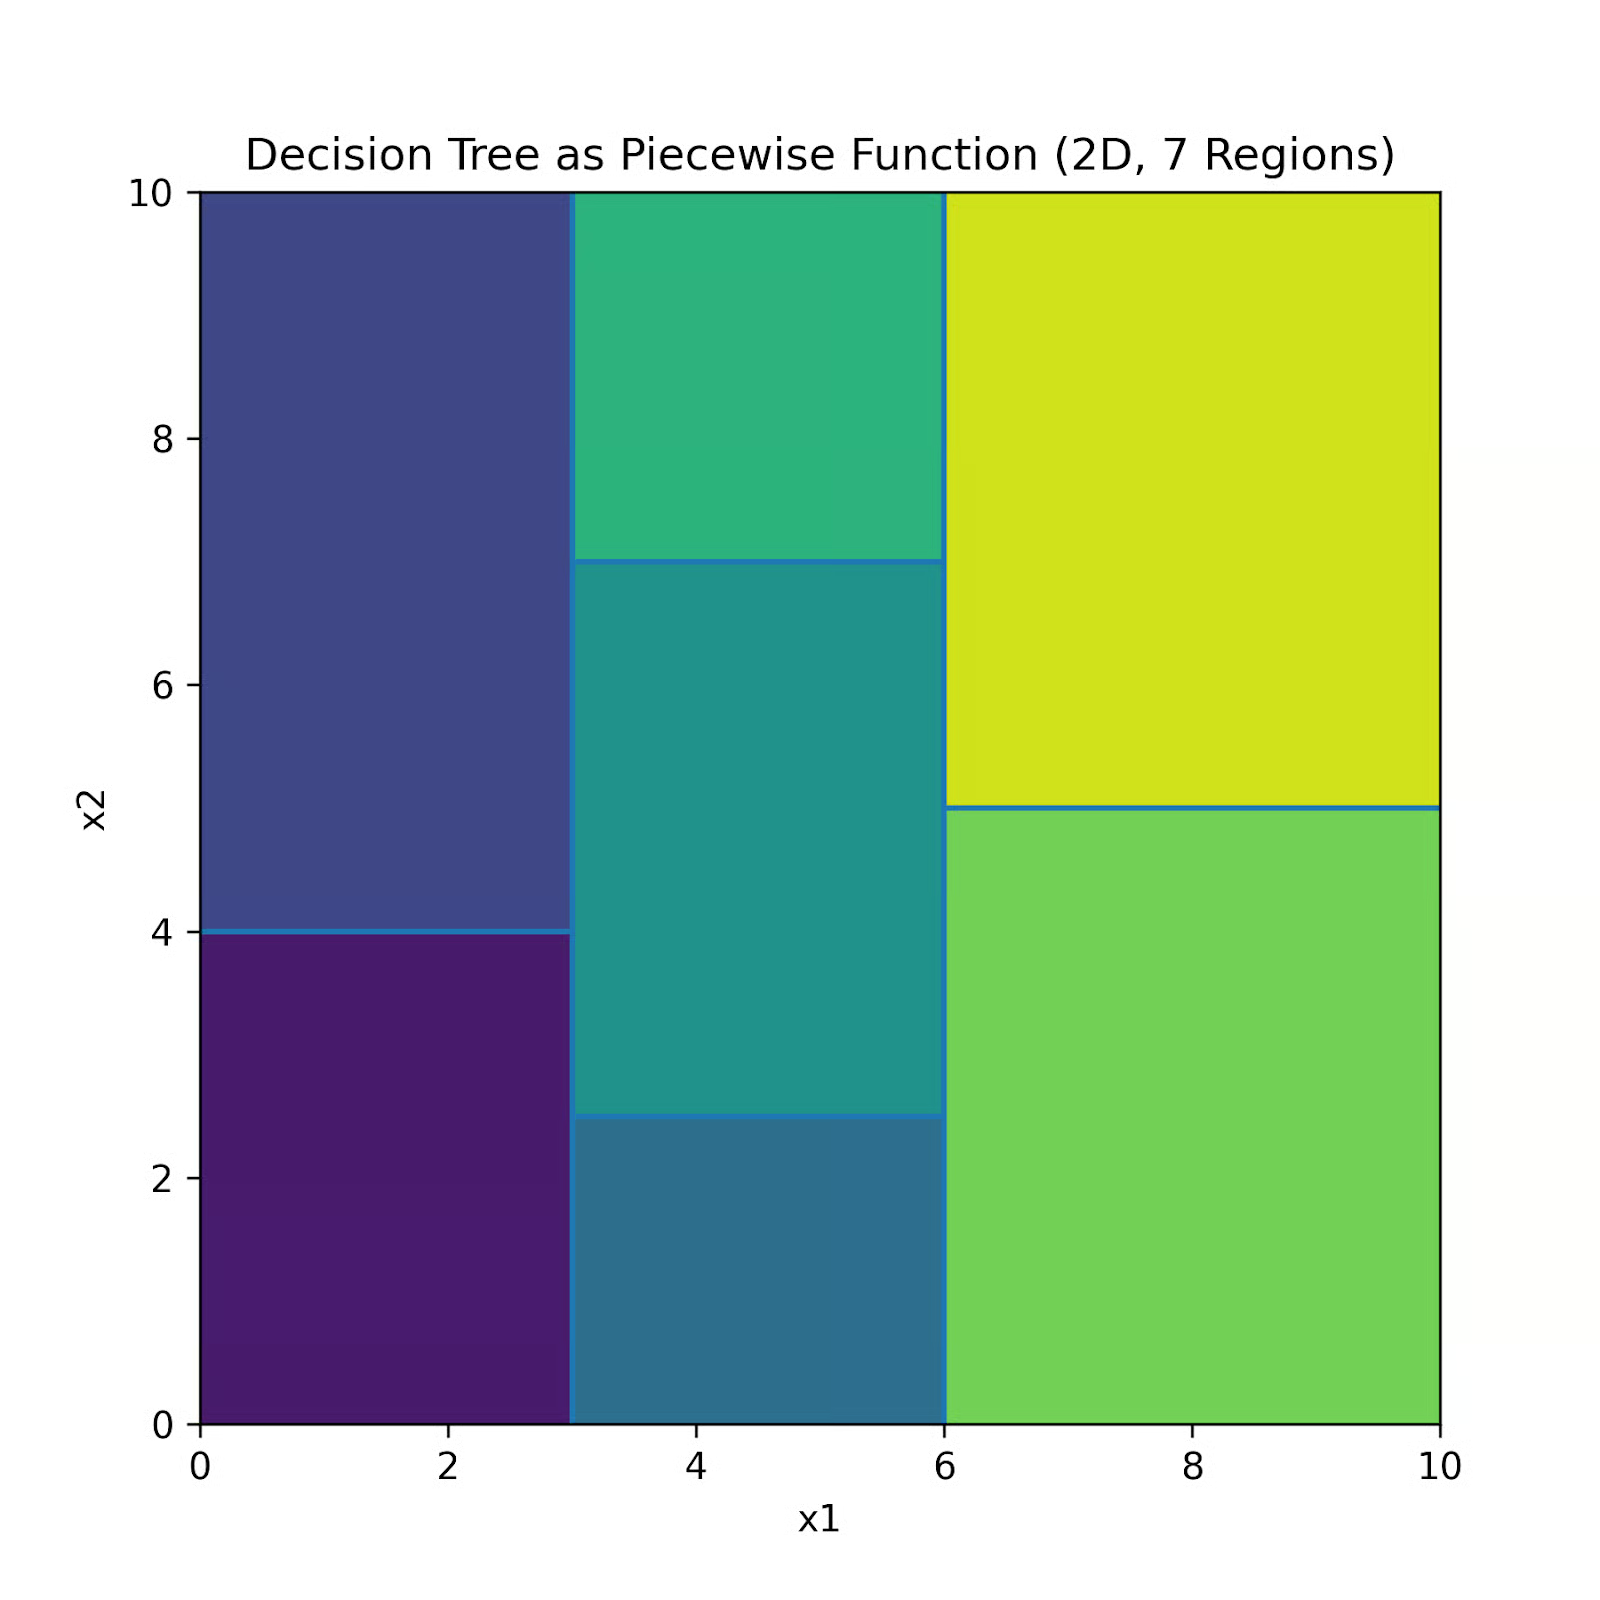
Esse mapa de calor corresponde às seguintes regiões:
|
Região |
Parte do domínio |
Valor da função |
|
1 |
x1 < 3 e x2 < 4 |
1 |
|
2 |
x1 < 3 e x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 e x2 < 2,5 |
3 |
|
4 |
3 ≤ x1 < 6 e 2,5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 e x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 e x2 < 5 |
6 |
|
7 |
x1 ≥ 6 e x2 ≥ 5 |
7 |
Otimização de funções é o processo de encontrar valores de entrada que maximizem ou minimizem uma função. Por exemplo, você pode querer maximizar uma função de lucro ou minimizar uma função de erro. O estudo de otimização é conhecido como "pesquisa operacional" e é um vasto corpo teórico em constante evolução.
Otimizar funções está intimamente ligado aos "extremos" locais e globais (pontos de máximo ou mínimo). Um "mínimo local" é o mínimo dentro de uma faixa específica, e um "mínimo global" é o menor valor da função como um todo.
Por exemplo, considere a função f(x) = x4 - 3x2 + x.
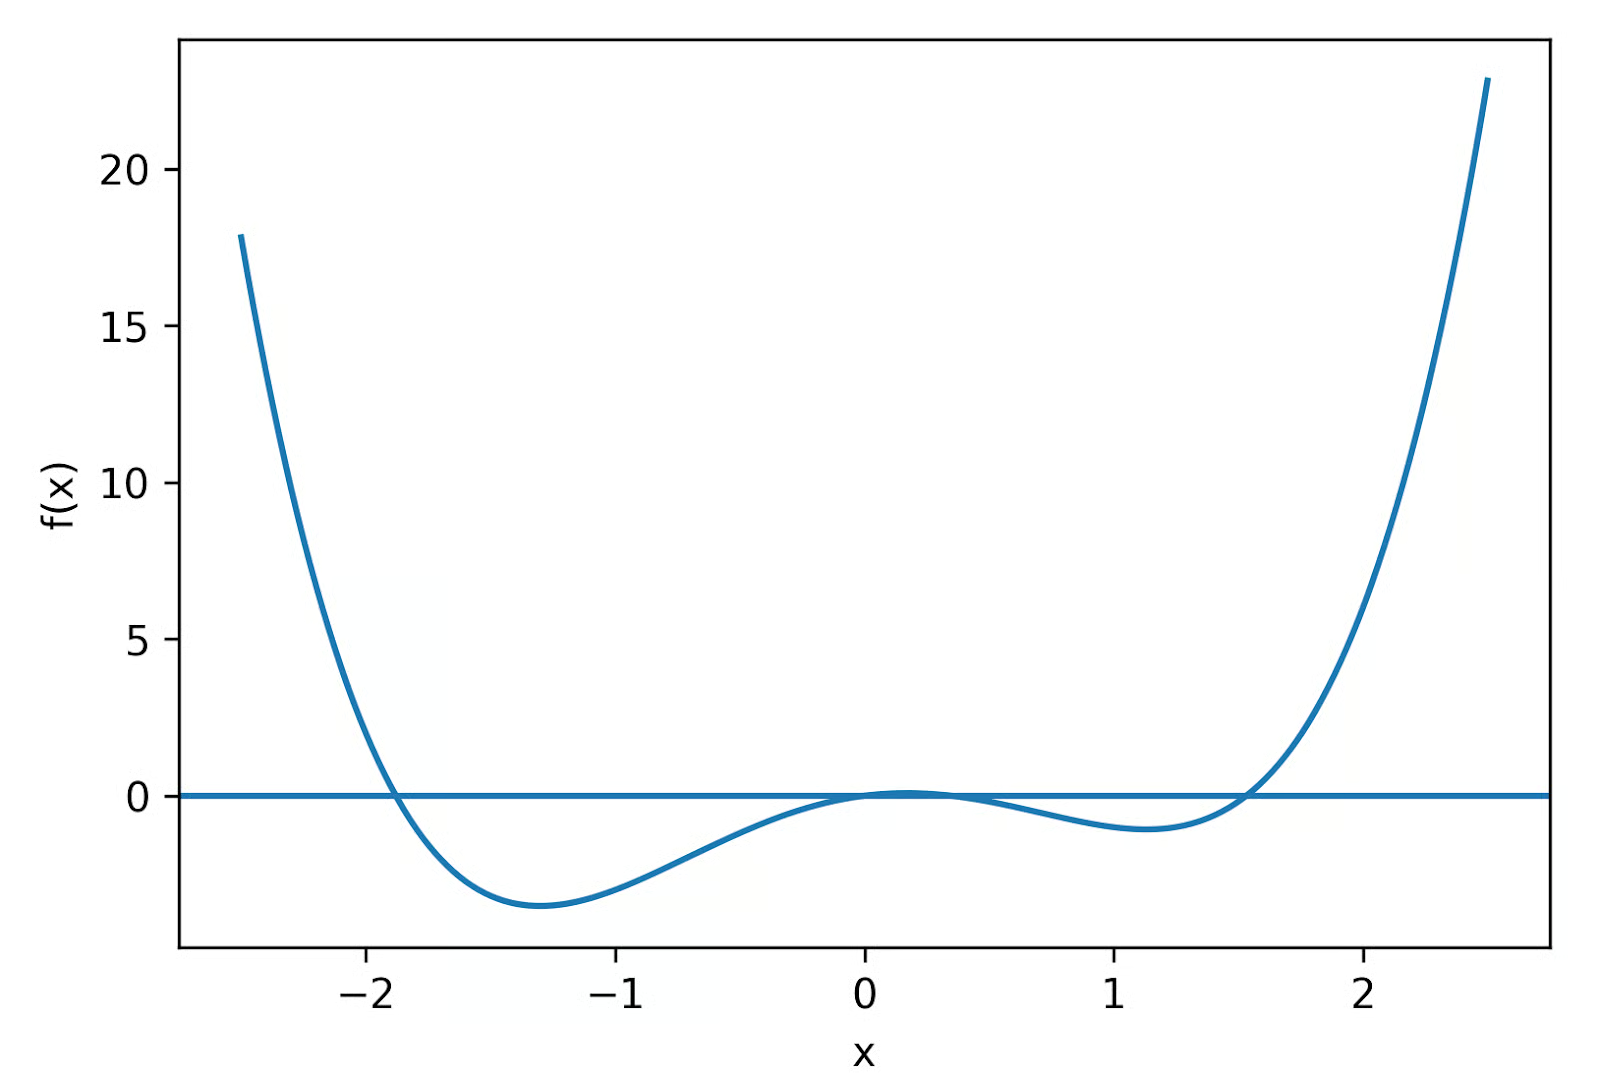
Há dois mínimos locais: um quando x é aproximadamente -1,30 e outro quando x é aproximadamente 1,13. O valor de y é menor quando x é -1,30, portanto esse é o mínimo global da função.
Para tarefas simples, como encontrar o melhor preço para maximizar lucro em um modelo de uma variável, basta derivar a função, igualar a zero e resolver para x. Para treinar redes neurais profundas, não é tão simples, mas a lógica é parecida.
O método de otimização mais importante para deep learning é o gradient descent. O gradiente é a generalização multidimensional da inclinação, indicando como a perda muda em relação a cada parâmetro.
Ele funciona movendo repetidamente na direção de maior declive de uma função. A cada passo, usa o gradiente para decidir para onde ir e um tamanho de passo para decidir o quanto avançar. Com o tempo, esse processo converge para um mínimo local.
Funções estão por toda parte em matemática, programação e ciência de dados. O "aprendizado" em machine learning nada mais é do que encontrar a melhor função (e seus parâmetros) para mapear entradas em saídas. Agora que você entende funções, coloque a mão na massa em Python ou na sua linguagem favorita!
Para ver como essas ideias se encaixam em fluxos reais de machine learning, continue com o curso Understanding Machine Learning.
Cursos de matemática
Curso
Curso
Curso
blog
DataCamp Team
11 min
blog
blog
Joleen Bothma
9 min
Tutorial
Karlijn Willems
14 min
Tutorial
DataCamp Team
13 min
Tutorial
Mark Pedigo
10 min


