

Exponentielle und logarithmische Funktionen
Schauen wir uns zwei eng verwandte Funktionstypen an: exponentielle und logarithmische Funktionen.
Exponentielle Funktionen
Angenommen, du legst 100 $ auf ein Sparkonto mit 10 % Zinsen, jährlich verzinst, an.
- Im Jahr 0 (vor Ablauf eines Jahres) gilt: f(0) = 100 $.
- Nach Jahr 1: f(1) = 100 $ × 1,10 = 110 $.
- Nach Jahr 2: f(2) = 110 $ × 1,10 = (100 $ × 1,10) × 1,10 = 100 $ × 1,102 = 121 $.
- Nach Jahr 3: f(3) = 121 $ × 1,10 = (100 $ × 1,10 × 1,10) × 1,10 = 100 $ × 1,103 = 133,10 $
- Nach x Jahren: f(x) = 100 $ × 1,10x.
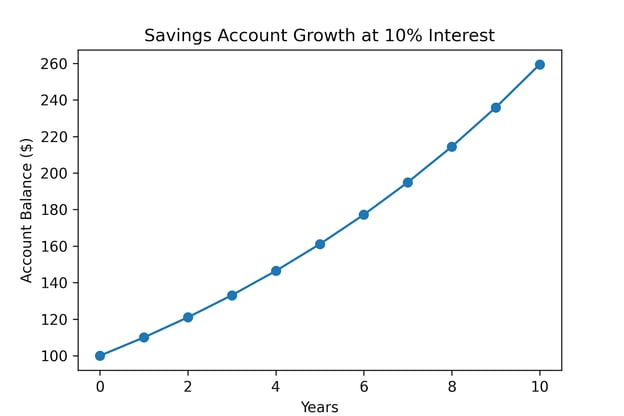
Das ist ein Beispiel für exponentielles Wachstum. Jeder Schritt multipliziert den vorherigen mit einem festen Faktor. Die allgemeine Form lautet y = A bx, wobei y die Ausgabe, x die Eingabe (oft Zeit), A der Anfangsbetrag und b der Wachstumsfaktor pro Einheit x ist.
In der Data Science tauchen exponentielle Modelle z. B. bei Zinseszinseffekten wie Nutzer‑ oder Umsatzwachstum, in Wahrscheinlichkeitsmodellen und vielen weiteren Anwendungen auf.
Logarithmische Funktionen
Logarithmen drehen die Frage um. Statt zu fragen, wie hoch der Betrag nach x Jahren ist, möchtest du nun wissen: Wie lange muss das Geld wachsen, um 200 $ zu erreichen – bei 10 % Zinseszins?
- Stelle die Gleichung auf: 200 = 100 × 1,10x
- Teile durch 100: 2 = 1 × 1,10x
Jetzt müssen wir wissen, wie oft sich 1,10 mit sich selbst multipliziert, um 2 zu ergeben. Genau das beantworten Logarithmen.
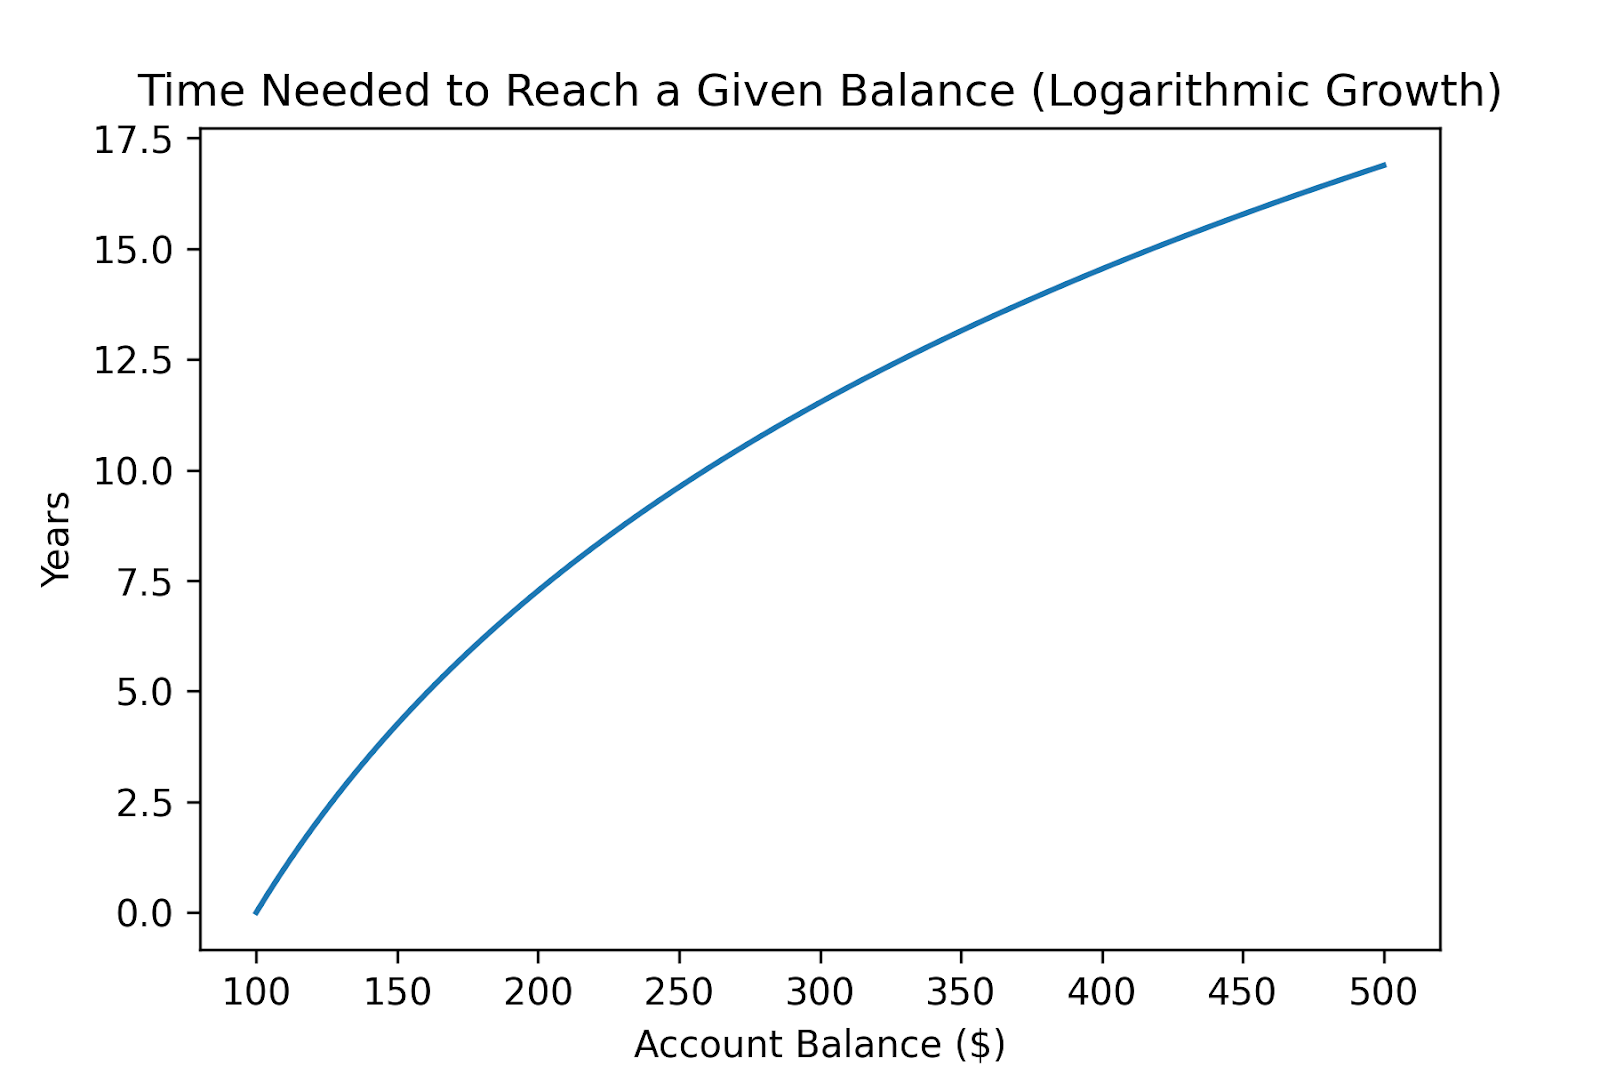
Aus dem Graphen liest du ab: Es dauert etwas mehr als 7 Jahre, bis sich das Geld verdoppelt.
Wie gezeigt, sind logarithmische Funktionen die Inversen der exponentiellen Funktionen. Exponentielle Modelle fragen: Wie groß ist der Betrag nach x Monaten? Logarithmische Modelle fragen: Gegeben einen Betrag, wie viele Monate hat es gedauert, um dorthin zu kommen?
Data Scientists nutzen Logarithmen oft, um eine stark schiefe Verteilung beherrschbar zu machen. Einkommensverteilungen sind z. B. meist stark rechtsschief: Wenige Spitzenverdiener ziehen den oberen Rand, während die meisten am unteren Ende konzentriert sind.
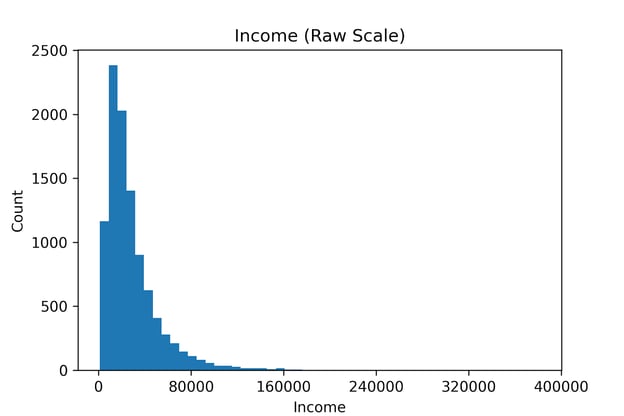
Du kannst die Daten transformieren, indem du von jedem Datenpunkt den Logarithmus nimmst:
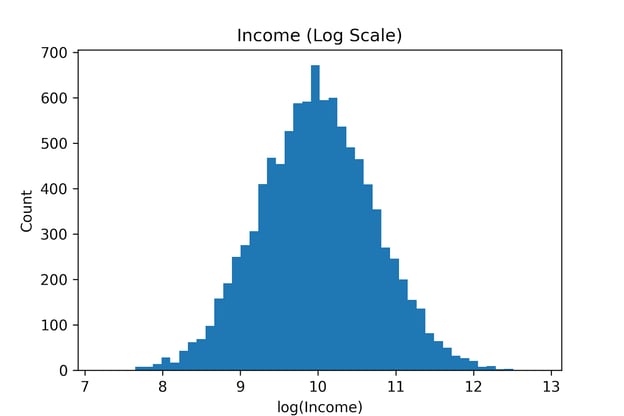
Hohe Einkommen werden gestaucht, andere gestreckt. Log‑Transforms verschieben die Perspektive von absoluten auf relative Unterschiede. Dadurch schrumpft der lange rechte Schwanz, und die Verteilung wird oft näherungsweise normal. Die Varianz ist stabiler, und wir können lineare Regression anwenden.
Der Logarithmus spielt eine zentrale Rolle in einer der am häufigsten verwendeten Verlustfunktionen für binäre Klassifikation: der Cross‑Entropy‑Loss oder Log‑Loss, für ein einzelnes Sample definiert als:
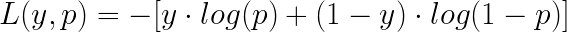
Hier ist die binäre Variable y (0 oder 1) der wahre Wert eines Samples, und p ist die vorhergesagte Wahrscheinlichkeit, dass y zur Klasse 1 gehört.
- Ist y gleich 1, ist der Verlust −log(p); je näher p an 0 liegt, desto stärker die Strafe.
- Ist y gleich 0, ist der Verlust −log(1−p); je näher p an 1 liegt, desto stärker die Strafe.
Log‑Loss bestraft selbstsichere, aber falsche Vorhersagen stark. Eine Wahrscheinlichkeit nahe 0 zu prognostizieren, wenn das wahre Label 1 ist (oder umgekehrt), führt zu einer hohen Strafe; unsichere Vorhersagen werden geringer bestraft. Das macht Log‑Loss geeignet für probabilistische Klassifikatoren wie Logistische Regression.
Nichtlineare Aktivierungsfunktionen
Aktivierungsfunktionen sorgen in Neuronalen Netzen dafür, dass die Ausgabe jeder Schicht nichtlinear ist. Häufig sind Sigmoid und ReLU.
Sigmoidfunktion
Die Sigmoidfunktion ist eine glatte, S‑förmige Funktion mit folgender Definition:
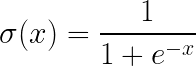
Sie nimmt jede reelle Zahl als Eingabe und gibt einen Wert strikt zwischen 0 und 1 aus. Damit lassen sich Rohscores in Wahrscheinlichkeiten umwandeln.
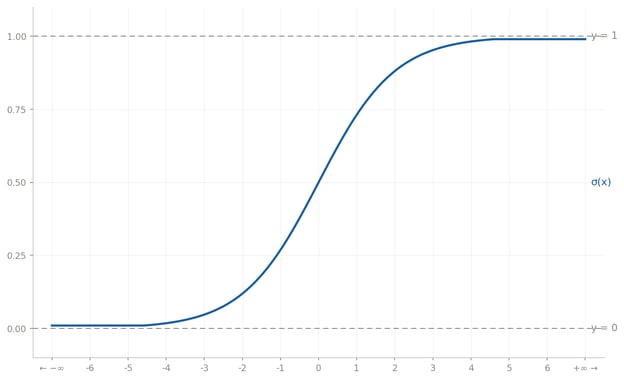
Ein typischer Einsatz ist die logistische Regression für binäre Klassifikation. Sie berechnet eine lineare Kombination der Eingaben zu einem Score, der anschließend per Sigmoid in eine Wahrscheinlichkeit transformiert wird. Wahrscheinlichkeiten oberhalb eines Schwellwerts (typisch 0,5) werden als 1 klassifiziert, darunter als 0.
Mehr dazu in unseren Tutorials Python Logistic Regression und Logistic Regression in R.
ReLU (Rectified Linear Unit)
Die Funktion Rectified Linear Unit (ReLU) setzt negative Zahlen auf 0 und lässt positive unverändert. Sie ist definiert als:
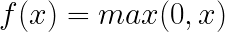
Für Werte über 0 entspricht sie der Identitätsfunktion, wie der Graph zeigt:
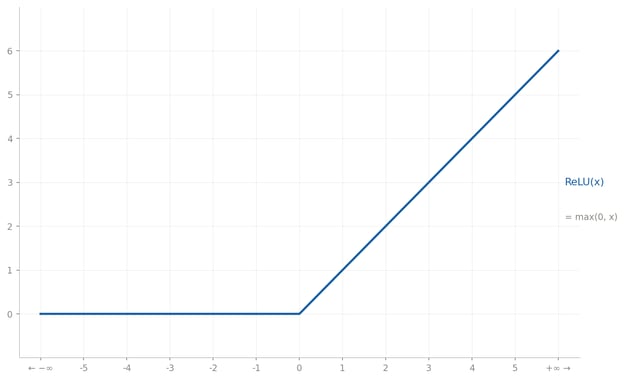
Wie die Sigmoidfunktion dient sie als nichtlineare Aktivierung in den verborgenen Schichten eines Neural Network. Sie ist jedoch rechnerisch sehr einfach (nur eine Maximum‑Operation), während die Sigmoidfunktion einen teuren Exponentialaufruf benötigt.
Weil ReLU alle negativen Werte auf 0 setzt, erzeugt sie Sparsity im Netzwerk – viele Neuronen werden auf Null gesetzt. Das kann Rauschen reduzieren und zu effizienteren Repräsentationen führen.
Entscheidungsbäume als stückweise Funktionen
Eine weitere Form nichtlinearer Funktionen findet sich bei Entscheidungsbäumen. Sie partitionieren den Eingaberaum rekursiv in kleinere Bereiche, indem sie anhand von Features und Schwellenwerten splitten, bis ein Abbruchkriterium erreicht ist.
Jedes resultierende Blatt bekommt einen Vorhersagewert. Ein Entscheidungsbaum lässt sich daher als stückweise definierte Funktion auffassen, bei der jeder Bereich der Definitionsmenge auf einen konstanten Vorhersagewert abbildet. Durch das Zusammensetzen vieler lokaler Regeln können Entscheidungsbäume komplexe Muster erfassen.
Zum Beispiel könnte ein zweidimensionaler Bereich so partitioniert werden:
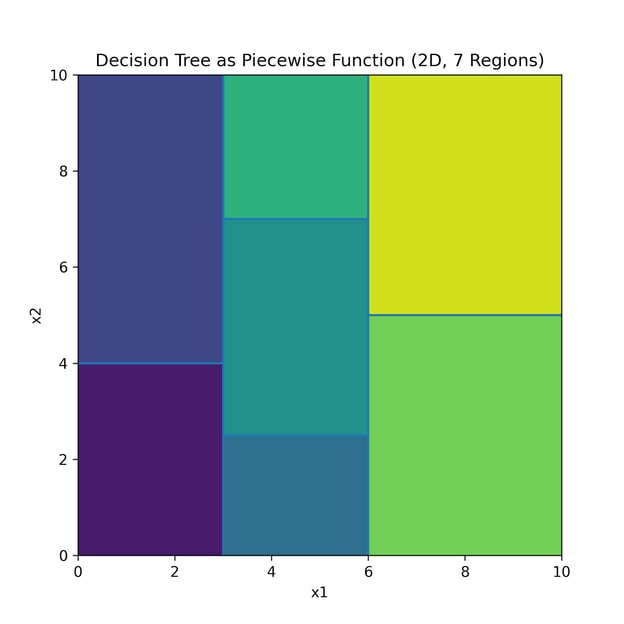
Diese Heatmap entspricht folgenden Bereichen:
|
Bereich |
Definitionsstück |
Funktionswert |
|
1 |
x1 < 3 und x2 < 4 |
1 |
|
2 |
x1 < 3 und x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 und x2 < 2.5 |
3 |
|
4 |
3 ≤ x1 < 6 und 2.5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 und x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 und x2 < 5 |
6 |
|
7 |
x1 ≥ 6 und x2 ≥ 5 |
7 |
Funktionsoptimierung
Unter Funktionsoptimierung versteht man das Finden von Eingabewerten, die eine Funktion maximieren oder minimieren. Du möchtest z. B. eine Gewinnfunktion maximieren oder eine Fehlerfunktion minimieren. Dieser Bereich wird als "Operations Research" bezeichnet und ist ein großes, stetig wachsendes Feld mathematischer Theorie.
Das Optimieren hängt eng mit lokalen und globalen "Extrema" (Maximum/Minimum) einer Funktion zusammen. Ein "lokales Minimum" ist ein Minimum in einem bestimmten Bereich, ein "globales Minimum" das Minimum der gesamten Funktion.
Betrachte z. B. f(x) = x4 − 3x2 + x.
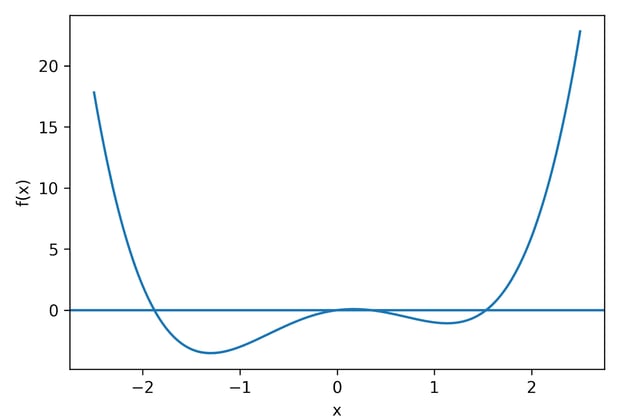
Es gibt zwei lokale Minima: eines bei x ≈ −1,30 und ein weiteres bei x ≈ 1,13. Der y‑Wert ist bei x = −1,30 kleiner; das ist also das globale Minimum.
Für einfache Optimierungsaufgaben – etwa den besten Preis in einem eindimensionalen Preismodell – reicht es, die Ableitung zu bilden, gleich Null zu setzen und nach x zu lösen. Beim Training tiefer neuronaler Netze ist es nicht ganz so simpel, läuft aber ähnlich.
Die wichtigste Optimierungsmethode im Deep Learning ist der Gradientenabstieg. Der Gradient verallgemeinert die Steigung auf mehrere Dimensionen und zeigt, wie sich der Loss in Bezug auf jeden Parameter ändert.
Dabei bewegt man sich wiederholt in Richtung der steilsten Abwärtsänderung der Funktion. In jedem Schritt geben Richtung (Gradient) und Schrittweite vor, wohin und wie weit man geht. Mit der Zeit führt das zu einem lokalen Minimum.
Fazit
Funktionen sind allgegenwärtig in Mathematik, Programmierung und Data Science. "Lernen" im Machine Learning bedeutet im Kern, die beste Funktion (und ihre Parameter) zu finden, um Eingaben auf Ausgaben abzubilden. Jetzt, da du Funktionen kennst, schreibe welche in Python – oder in deiner Lieblingssprache!
Wenn du sehen möchtest, wie diese Ideen in echten ML‑Workflows zusammenspielen, mach mit dem Kurs Understanding Machine Learning weiter.
Mathematische Funktionen: FAQs
Was ist eine Funktion in der Mathematik?
Eine mathematische Funktion ist eine Regel, die jeder Eingabe genau eine Ausgabe zuordnet.
Warum hat eine mathematische Funktion nur eine Ausgabe?
Andernfalls wäre die Regel per Definition keine Funktion, da sie mehrdeutig wäre.
Sind Programmierfunktionen dasselbe wie mathematische Funktionen?
Nicht ganz. Programmierfunktionen können Seiteneffekte haben oder gar keinen sinnvollen Wert zurückgeben – das ist bei mathematischen Funktionen nicht erlaubt.
Warum sind Funktionen in der Data Science wichtig?
Weil Modelle Funktionen sind. Sie ordnen Features Vorhersagen, Wahrscheinlichkeiten oder Scores zu.
Was sind Definitionsmenge und Zielmenge einer Funktion?
Die Definitionsmenge ist die Menge der gültigen Eingaben. Die Zielmenge ist die Menge der beabsichtigten Ausgaben.

Mark Pedigo, PhD, ist ein angesehener Datenwissenschaftler mit Fachwissen in den Bereichen Datenwissenschaft im Gesundheitswesen, Programmierung und Bildung. Mit einem Doktortitel in Mathematik, einem B.S. in Informatik und einem Professional Certificate in KI verbindet Mark technisches Wissen mit praktischer Problemlösungskompetenz. In seiner beruflichen Laufbahn war er unter anderem an der Aufdeckung von Betrug, der Vorhersage von Kindersterblichkeit und Finanzprognosen beteiligt und hat an der Kostenschätzungssoftware der NASA mitgearbeitet. Als Pädagoge hat er auf dem DataCamp und an der Washington University in St. Louis unterrichtet und junge Programmierer angeleitet. In seiner Freizeit genießt Mark mit seiner Frau Mandy und seinem Hund Harley die Natur in Minnesota und spielt Jazz-Piano.




Angehende und Junior‑Data Scientists stolpern oft über den Begriff "Funktion" – doch was er genau bedeutet, ist nicht immer eindeutig.
In diesem Artikel erfährst du, was eine mathematische Funktion ist, welche Mengen ihre Eingabe- und Ausgabewerte beschreiben und worin sich stetige und diskrete Werte unterscheiden. Du siehst, wie Funktionen in der Technologie eingesetzt werden, lernst gängige Funktionen in der Data Science kennen und wie man sie optimiert. Unterwegs findest du Python‑Code, um Funktionen zu manipulieren und zu visualisieren.
Wenn du das Schreiben und Verwenden eigener Funktionen in Python üben willst, empfehle ich dir unseren Kurs Writing Functions in Python.
Was ist eine Funktion in der Mathematik?
In der Mathematik ordnet eine Funktion jeder Eingabe genau eine Ausgabe zu. Jede gültige Eingabe führt zu genau einer Ausgabe. Eine Eingabe kann nicht mehrere Ausgaben haben.
Beispiel: 32 Grad Fahrenheit entsprechen 0 Grad Celsius. Der Fahrenheit‑Wert entspricht einem Wert in Celsius – und zwar genau einem. Du kannst nicht zwei verschiedene Ausgabewerte (Celsius) für eine gültige Eingabe (Fahrenheit) haben.
Weitere Beispiele sind Lohnabrechnungen mit Stundenlohn. Wenn du 20 $ pro Stunde verdienst und 40 Stunden arbeitest, erhältst du 20 × 40 = 800 $.
Nicht jede Zuordnung ist eine Funktion. Manchmal ist es logisch, mehrere Ausgaben für eine Eingabe zuzulassen. Ein Name zu einer Person passt zum Beispiel nicht: Der Name "John Smith" kann mehreren Personen zugeordnet sein.
In der Mathematik werden Regeln oft so formuliert, dass es genau eine Ausgabe pro gültiger Eingabe gibt. Manchmal bildet das die Realität direkt ab (Lohnabrechnung). In anderen Fällen formuliert man Probleme absichtlich als Funktionen, um sie handhabbar zu machen: Statt einem Wirrwarr aus Eingaben und Ausgaben wird das Modell so aufgesetzt, dass eine Eingabe nicht zu mehreren Ausgaben führen kann.
Du kannst dir eine Funktion als "Maschine" vorstellen, die eine Eingabe (oft x) annimmt, sie irgendwie verarbeitet und eine Ausgabe (oft y) erzeugt.
Hier nimmt eine Maschine links auf dem Förderband Eingaben auf, verarbeitet sie und erzeugt rechts ein fröhliches grünes Häkchen.
Multivariate Funktionen akzeptieren mehrere Eingaben, liefern aber genau eine Ausgabe. Du kannst dir das wie eine Datenzeile mit mehreren Variablen oder Features vorstellen, die auf einen einzelnen Ausgabewert abgebildet werden.
Funktionsschreibweise und Terminologie
Wie schreibt man die Gleichung auf? Beim Temperaturbeispiel lautet die Formel y = f(x) = (5/9) (x - 32), wobei x die Temperatur in Fahrenheit und y in Celsius ist. Um diese Notation zu verstehen, lies sie von links nach rechts.
Links steht y, also die Ausgabe. Die Schreibweise f(x) zeigt, dass du eine Funktion namens f verwendest, die eine Eingabe x nimmt. Beachte: f(x) bedeutet hier nicht f mal x.
Rechts steht die Rechenvorschrift: Nimm die Eingabe x, ziehe 32 ab und multipliziere das Ergebnis mit 5/9.
Definitionsmenge, Zielmenge und Wertebereich
Angenommen, du misst einmal täglich die Außentemperatur und hast k Messwerte, bezeichnet als (x1, x2, …, xk), aufgezeichnet. Du möchtest eine Funktion, die nach n vergangenen Tagen den bisherigen Jahresdurchschnitt zurückgibt. Definiere eine Funktion, die eine positive ganze Zahl n mit n ≤ k entgegennimmt und den Durchschnitt der ersten n Temperaturen als reelle Zahl zurückgibt. Die Notation dafür lautet f: {1, 2, …, k} → ℝ.
Es ist hilfreich, Fachbegriffe für die beteiligten Mengen zu haben: das führt zu Definitionsmenge, Zielmenge und Wertebereich.
Nun betrachten wir den Wertebereich. Betrachte eine einfache quadratische Funktion: y = f(x) = x2. Um Definitions- und Zielmenge zu spezifizieren, schreibe f: ℝ → ℝ.
Damit weißt du, dass sowohl die Definitionsmenge (Eingaben) als auch die Zielmenge (Ausgaben) aus reellen Zahlen bestehen. Mit etwas Überlegung wird aber klar: Die tatsächlich auftretenden Ausgaben können nicht alle reellen Zahlen sein.
Da jedes Quadrat nichtnegativ ist, besteht die tatsächliche Ausgabemenge nicht aus allen reellen Zahlen, sondern nur aus nichtnegativen reellen Zahlen. Dafür verwenden wir den Begriff Wertebereich: Der Wertebereich dieser Funktion sind alle nichtnegativen reellen Zahlen.
Die Zielmenge ist die potenzielle Ausgabemenge; der Wertebereich ist die Menge der tatsächlich realisierten Ausgaben. Du wählst die Zielmenge passend zum beabsichtigten Ausgabetyp, und du ermittelst den Wertebereich, also die tatsächlich auftretenden Ausgabewerte.
Stetige und diskrete Variablen
Damit sind wir bei der Unterscheidung zwischen stetigen und diskreten Variablen:
Eine stetige Variable im Intervall [0, 1] kann z. B. die Werte 0, 0,5, 0,4141 oder jeden anderen reellen Wert im Intervall annehmen. Stetige Variablen werden häufig in Modellen verwendet, deren Ausgabe theoretisch jeden Wert annehmen kann, etwa in der Regression.
In der binären Klassifikation interessiert dich jedoch nur, ob 0 oder 1: Ein Bild enthält eine Katze oder nicht. In einer Multiklassen‑Klassifikation gibt es ebenfalls nur endlich viele Werte, z. B. 0 für Hund, 1 für Katze, 2 für Pferd.
Das Problem, das du lösen willst, bestimmt die Art der Funktion: Klassifikationsprobleme liefern diskrete Werte, Regressionsprobleme stetige Funktionen.
Vektorschreibweise
Manchmal müssen mehrere Variablen in eine Funktion eingehen. Etwa wenn du eine Feature‑Zeile in eine Machine‑Learning‑Funktion gibst. In diesem Fall kannst du die Features in einem Container bündeln und diesen übergeben. Eine Möglichkeit ist ein Vektor. Das Modell nimmt einen Eingabevektor x = [x1, x2, x3] und gibt ein Ziel y aus.
In Python verwendest du typischerweise ein NumPy‑Array, um einen Vektor darzustellen.
Dieser Code nimmt einen Vektor mit den Zahlen 3, 4 und 7.1 und gibt den Durchschnitt zurück.
Für eine Sammlung von Vektoren nutzt man oft die DataFrame‑Datenstruktur aus der pandas‑Bibliothek.
Dieser Code gibt eine pandas Series mit den Zeilendurchschnitten zurück, einen Wert pro Zeile. In diesem Fall:
Funktionen in der Technologie
Der Funktionsbegriff ist in der Technologie allgegenwärtig. Aus praktischen Gründen ist "Funktion" dort nicht immer so streng definiert wie in der Mathematik. Programmierfunktionen können beispielsweise Seiteneffekte haben, die andere Variablen als die Ausgabe verändern – mathematische Funktionen nicht.
Tabellenkalkulationen
Funktionen sind in Tabellen weit verbreitet, etwa in Excel‑Formeln. Du willst vielleicht die Summe, den Mittelwert oder den Median einer Spalte berechnen. In Tabellenkalkulationen folgen Funktionen derselben Definition wie die oben eingeführten mathematischen Funktionen.
Eine Sache, in der Tabellen glänzen (Wortspiel beabsichtigt), sind Bedingte Funktionen: Sie erlauben dir, komplexere Bedingungen mit Funktionen wie
IF()zu bauen.Du könntest beispielsweise die Gesamtsumme deiner Zahlungen an die Hypothekenbank in einem Jahr ermitteln. Dazu würdest du wahrscheinlich die
SUM()‑Funktion deiner Tabelle verwenden.Programmiersprachen
Funktionen sind in Programmiersprachen allgegenwärtig. Je nach Sprache ist die Definition von "Funktion" weniger streng als in der Mathematik. Manche Sprachen erlauben, dass eine Funktion mehrere Werte oder gar keinen Wert zurückgibt.
Eine Funktion kann etwa Werte entgegennehmen und eine Ausgabe auf dem Bildschirm drucken, aber keinen expliziten Rückgabewert liefern. Eine Python‑Funktion sieht so aus:
Dieser Code erzeugt die Ausgabe: "My name is Mark and my favorite color is blue." Ein mathematischer Wert wird nicht explizit zurückgegeben.
Code in vielen gängigen Sprachen wie Python kann in Funktionen auch andere Seiteneffekte haben, etwa das Ändern einer globalen Variable. Obwohl Seiteneffekte möglich und erlaubt sind, sind sie unerwünscht – sie erschweren Tests, Debugging und das Verständnis des Programms.
Aus diesen Gründen sind einige "funktionale" Sprachen wie Scala und Haskell stärker und strenger um den Funktionsbegriff herum aufgebaut.
Machine Learning
Im Machine‑Learning‑Kontext sind die Eingaben Features, die Funktion ist das Modell, und die Ausgabe ist die Vorhersage des Modells. Ein solches Modell wird oft als "Black Box" beschrieben, weil nicht unbedingt klar ist, wie die Eingabefeatures verarbeitet werden, um die Vorhersage zu erzeugen – unsere frühere Maschinen‑Metapher passt hier also noch besser:
In dieser Illustration werden die Features in die Modell‑"Maschine" eingespeist, die sie auf irgendeine Weise verarbeitet und eine Vorhersage ausgibt. Im Vergleich zu einfachen, deterministischen Funktionen wie der Temperaturumrechnung ist das Innenleben schwerer zu beschreiben.
Im ML sind die Eingaben Feature‑Vektoren; die Zielmenge kann aus Wahrscheinlichkeiten, Klassen oder reellwertigen Vorhersagen bestehen.
Im Deep Learning werden Funktionen meist nicht direkt auf Eingaben angewendet, sondern die Güte des Modells mit einer Kostenfunktion bewertet. Eine Kostenfunktion ist ein Maß dafür, wie falsch ein Modell über den Trainingssatz liegt. Sie vergleicht Vorhersagen mit den wahren Labels oder Werten und fasst die Fehler zu einer Zahl zusammen.
Gängige Funktionen in der Data Science
Bestimmte Funktionen begegnen dir in der Data Science ständig: lineare, logarithmische und exponentielle Funktionen sowie nichtlineare Aktivierungsfunktionen für Deep Learning.
Lineare Funktionen
Starten wir mit dem Klassiker: lineare Funktionen.
Steigung
Angenommen, du hast Appetit auf Äpfel. Im Supermarkt kosten Äpfel 0,75 $ pro Pfund. Ein Pfund kostet also 0,75 $, 2 Pfund kosten 2 × 0,75 $ = 1,50 $, und 3 Pfund kosten 3 × 0,75 $ = 2,25 $. Jedes weitere Pfund erhöht die Gesamtkosten um einen festen Betrag.
Als Funktionsschreibweise könntest du die Formel als f(x) = 0.75 x schreiben. Die Zahl 0,75 ist die Steigung der linearen Funktion. Die Steigung ist die Änderungsrate der Ausgabe pro Einheit der Eingabe.
Um so eine Funktion zu plotten, kannst du ähnlichen Code verwenden:
Solche Funktionen heißen lineare Funktionen. Jede Erhöhung der Eingabe x trägt denselben festen Betrag zur Ausgabe y bei. Wie der Name sagt, ergibt die Zeichnung eine Gerade.
Achsenabschnitt
Angenommen, du lässt dir die Lebensmittel liefern. Der Supermarkt verlangt eine Pauschale von 2,00 $ für die Lieferung. Dann lautet die Funktion für deine Äpfel f(x) = 0.75 x + 2. Wie zuvor ist 0,75 die Steigung. Die Zahl 2, also der Schnittpunkt mit der y‑Achse, ist der "y‑Achsenabschnitt". Er ist der Ausgabewert bei Eingabe 0.
Die Gesamtkosten sind Summe aus Äpfeln und Liefergebühr. Allgemein lässt sich eine univariate lineare Funktion als f(x) = mx + b schreiben, wobei m die Steigung und b der y‑Achsenabschnitt ist.
Multivariate lineare Funktion
Wahrscheinlich willst du mehr als nur Äpfel essen. Angenommen, du kaufst auch Brot und Erdnussbutter. Äpfel kosten 0,75 $ pro Pfund, ein Laib Brot 2,50 $, ein Glas Erdnussbutter 3,00 $. Deine Einkaufsfunktion lautet dann:
Diese Funktion gilt weiterhin als linear, da sie in jeder Variablen linear ist. Allgemein hat eine lineare Funktion die Form:
Das entspricht dem Aufsummieren deiner Mengen, jeweils multipliziert mit ihren Gewichten (ein anderes Wort für Steigung in diesem Kontext), plus dem Achsenabschnitt.
In Vektorschreibweise sieht das so aus:
Das T steht für „transponiert“ und ist nötig, um die Vektormultiplikation von w und x durchzuführen.
Lineare Regression
Betrachte Kraftstoffeffizienz versus Geschwindigkeit. Du vermutest: Je schneller man fährt, desto geringer die Effizienz. Du sammelst fünfzig Datenpunkte zwischen 45 und 65 mph und siehst folgendes Muster:
Würdest du alle Punkte verbinden, ergäbe das ein unübersichtliches Zickzack. Der Trend ist in diesem Bereich jedoch näherungsweise linear. Wenn wir die Geschwindigkeit x nennen, lautet die Funktion für dieses Diagramm:
Um eine solche "beste Gerade" zu finden, nutzt du das Verfahren der einfachen linearen Regression.
Eine solche Gerade lässt sich in Python mit Matplotlib und Seaborn berechnen und visualisieren:
Lineare Regression funktioniert auch mit mehreren Variablen. Angenommen, du modellierst linear mit Geschwindigkeit (x), Fahrzeuggewicht (y) und Motorgröße (z). Die resultierende Formel für die multivariate lineare Regression lautet:
Hier steht der Koeffizient jeder Variablen für das Gewicht bzw. die Bedeutung dieses Features – jeweils bei konstant gehaltenen anderen Variablen.
Inverse Funktionen
Jetzt drehen wir die Apfel‑Frage um: Wenn du 2,25 $ für Äpfel ausgegeben hast – wie viele Pfund hast du gekauft? Antwort: 2,25 / 0,75 = 3, also drei Pfund. Diese "Umkehrung" einer Funktion heißt Inverse der Funktion. Im Beispiel ohne Achsenabschnitt ist die Inverse:
Beachte: Das „−1“ bezeichnet hier die inverse Funktion, nicht den Kehrwert.
Achte darauf, dass sich die Definitionsmenge ändern kann. Angenommen, deine ursprüngliche Funktion ist:
Diese Funktion ist für alle reellen Zahlen außer 2 definiert, da der Nenner nicht Null sein darf. Die inverse Funktion ist
Aus demselben Grund ist die Inverse für alle Eingaben außer 0 definiert.
Ein weiteres Stolpersteinchen: Die Inverse kann wegen Mehrdeutigkeit keine Funktion sein. Betrachte y = x2. Die Umkehrung wäre dann:
Wie am Plus/Minus zu sehen ist, hat die Inverse zwei Ausgaben für eine Eingabe – sie ist also keine Funktion, es sei denn, wir schränken die Definitionsmenge ein (z. B. auf x ≥ 0).
Grafisch sind eine Funktion und ihre Inverse (falls vorhanden) Spiegelbilder an der Geraden y = x. Betrachte y = x3. Der Graph dieser Funktion und ihrer Inversen ist: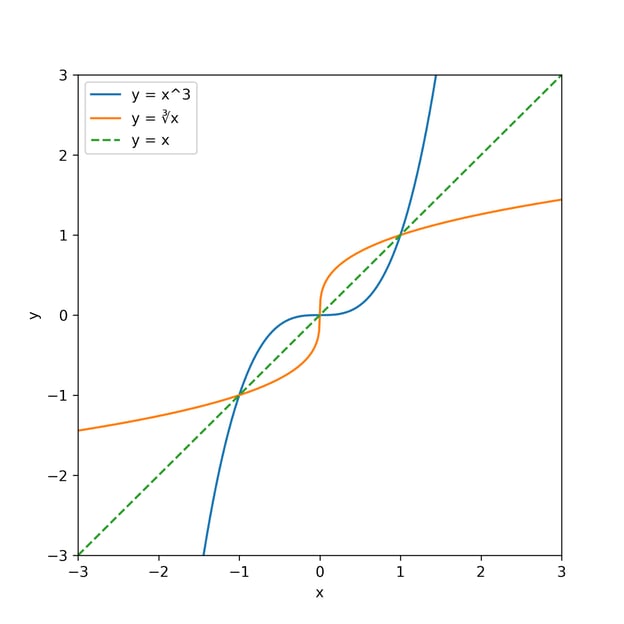
Die Ausgangsfunktion (blau) hat eine Inverse (orange), die an der Geraden y = x gespiegelt ist.