
¡Última oportunidad! 50 % de descuento en todo
La oferta termina dentro de
Quienes empiezan en ciencia de datos ven a menudo el término "función", pero no siempre queda claro qué significa realmente.
En este artículo vas a aprender qué es una función matemática, qué conjuntos describen sus valores de entrada y de salida, y en qué se diferencian los valores continuos y discretos. Verás cómo se usan las funciones en tecnología, cuáles son las más comunes en ciencia de datos y cómo se optimizan. Por el camino, verás código en Python para manipular y representar funciones.
Si quieres practicar cómo escribir y usar funciones propias en Python, te recomendamos nuestro curso Writing Functions in Python.
En matemáticas, una función asigna a cada entrada una única salida. Cada entrada válida se envía a una y solo una salida. Una misma entrada no puede tener varios resultados.
Por ejemplo, 32 grados Fahrenheit son 0 Celsius. El valor en Fahrenheit corresponde a un valor en Celsius; y corresponde a un único valor. No puede haber dos salidas (Celsius) distintas para una misma entrada válida (Fahrenheit).
Otros ejemplos incluyen la nómina, donde te pagan un importe por hora. Si cobras 20 $ la hora y trabajas 40 horas, ganas 20 x 40 = 800 $.
No todas las reglas son funciones. En algunos casos, tiene sentido lógico que una entrada tenga múltiples salidas. Por ejemplo, emparejar un nombre con una persona no es una función. El nombre "John Smith" podría corresponder a varias personas que comparten ese nombre.
En matemáticas, las reglas suelen plantearse de forma que haya una única salida por cada entrada válida. A veces es así porque refleja cómo funciona el mundo (la nómina). En otras, se formulan problemas en términos de funciones porque así resultan abordables. En vez de un embrollo de entradas y salidas, el modelo se construye de forma que cada entrada no pueda tener varias salidas.
Puedes imaginar una función como una "máquina" que recibe una entrada (a menudo x), la procesa de alguna manera y devuelve una salida (a menudo y).
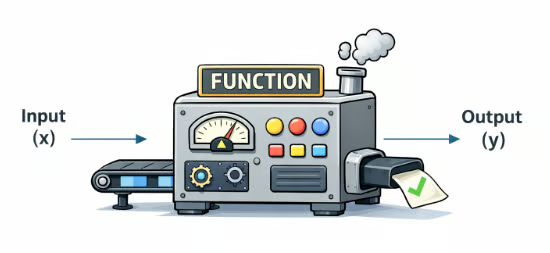
Aquí, una máquina recibe entradas por la cinta de la izquierda, las procesa y produce una alegre marca verde a la derecha.
Multivariate functions aceptan un conjunto de varias entradas pero devuelven una única salida. Puedes pensar en ello como pasar una fila de datos con varias variables o características que se mapean a una sola salida.
¿Cómo se escribe la ecuación? En el ejemplo de conversión de temperatura, podemos escribir la fórmula como y = f(x) = (5/9) (x - 32), con x la temperatura en Fahrenheit e y en Celsius. Para entender esta notación, léela de izquierda a derecha.
A la izquierda ves y, que es la salida. La notación f(x) indica que usas una función, llamada f, que toma una entrada x. Fíjate en que, en este contexto, f(x) no significa algún valor f multiplicado por otro valor x.
A la derecha está la fórmula. Dice que tomes la entrada x, le restes 32 y multipliques el resultado por 5/9.
Supón que registras la temperatura exterior una vez al día y has recogido k mediciones, denotadas (x1, x2, …, xk). Quieres una función que devuelva la temperatura media en lo que va de año tras n días. Define una función que tome un entero positivo n menor o igual que k que devuelva la media de las primeras n temperaturas, que es un número real. La notación para tal función es f: {1, 2, …, k} → ℝ.
Es útil tener jerga para describir los conjuntos en la función, lo que nos lleva al dominio, el codominio y el recorrido.
Ahora, veamos el recorrido. Considera una función cuadrática simple: y = f(x) = x2. Para especificar dominio y codominio, escribe f: ℝ → ℝ.
Esto nos dice que tanto el dominio (conjunto de entradas) como el codominio (conjunto de salidas) son números reales. Sin embargo, si lo piensas un poco, verás que el conjunto de salidas no puede ser todos los números reales.
Como cualquier número al cuadrado es no negativo, el conjunto de salidas que realmente se obtienen no son todos los reales, sino solo los reales no negativos. El término para describir esta situación es recorrido. Decimos que el recorrido de esta función son todos los números reales no negativos.
El codominio es el conjunto de salidas potenciales; el recorrido es el conjunto de salidas efectivas. Tú eliges el codominio para reflejar el tipo de salida prevista, y descubres el recorrido, que es el conjunto de valores de salida que realmente se obtienen.
Esto nos lleva a la distinción entre variables continuas y discretas:
Por ejemplo, una variable continua en [0, 1] puede tomar los valores 0, 0,5, 0,4141 o cualquier otro valor real en ese rango. Las variables continuas se usan habitualmente en modelos donde la salida podría ser, en teoría, cualquier valor, como en regresión.
En cambio, en clasificación binaria solo te interesan dos valores: 0 y 1. Por ejemplo, una imagen contiene un gato o no lo contiene. En un problema de clasificación multiclase, sigues teniendo un número finito de valores, por ejemplo 0 para perro, 1 para gato, 2 para caballo.
El problema que intentas resolver determina qué tipo de función te interesa. Los problemas de clasificación dan valores discretos; los de regresión, funciones continuas.
A veces necesitas pasar varias variables a una función. Por ejemplo, puedes pasar una fila de características a una función de aprendizaje automático. En ese caso, puedes agrupar las características en un contenedor y pasarlo. Una forma de agrupar datos así es mediante un vector. El modelo toma un vector de entrada x = [x1, x2, x3] y devuelve un objetivo y.
En Python, normalmente usas un array de NumPy para representar un vector.
import numpy as np

def f(x):
    result = (x[0] + x[1] + x[2]) / 3
    return result

x = [3, 4, 7.1]
print(f(x))4.7Este código toma un vector con los números 3, 4 y 7,1 y devuelve su media.
Para un conjunto de vectores, una opción muy popular es usar la estructura de datos DataFrame de la librería pandas.
import pandas as pd

def row_averages(df):
    return df.mean(axis=1).round(1)

df = pd.DataFrame({
    "A": [1, 5, 2],
    "B": [9, 3, 6],
    "C": [7, 8, 10]
})

print(row_averages(df))
Este código devuelve una Series de pandas con las medias por fila, un valor por fila. En este caso:
0    5.7
1    5.3
2 6.0El concepto de función está por todas partes en tecnología. En la práctica, ten en cuenta que "función" no siempre se define con el mismo rigor que en matemáticas. Por ejemplo, las funciones de programación pueden tener efectos secundarios que cambian el valor de variables distintas de la salida, cosa que no ocurre en las funciones matemáticas.
Las funciones se usan ampliamente en hojas de cálculo, por ejemplo, en las fórmulas de Excel. Puede que quieras calcular la suma, la media o la mediana de una columna de números. En hojas de cálculo, las funciones siguen la misma definición que la función matemática presentada antes.
Una cosa en la que las hojas de cálculo son brillantes (con juego de palabras) es en las funciones condicionales: permiten construir estructuras lógicas más complejas con funciones como IF().
Por ejemplo, puedes querer hallar el total de pagos hechos a tu hipoteca durante un año. Para ello, seguramente usarías la función SUM() de tu hoja de cálculo.
Las funciones son ubicuas en los lenguajes de programación. Según el lenguaje, la definición de "función" puede ser más laxa que la matemática. Algunos lenguajes permiten que una función devuelva varios valores, o ninguno.
Por ejemplo, una función puede recibir valores e imprimir un mensaje, pero no devolver explícitamente un valor. Una función de Python tiene este aspecto:
def print_me(name, color):
       print(f"My name is {name} and my favorite color is {color}.")

name = "Mark"
color = "blue"
print_me(name, color)
Este código produce la salida: "My name is Mark and my favorite color is blue." La función no devuelve explícitamente ningún valor matemático.
El código en muchos lenguajes generalistas, como Python, también puede tener otros efectos secundarios en una función, como cambiar el valor de una variable global. Aunque los efectos secundarios son posibles y están permitidos, se desaconsejan. Complican las pruebas, la depuración y el razonamiento del programa.
Por estas razones, algunos lenguajes "funcionales", como Scala y Haskell, son más rigurosos en torno a la idea de función.
En un contexto de Machine Learning, las entradas son las características, la función es el modelo y la salida es la predicción del modelo. A menudo se describe al modelo como una "caja negra" porque no siempre está claro cómo se procesaron las características de entrada para obtener la predicción, por lo que nuestra metáfora de la ”máquina” encaja aún mejor:
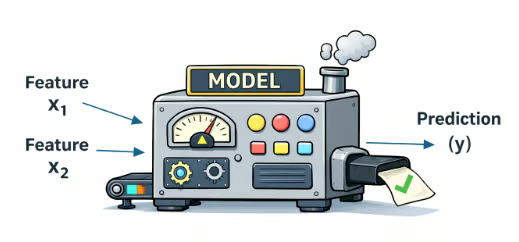
En esta ilustración, las características se introducen en la "máquina" del modelo, que las procesa de alguna manera y devuelve una predicción. En comparación con funciones deterministas más simples, como la conversión de temperatura, lo que ocurre dentro de la máquina es más difícil de describir.
En ML, el dominio son vectores de características; el codominio pueden ser probabilidades, clases o predicciones de valor real.
En Deep Learning, las funciones no suelen aplicarse directamente a un conjunto de entradas, sino que se evalúa la corrección del modelo con una función de coste. Una cost function es una medida de lo erróneo que es un modelo en el conjunto de entrenamiento. Compara predicciones con etiquetas o valores reales y agrega los errores en un solo número.
Hay ciertas funciones que aparecen prácticamente en todas partes en ciencia de datos. Entre ellas están las funciones lineales, logarítmicas y exponenciales, además de funciones de activación no lineales para deep learning.
Empecemos con el ejemplo clásico: las funciones lineales.
Supón que te apetecen manzanas. Vas a una tienda donde venden manzanas a un precio fijo de 0,75 $ por libra. Una libra cuesta 0,75 $, 2 libras cuestan 2 x 0,75 $ = 1,50 $, y 3 libras cuestan 3 x 0,75 $ = 2,25 $. Cada libra que compras suma una cantidad fija al coste total.
En notación funcional, puedes escribir la fórmula como f(x) = 0.75 x. El número 0,75 es la pendiente de la función lineal. La pendiente es la tasa de cambio de la salida respecto a cada unidad de cambio en la entrada.
Para representar una función así, puedes usar un código como el siguiente:
import numpy as np
import matplotlib.pyplot as plt

def cost_of_apples(x, m):
    result = m * x
    return result

# Define x y y
x = np.linspace(0, 5, 100)
y = cost_of_apples(x, 0.75)

# Dibujo
plt.figure()
plt.plot(x, y)
plt.xlabel("Pounds of Apples")
plt.ylabel("Total Cost ($)")
plt.title("Cost of Apples")
plt.show()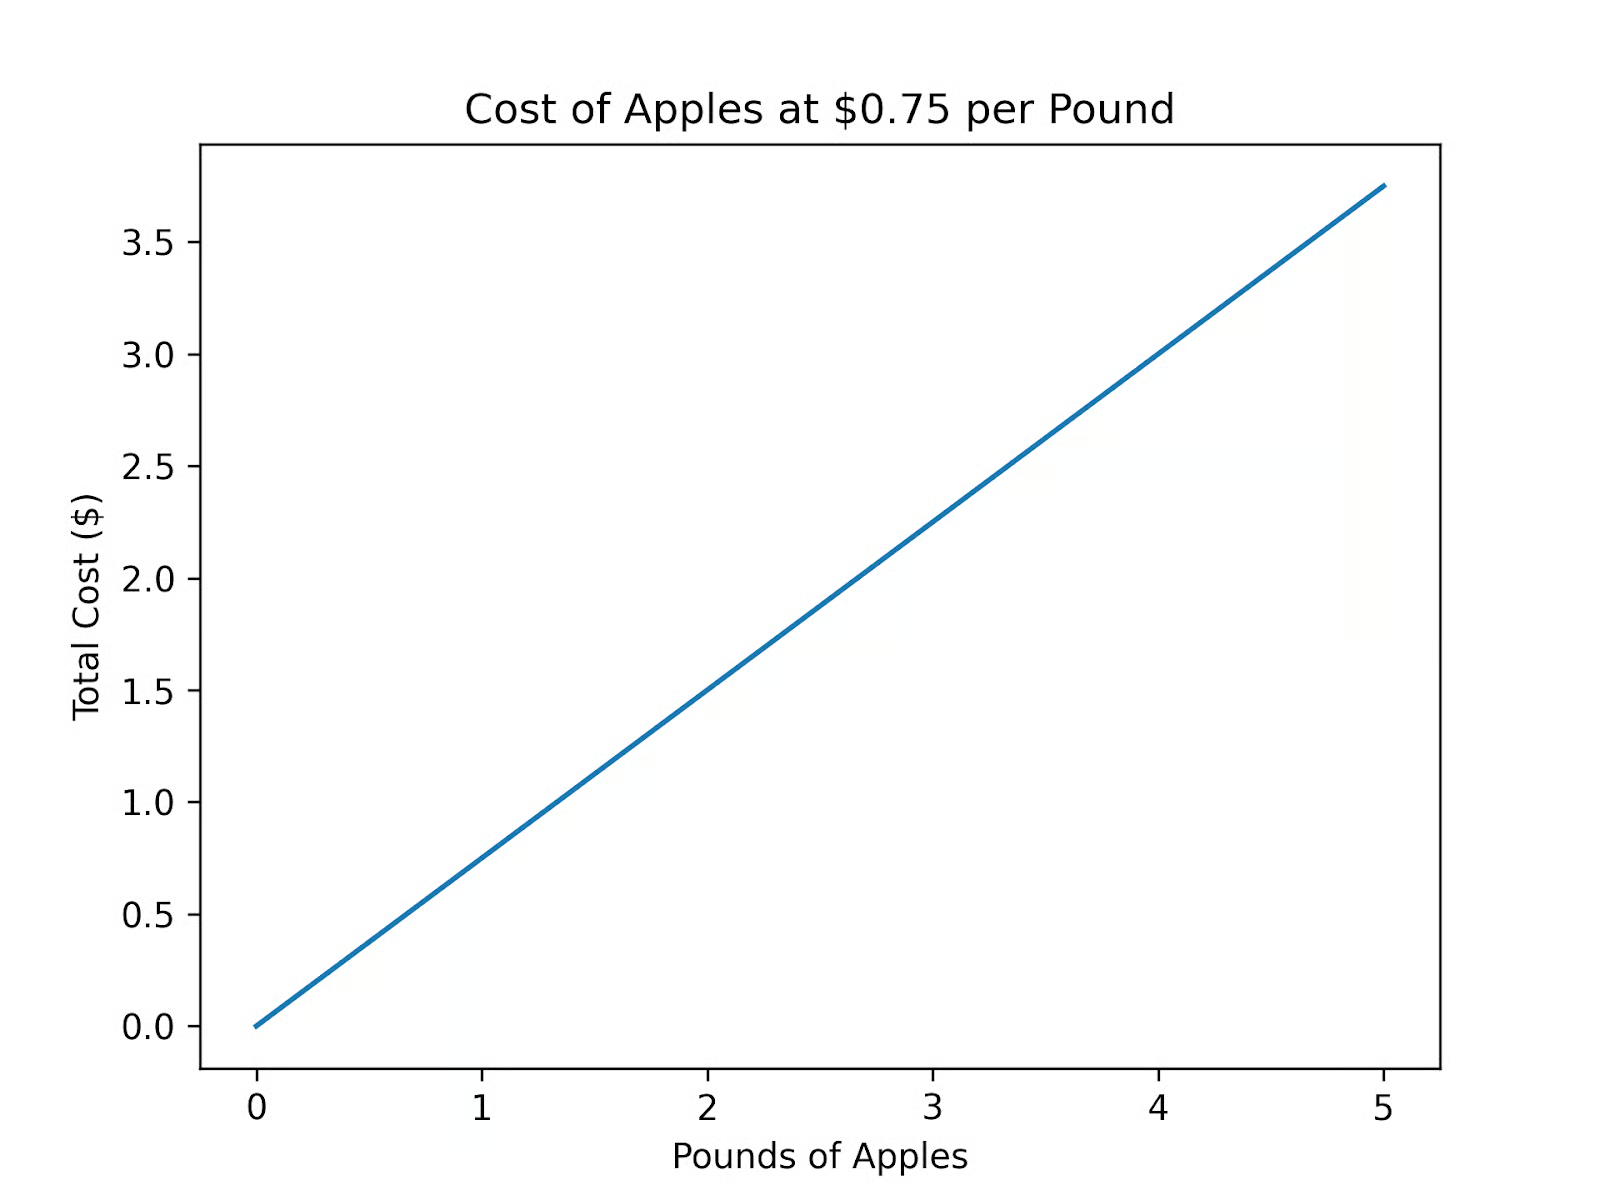
A estas se las llama funciones lineales. Cada aumento en la entrada, x, aporta la misma cantidad fija a la salida, y. Como su nombre sugiere, al representarlas, una función lineal da una recta.
Ahora supón que te gusta que te lleven la compra a casa. La tienda cobra 2,00 $ de tarifa fija de envío. En este caso, la función para tus manzanas es f(x) = 0.75 x + 2. Como antes, 0,75 es la pendiente. El número 2, que es donde la gráfica corta el eje y, se conoce como "intersección con y". Es el valor de salida cuando la entrada es 0.
El coste total es la suma de las manzanas y la tarifa de envío. En general, una función lineal univariante puede escribirse como f(x) = mx + b, donde m es la pendiente y b es la intersección con y.
Probablemente quieras algo más que manzanas. Supón que también compras pan y mantequilla de cacahuete. Las manzanas cuestan 0,75 $/lb, una barra de pan 2,50 $ y un tarro de mantequilla de cacahuete 3,00 $. Ahora, tu función de compra es:
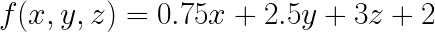
Esta función sigue considerándose lineal porque es lineal en cada variable. En general, una función lineal toma la forma:
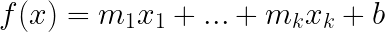
Equivale a sumar cada una de tus cantidades multiplicadas por sus pesos (otro término para pendiente en este contexto), más la intersección.
En notación vectorial, esta función se escribe así:
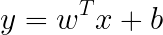
La T indica "traspuesta", necesaria para realizar la multiplicación vectorial de w y x.
Considera la eficiencia de combustible frente a la velocidad. Sospechas que, al conducir más rápido, disminuye la eficiencia. Recoges cincuenta puntos entre 45 y 65 millas por hora y observas este patrón:
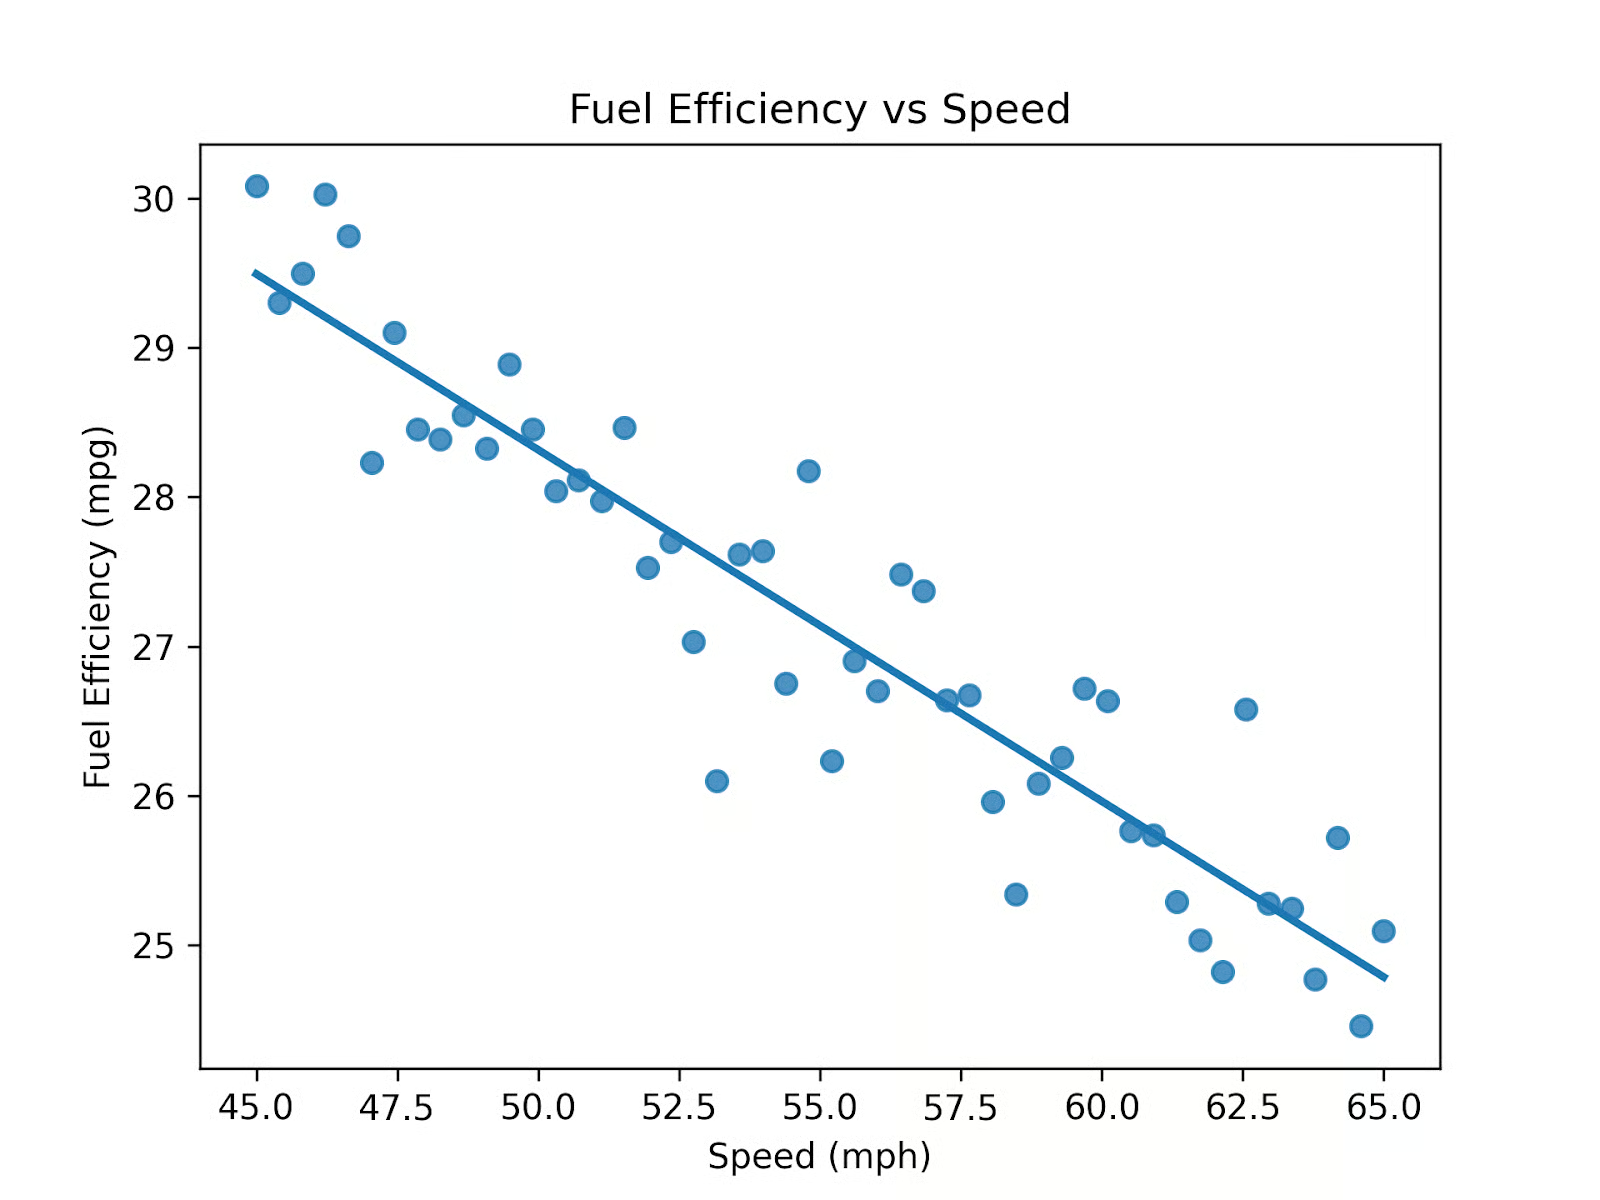
Unir cada punto daría un garabato poco legible e inútil. Pero la tendencia general es aproximadamente lineal en ese rango. Si llamamos x a la velocidad, la función de esta gráfica es:
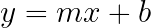
Para encontrar una recta como esa que se ajuste mejor a los datos, usas un proceso matemático llamado simple linear regression.
Puedes calcular una recta así en Python usando Matplotlib y Seaborn:
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# Reproducibilidad
np.random.seed(0)

# Crear dataset
speed = np.linspace(45, 65, 50)
mpg = 38 - 0.2 * speed + 0.002 * (speed - 55)**2 + np.random.normal(0, 0.5, size=50)

df = pd.DataFrame({
    "speed": speed,
    "mpg": mpg
})

# Gráfico con línea de regresión
sns.regplot(data=df, x="speed", y="mpg", ci=None)

plt.xlabel("Speed (mph)")
plt.ylabel("Fuel Efficiency (mpg)")
plt.title("Fuel Efficiency vs Speed")
plt.show()
La regresión lineal funciona con múltiples variables. Supón que defines un modelo de regresión lineal para velocidad (x), peso del vehículo (y) y tamaño del motor (z). La fórmula resultante para la multivariate linear regression es:
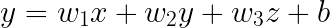
En este caso, el coeficiente de cada variable representa el peso o importancia de esa característica, manteniendo fijas las demás.
Ahora, vamos a "invertir" la pregunta de comprar manzanas: si gastaste 2,25 $ en manzanas, ¿cuántas libras compraste? La respuesta es 2,25 / 0,75 = 3, así que compraste tres libras. Esta especie de "inversión" de una función se llama inversa de la función. En el ejemplo sin intersección, la inversa es:
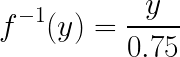
Ten en cuenta que, en esta notación, el "-1" indica que tomas la inversa de una función, no el recíproco.
Algo a vigilar es que el dominio puede cambiar. Por ejemplo, supón que tu función original es:
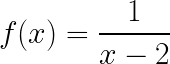
Esta función está definida para todos los números reales excepto 2, ya que el denominador no puede ser cero. La inversa de esta función es
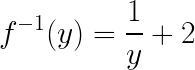
Por el mismo motivo, la función inversa está definida para todas las entradas excepto 0.
Otra advertencia: la inversa resultante podría no ser una función si tiene múltiples salidas para una sola entrada. Considera la función y = x2. Su inversión sería por tanto:
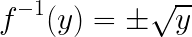
Como ves por el más/menos, la inversa tiene dos salidas para una entrada, por lo que no es una función salvo que restrinjamos el dominio (por ejemplo, a x ≥ 0)
Gráficamente, una función y su inversa (si existe) son imágenes especulares respecto de la recta y=x. Considera la función y = x3. La gráfica de esta función y su inversa es: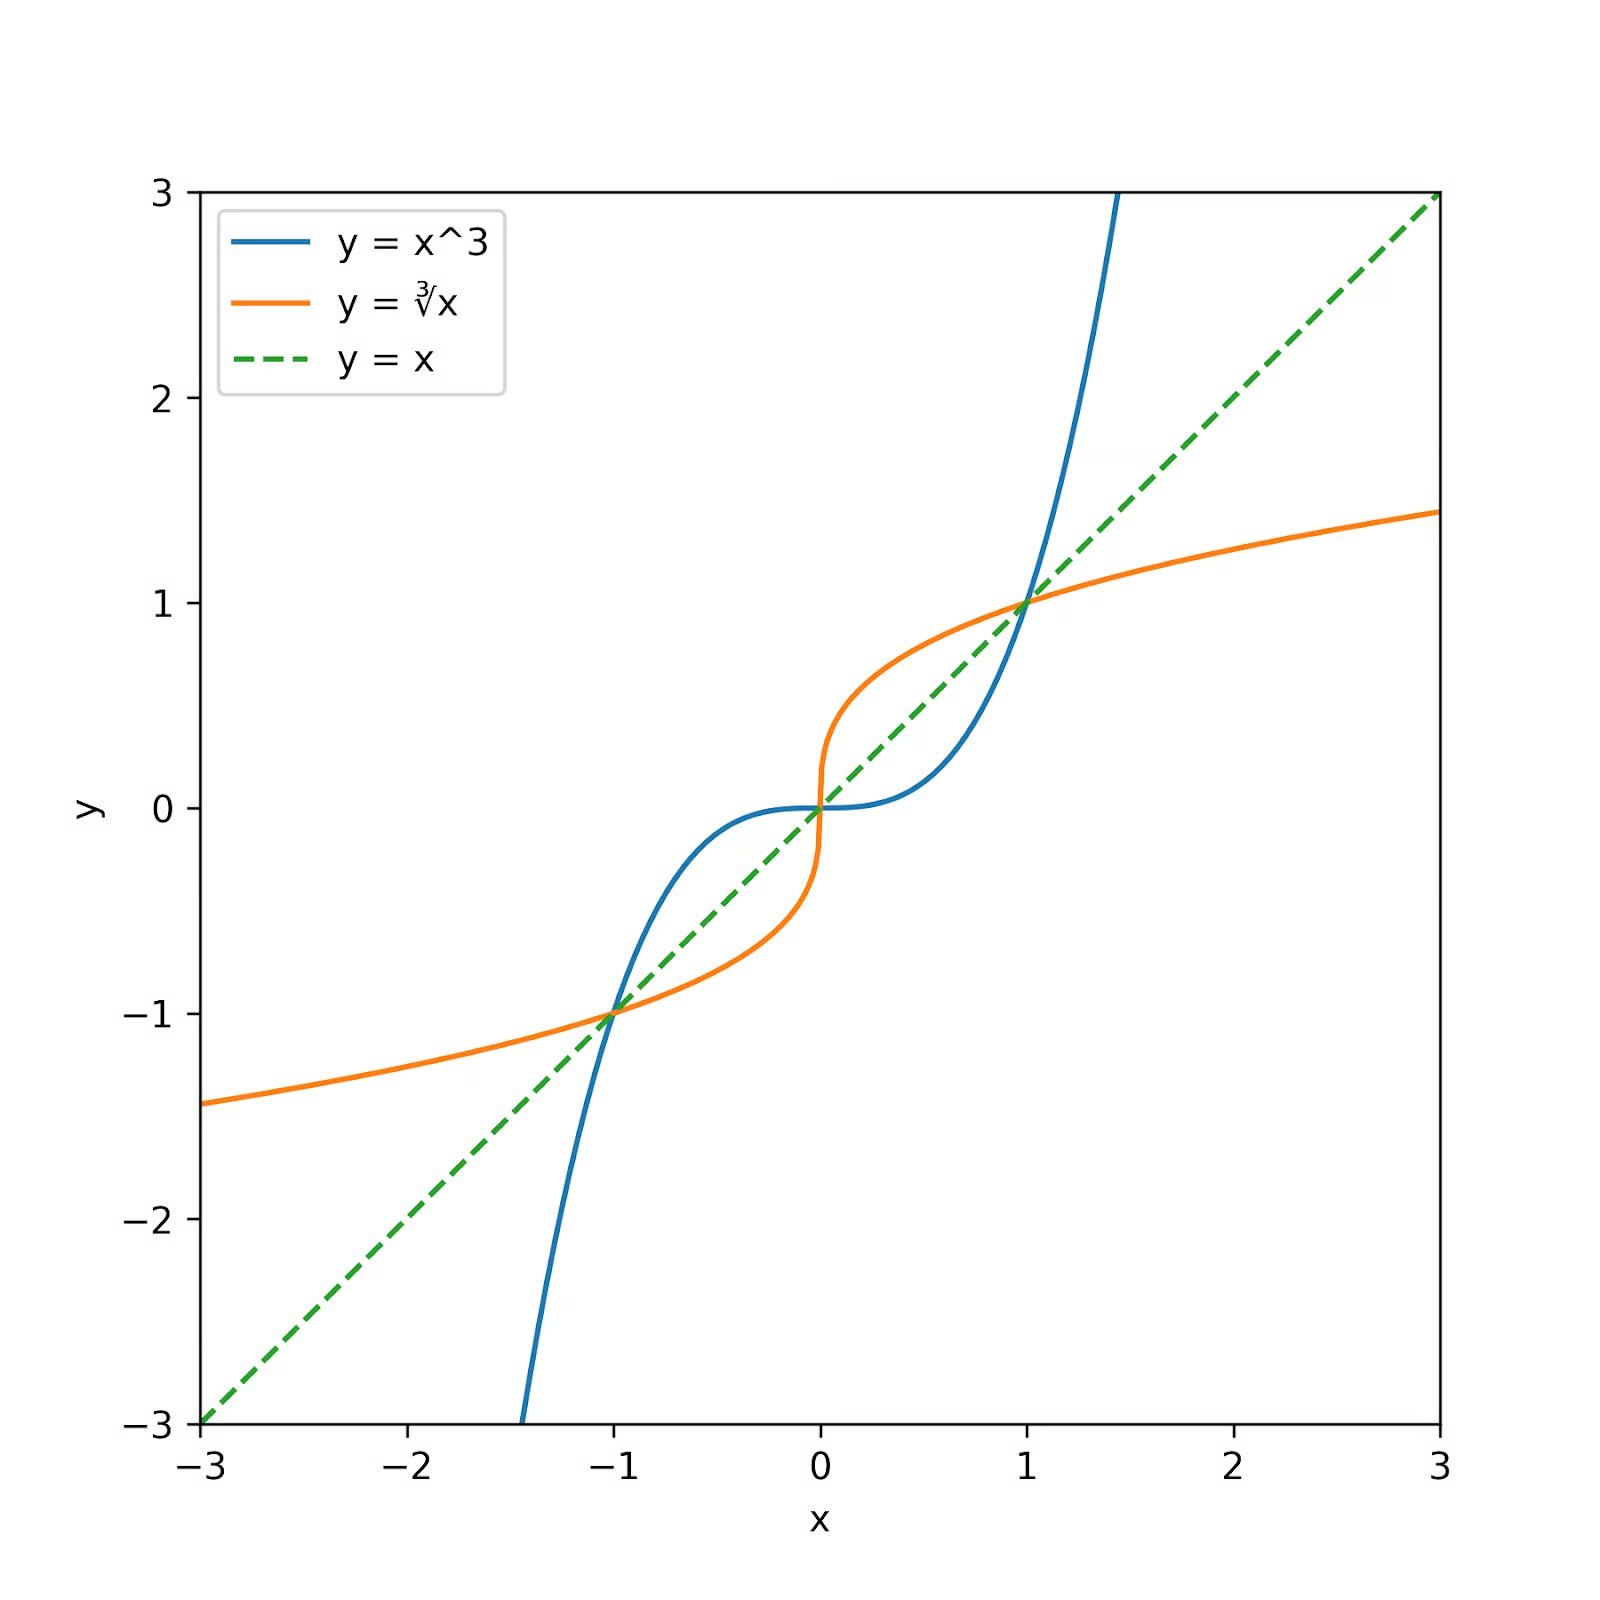
La función original (en azul) tiene una inversa (en naranja) que es el reflejo respecto de la recta y = x.
Veamos dos tipos de funciones estrechamente relacionadas: las exponenciales y las logarítmicas.
Supón que depositas 100 $ en una cuenta de ahorros que paga un 10% de interés compuesto anualmente.
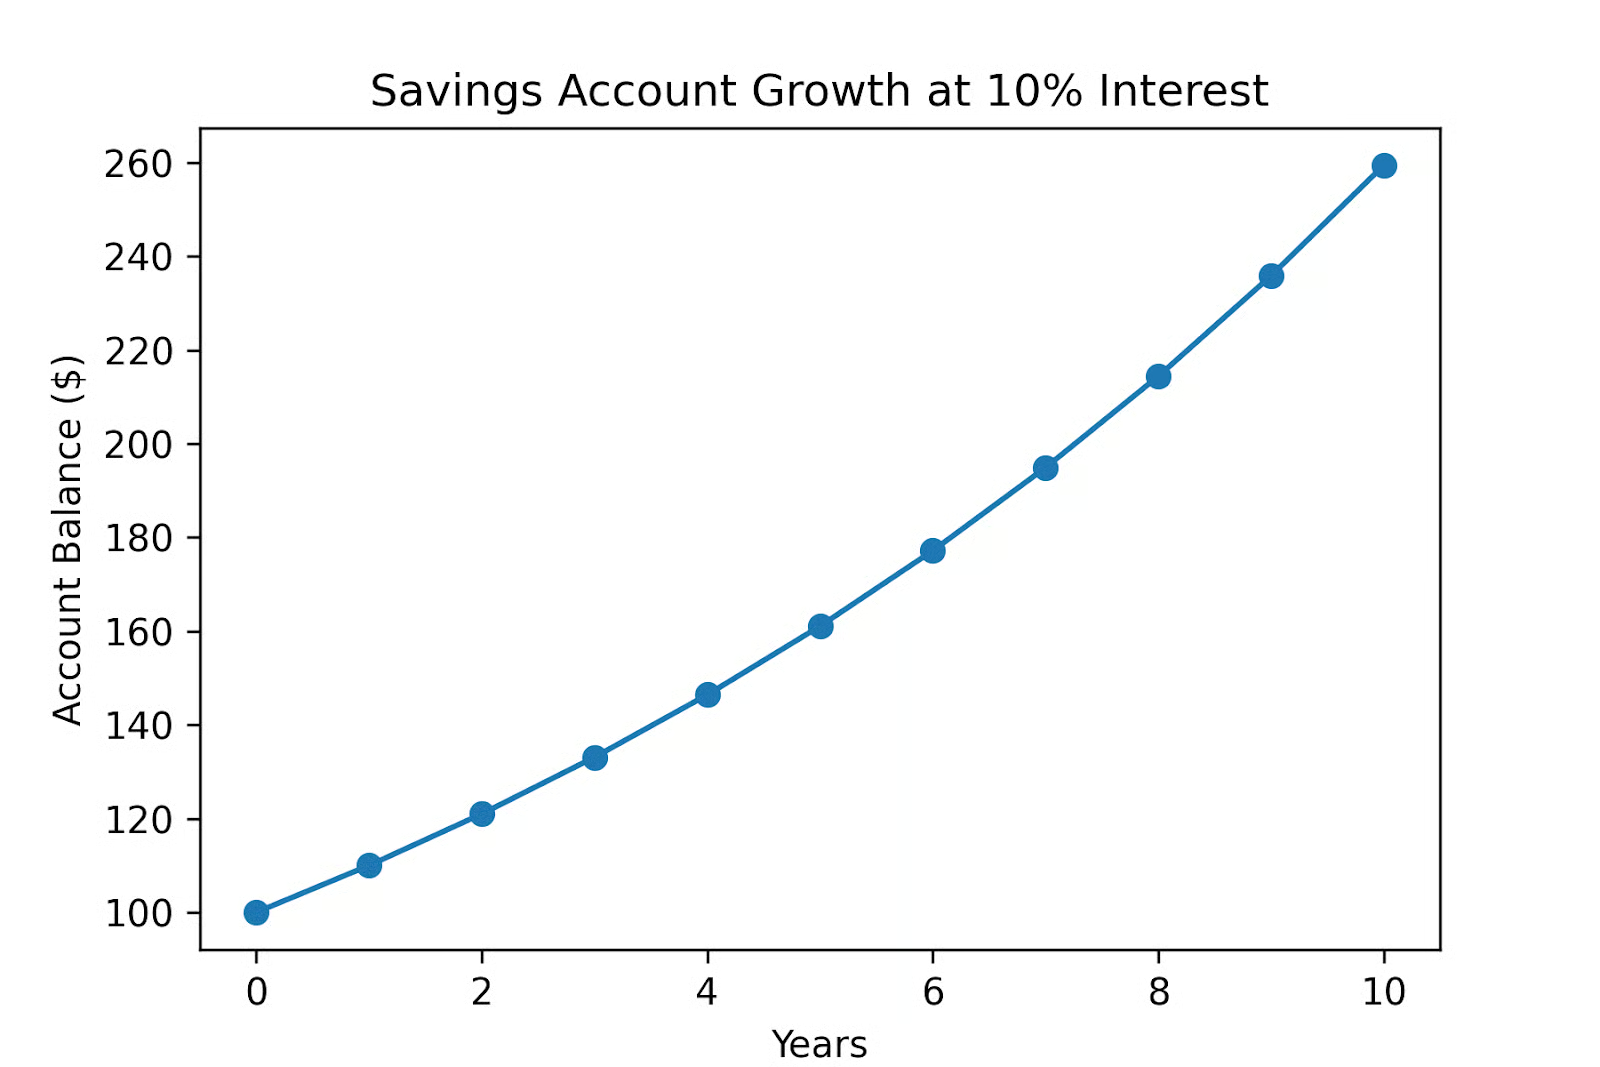
Este es un ejemplo de crecimiento exponencial. Cada paso multiplica el anterior por una cantidad fija. La función general de crecimiento exponencial es y = A bx, donde y es la salida, x la entrada (a menudo, el tiempo), A el importe inicial y b el factor de crecimiento por unidad de x.
En ciencia de datos, los modelos exponenciales aparecen en procesos de crecimiento compuesto como el de usuarios o ingresos, en modelos de probabilidad y en muchas otras aplicaciones.
Las funciones logarítmicas le dan la vuelta a la pregunta. Ahora, en lugar de preguntar por la cantidad tras x tiempo, supón que quieres saber cuánto tiempo necesitas dejar crecer tu dinero hasta llegar a 200 $, suponiendo un factor de capitalización del 10%.
Ahora necesitamos saber cuántas veces se multiplica 1,10 por sí mismo para obtener 2. A esta pregunta responden los logaritmos.
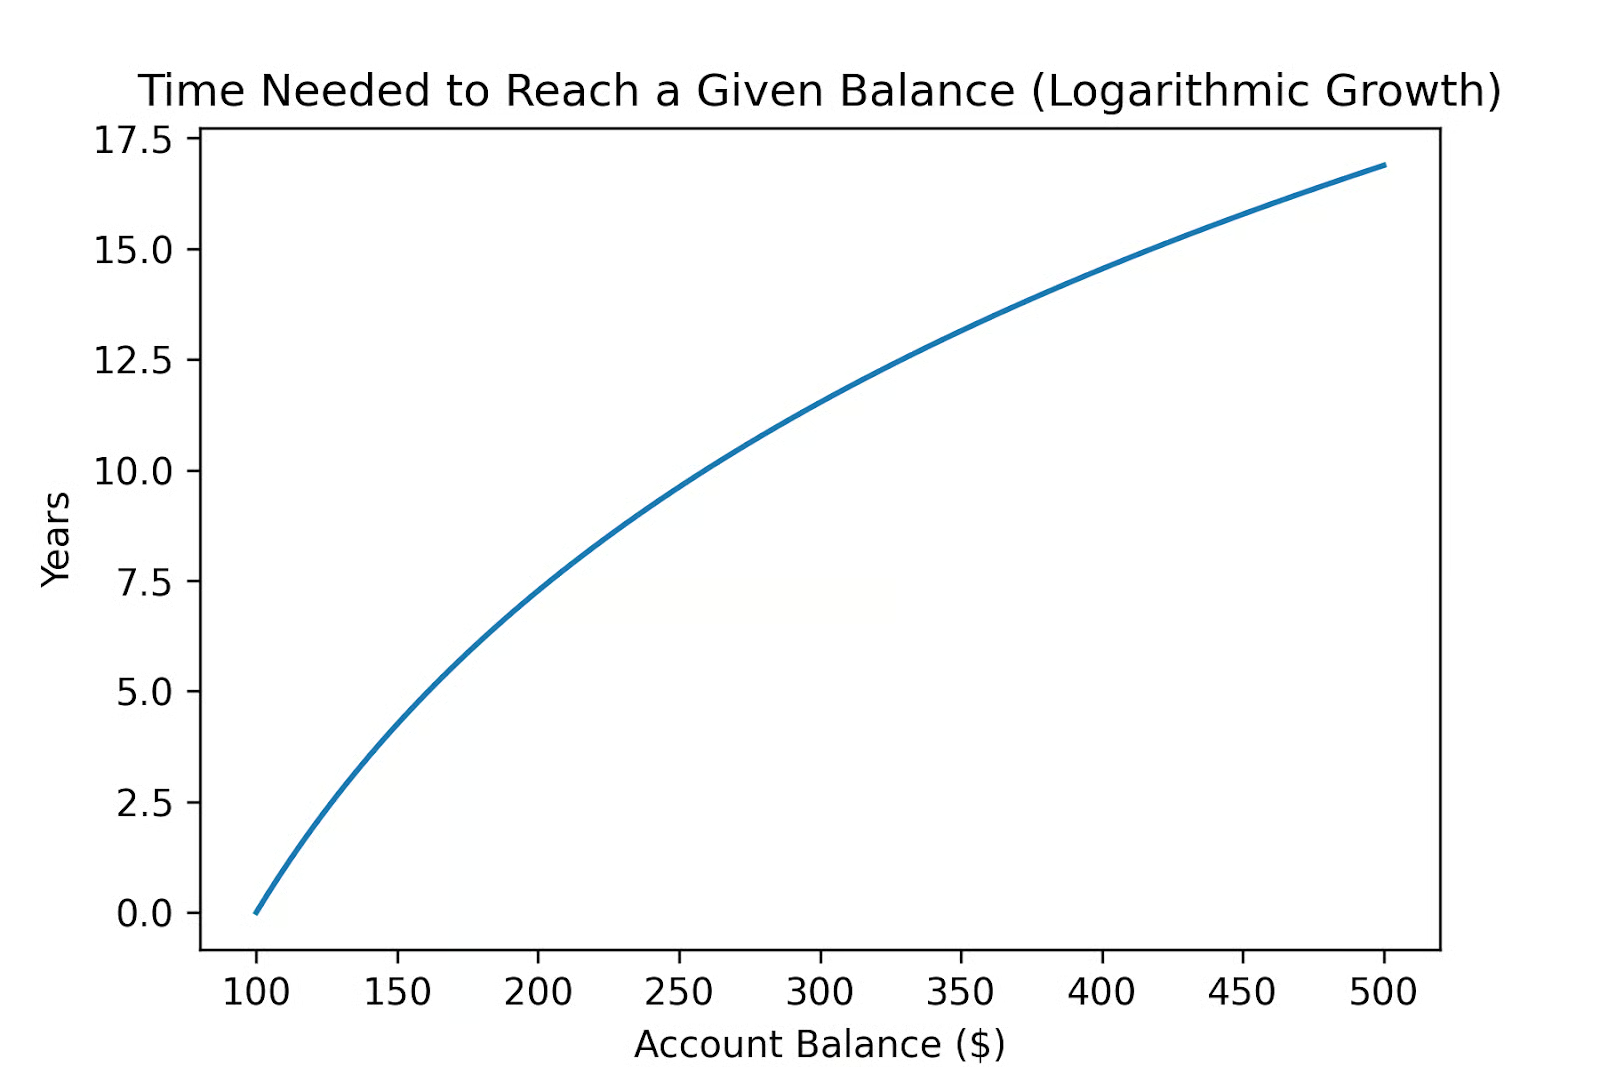
Viendo la gráfica, tardará algo más de 7 años en duplicarse.
Como hemos visto, las funciones logarítmicas son la inversa de las exponenciales. Los modelos exponenciales preguntan: tras x meses, ¿cuál es la tasa de crecimiento? Los modelos logarítmicos preguntan: dada una tasa de crecimiento, ¿cuántos meses ha tardado en alcanzarse?
Los científicos de datos suelen usar logaritmos para hacer manejable una distribución sesgada. Por ejemplo, las distribuciones de ingresos suelen estar muy sesgadas a la derecha: unas pocas rentas altas estiran la cola superior, mientras que la mayoría se concentra en la parte baja.
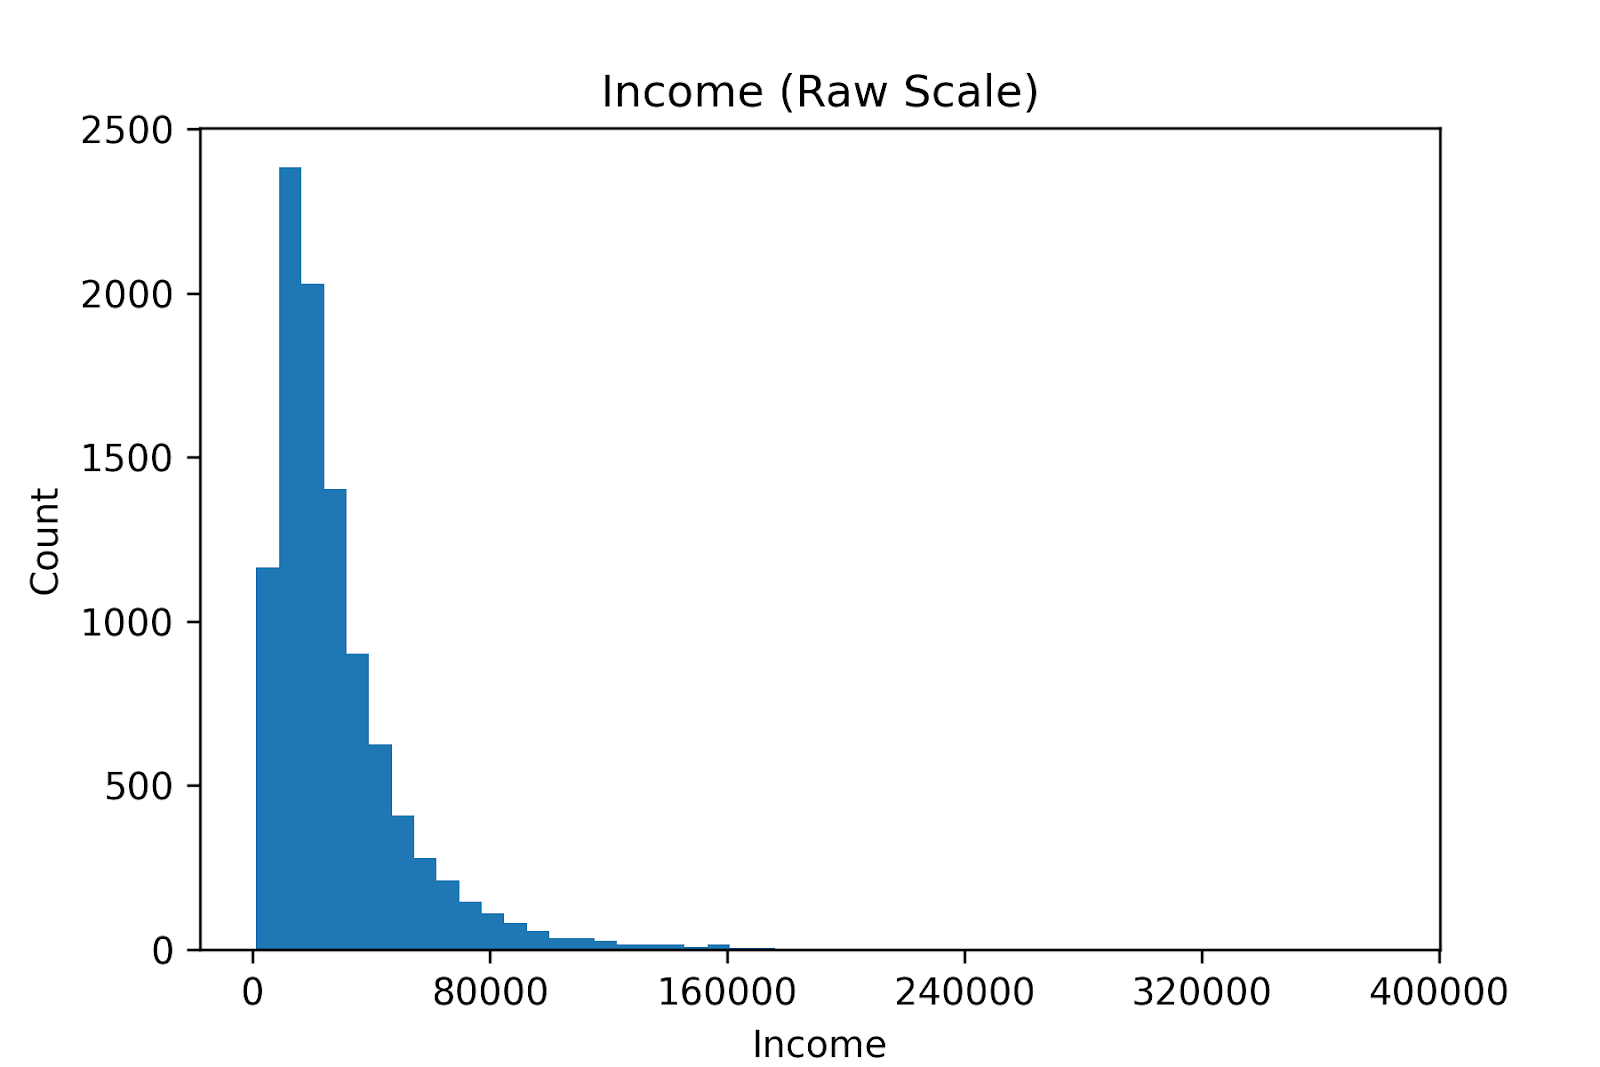
Puedes transformar los datos tomando el logaritmo de cada punto:
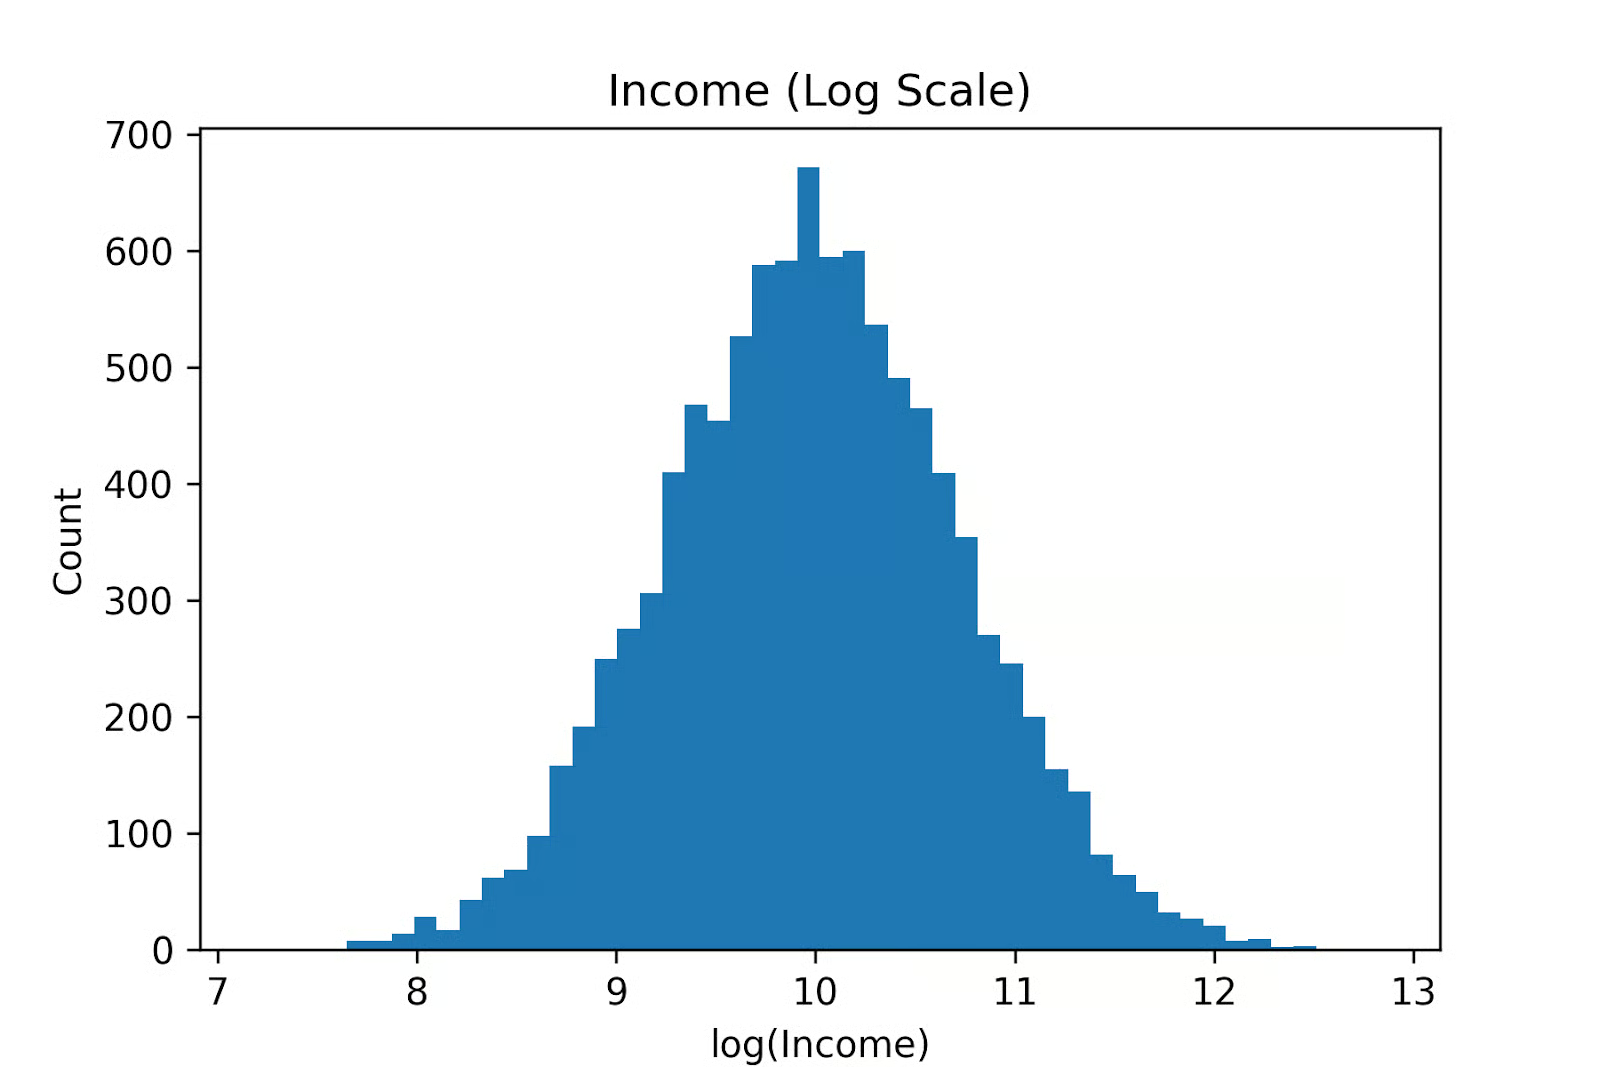
Las rentas altas se comprimen y el resto se expanden. Las transformaciones log cambian la pregunta de diferencias absolutas a diferencias relativas. Como resultado, la larga cola derecha colapsa y la distribución a menudo se vuelve aproximadamente normal. Ahora la varianza es más estable y podemos aplicar regresión lineal.
El logaritmo desempeña un papel central en una de las funciones de pérdida más usadas en clasificación binaria, conocida como cross-entropy loss o log loss, definida para una sola muestra como:
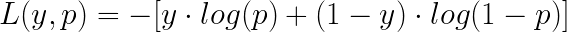
Aquí, la variable binaria y (0 o 1) es el valor real de una muestra, y p es la probabilidad predicha de que y sea la clase 1.
La log loss penaliza con fuerza las predicciones muy seguras pero incorrectas. Predecir una probabilidad cercana a 0 cuando la etiqueta real es 1 (o al revés) da una penalización grande, mientras que las predicciones inciertas reciben penalizaciones menores. Esto hace que la log loss sea idónea para entrenar clasificadores probabilísticos como la logistic regression.
Las funciones de activación se usan en redes neuronales para asegurar que la salida de cada capa sea no lineal. Las más comunes son la sigmoide y la ReLU.
La sigmoid function es una función suave en forma de S definida por la siguiente fórmula:
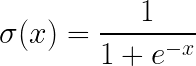
Acepta cualquier número real como entrada y devuelve un valor estrictamente entre 0 y 1. Se usa para convertir puntuaciones crudas en probabilidades.
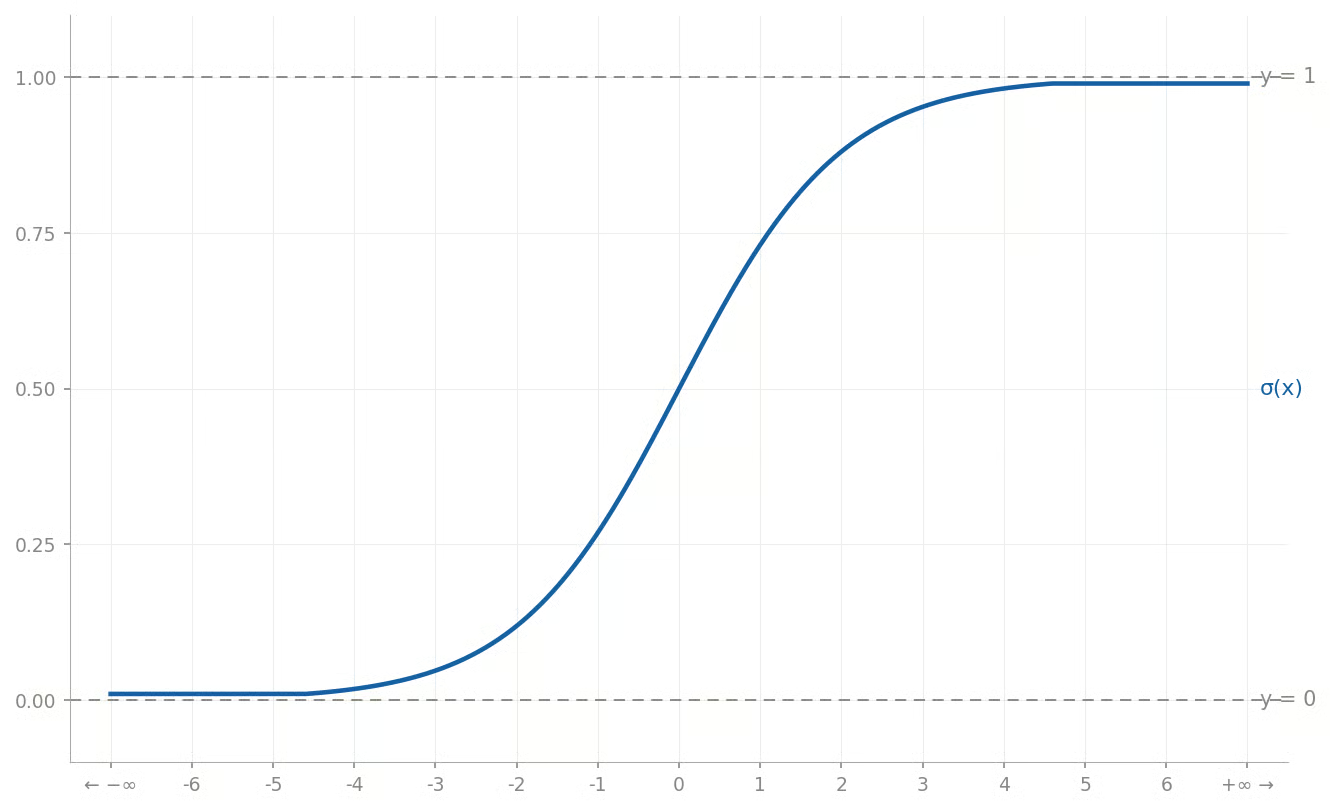
Un uso común de la sigmoide es en la regresión logística para clasificación binaria. La regresión logística calcula una combinación lineal de las entradas para producir una puntuación. Esa puntuación se convierte en probabilidad usando la función sigmoide. Las probabilidades por encima de un umbral (típicamente 0,5) se clasifican como 1 y las que quedan por debajo como 0.
Para saber más, consulta nuestros tutoriales de Python logistic regression y logistic regression in R.
La función rectified linear unit (ReLU) convierte los números negativos en 0 y deja los positivos sin cambios. Se define como:
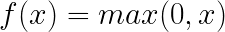
Para valores mayores que 0, coincide con la función identidad, como se aprecia en su gráfica:
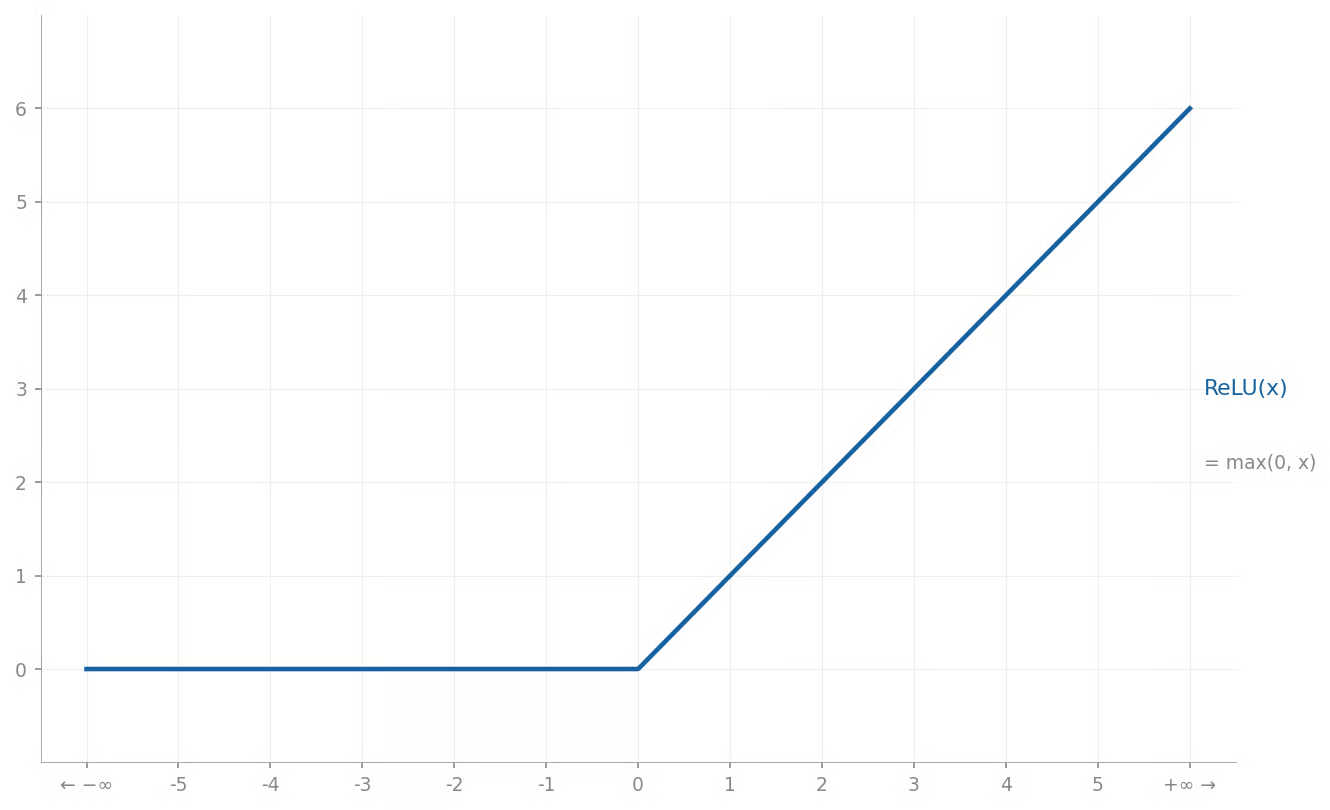
Al igual que la sigmoide, actúa como función de activación no lineal en las capas ocultas de una neural network. Sin embargo, es computacionalmente sencilla, pues solo requiere una operación de máximo, mientras que la sigmoide necesita una llamada a la función exponencial, más costosa.
Como una ReLU pone a 0 todos los valores negativos, produce esparsidad en la red, donde muchas neuronas quedan a cero. Esto puede reducir el ruido y conducir a representaciones más eficientes.
Otra forma de funciones no lineales se encuentra en los árboles de decisión, que particionan recursivamente el espacio de entrada en regiones más pequeñas dividiendo por características y umbrales hasta cumplir un criterio de parada.
A cada nodo hoja resultante se le asigna un valor de predicción. Así, un árbol de decisión puede verse como una función a trozos, donde cada región del dominio se asigna a un valor de predicción constante. Al unir muchas reglas locales, los árboles pueden capturar patrones complejos.
Por ejemplo, puedes ver una región bidimensional particionada así:
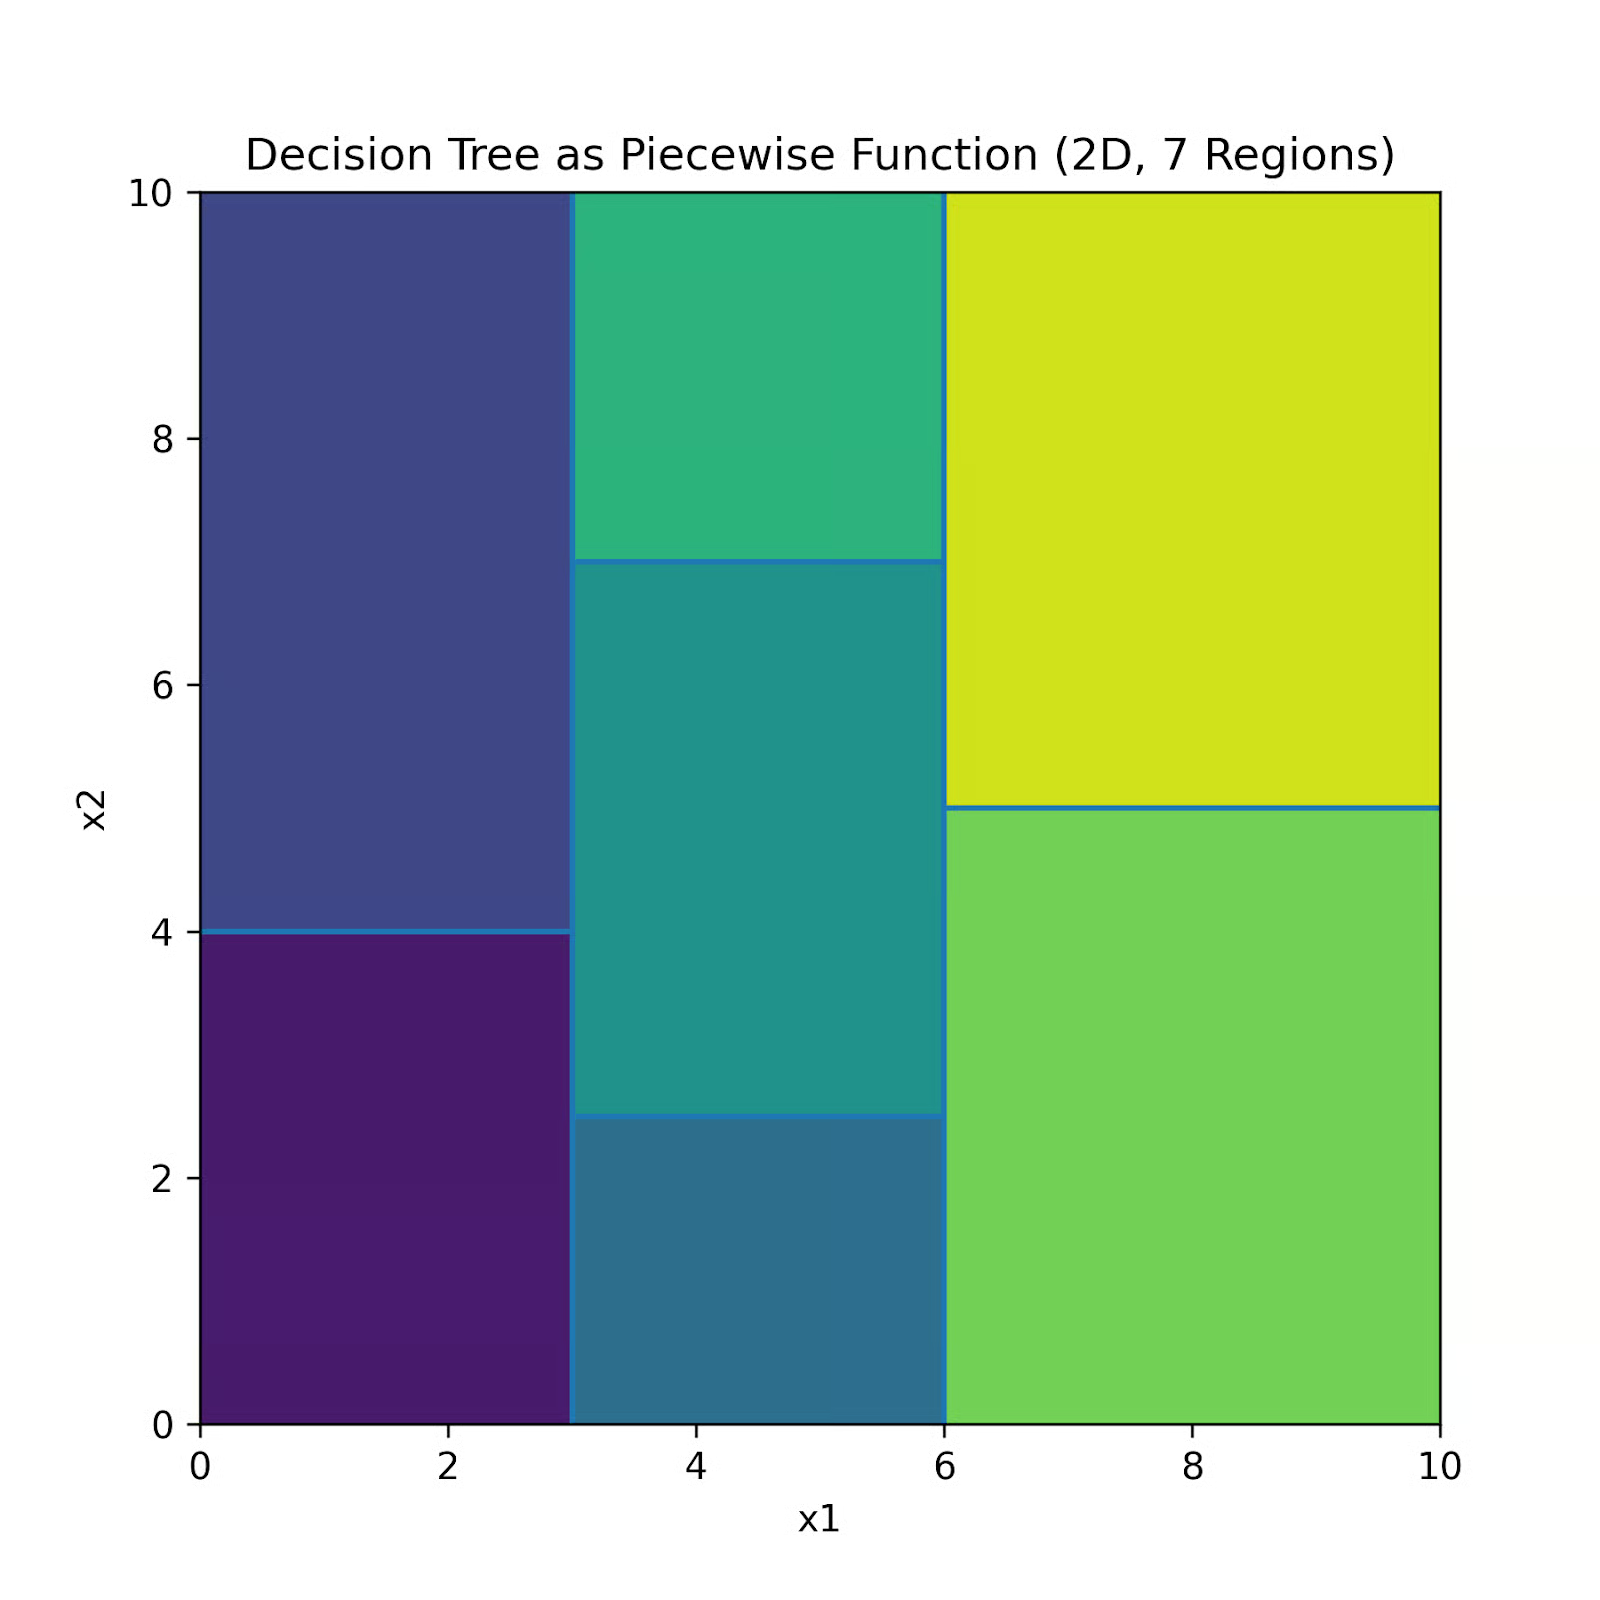
Este mapa de calor corresponde a las siguientes regiones:
|
Región |
Parte del dominio |
Valor de la función |
|
1 |
x1 < 3 y x2 < 4 |
1 |
|
2 |
x1 < 3 y x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 y x2 < 2,5 |
3 |
|
4 |
3 ≤ x1 < 6 y 2,5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 y x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 y x2 < 5 |
6 |
|
7 |
x1 ≥ 6 y x2 ≥ 5 |
7 |
La optimización de funciones es el proceso de encontrar valores de entrada que maximizan o minimizan una función. Por ejemplo, puedes querer maximizar una función de beneficio o minimizar una función de error. El estudio de la optimización se conoce como "investigación operativa" y es un cuerpo de teoría matemática enorme y en evolución constante.
Optimizar funciones está estrechamente relacionado con los "extremos" locales y globales (puntos de máximo o mínimo). Un "mínimo local" es un mínimo dentro de un rango concreto, y un "mínimo global" es el mínimo de la función en todo su dominio.
Por ejemplo, considera la función f(x) = x4 - 3x2 + x.
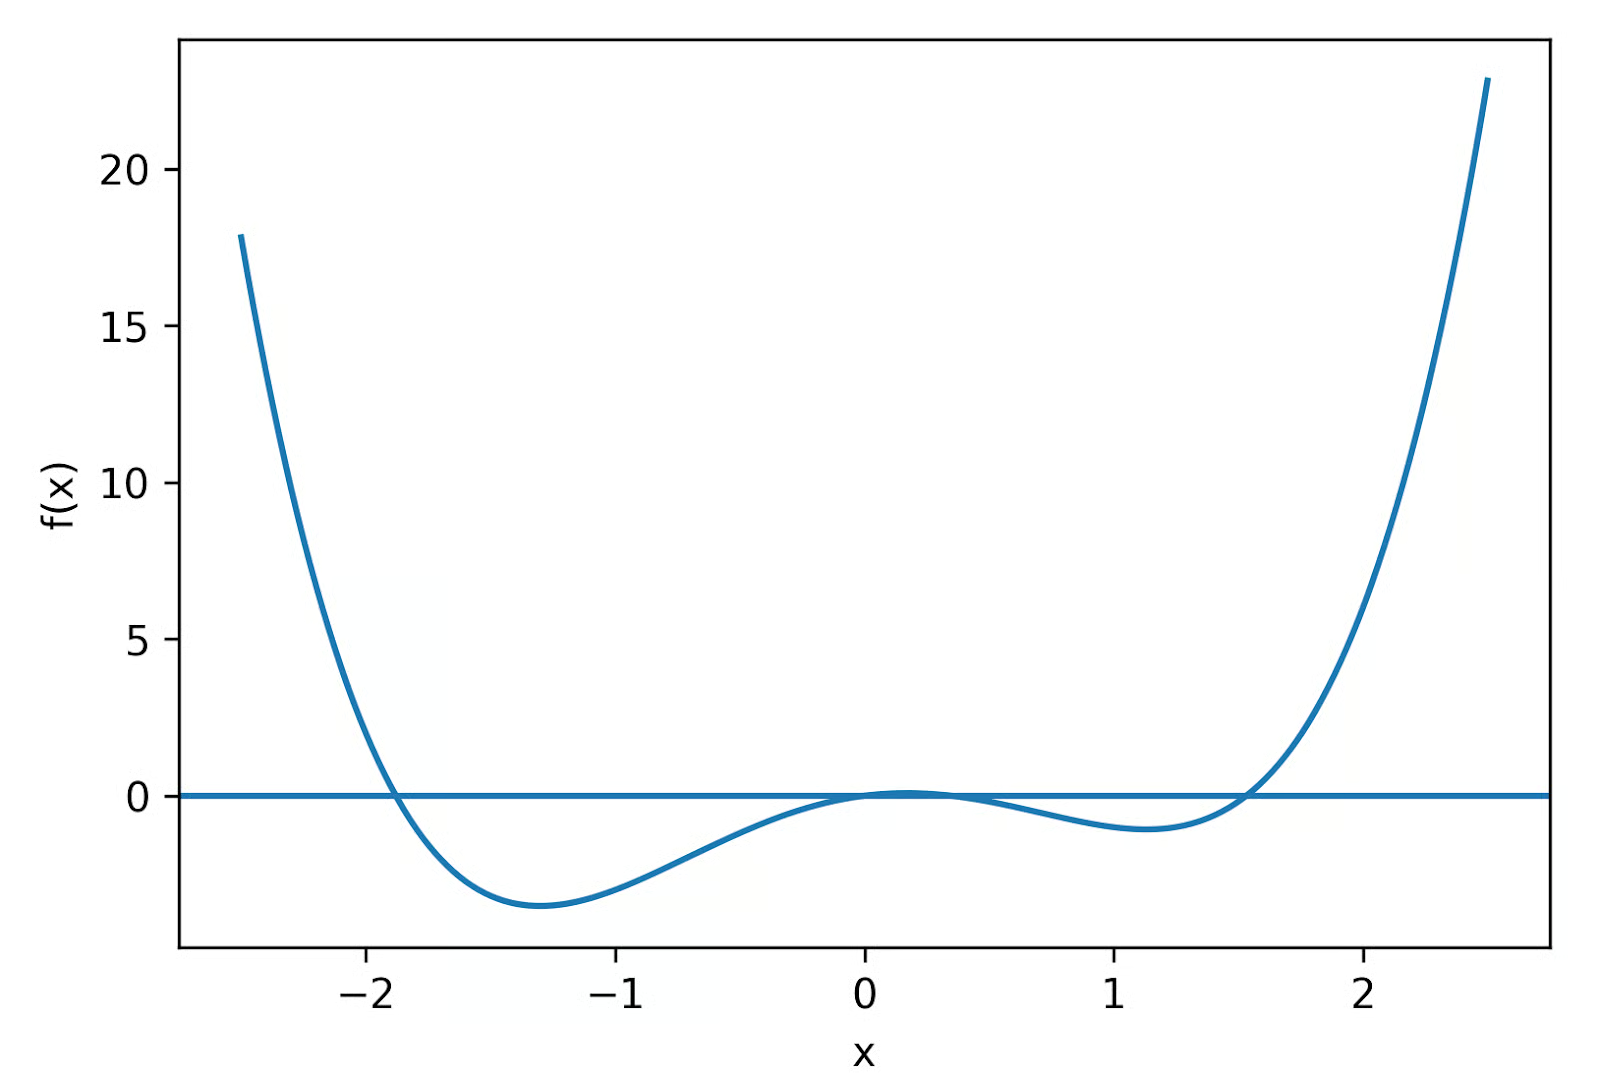
Hay dos mínimos locales: uno cuando x es aproximadamente -1,30 y otro cuando x es aproximadamente 1,13. El valor y es menor cuando x es -1,30, así que ese es el mínimo global de la función.
Para tareas sencillas, como encontrar el mejor precio que maximiza el beneficio en un modelo de una variable, basta con derivar la función, igualarla a cero y resolver x. Para entrenar redes neuronales profundas no es tan simple, pero la idea es similar.
El método de optimización más importante para el deep learning es el gradient descent. El gradiente es la generalización multidimensional de la pendiente y nos dice cómo cambia la pérdida respecto de cada parámetro.
Funciona moviéndose repetidamente en la dirección de mayor descenso de una función. En cada paso usa el gradiente para decidir hacia dónde moverse y un tamaño de paso para decidir cuánto. Con el tiempo, este proceso conduce hacia un mínimo local.
Las funciones están por todas partes en matemáticas, programación y ciencia de datos. El "aprendizaje" en machine learning no es más que encontrar la mejor función (y sus parámetros) para mapear entradas a salidas. Ahora que ya sabes sobre funciones, ¡ponte a codificar algunas en Python o en tu lenguaje favorito!
Para ver cómo encajan estas ideas en flujos de trabajo reales de machine learning, puedes continuar con el curso Understanding Machine Learning.
Cursos de matemáticas
Curso
Curso
Curso
blog
DataCamp Team
11 min
blog
Zoumana Keita
14 min
Tutorial
Karlijn Willems
14 min
Tutorial
Javier Canales Luna
11 min
Tutorial
DataCamp Team
13 min
Tutorial
Kurtis Pykes
8 min


