
{count, plural, one {Corso} other {Corsi}}
Algebra lineare per la Data Science in R
{hours} ore
21.8K
Aspiranti e junior data scientist incontrano spesso il termine "funzione", ma non sempre è chiaro cosa significhi davvero.
In questo articolo scoprirai cos'è una funzione matematica, quali insiemi descrivono i suoi valori di input e output e in cosa differiscono i valori continui e discreti. Vedrai come le funzioni sono utilizzate nella tecnologia, le funzioni più comuni nella data science e come vengono ottimizzate. Lungo il percorso, vedrai anche codice Python per manipolare e rappresentare graficamente le funzioni.
Se vuoi esercitarti a scrivere e usare le tue funzioni in Python, ti consiglio il nostro corso Writing Functions in Python.
In matematica, una funzione associa a ogni input un unico output. Ogni input valido è inviato a uno e un solo output. Un input non può avere più output.
Per esempio, 32 gradi Fahrenheit corrispondono a 0 Celsius. Il valore in Fahrenheit corrisponde a un valore in Celsius; e corrisponde a un solo valore. Non puoi avere due diversi valori di output (Celsius) per un unico input valido (Fahrenheit).
Altri esempi includono le buste paga, dove vieni pagato un importo per ora. Se guadagni $20 l'ora e lavori 40 ore, guadagni 20 x 40 = $800.
Non tutte le regole sono funzioni. In alcuni casi ha senso, logicamente, avere più output per un singolo input. Per esempio, associare un nome a una persona non è una funzione. Il nome "John Smith" potrebbe corrispondere a più persone, tutte con lo stesso nome.
In matematica, spesso le regole sono impostate in modo tale che ci sia un solo output per ogni input valido. In molti casi, questo riflette esplicitamente come funziona davvero il mondo (buste paga). In altri casi, i problemi sono formulati in termini di funzioni perché rendono il problema trattabile. Invece di seguire un groviglio di input e output, il modello è definito in modo tale che ogni input non possa avere più output.
Puoi pensare a una funzione come a una "macchina" che accetta un input (spesso indicato con x), lo elabora in qualche modo e produce un output (spesso indicato con y).
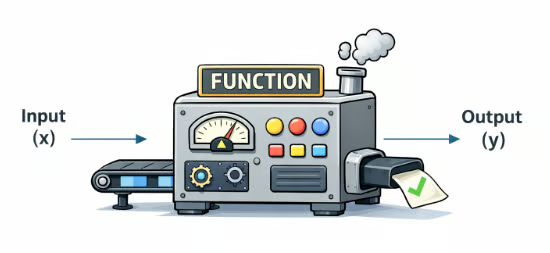
Qui, una macchina accetta input dal nastro trasportatore sul lato sinistro, lo elabora e produce a destra un allegro segno di spunta verde.
Multivariate funzioni multivariate accettano una collezione di più input ma producono un solo output. Puoi pensarlo come passare una riga di dati composta da diverse variabili o feature che mappano a un singolo output.
Come si scrive l'equazione? Nell'esempio della conversione di temperatura, potremmo scrivere la formula come y = f(x) = (5/9) (x - 32), con x la temperatura in Fahrenheit e y in Celsius. Per capire questa notazione, leggila da sinistra a destra.
A sinistra vedi y, che è l'output. La notazione f(x) indica che stai usando una funzione, chiamata f, che prende un input x. Nota che in questo contesto, f(x) non significa un qualche valore f moltiplicato per un altro valore x.
A destra c'è la formula. Dice di prendere l'input x, sottrarre 32 e moltiplicare questo risultato per 5/9.
Supponi di registrare la temperatura esterna una volta al giorno e di aver raccolto k misurazioni, indicate con (x1, x2, …, xk). Vuoi una funzione che restituisca la temperatura media da inizio anno dopo che sono trascorsi n giorni. Definisci una funzione che prenda un intero positivo n minore o uguale a k che restituisca la media delle prime n temperature, che è un numero reale. La notazione per una tale funzione è f: {1, 2, …, k} → ℝ.
È utile avere un gergo per descrivere gli insiemi nella funzione, il che ci porta a dominio, codominio e immagine.
Ora guardiamo l'immagine. Considera una semplice funzione quadratica: y = f(x) = x2. Per specificare dominio e codominio, scrivi f: ℝ → ℝ.
Ora sai che questo indica che sia il dominio (insieme degli input) sia il codominio (insieme degli output) sono composti da numeri reali. Tuttavia, riflettendoci un po', potresti renderti conto che l'insieme degli output non può essere tutti i numeri reali.
Poiché il quadrato di qualsiasi numero è non negativo, l'insieme degli output effettivamente realizzati non è l'insieme di tutti i numeri reali, ma solo dei numeri reali non negativi. Il termine per descrivere questa situazione è immagine. Diciamo che l'immagine di questa funzione è l'insieme di tutti i numeri reali non negativi.
Il codominio è l'insieme potenziale degli output; l'immagine è l'insieme degli output effettivi. Scegli il codominio per riflettere il tipo di output che intendi, e scopri l'immagine, che è l'insieme dei valori di output che si realizzano davvero.
Questo ci porta alla distinzione tra variabili continue e discrete:
Per esempio, una variabile continua in [0, 1] può assumere i valori 0, 0,5, 0,4141 o qualsiasi altro valore reale nell'intervallo. Le variabili continue sono comunemente usate in modelli in cui l'output potrebbe teoricamente essere qualsiasi valore, come nella regressione.
Tuttavia, nella classificazione binaria ti interessano solo due valori: 0 e 1. Per esempio, un'immagine contiene un gatto oppure no. In un problema di classificazione multiclasse, hai comunque solo un numero finito di valori, ad esempio 0 per un cane, 1 per un gatto, 2 per un cavallo.
Il problema che stai cercando di risolvere determina il tipo di funzione che ti interessa. I problemi di classificazione producono valori discreti; i problemi di regressione producono funzioni continue.
A volte devi passare più variabili a una funzione. Per esempio, potresti passare una riga di feature a una funzione di machine learning. In questo caso, puoi raggruppare le feature in un contenitore e passarlo. Un modo per raggruppare i dati in un contenitore di questo tipo è tramite un vettore. Il modello prende un vettore di input x = [x1, x2, x3] e restituisce un target y.
In Python, in genere usi un array NumPy per rappresentare un vettore.
import numpy as np

def f(x):
    result = (x[0] + x[1] + x[2]) / 3
    return result

x = [3, 4, 7.1]
print(f(x))4.7Questo codice prende un vettore composto dai numeri 3, 4 e 7.1 e restituisce una media.
Per una collezione di vettori, un metodo diffuso è usare la struttura dati DataFrame della libreria pandas.
import pandas as pd

def row_averages(df):
    return df.mean(axis=1).round(1)

df = pd.DataFrame({
    "A": [1, 5, 2],
    "B": [9, 3, 6],
    "C": [7, 8, 10]
})

print(row_averages(df))
Questo codice restituisce una Series di pandas contenente le medie di riga, un valore per riga. In questo caso:
0    5.7
1    5.3
2 6.0Il concetto di funzione è onnipresente nella tecnologia. Per ragioni pratiche, sappi che "funzione" non è sempre definita con il rigore della matematica. Per esempio, le funzioni di programmazione possono avere effetti collaterali che cambiano i valori di variabili diverse dall'output, mentre le funzioni matematiche no.
Le funzioni sono ampiamente utilizzate nei fogli di calcolo, ad esempio nelle Formule di Excel. Potresti voler calcolare la somma, la media o la mediana di una colonna di numeri. Per i fogli di calcolo, le funzioni seguono la stessa definizione matematica introdotta prima.
Una cosa in cui i fogli di calcolo eccellono (gioco di parole voluto) sono le funzioni condizionali: ti permettono di costruire strutture condizionali più complesse usando funzioni come IF().
Per esempio, potresti voler trovare il totale dei pagamenti effettuati alla tua società di mutuo nell'arco di un anno. Per farlo, probabilmente useresti la funzione SUM() del tuo foglio di calcolo.
Le funzioni sono ovunque nei linguaggi di programmazione. A seconda del linguaggio, la definizione di "funzione" può essere più lasca rispetto a quella matematica. Alcuni linguaggi permettono a una funzione di restituire più valori, o nessun valore.
Per esempio, una funzione può prendere dei valori e stampare una stringa, ma non restituire esplicitamente un valore. Una funzione Python ha questo aspetto:
def print_me(name, color):
       print(f"My name is {name} and my favorite color is {color}.")

name = "Mark"
color = "blue"
print_me(name, color)
Questo codice produce l'output: "My name is Mark and my favorite color is blue." Nessun valore matematico viene esplicitamente restituito dalla funzione.
Il codice in molti linguaggi diffusi, come Python, può anche avere altri effetti collaterali in una funzione, come cambiare il valore di una variabile globale. Anche se gli effetti collaterali sono possibili e consentiti, sono sconsigliati. Rendono i programmi più difficili da testare, fare debug e ragionare.
Per questi motivi, alcuni linguaggi "funzionali", come Scala e Haskell, sono basati in modo più rigoroso sull'idea di funzione.
Nel contesto del Machine Learning, gli input sono le feature, la funzione è il modello e l'output è la previsione del modello. Un tale modello è spesso descritto come una "scatola nera" perché non è necessariamente chiaro come le feature di input siano state elaborate per dare la previsione di output, motivo per cui la metafora della ”macchina” di prima calza ancora meglio:
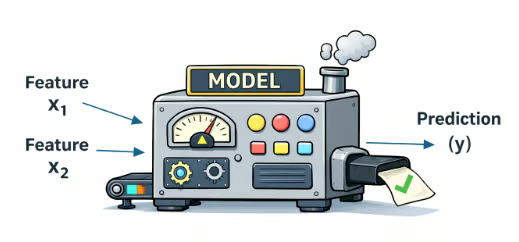
In questa illustrazione, le feature vengono alimentate nella "macchina" del modello, che le elabora in qualche modo e produce una previsione. Rispetto a funzioni più semplici e deterministiche come l'esempio della conversione di temperatura, ciò che accade dentro la macchina è più difficile da descrivere.
Nel ML, il dominio è costituito da vettori di feature; il codominio può essere fatto di probabilità, classi o previsioni a valori reali.
Nell'area del Deep Learning, le funzioni di solito non vengono applicate direttamente a un insieme di input, ma la correttezza del modello è valutata usando una funzione di costo. Una funzione di costo è una mesura di quanto un modello sbaglia sull'insieme di training. Confronta le previsioni con le etichette o i valori reali e aggrega gli errori in un unico numero.
Alcune funzioni compaiono quasi ovunque nella data science. Tra queste ci sono le funzioni lineari, logaritmiche ed esponenziali, oltre alle funzioni di attivazione non lineari per il deep learning.
Partiamo dall'esempio classico, le funzioni lineari.
Supponi di avere voglia di mele. Vai in un supermercato che vende mele a un prezzo fisso di $0,75 al chilo. Quindi un chilo di mele costa $0,75, 2 chili costano 2 x $0,75 = $1,50 e 3 chili costano 3 x $0,75 = $2,25. Ogni chilo che compri aggiunge una quantità fissa al costo totale.
In notazione funzionale, potresti scrivere la formula come f(x) = 0.75 x. Il numero 0,75 è la pendenza della funzione lineare. La pendenza è la velocità di variazione dell'output rispetto a ogni unità di variazione dell'input.
Per rappresentare graficamente una tale funzione, puoi usare un codice simile al seguente:
import numpy as np
import matplotlib.pyplot as plt

def cost_of_apples(x, m):
    result = m * x
    return result

# Define x and y
x = np.linspace(0, 5, 100)
y = cost_of_apples(x, 0.75)

# Plot
plt.figure()
plt.plot(x, y)
plt.xlabel("Pounds of Apples")
plt.ylabel("Total Cost ($)")
plt.title("Cost of Apples")
plt.show()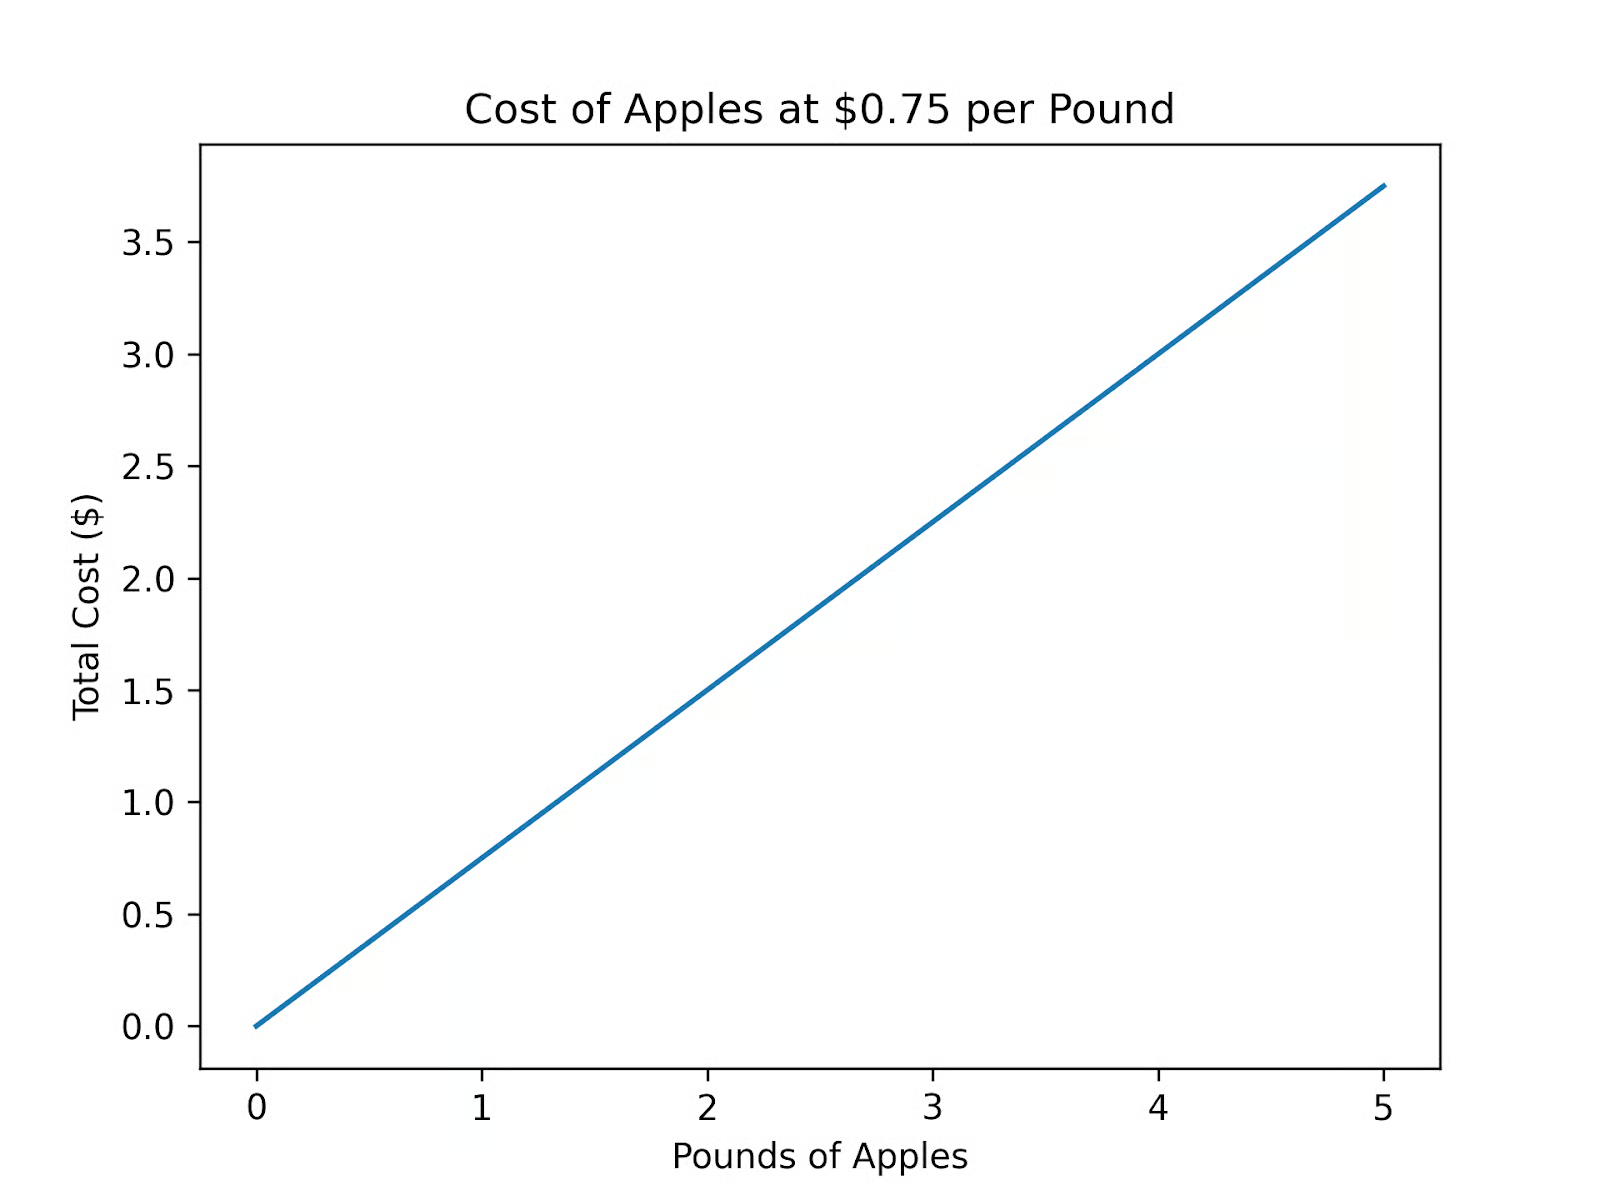
Tali funzioni sono dette funzioni lineari. Ogni incremento dell'input, x, contribuisce con la stessa quantità fissa all'output, y. Come suggerisce il nome, quando è rappresentata graficamente, una funzione lineare produce una retta.
Ora supponi che ti piaccia la consegna a domicilio. Il supermercato applica una tariffa fissa di consegna di $2,00. In questo caso, la funzione per le tue mele è f(x) = 0.75 x + 2. Come prima, 0,75 è la pendenza. Il numero 2, che è il punto in cui il grafico interseca l'asse y, è noto come "intercetta sull'asse y". È il valore di output quando l'input è 0.
Il costo totale è la somma delle mele e della tariffa di consegna. In generale, una funzione lineare univariata si può scrivere come f(x) = mx + b, dove il valore m è detto pendenza e b è detto intercetta y.
Probabilmente vorrai mangiare più delle sole mele. Supponi di voler comprare anche del pane e del burro di arachidi. Le mele costano $0,75 al chilo, una pagnotta di pane costa $2,50 e un barattolo di burro di arachidi costa $3,00. Ora, la funzione del tuo conto della spesa è:
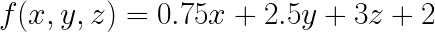
Questa funzione è ancora considerata lineare perché è lineare in ciascuna variabile. In generale, una funzione lineare assume la forma:
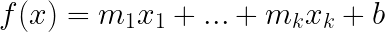
Questo equivale a sommare ciascuna quantità moltiplicata per il suo peso (un altro termine per pendenza usato in questo contesto), più l'intercetta.
In notazione vettoriale, questa funzione si scrive così:
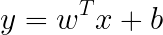
La T qui sta per “trasposta”, necessaria per eseguire la moltiplicazione vettoriale tra w e x.
Considera l'efficienza del carburante in funzione della velocità. Sospetti che, a mano a mano che si guida più veloce, l'efficienza diminuisca. Raccogli cinquanta punti dati tra 45 e 65 miglia orarie e vedi il seguente andamento:
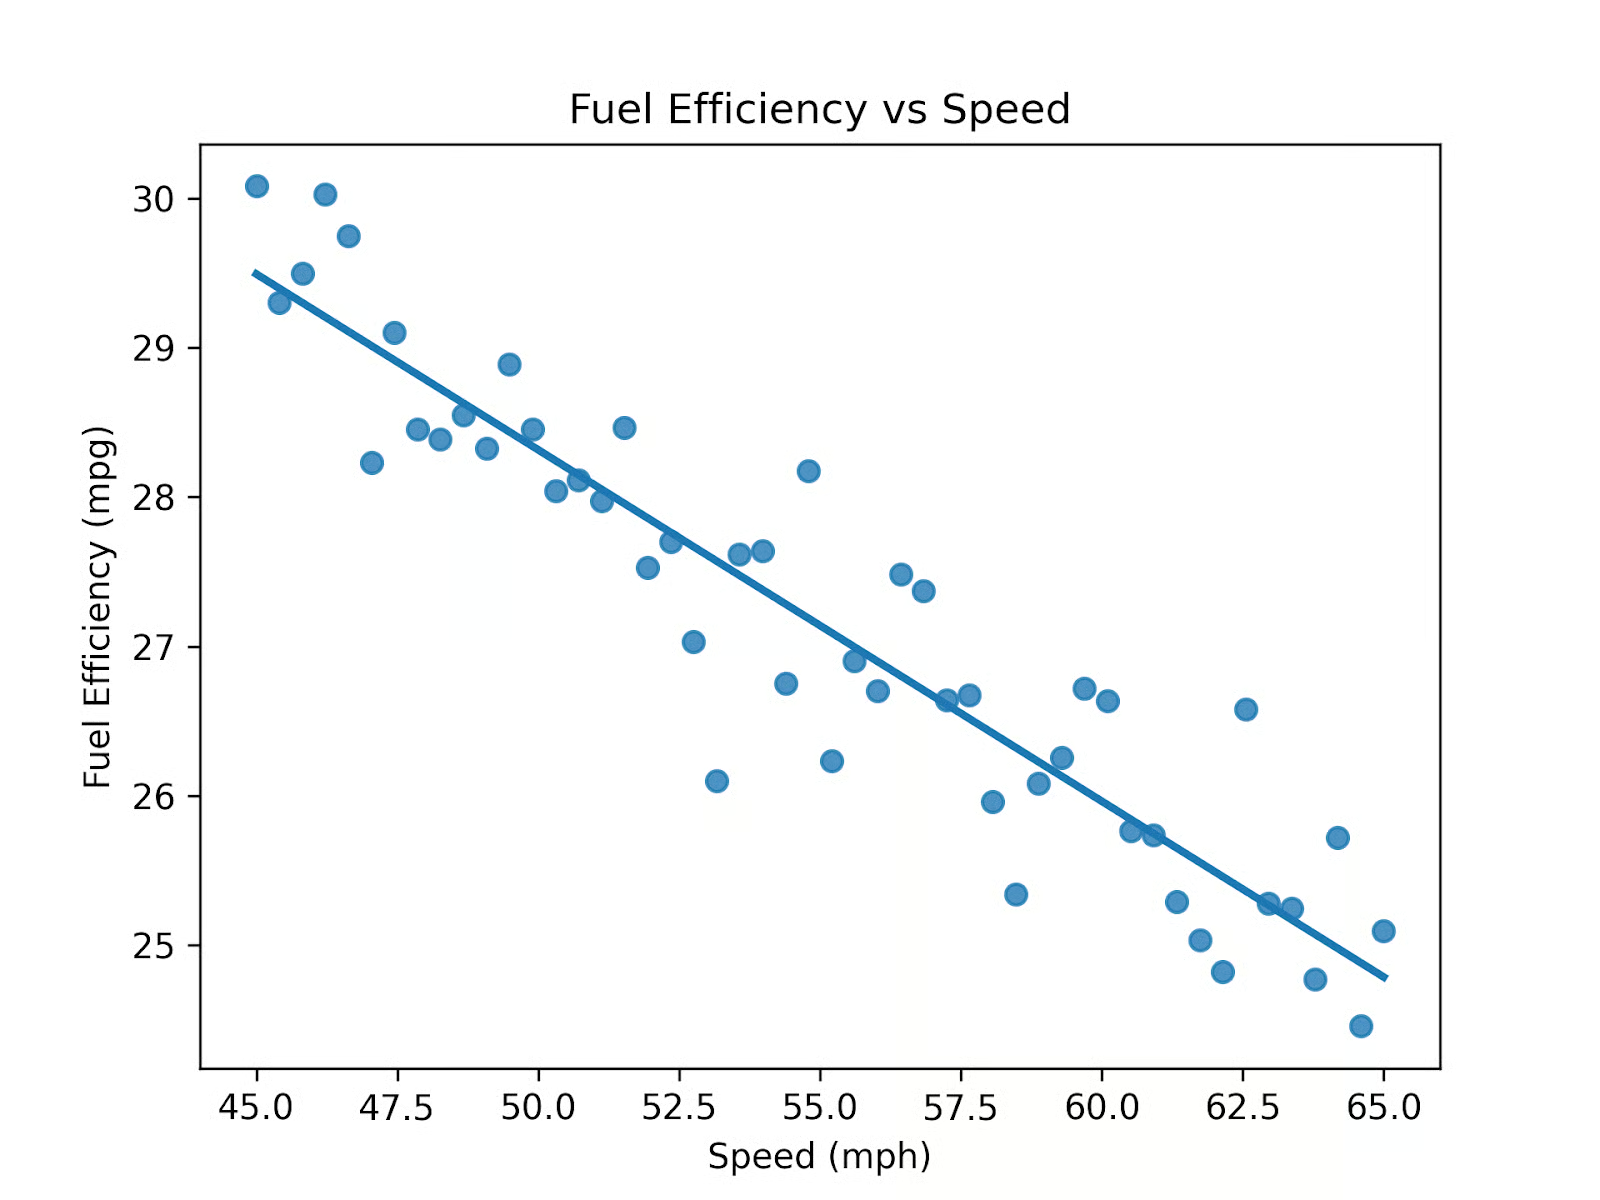
Collegare ogni punto dati ti darebbe un modello frastagliato, difficile da leggere e poco utile. Ma la tendenza generale dei dati è approssimativamente lineare su questo intervallo. Se chiamiamo x la velocità, la funzione per questo grafico è:
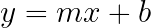
Per trovare una retta come questa che si adatti al meglio ai dati, usi un processo matematico chiamato regressione lineare semplice.
Puoi calcolare una retta di questo tipo in Python usando Matplotlib e Seaborn:
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# Reproducibility
np.random.seed(0)

# Create dataset
speed = np.linspace(45, 65, 50)
mpg = 38 - 0.2 * speed + 0.002 * (speed - 55)**2 + np.random.normal(0, 0.5, size=50)

df = pd.DataFrame({
    "speed": speed,
    "mpg": mpg
})

# Plot with regression line
sns.regplot(data=df, x="speed", y="mpg", ci=None)

plt.xlabel("Speed (mph)")
plt.ylabel("Fuel Efficiency (mpg)")
plt.title("Fuel Efficiency vs Speed")
plt.show()
La regressione lineare funziona con più variabili. Supponi di voler definire un modello di regressione lineare per velocità (x), peso del veicolo (y) e cilindrata (z). La formula risultante per la regressione lineare multivariata è:
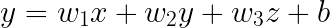
In questo caso, il coefficiente di ciascuna variabile rappresenta il peso o l'importanza di quella feature, a parità delle altre variabili.
Ora, "invertiamo" la questione delle mele: se hai speso $2,25 in mele, quanti chili hai comprato? La risposta è 2,25 / 0,75 = 3, quindi hai comprato tre chili. Questo tipo di "inversione" di una funzione è detta inversa della funzione. Nell'esempio senza intercetta, l'inversa è:
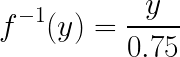
Nota che in questa notazione il "-1" indica che stai prendendo l'inversa di una funzione, non un reciproco.
Una cosa a cui prestare attenzione è che il dominio può cambiare. Per esempio, supponi che la tua funzione originale sia:
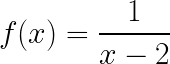
Questa funzione è definita per tutti i numeri reali tranne 2, poiché il denominatore non può essere zero. L'inversa di questa funzione è
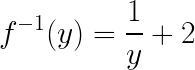
Per lo stesso motivo, la funzione inversa è definita per tutti gli input tranne 0.
Un altro tranello a cui prestare attenzione è che l'inversa risultante potrebbe non essere una funzione perché presenta più output per un singolo input. Considera la funzione y = x2. La sua inversa sarebbe quindi:
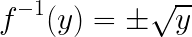
Come si vede dal più/meno, l'inversa ha due output per un input, quindi non è una funzione a meno di restringere il dominio (ad esempio, a x ≥ 0)
Graficamente, una funzione e la sua inversa (se esiste) sono l'immagine speculare rispetto alla retta y=x. Considera la funzione y = x3. Il grafico di questa funzione e della sua inversa è: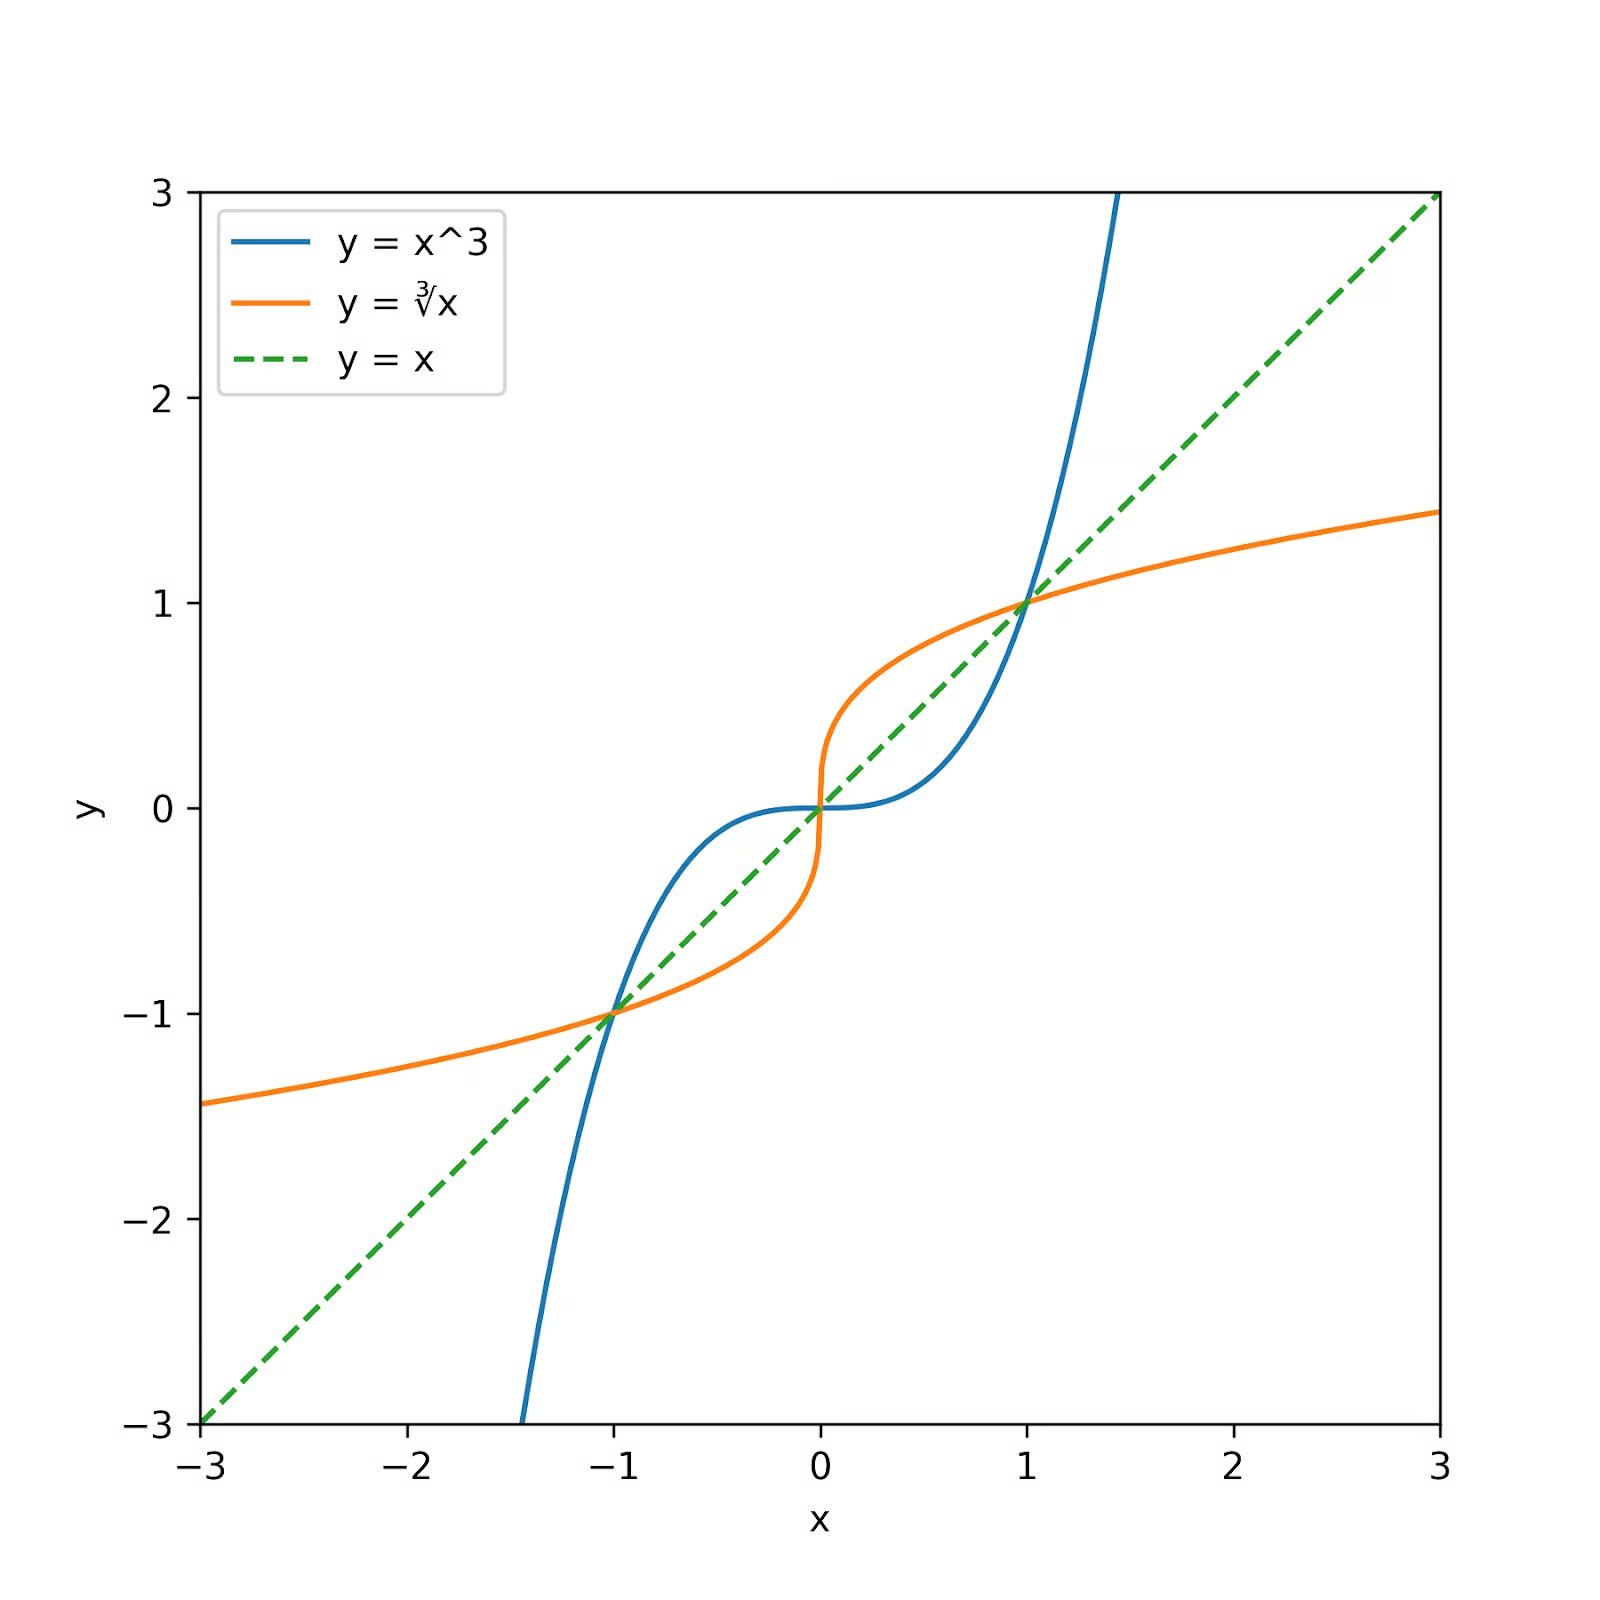
La funzione originale (in blu) ha un'inversa (in arancione) che è riflessa rispetto alla retta y = x.
Vediamo due tipi di funzioni strettamente correlate: le funzioni esponenziali e quelle logaritmiche.
Supponi di depositare $100 in un conto di risparmio che paga il 10% di interessi, capitalizzati annualmente.
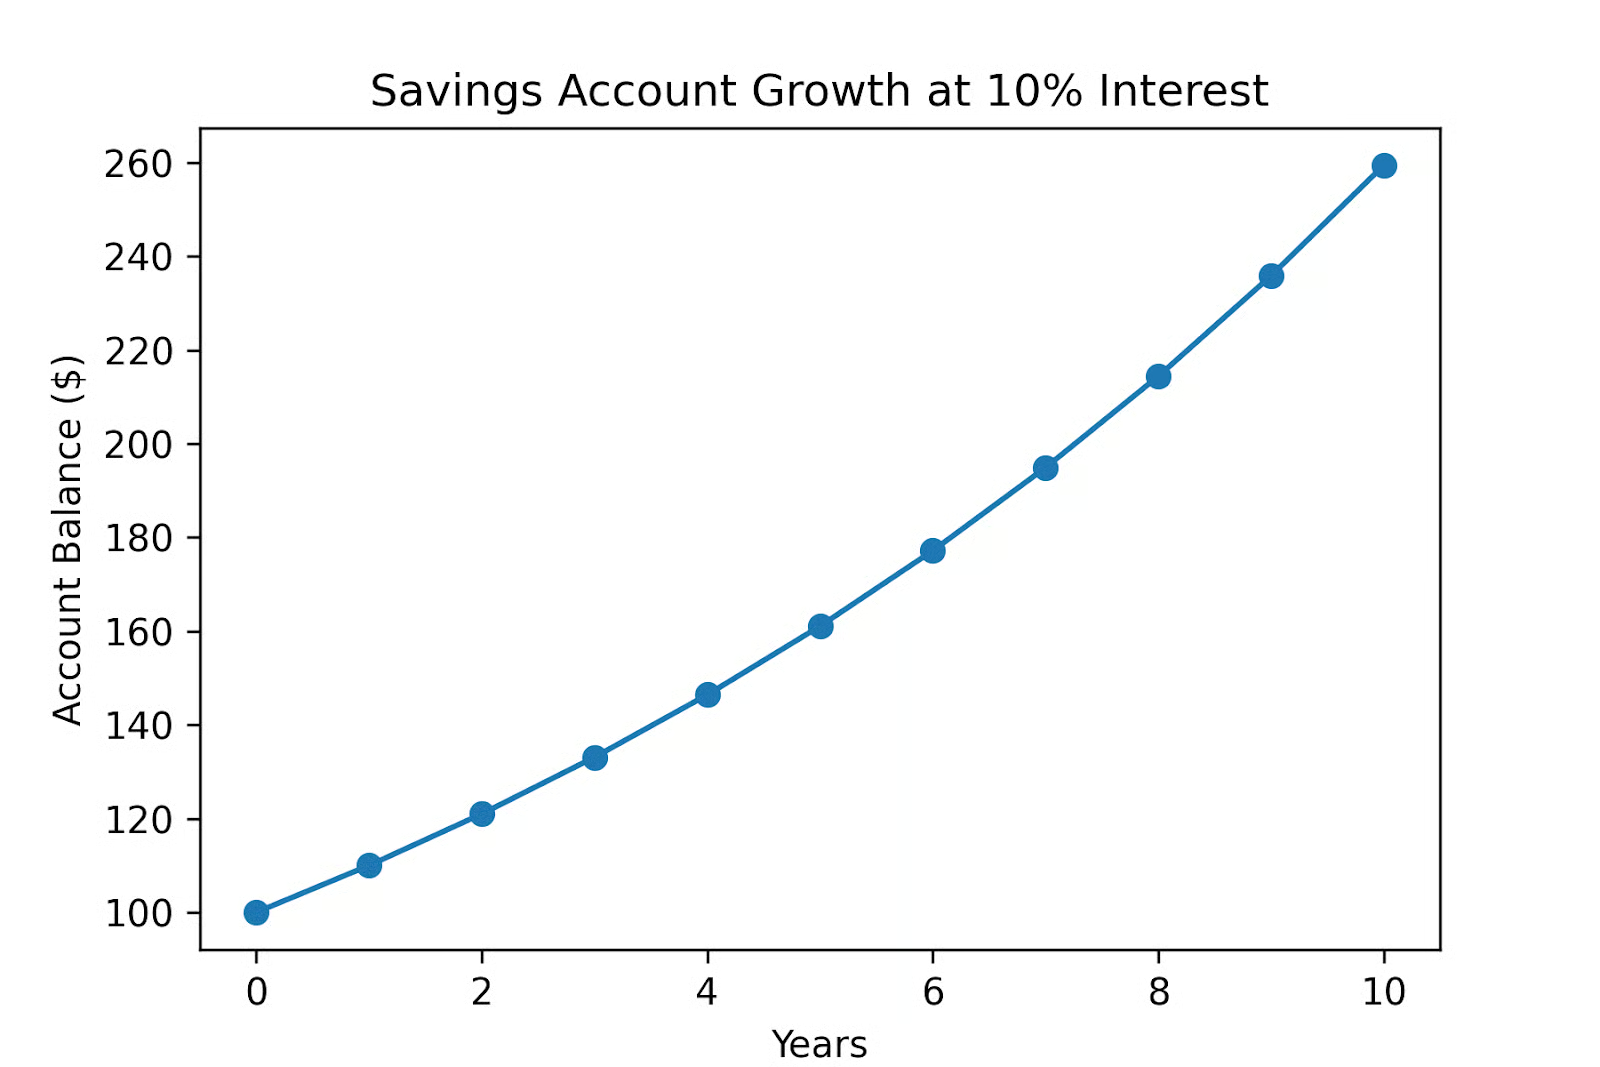
Questo è un esempio di crescita esponenziale. Ogni passo moltiplica il passo precedente per una quantità fissa. La funzione generale per la crescita esponenziale è y = A bx, dove y è l'output, x è l'input (spesso il tempo), A è l'importo iniziale e b è il fattore di crescita per unità di x.
Nella data science, i modelli esponenziali compaiono in processi di crescita composta come la crescita degli utenti o dei ricavi, in modelli di probabilità e in molte altre applicazioni.
Le funzioni logaritmiche ribaltano la domanda. Ora, invece di chiedere l'importo dopo che è passato x tempo, supponi di voler sapere quanto tempo serve lasciare crescere il denaro per raggiungere $200, assumendo un fattore di capitalizzazione del 10%.
Ora dobbiamo sapere quante volte 1,10 è moltiplicato per se stesso per ottenere 2. A questa domanda rispondono i logaritmi.
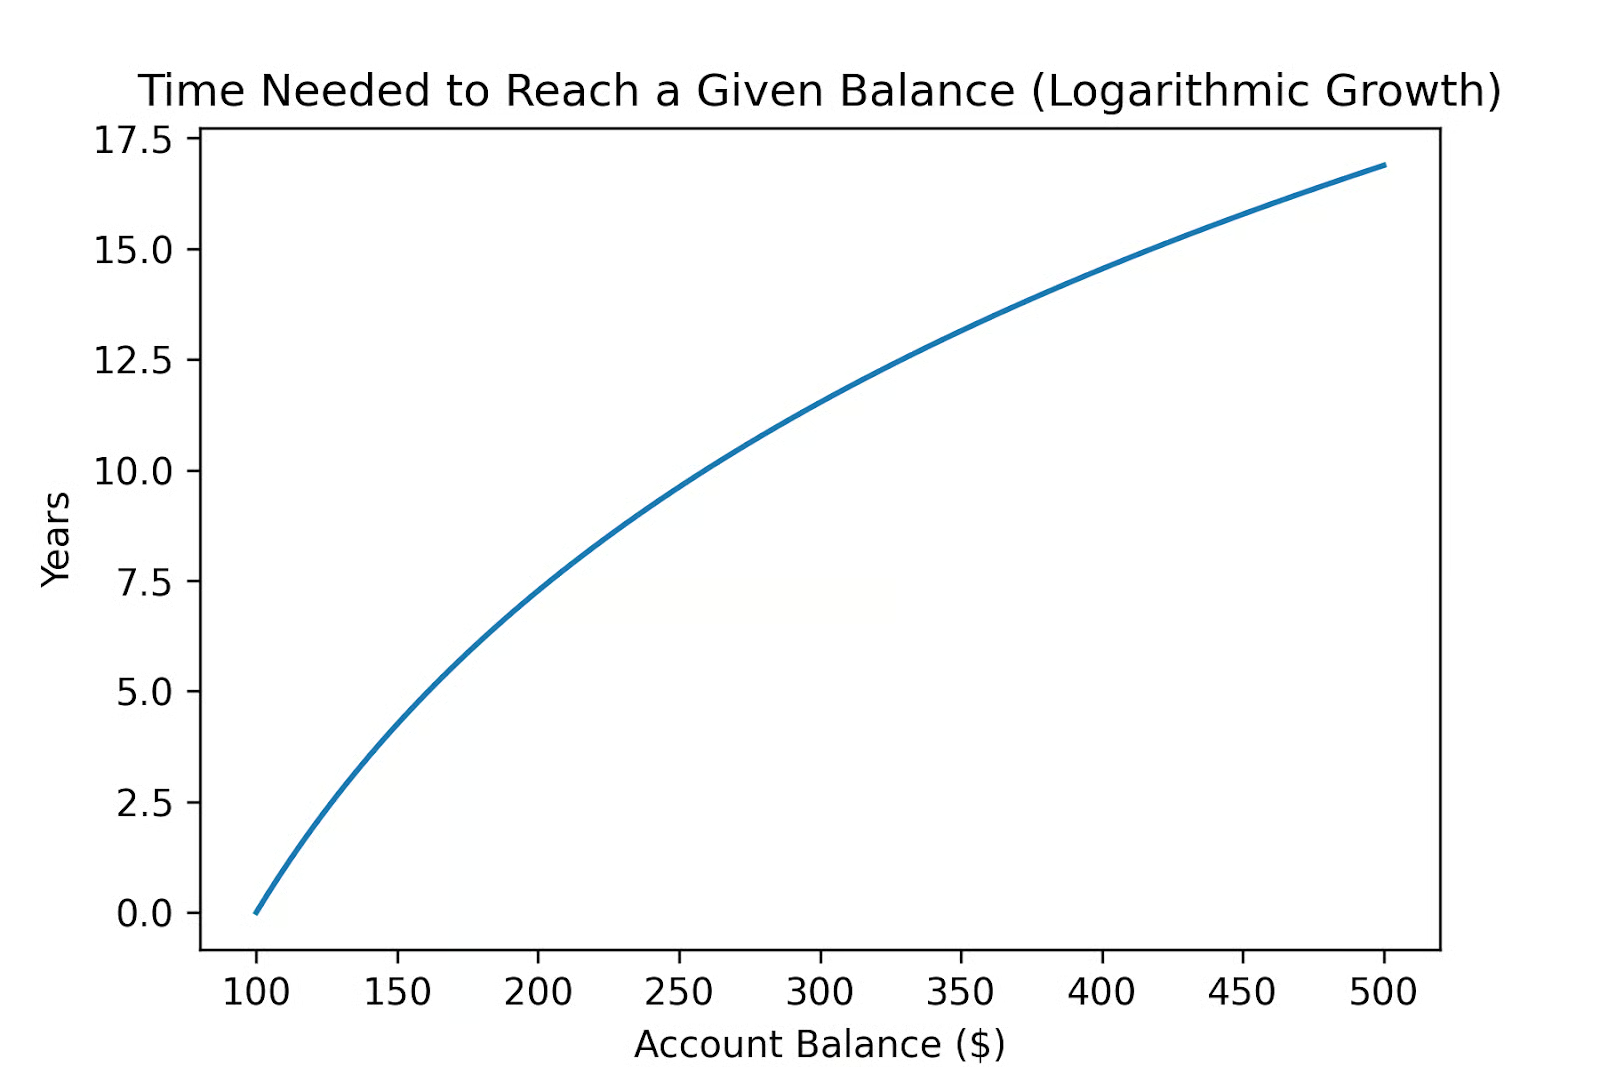
Guardando il grafico, vediamo che ci vorranno poco più di 7 anni perché il nostro denaro raddoppi.
Come abbiamo visto, le funzioni logaritmiche sono l'inversa delle funzioni esponenziali. I modelli esponenziali chiedono: dopo x mesi, qual è l'ammontare? I modelli logaritmici chiedono: dato un ammontare, quanti mesi sono serviti per arrivarci?
I data scientist usano spesso i logaritmi per rendere gestibile una distribuzione asimmetrica. Per esempio, le distribuzioni dei redditi sono di solito fortemente asimmetriche a destra: pochi redditi alti allungano la coda superiore della distribuzione, mentre la maggior parte delle persone è concentrata nella parte bassa.
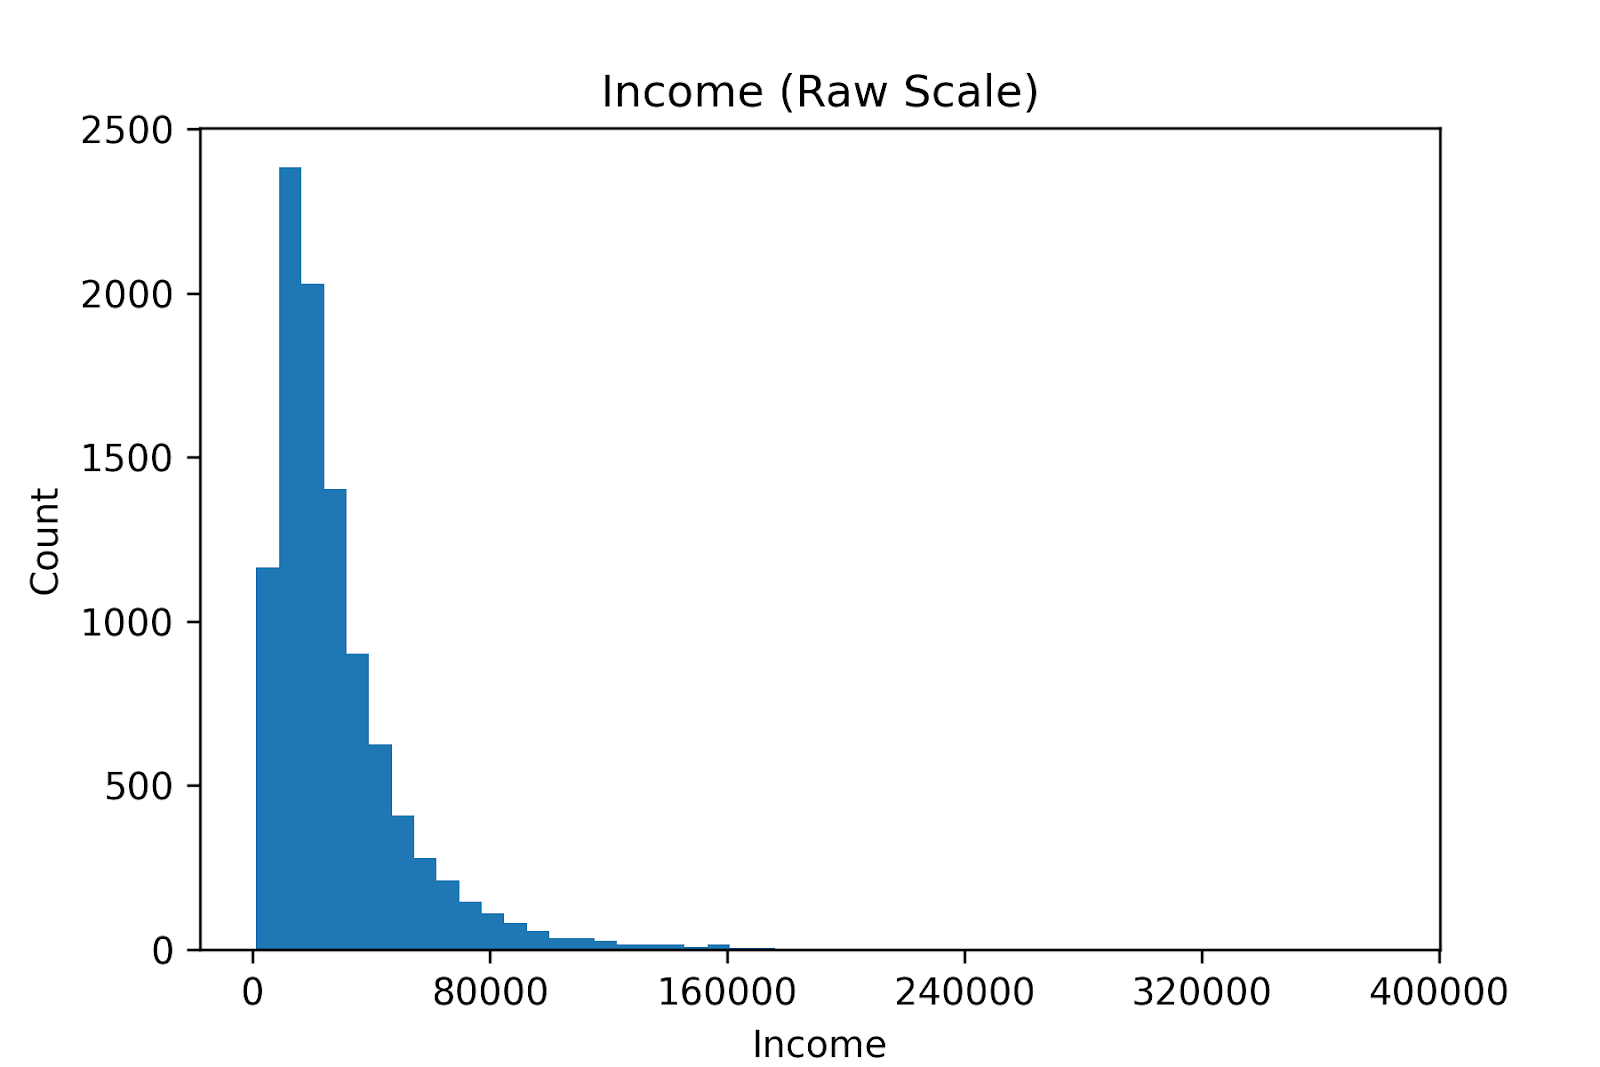
Puoi trasformare i dati prendendo il logaritmo di ogni punto dati:
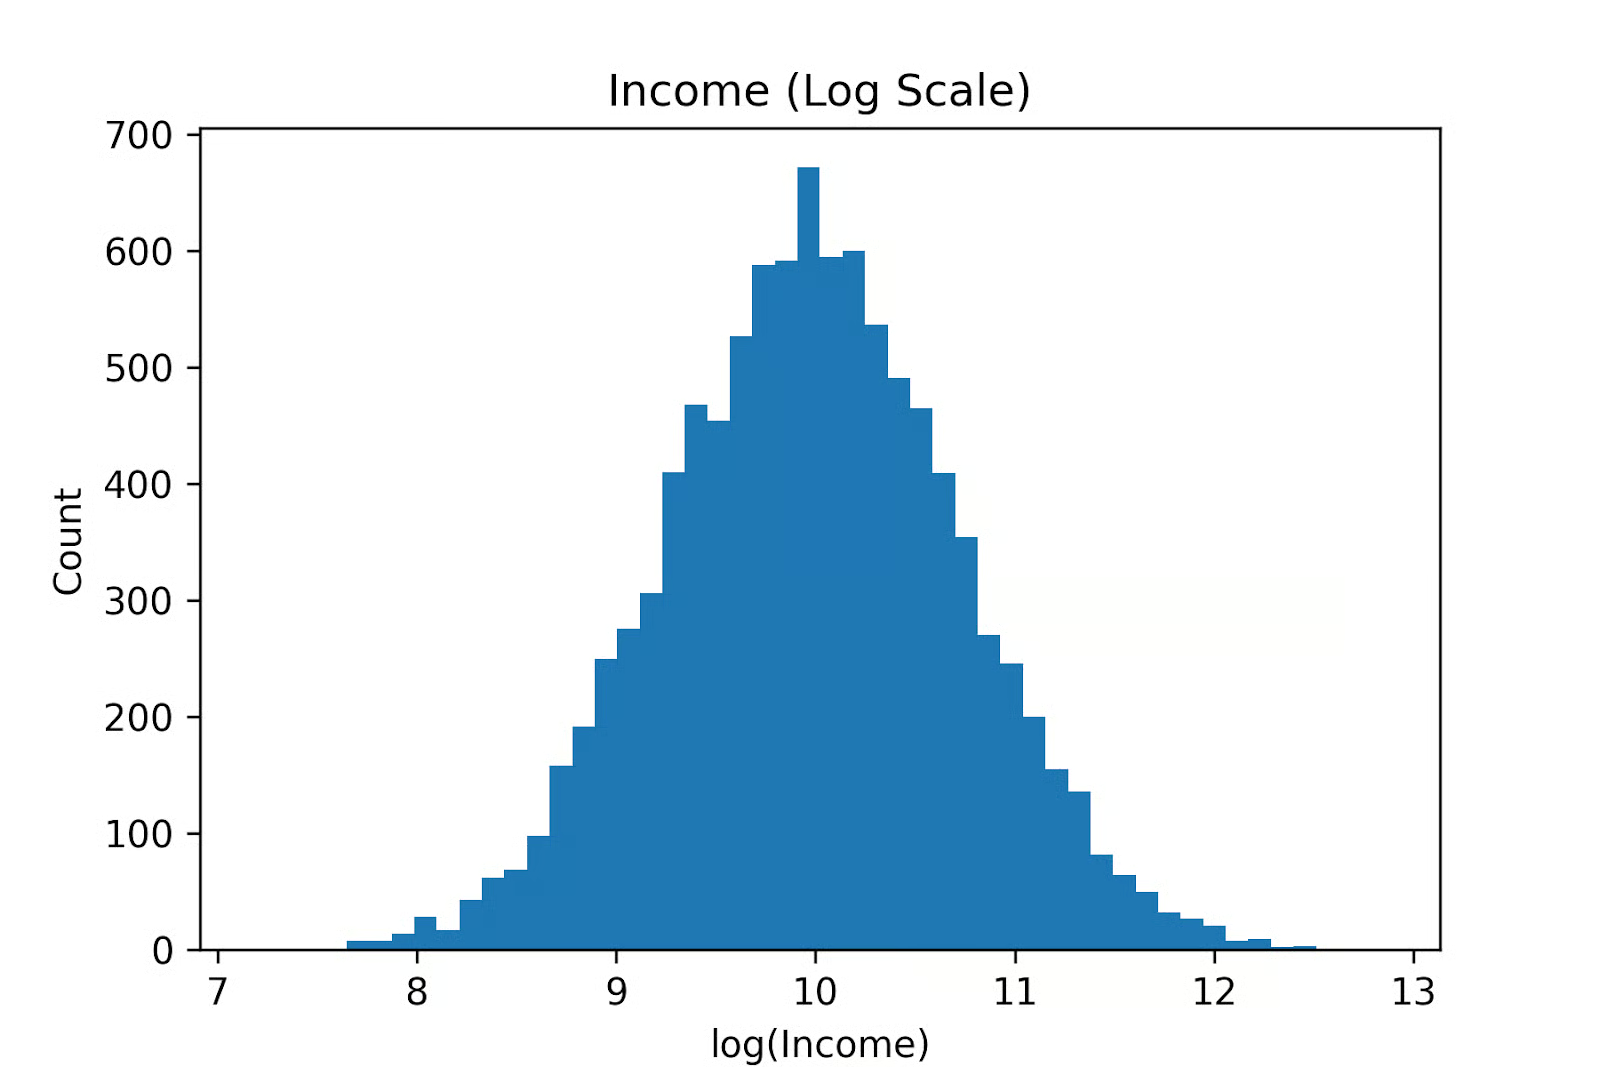
I redditi elevati vengono compressi mentre gli altri si distendono. Le trasformazioni logaritmiche cambiano la domanda da differenze assolute a differenze relative. Di conseguenza, la lunga coda destra collassa e la distribuzione spesso diventa approssimativamente normale. Ora la varianza è più stabile e possiamo applicare la regressione lineare.
Il logaritmo gioca un ruolo centrale in una delle funzioni di perdita più usate nella classificazione binaria, nota come Cross-Entropy Loss o log loss, definita per un singolo campione come:
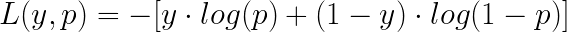
Qui, la variabile binaria y (0 o 1) è il valore reale per un campione, e p è la probabilità prevista che y sia la classe 1.
La log loss penalizza fortemente previsioni sicure ma errate. Prevedere una probabilità vicina a 0 quando l'etichetta reale è 1 (o viceversa) comporta una penalità elevata, mentre previsioni incerte comportano penalità minori. Questo rende la log loss adatta all'addestramento di classificatori probabilistici come la regressione logistica.
Le funzioni di attivazione sono usate nelle reti neurali per garantire che l'output di ogni livello sia non lineare. Funzioni di attivazione comuni sono sigmoid e ReLU.
La funzione sigmoide è una funzione liscia, a forma di S, definita dalla seguente formula:
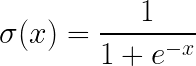
Accetta come input qualsiasi numero reale e restituisce un valore strettamente compreso tra 0 e 1. Viene usata per convertire punteggi grezzi in probabilità.
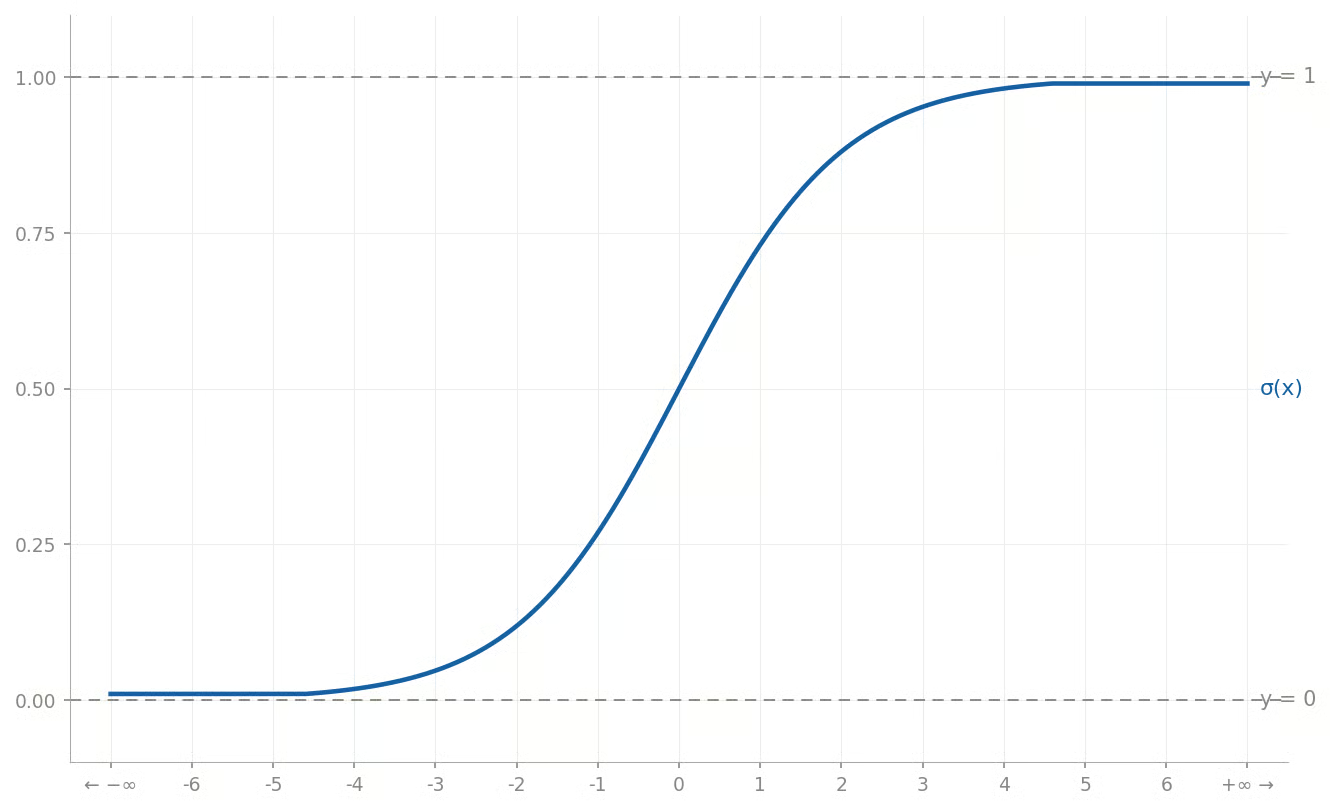
Un caso d'uso comune della funzione sigmoide è nella regressione logistica per la classificazione binaria. La regressione logistica calcola una combinazione lineare degli input per produrre un punteggio. Quel punteggio viene poi convertito in una probabilità usando la funzione sigmoide. Le probabilità sopra una soglia (tipicamente 0,5) sono classificate come 1, quelle sotto la soglia come 0.
Per approfondire, consulta i nostri tutorial Python Logistic Regression e Logistic Regression in R.
La funzione Rectified Linear Unit (ReLU) converte i numeri negativi in 0 e lascia invariati i numeri positivi. È definita come:
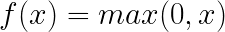
Per valori maggiori di 0, coincide con la funzione identità, come si vede dal grafico:
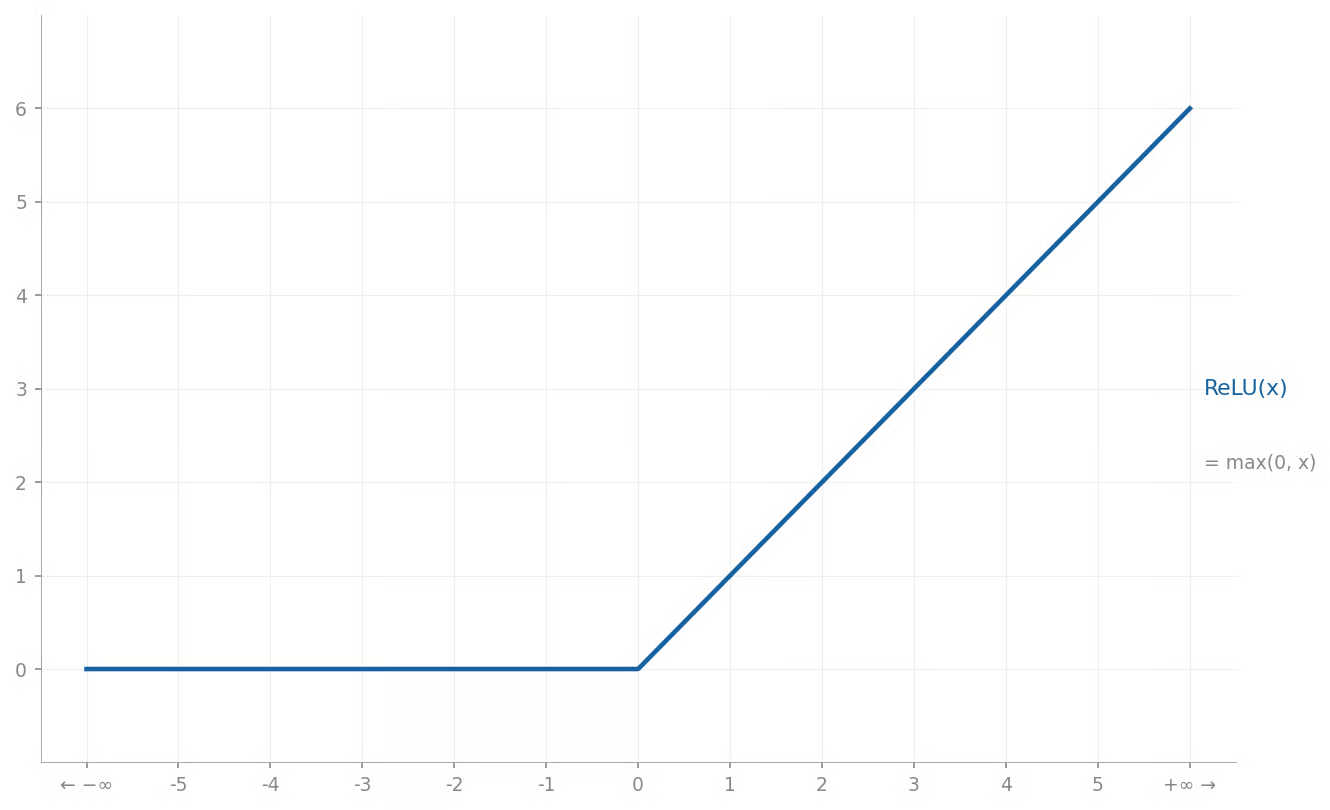
Come la sigmoide, agisce come funzione di attivazione non lineare nei livelli nascosti di una rete neurale. Tuttavia, è computazionalmente semplice, richiedendo solo un'operazione di massimo, mentre la sigmoide richiede una costosa chiamata alla funzione esponenziale.
Poiché una ReLU imposta tutti i valori negativi a 0, produce sparsità nella rete, dove molti neuroni vengono azzerati. Questo può ridurre il rumore e portare a rappresentazioni più efficienti.
Un'altra forma di funzioni non lineari si trova negli alberi decisionali, che partizionano ricorsivamente lo spazio degli input in regioni più piccole suddividendo per feature e soglie fino al soddisfacimento di un criterio di arresto.
A ogni nodo foglia risultante viene assegnato un valore di previsione. Pertanto, un albero decisionale può essere visto come una funzione a tratti, in cui ciascuna regione del dominio mappa a un valore di previsione costante. Unendo molte regole locali, gli alberi decisionali possono catturare pattern complessi.
Per esempio, potresti vedere una regione bidimensionale partizionata come segue:
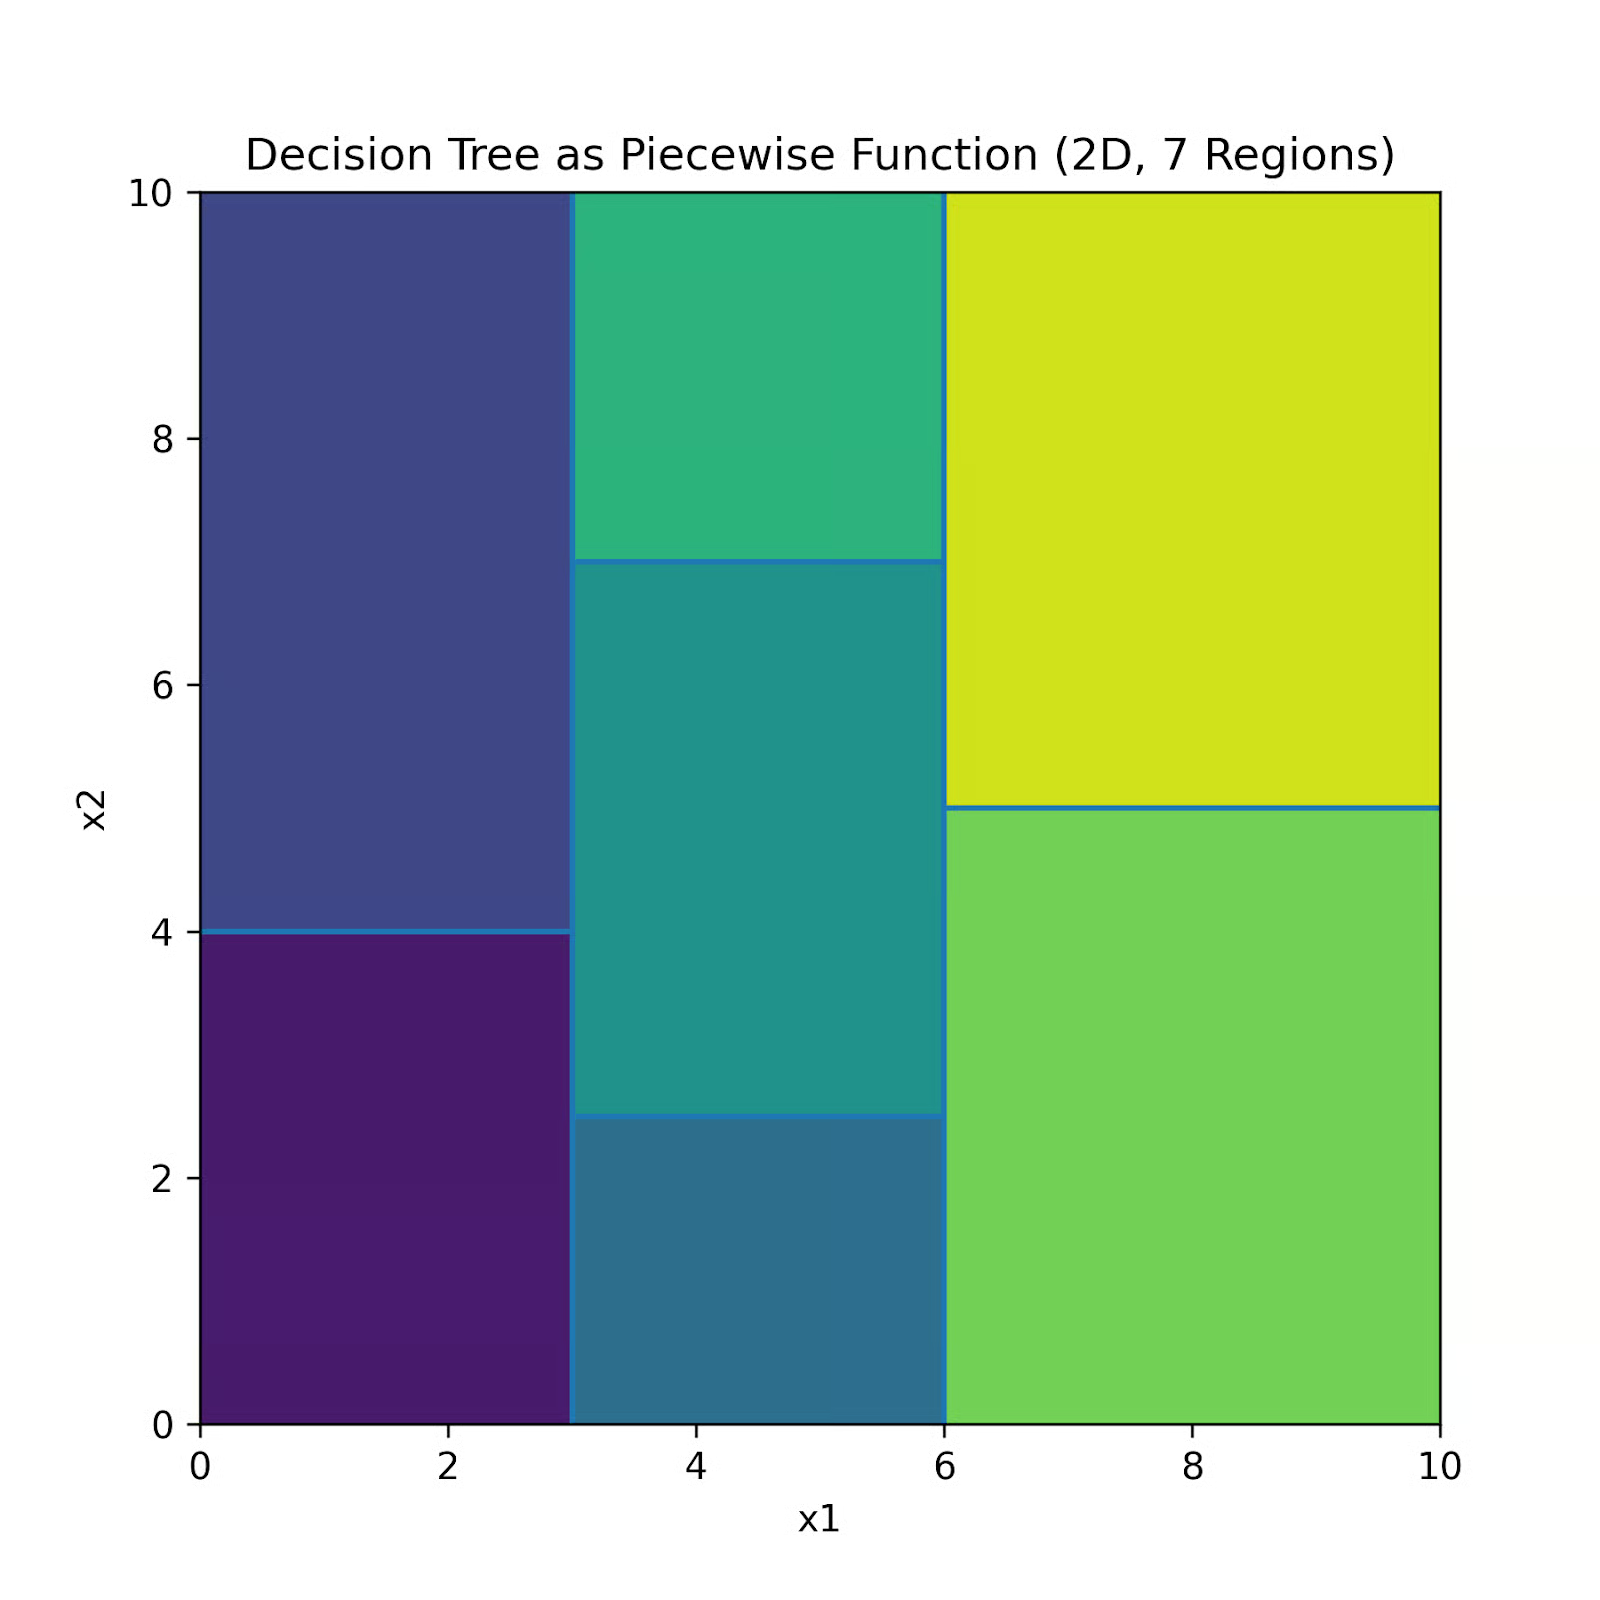
Questa heat map corrisponde alle seguenti regioni:
|
Regione |
Parte del dominio |
Valore della funzione |
|
1 |
x1 < 3 e x2 < 4 |
1 |
|
2 |
x1 < 3 e x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 e x2 < 2.5 |
3 |
|
4 |
3 ≤ x1 < 6 e 2.5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 e x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 e x2 < 5 |
6 |
|
7 |
x1 ≥ 6 e x2 ≥ 5 |
7 |
L'ottimizzazione delle funzioni è il processo di trovare i valori di input che massimizzano o minimizzano una funzione. Per esempio, potresti voler massimizzare una funzione di profitto o minimizzare una funzione di errore. Lo studio dell'ottimizzazione delle funzioni è noto come "ricerca operativa" ed è un vasto e continuo corpo di teoria matematica.
L'ottimizzazione delle funzioni è strettamente collegata agli "estremi" locali e globali di una funzione (punti di massimo o minimo). Un "minimo locale" è un minimo all'interno di un particolare intervallo, e un "minimo globale" è il minimo complessivo della funzione.
Per esempio, considera la funzione f(x) = x4 - 3x2 + x.
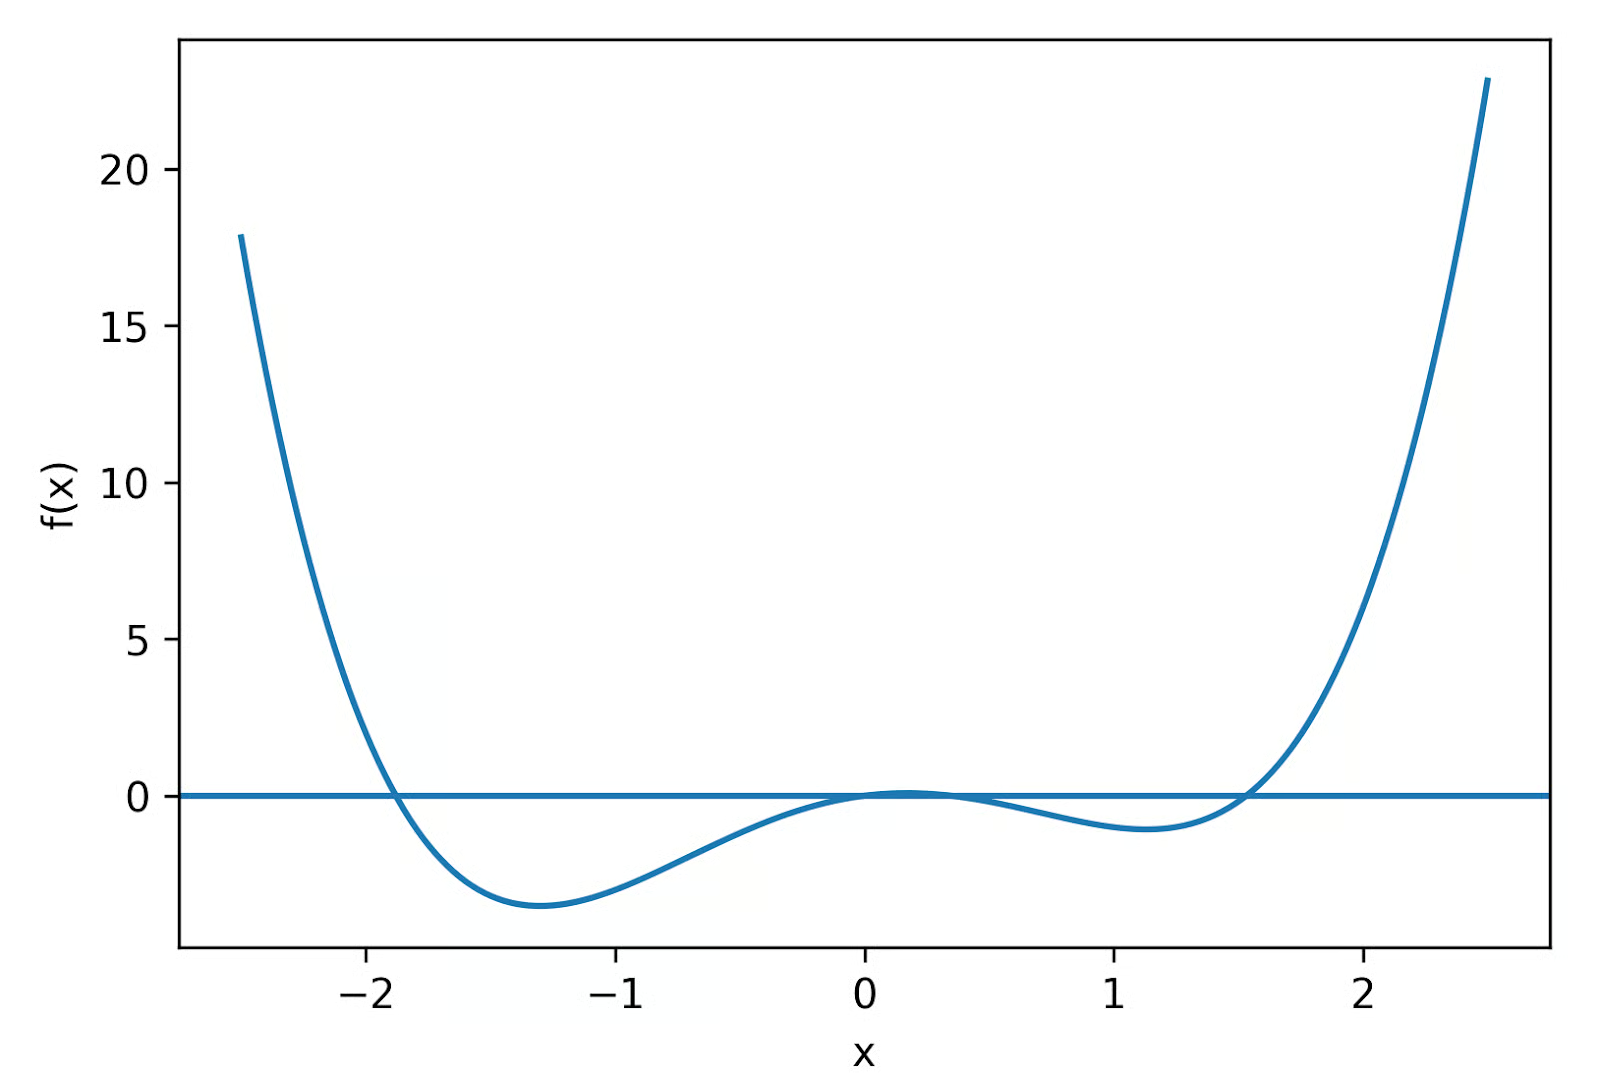
Ci sono due minimi locali: uno quando x è circa -1,30 e un altro quando x è circa 1,13. Il valore di y è più basso quando x è -1,30, quindi quello è il minimo globale della funzione.
Per compiti di ottimizzazione semplici, come trovare il prezzo ottimale per massimizzare il profitto in un modello di prezzo a una variabile, è sufficiente derivare la funzione, porre la derivata uguale a zero e risolvere per x. Per l'addestramento di reti neurali profonde non è così semplice, ma il principio è simile.
Il metodo di ottimizzazione più importante per il Deep Learning è la discesa del gradiente. Il gradiente è la generalizzazione multi‑dimensionale della pendenza, e ci dice come cambia la loss rispetto a ciascun parametro.
Funziona spostandosi ripetutamente nella direzione di massima discesa di una funzione. A ogni passo usa il gradiente per decidere in che direzione muoversi e una dimensione del passo per decidere di quanto. Nel tempo, questo processo conduce verso un minimo locale.
Le funzioni sono ovunque in matematica, programmazione e data science. Il "learning" nel machine learning è proprio trovare la migliore funzione (e i suoi parametri) per mappare gli input agli output. Ora che conosci le funzioni, prova a scriverne un po' in Python o nel tuo linguaggio preferito!
Per vedere come queste idee si inseriscono nei flussi di lavoro reali di machine learning, puoi proseguire con il corso Understanding Machine Learning.
Corsi di matematica
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



