

घातीय और लघुगणकीय फ़ंक्शन
आइए दो प्रकार के निकट से संबंधित फ़ंक्शनों को देखें: घातीय और लघुगणकीय फ़ंक्शन।
घातीय फ़ंक्शन
मान लीजिए आप $100 ऐसे सेविंग अकाउंट में जमा करते हैं जो 10% ब्याज देता है, वार्षिक चक्रवृद्धि के साथ।
- वर्ष 0 पर (एक वर्ष बीतने से पहले), f(0) = $100।
- वर्ष 1 के बाद, f(1) = $100 x 1.10 = $110।
- वर्ष 2 के बाद, f(2) = $110 x 1.10 = ($100 x 1.10) x 1.10 = $100 x 1.102 = $121।
- वर्ष 3 के बाद, f(3) = $121 x 1.10 = ($100 x 1.10 x 1.10) x 1.10 = $100 x 1.103 = $133.10
- वर्ष x के बाद, f(x) = $100 * 1.10x।
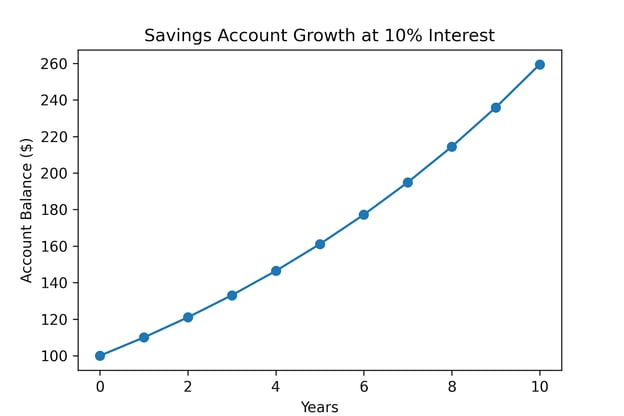
यह घातीय वृद्धि का उदाहरण है। हर कदम पिछले कदम को एक निश्चित मात्रा से गुणा करता है। घातीय वृद्धि के लिए सामान्य फ़ंक्शन है y = A bx, जहाँ y आउटपुट है, x इनपुट (अक्सर समय), A प्रारंभिक राशि है, और b x की प्रति इकाई का वृद्धि गुणांक है।
डेटा साइंस में, घातीय मॉडल चक्रवृद्धि वृद्धि प्रक्रियाओं जैसे उपयोगकर्ता वृद्धि या राजस्व वृद्धि, प्रायिकता मॉडलों, और कई अन्य अनुप्रयोगों में दिखाई देते हैं।
लघुगणकीय फ़ंक्शन
लघुगणकीय फ़ंक्शन इस प्रश्न को उलट देते हैं। अब, x समय बीतने के बाद राशि कितनी होगी पूछने के बजाय, मान लीजिए आप जानना चाहते हैं कि $200 तक पहुँचने में आपके पैसों को कितना समय लगेगा, यदि आप 10% के चक्रवृद्धि गुणांक को मान लें।
- समीकरण सेट करें: 200 = 100 * 1.10x
- प्रत्येक तरफ 100 से भाग दें: 2 = 1 * 1.10x
अब हमें यह जानना है कि 2 पाने के लिए 1.10 को अपने आप से कितनी बार गुणा किया गया है। यही प्रश्न लॉगरिद्म्स हल करते हैं।
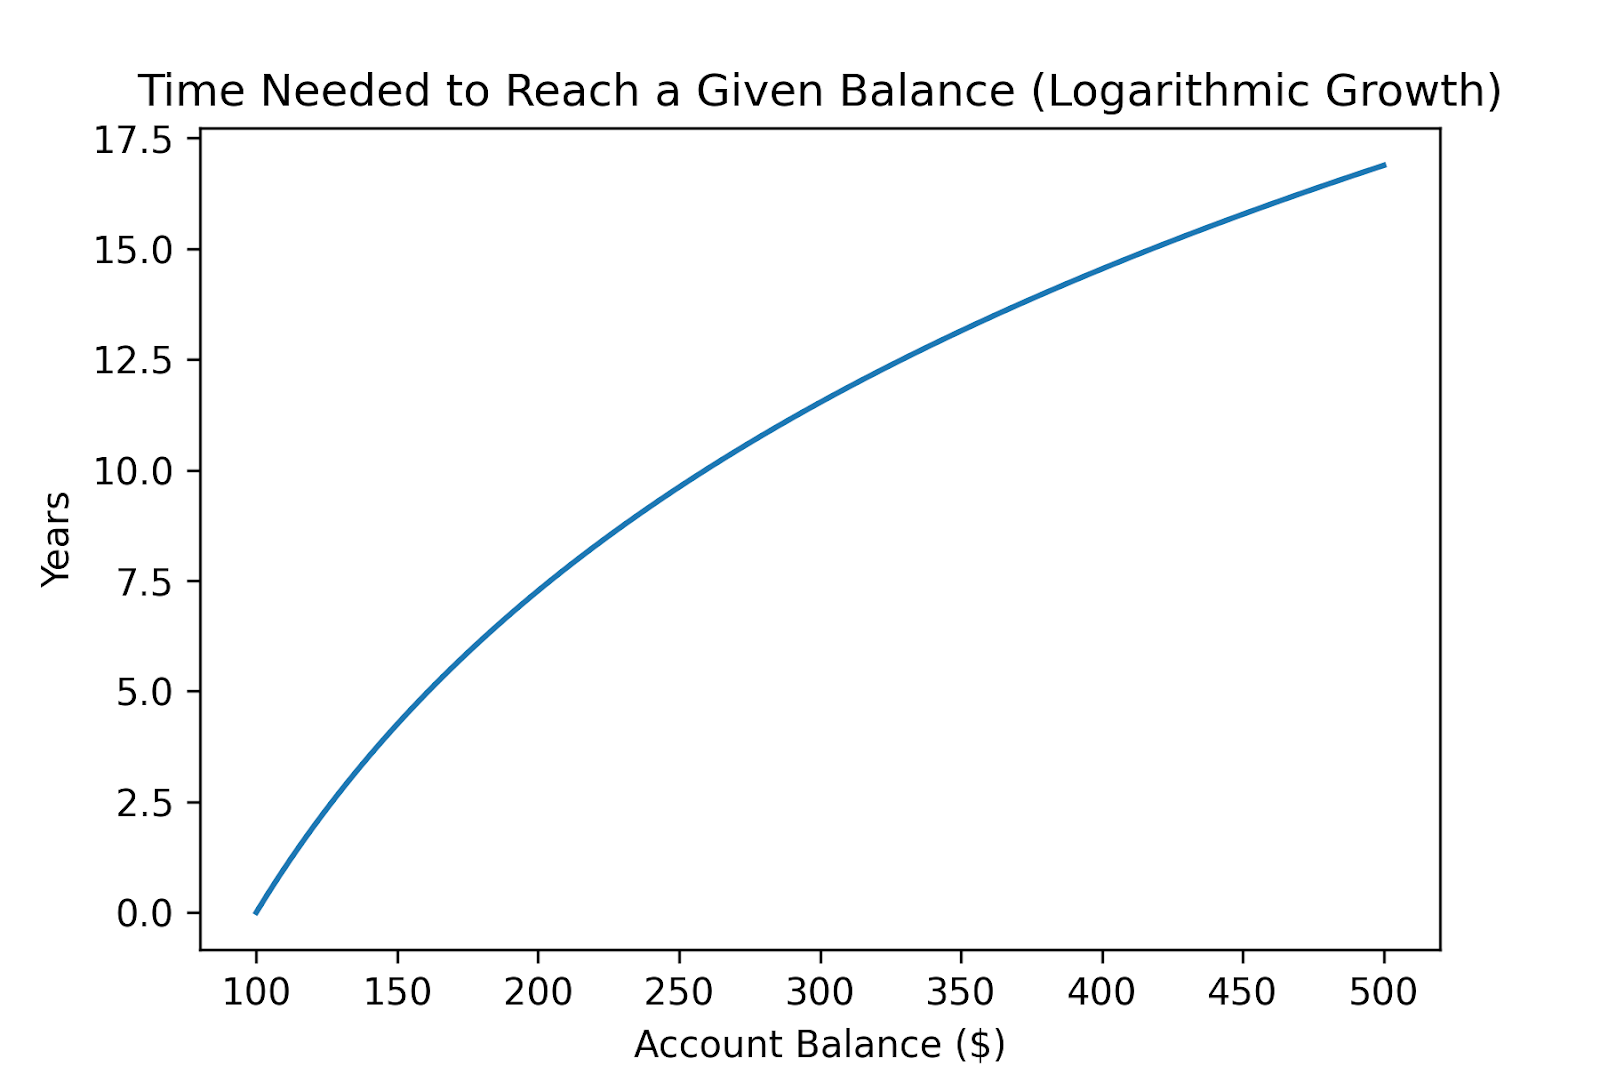
ग्राफ़ को देखकर, हम देखते हैं कि हमारे पैसों के दोगुना होने में 7 साल से थोड़ा अधिक समय लगेगा।
जैसा कि हमने समझा, लघुगणकीय फ़ंक्शन घातीय फ़ंक्शनों के इनवर्स होते हैं। घातीय मॉडल यह पूछते हैं: x महीनों के बाद वृद्धि दर क्या है? लघुगणकीय मॉडल पूछते हैं: दी गई वृद्धि दर के आधार पर वहाँ तक पहुँचने में कितने महीने लगे?
डेटा साइंटिस्ट अक्सर किसी तिरछे (skewed) वितरण को संभालने योग्य बनाने के लिए लॉगरिद्म का उपयोग करते हैं। उदाहरण के लिए, आय वितरण आमतौर पर अत्यधिक दाएँ‑तिरछे होते हैं: कुछ उच्च आय वाले शीर्ष को खींच देते हैं, जबकि अधिकांश लोग निचले सिरे पर सघन होते हैं।
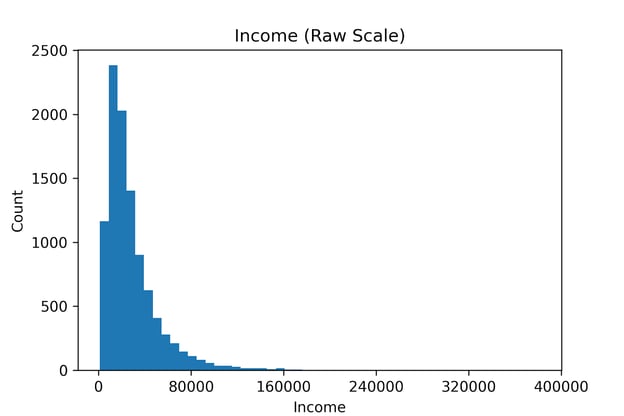
आप प्रत्येक डेटा बिंदु का लघुगणक लेकर डेटा को रूपांतरित कर सकते हैं:
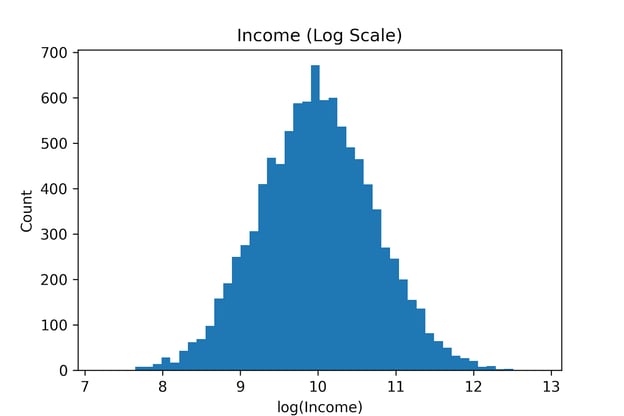
बड़ी आयें संकुचित हो जाती हैं जबकि अन्य आयें फैल जाती हैं। लॉग ट्रांसफॉर्म प्रश्न को पूर्णांकों के अंतर से सापेक्ष अंतर में बदल देते हैं। परिणामस्वरूप, लंबी दाहिनी पूँछ सिकुड़ जाती है, और वितरण अक्सर मोटे तौर पर नार्मल हो जाता है। अब, विरंचन (variance) अधिक स्थिर है, और हम रैखिक रिग्रेशन लागू कर सकते हैं।
लॉगरिद्म बाइनरी क्लासिफिकेशन में सबसे सामान्यत: प्रयुक्त लॉस फ़ंक्शनों में से एक में केंद्रीय भूमिका निभाता है, जिसे क्रॉस‑एंट्रॉपी लॉस या लॉग लॉस कहा जाता है, जो एकल नमूने के लिए इस प्रकार परिभाषित है:
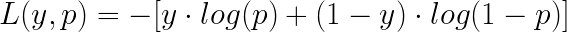
यहाँ, बाइनरी चर y (0 या 1) किसी नमूने का वास्तविक मान है, और p वह अनुमानित प्रायिकता है कि y वर्ग 1 है।
- यदि y 1 है, तो लॉस -log(p) है, जो p के 0 के क़रीब होने पर आपको अधिक दंडित करता है।
- यदि y 0 है, तो लॉस -log(1-p) है, जो p के 1 के क़रीब होने पर आपको अधिक दंडित करता है।
लॉग लॉस आत्मविश्वासी लेकिन ग़लत भविष्यवाणियों को कड़ी सज़ा देता है। जब वास्तविक लेबल 1 हो तब 0 के क़रीब प्रायिकता (या इसके उलट) की भविष्यवाणी एक बड़ा दंड देती है, जबकि अनिश्चित भविष्यवाणियाँ छोटे दंड देती हैं। यह लॉग लॉस को जैसे लॉजिस्टिक रिग्रेशन जैसे प्रायिकतामूलक क्लासिफ़ायरों के प्रशिक्षण के लिए उपयुक्त बनाता है।
नॉन‑लीनियर एक्टिवेशन फ़ंक्शन
एक्टिवेशन फ़ंक्शन न्यूरल नेटवर्क्स में उपयोग किए जाते हैं ताकि प्रत्येक लेयर का आउटपुट नॉन‑लीनियर हो। सामान्य एक्टिवेशन फ़ंक्शनों में सिग्मॉइड और ReLU फ़ंक्शन शामिल हैं।
सिग्मॉइड फ़ंक्शन
सिग्मॉइड फ़ंक्शन एक स्मूथ, S‑आकार का फंक्शन है, जो निम्न सूत्र से परिभाषित होता है:
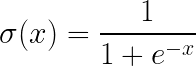
यह किसी भी वास्तविक संख्या को इनपुट के रूप में लेकर 0 और 1 के बीच का एक मान आउटपुट करता है। इसका उपयोग कच्चे स्कोर को प्रायिकताओं में बदलने के लिए किया जाता है।
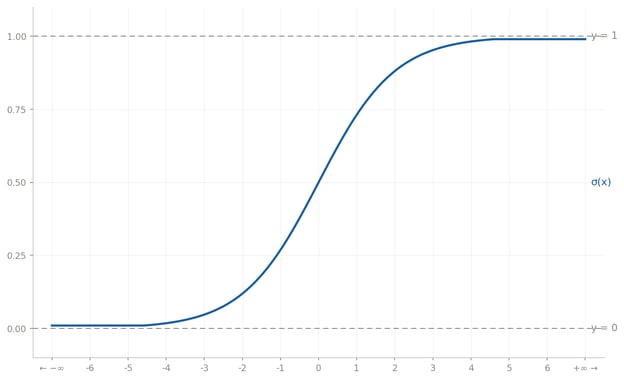
सिग्मॉइड फ़ंक्शन का एक सामान्य उपयोग‑मामला बाइनरी क्लासिफिकेशन के लिए लॉजिस्टिक रिग्रेशन में है। लॉजिस्टिक रिग्रेशन इनपुट्स के एक रैखिक संयोजन की गणना कर एक स्कोर बनाता है। फिर उस स्कोर को सिग्मॉइड फ़ंक्शन का उपयोग कर प्रायिकता में बदला जाता है। किसी सीमा (आमतौर पर 0.5) से ऊपर की प्रायिकताएँ 1 के रूप में वर्गीकृत होती हैं, और उससे नीचे 0 के रूप में।
इस विषय पर अधिक जानकारी के लिए, हमारे Python Logistic Regression और R में Logistic Regression ट्यूटोरियल देखें।
ReLU (रेक्टिफ़ाइड लीनियर यूनिट)
Rectified Linear Unit (ReLU) फ़ंक्शन ऋणात्मक संख्याओं को 0 में बदल देता है और धनात्मक संख्याओं को वैसा ही रहने देता है। इसे इस प्रकार परिभाषित किया जाता है:
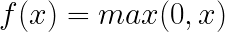
0 से ऊपर के मानों के लिए, यह पहचान फ़ंक्शन जैसा ही है, जैसा कि इसके ग्राफ से दिखता है:
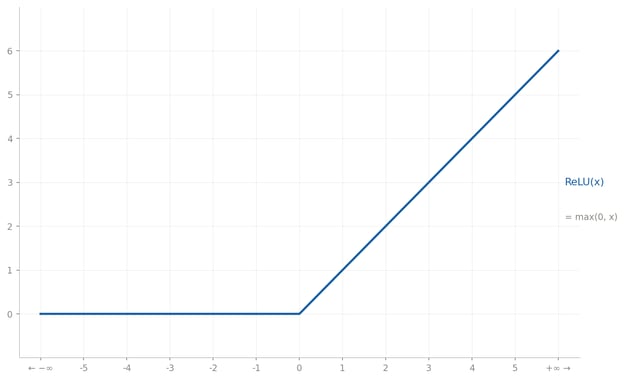
सिग्मॉइड फ़ंक्शन की तरह, यह एक न्यूरल नेटवर्क की हिडन लेयर्स में नॉन‑लीनियर एक्टिवेशन फ़ंक्शन का काम करता है। हालाँकि, यह संगणनात्मक रूप से सरल है, जिसमें केवल एक मैक्सिमम ऑपरेशन चाहिए, जबकि सिग्मॉइड में महँगे घातांकीय फ़ंक्शन कॉल की आवश्यकता होती है।
क्योंकि ReLU सभी ऋणात्मक मानों को 0 कर देता है, यह नेटवर्क में विरलता (sparsity) उत्पन्न करता है, जहाँ कई न्यूरॉन्स शून्य हो जाते हैं। इससे शोर कम हो सकता है और अधिक कुशल प्रतिनिधित्व प्राप्त हो सकते हैं।
पीसवाइज़ फ़ंक्शनों के रूप में डिसीजन ट्री
नॉन‑लीनियर फ़ंक्शनों का एक और रूप डिसीजन ट्री में मिलता है, जो फीचर्स और थ्रेशहोल्ड्स पर स्प्लिट करके इनपुट स्पेस को पुनरावर्ती रूप से छोटे क्षेत्रों में विभाजित करते हैं, जब तक कि कोई स्टॉपिंग मापदंड पूरा न हो जाए।
प्रत्येक परिणामी पत्ती नोड को एक भविष्यवाणी मान सौंपा जाता है। इस प्रकार, एक डिसीजन ट्री को एक पीसवाइज़ फ़ंक्शन के रूप में देखा जा सकता है, जहाँ डोमेन का प्रत्येक क्षेत्र एक स्थिर भविष्यवाणी मान से मैप होता है। कई स्थानीय नियमों को जोड़कर, डिसीजन ट्री जटिल पैटर्न पकड़ सकते हैं।
उदाहरण के लिए, आप एक द्वि‑आयामी क्षेत्र को निम्नानुसार विभाजित देख सकते हैं:
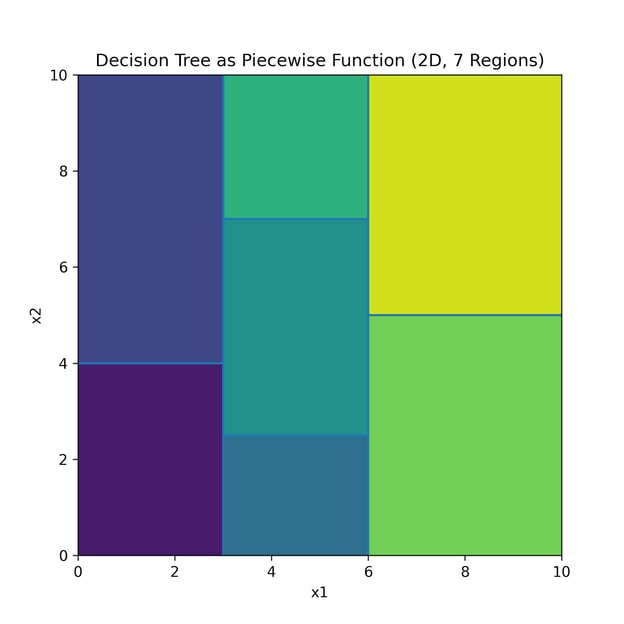
यह हीट मैप निम्न क्षेत्रों के अनुरूप है:
|
क्षेत्र |
डोमेन खंड |
फ़ंक्शन मान |
|
1 |
x1 < 3 और x2 < 4 |
1 |
|
2 |
x1 < 3 और x2 >= 4 |
2 |
|
3 |
3 ≤ x1 < 6 और x2 < 2.5 |
3 |
|
4 |
3 ≤ x1 < 6 और 2.5 ≤ x2 < 7 |
4 |
|
5 |
3 ≤ x1 < 6 और x2 ≥ 7 |
5 |
|
6 |
x1 ≥ 6 और x2 < 5 |
6 |
|
7 |
x1 ≥ 6 और x2 ≥ 5 |
7 |
फ़ंक्शन ऑप्टिमाइज़ेशन
फ़ंक्शन ऑप्टिमाइज़ेशन वह प्रक्रिया है जिसमें ऐसे इनपुट मान खोजे जाते हैं जो किसी फ़ंक्शन को अधिकतम या न्यूनतम करें। उदाहरण के लिए, आप किसी प्रॉफिट फ़ंक्शन को अधिकतम या एरर फ़ंक्शन को न्यूनतम करना चाह सकते हैं। फ़ंक्शन ऑप्टिमाइज़ेशन के अध्ययन को "ऑपरेशंस रिसर्च" कहा जाता है और यह गणितीय सिद्धांत का एक विशाल और सतत क्षेत्र है।
फ़ंक्शनों का ऑप्टिमाइज़ेशन किसी फ़ंक्शन के स्थानीय और वैश्विक "चरम" (अधिकतम या न्यूनतम बिंदु) से निकटता से जुड़ा है। "स्थानीय न्यूनतम" किसी विशेष दायरे के भीतर का न्यूनतम होता है, और "वैश्विक न्यूनतम" फ़ंक्शन का समग्र न्यूनतम होता है।
उदाहरण के लिए, फ़ंक्शन पर विचार करें f(x) = x4 - 3x2 + x.
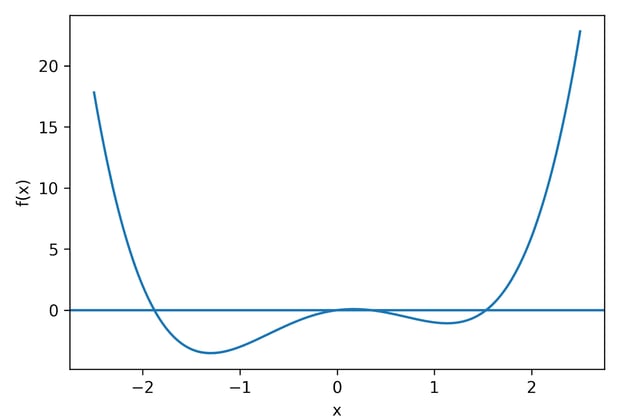
यहाँ दो स्थानीय न्यूनतम हैं: एक जब x लगभग -1.30 है और दूसरा जब x लगभग 1.13 है। जब x -1.30 है तब y मान कम होता है, इसलिए वही इस फ़ंक्शन का वैश्विक न्यूनतम है।
सरल ऑप्टिमाइज़ेशन कार्यों के लिए, जैसे एक‑चर प्राइसिंग मॉडल में लाभ को अधिकतम करने के लिए सर्वश्रेष्ठ मूल्य खोजना, फ़ंक्शन का अवकलज (डेरिवेटिव) लेना, उसे शून्य के बराबर रखना, और x के लिए हल करना पर्याप्त होता है। डीप न्यूरल नेटवर्क्स को प्रशिक्षित करने के लिए यह इतना सरल नहीं है, लेकिन सिद्धांततः यही तरीका काम करता है।
डीप लर्निंग के लिए सबसे महत्वपूर्ण ऑप्टिमाइज़ेशन विधि है ग्रेडिएंट डिसेंट। ग्रेडिएंट ढाल का बहु‑आयामी सामान्यीकरण है, जो बताता है कि प्रत्येक पैरामीटर के सापेक्ष लॉस कैसे बदलता है।
यह बार‑बार किसी फ़ंक्शन के सबसे तीव्र ढलान की दिशा में आगे बढ़कर काम करता है। प्रत्येक चरण में, यह किस दिशा में जाना है इसके लिए ग्रेडिएंट का उपयोग करता है और कितना दूर जाना है इसके लिए स्टेप साइज का। समय के साथ, यह प्रक्रिया किसी स्थानीय न्यूनतम की ओर ले जाती है।
निष्कर्ष
गणित, प्रोग्रामिंग, और डेटा साइंस में फ़ंक्शन सर्वव्यापी हैं। मशीन लर्निंग में "लर्निंग" मूलतः सबसे अच्छा फ़ंक्शन (और उसके पैरामीटर) खोजना ही तो है, जो इनपुट्स को आउटपुट्स से मैप करे। अब जब आप फ़ंक्शनों के बारे में जानते हैं, तो Python या अपनी पसंदीदा प्रोग्रामिंग भाषा में इन्हें कोड करें!
यह देखने के लिए कि ये विचार वास्तविक मशीन लर्निंग वर्कफ़्लोज़ में कैसे फिट बैठते हैं, आप Understanding Machine Learning कोर्स जारी रख सकते हैं।
Mathematical Functions FAQs
गणित में फ़ंक्शन क्या है?
गणितीय फ़ंक्शन एक नियम है जो प्रत्येक इनपुट को ठीक एक आउटपुट से मैप करता है।
गणितीय फ़ंक्शन का केवल एक आउटपुट ही क्यों होता है?
अन्यथा, वह नियम परिभाषा के अनुसार फ़ंक्शन नहीं होगा, क्योंकि वह अस्पष्ट होगा।
क्या प्रोग्रामिंग फ़ंक्शन और गणितीय फ़ंक्शन एक जैसे होते हैं?
पूरी तरह नहीं। प्रोग्रामिंग फ़ंक्शनों में साइड इफेक्ट्स हो सकते हैं या वे कोई उपयोगी मान नहीं भी लौटा सकते, जो गणितीय फ़ंक्शनों में अनुमत नहीं है।
डेटा साइंस में फ़ंक्शन महत्त्वपूर्ण क्यों हैं?
क्योंकि मॉडल फ़ंक्शन होते हैं। मॉडल फीचर्स को प्रेडिक्शन, प्रायिकताओं, या स्कोर से मिलाते हैं।
किसी फ़ंक्शन के डोमेन और कोडोमेन क्या होते हैं?
डोमेन वैध इनपुट्स का समुच्चय है। कोडोमेन वैध आउटपुट्स का समुच्चय है।

मार्क पेडिगो, PhD, स्वास्थ्यसेवा डेटा विज्ञान, प्रोग्रामिंग और शिक्षा में विशेषज्ञता वाले एक प्रतिष्ठित डेटा वैज्ञानिक हैं। गणित में PhD, कंप्यूटर साइंस में B.S., और AI में प्रोफेशनल सर्टिफिकेट रखने वाले मार्क तकनीकी ज्ञान को व्यावहारिक समस्या-समाधान से प्रभावी रूप से जोड़ते हैं। उनके करियर में धोखाधड़ी का पता लगाने, शिशु मृत्यु दर की भविष्यवाणी, और वित्तीय पूर्वानुमान से जुड़ी भूमिकाएँ शामिल रही हैं, साथ ही NASA के लागत आकलन सॉफ़्टवेयर में उनके योगदान भी हैं। एक शिक्षक के रूप में, उन्होंने DataCamp और वॉशिंगटन यूनिवर्सिटी इन सेंट लुईस में पढ़ाया है और कनिष्ठ प्रोग्रामरों का मार्गदर्शन किया है। खाली समय में, मार्क अपनी पत्नी मैंडी और कुत्ते हार्ले के साथ मिनेसोटा की प्राकृतिक सुंदरता का आनंद लेते हैं और जैज़ पियानो बजाते हैं।
उदीयमान और जूनियर डेटा साइंटिस्ट अक्सर "फ़ंक्शन" शब्द देखते हैं, लेकिन हमेशा स्पष्ट नहीं होता कि इसका अर्थ वास्तव में क्या है।
इस लेख में, आप जानेंगे कि गणितीय फ़ंक्शन क्या होता है, कौन-से समुच्चय इसके इनपुट और आउटपुट मानों का वर्णन करते हैं, और सतत तथा असतत मानों में क्या अंतर होता है। आप यह भी देखेंगे कि तकनीक में फ़ंक्शनों का उपयोग कैसे होता है, डेटा साइंस में प्रचलित फ़ंक्शन कौन-से हैं, और उन्हें कैसे ऑप्टिमाइज़ किया जाता है। रास्ते में, आप फ़ंक्शनों को संशोधित और प्लॉट करने के लिए Python कोड भी देखेंगे।
यदि आप Python में अपने स्वयं के फ़ंक्शन लिखने और उपयोग करने का अभ्यास करना चाहते हैं, तो मैं हमारा Writing Functions in Python कोर्स लेने की सलाह देता/देती हूँ।
गणित में फ़ंक्शन क्या है?
गणित में, फ़ंक्शन हर इनपुट को एक अद्वितीय आउटपुट से जोड़ता है। प्रत्येक वैध इनपुट केवल और केवल एक आउटपुट देता है। किसी इनपुट के एक से अधिक आउटपुट नहीं हो सकते।
उदाहरण के लिए, 32 डिग्री फ़ारेनहाइट 0 सेल्सियस होता है। फ़ारेनहाइट का मान सेल्सियस के एक मान से मेल खाता है; और वह भी केवल एक मान से। आप एक वैध इनपुट (फ़ारेनहाइट) के लिए दो अलग-अलग आउटपुट (सेल्सियस) नहीं रख सकते।
अन्य उदाहरणों में पेरोल शामिल है, जहाँ आपको प्रति घंटा एक राशि का भुगतान किया जाता है। यदि आप $20 प्रति घंटा कमाते हैं और 40 घंटे काम करते हैं, तो आप 20 x 40 = $800 कमाते हैं।
सभी नियम फ़ंक्शन नहीं होते। कुछ मामलों में, एक इनपुट के लिए कई आउटपुट होना तार्किक रूप से समझ में आता है। उदाहरण के लिए, किसी नाम को किसी व्यक्ति से मिलाना फ़ंक्शन नहीं है। "John Smith" नाम कई लोगों से मेल खा सकता है, जो सभी यह नाम साझा करते हैं।
गणित में, नियम अक्सर इस तरह बनाए जाते हैं कि प्रत्येक वैध इनपुट के लिए केवल एक आउटपुट हो। कई मामलों में, दुनिया वास्तव में इसी तरह काम करती है (पेरोल)। अन्य मामलों में, समस्याएँ फ़ंक्शनों के रूप में इसीलिए गढ़ी जाती हैं क्योंकि इससे समस्या सुलझने योग्य बनती है। उलझे हुए इनपुट‑आउटपुट जाल का पीछा करने के बजाय, मॉडल इस तरह सेट किया जाता है कि किसी इनपुट के कई आउटपुट न हों।
आप किसी फ़ंक्शन को एक "मशीन" की तरह समझ सकते हैं जो एक इनपुट (अक्सर x) लेती है, उसे किसी तरह प्रोसेस करती है, और एक आउटपुट (अक्सर y) देती है।
यहाँ, एक मशीन बाएँ तरफ़ अपनी कन्वेयर बेल्ट से इनपुट लेती है, उसे प्रोसेस करती है, और दाईं ओर एक हरे टिक मार्क के रूप में आउटपुट पैदा करती है।
मल्टीवेरिएट फ़ंक्शन कई इनपुट्स के एक समूह को स्वीकार करते हैं लेकिन केवल एक आउटपुट देते हैं। आप इसे ऐसे समझ सकते हैं जैसे कई चरों या फीचर्स वाली एक डेटा पंक्ति को पास करना जो एकल आउटपुट से मैप होती है।
फ़ंक्शन संकेतांकन और पारिभाषिकी
समीकरण कैसे लिखते हैं? तापमान रूपांतरण उदाहरण में, हम सूत्र को y = f(x) = (5/9) (x - 32) के रूप में लिख सकते हैं, जहाँ x फ़ारेनहाइट में तापमान है और y सेल्सियस में। इस संकेतांकन को समझने के लिए, इसे बाएँ से दाएँ पढ़ें।
बाएँ ओर y है, जो आउटपुट है। f(x) संकेत करता है कि आप f नामक फ़ंक्शन का उपयोग कर रहे हैं, जो एक इनपुट x लेता है। ध्यान दें कि इस संदर्भ में f(x) का अर्थ किसी मान f का किसी अन्य मान x से गुणन नहीं है।
दाएँ ओर सूत्र है। यह कहता है कि इनपुट x लें, उसमें से 32 घटाएँ, और परिणाम को 5/9 से गुणा करें।
डोमेन, कोडोमेन, और रेंज
मान लीजिए आप रोज़ एक बार बाहरी तापमान दर्ज करते हैं और आपने k माप एकत्र किए हैं, जिन्हें (x1, x2, …, xk) से सूचित किया गया है। आप एक ऐसा फ़ंक्शन चाहते हैं जो n दिन बीतने के बाद वर्ष‑तिथि औसत तापमान लौटाए। एक ऐसा फ़ंक्शन परिभाषित करें जो एक धनात्मक पूर्णांक n (जो k से कम या बराबर हो) लेता है और पहले n तापमानों का औसत लौटाता है, जो एक वास्तविक संख्या है। ऐसे फ़ंक्शन के लिए संकेतांकन है f: {1, 2, …, k} → ℝ.
फ़ंक्शन में शामिल समुच्चयों का वर्णन करने के लिए कुछ जार्गन होना सहायक होता है, जो हमें डोमेन, कोडोमेन और रेंज तक ले जाता है।
अब, रेंज पर नज़र डालते हैं। एक साधारण द्विघात फ़ंक्शन पर विचार करें: y = f(x) = x2. डोमेन और कोडोमेन निर्दिष्ट करने के लिए, लिखें f: ℝ → ℝ.
अब आप जानते हैं कि यह संकेत करता है कि डोमेन (इनपुट का समुच्चय) और कोडोमेन (आउटपुट का समुच्चय) दोनों वास्तविक संख्याओं से बने हैं। हालाँकि, थोड़ा सोचने पर, आप महसूस करेंगे कि आउटपुट का समुच्चय सभी वास्तविक संख्याएँ नहीं हो सकता।
क्योंकि किसी भी संख्या का वर्ग गैर‑ऋणात्मक होता है, तो वास्तव में प्राप्त होने वाले आउटपुट सभी वास्तविक संख्याएँ नहीं, बल्कि केवल गैर‑ऋणात्मक वास्तविक संख्याएँ हैं। इस स्थिति का वर्णन करने के लिए प्रयुक्त शब्द है रेंज। हम कहते हैं कि इस फ़ंक्शन की रेंज सभी गैर‑ऋणात्मक वास्तविक संख्याएँ हैं।
कोडोमेन संभावित आउटपुट का समुच्चय है; रेंज वास्तव में प्राप्त आउटपुट का समुच्चय है। आप कोडोमेन को अपने इच्छित आउटपुट के प्रकार के अनुरूप चुनते हैं, और रेंज का पता लगाते हैं, जो वास्तव में प्राप्त आउटपुट मानों का समुच्चय है।
सतत और असतत चर
यह हमें सतत और असतत चरों के अंतर तक लाता है:
उदाहरण के लिए, [0, 1] में एक सतत चर 0, 0.5, 0.4141, या इस दायरे में कोई भी वास्तविक मान ले सकता है। सतत चर उन मॉडलों में सामान्य हैं जहाँ आउटपुट सैद्धांतिक रूप से कोई भी मान हो सकता है, जैसे रिग्रेशन में।
हालाँकि, बाइनरी क्लासिफिकेशन में, आपको केवल दो मानों की चिंता होती है: 0 और 1। उदाहरण के लिए, किसी तस्वीर में या तो बिल्ली है या नहीं है। एक मल्टी‑क्लास क्लासिफिकेशन समस्या में भी, आपके पास सीमित संख्या के मान होते हैं, जैसे 0 कुत्ते के लिए, 1 बिल्ली के लिए, 2 घोड़े के लिए।
आप जिस समस्या को हल करना चाहते हैं, वही तय करती है कि आपको किस तरह के फ़ंक्शन में दिलचस्पी है। क्लासिफिकेशन समस्याएँ असतत मान देती हैं; रिग्रेशन समस्याएँ सतत फ़ंक्शन देती हैं।
वेक्टर संकेतांकन
कभी‑कभी आपको किसी फ़ंक्शन में कई चरों को पास करना पड़ता है। उदाहरण के लिए, आप किसी मशीन लर्निंग फ़ंक्शन में फीचर्स की एक पंक्ति पास कर सकते हैं। इस स्थिति में, आप फीचर्स को एक कंटेनर में समूहित कर सकते हैं और उसे पास कर सकते हैं। डेटा को इस तरह एक कंटेनर में समूहित करने का एक तरीका है वेक्टर। मॉडल एक इनपुट वेक्टर x = [x1, x2, x3] लेता है और एक लक्ष्य y आउटपुट करता है।
Python में, आप आमतौर पर एक NumPy array का उपयोग वेक्टर को निरूपित करने के लिए करते हैं।
यह कोड 3, 4 और 7.1 संख्याओं से बने एक वेक्टर को लेता है और एक औसत लौटाता है।
वेक्टरों के एक समूह के लिए, एक लोकप्रिय तरीका है pandas लाइब्रेरी की DataFrame डेटा संरचना का उपयोग करना।
यह कोड पंक्ति‑औसतों वाला एक pandas Series लौटाता है, प्रति पंक्ति एक मान। इस मामले में:
प्रौद्योगिकी में फ़ंक्शन
प्रौद्योगिकी में फ़ंक्शन की अवधारणा सर्वव्यापी है। व्यावहारिक कारणों से, ध्यान रखें कि तकनीक में "फ़ंक्शन" हमेशा गणित जितना सख्ती से परिभाषित नहीं होता। उदाहरण के लिए, प्रोग्रामिंग फ़ंक्शन ऐसे साइड इफेक्ट्स कर सकते हैं जो आउटपुट के अलावा अन्य वेरिएबल्स के मान बदल दें, जबकि गणितीय फ़ंक्शनों में ऐसा नहीं होता।
स्प्रेडशीट्स
फ़ंक्शनों का स्प्रेडशीट्स में व्यापक उपयोग होता है, जैसे कि Excel फ़ॉर्मूला में। आप किसी संख्यात्मक कॉलम का जोड़, माध्य या माध्यिका निकालना चाह सकते हैं। स्प्रेडशीट्स के लिए, फ़ंक्शन पहले बताई गई गणितीय परिभाषा का ही अनुसरण करते हैं।
स्प्रेडशीट्स जिस एक चीज़ में उत्कृष्ट हैं (जानबूझकर किया गया मज़ाक) वह है शर्तीय फ़ंक्शन: ये आपको
IF()जैसे फ़ंक्शनों का उपयोग कर अधिक जटिल शर्तीय संरचनाएँ बनाने देते हैं।उदाहरण के लिए, आप एक वर्ष के दौरान अपने मॉर्गेज कंपनी को किए गए भुगतानों का कुल निकालना चाह सकते हैं। ऐसा करने के लिए, आप संभवतः अपनी स्प्रेडशीट के
SUM()फ़ंक्शन का उपयोग करेंगे।प्रोग्रामिंग भाषाएँ
प्रोग्रामिंग भाषाओं में फ़ंक्शन सर्वत्र पाए जाते हैं। प्रोग्रामिंग भाषा के आधार पर, "फ़ंक्शन" की परिभाषा गणितीय फ़ंक्शन की तुलना में ढीली हो सकती है। कुछ भाषाएँ एक फ़ंक्शन को कई मान लौटाने देती हैं, या कोई मान न लौटाने देती हैं।
उदाहरण के लिए, कोई फ़ंक्शन मान ले सकता है और एक कथन प्रिंट कर सकता है, लेकिन स्पष्ट रूप से कोई मान नहीं लौटाता। एक Python फ़ंक्शन कुछ इस तरह दिखता है:
यह कोड निम्न आउटपुट देता है: "My name is Mark and my favorite color is blue." फ़ंक्शन से कोई गणितीय मान स्पष्ट रूप से वापस नहीं किया जाता।
Python जैसी कई मुख्यधारा की भाषाओं में कोड में किसी फ़ंक्शन के भीतर अन्य साइड इफेक्ट्स भी हो सकते हैं, जैसे किसी ग्लोबल वेरिएबल का मान बदलना। यद्यपि साइड इफेक्ट्स संभव और अनुमत हैं, वे हतोत्साहित किए जाते हैं। साइड इफेक्ट्स प्रोग्रामों का परीक्षण, डिबग और समझना कठिन बनाते हैं।
इन्हीं कारणों से, कुछ "फ़ंक्शनल" भाषाएँ, जैसे Scala और Haskell, फ़ंक्शन के विचार के इर्द‑गिर्द अधिक सख्ती से आधारित हैं।
मशीन लर्निंग
मशीन लर्निंग के संदर्भ में, इनपुट्स फीचर्स होते हैं, फ़ंक्शन मॉडल होता है, और आउटपुट मॉडल की भविष्यवाणी। ऐसे मॉडल को अक्सर "ब्लैक बॉक्स" कहा जाता है क्योंकि यह आवश्यक नहीं कि स्पष्ट हो कि आउटपुट भविष्यवाणी देने के लिए इनपुट फीचर्स को कैसे प्रोसेस किया गया, इसीलिए हमारा पहले वाला ”मशीन” रूपक और भी उपयुक्त बैठता है:
इस चित्रण में, फीचर्स को मॉडल "मशीन" में फीड किया जाता है, जो उन्हें किसी तरह प्रोसेस कर एक भविष्यवाणी आउटपुट करता है। साधारण, नियतात्मक फ़ंक्शनों (जैसे तापमान रूपांतरण) की तुलना में, मशीन के अंदर क्या होता है, इसका वर्णन करना कठिन होता है।
ML में, डोमेन फीचर वेक्टर होते हैं; कोडोमेन संभावनाएँ, वर्ग, या वास्तविक‑मान वाली भविष्यवाणियाँ हो सकता है।
डीप लर्निंग क्षेत्र में, फ़ंक्शन सामान्यतः सीधे इनपुट के एक सेट पर लागू नहीं किए जाते, बल्कि मॉडल की शुद्धता का आकलन एक कॉस्ट फ़ंक्शन से किया जाता है। कॉस्ट फ़ंक्शन प्रशिक्षण सेट पर किसी मॉडल के गलत होने का एक माप है। यह भविष्यवाणियों की तुलना वास्तविक लेबल्स या मानों से करता है और त्रुटियों को एक एकल संख्या में समेकित करता है।
डेटा साइंस में सामान्य फ़ंक्शन
कुछ फ़ंक्शन डेटा साइंस में लगभग हर जगह दिखते हैं। इनमें रैखिक (linear) फ़ंक्शन, लघुगणकीय (logarithmic) फ़ंक्शन और घातीय (exponential) फ़ंक्शन, साथ ही डीप लर्निंग के लिए नॉन‑लीनियर एक्टिवेशन फ़ंक्शन शामिल हैं।
रैखिक फ़ंक्शन
आइए क्लासिक उदाहरण, रैखिक फ़ंक्शनों से शुरू करें।
ढाल (Slope)
मान लीजिए आपको सेब खाने की इच्छा है। आप एक किराना दुकान पर जाते हैं जो सेब $0.75 प्रति पाउंड के निश्चित दाम पर बेचती है। तो एक पाउंड सेब की कीमत $0.75 है, 2 पाउंड की कीमत 2 x $0.75 = $1.50, और 3 पाउंड की कीमत 3 x $0.75 = $2.25। आप जितने पाउंड खरीदते हैं, प्रत्येक पाउंड कुल लागत में एक निश्चित राशि जोड़ता है।
फ़ंक्शन संकेतांकन में, आप सूत्र को f(x) = 0.75 x लिख सकते हैं। संख्या 0.75 इस रैखिक फ़ंक्शन की ढाल है। ढाल इनपुट में प्रति इकाई परिवर्तन के सापेक्ष आउटपुट के परिवर्तन की दर है।
ऐसे फ़ंक्शन का ग्राफ बनाने के लिए, आप निम्न जैसा कोड उपयोग कर सकते हैं:
ऐसे फ़ंक्शनों को रैखिक फ़ंक्शन कहा जाता है। इनपुट x में प्रत्येक वृद्धि आउटपुट y में एक ही निश्चित राशि का योगदान देती है। जैसा कि नाम से स्पष्ट है, ग्राफ करने पर रैखिक फ़ंक्शन एक सीधी रेखा देता है।
इंटरसेप्ट
अब, मान लीजिए आपको अपनी ग्रॉसरी डिलीवर करवाना पसंद है। किराना दुकान $2.00 का फिक्स्ड डिलीवरी शुल्क लेती है। इस स्थिति में, सेब के लिए आपका फ़ंक्शन होगा f(x) = 0.75 x + 2। पहले की तरह, 0.75 ढाल है। संख्या 2, जहाँ ग्राफ y‑अक्ष को काटता है, "y‑इंटरसेप्ट" कहलाती है। यह वह आउटपुट मान है जब इनपुट 0 होता है।
कुल लागत सेबों के जोड़ और डिलीवरी शुल्क का योग है। सामान्यतः, एक एकचर (univariate) रैखिक फ़ंक्शन को f(x) = mx + b के रूप में लिखा जा सकता है, जहाँ m को ढाल और b को y‑इंटरसेप्ट कहते हैं।
मल्टीवेरिएट रैखिक फ़ंक्शन
संभवतः आप केवल सेब ही नहीं, और भी चीज़ें खाना चाहेंगे। मान लीजिए आप ब्रेड और पीनट बटर भी खरीदना चाहते हैं। सेब $0.75 प्रति पाउंड हैं, एक ब्रेड की लोफ $2.50 है, और पीनट बटर का एक जार $3.00 है। अब, आपका ग्रॉसरी बिल फ़ंक्शन है:
यह फ़ंक्शन अभी भी रैखिक माना जाता है क्योंकि यह प्रत्येक चर में रैखिक है। सामान्यतः, एक रैखिक फ़ंक्शन का रूप होता है:
यह आपके प्रत्येक परिमाण को उनके वेट्स (ढाल के लिए इस संदर्भ में प्रयुक्त एक और शब्द) से गुणा कर जोड़ने, और फिर इंटरसेप्ट जोड़ने के बराबर है।
वेक्टर संकेतांकन में, यह फ़ंक्शन इस प्रकार लिखा जाता है:
यहाँ T "ट्रांसपोज़्ड" के लिए है, जो w और x के लिए वेक्टर गुणा करने हेतु आवश्यक है।
रैखिक रिग्रेशन
ईंधन क्षमता बनाम गति पर विचार करें। आपको संदेह है कि जैसे‑जैसे कोई तेज़ ड्राइव करता है, ईंधन क्षमता घटती है। आप 45 से 65 मील प्रति घंटा की गति के बीच पचास डेटा बिंदु एकत्र करते हैं और निम्न पैटर्न देखते हैं:
हर डेटा बिंदु को जोड़ना एक टेढ़ा‑मेढ़ा, पढ़ने में कठिन, अनुपयोगी मॉडल देगा। लेकिन इस दायरे में डेटा का सामान्य रुझान लगभग रैखिक है। यदि हम गति को x कहते हैं, तो इस ग्राफ के लिए फ़ंक्शन है:
ऐसी रेखा खोजने के लिए जो डेटा के लिए सर्वोत्तम फिट हो, आप सिंपल लीनियर रिग्रेशन नामक गणितीय प्रक्रिया का उपयोग करते हैं।
आप Python में Matplotlib और Seaborn का उपयोग कर ऐसी रेखा की गणना कर सकते हैं:
रैखिक रिग्रेशन कई चरों के साथ काम करता है। मान लीजिए आप गति (x), वाहन का वज़न (y), और इंजन का आकार (z) के लिए एक रैखिक रिग्रेशन मॉडल परिभाषित करना चाहते हैं। मल्टीवेरिएट लीनियर रिग्रेशन के लिए परिणामी सूत्र है:
इस मामले में, प्रत्येक चर के गुणांक उस फीचर के वेट या महत्त्व का प्रतिनिधित्व करते हैं, जबकि अन्य चरों को स्थिर माना जाता है।
इनवर्स फ़ंक्शन
अब, सेब खरीदने के प्रश्न को "उलटते" हैं: यदि आपने सेब पर $2.25 खर्च किए, तो आपने कितने पाउंड खरीदे? उत्तर है 2.25 / 0.75 = 3, तो आपने तीन पाउंड खरीदे। फ़ंक्शन की इस तरह की "उलट" को फ़ंक्शन का इनवर्स कहा जाता है। इंटरसेप्ट के बिना वाले उदाहरण में, इनवर्स है:
ध्यान दें कि इस संकेतांकन में "-1" का अर्थ है कि आप किसी फ़ंक्शन का इनवर्स ले रहे हैं, न कि व्युत्क्रम (reciprocal)।
एक बात जिस पर ध्यान देना चाहिए वह है कि डोमेन बदल सकता है। उदाहरण के लिए, मान लीजिए आपका मूल फ़ंक्शन है:
यह फ़ंक्शन सभी वास्तविक संख्याओं के लिए परिभाषित है, सिवाय 2 के, क्योंकि हर का हर (denominator) शून्य नहीं हो सकता। इस फ़ंक्शन का इनवर्स है
उसी कारण से, इनवर्स फ़ंक्शन सभी इनपुट्स के लिए परिभाषित है, 0 को छोड़कर।
एक और सावधानी यह है कि प्राप्त इनवर्स कई बार फ़ंक्शन नहीं होता क्योंकि एक इनपुट के कई आउटपुट हो सकते हैं। फ़ंक्शन y = x2 पर विचार करें। इसका उलटा इसलिए होगा:
जैसा कि प्लस/माइनस से स्पष्ट है, इनवर्स में एक इनपुट के लिए दो आउटपुट हैं, इसलिए यह फ़ंक्शन नहीं है जब तक कि हम डोमेन को सीमित न करें (उदाहरण के लिए, x ≥ 0)
ग्राफ़िक रूप से, कोई फ़ंक्शन और उसका इनवर्स (यदि अस्तित्व में हो) रेखा y=x के आरपार एक‑दूसरे के दर्पण प्रतिबिंब होते हैं। फ़ंक्शन y = x3 पर विचार करें। इस फ़ंक्शन और उसके इनवर्स का ग्राफ है: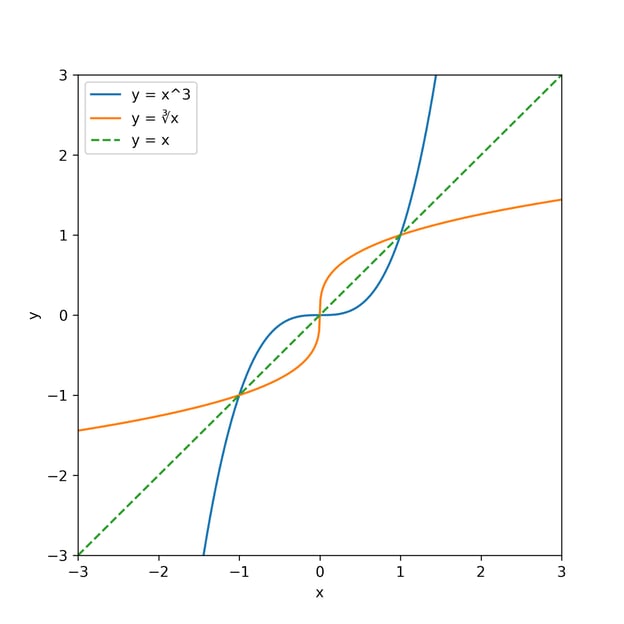
मूल फ़ंक्शन (नीले रंग में) का एक इनवर्स (नारंगी रंग में) है जो रेखा y = x के आरपार परावर्तित है।