
Kurs
Vibe Coding mit Replit
2 Std.
13.6K
Ich habe in den letzten sechs Monaten Vollzeit im Vibe-Coding-Modus gearbeitet und mehrere SaaS-Produkte Ende-zu-Ende gebaut und ausgeliefert. Dazu gehören eine Online-Bibliothek, Budget-Tracking-Tools und eine Zahlungsplattform mit Fokus auf USD-Zahlungen und Freelancer-Auszahlungen. Unterwegs habe ich außerdem Stablecoin-Wallets und weitere SaaS-Ideen von Grund auf erkundet.
Nach dem parallelen Aufbau mehrerer Produkte wurde eine Lektion sehr deutlich. Selbst mit besseren KI-Tools, MCPs, Agents und KI-gestützten Workflows ist die wichtigste Entscheidung nicht Perfektion. Es geht darum, einen Tech-Stack zu wählen, der zu deinen Produktzielen, deinem Entwicklungstempo und deinem Erfahrungsniveau passt.
Das bedeutet nicht, die fortschrittlichsten Tools zu wählen. Es bedeutet, Tools zu kombinieren, die reibungslos zusammenspielen, Reibung reduzieren und dir erlauben, innerhalb von Stunden ein funktionierendes MVP zu shippen.
In diesem Blog zerlege ich die Kernbausteine eines modernen SaaS-Stacks, stelle drei praxisnahe Stack-Muster vor und zeige, wie du in wenigen Stunden mit dem Bau deines eigenen SaaS startest.
Wenn Leute von einem „Tech-Stack“ sprechen, meinen sie eigentlich all die beweglichen Teile, die gemeinsam aus einer Idee ein nutzbares SaaS-Produkt machen. Beim Vibe Coding geht es nicht um Overengineering, sondern um Tools, die Reibung entfernen und schnelles Shipping ermöglichen – bei Produktionsreife.
Hier ist eine einfache Ansicht, wie die Kernbausteine eines modernen SaaS ineinandergreifen:
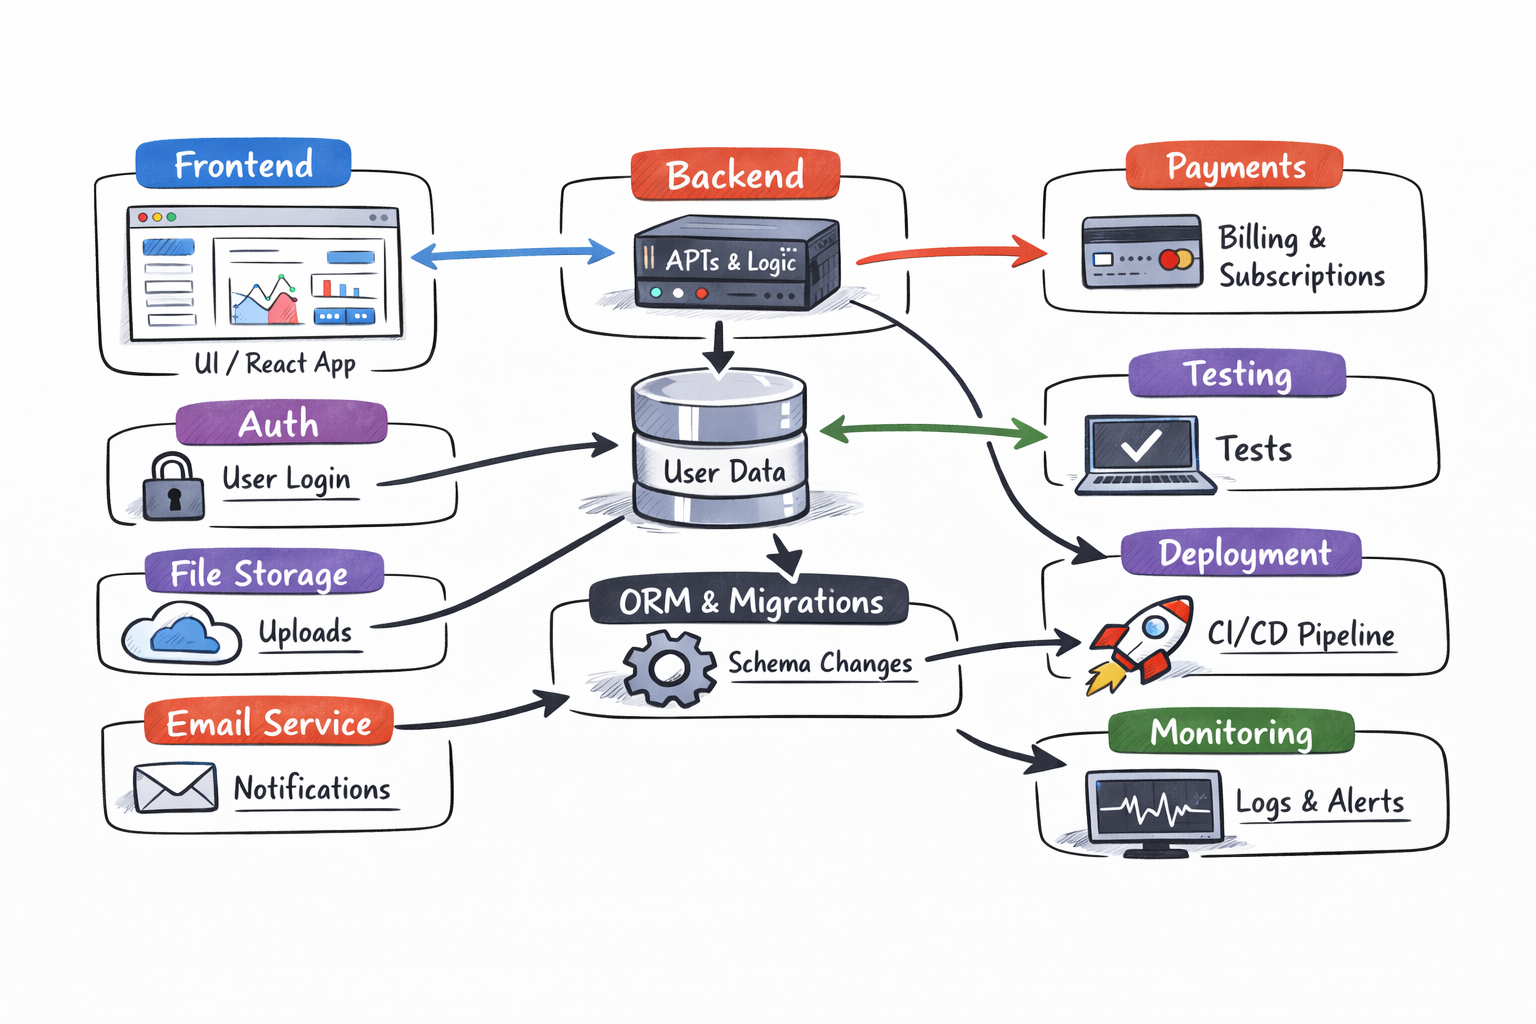
Bild generiert mit ChatGPT
Das Frontend ist alles, was Nutzer sehen und bedienen: Seiten, Formulare, Dashboards und Einstellungen.
In modernen SaaS-Projekten ist das meist eine React-basierte App, die schnell rendert, aufgeräumt aussieht und sich leicht iterieren lässt. Designsysteme und Komponentenbibliotheken helfen dir, zügig voranzukommen, ohne jeden Button neu zu entwerfen.
Ein gutes Frontend-Setup fokussiert sich auf Responsiveness, Barrierefreiheit und Entwicklergeschwindigkeit.
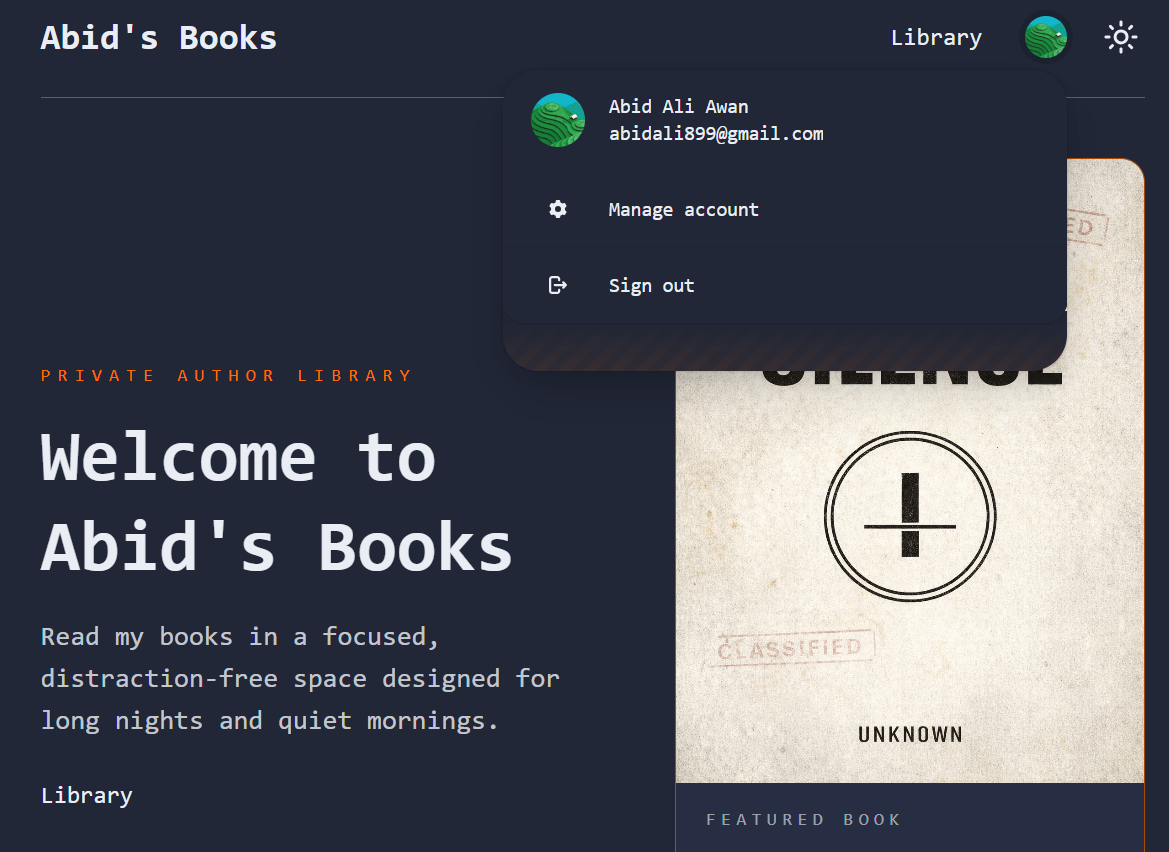
Quelle: Abid's Books
Das Backend ist das Gehirn der App. Es kümmert sich um Geschäftslogik, Berechtigungen, Formularübermittlungen und Datenverarbeitung. In einem Vibe-Coding-Setup lebt das Backend oft direkt neben dem Frontend, sodass du für den Start keinen separaten Server brauchst. Das macht Features wie Nutzeraktionen, Hintergrundjobs und Integrationen deutlich einfacher auszuliefern und zu warten.
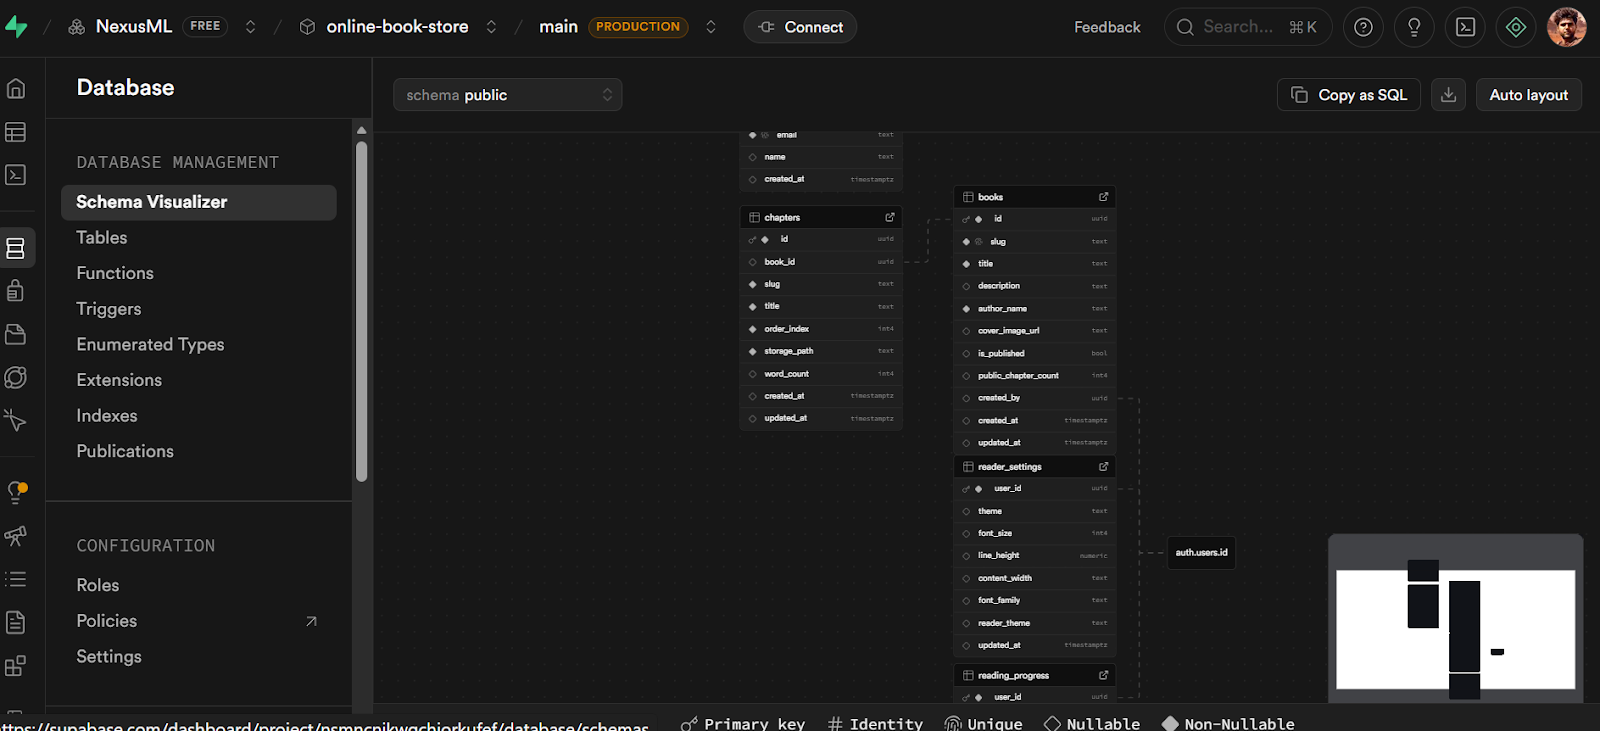
Die Datenbank speichert alles, was bestehen bleiben muss: Nutzer, Abos, Einstellungen und Anwendungsdaten. Die meisten SaaS-Produkte setzen auf eine relationale Datenbank, weil sie zuverlässig, flexibel und gut verstanden ist.
Eine gemanagte Datenbank nimmt dir Backups, Skalierung und Wartung ab, damit du dich aufs Produkt konzentrieren kannst – nicht auf den Betrieb.
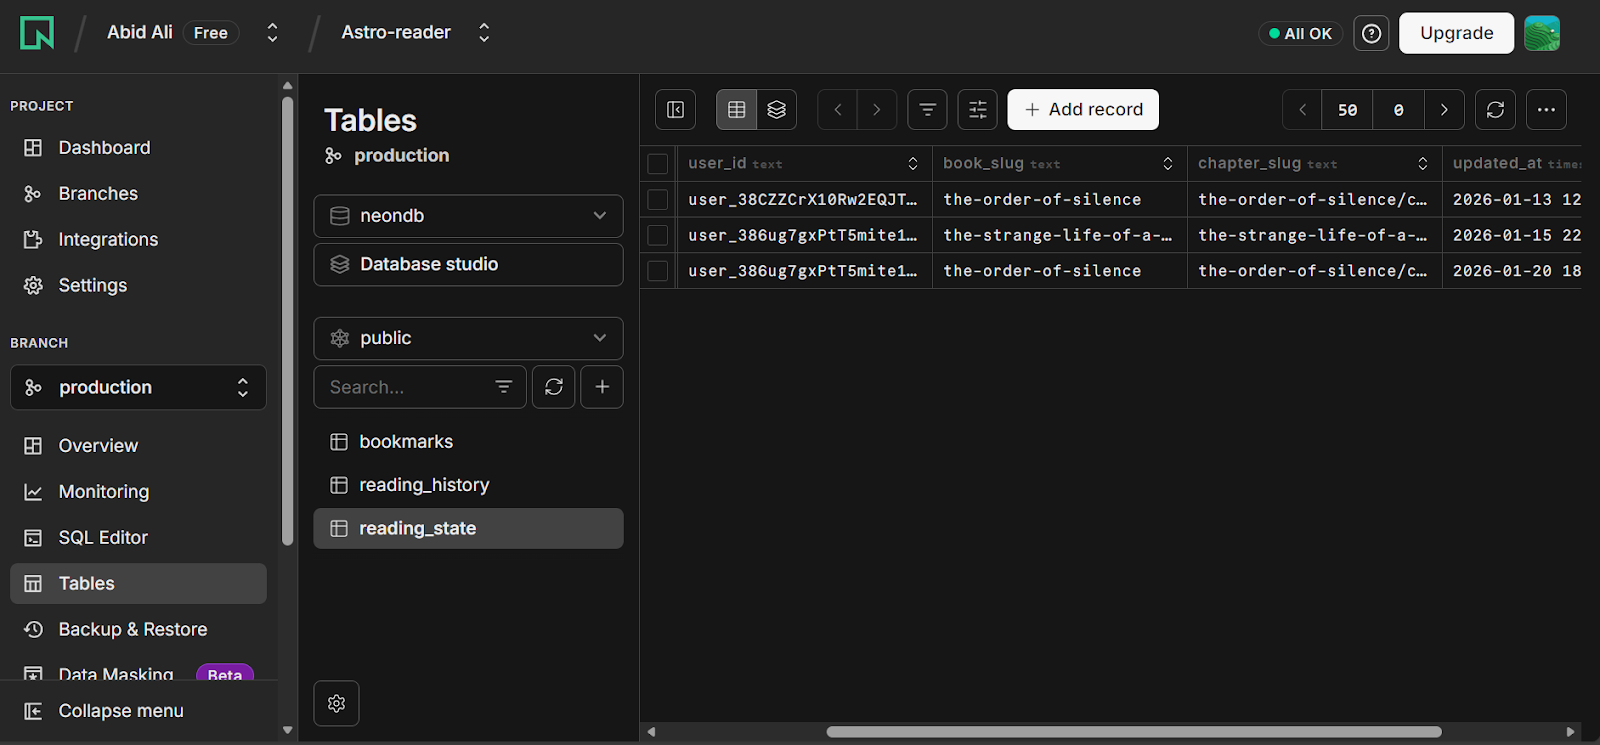
Ein ORM sitzt zwischen deinem Code und der Datenbank und bietet Typsicherheit sowie ein klares Schema.
Migrationen erlauben es dir, die Datenbankstruktur über die Zeit weiterzuentwickeln, ohne die Produktion zu brechen. Das ist für SaaS entscheidend, denn Datensicherheit zählt, sobald echte Nutzer an Bord sind.
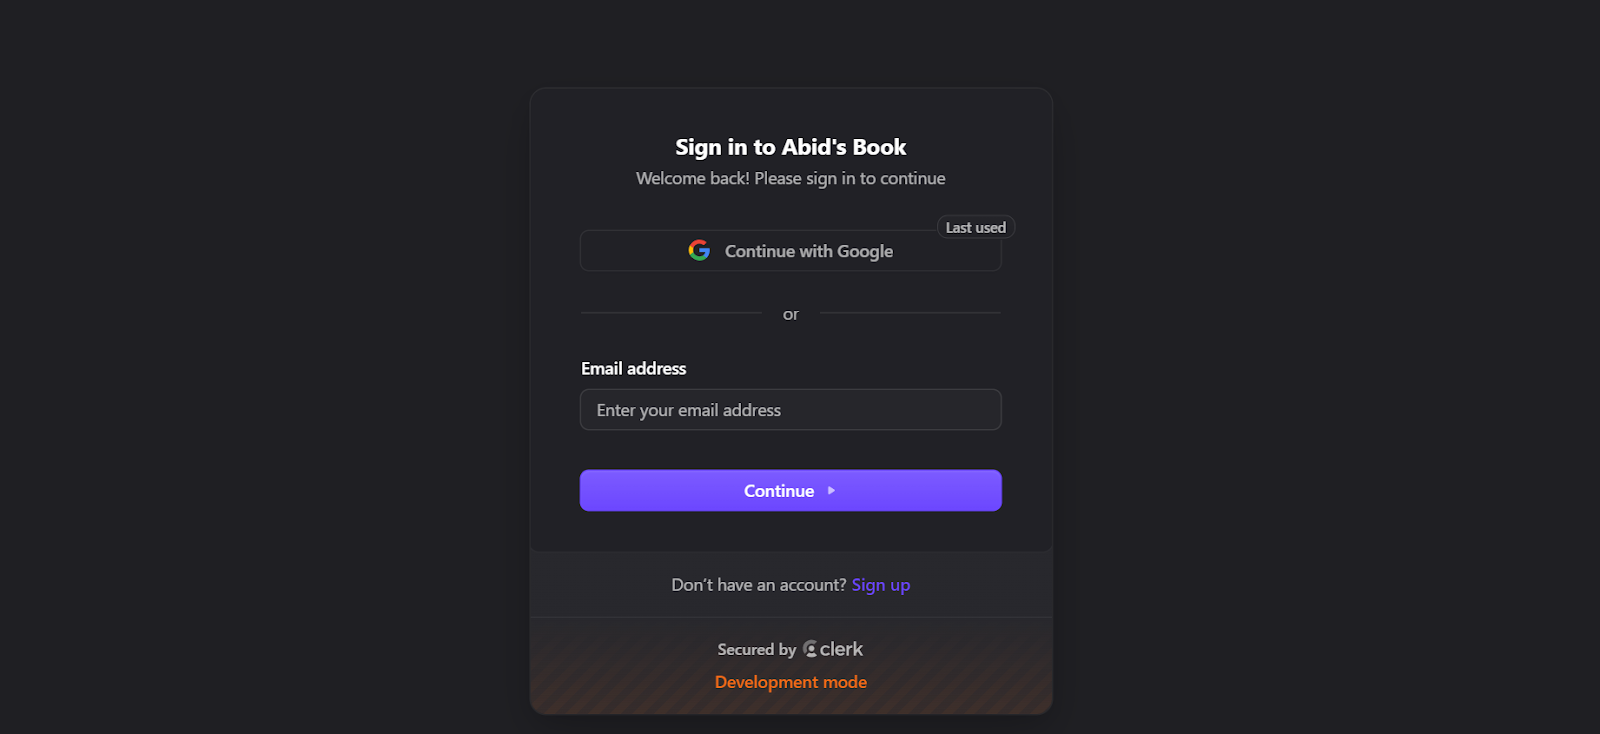
Authentifizierung deckt Sign-ups, Logins, Passwort-Resets und Berechtigungen ab. Das an einen spezialisierten Dienst auszulagern, spart enorm viel Zeit und verhindert Sicherheitsfehler. Für SaaS erleichtert es außerdem spätere Features wie Social Login, Teams und rollenbasierte Zugriffe.
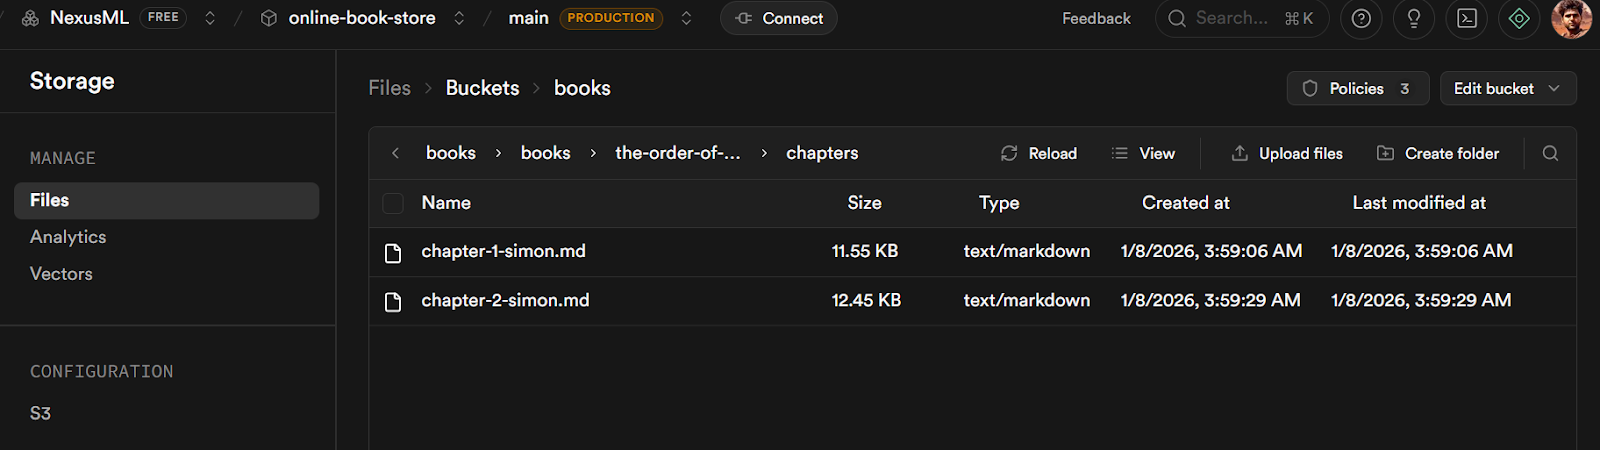
Die meisten SaaS-Produkte müssen früher oder später Dateien speichern: Profilbilder, Dokumente, Exporte oder KI-generierte Assets. Blob-Speicher ist dafür optimiert und getrennt von der Datenbank. Er ist günstiger, schneller und skaliert unabhängig.
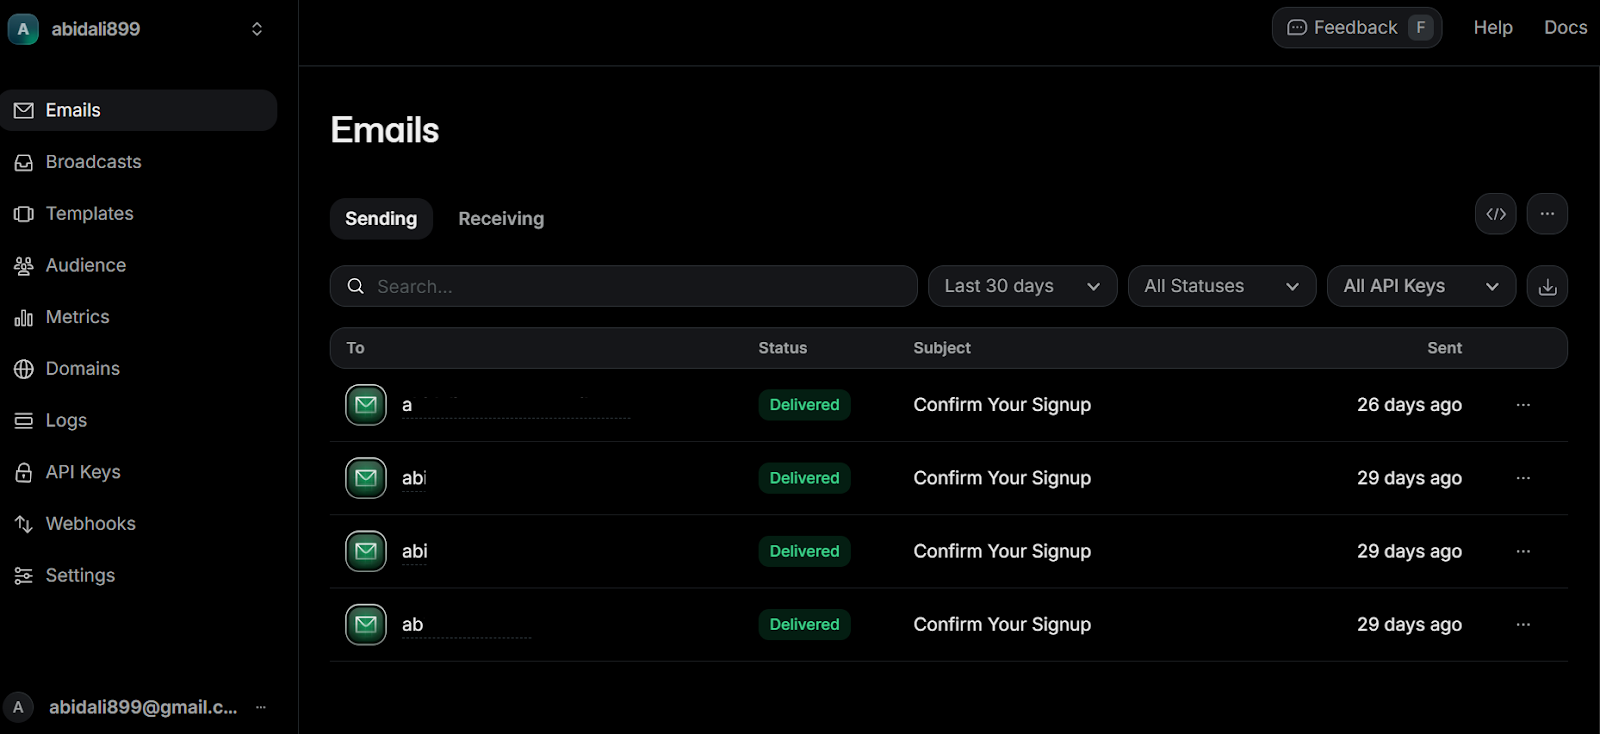
E-Mail ist essenziell für Onboarding, Verifizierung, Passwort-Resets und Benachrichtigungen. Ein spezialisierter E-Mail-Dienst sorgt für zuverlässige Zustellung und trennt dieses Thema von deiner Kernlogik.
Wenn dein SaaS kostenpflichtig ist, brauchst du Billing, Abos, Rechnungen und Webhooks. Ein Zahlungsanbieter abstrahiert Steuerregeln, Compliance und Edge Cases, sodass du dich auf Preisgestaltung und Mehrwert konzentrierst – nicht auf Finanzinfrastruktur.
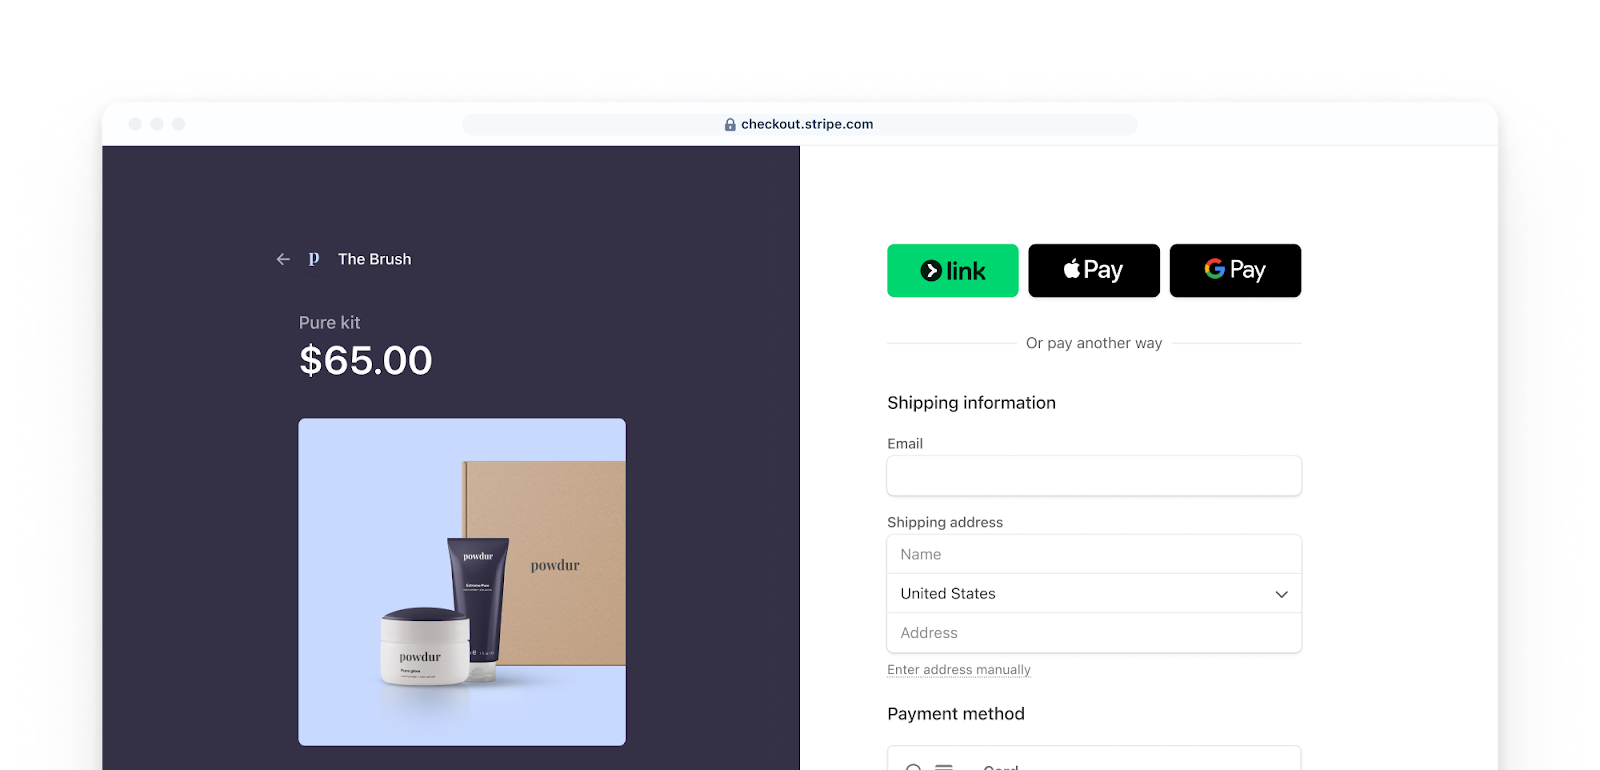
Quelle: Payments | Stripe Documentation
Tests stellen sicher, dass du schnell shippen kannst, ohne Dinge zu zerbrechen. Unit-Tests prüfen Logik, End-to-End-Tests simulieren echtes Nutzerverhalten. Im Vibe Coding geht es um genug Tests, um zügig und sicher zu liefern.
Deployment macht aus deinem Code ein Live-Produkt. Ein moderner SaaS-Stack nutzt automatisierte Builds, Previews und Continuous Integration, damit jede Änderung sicher getestet und ausgeliefert werden kann. Dieser kurze Feedback-Loop ist der Schlüssel zu schneller Iteration.
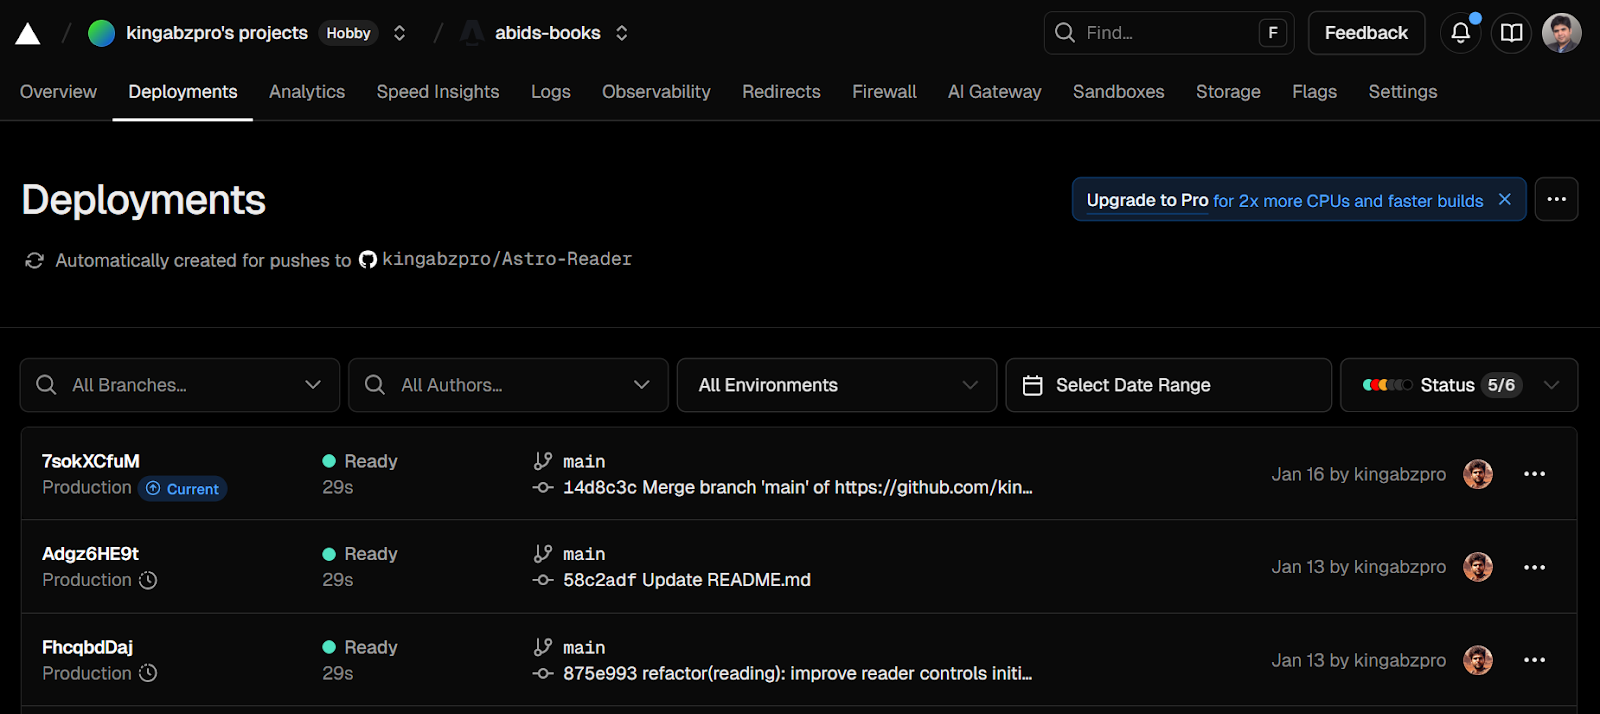
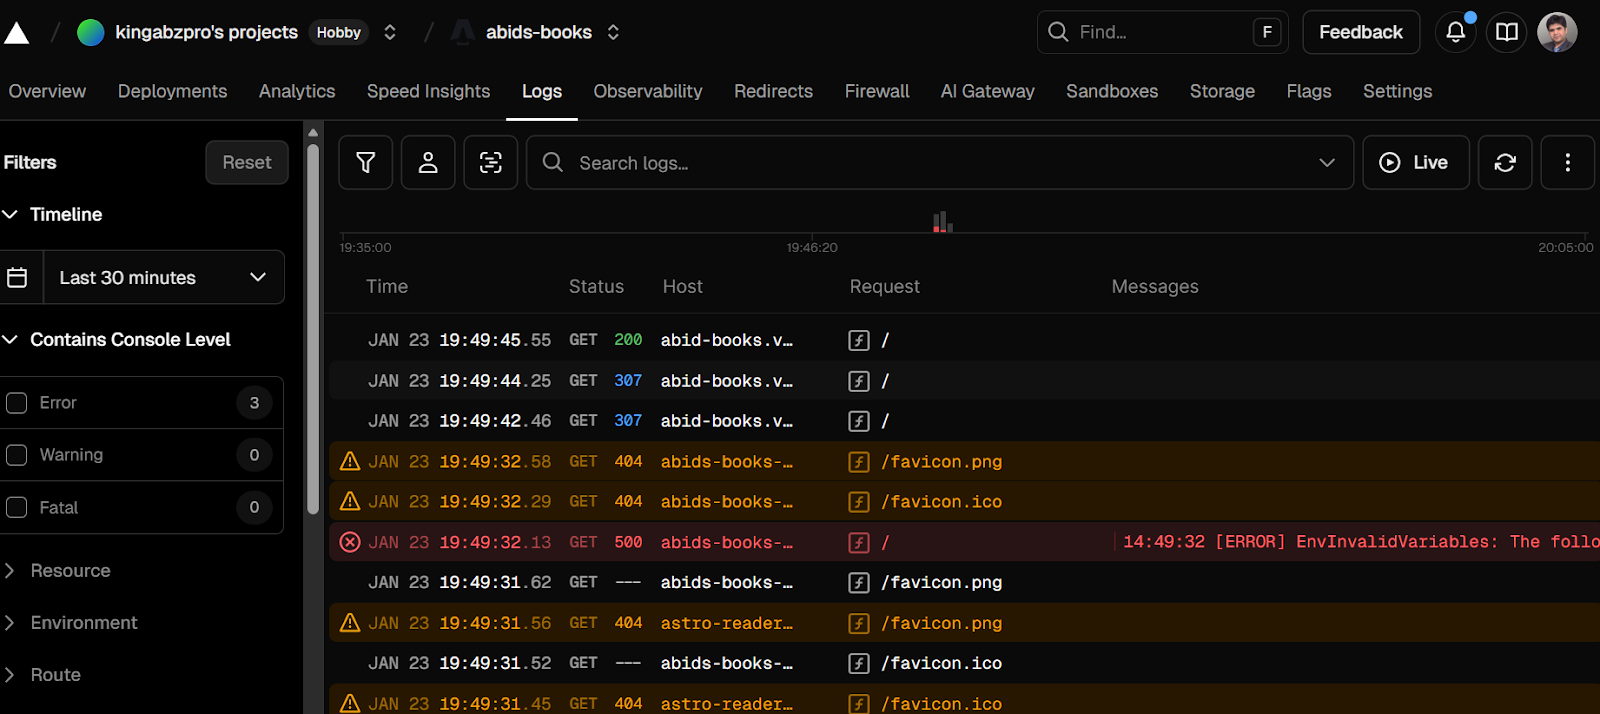
Sobald Nutzer live sind, brauchst du Sichtbarkeit. Logs und grundlegendes Monitoring helfen, Fehler früh zu erkennen, Verhalten zu verstehen und Probleme schnell zu debuggen – ohne am ersten Tag ein komplexes Observability-System aufzusetzen.
Ein guter SaaS-Stack geht nicht um „schicke“ Tools. Es geht um klare Trennung der Zuständigkeiten: UI, Logik, Daten, Auth, Storage, Payments und Deployment – jeweils mit einem klaren Job. Vibe Coding heißt, Defaults zu wählen, die Reibung reduzieren, damit du mehr Zeit in Features und weniger in Infrastrukturverkabelung steckst.
In der Praxis fallen die meisten modernen SaaS-Produkte in eines von drei Stack-Mustern. Jedes verfolgt ein anderes Ziel und bringt andere Trade-offs mit. Klare Namen machen es leichter, zu entscheiden, welchen Stack du wann einsetzen oder wechseln solltest.
Die drei Vibe-Coding-Stacks sind:
Die meisten Vibe Coder starten mit dem Sprint Stack, wechseln beim Stabilisieren zum Leverage Stack und greifen erst bei Skalierung, Kosten oder Compliance zum Control Stack, wenn volle Ownership nötig wird.
Dieser Stack ist auf Geschwindigkeit statt Zeremonie ausgelegt. Er hält alles simpel, modern und produktionsreif, ohne dich zu früh in Infrastrukturentscheidungen zu ziehen.
Next.js übernimmt Frontend und Backend, sodass du mit Server Actions und API Routes schnell vorankommst.
Neon liefert eine skalierbare Postgres-Datenbank ohne Betriebsaufwand, während Drizzle Schemas und Migrationen leichtgewichtig und typsicher hält.
Clerk kümmert sich End-to-End um Authentifizierung – inklusive Sign-ups, Logins, Passwort-Resets und transaktionalen E-Mails – sodass du keinen separaten E-Mail-Dienst brauchst.
Stripe kommt erst dazu, wenn du Zahlungen brauchst. Tests bleiben bewusst minimal, damit du schnell shippen kannst, und Vercel übernimmt Deployment, Previews und Logs out of the box.
Am besten geeignet, wenn: du in Stunden von der Idee zum Live-Produkt kommen, schnell iterieren und Infrastruktur komplett meiden willst.
Dieser Stack ist für Builder, die maximale Hebelwirkung bei minimaler Betriebsarbeit wollen. Statt getrennte Systeme für Daten, Authentifizierung, Storage und Hintergrundjobs zu managen, lebt das meiste Backend im Rahmen einer zentralen gemanagten Plattform.
Next.js treibt Frontend und Backend-Logik und wird auf Vercel für schnelle Previews und einfaches Hosting deployt.
Supabase fungiert als Backend-Grundlage mit gemanagtem Postgres inklusive Dashboards und optionalen Backups, integrierter Authentifizierung, Datei- und Blob-Speicher, Realtime-Updates und geplanten Hintergrundjobs.
Resend übernimmt transaktionale E-Mails, Stripe verwaltet Billing und Abos, und PostHog sowie Sentry liefern Analysen und Fehlersichtbarkeit über Free-Tiers.
Tests bleiben leichtgewichtig mit Vitest und Playwright, während CI/CD über GitHub Actions läuft – inklusive synchron gehaltener Datenbankmigrationen.
Am besten geeignet, wenn: du ein zentrales Dashboard für die meisten Backend-Bedürfnisse möchtest, großzügige Free-Tiers nutzt und ohne frühen Infrastrukturaufwand skalieren willst.
Dieser Stack ist für Builder, die volle Kontrolle, null Vendor Lock-in und alles lokal lauffähig wollen. Jede Komponente ist Open Source und läuft über Docker Compose. So kann jede:r das Repository klonen und mit einem Befehl eine komplette SaaS-Umgebung starten.
Next.js betreibt Frontend und Backend lokal, während Postgres eine selbstgehostete relationale Datenbank liefert.
Das Schema-Management übernimmt Drizzle lokal. Authentifizierung läuft über Better Auth – Identität und Zugriff bleiben vollständig unter deiner Kontrolle.
MinIO ersetzt Cloud-Blob-Speicher durch einen S3-kompatiblen lokalen Dienst. Mailpit fängt ausgehende E-Mails in der Entwicklung ab, und Redis treibt Caching und Hintergrundjobs via BullMQ an.
Meilisearch übernimmt schnelle Volltextsuche, und optionale Observability-Tools wie Grafana, Prometheus und Loki liefern bei Bedarf tiefere Einblicke.
Das Deployment bleibt flexibel mit Coolify oder Dokku auf einem VPS, während GitHub Actions Docker-Images baut und per SSH deployt.
Am besten geeignet, wenn: du einen vollständig offline lauffähigen SaaS-Stack willst, den man mit docker compose up teilen kann, Vendor Lock-in vermeidest und dennoch produktionsfähig bleibst.
Der Start muss weder lang noch kompliziert sein. Ziel ist, Reibung zu entfernen, Momentum aufzubauen und so früh wie möglich etwas Echtes zu shippen. Die folgenden Schritte sind bewusst einfach und funktionieren mit jedem der drei Vibe-Coding-Stacks.
Entscheide dich zuerst für einen Stack. Denk nicht zu lange darüber nach. Du kannst später migrieren, aber Tool-Wechsel mitten im Build bremsen dein Momentum.
Vorab angelegte Accounts verhindern Kontextwechsel, sobald du mit dem Bauen loslegst.
Nachdem du deinen Stack gewählt hast, richte die Kernservices ein, auf die du ab Tag eins setzt. Typischerweise gehören dazu Authentifizierung, Datenbankzugriff, E-Mail-Zustellung, Zahlungen und Deployment. Wenn du diese Accounts früh erstellst, integrierst du sie während des Baus natürlich statt sie später anzuflanschen.
Je nach Stack brauchst du in der Regel Accounts und API-Keys für:
Sobald die Accounts stehen, generiere die nötigen API-Keys und Service-URLs und speichere sie als Umgebungsvariablen. Bewahre diese Werte lokal in einer .env-Datei auf und commite niemals Secrets ins Version Control. Committe nur sichere Konfiguration, etwa Beispiel-Env-Dateien oder Public Keys.
Dieses frühe Setup hält deinen Entwicklungsfluss glatt und verhindert Breaking Changes kurz vor dem Launch.
Starte nicht in ein leeres Repository. Nutze ein Starter-Template, das Framework, Grundlayout und essentielle Konfiguration bereits mitbringt.
Ein gutes Starter liefert dir:
Das spart Stunden an Setup und lässt dich auf Produktlogik statt Boilerplate fokussieren.
Claude Code funktioniert am besten, wenn du es als interaktiven Pair Programmer nutzt, nicht nur als Codegenerator. Die Claude-Code-Erweiterung in VS Code liefert schnelles Feedback, starken Kontext und eine viel dialogorientiertere Art zu bauen.
Beim Start eines neuen Projekts beginne immer im Plan-Modus und aktiviere Reasoning. So denkt Claude Architektur, Datenflüsse und Edge Cases durch, bevor Code entsteht. Das führt zu saubereren Strukturen und weniger Rewrites.
Verbinde außerdem früh die wesentlichen MCP-Server. Mindestens solltest du aktivieren:
So kann Claude mit echter Doku und realen Implementierungen argumentieren statt zu raten.
Bevor du Code schreibst, gib immer eine klare und detaillierte Einführung zu dem, was du baust. Sei explizit in Bezug auf:
Dieser Kontext verankert die KI von Anfang an und verhindert falsche Annahmen.
Beispiel-Starter-Prompt:
Baue ein minimales, produktionsreifes Kursverkaufs-SaaS mit Next.js + Supabase + Stripe + Vercel.
Muss Marketing-Seiten, Auth, Stripe-Abos (Checkout + Webhooks + Portal), Dashboard und geschützte Kursinhalte enthalten.
Halte es minimal, sicher (nur Server-Secrets, Webhook-Verifizierung) und deploybar.Deploye, sobald deine App lokal läuft.
Verbinde dein Repository mit deiner Deploy-Plattform (Vercel), aktiviere Preview-Deployments und pushe häufig. Eine Live-URL hilft, Umgebungsprobleme früh zu erkennen, erleichtert das Teilen von Fortschritt und das Einholen von Feedback.
Je früher deine App live ist, desto besser werden deine Entscheidungen.
Sobald echte Nutzer mit deinem Produkt interagieren, lass ihr Verhalten deinen Lernplan steuern.
Konzentriere dich auf:
Behebe zuerst das schmerzhafteste Problem und wiederhole. Kleine Iterationen summieren sich schneller als große Rewrites.
Sobald dein SaaS live ist und Nutzer damit arbeiten, ist Sichtbarkeit wichtiger als neue Features. In dieser Phase machst du das Produkt verlässlich, berechenbar und leichter weiterentwickelbar.
Starte mit Monitoring und Error Tracking, damit du Probleme erkennst, bevor Nutzer sie melden. Kombiniere das mit automatisierten Basistests, um Kernflüsse wie Signup, Login und Zahlungen bei Iterationen zu schützen.
Führe als Nächstes Automatisierungen für wiederkehrende oder zeitbasierte Aufgaben ein – etwa geplante Jobs, Hintergrundverarbeitung, Aufräumaufgaben oder E-Mail-Flows. Automatisierungen reduzieren manuellen Aufwand und halten das System konsistent, wenn die Nutzung wächst.
Zum Schluss fokussiere dich auf Nutzerverhalten. Verfolge, wie sich Nutzende durch das Produkt bewegen, wo sie zögern und welche Features sie tatsächlich verwenden. Diese Daten sind wertvoller als Meinungen oder Annahmen.
Wenn ich einen zentralen Rat geben müsste, dann: Starte mit einem soliden Skelett. Ich lasse meinen Coding-Agenten meist zuerst das Fundament der Anwendung bauen – mit klaren Platzhaltern für Features, die später kommen. So hat das Projekt von Tag eins Struktur, und spätere Änderungen sind deutlich schmerzfreier.
Hier glänzt der Plan-Modus in Claude Code besonders. Ich starte damit, Architektur, User Flows und Datenmodell durchdenken zu lassen, bevor eine Zeile Code entsteht. Wenn der Plan passt, geht es in die Umsetzung.
Von dort hilft mir Claude Code beim Bauen von Features, beim Schreiben und Ausführen von Tests und sogar beim Deployment per CLI. Es kann Doku referenzieren, typische Probleme erkennen und automatisch Fixes vorschlagen – das entfernt viel Reibung während der Entwicklung.
Sobald die Anwendung lokal läuft, folgt das Deployment. Ich versuche, so früh wie möglich auf Vercel zu deployen. Eine Live-URL verändert, wie du über das Produkt denkst: Sie schafft Momentum, macht Fortschritt greifbar und erlaubt es, die Arbeit schnell mit Freund:innen oder Early Usern zu teilen und Feedback einzuholen.
Wenn das Produkt wächst, wird Ordnung wichtig. Bevor ich ein neues Feature baue, erstelle ich ein GitHub-Issue und öffne dann einen neuen Branch dafür.
Ich arbeite das Feature isoliert aus und schließe mit einem Pull Request ab. Dieser einfache Workflow hilft, Fortschritt nachzuverfolgen, Änderungen zu kapseln und das Projekt langfristig handhabbar zu halten – auch solo.
Wenn du tiefer in einige der in diesem Guide genannten Tools einsteigen willst, empfehle ich diese Ressourcen:
Das Wichtigste ist: Fang einfach an zu shippen. Wähle einen Stack, öffne deinen Editor und lass dich von den Vibes zur ersten Live-URL führen.
Top DataCamp Courses
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Nisha Arya Ahmed
15 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Sejal Jaiswal
24 Min.


