
Cours
Coder en mode Vibe avec Replit
2 h
13.6K
Je fais du vibe coding à plein temps depuis six mois, en créant et en livrant de bout en bout plusieurs produits SaaS. Cela inclut une application de bibliothèque de livres avec accès en ligne, des outils de suivi budgétaire et une plateforme de paiement axée sur les paiements en USD et le versement aux freelances. Au passage, j’ai aussi exploré des portefeuilles en stablecoins et d’autres idées SaaS en partant de zéro.
Après avoir mené plusieurs produits en parallèle, une leçon s’est imposée. Même avec de meilleurs outils d’IA, des MCP, des agents et des workflows assistés par IA, la décision la plus importante n’est pas de viser la perfection. C’est de choisir un stack technique adapté à vos objectifs produit, à votre vitesse de développement et à votre niveau d’expérience.
Cela ne veut pas dire sélectionner les outils les plus avancés. Il s’agit de choisir des outils qui s’imbriquent bien, réduisent les frictions et vous permettent de livrer un MVP fonctionnel en quelques heures.
Dans cet article, je passe en revue les composants clés d’un stack SaaS moderne, je présente trois schémas de stack concrets, et je vous montre comment démarrer la création de votre propre SaaS en quelques heures.
Quand on parle de « stack tech », on désigne en réalité toutes les pièces qui coopèrent pour transformer une idée en produit SaaS utilisable. En vibe coding, l’objectif n’est pas de sur‑ingénierie, mais de choisir des outils qui lèvent les frictions et vous laissent livrer vite tout en restant prêts pour la production.
Voici une vue simple de l’assemblage des pièces maîtresses d’un SaaS moderne :
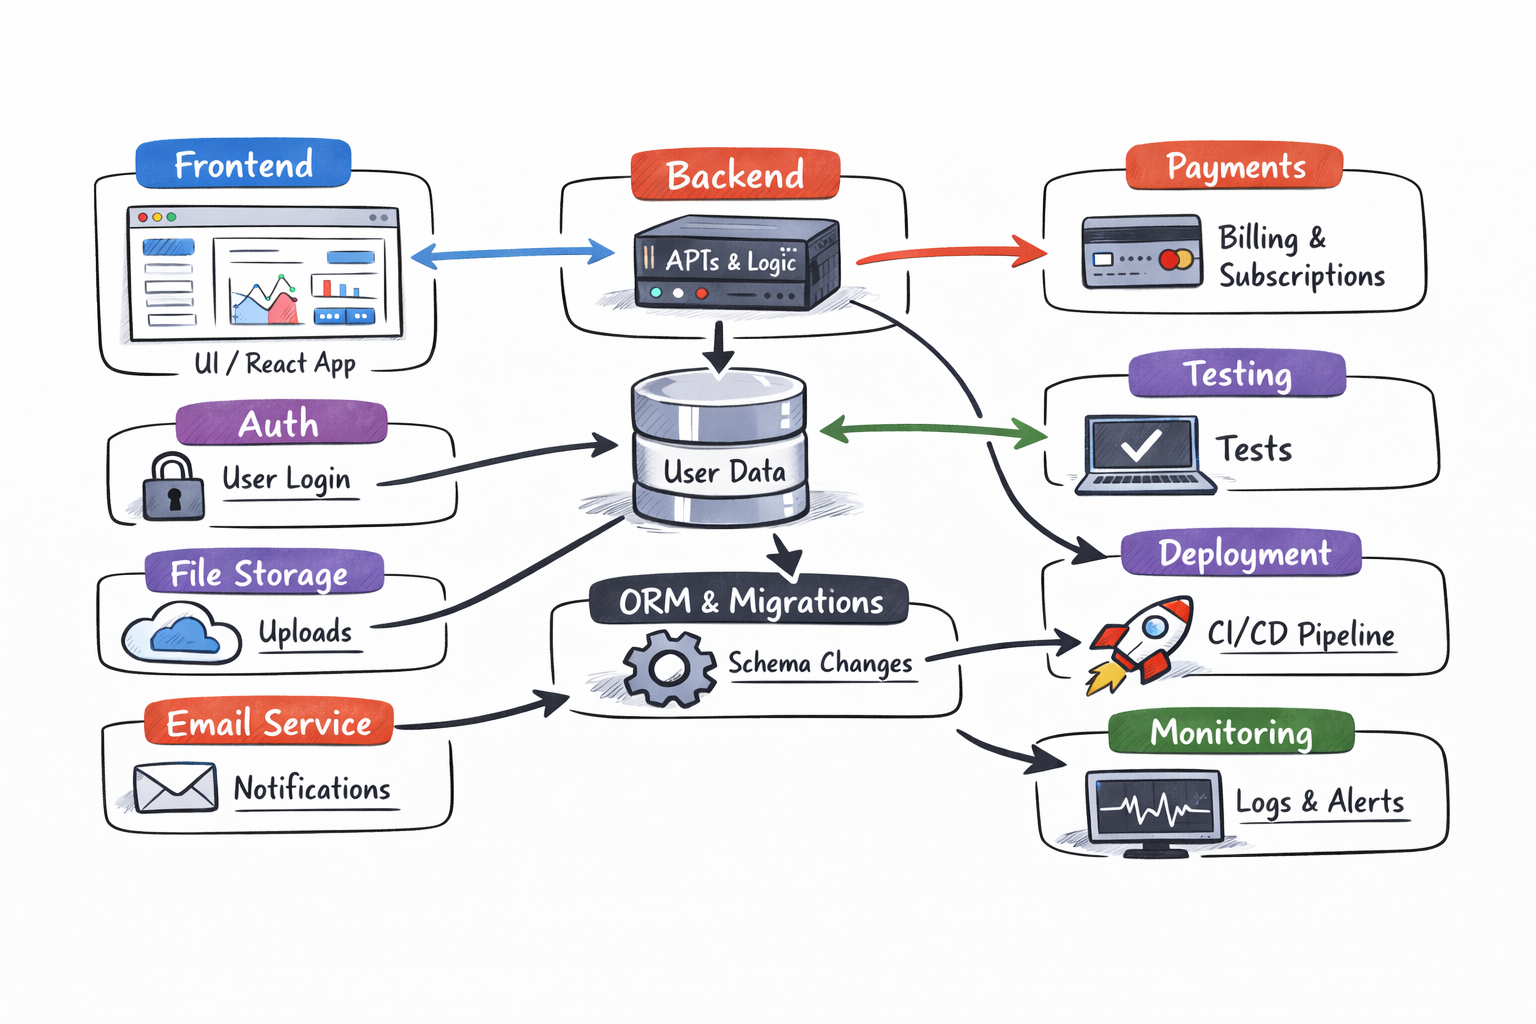
Image générée avec ChatGPT
Le frontend, c’est tout ce que l’utilisateur voit et manipule : pages, formulaires, tableaux de bord, paramètres.
Dans un SaaS moderne, il s’agit souvent d’une app basée sur React, rapide, soignée et facile à faire évoluer. Les systèmes de styles et les bibliothèques de composants permettent d’avancer vite sans réinventer chaque bouton.
Un bon setup frontend privilégie la réactivité, l’accessibilité et la vitesse de développement.
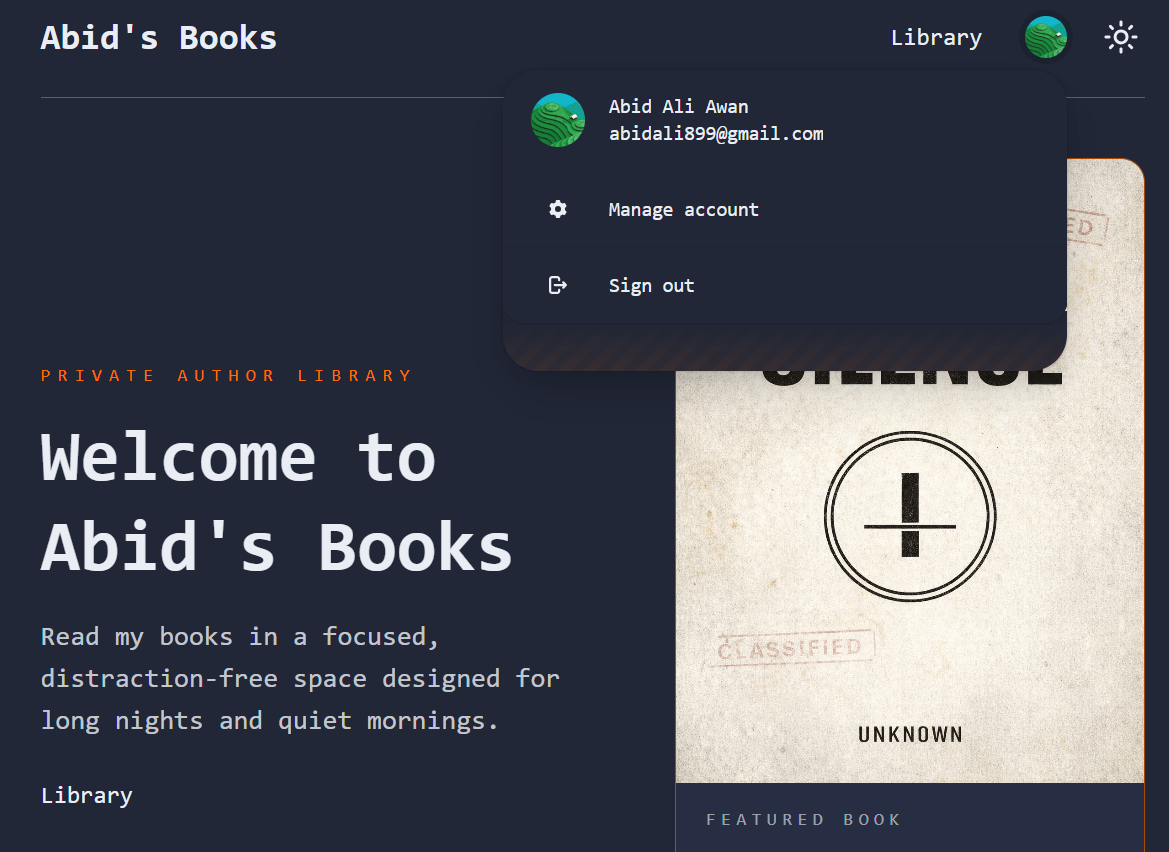
Source : Abid's Books
Le backend est le cerveau de l’app. Il gère la logique métier, les permissions, les soumissions de formulaires et le traitement des données. En vibe coding, le backend vit souvent aux côtés du frontend, ce qui évite d’avoir un serveur distinct au départ. Résultat : des actions utilisateur, des tâches en arrière‑plan et des intégrations bien plus simples à livrer et maintenir.
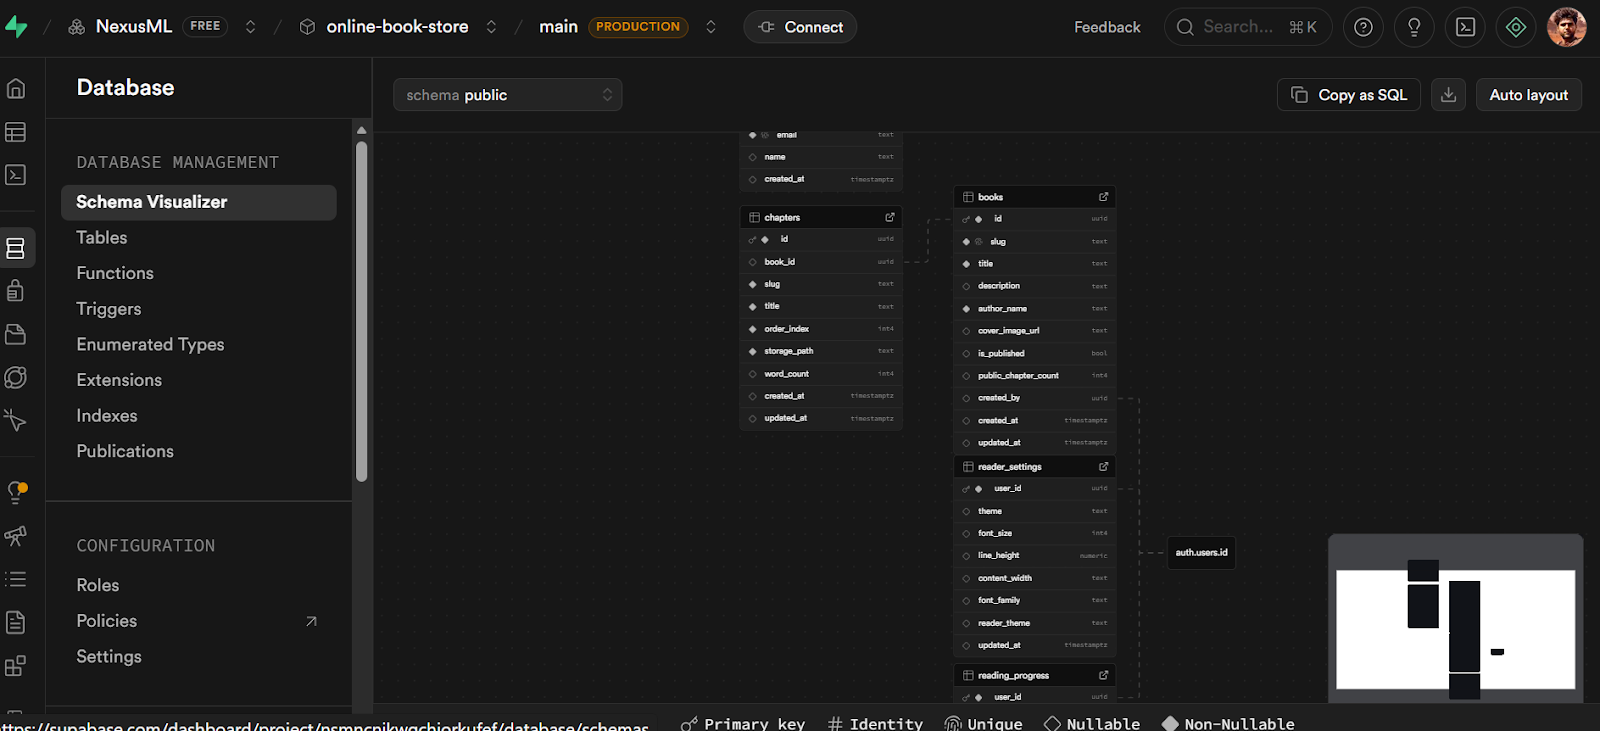
La base de données stocke tout ce qui doit persister : utilisateurs, abonnements, paramètres et données métier. La plupart des SaaS s’appuient sur une base relationnelle car elle est fiable, flexible et bien maîtrisée.
Une base managée vous décharge des sauvegardes, de la montée en charge et de la maintenance, pour vous concentrer sur le produit plutôt que sur l’exploitation.
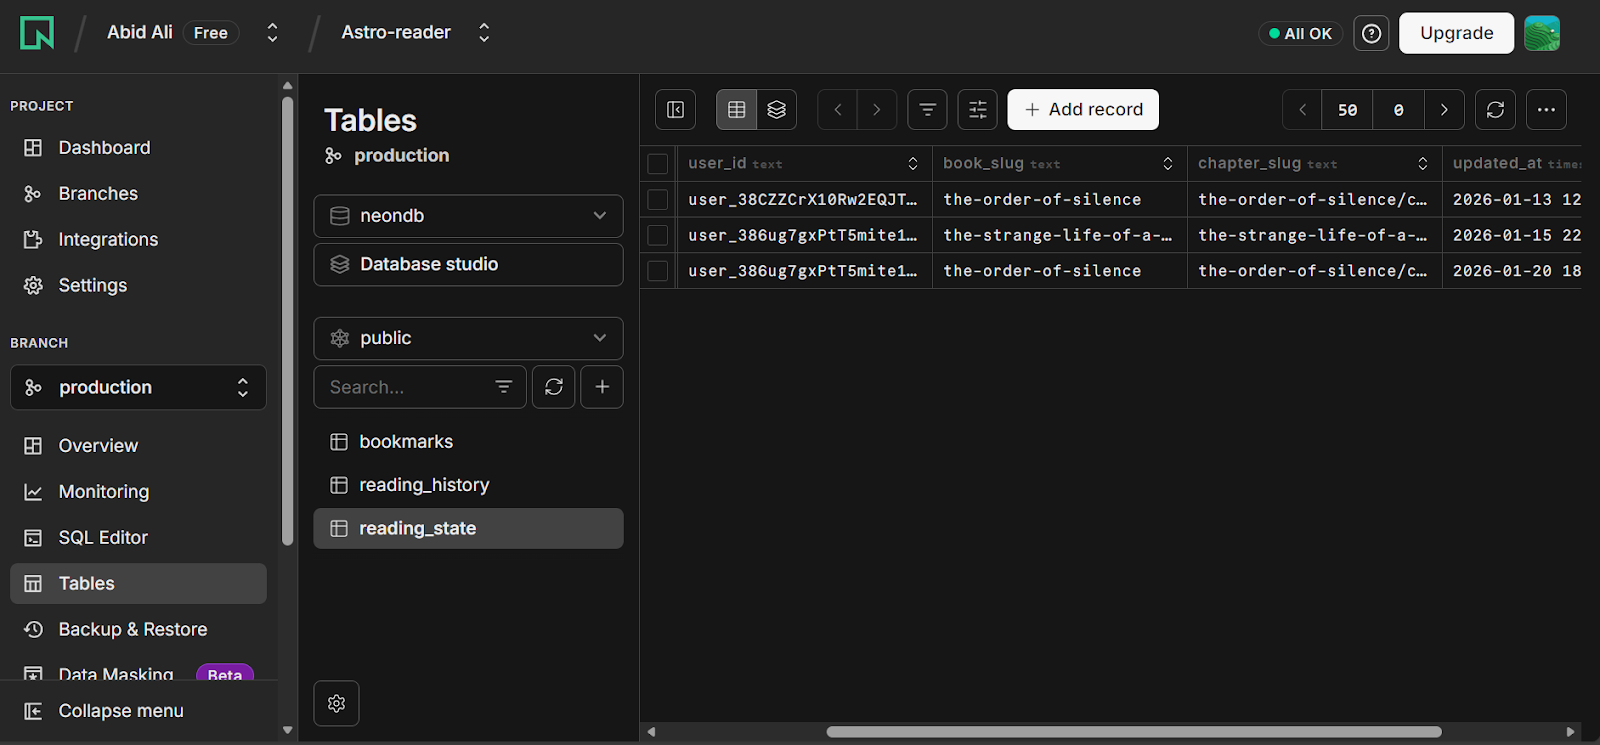
Un ORM s’intercale entre votre code et la base, vous offrant sécurité de typage et schéma clair.
Les migrations permettent de faire évoluer la structure de la base dans le temps sans casser la prod. C’est crucial pour un SaaS, où l’intégrité des données compte dès les premiers utilisateurs.
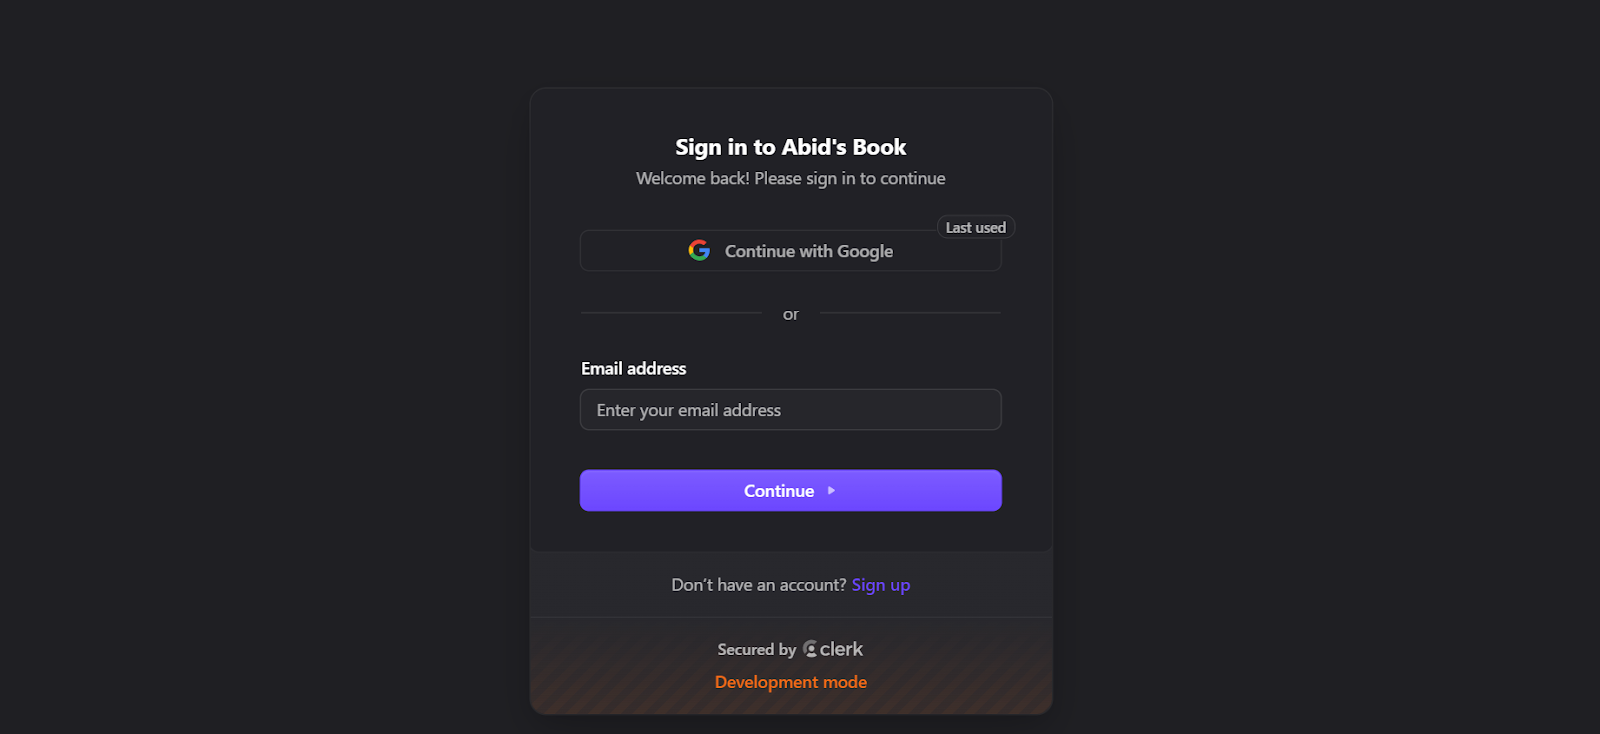
L’authentification couvre inscriptions, connexions, réinitialisations de mot de passe et permissions. Déléguer cela à un service dédié fait gagner un temps énorme et évite des erreurs de sécurité. Pour un SaaS, cela facilite aussi l’ajout ultérieur du login social, des équipes et des rôles.
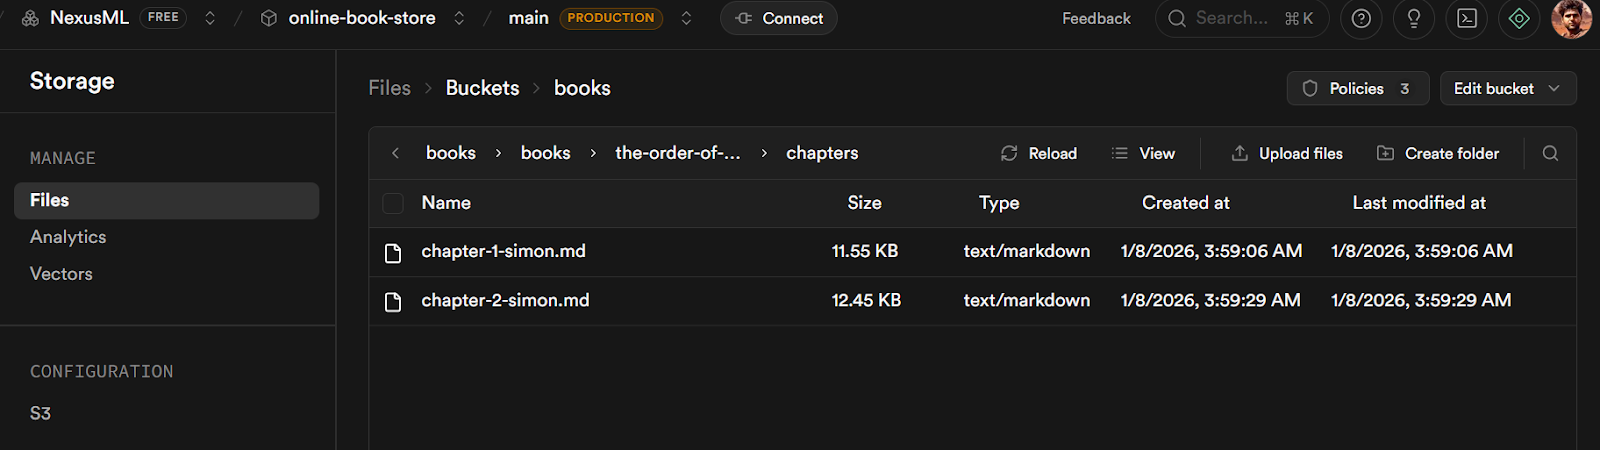
La plupart des SaaS doivent stocker des fichiers à un moment : images de profil, documents, exports, ou ressources générées par l’IA. Le stockage de blobs est optimisé pour cela et séparé de la base de données. C’est moins cher, plus rapide et ça monte en charge indépendamment.
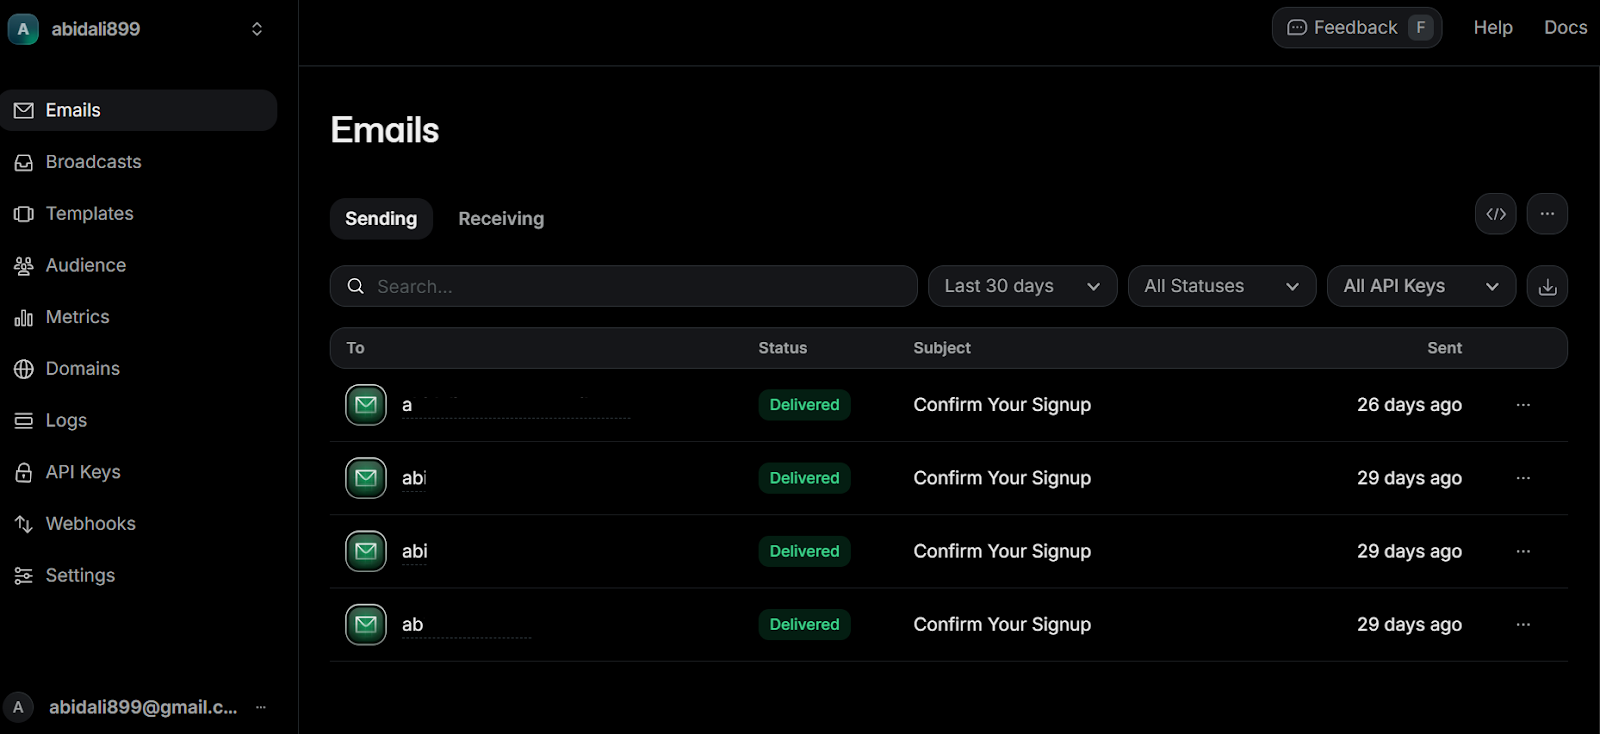
L’email est indispensable pour l’onboarding, la vérification, les réinitialisations et les notifications. Un service email dédié assure une délivrabilité fiable et isole cette brique de votre logique applicative.
Si votre SaaS est payant, vous avez besoin de facturation, d’abonnements, de factures et de webhooks. Un prestataire de paiement vous abstrait la fiscalité, la conformité et les cas limites pour que vous vous concentriez sur la tarification et la valeur, pas sur l’infrastructure financière.
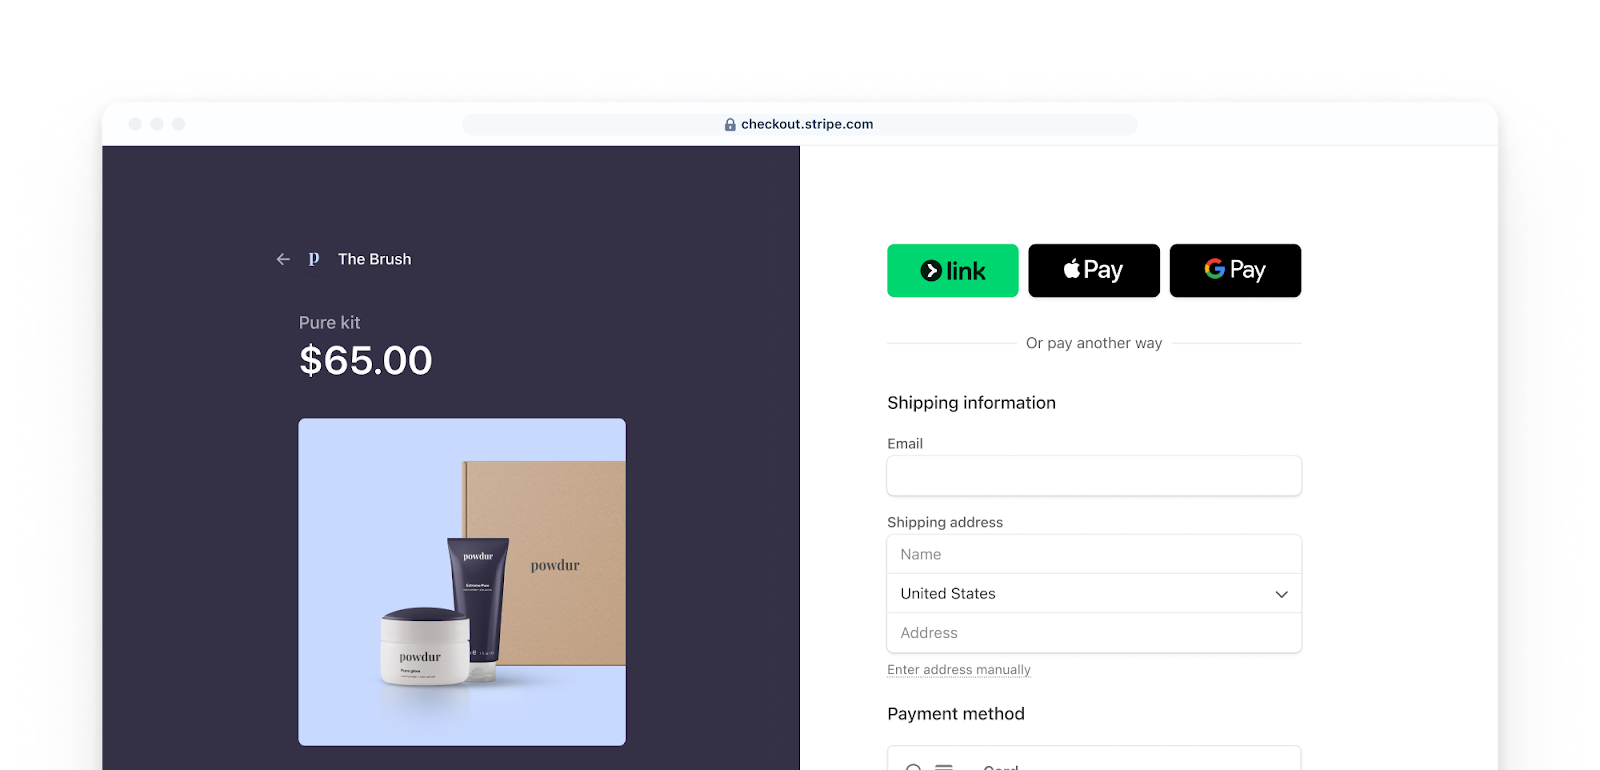
Source : Payments | Stripe Documentation
Les tests garantissent que vous pouvez livrer vite sans tout casser. Les tests unitaires couvrent la logique, tandis que les tests end‑to‑end simulent le comportement réel des utilisateurs. En vibe coding, l’accent est mis sur juste ce qu’il faut de tests pour avancer vite en confiance.
Le déploiement transforme votre code en produit en ligne. Un stack SaaS moderne s’appuie sur des builds automatisés, des aperçus et de l’intégration continue pour que chaque changement soit testé et livré en sécurité. Ce cycle de feedback court est la clé pour itérer vite.
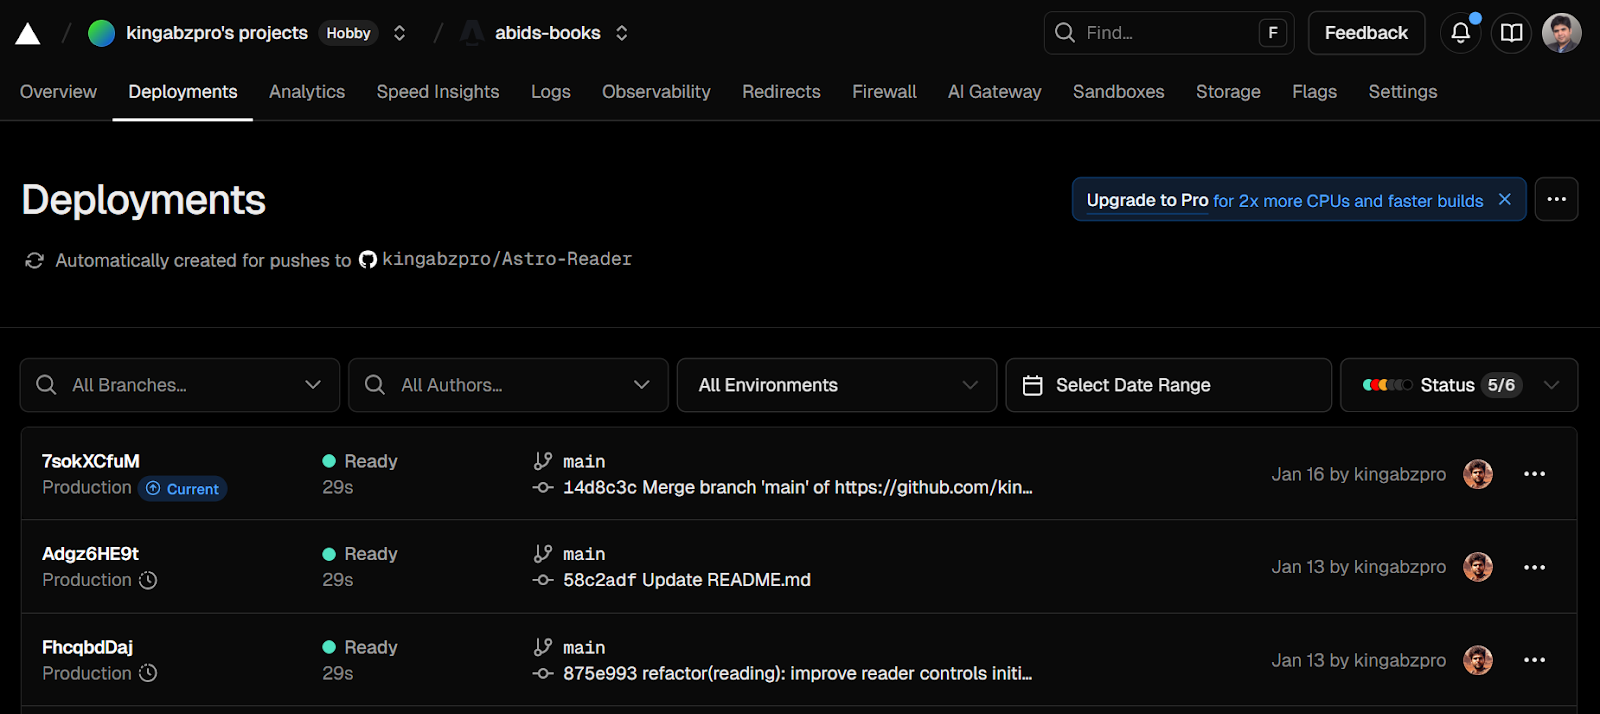
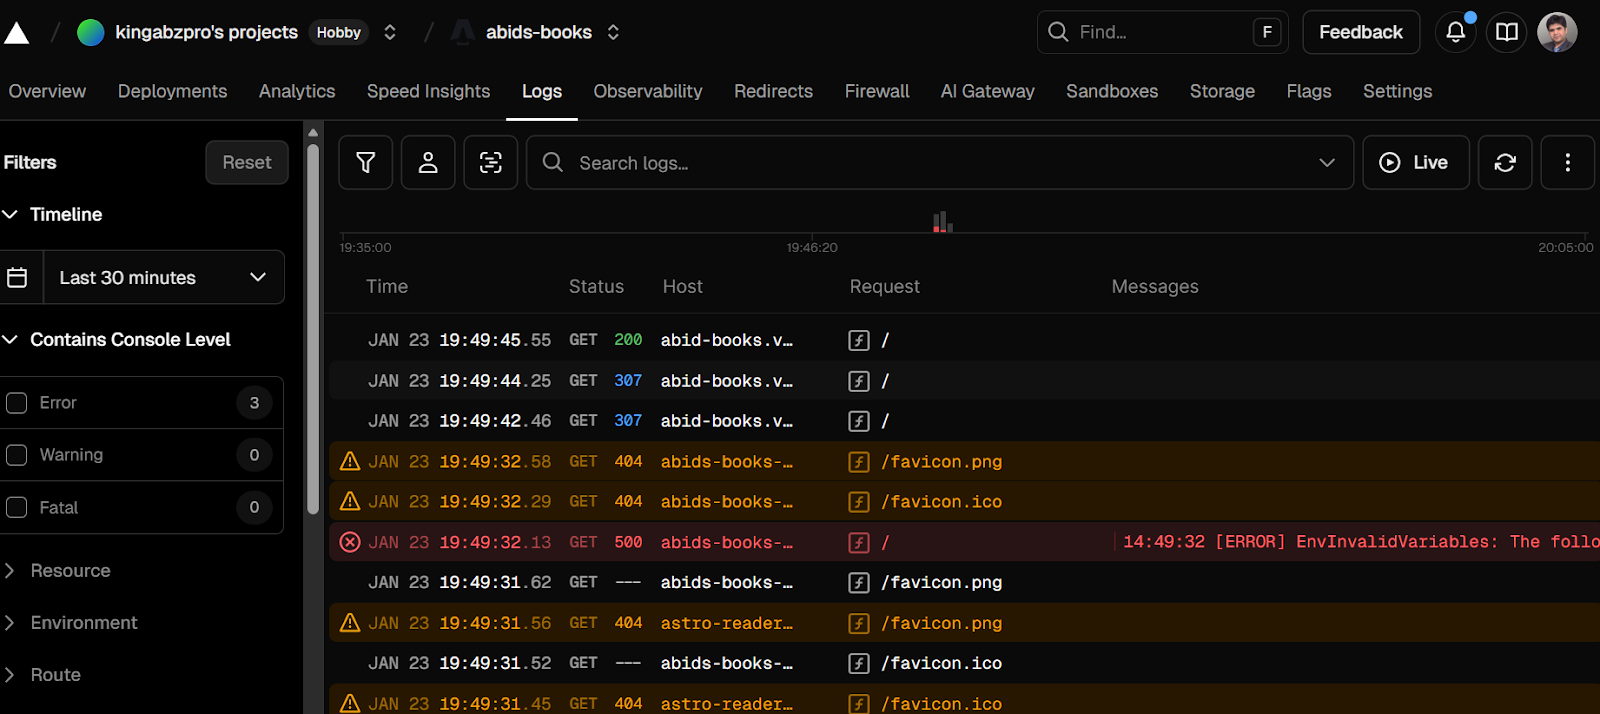
Une fois les utilisateurs en ligne, il vous faut de la visibilité. Les logs et un monitoring de base aident à détecter les erreurs, comprendre les comportements et déboguer rapidement, sans mettre en place un système d’observabilité complexe dès le premier jour.
Un bon stack SaaS n’est pas une histoire d’outils « tape‑à‑l’œil ». Il repose sur une séparation claire des préoccupations : UI, logique, données, auth, stockage, paiements et déploiement — chacun fait une chose et la fait bien. Le vibe coding consiste à choisir des défauts qui réduisent les frictions, pour consacrer plus de temps aux fonctionnalités et moins au câblage de l’infrastructure.
En pratique, la plupart des SaaS modernes s’inscrivent dans l’un de trois schémas. Chacun a un objectif et des compromis différents. Les nommer clairement aide à choisir le bon stack et à savoir quand en changer.
Les trois stacks de vibe coding sont :
La plupart des vibe coders commencent avec le Sprint Stack, migrent vers le Leverage Stack une fois le produit stabilisé, puis ne passent au Control Stack que lorsque l’échelle, le coût ou la conformité imposent une pleine propriété.
Ce stack privilégie la vitesse au cérémonial. Il reste simple, moderne et prêt pour la production, sans vous entraîner trop tôt dans des choix d’infrastructure.
Next.js gère à la fois le frontend et le backend, ce qui vous permet d’avancer vite via les server actions et les routes API.
Neon fournit une base Postgres scalable sans charge opérationnelle, tandis que Drizzle garde les schémas et migrations légers et typés.
Clerk gère l’authentification de bout en bout — inscriptions, connexions, réinitialisations et emails transactionnels — vous évitant un service email séparé.
Stripe n’est ajouté que lorsque les paiements sont nécessaires. Les tests restent volontairement minimaux pour livrer vite, et Vercel prend en charge déploiement, aperçus et logs nativement.
Idéal quand : vous voulez passer de l’idée au produit en ligne en quelques heures, itérer rapidement et éviter totalement la gestion d’infrastructure.
Ce stack s’adresse à celles et ceux qui veulent un maximum de levier avec un minimum d’opérations. Plutôt que de gérer des systèmes séparés pour les données, l’auth, le stockage et les tâches en arrière‑plan, la plupart des besoins backend résident dans une seule plateforme managée.
Next.js alimente frontend et logique backend, déployés sur Vercel pour des aperçus rapides et un hébergement simple.
Supabase sert de socle backend en offrant une base Postgres managée avec tableaux de bord et options de sauvegarde, une authentification intégrée, un stockage de fichiers et blobs, du temps réel et des tâches planifiées.
Resend gère l’email transactionnel, Stripe la facturation et les abonnements, et PostHog et Sentry apportent analytics et visibilité sur les erreurs via leurs offres gratuites.
Les tests restent légers avec Vitest et Playwright, tandis que la CI/CD passe par GitHub Actions avec synchronisation des migrations de base.
Idéal quand : vous voulez un tableau de bord central pour la plupart des besoins backend, des offres gratuites généreuses et un stack qui passe à l’échelle sans vous plonger tôt dans l’infra.
Ce stack s’adresse à celles et ceux qui veulent un contrôle total, zéro dépendance fournisseur, et un fonctionnement intégralement local. Chaque composant est open source et tourne via Docker Compose, ce qui permet à quiconque de cloner le repo et de démarrer un environnement SaaS complet en une seule commande.
Next.js exécute frontend et backend en local, tandis que Postgres fournit une base relationnelle auto‑hébergée.
La gestion de schéma est assurée par Drizzle en local. L’authentification est gérée avec Better Auth, pour garder l’identité et l’accès entièrement sous votre contrôle.
MinIO remplace le blob storage cloud par un service local compatible S3. Mailpit capte les emails sortants en développement, et Redis alimente le cache et les tâches de fond via BullMQ.
Meilisearch gère la recherche plein texte rapide, et des outils d’observabilité optionnels comme Grafana, Prometheus et Loki peuvent s’ajouter pour une visibilité accrue.
Le déploiement reste flexible via Coolify ou Dokku sur un VPS, avec GitHub Actions pour construire et déployer des images Docker en SSH.
Idéal quand : vous voulez un stack SaaS entièrement hors‑ligne, partageable avec docker compose up, sans verrouillage fournisseur, tout en restant apte à la production.
Se lancer n’a pas besoin d’être long ni compliqué. L’objectif : lever les frictions, créer de l’élan et livrer quelque chose de concret le plus tôt possible. Les étapes ci‑dessous sont volontairement simples et fonctionnent avec chacun des trois stacks de vibe coding.
Commencez par choisir le stack que vous allez utiliser. N’y réfléchissez pas trop. Vous pourrez toujours migrer plus tard, mais changer d’outils en plein développement casse l’élan.
Avoir les comptes prêts dès le départ évite les changements de contexte une fois la construction lancée.
Après avoir choisi votre stack, mettez en place les services clés dont vous aurez besoin dès le premier jour. Il s’agit en général de l’authentification, de l’accès à la base, de l’envoi d’emails, des paiements et du déploiement. Créer ces comptes tôt permet de les intégrer naturellement au fil du développement, plutôt que de les greffer après coup.
Selon votre stack, vous devrez généralement créer des comptes et générer des clés API pour :
Une fois les comptes créés, générez les clés API et URLs nécessaires et stockez‑les en variables d’environnement. Conservez ces valeurs dans un fichier .env local et ne commitez jamais de secrets. Ne versionnez que des configurations sûres, comme des fichiers d’exemple ou des clés publiques.
Le faire tôt fluidifie votre développement et évite les changements cassants à l’approche du lancement.
Ne partez pas d’un dépôt vide. Utilisez un template de démarrage qui inclut déjà votre framework, une mise en page de base et la configuration essentielle.
Un bon starter doit vous apporter :
Vous gagnerez des heures de setup et vous concentrerez sur la logique produit plutôt que sur le boilerplate.
Claude Code est le plus efficace si vous le considérez comme un pair programmer interactif, pas juste un générateur de code. Utiliser l’extension Claude Code dans VS Code vous apporte un feedback rapide, un contexte solide et une manière plus conversationnelle de construire.
Au démarrage d’un nouveau projet, commencez toujours en mode plan et assurez‑vous que le raisonnement est activé. Claude réfléchit alors à l’architecture, aux flux de données et aux cas limites avant d’écrire du code. Vous obtenez une structure plus propre et moins de réécritures ensuite.
Connectez aussi tôt les serveurs MCP essentiels. A minima, activez :
Claude peut ainsi raisonner avec de la documentation réelle et des implémentations du monde réel, plutôt que d’« deviner ».
Avant toute écriture de code, fournissez toujours une présentation claire et détaillée de ce que vous construisez. Soyez explicite sur :
Ce contexte ancre l’IA dès le départ et évite les malentendus.
Exemple de prompt de départ :
Build a minimal, production-ready course-selling SaaS using Next.js + Supabase + Stripe + Vercel.
Must include marketing pages, auth, Stripe subscriptions (Checkout + webhooks + portal), dashboard, and protected course content.
Keep it minimal, secure (server-only secrets, webhook verification), and deployable.Déployez dès que votre app tourne en local.
Connectez votre dépôt à la plateforme de déploiement (Vercel), activez les déploiements d’aperçu et poussez fréquemment. Une URL en ligne permet de détecter tôt les problèmes d’environnement et facilite le partage de l’avancement et la collecte de retours.
Plus votre app est en ligne tôt, meilleures seront vos décisions.
Dès que de vrais utilisateurs utilisent votre produit, laissez leur comportement guider votre feuille de route.
Concentrez‑vous sur :
Corrigez d’abord le point le plus douloureux, puis répétez. Les petites itérations s’additionnent plus vite que les grandes réécritures.
Une fois votre SaaS en ligne et utilisé, la visibilité devient plus importante que les nouvelles features. C’est le moment de rendre le produit fiable, prévisible et plus facile à faire évoluer.
Commencez par ajouter du monitoring et du suivi d’erreurs pour être alerté avant vos utilisateurs. Associez‑y des tests automatisés basiques pour protéger les parcours critiques (inscription, connexion, paiement) au fil des itérations.
Introduisez ensuite des automatisations pour le travail répétitif ou temporel : jobs planifiés, traitements en arrière‑plan, tâches de nettoyage, workflows email. Cela diminue l’effort manuel et garde le système cohérent quand l’usage croît.
Enfin, misez sur le suivi du comportement utilisateur. Suivez leurs parcours, leurs hésitations et les fonctionnalités réellement utilisées. Ces données valent bien plus que des opinions ou des suppositions.
Si je ne devais donner qu’un seul conseil, ce serait de commencer par un bon squelette. Je demande d’abord à mon agent de code de bâtir la fondation de l’application, avec des emplacements clairs pour les futures fonctionnalités. Cette approche donne de la structure dès le jour 1 et rend les changements ultérieurs bien moins douloureux.
C’est là que le mode plan de Claude Code brille vraiment. Je lui demande d’abord de réfléchir à l’architecture, aux parcours utilisateurs et au modèle de données avant d’écrire la moindre ligne. Une fois le plan validé, je passe à l’exécution.
De là, Claude Code m’aide à construire des features, écrire et exécuter des tests, et même déployer l’app via les commandes CLI. Il peut aussi consulter la doc, repérer les problèmes courants et proposer des correctifs automatiquement, ce qui lisse énormément le développement.
Dès que l’application tourne en local, l’étape suivante est le déploiement. J’essaie de déployer sur Vercel le plus tôt possible. Avoir une URL live change la façon de penser le produit. Cela crée de l’élan, rend les progrès tangibles et permet de partager rapidement avec des proches ou des premiers utilisateurs pour obtenir des retours.
À mesure que le produit grandit, l’organisation devient clé. À chaque nouvelle fonctionnalité, je crée d’abord une issue GitHub, puis j’ouvre une branche liée à cette issue.
Je travaille la feature isolément et je termine par une pull request. Ce workflow simple aide à suivre l’avancement, à contenir les changements et à rendre le projet plus gérable dans le temps, même en solo.
Pour aller plus loin sur certains outils cités, je recommande vivement :
L’essentiel, c’est de vous lancer et livrer. Choisissez un stack, ouvrez votre éditeur et laissez le flow vous guider vers votre première URL en ligne.
Les meilleurs cours DataCamp
Cours
Cours
Cours