
Kurs
Einführung in NoSQL
4 Std.
10.7K
Da die Datenmengen im digitalen Zeitalter explodieren, sind Datenbanken entscheidend, um große Datenbestände zu speichern, zu verwalten und zu analysieren. Grundsätzlich gibt es zwei Arten von Datenbanken: SQL- und NoSQL-Datenbanken.
SQL-Datenbanken nutzen ein strukturiertes Format, die Daten sind in Tabellen mit Schemas organisiert. Im Gegensatz dazu bieten NoSQL-Datenbanken flexible Schemas, um semi-strukturierte und unstrukturierte Daten zu speichern. Sie stellen die nötige Infrastruktur bereit, um die riesigen Datenmengen der heutigen digitalen Welt zu managen und zu nutzen.
Dieser umfassende Leitfaden behandelt die Grundlagen von NoSQL-Datenbanken, zeigt verschiedene NoSQL-Typen mit Praxisbeispielen aus der Industrie. Sobald wir diese Basics verstanden haben, tauchen wir in MongoDB ein, eine der beliebtesten NoSQL-Datenbanken, und lernen, wie man CRUD-Operationen (Create, Retrieve, Update, Delete) ausführt.
NoSQL steht für „Not Only SQL“ und wurde entwickelt, um die Grenzen relationaler Datenbanken zu überwinden. Relationale Datenbanken folgen einer starren Struktur, haben ein tabellarisches Format und nutzen SQL (Structured Query Language) zur Datenmanipulation.
NoSQL-Datenbanken bieten einen flexibleren Ansatz für die Speicherung semi-strukturierter und unstrukturierter Daten.
Der größte Vorteil von NoSQL-Datenbanken ist ihre Eignung für sehr große Datenmengen mit variierenden Strukturen. NoSQL-Datenbanken sind schemafrei, was mehr Agilität und Skalierbarkeit ermöglicht.
Diese Vorteile gehen jedoch mit Trade-offs einher. Sie bieten eine schwächere Konsistenz und nur begrenzte Unterstützung für komplexe Abfragen. Trotz dieser Einschränkungen sind sie wegen ihrer Stärken weit verbreitet und ergänzen SQL-Datenbanken sinnvoll.
Mehr über die wichtigsten Unterschiede zwischen SQL- und NoSQL-Datenbanken sowie Tipps zur richtigen Wahl findest du in einem separaten Tutorial.
Um unterschiedliche Anwendungsfälle abzudecken, nutzen NoSQL-Datenbanken verschiedene Datenmodelle zur Organisation und zum Zugriff auf Daten. Hier sind vier gängige NoSQL-Typen.
Wenn du mehr über die unterschiedlichen Datenbanktypen erfahren möchtest, schau dir unser Tutorial NoSQL-Datenbanken: Was jede Data Scientist wissen sollte an.
Nachdem wir geklärt haben, was NoSQL ist und welche Arten es gibt, ist es Zeit für praktische Übungen mit NoSQL-Datenbanken.
Ein praxisnahes Beispiel ist entscheidend, um die behandelten Konzepte wirklich zu verstehen und auszuprobieren. Gehen wir gemeinsam ein NoSQL-Tutorial durch.
Angenommen, du möchtest deine eigene Blogplattform aufbauen. Du willst Blogbeiträge erstellen, Kommentare erlauben und alles aktuell halten. Da du weißt, dass die Daten unstrukturiert sind, liegt eine NoSQL-Datenbank wie MongoDB für diesen Use Case auf der Hand.
MongoDB ist eine Open-Source-NoSQL-Datenbank. Anstelle von Tabellen speichert sie Daten in JSON-ähnlichen Dokumenten. Das erleichtert die Abbildung komplexer Strukturen und Beziehungen. Unterschiedliche Datentypen wie Text, Zahlen oder Bilder – typisch für Blogs – lassen sich einfach verwalten.
Starten wir mit der Einrichtung von MongoDB auf deinem Rechner.
Die Installation von MongoDB ist unkompliziert. Du kannst es von der offiziellen MongoDB-Website herunterladen und installieren. Die Schritte unterscheiden sich je nach Betriebssystem, daher lies die Installationsanleitung für dein Betriebssystem in der offiziellen Dokumentation.
Nach der Installation startest du MongoDB. Öffne einfach das Terminal und gib je nach Betriebssystem Folgendes ein:
// Linux
sudo systemctl start mongod

//Mac OS
brew services start mongodb-community@7.0
Du erhältst eine Meldung wie „Successfully started“, wie unten gezeigt.

Ausgabe: MongoDB wird gestartet. (Dieses und alle folgenden Bilder: Autor)
Die MongoDB-Installation enthält eine Shell namens mongosh, mit der wir mit der MongoDB-Datenbank interagieren können. Es ist keine zusätzliche Installation nötig.
Starte die MongoDB-Shell mit folgendem Befehl im Terminal:
mongosh
Die Ausführung des Befehls mongosh zeigt eine Ausgabe, die die Verbindung zu deiner Datenbank bestätigt.
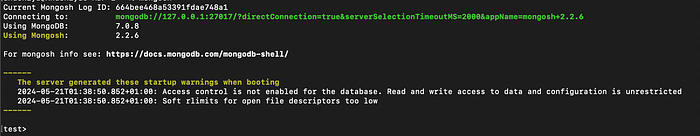
Die MongoDB-Shell starten.
Mit installierter MongoDB definieren wir als Nächstes unser Datenmodell.
Wir erstellen eine Datenbank namens „blog“ und zwei Collections namens „posts“ und „comments“. Die Collection „posts“ enthält die Blogeinträge, „comments“ speichert die Kommentare zu diesen Beiträgen.
Jedes Post-Dokument hat Felder für Titel, Inhalt, Autor und Erstellungsdatum; jedes Kommentar-Dokument enthält Inhalt, Autor und die zugehörige Post-ID.
Um alle vorhandenen Datenbanken aufzulisten, führe in der Shell show dbs aus. Wenn du MongoDB zum ersten Mal verwendest, siehst du folgende Ausgabe.
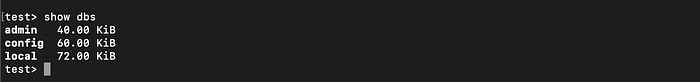
Vorhandene Datenbanken auflisten.
Standardmäßig verwenden wir die Datenbank „test“. Obwohl wir uns in „test“ befinden, wird die Datenbank erst angelegt, wenn wir ein Dokument in eine Collection einfügen.
Um eine neue Datenbank zu erstellen, führe use <database_name> aus.
In unserem Beispiel nutzen wir „blog“ als Namen. Führe use blog aus, um die neue Datenbank zu erstellen. Wie oben erwähnt, erscheint die Datenbank mit show dbs erst, nachdem wir eine Collection eingefügt haben. Führe daher die folgenden Befehle aus, um Collections anzulegen.
// create database
use blog

// create collection
db.createCollection("posts")
db.createCollection("comments")
Die Ausführung von use blog wechselt die Datenbank von „test“ zu „blog“.
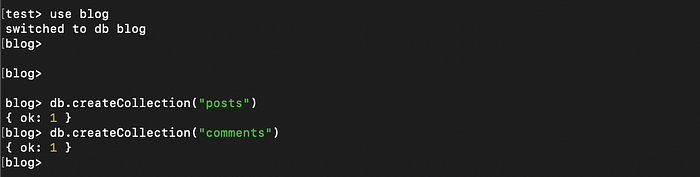
Ausgabe: Datenbank und Collections erstellen.
Nach dem Erstellen der Collections können wir das mit show dbs prüfen.
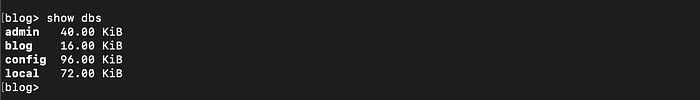
Liste der Datenbanken.
Wir haben erfolgreich eine Datenbank und Collections angelegt.
MongoDB unterstützt vier zentrale CRUD-Operationen (Create, Read, Update, Delete) zur Dateninteraktion:
insertOne() oder insertMany() in eine Collection ein. Dokumente können beliebige gültige JSON-Daten enthalten, was ein flexibles Schema ermöglicht.find(). Abfragen filtern Dokumente anhand angegebener Kriterien und geben die Ergebnisse zurück.updateOne() oder updateMany(). Diese Methoden erlauben flexible Datenmanipulation.deleteOne() oder deleteMany(). Gelöscht wird anhand festgelegter Kriterien, zum Beispiel eines bestimmten Feldwerts.Nachdem wir die Befehle gesehen haben, setzen wir sie nun in unserem Blogging-Use-Case praktisch um.
Zum Einfügen von Dokumenten in eine MongoDB-Datenbank gibt es zwei Methoden.
insertOne(): Fügt jeweils ein Dokument ein.insertMany(): Fügt mehrere Dokumente in einem Rutsch ein.Wir nutzen beide Methoden, um Blogbeiträge zur Datenbank hinzuzufügen. Im folgenden Code erstellen wir Dokumente in der Collection „posts“. Jedes Dokument hat einen Titel, Inhalt, Autor und ein Erstellungsdatum.
// use insertOne() method to insert one document to the "posts" collection
db.posts.insertOne({
   title: "Introduction to NoSQL with MongoDB",
   content: "MongoDB is a NoSQL database that stores data in JSON format",
   author: "Arunn Thevapalan",
   createdAt: new Date()
})

// array of blog post documents
var postsData = [
   {
       title: "Getting Started with MongoDB",
       content: "Learn the basics of MongoDB",
       author: "Arunn Thevapalan",
       createdAt: new Date()
   },
   {
       title: "Advanced MongoDB Techniques",
       content: "Explore advanced features of MongoDB",
       author: "Jim Murphy",
       createdAt: new Date()
   }
];

// use insertMany() to insert multiple documents
db.posts.insertMany(postsData);
Diese Ausgabe zeigt, dass der MongoDB-Server die insertOne-Anfrage erfolgreich erhalten und verarbeitet hat.
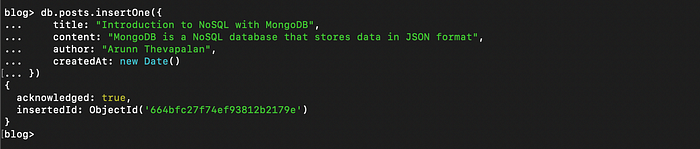 Ausgabe: Ein Dokument in eine Collection einfügen.
Ähnlich zeigt die folgende Ausgabe die erfolgreiche Verarbeitung der insertMany-Anfrage.
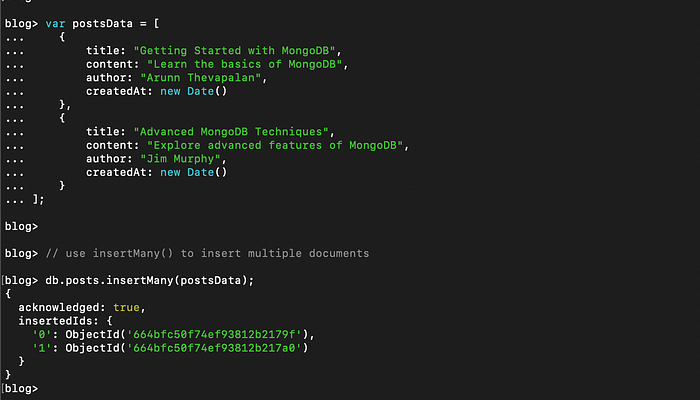 Ausgabe: Mehrere Dokumente in eine Collection einfügen.
Mit dem Create-Schritt im Gepäck geht es weiter mit Read.
Mit der Methode find() können wir Daten aus Collections abrufen. Um die oben eingefügten Blogposts aus „posts“ zu holen, führe den folgenden Befehl aus:
db.posts.find()
Die Methode find ruft alle Dokumente in der Collection „posts“ ab. Die folgende Ausgabe zeigt alle Dokumente, die wir im vorherigen Schritt eingefügt haben.

Ausgabe: Dokumente aus einer Collection abrufen.
Wenn wir einem Beitrag ein paar Kommentare hinzufügen möchten, fügen wir ein Dokument in die Collection „comments“ ein. Kommentare sind Beiträgen zugeordnet, daher speichern wir die Referenz auf die Post-ID.
// use an object id from any of the above entries
var postId = ObjectId("664bfc27f74ef93812b2179e")

// insert one comment
db.comments.insertOne({
   postId: postId,
   content: "Informative article!",
   author: "Anne Smith",
   createdAt: new Date()
})
Diese Ausgabe zeigt, dass der MongoDB-Server die Anfrage erhalten und verarbeitet hat.
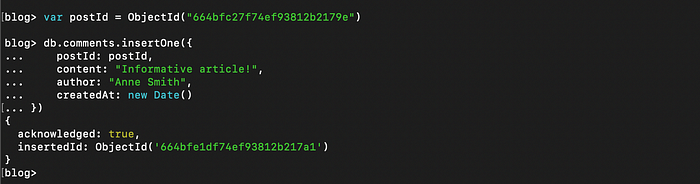
Ausgabe: Ein Dokument erstellen, das auf ein anderes verweist.
Um Kommentare zu einem bestimmten Blogpost zu holen, verwenden wir find() mit einem Query-Filter:
// retrieve the above comment
db.comments.find({postId: postId})
Die folgende Ausgabe zeigt den Kommentar, den wir im vorherigen Schritt eingefügt haben.
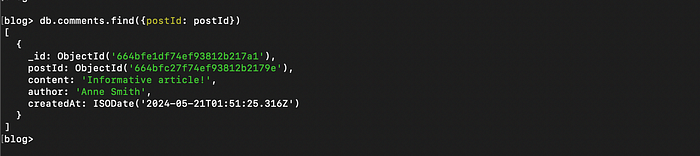
Ausgabe: Ein Dokument mit einer find-Abfrage finden.
Sobald Nutzer Beiträge erstellt haben, möchten sie diese später aktualisieren können. Schauen wir uns also an, wie wir bestehende Dokumente ändern.
Ähnlich wie beim Einfügen geht das Aktualisieren einzeln oder in der Masse.
updateOne(): Aktualisiert ein einzelnes Dokument.updateMany(): Aktualisiert mehrere Dokumente auf einmal.Ändere den Titel des Blogposts „Introduction to NoSQL with MongoDB“ zu „Absolute Beginner Guide to NoSQL with MongoDB“.
Da wir die Post-ID aus einem der vorherigen Schritte kennen, führe den folgenden Code aus, um den Titel zu ändern. Achte darauf, die postId durch deine Dokument-ID zu ersetzen.
var postId = ObjectId("664bfc27f74ef93812b2179e");

db.posts.updateOne(
   { _id: postId },
   { $set: { title: "Absolute Beginner guide to NoSQL with MongoDB"} }
);

// verify update
db.posts.find({_id: postId})
Die Ausgabe zeigt, dass die Anfrage erfolgreich verarbeitet wurde. Ein passendes Dokument wurde gefunden und eines geändert.
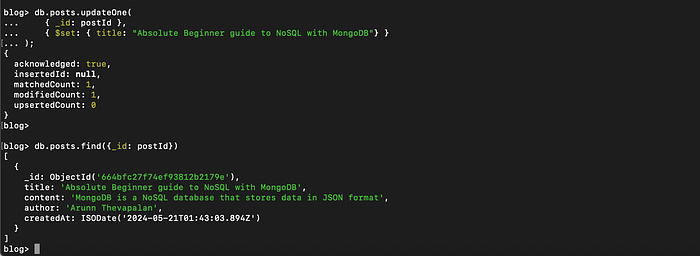
Ausgabe: Ein Dokument aktualisieren.
Zum Löschen eines Blogposts verwenden wir deleteOne(). Analog können wir mit deleteMany() mehrere Dokumente auf einmal entfernen.
var postId = ObjectId("664bfc27f74ef93812b2179e");

// delete post
db.posts.deleteOne({ _id: postId });

// verify deletion -> no output
db.posts.find({_id: postId})
Die Ausgabe bestätigt das erfolgreiche Löschen.
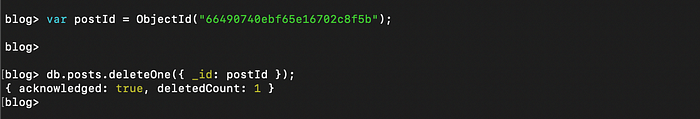
Ausgabe: Ein Dokument aus einer Collection löschen
Natürlich haben wir das Design einer Blogging-Plattform vereinfacht. In der Praxis gibt es oft weitere Funktionen wie Highlights, Likes, Klatschen, Empfehlungen usw. Doch all diese Aktionen basieren auf CRUD-Operationen – und diese Grundkonzepte beherrschst du jetzt. Du bist dran: Erkunde und experimentiere mit weiteren Features auf Basis dieser Operationen.
Dieses Tutorial hat dich in NoSQL-Datenbanken eingeführt. Wir haben mit den Grundbegriffen gestartet: Was NoSQL ist, wie es sich von relationalen Datenbanken unterscheidet und welche Typen es gibt.
Anschließend haben wir MongoDB behandelt, eine weit verbreitete dokumentenbasierte Datenbank. Zum Schluss haben wir anhand eines einfachen Beispiels eine Datenbank für unsere Blogplattform entworfen.
Es ist normal, beim Design einer Datenbank für einen neuen Use Case ins Stocken zu geraten. Wir empfehlen dir, in der offiziellen Dokumentation die aktuellen Funktionen und Beispiele nachzuschlagen.
Wenn du dein NoSQL-Wissen vertiefen möchtest, findest du hier weitere Kurse und Tutorials:
Mit DataCamp weiterlernen
Kurs
Kurs
Kurs