
Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.8K
Auch wenn die meisten Google mit Suchmaschinen verbinden, hat das Unternehmen tiefe Wurzeln in der Data-Science-Welt. Google liefert kontinuierlich State-of-the-Art-Produkte und -Lösungen, um Daten maximal zu nutzen. Eines dieser Produkte, Vertex AI, wurde 2021 veröffentlicht, um Machine Learning im Unternehmensmaßstab zu vereinfachen.
In diesem Tutorial lernst du, wie du mit Googles Vertex AI startest und es für eine Vielzahl von Aufgaben im ML-Lebenszyklus nutzt. Am Ende hast du ein bereitgestelltes Modell, an das du Anfragen senden kannst, um Vorhersagen für eine Klassifikationsaufgabe zu erzeugen.
Ein typischer Machine-Learning-Lebenszyklus besteht aus vielen Phasen:
All diese Phasen und Unterphasen erfordern unterschiedliche Tools und ein diverses Team an Expertinnen und Experten, die sie koordinieren.
Vertex AI von Google Cloud verschlankt und vereint diesen gesamten Prozess in einer einzigen Plattform.
Auch wenn groß angelegte ML-Anwendungen erfahrene Spezialisten brauchen, macht Vertex AI Nutzende aller Kompetenzstufen handlungsfähig:
Es gibt vieles, das wir hier nicht erwähnen – du wirst im Verlauf des Tutorials mit den meisten Funktionen selbst arbeiten.
Bevor wir die Plattform erkunden, ein Wort zum Elternteil — Google Cloud Services. Google Cloud Services umfasst eine breite Palette an Cloud-Computing-Lösungen für Storage, Netzwerke, Datenbanken, Analytics und Machine Learning.
Diese Services arbeiten nahtlos mit Vertex AI zusammen und vereinheitlichen deinen Machine-Learning-Workflow. Hier eine Übersicht der häufig mit Vertex AI genutzten Dienste:
Die Google Cloud Services sind jederzeit über dein Google-Konto unter cloud.google.com verfügbar. Wenn du sie noch nie genutzt hast, klicke auf „Get started for free“, um deine kostenlose Testphase zu erhalten.
Andernfalls kannst du direkt zu console.cloud.google.com gehen, um loszulegen.
Hinweis: Wenn du dem Tutorial folgen willst, plane 25–30 $ für Vertex AI ein. Wir verwenden die günstigsten Konfigurationen.
Wenn du deine Google Cloud Console besuchst, landest du wahrscheinlich auf folgender Willkommensseite:
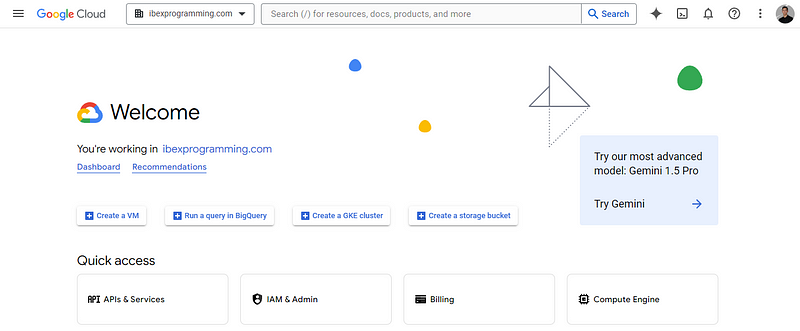
Hier siehst du den Namen deines Arbeitsbereichs; meiner ist ibexprogramming.com.
Als Erstes erstellen wir ein Projekt. Google-Cloud-Projekte sind übergeordnete Organisationseinheiten, um Ressourcen für eine bestimmte Aufgabe zu verwalten. So erstellst du eines (GIF):
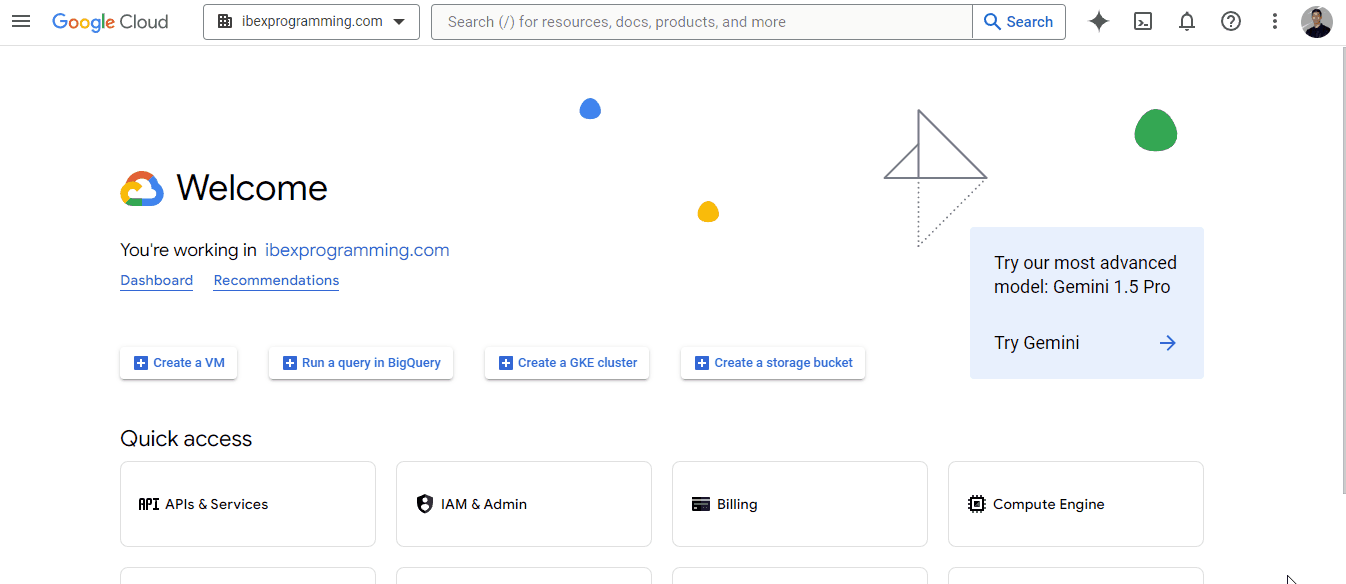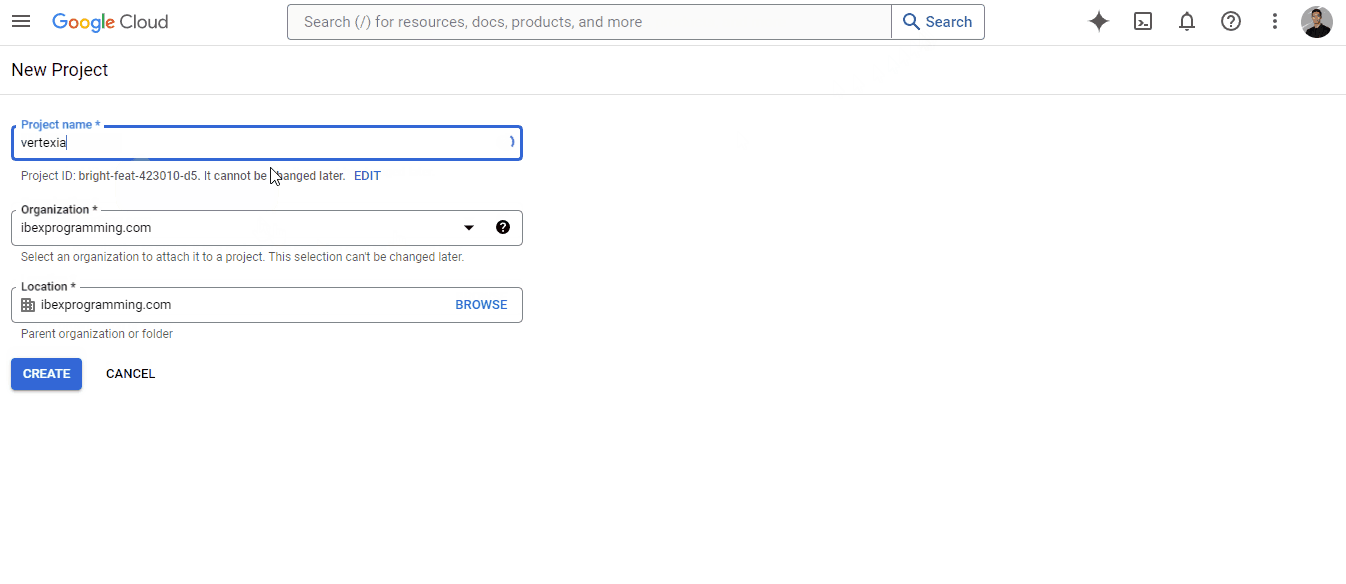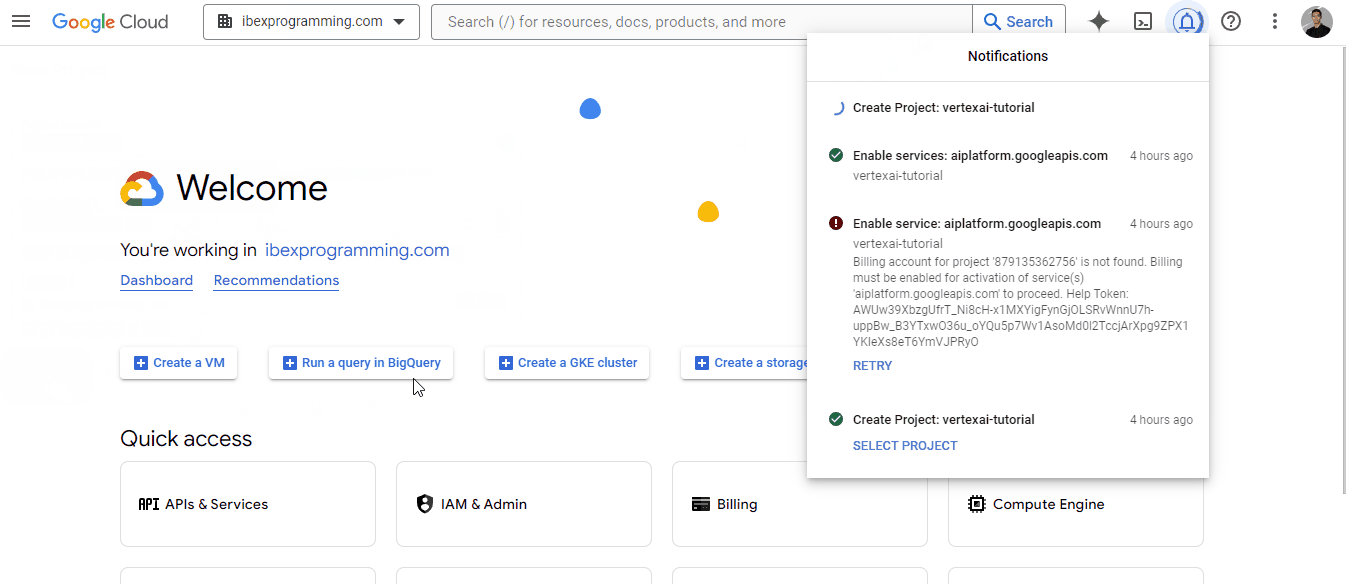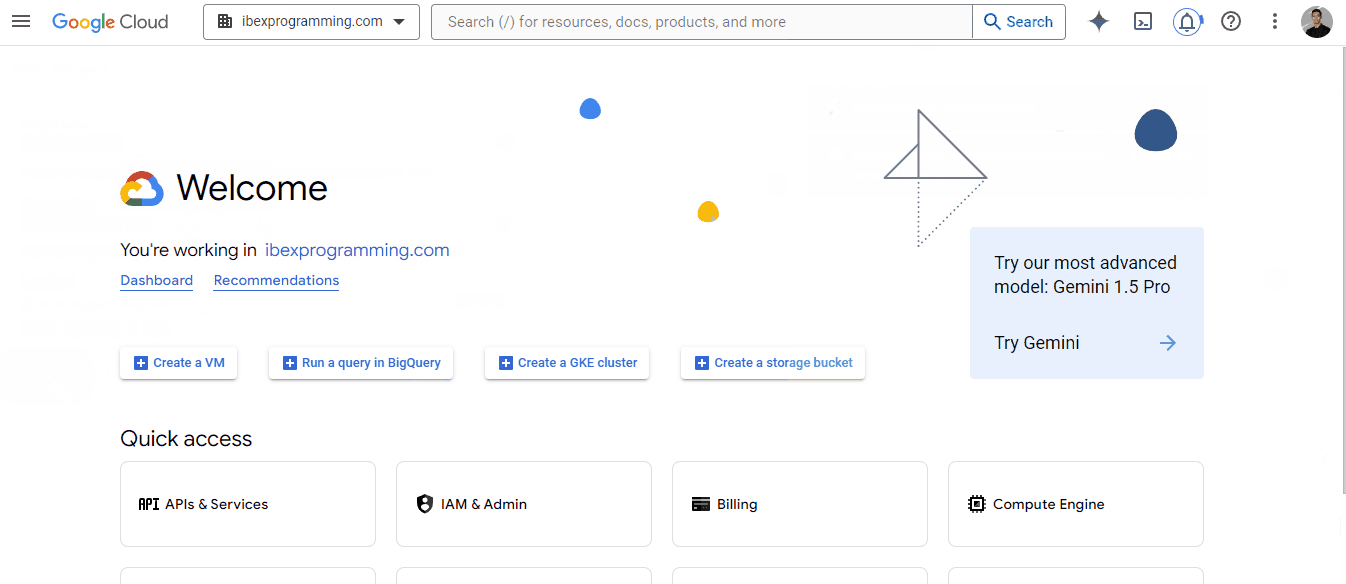
Sobald das Projekt erstellt wurde, wähle es aus, sodass die obere Leiste der Seite Folgendes anzeigt:
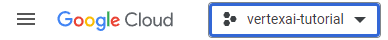
Jetzt musst du ein Abrechnungskonto anlegen, da Vertex AI Abrechnungsdaten benötigt, um seine Dienste zu aktivieren. Keine Sorge — es fallen erst Kosten an, wenn du kostenpflichtige Ressourcen nutzt. Gehe also zu https://console.cloud.google.com/billing:
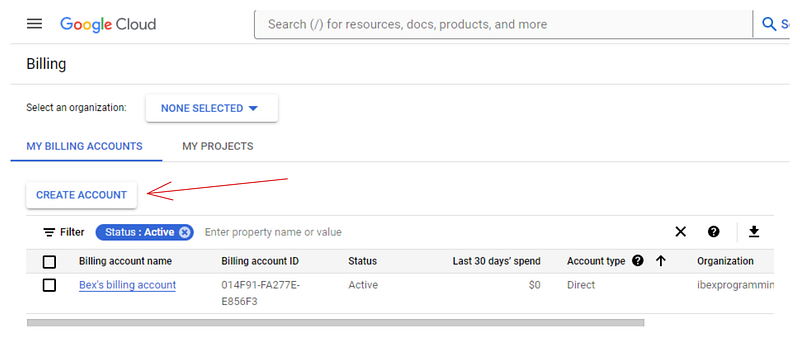
Wenn du – wie ich – noch kein Konto hast, klicke auf „Create account“ und folge den Anweisungen. Wir verknüpfen dieses Abrechnungskonto im nächsten Schritt mit unserem Projekt.
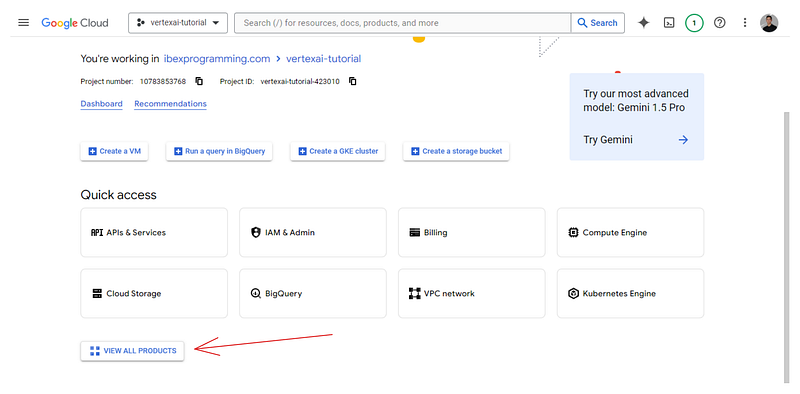
Gehe anschließend zurück zu https://console.cloud.google.com/ und klicke unten auf der Seite auf „View all products“:
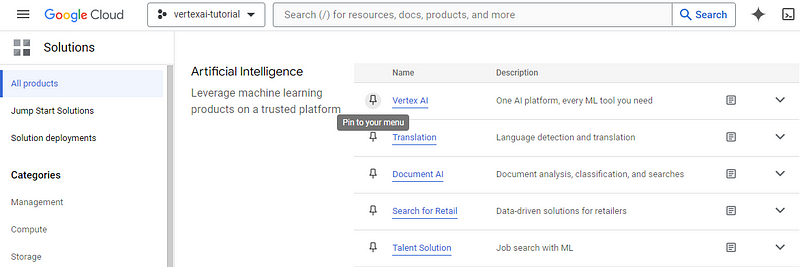
Auf der nächsten Seite werden alle Google-Cloud-Dienste für dein Projekt aufgelistet. Suche „Vertex AI“ (Strg + F) und hefte es für den Schnellzugriff an dein Menü an. Klicke dann auf den Dienst selbst:
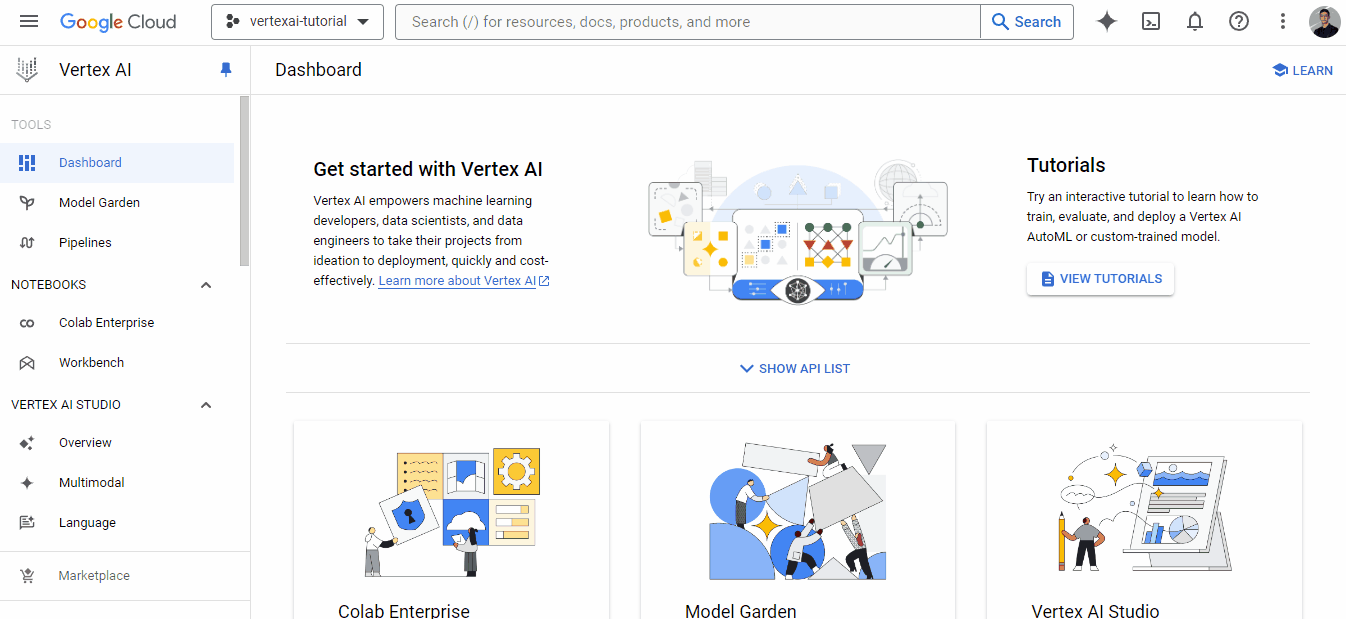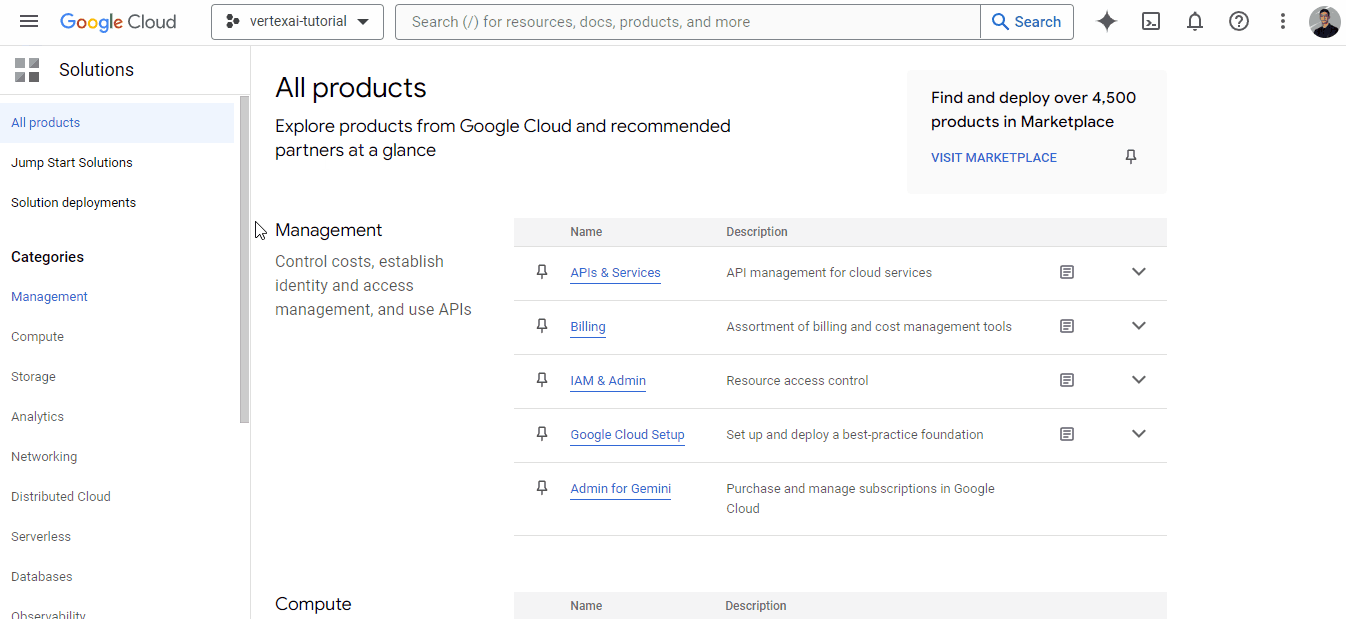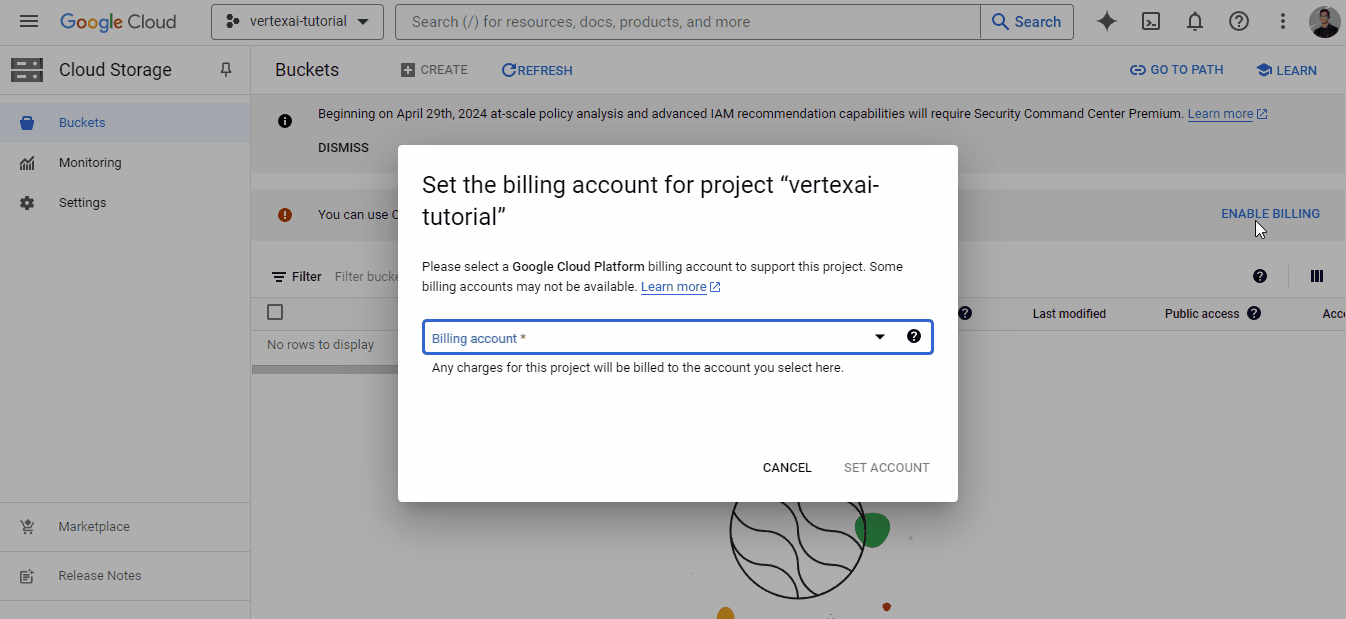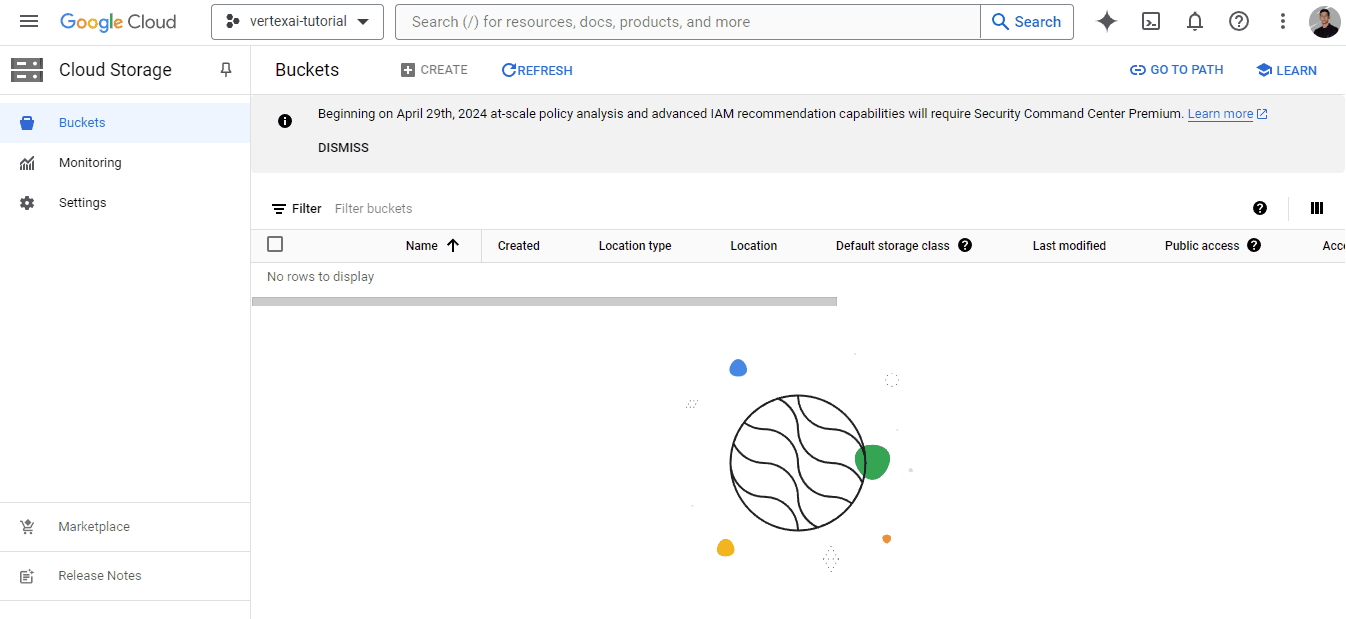
Du wirst zu deinem Vertex-AI-Dashboard weitergeleitet. Möglicherweise erscheint ein Fenster, das dich auffordert, die Vertex-AI-API zu aktivieren — wähle „Enable“. Falls kein Fenster erscheint, kannst du auf „Enable all API permissions“ klicken.
Jetzt sind wir bereit, ein Dataset in Vertex AI hochzuladen.
Es gibt verschiedene Möglichkeiten, ein Dataset zu Vertex AI hinzuzufügen. In diesem Abschnitt nutzen wir zur Einfachheit eine lokale CSV-Datei.
Für den Artikel verwenden wir das Dry Bean Dataset aus dem UCI Machine Learning Repository. Es enthält 13.000 Bohnen-Instanzen und deren 15 numerische Messwerte.
Die Aufgabe ist, sie in sieben Bohnentypen zu klassifizieren: Seker, Barbunya, Bombay, Cali, Dermosan, Horoz und Sira.
Speichere nach dem Download die Excel-Datei aus dem ZIP-Archiv in deinem lokalen Verzeichnis:
from pathlib import Path

cwd = Path.cwd()
data_path = cwd / "data" / "Dry_Bean_Dataset.xlsx"
Dann lesen wir die Datei mit pandas ein und speichern sie als CSV:
import pandas as pd

beans = pd.read_excel(data_path)

beans.shape
(13611, 17)Beachte, dass die Funktion read_excel die Installation der Bibliothek openpyxl per PIP erfordert.
Super, wir haben den Datensatz als DataFrame. Speichern wir ihn als CSV:
beans.to_csv(cwd / "data" / "dry_bean.csv", index=False)Wie bereits erwähnt, benötigen wir einen Google-Storage-Bucket, um unsere Rohdaten zu speichern. Folge dem GIF, um zum Dashboard des Produkts zu navigieren:
Das GIF zeigt, dass wir zur Nutzung der Storage-Dienste ein Abrechnungskonto verknüpfen müssen – und zwar das, das wir vorhin erstellt haben. Danach kannst du einen Bucket mit einem global eindeutigen Namen erstellen:
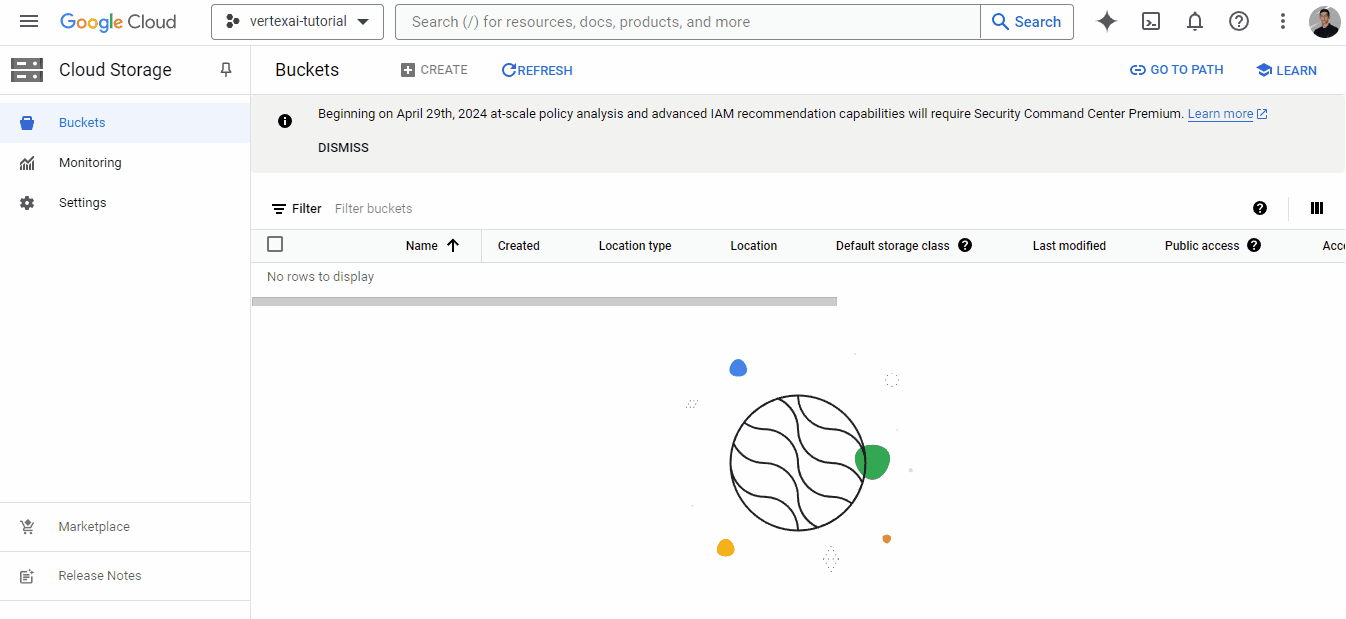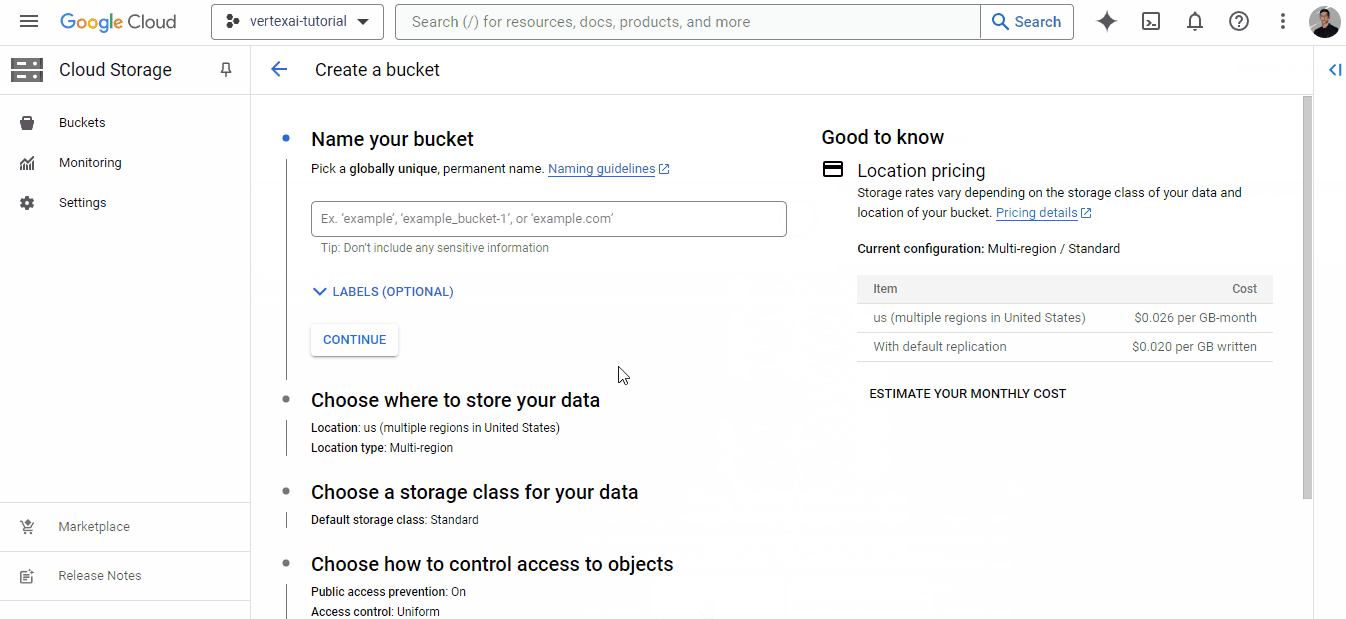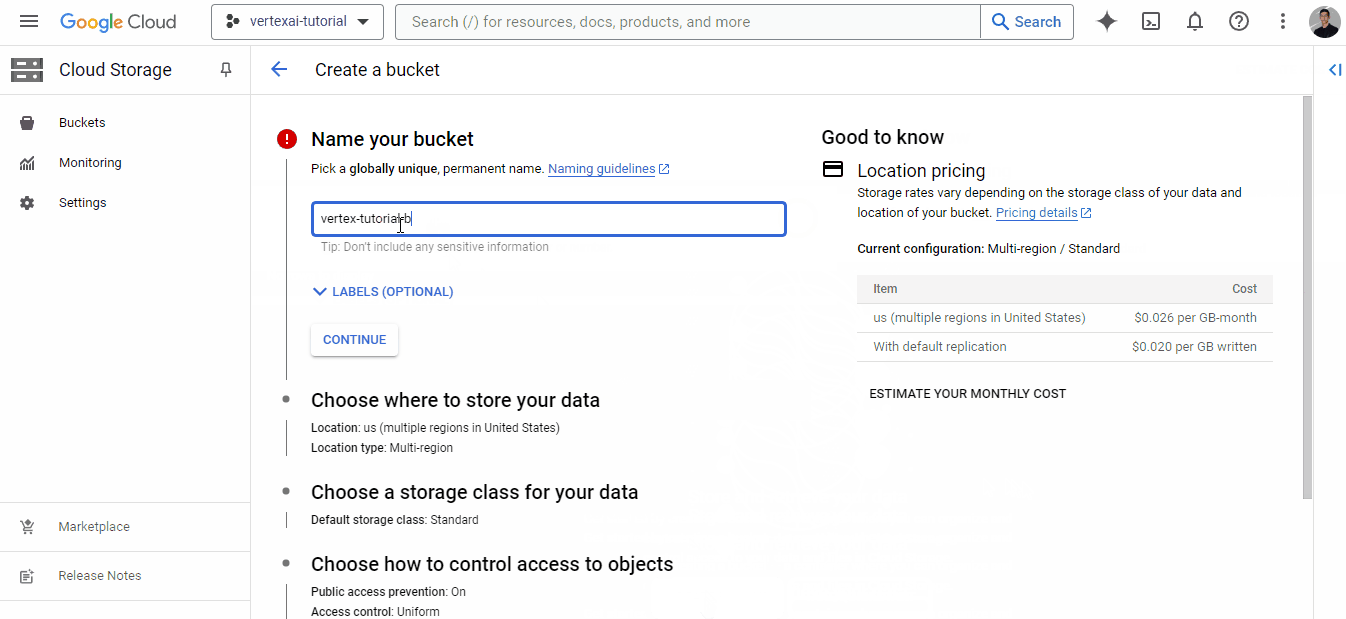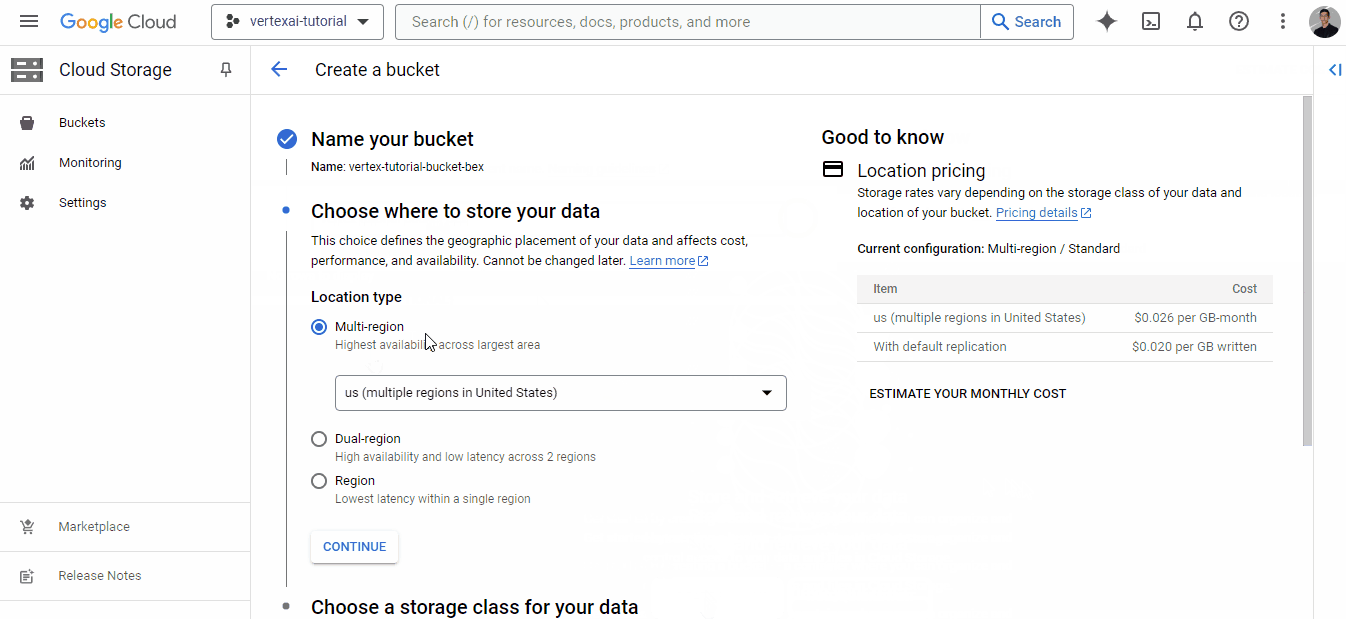
Sobald du einen eindeutigen Namen gefunden hast, klicke auf „Continue“, bis der Bucket erstellt ist — du kannst überall die Standardoptionen lassen.
Jetzt sind wir bereit, die CSV-Datei aus dem vorherigen Abschnitt zu ingestieren.
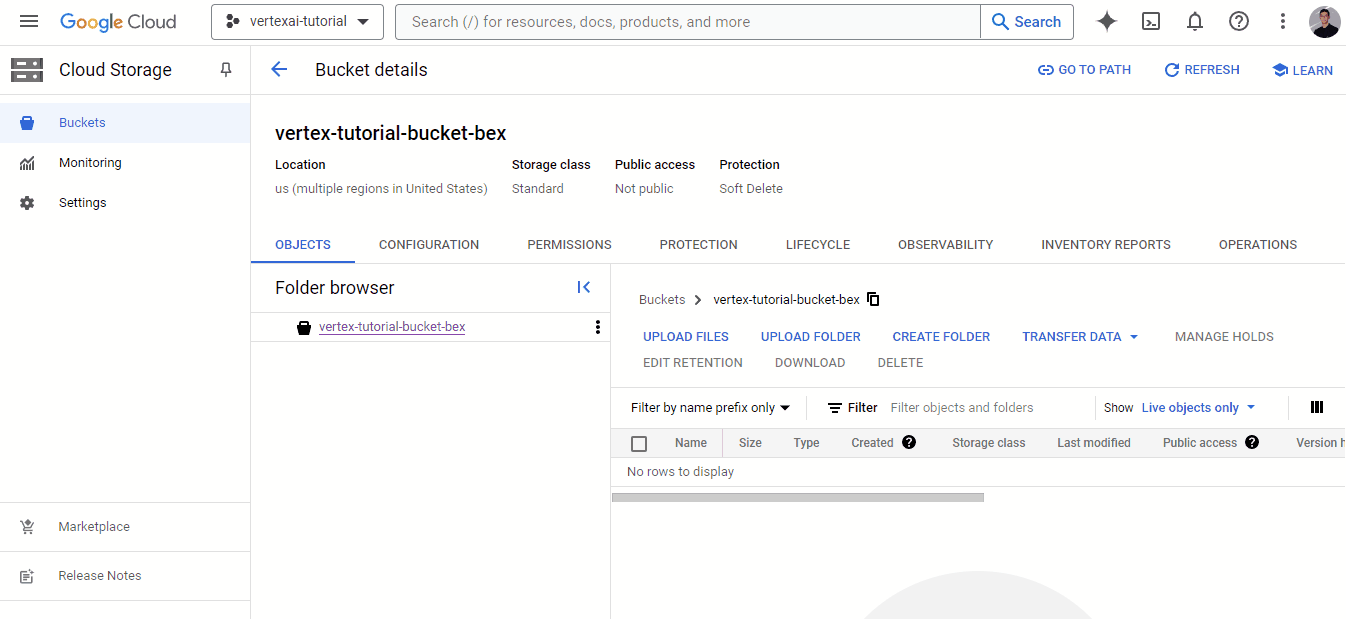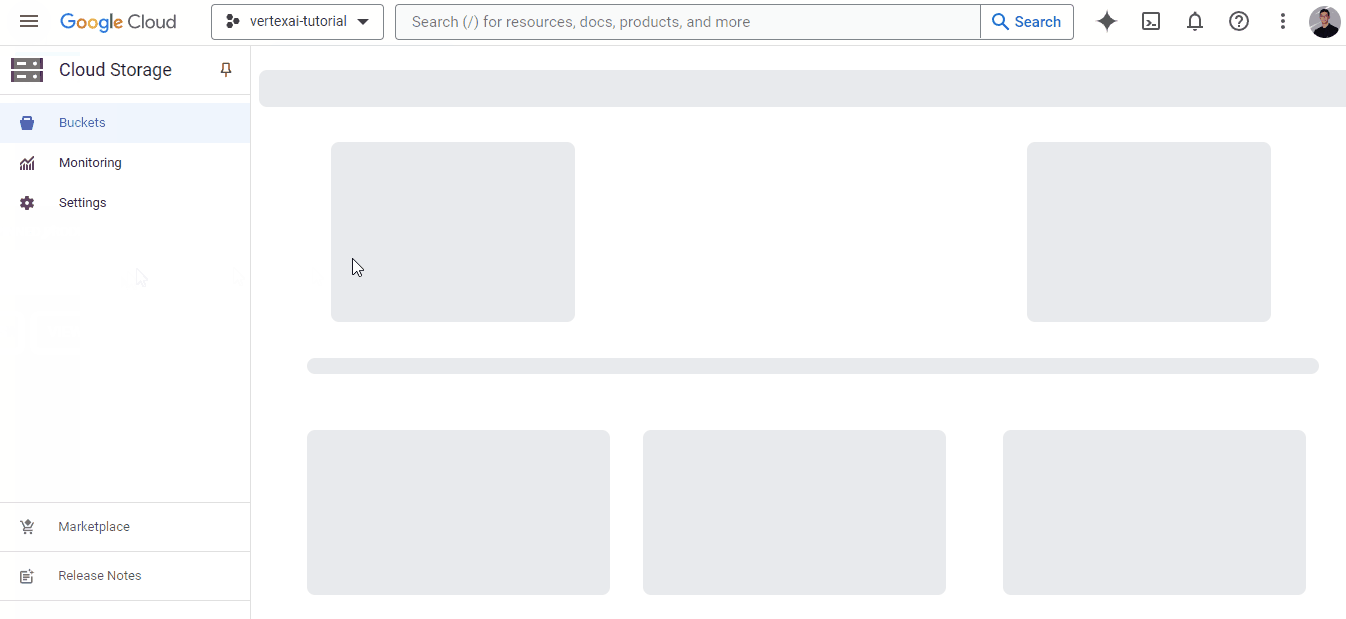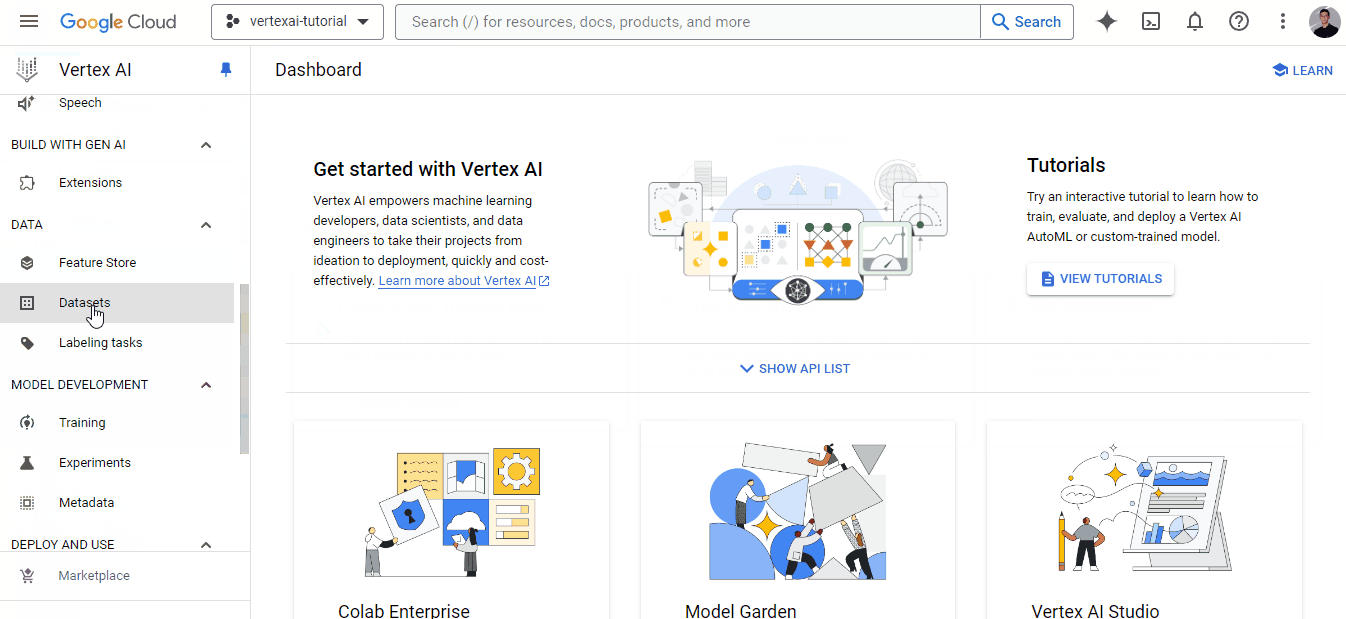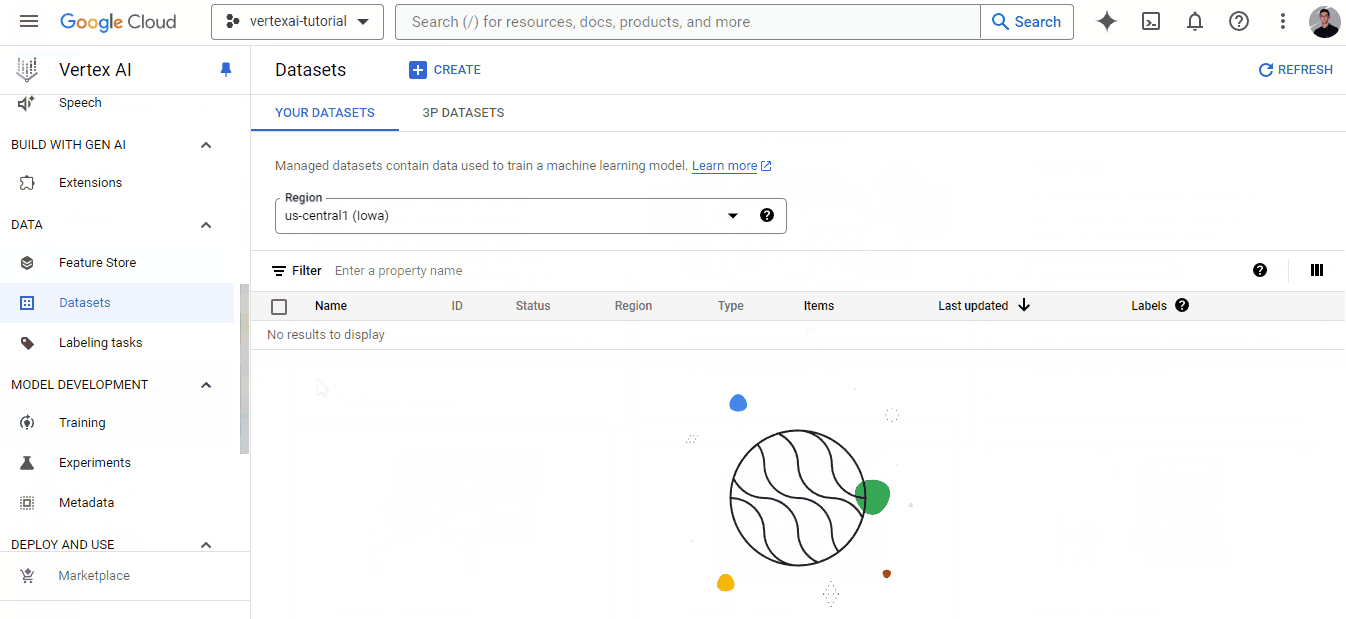
Wechsle zurück zu deinem Vertex-AI-Dashboard und öffne den Tab „Datasets“:
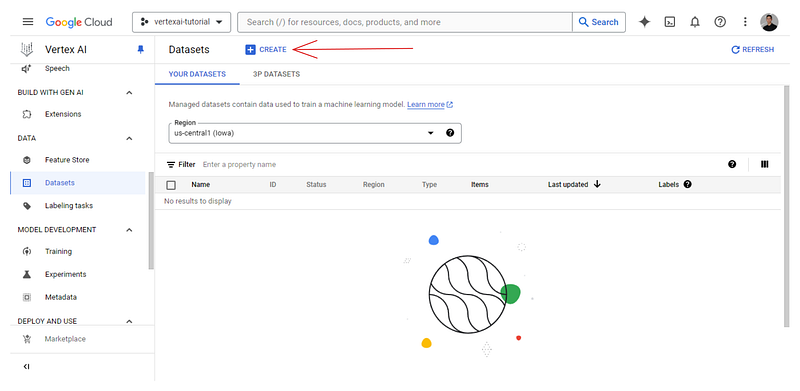
Er ist zunächst leer. Klicke auf „+Create“:
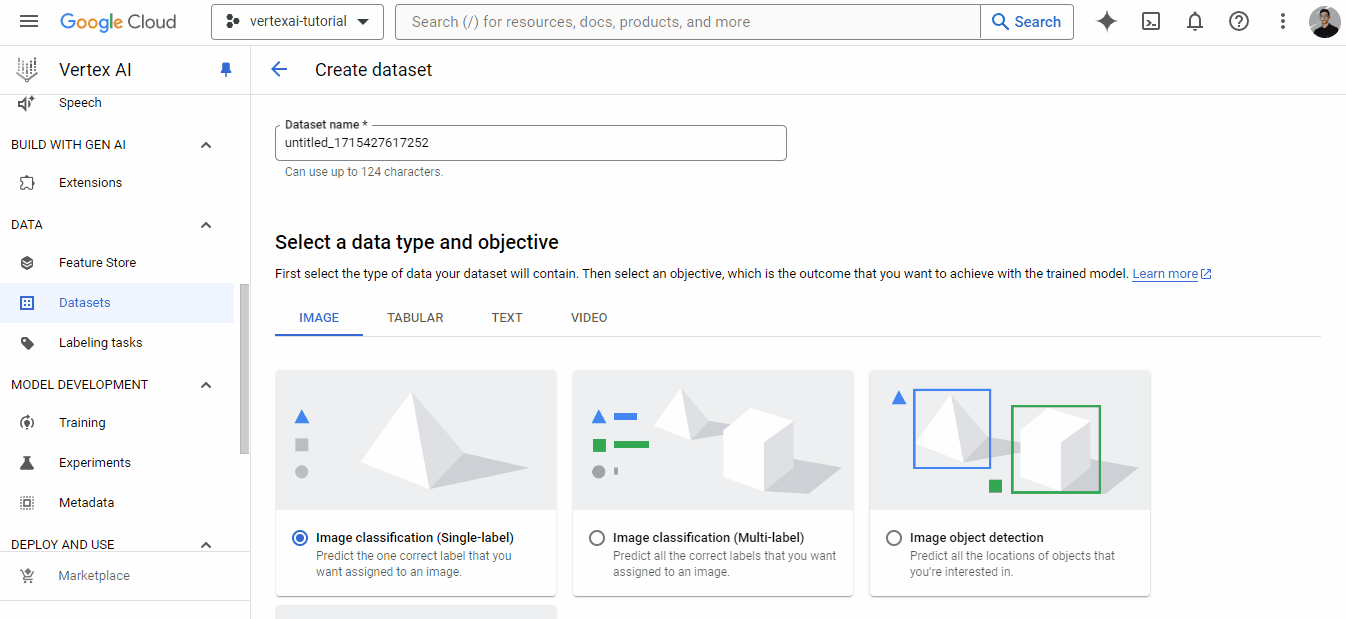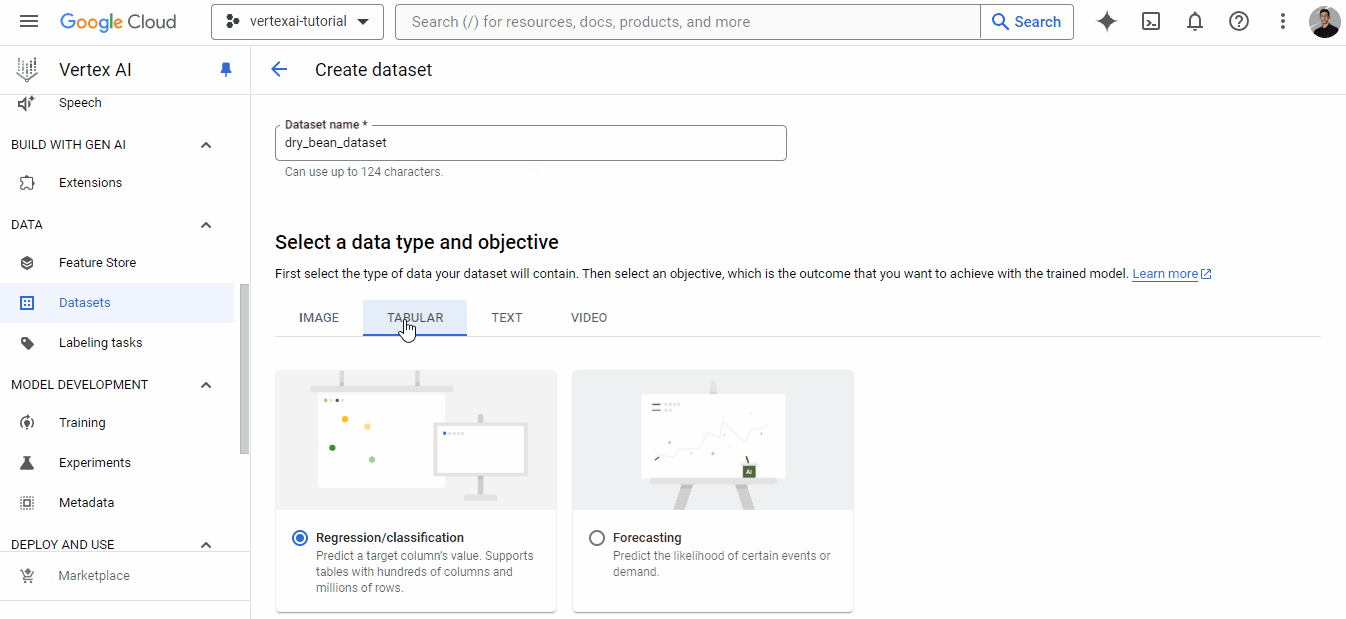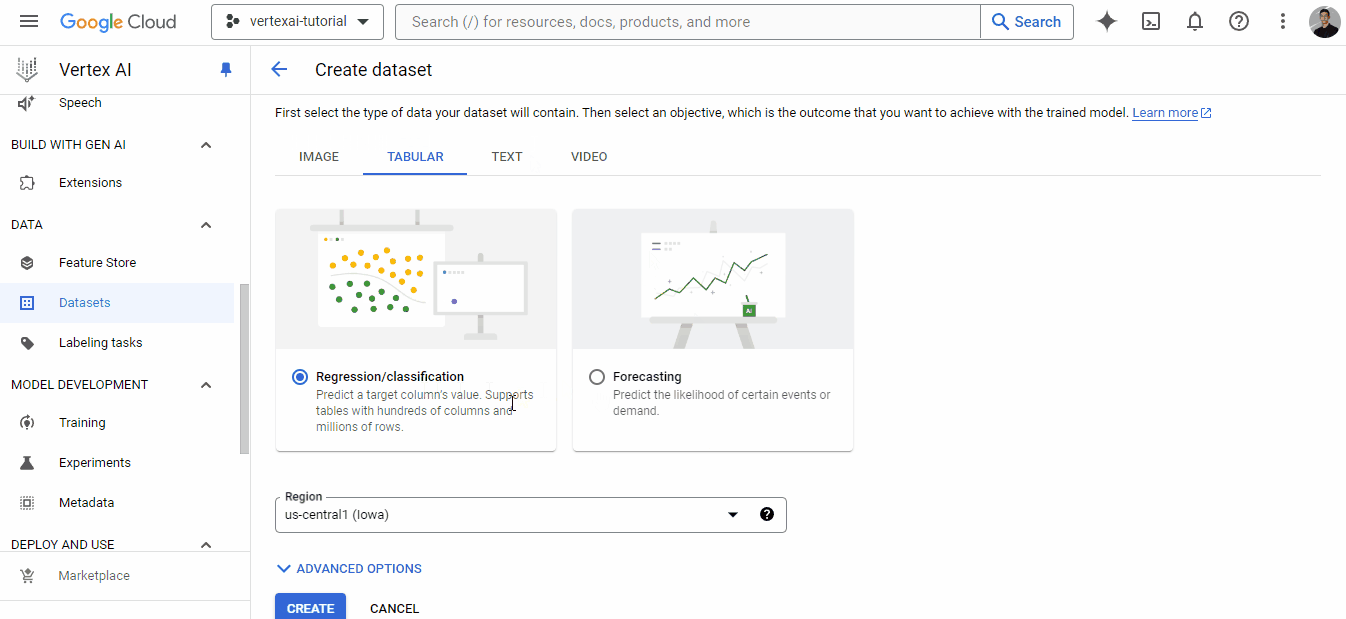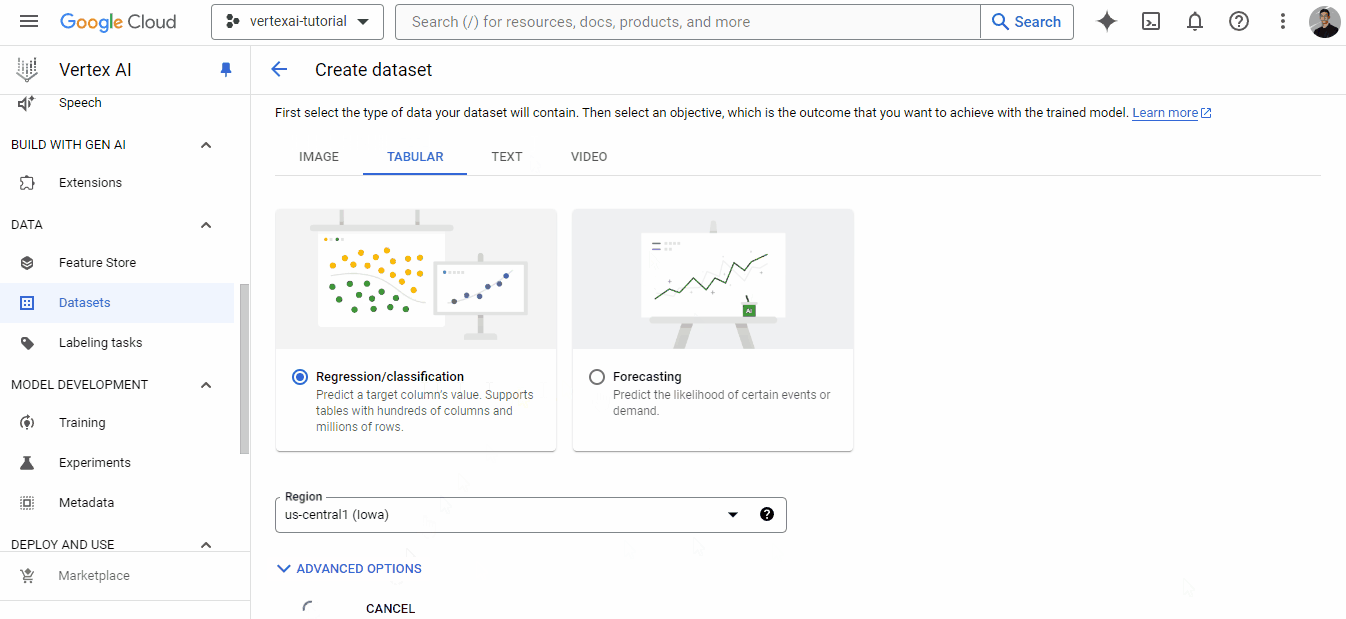
Gib dem Dataset einen eindeutigen Namen und wähle „Tabular“:
Anschließend zeigt dir die Plattform die Quelloptionen. Wähle den Upload einer lokalen CSV-Datei und gib beim Cloud-Storage-Pfad den eben erstellten Bucket an:
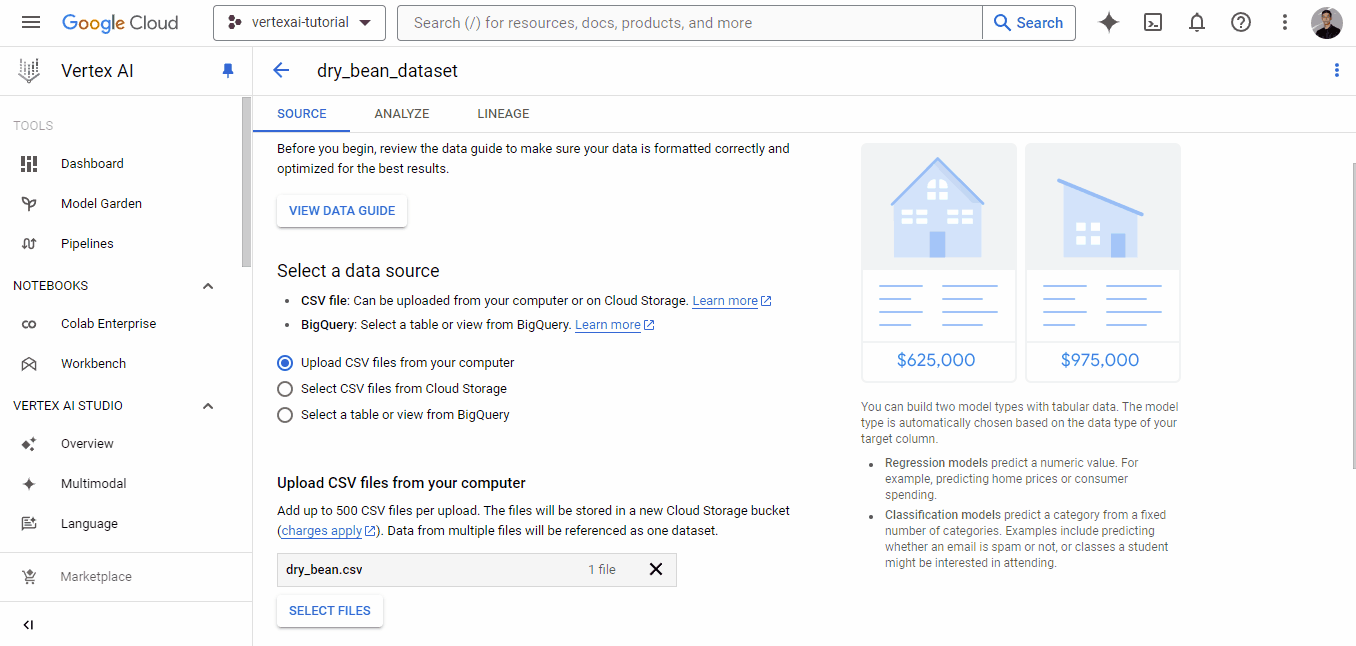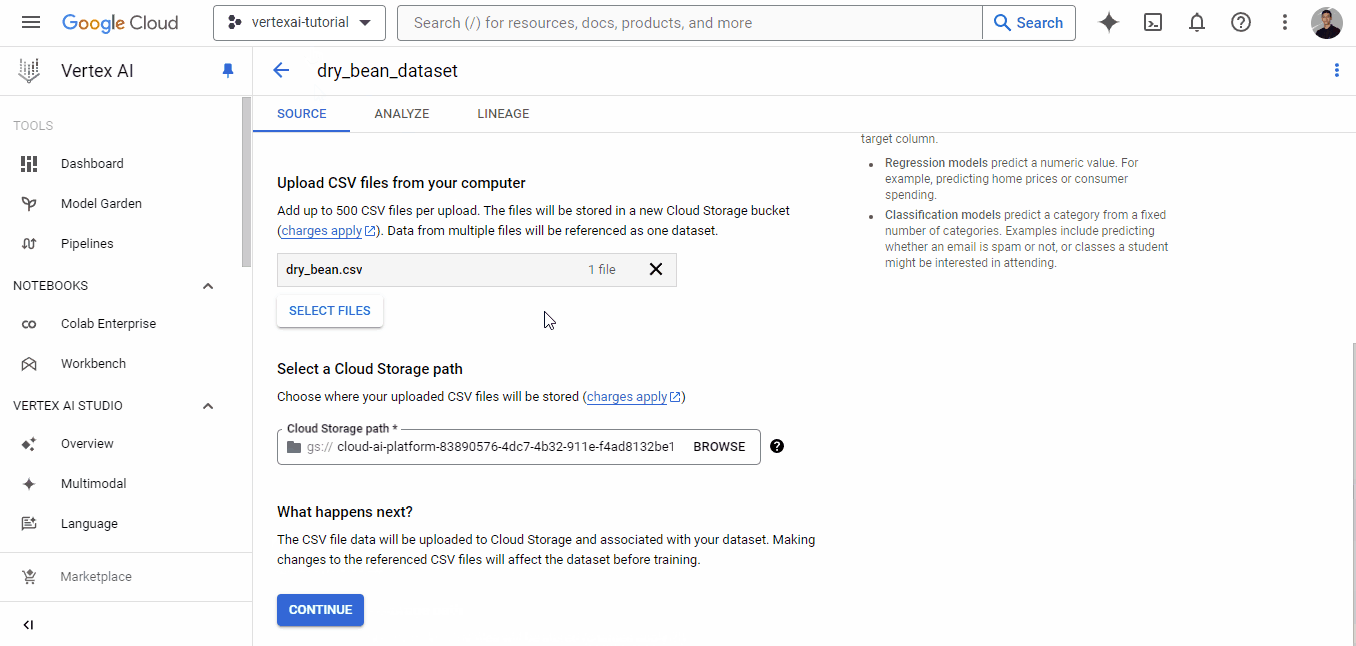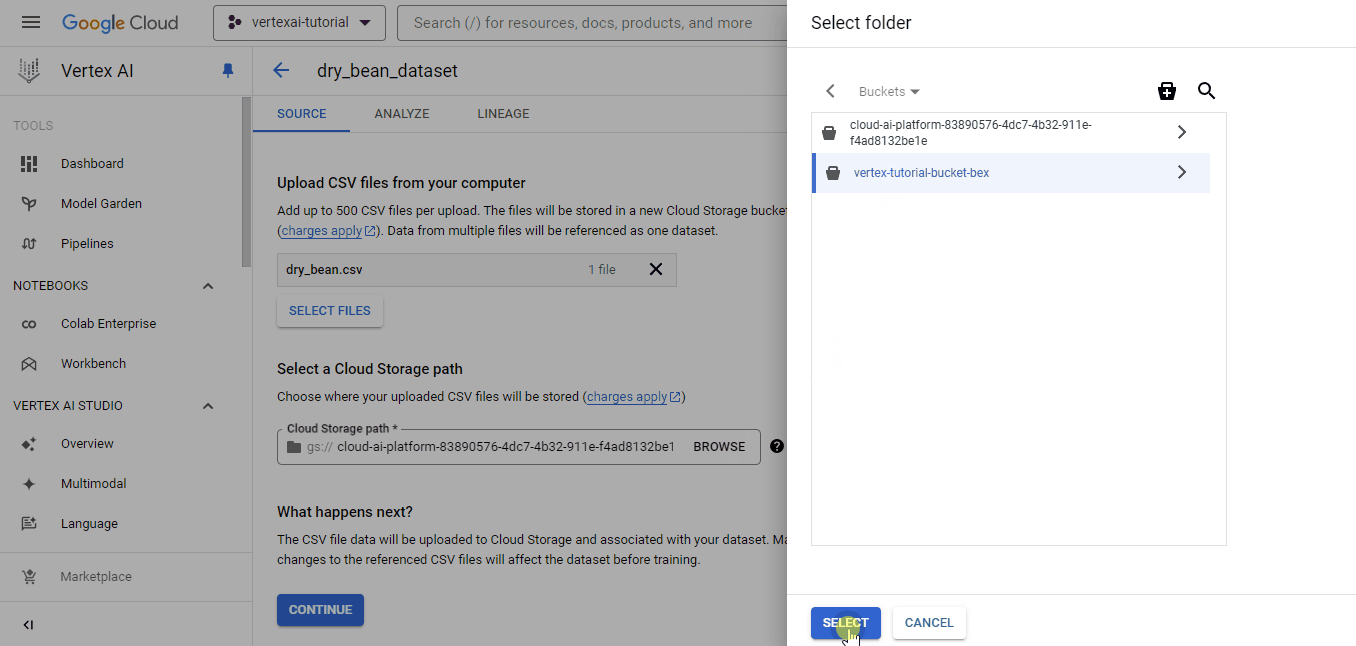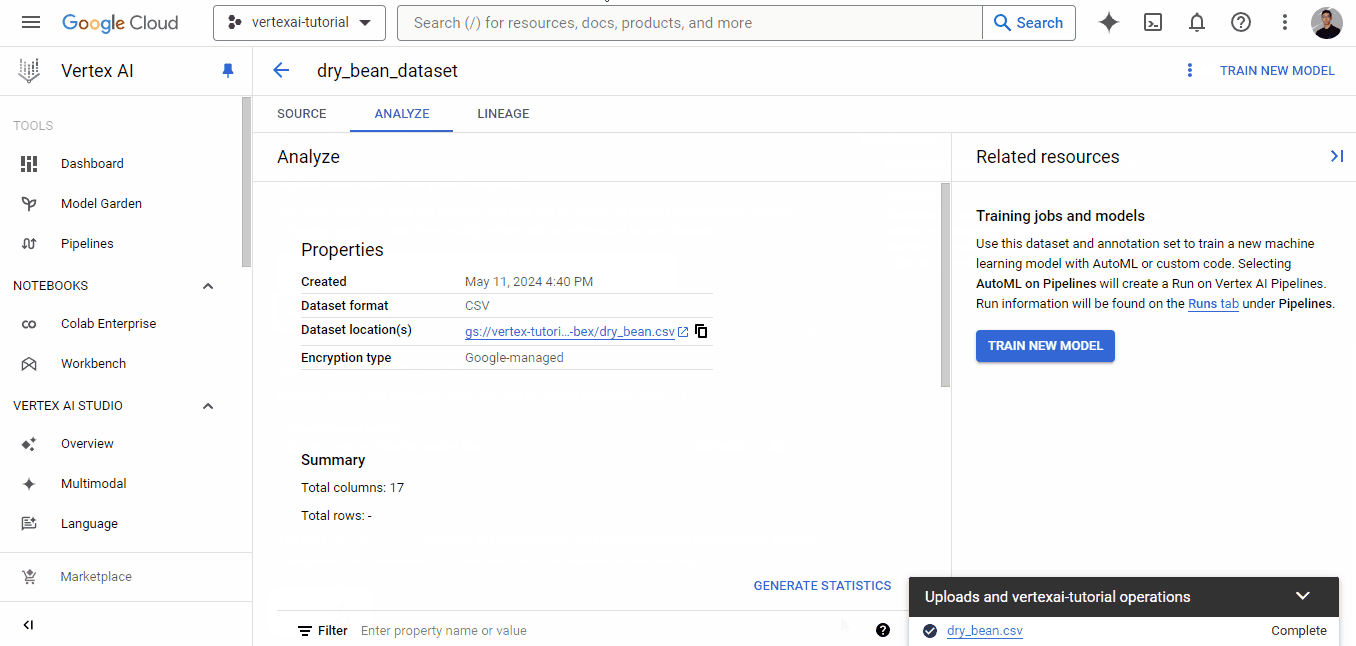
Sobald das Dataset erfolgreich hochgeladen ist, siehst du den Tab „Analyze“, der grundlegende Metadaten zur CSV anzeigt. Außerdem erscheint der Button „TRAIN NEW MODEL“, der einen AutoML-Trainingsjob startet.
Diesen Button nutzen wir allerdings nicht, denn er ist für absolute ML-Einsteiger gedacht. Stattdessen verwenden wir Vertex AI Workbench, um eine JupyterLab-Umgebung und Rechenressourcen zu konfigurieren und damit sowohl AutoML als auch eigene Bibliotheken auszuführen.
Da Vertex AI eine einheitliche Plattform ist, bietet sie auch Entwicklungsumgebungen, sogenannte Workbenches. Um eine Workbench zu erstellen, gehe zu ihrem Tab und folge den Anweisungen im GIF:
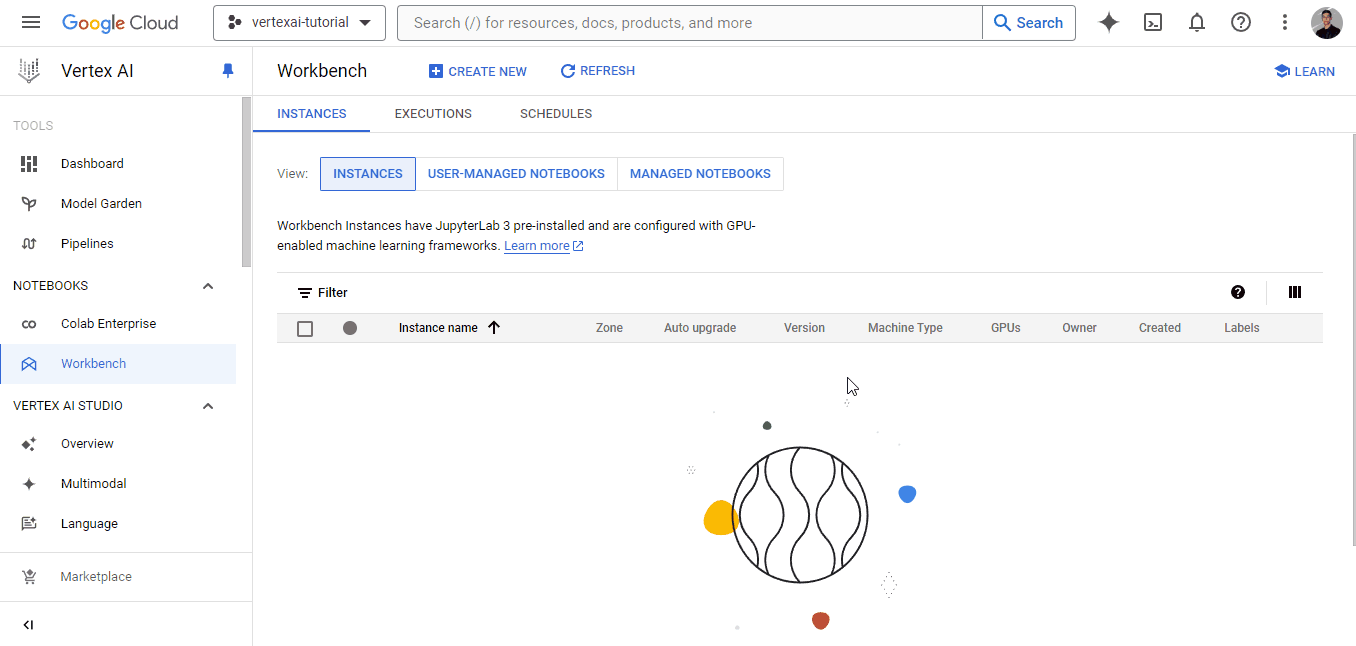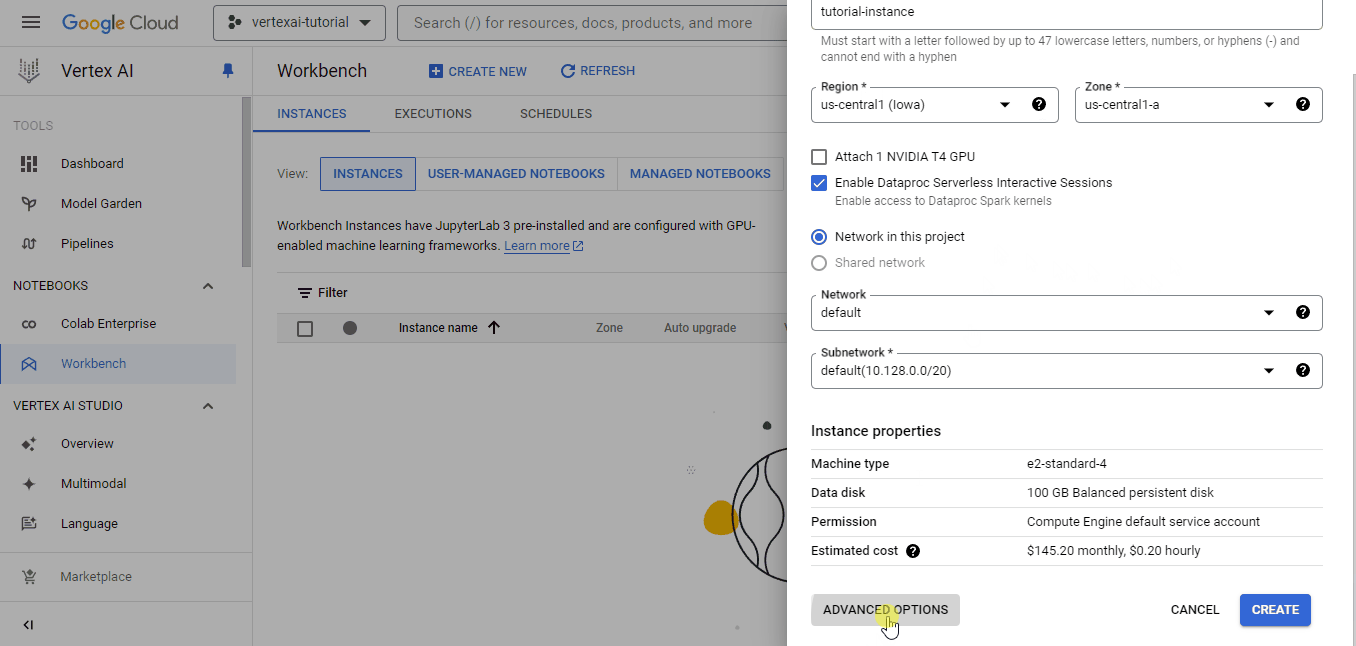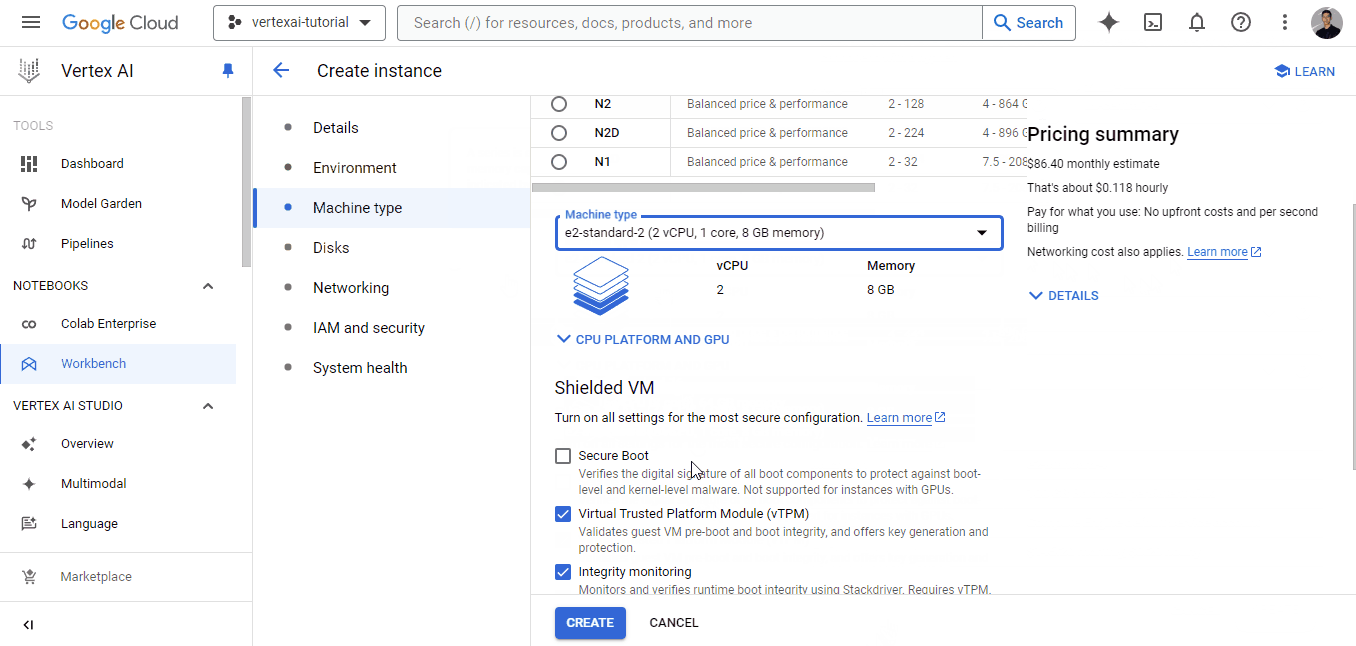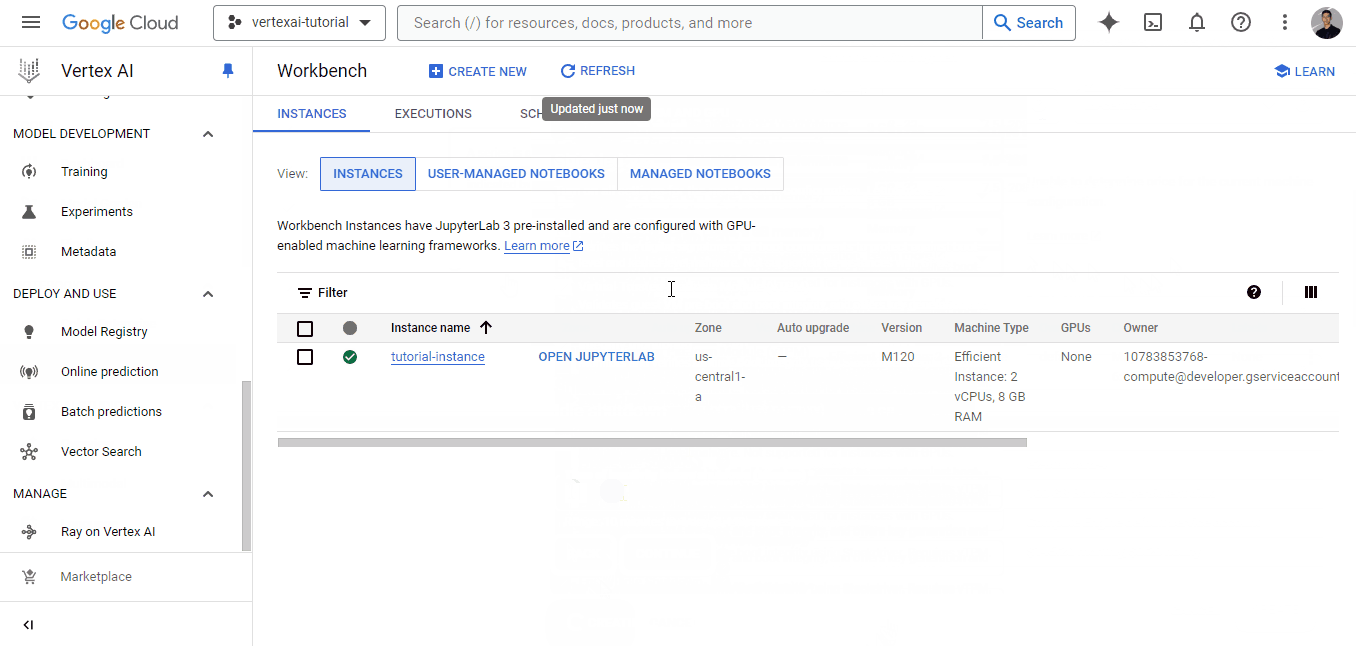
Jede Workbench wird mit JupyterLab 3 vorinstalliert ausgeliefert. Du musst also nur die Hardware-Optionen nach Budget und Bedarf konfigurieren. Da unser Datensatz recht klein ist, habe ich für die Illustration die schwächste Instanz gewählt, die nur etwa 0,12 $ pro Stunde kostet (ich empfehle eine Maschine mit mehr CPU-Kernen, um Berechnungen zu beschleunigen).
Ich habe außerdem das Leerlauf-Timeout auf 10 Minuten gesetzt, damit die Umgebung automatisch stoppt, falls ich vergesse, sie auszuschalten.
Die Workbench benötigt etwas Zeit zum Initialisieren. Sobald sie bereit ist, erscheint der Button „OPEN JUPYTERLAB“, und du kannst darauf klicken:
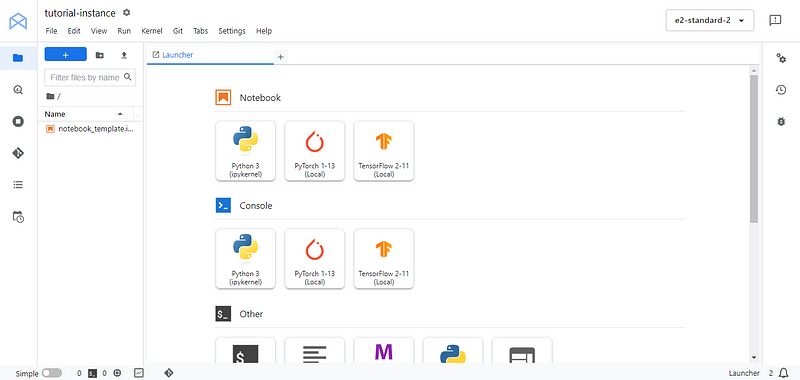
Du landest in der gewohnten JupyterLab-Oberfläche. Erstelle dort ein neues Python-3-Notebook und benenne es nach Belieben. Installiere bzw. aktualisiere in der ersten Zelle das Google-Cloud-Services-SDK google-cloud-aiplatform:
!pip3 install --upgrade --quiet google-cloud-aiplatform
Anschließend kannst du dir mit gcloud config list die unter deinem Konto verfügbaren Projekte anzeigen lassen:
!gcloud config list
[compute]
region = us-central1
[core]
account = # HIDDEN #
disable_usage_reporting = True
project = vertexai-tutorial-423010
[dataproc]
region = us-central1

Your active configuration is: [default]
gcloud und gsutil sind Terminal-Utilities, die in allen Workbenches verfügbar sind. Damit verwaltest du deine Google-Cloud-Services effizient.
Speichere die folgenden Informationen aus der Ausgabe als Python-Variablen:
PROJECT_ID = 'vertexai-tutorial-423010'
BUCKET_URI = 'gs://vetex-tutorial-bucket-bex'
REGION = 'us-central1'
Vergiss nicht, BUCKET_URI auf deinen eigenen Bucket-Namen zu ändern. Importiere dann das aiplatform-Submodul und initialisiere es:
from google.cloud import aiplatform as ai

ai.init(project=PROJECT_ID, location=REGION, staging_bucket=BUCKET_URI)
aiplatform dient als SDK, um mit Vertex-AI-Funktionen zu interagieren.
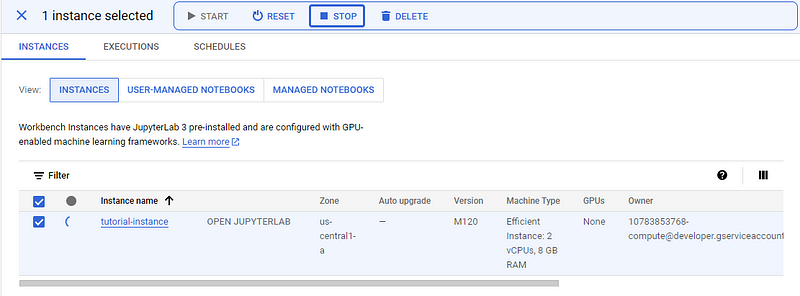
Wenn du mit dem Tutorial fertig bist oder eine Pause machst, vergiss nicht, die Instanz zu STOPPEN, um unnötige Kosten zu vermeiden.
Lass uns jetzt ein Modell mit AutoML trainieren. Wie bereits erwähnt, übernimmt AutoML die Schwerarbeit und liefert das beste Modell zurück, das für den gegebenen Datensatz trainiert werden konnte. Damit AutoML sein volles Potenzial entfalten kann, musst du sicherstellen, dass dein Datensatz möglichst hochwertig ist. Es lohnt sich also, vorher Features zu entwickeln und Vorverarbeitungsschritte durchzuführen.
AutoML verarbeitet den Datensatz intern vor, kann aber nicht alle Probleme deiner Daten beheben.
In diesem Abschnitt trainieren wir zur Vereinfachung jedoch nur ein Baseline-AutoML-Modell ohne Vorverarbeitung oder Feature Engineering.
Als Erstes laden wir die CSV aus unserem Bucket und schauen sie uns kurz an. Denk daran: EDA ist ein wichtiger Schritt – mehr dazu im Exploratory Data Analysis in Python Kurs!
import pandas as pd

# Path to your CSV file in GCS bucket
gcs_path = "gs://vertex-tutorial-bucket-bex/dry_bean.csv"

beans = pd.read_csv(gcs_path)

beans.head()

Gute Nachricht: pandas kann Dateien direkt von GCS-Pfaden laden. Der Haken ist, dass der obige Code nur in Vertex-AI-Workbenches funktioniert, da diese bereits mit deinen Google-Cloud-Anmeldedaten authentifiziert sind.
Wir führen keine Tiefenanalyse durch, um nicht vom Thema abzulenken. Wir begnügen uns mit ein paar zusammenfassenden Statistiken und Charts:
beans.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 13611 entries, 0 to 13610
Data columns (total 17 columns):
#   Column           Non-Null Count  Dtype
---  ------           --------------  -----
0   Area             13611 non-null  int64
1   Perimeter        13611 non-null  float64
2   MajorAxisLength  13611 non-null  float64
3   MinorAxisLength  13611 non-null  float64
4   AspectRation     13611 non-null  float64
5   Eccentricity     13611 non-null  float64
6   ConvexArea       13611 non-null  int64
7   EquivDiameter    13611 non-null  float64
8   Extent           13611 non-null  float64
9   Solidity         13611 non-null  float64
10  roundness        13611 non-null  float64
11  Compactness      13611 non-null  float64
12  ShapeFactor1     13611 non-null  float64
13  ShapeFactor2     13611 non-null  float64
14  ShapeFactor3     13611 non-null  float64
15  ShapeFactor4     13611 non-null  float64
16  Class            13611 non-null  object
dtypes: float64(14), int64(2), object(1)
memory usage: 1.8+ MB
Wir haben also 15 numerische Features und eine Zielspalte — Class. Es gibt nur rund 13.000 Zeilen und keine fehlenden Werte. Das vereinfacht das Training erheblich.
Speichern wir die Feature-Namen in einer separaten Liste, falls wir sie später benötigen:
feature_names = beans.columns.tolist()
Erstellen wir nun ein Pairplot einiger wichtiger Features:
import seaborn as sns

sns.pairplot(
   beans,
   vars=["Area", "MajorAxisLength", "MinorAxisLength", "Eccentricity", "roundness"],
   hue="Class",
);
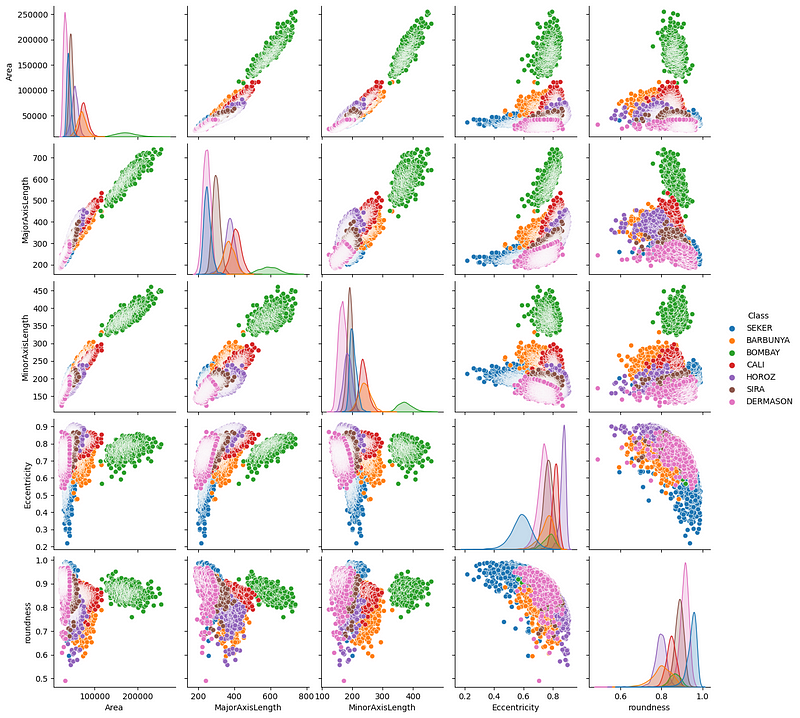
Wir sehen ein paar interessante Muster — vor allem scheinen Bombay-Bohnen (grün) anhand ihrer physikalischen Messwerte klar von den anderen getrennt zu sein.
Lass uns außerdem eine Korrelationsmatrix plotten:
import matplotlib.pyplot as plt

correlation = beans.corr(numeric_only=True)

# Create a square heatmap with center at 0
sns.heatmap(correlation, center=0, square=True, cmap="coolwarm", vmin=-1, vmax=1)

plt.show()
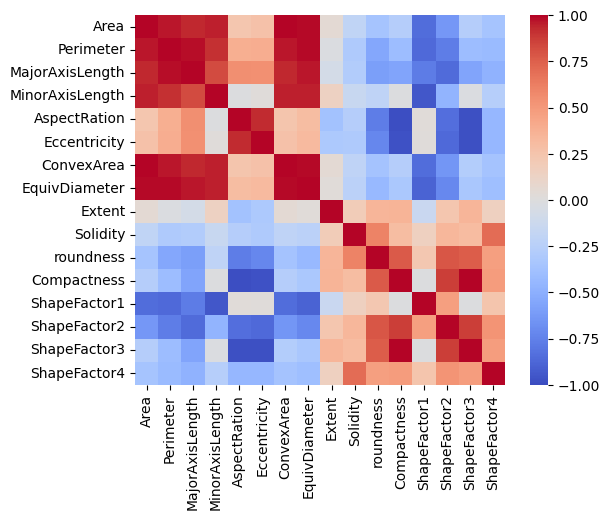
Einige Features sind fast perfekt korreliert, was Sinn ergibt, da sie physikalische Messgrößen beschreiben. Es gibt jedoch auch Paare mit keiner oder sehr geringer Korrelation.
An diesem Punkt überlasse ich dir die weitere Exploration und die Formulierung spannender Fragen an den Datensatz.
Um einen AutoML-Trainingsjob zu starten, benötigen wir zunächst ein damit kompatibles Dataset-Objekt:
ds = ai.TabularDataset.create(
   display_name="dry_bean_dataset", gcs_source=gcs_path
)
TabularDataset created.
type(ds)google.cloud.aiplatform.datasets.tabular_dataset.TabularDataset
ds.resource_name
'projects/10783853768/locations/us-central1/datasets/4978116960081412096'
Wir nutzen die Methode TabularDataset.create, um es als ds zu initialisieren. Vertex AI weist ihm einen eigenen Namen zu, den du über das Attribut resource_name abrufen kannst.
Jetzt initialisieren wir den Job mit der Klasse ai.AutoMLTabularTrainingJob. Sie benötigt zwei Argumente:
job = ai.AutoMLTabularTrainingJob(
   display_name="dry-bean-classification",
   optimization_prediction_type="classification",
)
Als Nächstes rufen wir die run-Methode des Jobs auf:
model = job.run(
   dataset=ds,
   target_column="Class",
   training_fraction_split=0.8,
   validation_fraction_split=0.1,
   test_fraction_split=0.1,
   model_display_name="baseline-classification-model",
   disable_early_stopping=False,
)
Die Parameter sind weitgehend selbsterklärend. Die Ausführung dauert eine Weile – je nach Rechenleistung.
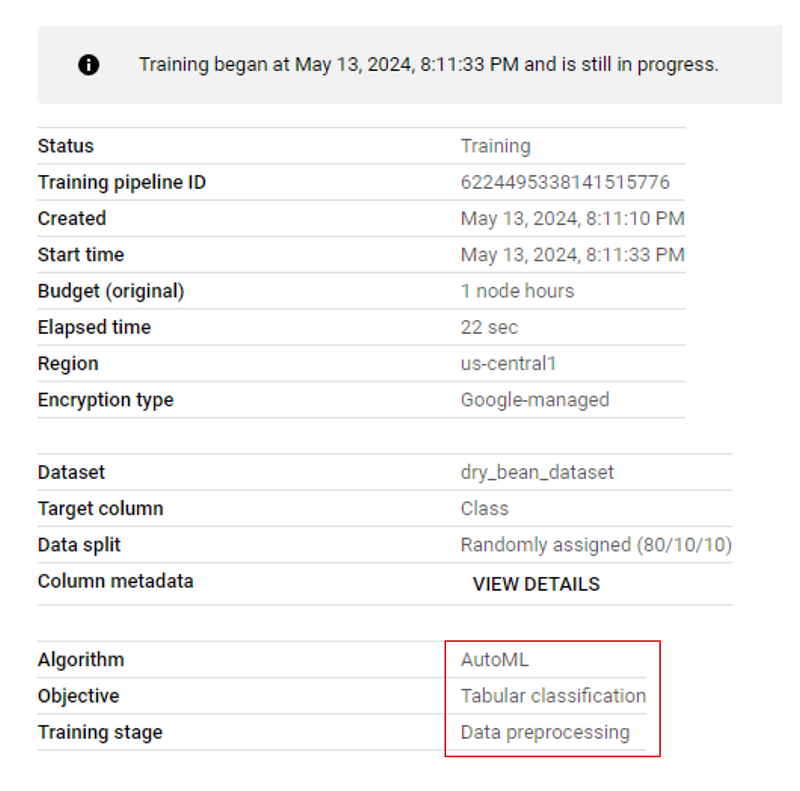
Wenn du im Dashboard den Tab „MODEL DEVELOPMENT > TRAINING“ öffnest und auf den Job-Namen klickst, siehst du den Live-Trainingsfortschritt. Das folgende Bild zeigt die Vorverarbeitungsphase:
Sobald das Training abgeschlossen ist, gehe erneut zum Trainings-Tab und klicke auf den Modellnamen. Jetzt werden Leistungsmetriken zum Modell angezeigt:
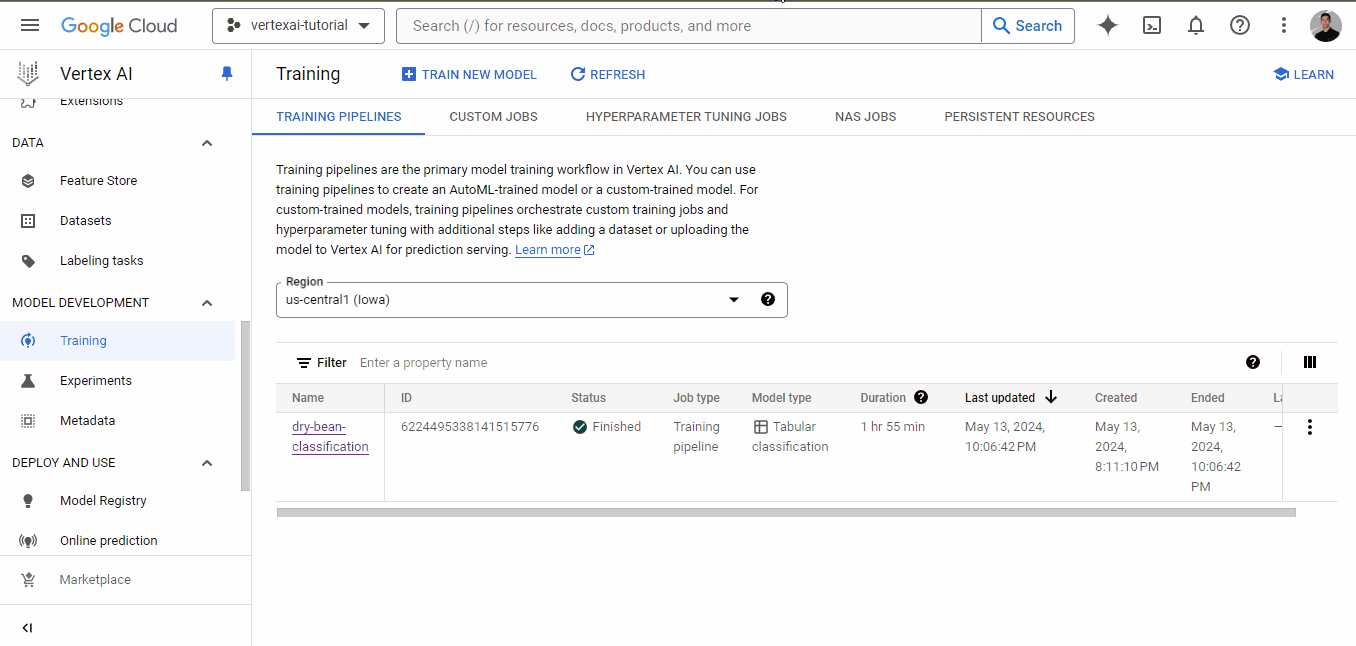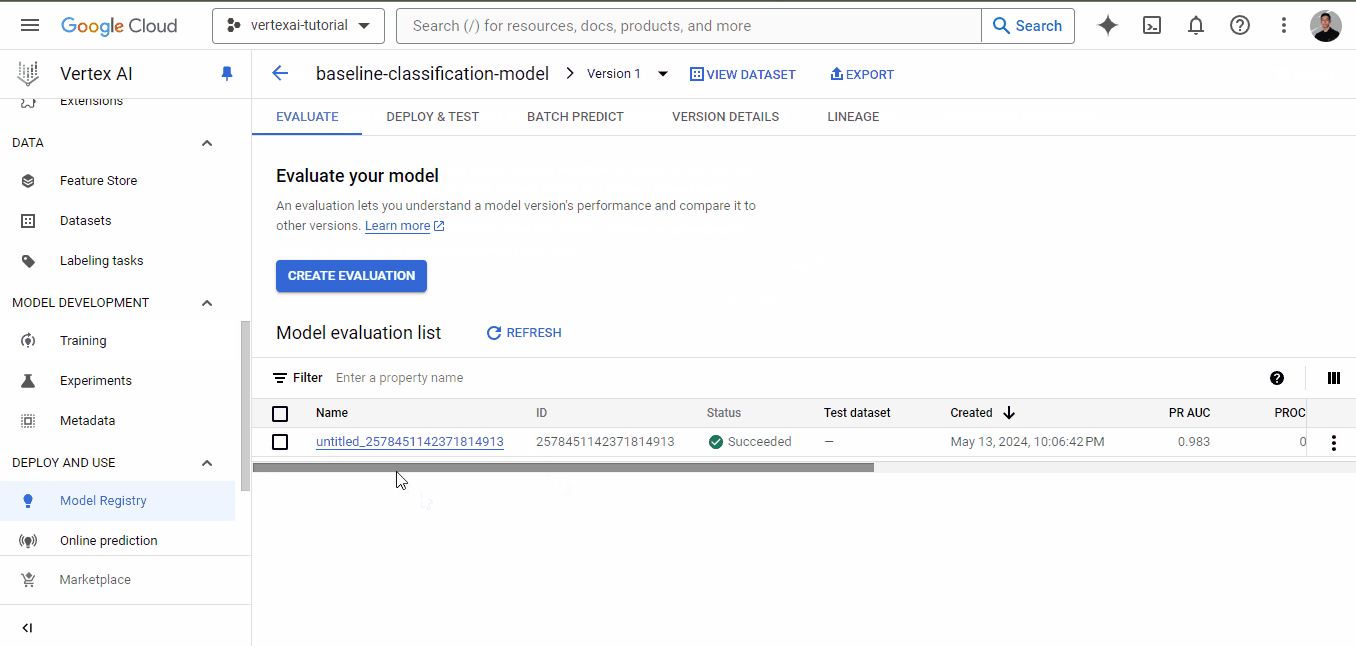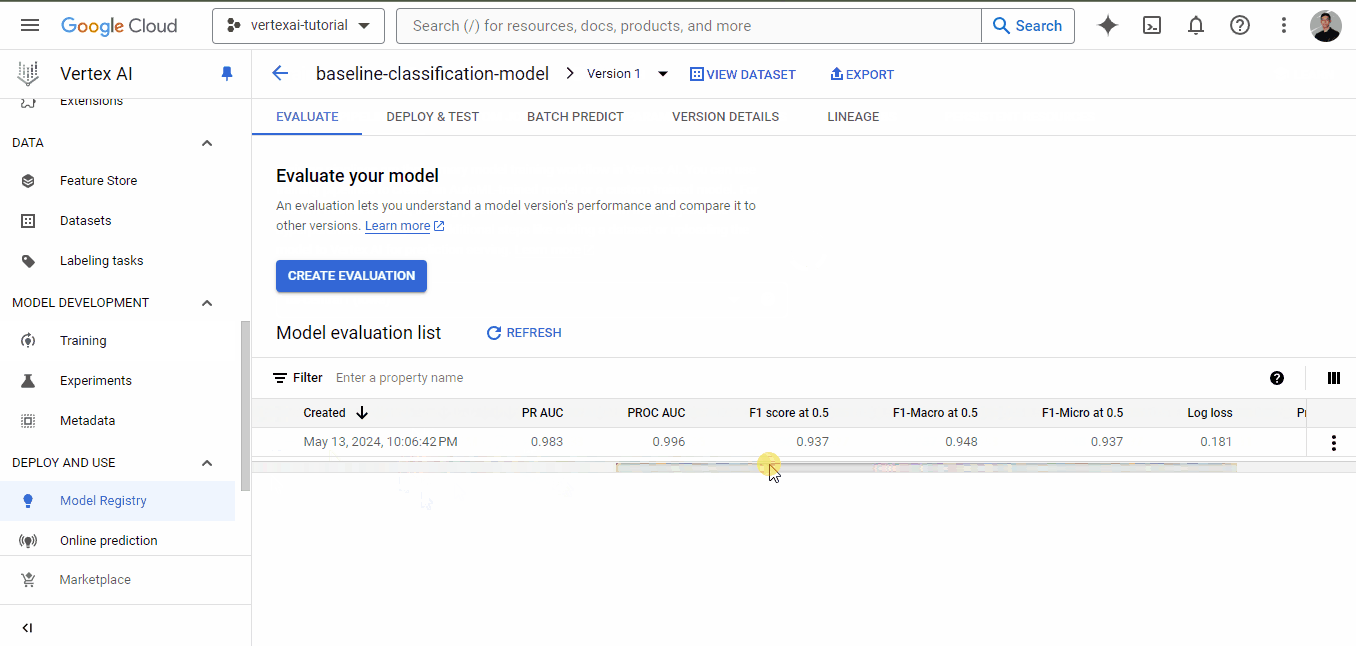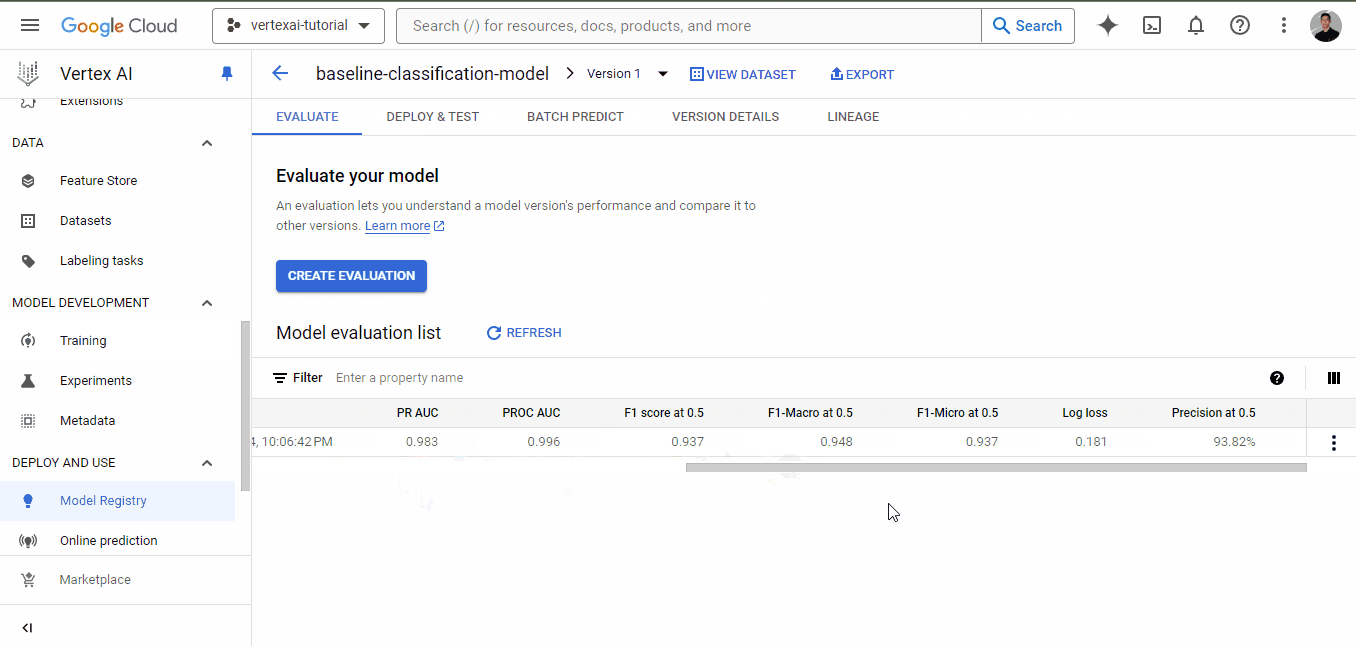
Wie du siehst, liefert selbst das Baseline-Modell sehr gute Kennzahlen – alle über 0,90.
Wir können dieses model mit einer einzigen Codezeile bereitstellen:
endpoint = model.deploy(machine_type="n1-standard-4")
Die Methode deploy benötigt nur ein Argument – den Maschinentyp für Inferenz. Ich führe die Zeile hier nicht aus, da für die Bereitstellung zusätzliche Kosten anfallen, solange das Modell online ist.
Wenn du sie ausführst, liefert deploy ein Endpoint-Objekt, an das wir Anfragen senden können:
prediction = endpoint.predict(
   [
       {
           "Area": "30099",
           "Perimeter": "638.8209999999999",
           "MajorAxisLength": "237.14191130827916",
           "MinorAxisLength": "162.3034300714102",
           "AspectRation": "1.4611022774068396",
           "Eccentricity": "0.7290928631259719",
           "ConvexArea": "30477",
           "EquivDiameter": "195.76321681302556",
           "Extent": "0.8036043251902283",
           "Solidity": "0.9875972044492568",
           "roundness": "0.9268374259664279",
           "Compactness": "0.8255108332939839",
           "ShapeFactor1": "0.007878730566074592",
           "ShapeFactor2": "0.002256976927384019",
           "ShapeFactor3": "0.6814681358857279",
           "ShapeFactor4": "0.9956946453228307",
       }
   ]
)

print(prediction)
Es gibt eine predict-Methode, die eine Liste von Samples für Vorhersagen akzeptiert. Die Samples müssen im JSON-Format übergeben werden.
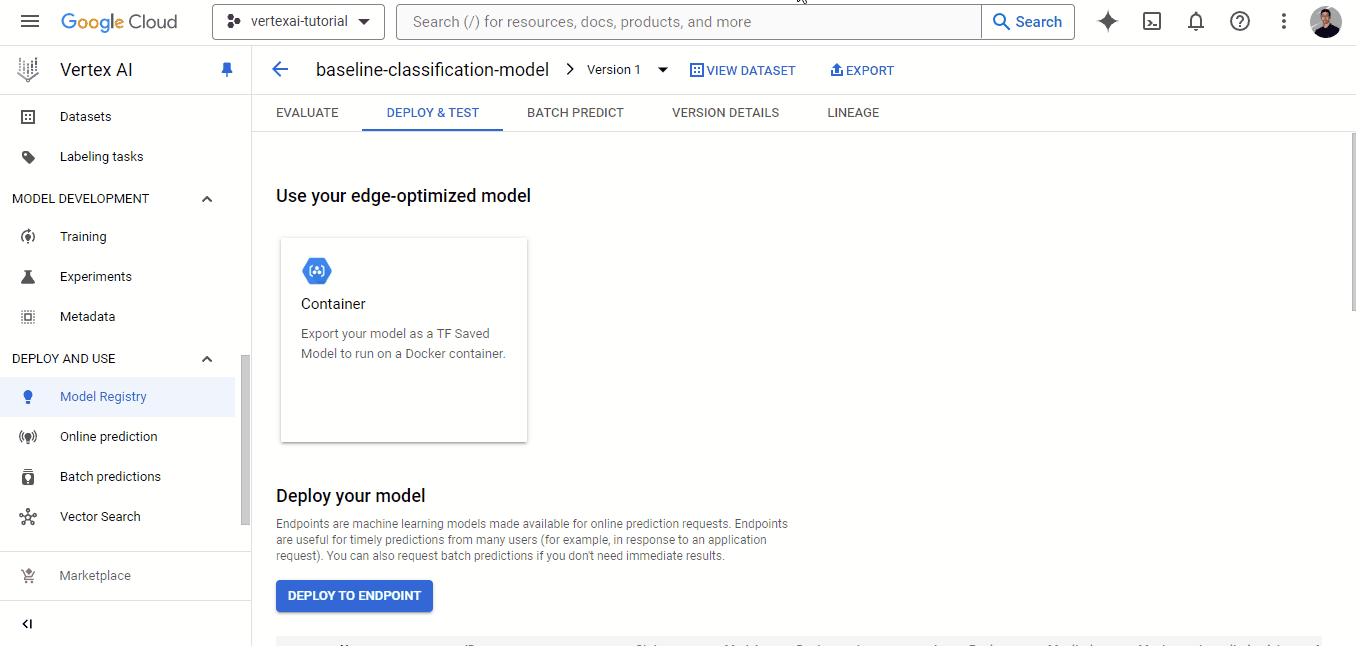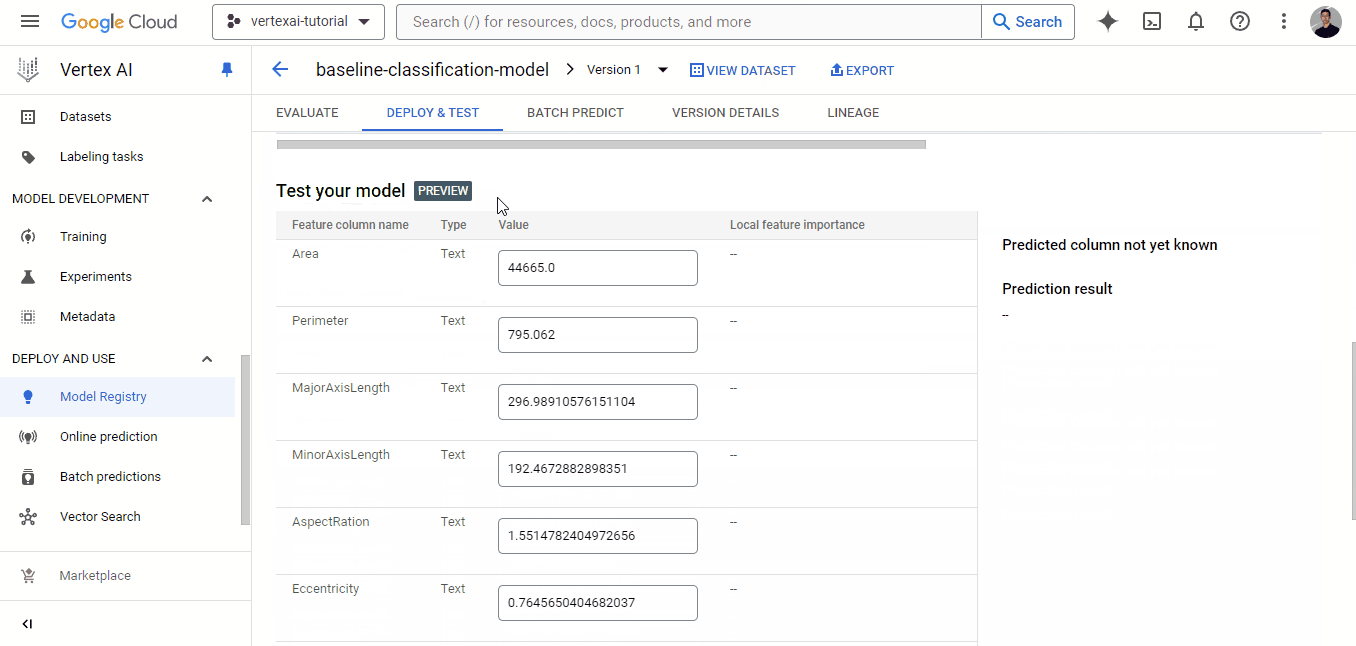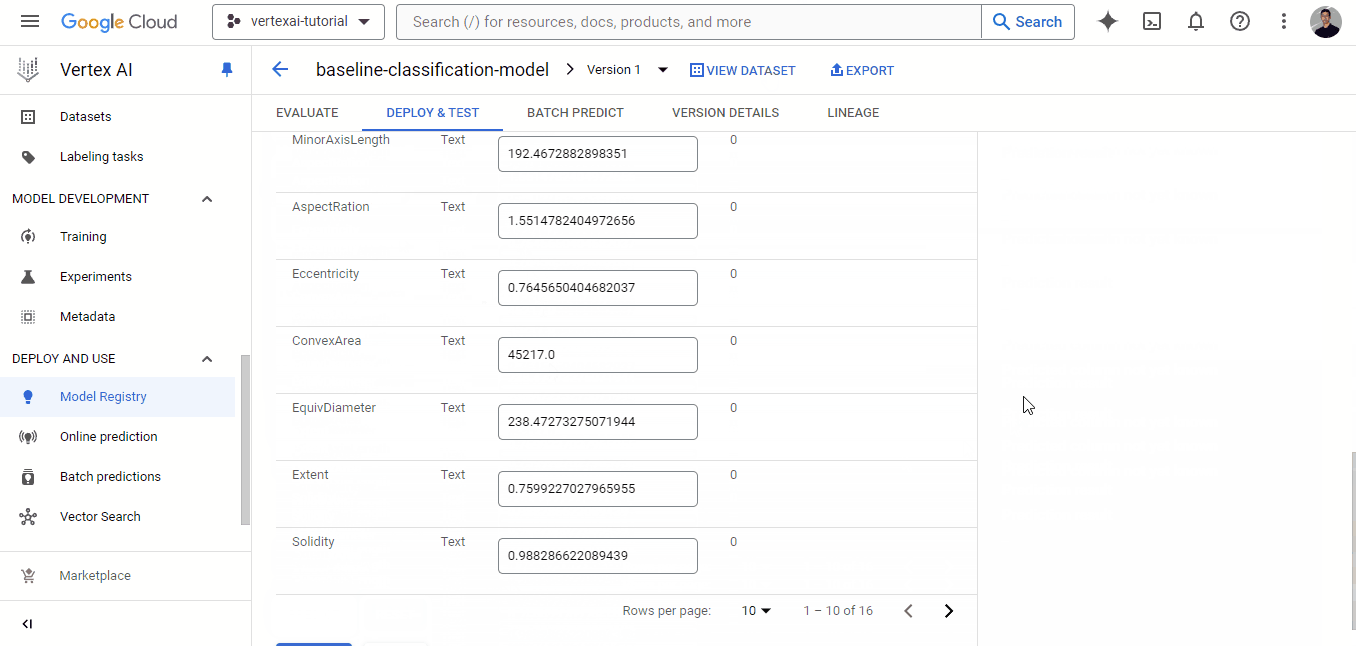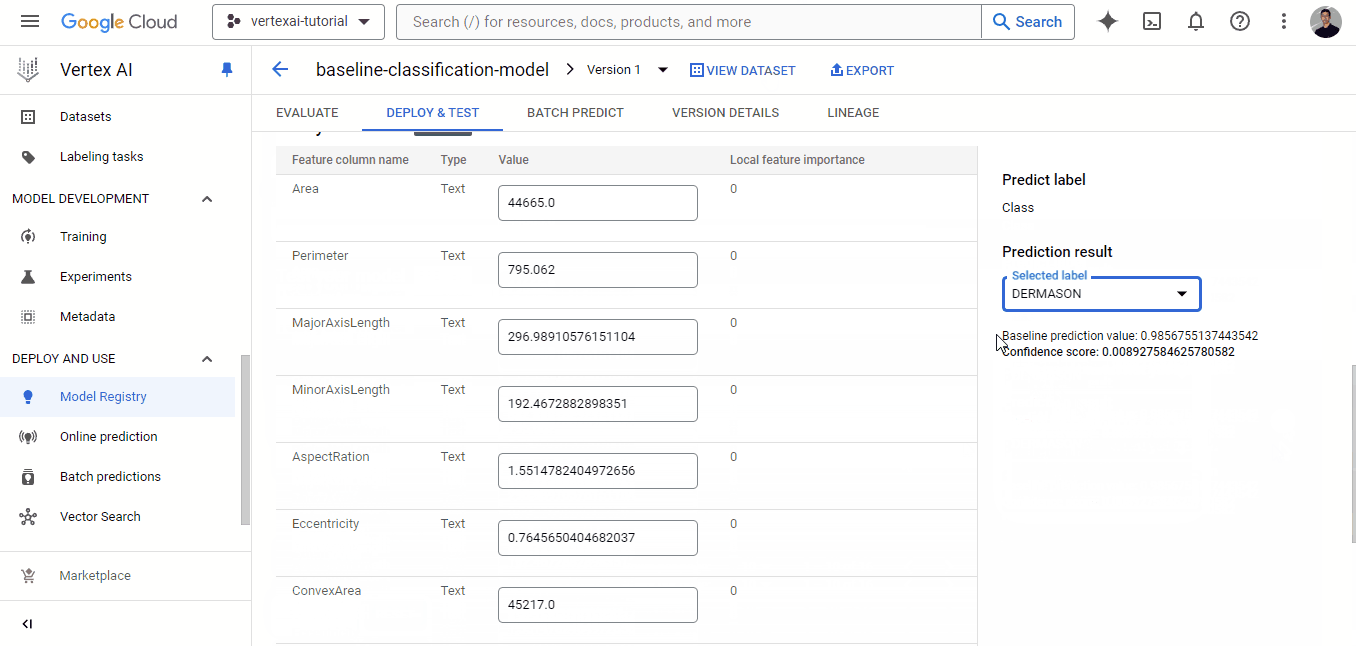
Du kannst Modelle auch über das Dashboard bereitstellen. Im Tab „MODEL REGISTRY“ findest du das Modell in der Liste. Klicke auf den Namen und wähle den Tab „DEPLOY & TEST“:
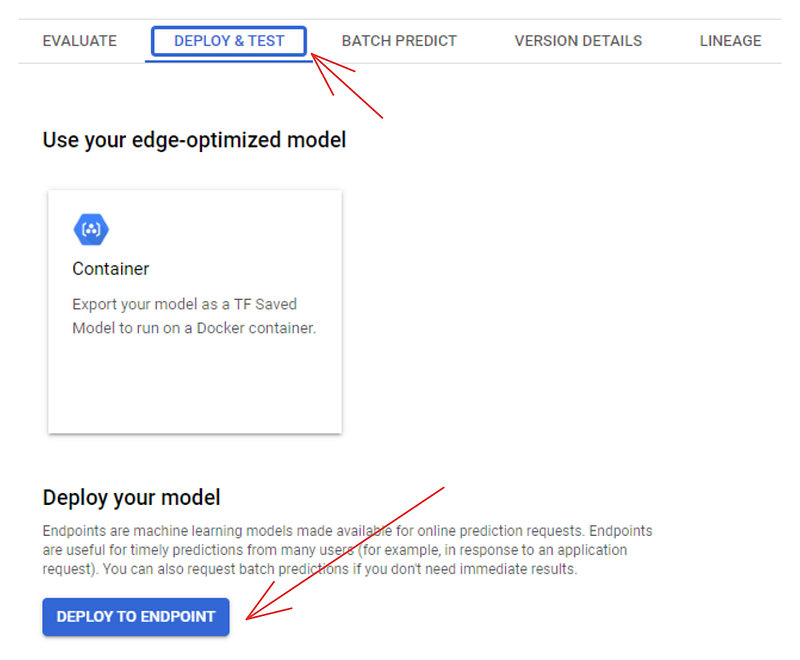
Ein Klick auf „DEPLOY TO ENDPOINT“ führt dich auf eine Seite, auf der du die Maschine für die Bereitstellung deines Modells konfigurieren kannst. Bevor du das tust, kannst du es im Bereich unterhalb des Deploy-Buttons testen:
Die Bereitstellung individueller Modelle in Vertex AI ist anspruchsvoller als bei AutoML und auch teurer, da zusätzlich Docker-Container zum Einsatz kommen – zusätzlich zu Workbench- und Bereitstellungskosten. Wenn du bereit bist, legen wir los!
Individualisiertes Training beginnt mit einem eigenen Trainingsskript. In diesem Skript kannst du alles tun, solange es Folgendes erfüllt:
Anschließend muss dieses Trainingsskript in einen Docker-Container gepackt und in die Google Container Registry gepusht werden. Von dort aus kannst du über das Vertex-AI-Python-SDK oder das Dashboard das Custom-Training starten.
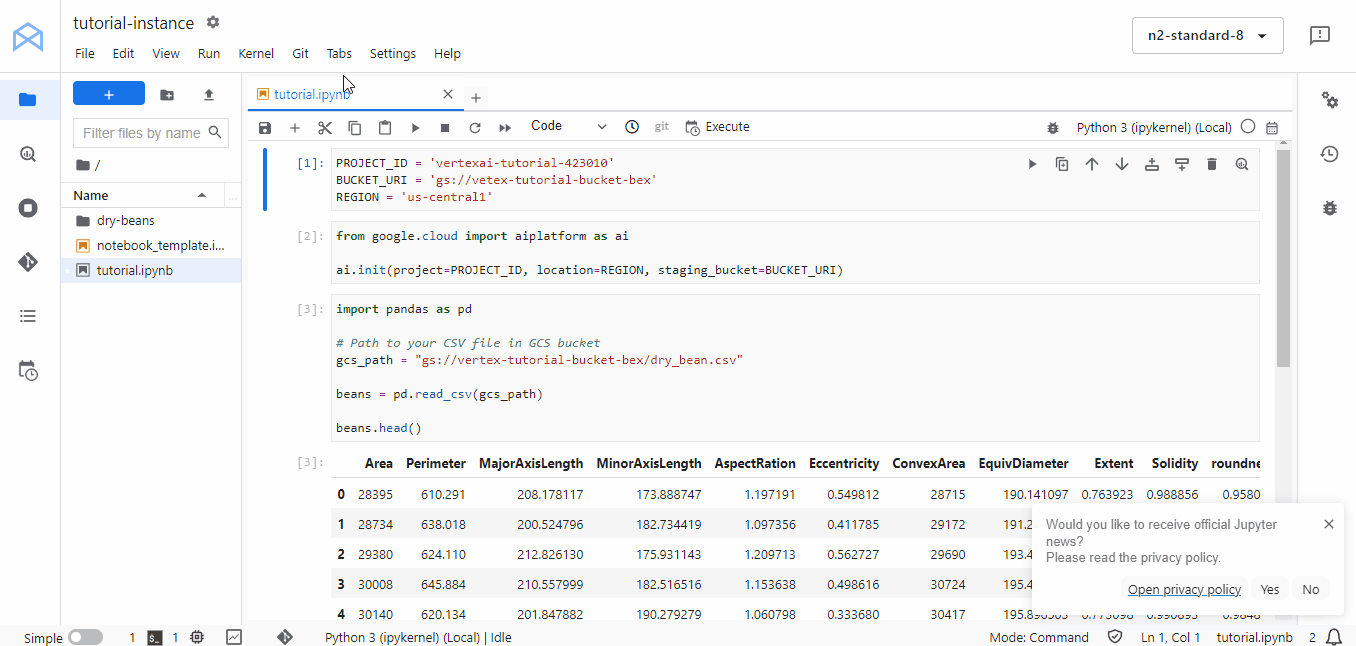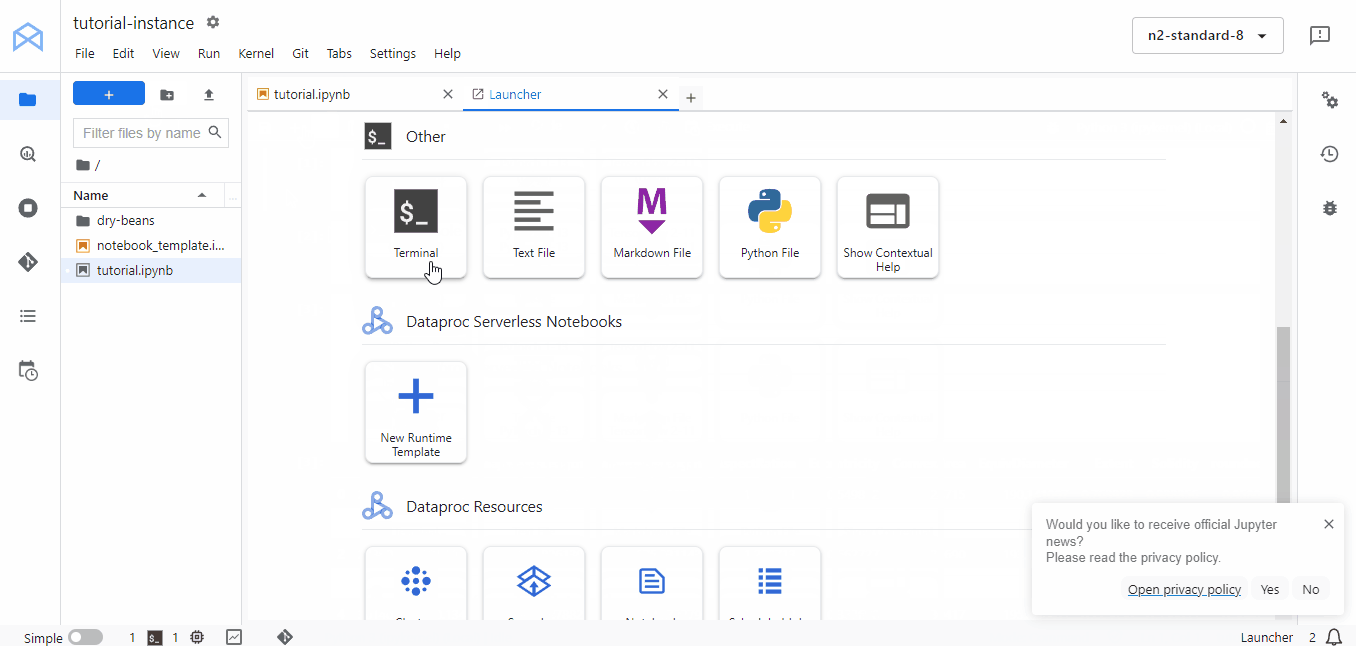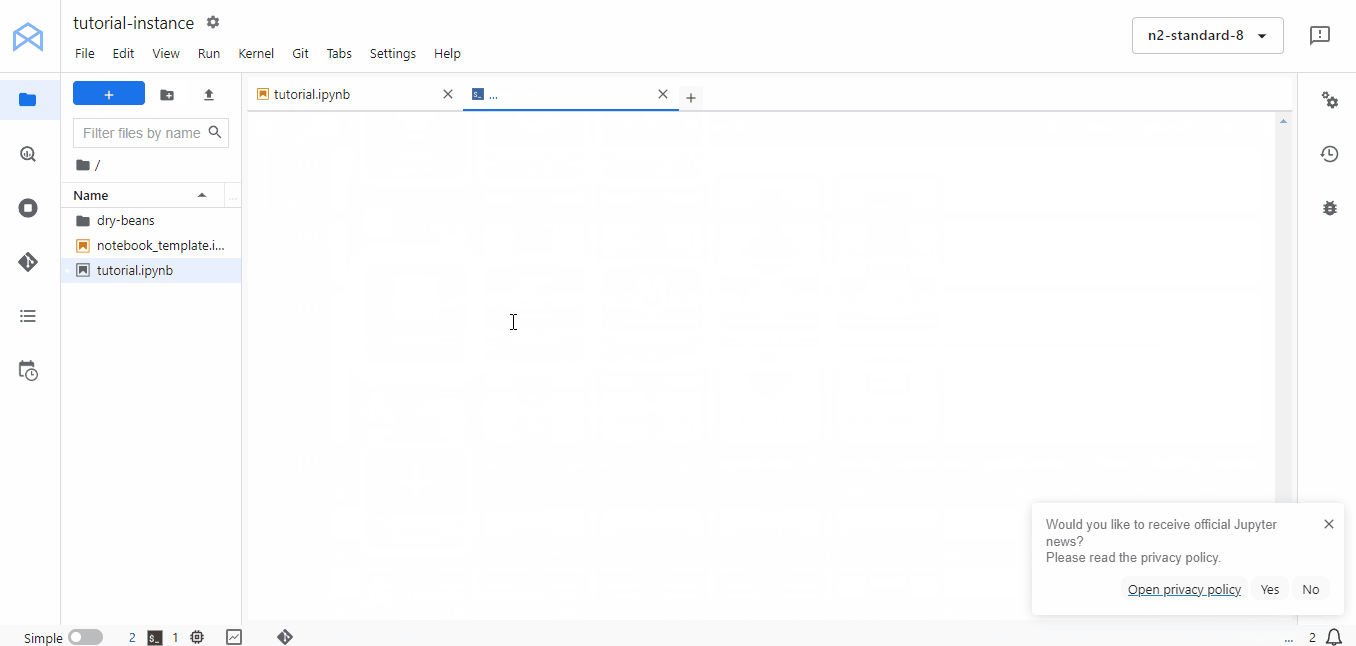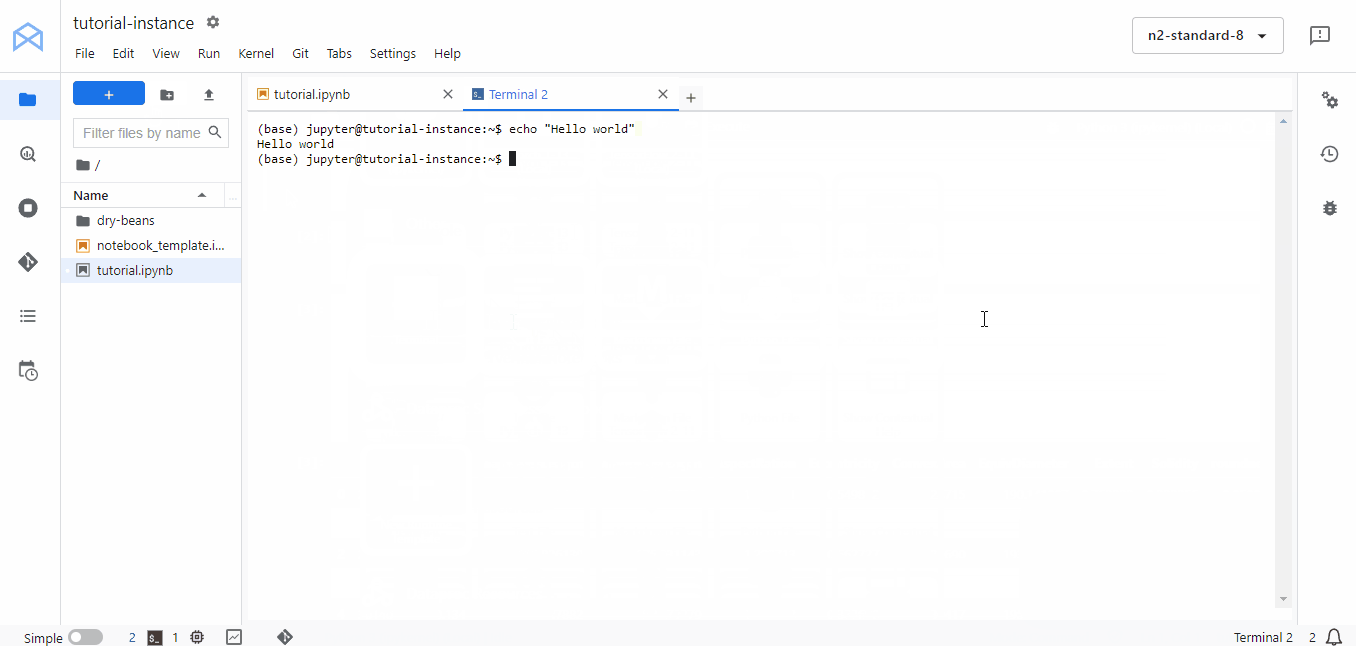
Lass uns zunächst die Verzeichnisstruktur wie in diesem Google Codelab empfohlen anlegen. Wechsle in deiner Workbench über einen neuen Launcher ins Terminal:
Erstelle dann ein neues Verzeichnis „dry-beans“ und wechsle hinein:
$ mkdir dry-beans
$ cd dry-beans/
Lege innerhalb von dry-beans ein weiteres Verzeichnis trainer und darin die Python-Datei train.py an:
$ mkdir trainer
$ touch trainer/train.py
Erstelle als Nächstes eine neue Dockerfile:
$ touch Dockerfile
Öffne die Datei und füge folgenden Inhalt ein:
FROM gcr.io/deeplearning-platform-release/tf2-cpu.2-6
WORKDIR /

# Copies the trainer code to the docker image.
COPY trainer /trainer

# Install XGBoost
RUN pip install xgboost==1.6.2

# Sets up the entry point to invoke the trainer.
ENTRYPOINT ["python", "-m", "trainer.train"]
Diese Dockerfile nutzt das offizielle Deep-Learning-Image aus der Google Container Registry mit vorinstalliertem TensorFlow. Die Datei kopiert unser Verzeichnis trainer, installiert XGBoost und führt am Ende unser Python-Skript aus.
Das Skript soll das Dry-Beans-Dataset aus unserem GCP-Bucket laden, einen XGBoost-Klassifikator trainieren und das Modell zurück in den Bucket speichern. Ich habe ein einfaches Skript, das diese Aufgaben erledigt, in diesem GitHub Gist bereitgestellt (ich teile es hier nicht vollständig, um Platz zu sparen).
Kopiere den Code aus dem Gist in train.py. Installiere dann im Terminal XGBoost, da es in deiner gewählten Workbench nicht vorinstalliert ist, und führe das Skript aus:
$ pip install xgboost==1.6.2
$ python trainer/train.py
Wenn das Skript fehlerfrei läuft, setze mit diesen beiden Variablen im Terminal fort:
$ PROJECT_ID='vertexai-tutorial-423010'  # Replace with your PROJECT_ID from earlier
$ IMAGE_URI="gcr.io/$PROJECT_ID/dry-beans:v1"  # This stays the same
Diese Variablen verwenden wir beim Bauen des Containers. Führe dann aus:
$ docker build ./ -t $IMAGE_URI
Der Build dauert etwas. Starte den Container danach, um zu prüfen, ob alles funktioniert:
$ docker run $IMAGE_URI
Model trained successfully!
Model uploaded successfully!
Wenn du die obigen Erfolgsmeldungen siehst, ist der Container bereit zum Pushen:
$ docker push $IMAGE_URIDamit ist der Großteil geschafft. Wechsle jetzt ins Dashboard und erstelle mit dem soeben gepushten Container einen individuellen Trainingsjob. Gehe zum Tab „MODEL REGISTRY“ und klicke auf „CREATE“:
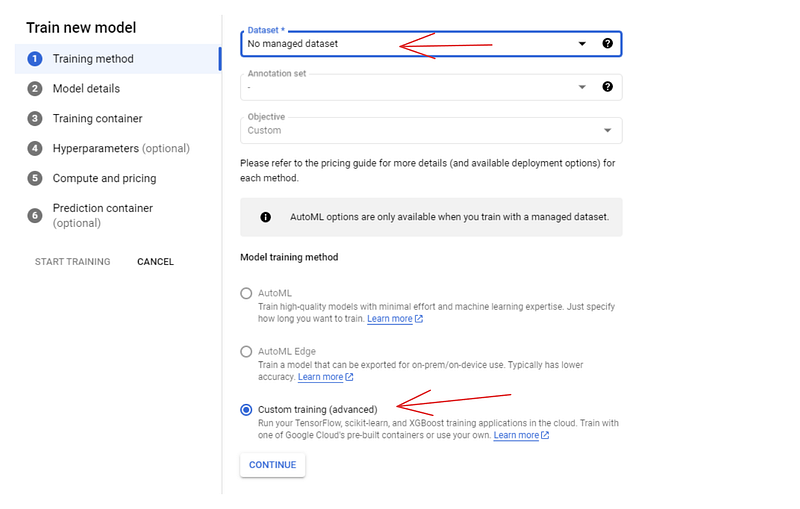
Wähle als Trainingsmethode „No managed dataset“ und „Custom training“. Vergib im nächsten Schritt (Model details) einen Namen — dry-beans-classifier.
Im Bereich „Training container“:
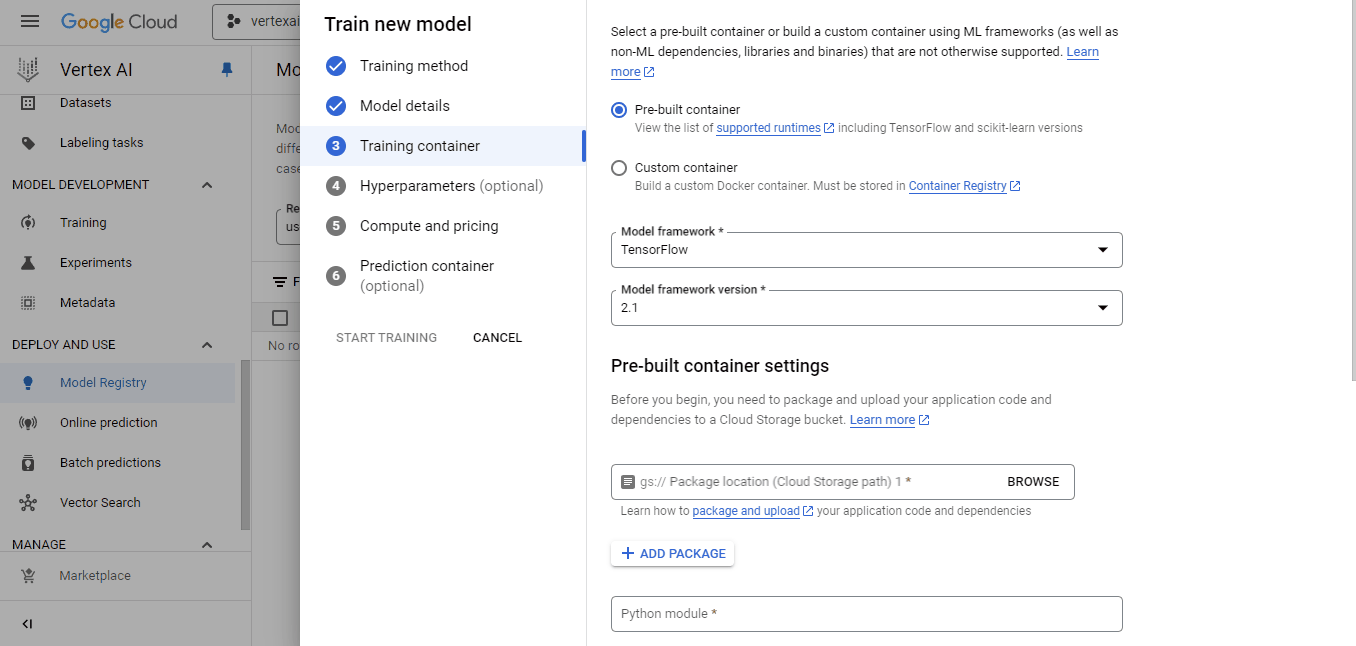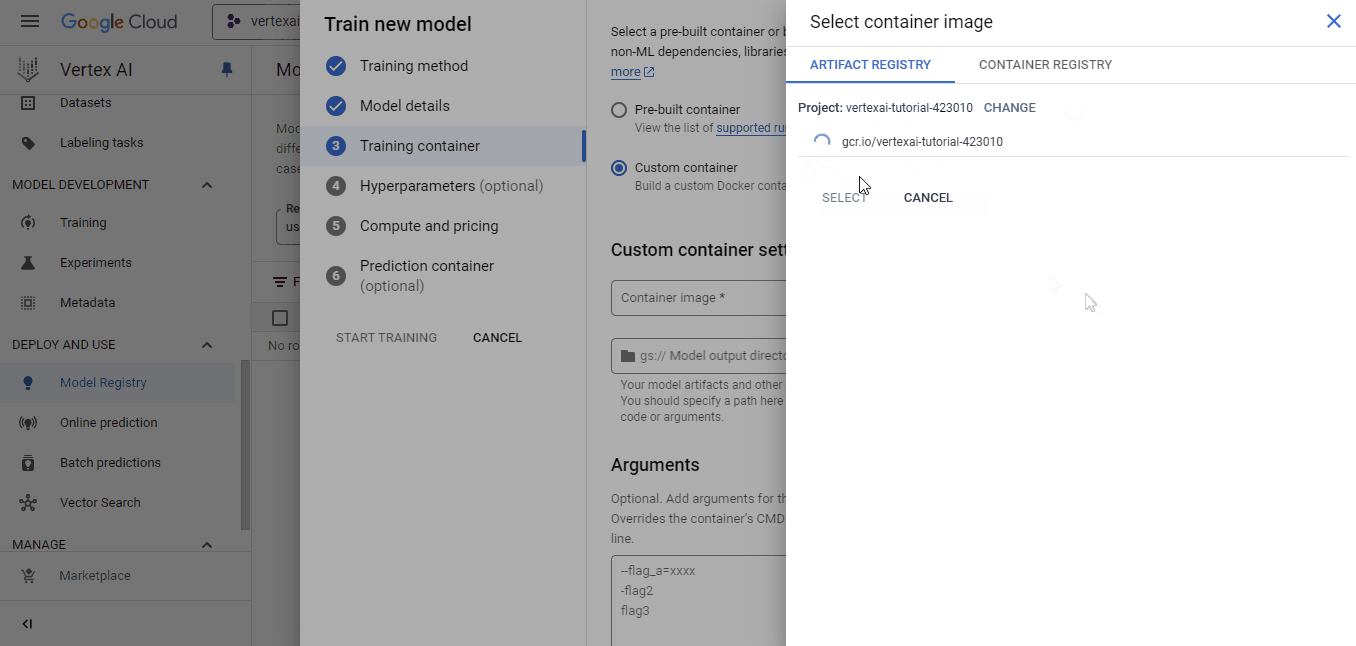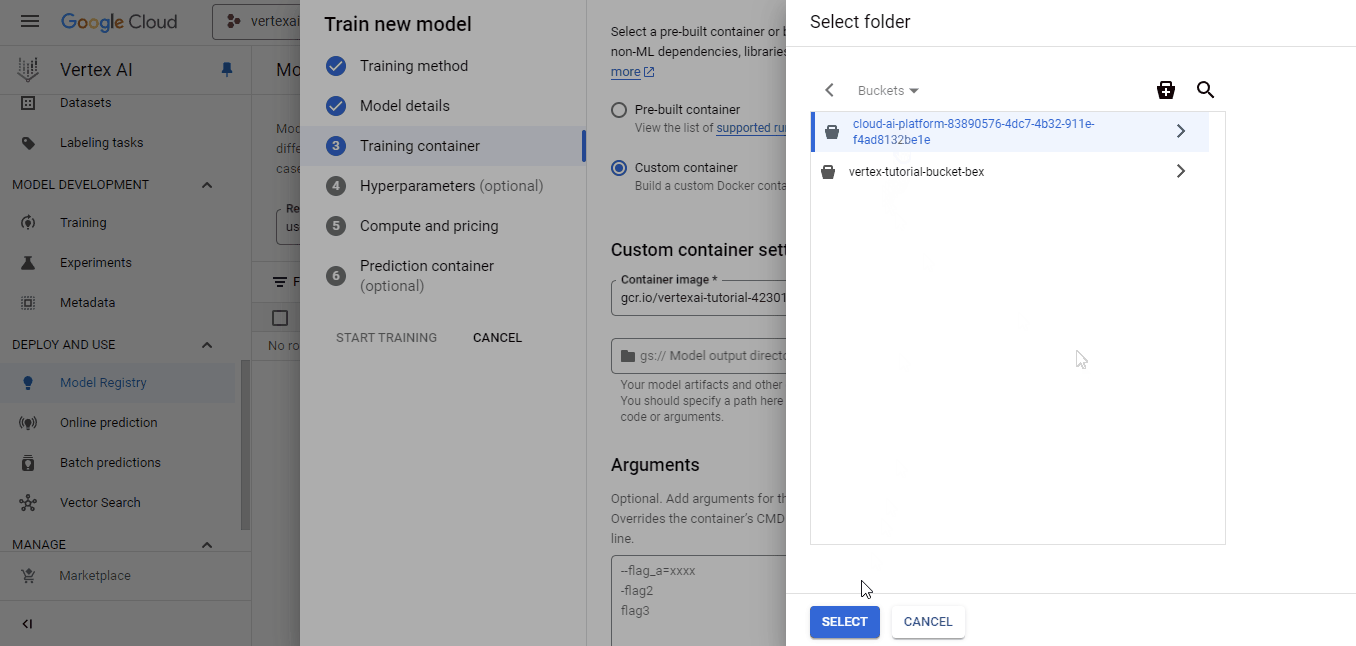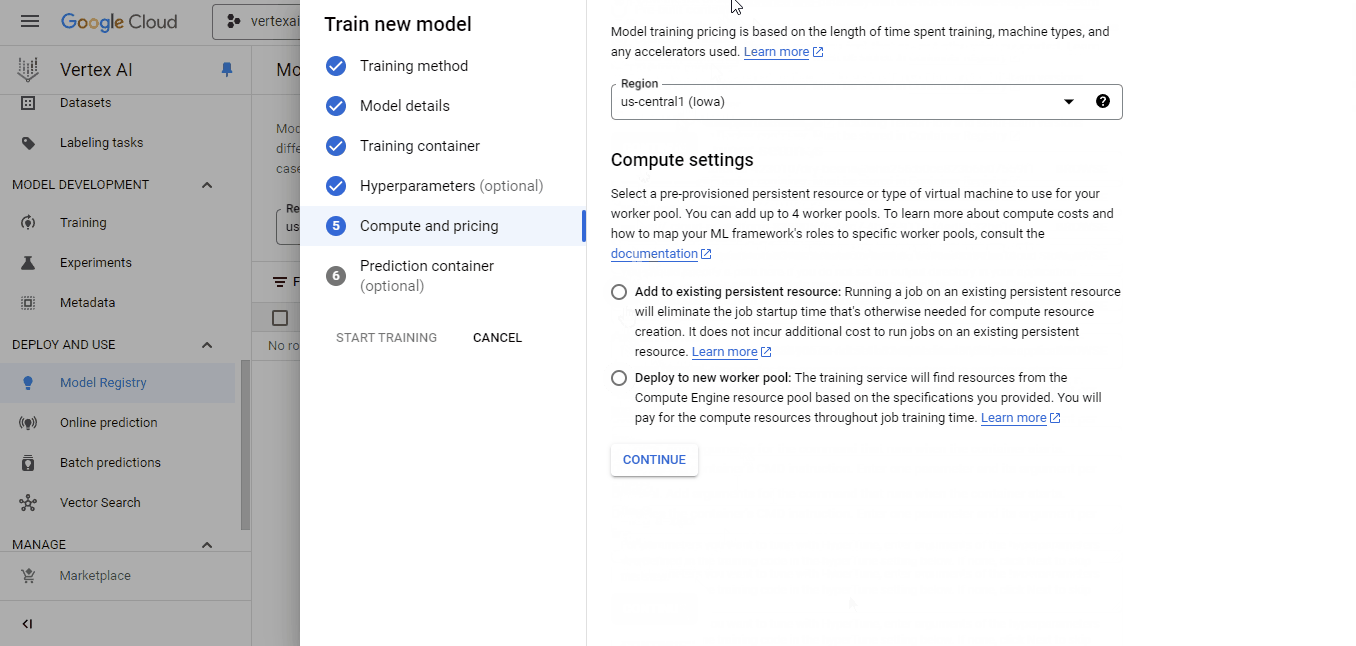
Wähle das von uns gepushte Custom-Image und den Bucket cloud-ai-platform für die Modellausgabe. Klicke dann weiter, bis du zum Abschnitt „Compute and pricing“ gelangst:
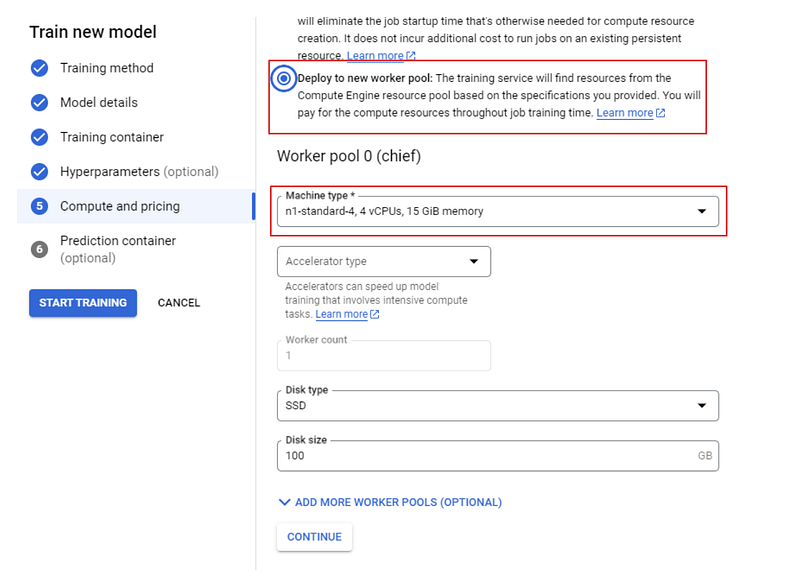
Wähle eine Standard-n1-Maschine mit 4 CPUs und klicke schließlich auf „START TRAINING“. Wechsle danach zum Tab „TRAINING“ in deinem Dashboard.
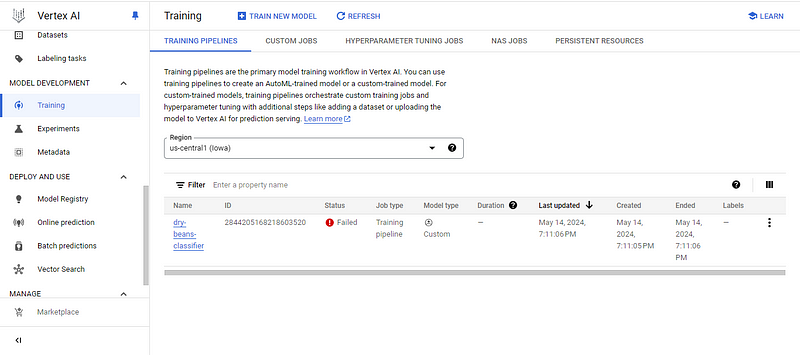
An diesem Punkt siehst du eines von zwei Dingen:
Bei mir ist Ersteres der Fall, also schauen wir, warum – klicke auf den Modellnamen:

Der Fehler besagt, dass ich die Anzahl erlaubter Custom-Training-CPUs überschritten habe. Ich bin tiefer eingestiegen – mit ernüchterndem Ergebnis.
Normalerweise stellt GCP pro Region mindestens 20 CPU-Quotas bereit. In meinem Profil war die Quote jedoch nur 1. Das bedeutet, ich kann keinen Custom-Training-Job starten, da alle von Google angebotenen Maschinen mindestens zwei CPUs haben.
Ich habe versucht, meine Quote mit den Antworten aus diesem StackOverflow-Thread zu erhöhen, aber ohne Erfolg. Die Rückmeldung war, dass neue Vertex-AI-Nutzende zunächst nur eine CPU-Einheit erhalten. Um die Quote zu erhöhen, müsste ich ein Support-Ticket einreichen – was nicht kostenlos ist (es braucht einen kostenpflichtigen Supportvertrag).
Wenn du ähnlich „unglücklich“ bist, probiere die Vorschläge im SO-Thread aus. Bei einigen haben sie funktioniert. Wenn nicht, bleibt nur der Support.
Wenn dein Training hingegen erfolgreich durchläuft, kannst du das Modell wie bei den AutoML-Modellen beschrieben bereitstellen.
Vertex AI ist eine umfangreiche Plattform mit vielen Features. In diesem Tutorial haben wir nur an der Oberfläche gekratzt, aber die wichtigsten Bausteine abgedeckt. Wenn du das Erstellen von Storage-Buckets, Workbenches und Trainingsjobs beherrschst, bist du bestens gerüstet, um den Rest der Plattform zu erkunden.
Wenn du mehr über Google Cloud Services lernen willst, sieh dir diese Ressourcen an:
Starte heute mit deiner KI-Reise!
Kurs
Kurs
Kurs