Cours
Introduction à R
4 h
3.1M
Une chaîne de Markov est un système mathématique qui passe d’un état à un autre selon un ensemble de règles probabilistes. Les chaînes de Markov sont des processus stochastiques, mais elles s’en distinguent par l’absence de « mémoire ». Autrement dit, la probabilité du prochain état du système ne dépend que de l’état présent, et non des états précédents. C’est ce que l’on appelle la propriété de Markov (illustrée ci-dessous) :

Pour construire un modèle de chaîne de Markov opérationnel, il est essentiel de définir une matrice de transition Pt. Une matrice de transition contient l’information sur la probabilité de passer d’un état à un autre dans le système. Pour être valide, chaque ligne doit être un vecteur de probabilités dont la somme des éléments vaut 1.
Les matrices de transition ont la propriété que le produit de matrices successives décrit les probabilités de transition sur un intervalle de temps. On peut donc modéliser la probabilité de se trouver dans un certain état après k pas en calculant :

Ce tutoriel aborde aussi les chaînes de Markov absorbantes. Ces chaînes comportent au moins un état tel que, dès qu’il est atteint, la probabilité d’y rester vaut 1 (on ne peut plus le quitter).
Une chaîne de Markov absorbante est une chaîne dans laquelle il est impossible de quitter certains états une fois qu’on y est entré. Toutefois, ce n’est qu’une des conditions. Pour qu’une chaîne soit absorbante, tous les autres états transitoires doivent pouvoir atteindre un état absorbant avec une probabilité de 1.
Les chaînes de Markov absorbantes ont des propriétés spécifiques qui les distinguent des chaînes de Markov homogènes dans le temps classiques. L’une d’elles concerne l’écriture de la matrice de transition. Pour une chaîne avec t états transitoires et r états absorbants, la matrice de transition P peut s’écrire sous forme canonique comme suit :

Où Q est une matrice t x t, R une matrice t x r, 0 une matrice nulle r x t, et Ir une matrice identité r x r. En particulier, la décomposition de la matrice de transition via la matrice fondamentale permet certains calculs, comme le nombre moyen de pas avant absorption depuis chaque état. La matrice fondamentale N se calcule ainsi :

Où It est une matrice identité t x t.
Le nombre moyen de pas s’appuie sur la linéarité de l’espérance et se calcule comme suit :

Où 1 est un vecteur colonne de même longueur que le nombre d’états transitoires, avec uniquement des 1.
On peut en outre calculer la probabilité d’être absorbé par un état absorbant donné en partant de n’importe quel état transitoire. Cette probabilité se calcule ainsi :

Les chaînes de Markov sont largement utilisées en finance, en théorie des jeux, ou encore en génétique. Ici, nous allons les utiliser pour modéliser la durée d’un cycle de vente, car celui-ci peut suivre un processus markovien. Cette hypothèse a été validée en testant si les séquences décrivant les étapes traversées par une opportunité avant sa conclusion respectaient la propriété de Markov.
Nous avons supposé que les probabilités de progression d’une opportunité d’un mois sur l’autre étaient constantes pour un secteur donné, afin d’utiliser des chaînes de Markov homogènes dans le temps. Autrement dit, les probabilités de transition entre états restent constantes au fil du temps (à mesure que le nombre de pas k augmente).
Les probabilités estimées étaient les suivantes :
Cette analyse a été réalisée en R. R propose un package pratique, markovchain, capable de gérer un large éventail de chaînes de Markov.
Nous avons d’abord vérifié si nos séquences de ventes respectaient la propriété de Markov. À cette fin, le package markovchain propose une fonction utile, verifyMarkovProperty(), qui teste si une séquence d’événements suit la propriété de Markov via des tests du χ² sur une série de tableaux de contingence dérivés de la séquence. De grandes valeurs de p indiquent que l’hypothèse nulle selon laquelle la séquence suit la propriété de Markov ne doit pas être rejetée. Voici un exemple de séquence indiquant la position d’une opportunité chaque mois, de la première réunion à la clôture :
library(markovchain)
library(dplyr)
# SDR Funnel désigne les étapes du commercial sédentaire, AE Funnel celles de l'account executive, et CW une affaire gagnée
seq <- c('SDR Funnel','SDR Funnel','AE Funnel','AE Funnel','AE Funnel','AE Funnel','AE Funnel','AE Funnel','CW')
verifyMarkovProperty(seq)
## Testing markovianity property on given data sequence
## Chi - square statistic is: 0.5733333 degrees of freedom are: 27 and corresponding p-value is: 1La p-valeur étant supérieure à 0,05, nous ne rejetons pas l’hypothèse nulle selon laquelle la séquence suit la propriété de Markov.
Une fois cette étape validée, nous avons tracé la structure de la chaîne de Markov avec les probabilités de transition issues de nos données. Le code ci-dessous instancie un objet chaîne de Markov en définissant la matrice de transition et les noms des états. Il affiche également la chaîne et ses probabilités de transition.
source('TransProb.R')
source('MatDataBase.R')
source('GatherTransMat.R')
transElec <- GatherTransMat('Manufacturing','Between 100M and 500M', 'Between 500 and 1k')
print(transElec)
markov2 <- new('markovchain',
transitionMatrix = transElec, # Probabilités de transition pour un secteur aléatoire
states = c('SDR','AE','CW'))
layout <- matrix(c(0,0,0,1,1,0), ncol = 2, byrow = TRUE)
plot(markov2, node.size = 10, layout = layout)## [,1] [,2] [,3]
## [1,] 0.5573215 0.4426785 0.0000000
## [2,] 0.0000000 0.8678118 0.1321882
## [3,] 0.0000000 0.0000000 1.0000000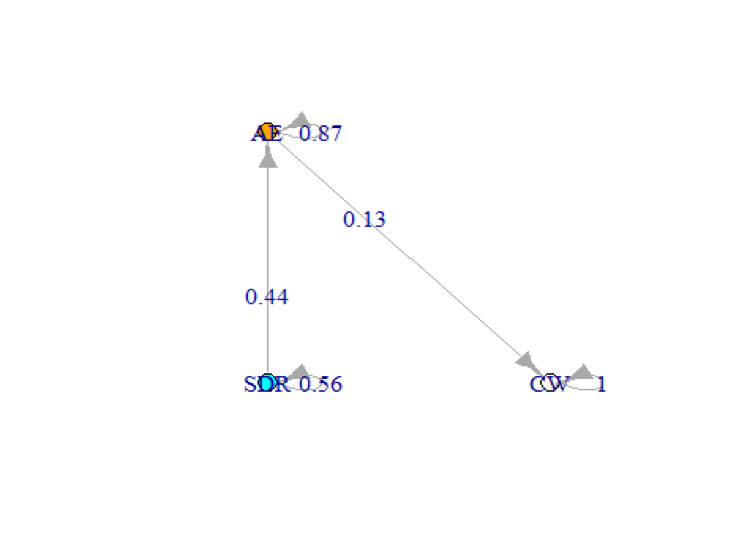
Comme nous avons une chaîne de Markov absorbante, nous calculons le temps moyen jusqu’à l’absorption. La première entrée du vecteur donne le nombre moyen de pas jusqu’à la clôture en partant de l’entonnoir SDR, la seconde en partant de l’entonnoir AE.
# Extraire Q de la matrice de transition
Q <- transElec[1:2,1:2]
# Générer It
It <- diag(2)
# Calculer la matrice fondamentale
N <- solve(It-Q)
# Générer un vecteur colonne de 1
one <- t(t(c(1,1)))

# Calculer le nombre moyen de pas par multiplication matricielle
expected <- N%*%one
print(expected)
## [,1]
## [1,] 9.823945
## [2,] 7.564969Nous pouvons aussi visualiser l’évolution des probabilités à mesure que le nombre de pas augmente, pour compléter l’interprétation du nombre moyen de pas. Nous avons donc examiné les probabilités d’être dans chacun des trois états sur 24 pas.
library(ggplot2)

initState <- c(1,0,0) # L'état initial est SDR Funnel (simulation d'un premier rendez-vous de découverte)

# Initialiser les vecteurs de probabilité
SDRProb <- c()
AEProb <- c()
CW <- c()

# Calculer les probabilités sur 24 pas
for(k in 1:24){
  nsteps <- initState*markov2^k
  SDRProb[k] <- nsteps[1,1]
  AEProb[k] <- nsteps[1,2]
  CW[k] <- nsteps[1,3]
}

# Créer les data frames et les fusionner
SDRProb <- as.data.frame(SDRProb)
SDRProb$Group <- 'SDR'
SDRProb$Iter <- 1:24
names(SDRProb)[1] <- 'Value'

AEProb <- as.data.frame(AEProb)
AEProb$Group <- 'AE'
AEProb$Iter <- 1:24
names(AEProb)[1] <- 'Value'

CW <- as.data.frame(CW)
CW$Group <- 'CW'
CW$Iter <- 1:24
names(CW)[1] <- 'Value'

steps <- rbind(SDRProb,AEProb,CW)

# Tracer les probabilités avec ggplot
ggplot(steps, aes(x = Iter, y = Value, col = Group))+
  geom_line() +
  xlab('Chain Step') +
  ylab('Probability') +
  ggtitle('24 Step Chain Probability Prediction')+
  theme(plot.title = element_text(hjust = 0.5))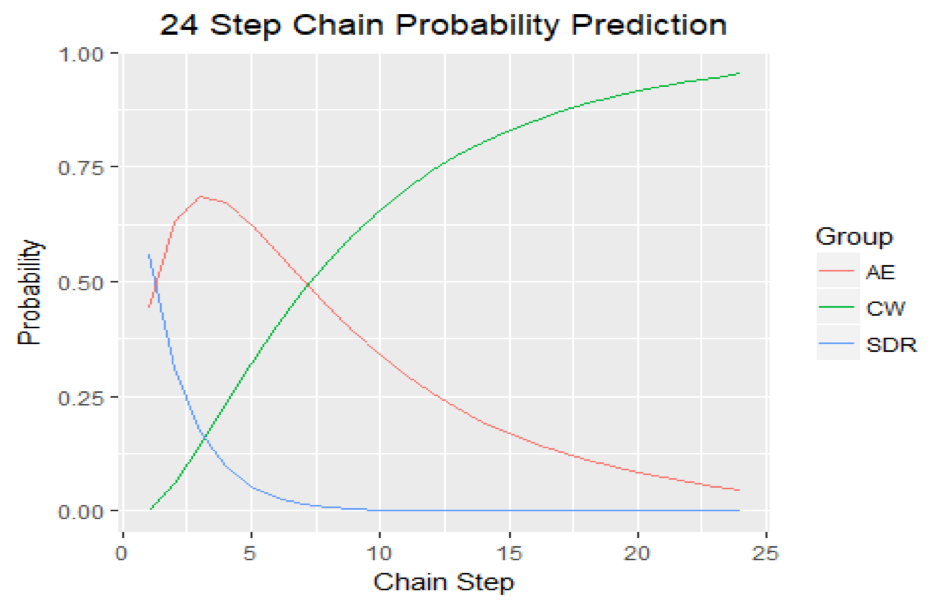
En combinant ces résultats, on voit clairement que l’état CW devient le plus probable après 6 à 9 pas. Étant donné que les probabilités de transition sont mensuelles, on peut en déduire qu’un cycle de vente type, du premier rendez-vous à la conclusion de l’affaire, se situe entre 6 et 9 mois pour ce secteur. C’est un cycle relativement long.
L’objectif de cette analyse était de montrer comment les principes de base des chaînes de Markov, y compris les chaînes absorbantes, peuvent répondre à une question métier. Dans ce cas, les résultats se sont révélés fiables malgré l’hypothèse d’homogénéité temporelle : des analyses empiriques complémentaires ont montré que la vélocité moyenne des ventes dans le secteur étudié était de 208 jours, soit presque 7 mois. Nous espérons que cet exemple vous donnera envie d’explorer davantage les chaînes de Markov et de les appliquer à vos propres enjeux.
Pour aller plus loin avec R, suivez le cours Intermediate R de DataCamp.
Découvrez aussi notre tutoriel Markov Chains in Python: Beginner Tutorial.
Cours R
Cours
Cours
Cours