
AI और ML आमतौर पर एक-दूसरे के स्थान पर इस्तेमाल होते हैं। लेकिन यदि मुझे इन्हें जल्दी से परिभाषित कर इनके अंतर दिखाने हों, तो मैं कहूँगा कि AI उस तकनीक को संदर्भित करता है जो मानव बुद्धि से जुड़ी संज्ञानात्मक क्रियाओं की नकल करने वाली मशीनें बनाती है, जबकि ML AI एल्गोरिद्म का वह उपसमूह है जो डेटा से सीखता और बेहतर होता है।
इस लेख में, मैं साइबर सुरक्षा में मशीन लर्निंग तकनीकों की प्रयोज्यता की यात्रा करना चाहता हूँ, उपयोग मामलों की एक श्रृंखला और व्याख्येयता, व्याख्यात्मकता, और मजबूती की चुनौतियाँ दिखाते हुए, जिन्हें इसकी क्षमता का लाभ उठाने के लिए संबोधित करना आवश्यक है।
खतरे की पहचान और रोकथाम
थ्रेट डिटेक्शन और रिस्पॉन्स का अर्थ है नेटवर्क या सिस्टम के खिलाफ साइबर खतरों की पहचान करना और उसके बाद त्वरित व प्रभावी शमन रणनीतियाँ अपनाना। इस प्रक्रिया में नेटवर्क और सिस्टम के भीतर असामान्य व्यवहार का पता लगाना, अनधिकृत घुसपैठ की पहचान करना, और हमारे सिस्टम की सुरक्षा के लिए मैलवेयर नमूनों का विश्लेषण करना शामिल है।
विसंगति पहचान
विसंगतियों का पता लगाना डेटा में ऐसे पैटर्न की पहचान करना है जो सामान्य व्यवहार की सुस्पष्ट धारणा से मेल नहीं खाते।
यह बुनियादी अवधारणा विभिन्न क्षेत्रों में लागू होती है, और साइबर सुरक्षा भी अपवाद नहीं है। मैं डेटा एक्सफिल्ट्रेशन, डिस्ट्रिब्यूटेड डिनायल ऑफ सर्विस (DDoS) हमले, मैलवेयर संक्रमण आदि जैसी विभिन्न दुर्भावनापूर्ण गतिविधियों की पहचान के लिए विसंगति पहचान का उपयोग करता हूँ।विभिन्न मशीन लर्निंग एल्गोरिद्म, जैसे लोकल आउटलायर फैक्टर (LOF), आइसोलेशन फॉरेस्ट, वन-क्लास सपोर्ट वेक्टर मशीन (OC-SVM) का उपयोग विसंगतियों का पता लगाने के लिए किया गया है। हालाँकि, आउटलायर की पहचान के लिए उपयुक्त तकनीक का चयन एक जटिल कार्य है, जिसके लिए कई कारकों का सावधानीपूर्वक विचार करना आवश्यक है, जिनमें शामिल हैं:
- डेटा का प्रकार (जैसे पॉइंट डेटा, अनुक्रमिक, स्थानिक, या ग्राफ-संरचित)
- विसंगतियों का स्वभाव (जैसे पॉइंट, सांदर्भिक, या सामूहिक)
- लेबल युक्त डेटा की उपलब्धता
- वांछित आउटपुट प्रारूप (जैसे बाइनरी लेबल या अनॉमली स्कोर)
हम यह खोजेंगे कि सही मशीन लर्निंग तकनीकों का चयन कैसे करें और यह भी समझाएँगे कि वे दुर्भावनापूर्ण साइबर सुरक्षा गतिविधियों का पता कैसे लगाती हैं। हमारा फोकस साइबर सुरक्षा के दो महत्वपूर्ण अनुप्रयोगों पर होगा: घुसपैठ का पता लगाना और मैलवेयर विश्लेषण।
इंट्रूज़न डिटेक्शन सिस्टम (IDS)
इंट्रूज़न डिटेक्शन सिस्टम (IDS) कंप्यूटर नेटवर्क और सिस्टम के आँख-कान हैं, जो नेटवर्क ट्रैफ़िक (नेटवर्क-आधारित IDS) और सिस्टम कॉल (होस्ट-आधारित IDS) की निगरानी और विश्लेषण करते हैं ताकि दुर्भावनापूर्ण गतिविधियों की पहचान की जा सके।
अपने प्रयोगों के दौरान, मैंने दोनों प्रणालियों के लिए विसंगति पहचान दृष्टिकोणों की शक्ति देखी है, जो नई या पहले से अज्ञात खतरों का पता लगाने में सक्षम हैं जो सिग्नेचर-आधारित तकनीकों से बच निकलते हैं, क्योंकि वे पहचान के लिए पूर्वपरिभाषित हमले के पैटर्न पर निर्भर करती हैं।
होस्ट-आधारित IDS में जाने से पहले, यह समझना महत्वपूर्ण है कि सिस्टम कॉल क्या हैं। ये मूलतः किसी प्रोग्राम द्वारा ऑपरेटिंग सिस्टम से विशिष्ट कार्य करने के लिए की गई अनुरोध होते हैं। मान लीजिए आप Linux ऑपरेटिंग सिस्टम पर किसी फ़ाइल को संशोधित करने के लिए टेक्स्ट एडिटर का उपयोग करते हैं। परदे के पीछे, आपका टेक्स्ट एडिटर open() सिस्टम कॉल का उपयोग कर फ़ाइल खोलने का अनुरोध करता है, write() से उसमें बदलाव लिखता है, और फिर close() से फ़ाइल बंद करके उसे सहेज देता है।
जहाँ टेक्स्ट एडिटर के सिस्टम कॉल सीधे और पूर्वानुमेय होते हैं, वहीं किसी दुर्भावनापूर्ण तत्व के सिस्टम कॉल अनुक्रम अक्सर भ्रामक होते हैं। कोई दुर्भावनापूर्ण प्रोग्राम open(), write() के जरिए एक छिपी फ़ाइल डाल सकता है, फिर execve() से उसे उच्चाधिकार के साथ चला सकता है। इसके बाद socket() जैसे नेटवर्क-संबंधी कॉल का उपयोग किया जा सकता है ताकि कमांड-एंड-कंट्रोल चैनल हमला स्थापित किया जा सके।
इसे संबोधित करने के लिए, सिस्टम कॉल अनुक्रमों को अक्सर मशीन लर्निंग एल्गोरिद्म के लिए उपयुक्त स्थिर फीचर प्रतिनिधित्व में बदला जाता है। लेकिन आप सोच रहे होंगे, इस स्थिति में कौन-सी लर्निंग तकनीक मॉडल प्रशिक्षण के लिए सबसे उपयुक्त है?
लर्निंग तकनीक का चयन लेबल की उपलब्धता पर बहुत निर्भर करता है। यदि सामान्य और असामान्य दोनों प्रकार के सिस्टम कॉल अनुक्रमों वाला संतुलित डाटासेट उपलब्ध है, तो मैं निश्चित रूप से सपोर्ट वेक्टर मशीन (SVM) जैसे सुपरवाइज्ड एनॉमली डिटेक्शन मॉडल चुनूँगा।
इसके विपरीत, यदि लेबल युक्त डेटा उपलब्ध नहीं है, तो मैं आइसोलेशन फॉरेस्ट जैसे अनसुपरवाइज्ड लर्निंग मॉडल का उपयोग कर सकता हूँ। ऐसे परिदृश्यों में जहाँ प्रशिक्षण डेटा में केवल सामान्य व्यवहार ही दर्शाया गया हो, मैं वन-क्लास SVM या DBSCAN जैसी सेमी-सुपरवाइज्ड तकनीकें चुनता हूँ।
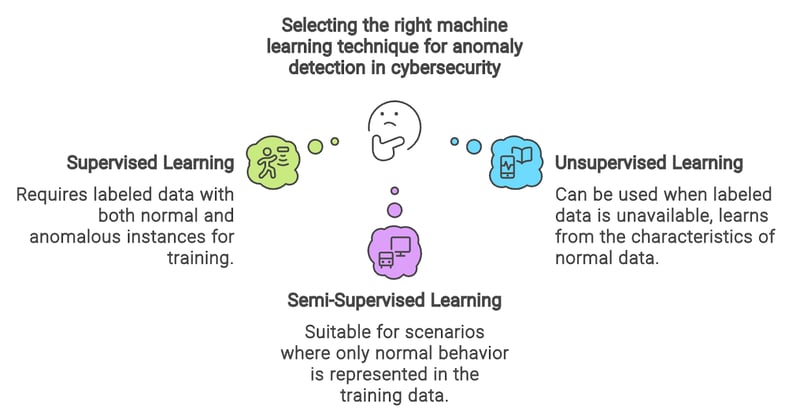
आरेख Napkin.ai के साथ बनाया गया
अब जब हमने समझ लिया है कि ML होस्ट-आधारित IDS में कैसे लागू होती है, तो आइए नेटवर्क-आधारित IDS के क्षेत्र में चलें। जहाँ होस्ट-आधारित सिस्टम व्यक्तिगत मशीनों पर केंद्रित होते हैं, वहीं नेटवर्क-आधारित IDS नेटवर्क डेटा में घुसपैठ की पहचान करते हैं; यानी सिस्टम कॉल का विश्लेषण करने के बजाय, नेटवर्क IDS नेटवर्क फ्लो आँकड़े, पेलोड डेटा और पैकेट हेडर की निगरानी करके सूचना चोरी और नेटवर्क बाधा गतिविधियों का निरीक्षण करते हैं।
निम्नलिखित तालिका पर एक त्वरित नज़र आपको यह समझने में मदद कर सकती है कि नेटवर्क फ्लो डाटासेट कैसा दिखता है।
|
गंतव्य पोर्ट |
स्रोत पोर्ट |
फ्लो अवधि (ms) |
कुल अग्रेषित पैकेट |
कुल प्रत्यावर्तित पैकेट |
लेबल |
|
54865 |
9910 |
6 |
5000 |
600 |
0 |
|
54810 |
9010 |
2 |
2000 |
200 |
1 |
संश्लेषित सामान्य और असामान्य नेटवर्क फ्लो आँकड़े।
डाटासेट की प्रत्येक पंक्ति दो एंडपॉइंट्स के बीच एक स्वतंत्र नेटवर्क संचार सत्र का प्रतिनिधित्व करती है, जिसका डाटासेट में अन्य फ्लो से कोई अंतर्निहित संबंध नहीं होता।
प्रत्येक फ्लो स्रोत और गंतव्य पोर्ट नंबर, मिलीसेकंड में फ्लो अवधि, और दोनों दिशाओं में आदान-प्रदान किए गए कुल पैकेटों जैसी विशेषताओं से परिभाषित होता है। एक श्रेणीबद्ध लेबल इंगित करता है कि नेटवर्क फ्लो को असामान्य या हमले के रूप में वर्गीकृत किया गया है, जो इंट्रूज़न डिटेक्शन मॉडलों के लिए आवश्यक ग्राउंड ट्रुथ प्रदान करता है।
ध्यान देने योग्य है कि डाटासेट की प्रत्येक पंक्ति एक स्वतंत्र नेटवर्क फ्लो का प्रतिनिधित्व करती है, जिसका अन्य फ्लो के साथ कोई अनुक्रमिक या संबंधपरक निर्भरता नहीं है।
नेटवर्क फ्लो की स्वतंत्र प्रकृति को देखते हुए, डाटासेट को कुछ फीचर इंजीनियरिंग तकनीकों के बाद एनॉमली डिटेक्शन हेतु मशीन लर्निंग एल्गोरिद्म में दिया जा सकता है। जैसा कि पहले होस्ट-आधारित IDS के संदर्भ में चर्चा की गई, उपयुक्त मशीन लर्निंग तकनीकों का चयन लेबल युक्त डेटा की उपलब्धता पर निर्भर है।
मैलवेयर विश्लेषण
मैलवेयर विश्लेषण पर जाने से पहले, हमें पहले यह समझाना होगा कि मैलवेयर क्या है और यह कैसे काम करता है।
मैलवेयर से तात्पर्य उस दुर्भावनापूर्ण सॉफ़्टवेयर या बाइनरी एक्ज़िक्यूटेबल्स से है, जो हमलावर के हानिकारक इरादों को क्रियान्वित करने के लिए बनाए जाते हैं। यह कोड जानबूझकर लक्षित सिस्टम की कमजोरियों का शोषण करता है ताकि उनकी अखंडता से समझौता किया जा सके, संवेदनशील डेटा चुराया जा सके, डेटा हटाया जा सके, और यहाँ तक कि फिरौती के लिए डेटा एन्क्रिप्ट किया जा सके। यह वायरस, वर्म, स्पायवेयर, ट्रोजन, रैनसमवेयर आदि कई श्रेणियों में आ सकता है।
मैलवेयर के प्रकार, उसकी कार्यक्षमता और संभावित प्रभाव को समझने के लिए, स्थैतिक और डायनेमिक विश्लेषण से कई फीचर निकाले जाते हैं और उपयुक्त मशीन लर्निंग एल्गोरिद्म में दिए जाते हैं।
Windows एक्ज़िक्यूटेबल्स, यानी पोर्टेबल एक्ज़िक्यूटेबल्स (PEs) के मैलवेयर विश्लेषण पर विचार करें। हम PEs के डायनेमिक और स्थैतिक विश्लेषण से आने वाले विभिन्न फीचर्स—जैसे बाइट अनुक्रम, APIs/सिस्टम कॉल, ऑपकोड्स, नेटवर्क, फ़ाइल सिस्टम, CPU रजिस्टर, PE फ़ाइल की विशेषताएँ और स्ट्रिंग्स—निकाल सकते हैं और फिर उन्हें उपयुक्त सुपरवाइज्ड, अनसुपरवाइज्ड और सेमी-सुपरवाइज्ड मशीन लर्निंग मॉडलों में देकर मैलवेयर का पता लगा सकते हैं।
भेद्यता प्रबंधन
साइबर हमलों के जोखिम को कम करने के लिए, हमें अपने नेटवर्क, कंप्यूटर और अनुप्रयोगों में संभावित सुरक्षा कमजोरियों की शीघ्र पहचान, आकलन और समाधान करना होगा। आइए देखें कि भेद्यता स्कैनिंग, पैच प्रबंधन और जोखिम आकलन के माध्यम से भेद्यता प्रबंधन में AI और ML एल्गोरिद्म की क्या भूमिका है।
भेद्यता स्कैनिंग
एक साइबर सुरक्षा शोधकर्ता के रूप में, मैं अक्सर नेटवर्क ट्रैफ़िक लॉग पार्सर, फ़ज़र आदि जैसे साइबर सुरक्षा कार्यों को स्वचालित करने के लिए कस्टम टूल विकसित करता हूँ।
ये उपकरण हमारी सुरक्षा परिचालन को काफी बढ़ा सकते हैं, लेकिन उन्हें उपयोग और सहकर्मियों के साथ साझा करने से पहले कड़े भेद्यता स्कैनिंग से गुजरना महत्वपूर्ण है।
अन्यथा, कोई हमलावर मेरी कस्टम स्क्रिप्ट में अनदेखी और अनपैच्ड कमजोरियों का शोषण कर अनधिकृत पहुँच प्राप्त कर सकता है, संवेदनशील जानकारी से समझौता कर सकता है, या हमारी कंपनी में सेवाओं को बाधित कर सकता है।
मशीन लर्निंग मॉडल पेड़ों के बीच जंगल देख लेते हैं। वे सूक्ष्म पैटर्न और सहसंबंध खोजकर बड़े डाटासेट से अर्थपूर्ण फीचर निकालने में उत्कृष्ट हैं। इसे ध्यान में रखते हुए, मैंने यह जाँचना शुरू किया कि क्या वे भेद्यता पहचान को स्वचालित करने, तेज़ विश्लेषण करने और पहले से अघोषित कमजोरियों की पहचान करने में सक्षम हैं।
ML-आधारित भेद्यता पहचान मॉडल बनाने के लिए, मैं विभिन्न स्रोतों—जैसे NVD (नेशनल वल्नरेबिलिटी डाटाबेस), OWASP, आदि—से प्रशिक्षण के लिए कमजोर और गैर-कोमल दोनों प्रकार का डेटा एकत्र करने से शुरू करता हूँ।
इसके बाद संग्रहण को पूर्वसंसाधित कर एम्बेड किया जाता है ताकि चुने गए मॉडल में दिया जा सके। इनपुट को ग्राफ या ट्री के रूप में दर्शाया जा सकता है, जो विभिन्न कोड तत्वों के बीच संबंध दिखाता है, जैसे कोड प्रॉपर्टी ग्राफ (CPG) या एब्स्ट्रैक्ट सिंटैक्स ट्री (AST)।
इनपुट टोकन-आधारित प्रतिनिधित्व भी हो सकता है, जिसमें सोर्स कोड को टोकन वेक्टर में बदला जाता है। बाद में विभिन्न एम्बेडिंग तकनीकें लागू की जा सकती हैं, जिनमें Word2Vec, ग्राफ एम्बेडिंग, वन-हॉट एम्बेडिंग, एन-ग्राम फीचर्स आदि शामिल हैं।
जैसा कि पिछले अनुप्रयोगों में समझाया गया, मशीन लर्निंग मॉडल और उसकी लर्निंग तकनीक चुनना मुख्यतः लेबल की उपलब्धता पर निर्भर करता है। प्रशिक्षण चरण में, भेद्यता पहचान डाटासेट को प्रशिक्षण और सत्यापन सेट में विभाजित किया जाता है, और मॉडल लेबल युक्त डेटा से सीखता है।
मॉडल के पैरामीटर भविष्यवाणी त्रुटियों के आधार पर अनुकूलन तकनीकों का उपयोग कर क्रमिक रूप से अपडेट होते हैं। मॉडल के सीखने की प्रक्रिया पूरी होने के बाद, अनदेखे डेटा पर उसकी भेद्यता पहचान करने की क्षमता मापी जाती है। सटीकता, प्रीसिजन, रिकॉल, और F1 स्कोर जैसे प्रमुख प्रदर्शन संकेतक गणना किए जाते हैं ताकि मॉडल की भेद्यता पहचानने की क्षमता का आकलन किया जा सके।
मेरी कस्टम स्क्रिप्ट में भेद्यता का पता चलने पर व्यापक जोखिम आकलन आवश्यक है। यदि मौजूदा सुरक्षा नियंत्रण खोजी गई कमजोरियों के शोषण को रोकते हैं या संभावित परिणाम न्यूनतम हैं, तो जोखिम स्वीकार किया जा सकता है।
वैकल्पिक रूप से, विकसित कोड का उपयोग पूरी तरह से टालना भी किसी भी शोषण जोखिम को समाप्त करने के लिए माना जा सकता है। हालाँकि, यदि पूर्ण उन्मूलन व्यवहार्य नहीं है, तो शमन रणनीतियाँ लागू करना महत्वपूर्ण है।
अगले चरण में, हम प्राथमिक शमन रणनीति के रूप में कमजोर सॉफ़्टवेयर पर पैच लगाने का अन्वेषण करेंगे।
पैच प्रबंधन
सभी खुली और गंभीर कमजोरियों को संबोधित करना आदर्श है, लेकिन अक्सर अव्यावहारिक। एक अधिक रणनीतिक दृष्टिकोण आवश्यक है। मशीन लर्निंग का उपयोग करके, हम सक्रिय रूप से यह भविष्यवाणी कर सकते हैं कि किन कमजोरियों का सबसे अधिक शोषण होने की संभावना है जिससे सुरक्षा घटनाएँ हो सकती हैं। इससे हम पैच लगाने की प्राथमिकता तय कर सकते हैं।
Napkin.ai के साथ बनाया गया
हमारी पैच प्राथमिकता प्रक्रिया को सुव्यवस्थित करने के लिए, हम ट्री-आधारित प्री-ट्रेंड Exploit Prediction Scoring System (EPSS) मॉडल का उपयोग करते हैं, जो भेद्यता जानकारी को वास्तविक दुनिया की शोषण गतिविधि के साथ संयोजित कर अगले तीस दिनों में किसी विशिष्ट भेद्यता का हमलावरों द्वारा उपयोग किए जाने की संभावना का पूर्वानुमान लगाता है।
EPSS मशीन लर्निंग मॉडल भेद्यता जानकारी (जैसे CVSS) और शोषण गतिविधि के बीच पैटर्न और संबंधों की पहचान कर यह गणितीय रूप से तय करता है कि हमलावर किसी भेद्यता का उपयोग करेंगे या नहीं।
भेद्यता प्राथमिकता के बाद, पैच को परिचालन जोखिमों को कम करने के लिए कड़ी अधिग्रहण, मान्यकरण और परीक्षण से गुजरना पड़ता है। पैच परिनियोजन एक जटिल प्रक्रिया है जो कई कारकों पर निर्भर करती है, जिनमें शामिल हैं:
- सॉफ़्टवेयर प्रकार (जैसे फ़र्मवेयर, ऑपरेटिंग सिस्टम, अनुप्रयोग)
- एसेट प्लेटफ़ॉर्म प्रकार (जैसे IT, OT, IoT, मोबाइल, क्लाउड, वर्चुअल मशीन)
- प्लेटफ़ॉर्म विशेषताएँ (जैसे प्रबंधित/अप्रबंधित एसेट, ऑन-प्रिमाइसेस या नहीं, वर्चुअलाइज़्ड या नहीं, कंटेनराइज़्ड या नहीं)
- पर्यावरणीय बाधाएँ (जैसे नेटवर्क कनेक्टिविटी और बैंडविड्थ)।
आधुनिक IT परिवेश के पैमाने और विविधता को देखते हुए, मैन्युअल पैच परिनियोजन अक्सर श्रम-सघन और समय लेने वाला होता है। AI-संचालित स्वचालन इन महत्वपूर्ण कारकों के आधार पर प्रत्येक सिस्टम के लिए उपयुक्त पैच को बुद्धिमानी से चुनकर और परिनियोजित कर इस प्रक्रिया को सुव्यवस्थित कर सकता है।
क्लस्टरिंग एल्गोरिद्म, जैसे K-means, का उपयोग समान प्रणालियों को समूहित कर अधिक कुशल पैच परिनियोजन के लिए किया जा सकता है।
जोखिम आकलन
साइबर-जोखिम आकलन संभावित खतरों और पहचानी गई कमजोरियों की पहचान, मूल्यांकन और शमन के लिए महत्वपूर्ण है।
क्योंकि पारंपरिक दृष्टिकोण अक्सर अप्रत्याशित साइबर-जोख़िम के संकेतक खोजने में विफल रहते हैं, शोधकर्ता मशीन लर्निंग की ओर मुड़ने लगे हैं।
सुपरवाइज्ड और मल्टी-क्लास वर्गीकरण ML का उपयोग कर, शोधकर्ता प्रमुख कारकों के व्यापक विश्लेषण के माध्यम से साइबर-जोखिम आकलन में सुधार कर सकते हैं।
नीचे दी गई तालिका में उल्लिखित अनुसार, इन कारकों में साइबर सुरक्षा निवेश, कार्यबल विशेषताएँ, हमले का इतिहास, अवसंरचना कमजोरियाँ, बाहरी परामर्श, और संबंधित जोखिम शामिल हैं। उनके प्रूफ-ऑफ-कॉन्सेप्ट SecRiskAI ML-आधारित फ्रेमवर्क से पता चलता है कि DDoS या फ़िशिंग हमलों की संभावना का पूर्वानुमान लगाने में ML की क्षमता है।
|
सूचना |
उदाहरण |
|
राजस्व |
2,500,000 |
|
साइबर सुरक्षा निवेश |
500,000 |
|
सफल हमले |
5 |
|
विफल हमले |
10 |
|
कर्मचारियों की संख्या |
4,450 |
|
कर्मचारी प्रशिक्षण |
मध्यम |
|
ज्ञात कमजोरियाँ |
9 |
|
बाहरी साइबर सुरक्षा सलाहकार |
नहीं |
|
जोखिम |
कम |
साइबर-जोखिम आकलन के लिए प्रमुख गुणों का एक उदाहरण (स्रोत)
इंसिडेंट रिस्पॉन्स
अब देखते हैं कि AI और ML इंसिडेंट रिस्पॉन्स को कैसे बदल रहे हैं। हम यह खोजेंगे कि वे इंसिडेंट रिस्पॉन्स वर्कफ़्लो को कैसे स्वचालित करते हैं, प्रतिक्रिया समय को कम करते हैं, छिपे खतरों का सक्रिय रूप से पता लगाते हैं, और साइबर हमलों की उत्पत्ति और प्रभाव का पता लगाने के लिए फोरेंसिक विश्लेषण में सुधार करते हैं।
सिक्योरिटी ऑर्केस्ट्रेशन, ऑटोमेशन, और रिस्पॉन्स (SOAR)
मैंने प्रत्यक्ष रूप से देखा है कि SOAR सिस्टम कैसे सिक्योरिटी इन्फॉर्मेशन एंड इवेंट मैनेजमेंट (SIEM) सिस्टम से अलर्ट लेते हैं और उपयुक्त प्लेबुक्स सक्रिय करते हैं, जो सुरक्षा कार्यों की एक श्रृंखला को स्वचालित और समन्वित करते हैं।
इन कार्यों में जाँच संबंधी क्रियाएँ शामिल हो सकती हैं, जैसे URL प्रतिष्ठा जाँचना या उपयोगकर्ता और एसेट विवरण प्राप्त करना, साथ ही प्रतिक्रिया क्रियाएँ, जैसे फ़ायरवॉल पर किसी IP पते को ब्लॉक करना या किसी एंडपॉइंट पर दुर्भावनापूर्ण प्रक्रिया को समाप्त करना।
हालाँकि, वर्तमान में हमें इन प्रणालियों में महत्वपूर्ण सीमाओं का सामना करना पड़ता है। सुरक्षा विश्लेषकों को प्लेबुक्स को मैन्युअल रूप से परिभाषित, बनाना और बदलना पड़ता है, और कई प्लेबुक्स के बीच चयन सुरक्षा विश्लेषकों द्वारा निर्धारित नियमों से संचालित होता है।
इन सीमाओं को दूर करने के लिए, मैंने देखा है कि SOC प्लेटफ़ॉर्म में AI और ML का एकीकरण इस प्रक्रिया में क्रांतिकारी बदलाव ला सकता है, जिससे हम ऐसी प्लेबुक्स स्वचालित रूप से जनरेट कर सकेंगे जो
अज्ञात अलर्ट का प्रभावी ढंग से जवाब दे सकें।
यह न केवल हमारी प्रतिक्रिया की दक्षता बढ़ाता है, बल्कि विश्लेषकों को अधिक कार्यों पर ध्यान केंद्रित करने में भी सक्षम बनाता है। ML एल्गोरिद्म का उपयोग कर, हम प्रत्येक प्रतिक्रिया कार्रवाई की पेनल्टी लागत को प्राप्त अलर्ट के अनुसार गणना करने और सबसे कम पेनल्टी वाली प्रतिक्रिया चुनने के लिए भी प्रशिक्षण दे सकते हैं।
थ्रेट हंटिंग
कल्पना कीजिए कि संभावित खतरों की पहचान करने के लिए आपको लाखों लॉग्स छाँटने पड़ें—यह कितना तनावपूर्ण होगा।
अब इस चुनौती को एंटरप्राइज़ स्तर तक बढ़ा दें, जहाँ प्रत्येक लॉग को एक-एक कर जाँचना पड़ता है और उसे दुर्भावनापूर्ण या साधारण के रूप में वर्गीकृत करना होता है।
प्रक्रिया में मशीन लर्निंग को शामिल कर, हम इस कार्य को सरल बना सकते हैं और थ्रेट डिटेक्शन को गति दे सकते हैं। AI और ML एल्गोरिद्म, जैसे SVM, रैंडम फॉरेस्ट, को लॉग्स का कुशल विश्लेषण और वर्गीकरण करने के लिए प्रशिक्षित किया जा सकता है, जिससे खतरों की त्वरित पहचान संभव होती है और सुरक्षा टीमों पर बोझ घटता है।
फोरेंसिक्स
जैसे-जैसे डिजिटल डेटा की मात्रा और जटिलता बढ़ रही है, डिजिटल फोरेंसिक्स—यानी साइबर अपराधों की जांच हेतु डिजिटल साक्ष्यों का विश्लेषण—में AI और ML का एकीकरण आवश्यक हो गया है।
यह एकीकरण हमें साइबर खतरों की पहचान और प्रतिक्रिया की गति, सटीकता और प्रभावशीलता बढ़ाने में सक्षम बनाता है।
उदाहरण के लिए, फोरेंसिक ट्रायाज में AI और ML का उपयोग किया जा सकता है। इस स्थिति में, हम जाँच से संबंधित प्रासंगिकता के आधार पर बड़ी संख्या में डिजिटल फ़ाइलों को वर्गीकृत और श्रेणीबद्ध करने के लिए ML एल्गोरिद्म का उपयोग करते हैं।
चुनौतियाँ और नैतिक विचार
साइबर सुरक्षा में AI का एकीकरण महत्वपूर्ण अवसर प्रस्तुत करता है। हालाँकि, इसकी अंतर्निहित चुनौतियों और सीमाओं को स्वीकार करना भी महत्वपूर्ण है।
एडवर्सैरियल हमले
कई AI प्रणालियाँ एडवर्सैरियल हमलों—जैसे पॉइज़निंग, एवेशन, मॉडल एक्सट्रैक्शन, प्रॉम्प्ट इंजेक्शन, और इन्फरेंस—के प्रति संवेदनशील होती हैं, जो उनकी कमजोरियों का शोषण करती हैं।
इन हमलों में, विरोधी इनपुट में ऐसे व्यवधान जोड़ते हैं जो मनुष्य के लिए अदृश्य होते हैं, लेकिन मॉडल को गलत भविष्यवाणी करने का कारण बन सकते हैं। यह सुरक्षा-आवश्यक वातावरण में इन प्रणालियों की तैनाती के बारे में चिंता बढ़ाता है, और साइबर सुरक्षा भी इसका अपवाद नहीं है।
इन हमलों का प्रभावी ढंग से मुकाबला करने के लिए, हम एडवर्सैरियल ट्रेनिंग, डिफेंसिव डिस्टिलेशन, और ग्रेडिएंट मास्किंग जैसी विभिन्न रक्षात्मक तंत्रों का उपयोग करते हैं।
व्याख्येयता और पारदर्शिता
यद्यपि AI एल्गोरिद्म परिणाम और भविष्यवाणियाँ हासिल करने में प्रभावी सिद्ध होते हैं, मुझे उनके आंतरिक कार्य-तंत्र को समझने में कठिनाई होती है।
मेरे क्षेत्र में यह बहुत महत्वपूर्ण है, क्योंकि किसी अगम्य प्रणाली को महत्वपूर्ण निर्णय सौंपना स्पष्ट जोखिम उत्पन्न करता है।
यहाँ Explainable AI (XAI) आगे का रास्ता दिखाती है, जो उच्च प्रदर्शन बनाए रखते हुए अधिक व्याख्येयता वाली AI-संचालित साइबर सुरक्षा प्रणालियाँ विकसित करने में मदद करती है। AI के निर्णय-निर्माण में पारदर्शिता प्रदान कर, XAI मुझे बेहतर सूचित विश्लेषण करने और सुरक्षा घटनाओं के जवाब में सबसे उपयुक्त कार्यवाही करने में सहायता करती है।
XAI की हालिया प्रगति—जैसे फीचर महत्व विश्लेषण और निर्णय वृक्ष का दृष्टांत—इस पारदर्शिता को संभव बना रही है।
पक्षपात और निष्पक्षता
जब भी मैं अपनी AI-आधारित साइबर सुरक्षा समाधानों के प्रशिक्षण के लिए डाटासेट चुनता हूँ, तो सुनिश्चित करता हूँ कि वह पक्षपाती न हो। अन्यथा, मेरे विकसित मॉडल अनुचित या भेदभावपूर्ण आउटपुट दे सकते हैं। मैं पक्षपात की पहचान और उसे हटाने के लिए डेटा पूर्वसंसाधन तकनीकें अपनाता हूँ, प्रशिक्षण डेटा को संतुलित करता हूँ, और संभावित पक्षपात के लिए मॉडल के आउटपुट का आकलन करने हेतु निष्पक्षता तकनीकें लागू करता हूँ।
साइबर सुरक्षा में AI का भविष्य
यदि आप यहाँ तक पढ़ चुके हैं, तो आपने देखा है कि AI और ML हमारे कंप्यूटर, मोबाइल डिवाइस, नेटवर्क और अनुप्रयोगों की सुरक्षा करने के तरीके को कैसे बदल रहे हैं। आपने देखा है कि वे सुरक्षा टीमों को कैसे सशक्त करते हैं, खतरों का तेज़ी से पता लगाते हैं, और विभिन्न साइबर सुरक्षा उपकरणों को मजबूत करते हैं।
और उत्साहजनक बात यह है: मेरा मानना है कि हम अभी बस शुरुआत कर रहे हैं।
साइबर सुरक्षा का भविष्य AI और ML की निरंतर प्रगति में निहित है, विशेष रूप से लार्ज लैंग्वेज मॉडल्स (LLMs) में। उनके विस्तारित टोकन लिमिट, कोड व्याख्या क्षमता और विस्तृत विश्लेषण के कारण, ये उन्नत मॉडल मैलवेयर विश्लेषण को अधिक गति और सटीकता के साथ स्केल कर हमारी पहचान और प्रतिक्रिया क्षमता को बढ़ाएँगे।
उदाहरण के लिए Gemini 1.5 मॉडल का मामला लें, जिसे वर्तमान में विशाल फ़ाइलों में मैलवेयर का पता लगाने के लिए उपयोग किया जा रहा है। साइबर सुरक्षा-विशिष्ट प्रशिक्षण न होने के बावजूद, वे प्रॉम्प्ट इंजीनियरिंग, इन-कॉन्टेक्स्ट लर्निंग, और चेन्स-ऑफ-थॉट के माध्यम से प्रासंगिक कार्य हल कर सकते हैं।
हम इस भविष्य की झलकें ओपन-वेट LLMs—जिनमें Llama भी शामिल है—को फाइन-ट्यून कर साइबर सुरक्षा से संबंधित कार्यों, जैसे Hackmentor, के लिए भी देख रहे हैं।
निष्कर्ष
इस ब्लॉग में, हमने देखा कि AI- और ML-आधारित साइबर सुरक्षा उपकरण आधुनिक साइबर खतरों की गतिशील और जटिल प्रकृति से निपटने में कितने उपयोगी हैं। ये उपकरण थ्रेट डिटेक्शन, भेद्यता प्रबंधन, और इंसिडेंट रिस्पॉन्स जैसे लक्षित अनुप्रयोगों के माध्यम से जोखिमों का पता लगाने, उन पर प्रतिक्रिया देने और उन्हें कम करने में प्रभावी हैं।
हालाँकि, हमें AI-आधारित साइबर सुरक्षा समाधानों के विकास और परिनियोजन से जुड़ी महत्वपूर्ण चुनौतियों और नैतिक निहितार्थों पर भी विचार करना चाहिए।
इन चुनौतियों के बावजूद, AI और ML तकनीकों की निरंतर प्रगति विकसित होते साइबर खतरों के खिलाफ हमारी रक्षा को मजबूत करने के लिए बड़े वादे रखती है।

मैं कंप्यूटर और संचार इंजीनियर तथा शोधकर्ता हूँ। मैं अपना समय साइबर सुरक्षा क्षेत्र को आगे बढ़ाने के लिए डीप लर्निंग आधारित औज़ार विकसित करने में लगाता/लगाती हूँ!
LockBit, Hive, Clop, Agent Tesla, Formbook, Raccoon, MoneroMiner, और CoinHive हालिया उन्नत मैलवेयर के कुछ उदाहरण हैं, जिन्होंने पारंपरिक मानव विश्लेषण विधियों को चुनौती दी है।
मैलवेयर विश्लेषण में रुचि रखने वाले एक साइबर सुरक्षा शोधकर्ता के रूप में, उनकी बढ़ती जटिलता और मात्रा के कारण उनकी छिपी हुई कार्यक्षमताओं, दुर्भावनापूर्ण इरादों और संभावित आक्रमण वेक्टरों का पता लगाने में मुझे महत्वपूर्ण सीमाओं का सामना करना पड़ा।
एक अधिक कुशल और प्रभावी दृष्टिकोण की आवश्यकता को पहचानते हुए, मैंने कृत्रिम बुद्धिमत्ता (AI) मॉडलों की क्षमता का पता लगाया ताकि वे दुर्भावनापूर्ण स्क्रिप्ट के इरादों का विश्लेषण, पहचान और व्याख्या कर सकें। परिणाम प्रभावशाली थे, जिन्होंने मैलवेयर विश्लेषण में तेजी लाने और इन खतरों को समझने की हमारी क्षमता को बढ़ाने में AI की शक्ति दिखाई।
मैलवेयर विश्लेषण से परे, AI का उपयोग अन्य महत्वपूर्ण साइबर सुरक्षा चुनौतियों—जैसे थ्रेट इंटेलिजेंस, घटना प्रतिक्रिया, और भेद्यता प्रबंधन—से निपटने में अत्यधिक संभावनाएँ रखता है।
जानें कि AI आपके संगठन को कैसे प्रभावित कर सकता है और सफल AI रणनीतियाँ कैसे लागू करें, हमारे श्वेतपत्र The Learning Leader's Guide to AI Literacy के साथ।
साइबर सुरक्षा में AI की जरूरत क्यों है?
बदलते साइबर सुरक्षा परिदृश्य में, कुछ कार्य केवल उदाहरणों से ही ठीक से परिभाषित किए जा सकते हैं। उदाहरण के लिए, नेटवर्क ट्रैफ़िक में विसंगति क्या होती है, इसे सटीक रूप से परिभाषित करना कठिन है। हम सामान्य और असामान्य नेटवर्क ट्रैफ़िक के इनपुट और आउटपुट युग्म तो निर्दिष्ट कर सकते हैं, लेकिन इनपुट (नेटवर्क ट्रैफ़िक) और वांछित आउटपुट (सामान्य या असामान्य) के बीच संक्षिप्त संबंध नहीं।
एक बड़ी चुनौती यह भी है कि साइबर सुरक्षा उपकरणों को लगातार फिर से डिजाइन करना पड़ता है ताकि वे गतिशील परिदृश्य के अनुकूल हो सकें, साथ ही विशाल डाटासेट से अंतर्दृष्टि निकालने का भारी काम। एकल थ्रेट एक्टर से जुड़ी प्रतीत होने वाली असंबद्ध गतिविधियों को जोड़ने वाली ओवरलैपिंग रणनीतियों, तकनीकों और प्रक्रियाओं (TTPs) की पहचान प्रभावी थ्रेट इंटेलिजेंस के लिए महत्वपूर्ण है।
हमें ऐसे दृष्टिकोण की आवश्यकता है जो साइबर सुरक्षा नमूनों में निहित इनपुट और आउटपुट के संबंध का सही मॉडलिंग करे, संबंधित साइबर सुरक्षा ज्ञान का बड़ा हिस्सा ट्रैक कर सके और विशाल डेटा में छिपे संबंधों व सहसंबंधों को निकालने में उत्कृष्ट हो। यहीं पर मशीन लर्निंग (ML), जो AI एल्गोरिद्म का एक उपसमूह है, काम आती है।