
कोर्स
LangChain के साथ LLM एप्लिकेशन विकसित करना
3 घंटा
51.3K
कल्पना कीजिए कि आप एक दोस्त को लंबी कहानी सुना रहे हैं, और पंचलाइन तक पहुंचते-पहुंचते उसे शुरुआत ही याद नहीं रहती। जब AI की “शॉर्ट-टर्म मेमोरी” खत्म हो जाती है, तो यही झुंझलाहट होती है—उसे नए इनपुट के लिए जगह बनाने हेतु अहम विवरण छोड़ने पड़ते हैं।
बड़े भाषा मॉडल (LLMs) की दुनिया में, इस ध्यान अवधि को संदर्भ विंडो परिभाषित करती है।
जैसे-जैसे मॉडल अधिक सक्षम होते हैं और संदर्भ आकार बढ़ते हैं, इन विंडो के काम करने का तरीका समझना विश्वसनीय और स्केलेबल AI सिस्टम बनाने के लिए अहम हो जाता है। इस गाइड में, हम संदर्भ विंडो की बुनियादी बातें, उन्हें बढ़ाने के समझौते, और उन्हें प्रभावी ढंग से इस्तेमाल करने की रणनीतियाँ समझेंगे।
सिद्धांत से आगे बढ़कर वास्तविक Python अनुप्रयोगों में संदर्भ सीमाएँ कैसे संभालें, यह सीखने के लिए हमारा Developing LLM Applications with LangChain कोर्स देखें।
किसी AI मॉडल की संदर्भ विंडो यह निर्धारित करती है कि उत्तर तैयार करते समय वह अपनी कार्यशील मेमोरी में कितना पाठ रख सकता है। यह सीमा तय करती है कि बिना पिछली बातों का विवरण भूले बातचीत कितनी देर तक चल सकती है।
आप इसे इंसान की अल्पकालिक स्मृति की तरह समझ सकते हैं। यह पिछली बातचीत की सूचनाएँ अस्थायी रूप से संचित करती है ताकि मौजूदा कार्य में काम आ सकें।
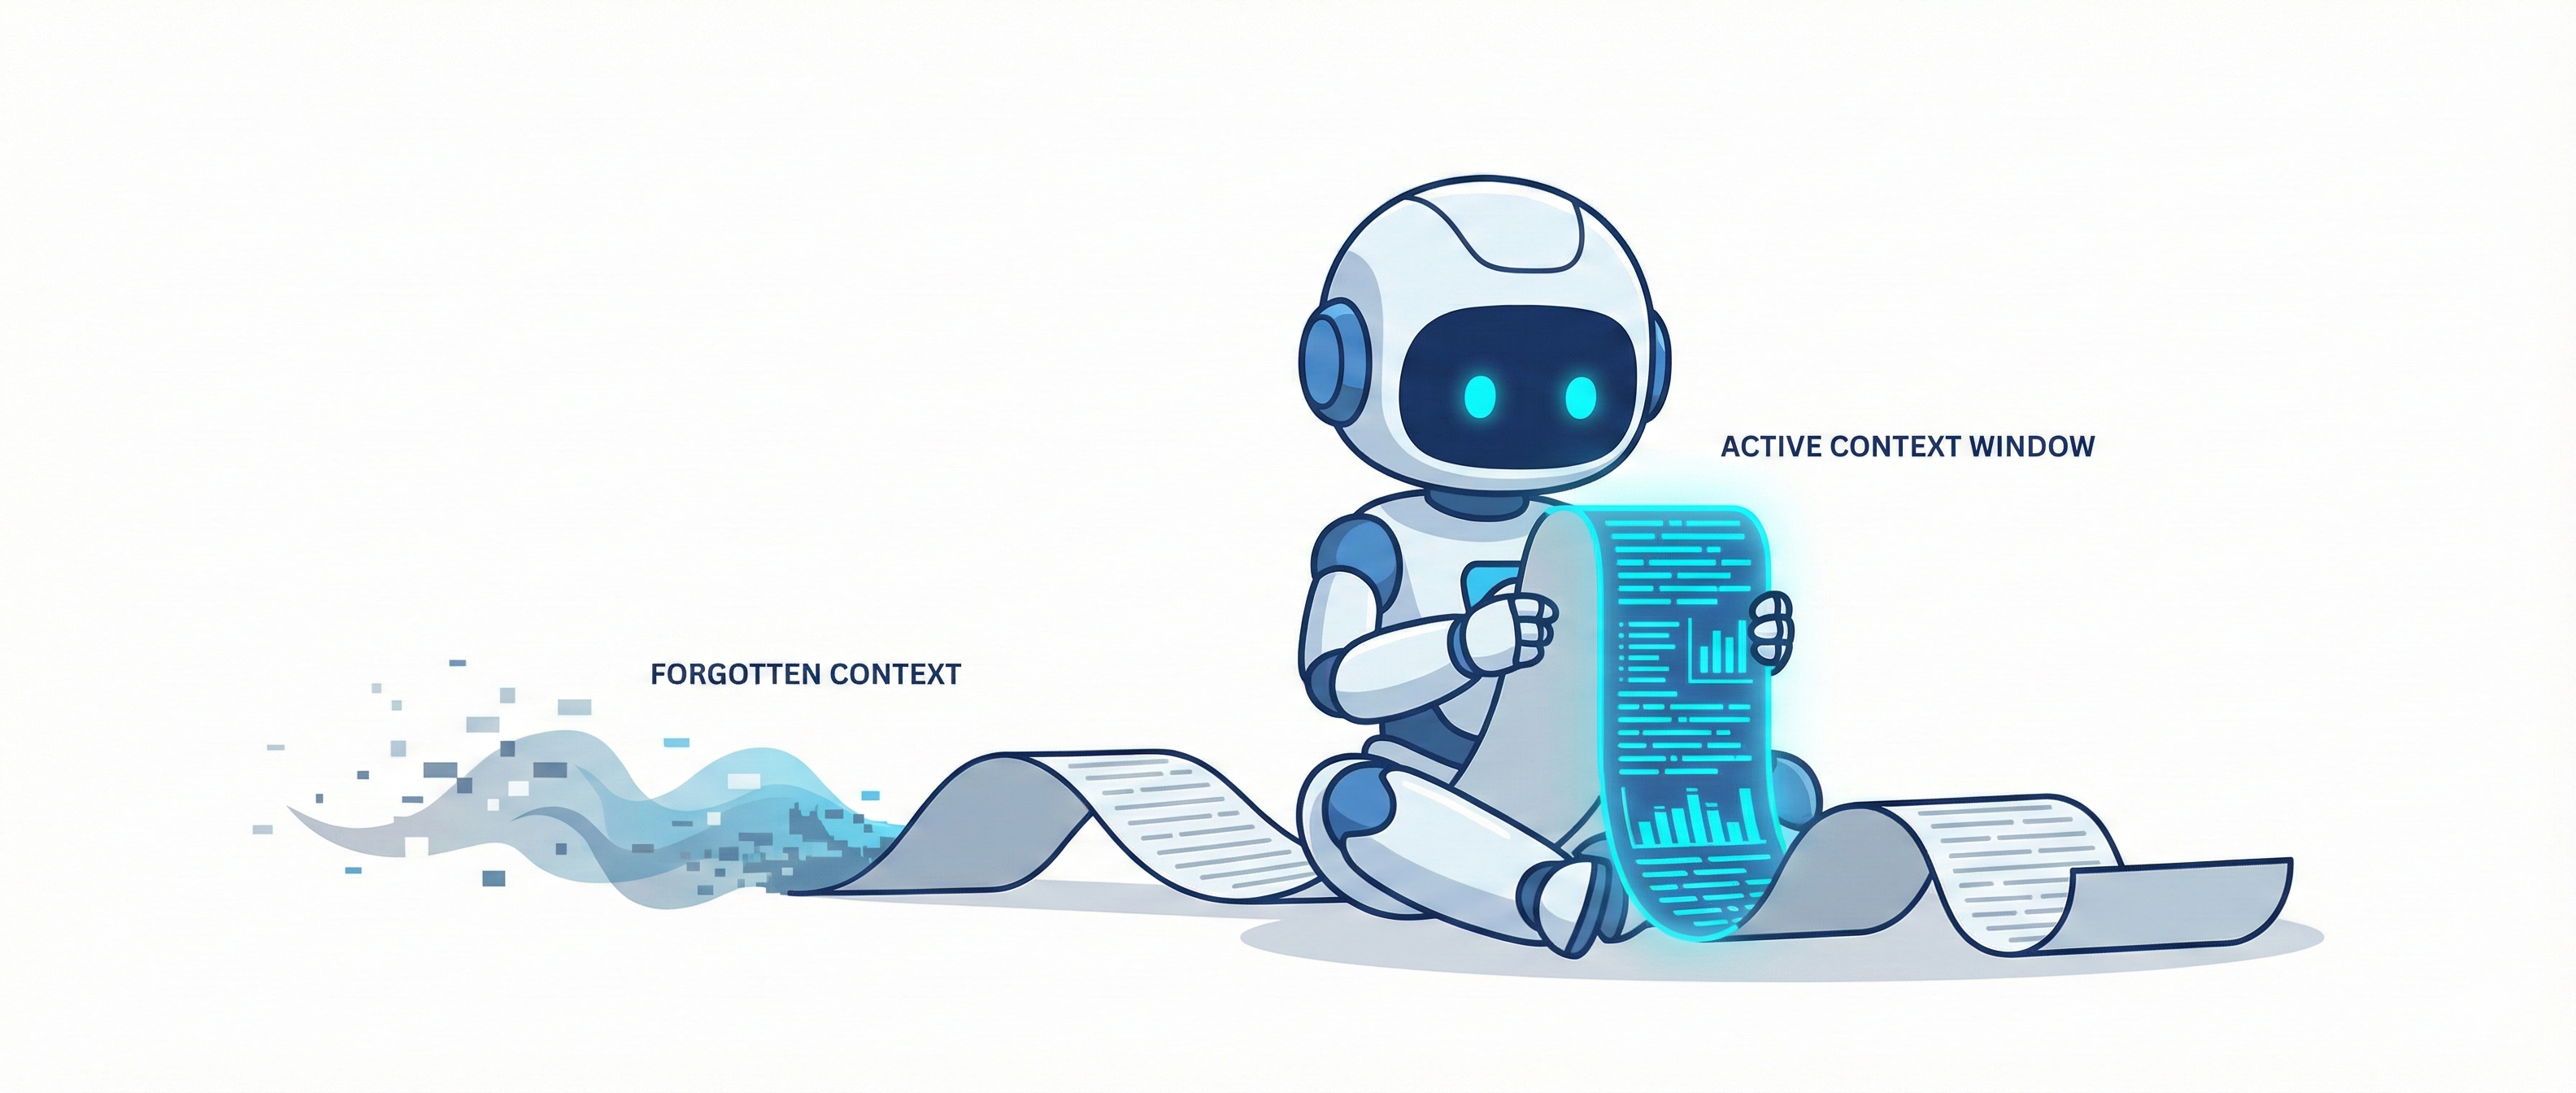
संदर्भ विंडो तर्क की गुणवत्ता, बातचीत की गहराई, और प्रतिक्रियाओं को निजीकरण करने की मॉडल की क्षमता सहित कई पहलुओं को प्रभावित करती है। यह एक बार में संसाधित किए जा सकने वाले इनपुट के अधिकतम आकार को भी निर्धारित करती है। जब कोई प्रॉम्प्ट या बातचीत का संदर्भ इस सीमा से आगे बढ़ जाता है, तो मॉडल जगह बनाने के लिए पाठ के शुरुआती हिस्सों को काट देता है (ट्रंकेट करता है)।
एकदम साफ तस्वीर पाने के लिए, आइए AI मॉडलों और संदर्भ विंडो से जुड़े कुछ बुनियादी सिद्धांतों पर नज़र डालें।
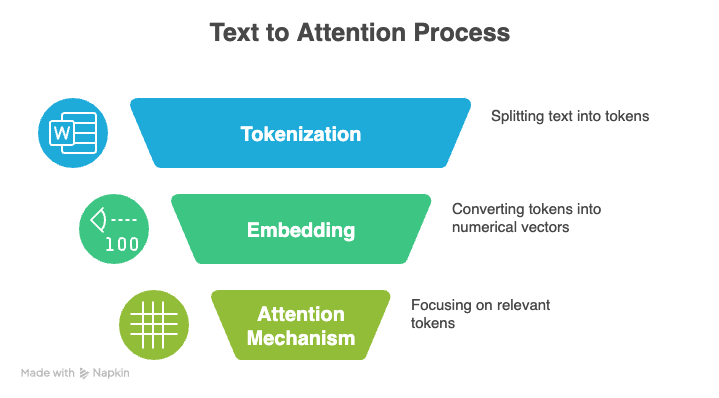
LLMs तीन मुख्य अवधारणाओं पर आधारित होते हैं: टोकनाइज़ेशन, अटेंशन मैकेनिज़्म, और पोज़ीशनल एनकोडिंग।
टोकनाइज़ेशन कच्चे पाठ को छोटे-छोटे घटकों या टोकन की श्रंखला में बदलने की प्रक्रिया है, जिसे LLM संसाधित कर सके। ये टोकन पूरे शब्द, अलग-अलग अक्षर, या आंशिक ध्वन्यात्मक इकाइयाँ भी हो सकते हैं। सामूहिक रूप से, मॉडल द्वारा पहचाने जाने वाले सभी अद्वितीय टोकनों के समूह को उसका शब्दकोश (वोकैबुलरी) कहा जाता है।
उदाहरण के लिए, वाक्य “Hello, world” को [“Hello”, “,”, “ world”] में टोकनाइज़ किया जा सकता है।
ट्रेनिंग या इन्फरेंस के दौरान, हर टोकन को एक अद्वितीय पूर्णांक में बदला जाता है, और मॉडल मूल पाठ के बजाय इन्हीं संख्याओं को पढ़ता है। यह संख्यात्मक अनुक्रम का विश्लेषण करता है, सीखता है कि टोकन एक-दूसरे से कैसे संबंधित हैं, और अगले संभावित टोकन की भविष्यवाणी करके नया पाठ उत्पन्न करता है।
कुशल टोकनाइज़ेशन इस बात में बड़ी भूमिका निभाता है कि किसी मॉडल की संदर्भ विंडो में कितनी जानकारी समा सकती है। जब कोई टोकनाइज़र पाठ को कम टोकनों में व्यक्त कर पाता है, तो उसी विंडो में अधिक सामग्री फिट हो जाती है।
वे टोकनाइज़र खास तौर पर प्रभावी होते हैं जो आम शब्दों या वाक्यांशों को एकल टोकन के रूप में दर्शाते हैं, क्योंकि वे टोकन संख्या घटाते हैं और मॉडल को अपनी संदर्भ सीमा के भीतर लंबी दस्तावेज़ी सामग्री संभालने देते हैं।
कथित अटेंशन मैकेनिज़्म आधुनिक LLMs की दूसरी नींव है। यह मॉडल को आउटपुट बनाते समय अपने इनपुट के सबसे प्रासंगिक हिस्सों पर ध्यान केंद्रित करने में मदद करता है।
हर टोकन को समान न मानकर, मॉडल वर्तमान अभिव्यक्ति की तुलना अन्य सभी टोकन अभिव्यक्तियों से करता है और हर तुलना को एक स्कोर देता है। यह चयनात्मक वेटिंग मॉडल को लंबी श्रंखलाएँ संसाधित करने और संदर्भ को अधिक प्रभावी ढंग से समझने देती है।
अटेंशन तीन घटकों के इर्द-गिर्द बनी है: क्वेरीज़, कीज़, और वैल्यूज़।
Queries: वर्तमान टोकन द्वारा भेजा गया वह संकेत जो शृंखला के बाकी हिस्से में प्रासंगिक जानकारी “खोजता” है।
Keys: शृंखला में प्रत्येक टोकन का पहचानकर्ता, जो तय करता है कि वह खोज संकेत से कितना मेल खाता है।
Values: वास्तविक सूचना-सामग्री, जिसे किसी Query और Key के मेल खाने पर प्राप्त किया जाता है और इस्तेमाल होता है।
मॉडल क्वेरियों और कीज़ के बीच समानता स्कोर की गणना करता है, उन स्कोरों को softmax सक्रियण फ़ंक्शन से वेट्स में बदलता है, और फिर अंतिम आउटपुट वैल्यूज़ के वेटेड सम के रूप में उत्पन्न करता है।
सेल्फ-अटेंशन वर्तमान टोकन की तुलना शृंखला के हर अन्य टोकन से करता है। इससे द्विघात कम्प्यूटेशनल लागत बनती है: संदर्भ विंडो को दोगुना करने से आवश्यक प्रसंस्करण शक्ति और मेमोरी चार गुना हो जाती है।
जैसे-जैसे संदर्भ विंडो बढ़ती हैं, लागत तेज़ी से बढ़ती है, इसलिए गणना को संभालने योग्य रखने के लिए मॉडल स्पार्स अटेंशन, लो-रैंक एप्रॉक्सिमेशन, या चंकिंग जैसी ऑप्टिमाइज़ेशन पर निर्भर रहते हैं।
ट्रांसफॉर्मर्स, जो आधुनिक भाषा मॉडलों को शक्ति देते हैं, स्वाभाविक रूप से टोकनों के क्रम को नहीं समझते। इसके बजाय, वे इस जानकारी को शामिल करने के लिए पोज़ीशनल एनकोडिंग पर निर्भर रहते हैं।
पोज़ीशनल एनकोडिंग हर टोकन में एक छोटा-सा संकेत जोड़ती है, जो मॉडल को दूरी और सापेक्ष व्यवस्था समझने में मदद करता है।
स्थितिजन्य जानकारी की विशिष्ट विधि यह भी तय करती है कि मॉडल शृंखला के भीतर संबंधों को कितनी दूर तक विश्वसनीय रूप से ट्रैक कर सकता है—जो उसकी संदर्भ विंडो के आकार और प्रभावशीलता को परिभाषित करती है। आइए कुछ लोकप्रिय तरीकों की तुलना करें:
Absolute Positional Embeddings: मॉडल शृंखला में प्रत्येक स्थिति के लिए अलग वेक्टर सीखता है, जैसे हर टोकन को एक तय पता मिलना। यह छोटे अनुक्रमों के लिए काम करता है, लेकिन ट्रेनिंग से परे स्थितियों को मॉडल संभाल नहीं पाता, जिससे संदर्भ विंडो का विस्तार कठिन हो जाता है।
Sinusoidal Encodings: स्थितियाँ दोहरती साइन और कोसाइन तरंगों का उपयोग करके एन्कोड होती हैं, जो स्थान के आधार पर हर टोकन को एक अद्वितीय पैटर्न देती हैं। ये एब्सोल्यूट एम्बेडिंग्स से लंबाइयों के लिए बेहतर सामान्यीकरण करती हैं, हालांकि अत्यंत लंबी श्रंखलाओं पर कम स्थिर हो सकती हैं।
Relative Positional Encodings: सटीक स्थिति चिह्नित करने के बजाय, मॉडल टोकनों के बीच की दूरी सीखता है। यह लंबी श्रंखलाओं तक सामान्यीकरण में मदद करता है, पर कुल संदर्भ सीमा फिर भी आर्किटेक्चर और मेमोरी पर निर्भर रहती है।
Rotary Positional Embeddings (RoPE): RoPE प्रत्येक टोकन के वेक्टर प्रतिनिधित्व को उसकी एब्सोल्यूट स्थिति के आधार पर घुमाकर दूरी की गणना करता है। यह तरीका श्रंखला बढ़ने पर स्थिर रहता है और बहुत बड़ी संदर्भ विंडो का समर्थन करता है।
ALiBi (Attention Linear Biases): ALiBi अटेंशन मैकेनिज़्म के भीतर दूरी-आधारित सरल बायस लगाता है, जिससे नज़दीकी टोकनों को स्वाभाविक रूप से अधिक वेट मिलता है। यह लंबी श्रंखलाओं तक अच्छी तरह स्केल करता है।
विस्तृत अवलोकन के लिए मैं यह ट्यूटोरियल देखने की सलाह देता/देती हूँ: ट्रांसफॉर्मर्स कैसे काम करते हैं।
यदि संदर्भ, संदर्भ विंडो से बड़ा हो जाए, तो मॉडल शुरुआती हिस्से को काट सकता है या अनदेखा कर सकता है, जिससे महत्वपूर्ण संदर्भ खो सकता है। यही कारण है कि शोधकर्ता लगातार इन सीमाओं को आगे बढ़ाने और लंबी संदर्भ विंडो सक्षम करने के लिए नई तकनीकों के साथ प्रयोग करते हैं।
2022 तक, OpenAI के GPT मॉडल परिदृश्य पर हावी थे। 2018 में जारी पहला GPT मॉडल 512-टोकन विंडो का समर्थन करता था। 2019 और 2020 के अगले दो संस्करणों ने हर बार यह सीमा दोगुनी की, और GPT-3 के लिए 2,048 टोकन तक पहुँची। इसके बाद के मॉडलों ने इन सीमाओं को बढ़ाते हुए एक मिलियन टोकन (GPT-4.1) तक कर दिया।
हाल में, OpenAI की टक्कर प्रतिस्पर्धियों से हुई—कहीं-कहीं पीछे भी रह गया। Google के Gemini 2.5 और 3 Pro संस्करण भी एक मिलियन टोकन तक की विंडो का समर्थन करते हैं, जिससे पूरी किताबें, बड़े कोडबेस, और बहु-दस्तावेज़ कार्य एक ही पास में प्रोसेस करना संभव हो जाता है।
Anthropic की Claude Sonnet 4.5 शृंखला वर्तमान में उसी संदर्भ विंडो आकार का बीटा में परीक्षण कर रही है, जो मूल 200,000 टोकन से विस्तारित है।
Llama और Mistral जैसी ओपन-सोर्स मॉडल परिवार आम तौर पर 100k से 200k की रेंज में आते हैं—लंबे संदर्भ पर सम्मानजनक प्रदर्शन देते हुए भी उन्हें स्थानीय रूप से परिनियोजित करना या फाइन-ट्यून करना व्यावहारिक रहता है।
उल्लेखनीय अपवादों में Llama Maverick शामिल है, जो लंबे दस्तावेज़ों पर सामान्य प्रयोजन तर्क के लिए 1 मिलियन टोकन विंडो का समर्थन करता है। वहीं, Llama Scout इससे भी आगे बढ़कर 10 मिलियन टोकन की विशाल क्षमता तक जाता है, जिसे विशेष रूप से पूरे कोडबेस या कानूनी अभिलेखागार को एक ही पास में प्रोसेस करने के लिए इंजीनियर किया गया है।
हालाँकि, इसी हफ्ते जारी GPT-5.2 ने रणनीति में बदलाव का संकेत दिया। अनंत संदर्भ की होड़ के बजाय, OpenAI ने अपने नवीनतम फ़्लैगशिप को 400,000-टोकन विंडो तक सीमित रखा, कच्चे आकार की जगह ‘परफेक्ट रिकॉल’ और बेहतर तर्क क्षमताओं को प्राथमिकता दी—जो बड़े मॉडलों में आम ध्यान-भंग मुद्दों से बचती हैं।
संदर्भ विंडो आकारों का अंतर वास्तविक कार्यप्रवाहों में हर मॉडल के प्रदर्शन को आकार देता है। बढ़ी हुई संदर्भ विंडो उच्च सटीकता, सामंजस्य, और दूरगामी तर्क को सक्षम करती हैं, लेकिन साथ ही अधिक गणना और अधिक सावधानीपूर्ण संदर्भ चयन की माँग करती हैं।
मध्यम-श्रेणी के मॉडल कुशल बने रहते हैं और लंबे दस्तावेज़ व विस्तारित चैट भी संभाल लेते हैं—हालाँकि बहुत बड़े इनपुट के लिए सही संरचना की ज़रूरत पड़ती है।
निम्नलिखित उपयोग-प्रकरण दिखाते हैं कि बड़ी संदर्भ विंडो वाले मॉडलों की ताकतें वास्तविक दुनिया के अनुप्रयोगों में कैसे उभरती हैं।
जब एक मॉडल के पास पूरे रिपोर्ट, ट्रांसक्रिप्ट, कोडबेस, या रिसर्च पेपर एक साथ रखने की पर्याप्त जगह होती है, तो वह पैटर्न ट्रैक कर सकता है, दूर-दूर की बातों को जोड़ सकता है, और शुरुआत से अंत तक एक सुसंगत समझ बनाए रख सकता है। इससे कई क्षेत्रों में उपयोग के अवसर खुलते हैं:
कानून: बड़ी विंडो मॉडल को पूरे कॉन्ट्रैक्ट का विश्लेषण करने, कई दस्तावेज़ों में क्लॉज़ की तुलना करने, और लंबे दस्तावेज़ों में छिपे संदर्भों को ट्रैक करने देती हैं।
स्वास्थ्य सेवा: टीमें विस्तृत नैदानिक दिशानिर्देश, रोगी इतिहास, या बहु-अध्ययन डेटासेट की समीक्षा कर सकती हैं, जबकि वह संदर्भ सुरक्षित रहता है जिसे छोटी विंडो छोड़ देतीं।
अनुसंधान: बड़ी-विंडो मॉडल एक ही पास में पूरे पेपर और साहित्य समीक्षाएँ पढ़ सकता है और वे कड़ियाँ सतह पर ला सकता है जो केवल पूरे दस्तावेज़ को देखने पर दिखती हैं।
बड़ी संदर्भ विंडो संवादी AI को अधिक स्वाभाविक बनाती हैं, क्योंकि मॉडल बातचीत के अधिक हिस्से को बिना शुरुआती संदेश भूले याद रख सकता है।
कस्टमर सर्विस में, इससे बातचीत अधिक सुगम और व्यक्तिगत बनती है। मॉडल पिछले रुझानों और पूर्व वार्तालापों का इस्तेमाल करके अधिक सटीक और प्रासंगिक उत्तर दे सकता है।
विस्तारित संदर्भ विंडो पाठ, ऑडियो और दृश्य सामग्री के बीच जटिल तर्क का समर्थन करती हैं, क्योंकि मॉडल के पास सभी माध्यमों को साथ रखने की पर्याप्त जगह होती है—उन्हें अलग-अलग संसाधित करने के बजाय।
जब पूरा ट्रांसक्रिप्ट, विज़ुअल फ़्रेम, और संबंधित लिखित सामग्री एक ही विंडो में समा जाती है, तो मॉडल फ़ॉर्मैट्स के आर-पार विवरणों की तुलना कर सकता है, संबंधों को ट्रैक कर सकता है, और संदर्भ की एकीकृत समझ बना सकता है।
यह उन खाइयों को पाट देता है जो तब उत्पन्न होती हैं जब जानकारी को चंक्स में बाँटना या सारांशित करना पड़ता है, और मॉडल को एक साथ पूरे इनपुट सेट पर तर्क करने देता है।
बड़ी संदर्भ विंडो शक्तिशाली क्षमताएँ खोलती हैं, लेकिन इनपुट आकार बढ़ने पर नए प्रदर्शन-संबंधी चुनौतियाँ भी लाती हैं। उन्नत मॉडल भी अत्यंत लंबी श्रंखलाओं में परिपूर्ण ध्यान बनाए रखने में संघर्ष करते हैं, इसलिए वे हमेशा संदर्भ के हर हिस्से से जानकारी उतनी विश्वसनीयता से नहीं उठाते जितनी आप अपेक्षा करते हैं।
लंबे-संदर्भ मॉडलों में एक आम मुद्दा “बीच में खो जाना” है। मॉडल लंबी श्रंखला की शुरुआत और अंत को ठीक-ठाक याद रखते हैं, पर बीच में दबे अहम विवरण अक्सर छूट जाते हैं या अनदेखे रह जाते हैं। इससे उत्तर कमजोर हो सकते हैं, भले ही पूरा संदर्भ उपलब्ध हो।
महत्वपूर्ण कार्यों के लिए इनपुट को स्मार्ट तरीके से संरचित करना इस समस्या से बचने में मदद करता है—जैसे इसे साफ़ सेक्शनों में बाँटना या मुख्य बिंदुओं को दोहराना ताकि मॉडल उन्हें नज़रअंदाज़ न करे।
संदर्भ विंडो का आकार बढ़ने के साथ लागत तेज़ी से बढ़ सकती है। हर अतिरिक्त टोकन अटेंशन गणना का आकार बढ़ाता है, जिससे इन्फरेंस समय, GPU मेमोरी आवश्यकताएँ, और समग्र सिस्टम लोड बढ़ता है।
इसे संभालने के लिए मॉडल को जानकारी खिलाने के अधिक प्रभावी तरीके चाहिए। चयनात्मक रिट्रीवल, अनुक्रमिक (हायरार्किकल) चंकिंग, या त्वरित सारांश जैसी तकनीकें इनपुट को छोटा रखती हैं ताकि मॉडल ओवरलोड न हो।
बड़ी विंडो सुरक्षा और गोपनीयता से जुड़ी चिंताएँ भी लाती हैं। जब आप मॉडल को अधिक इनपुट देते हैं, तो संवेदनशील डेटा उजागर होने की संभावना बढ़ जाती है।
इसीलिए टीमों को ठोस डेटा-हैंडलिंग नियम, रिडैक्शन चरण, और एक्सेस कंट्रोल लागू करने चाहिए ताकि बड़ी संदर्भ विंडो नए जोखिम न पैदा करें।
अक्सर, अनावश्यक या ढीले-ढाले तौर पर संबंधित जानकारी मॉडल के लिए संज्ञानात्मक बोझ बढ़ा देती है, जिससे भ्रम (हैलुसिनेशन) और गलत पैटर्न का जोखिम बढ़ता है। लंबे इनपुट शोर भी लाते हैं, जो कार्य की समझ को विकृत कर सकते हैं।
व्यवहार में, उच्च-गुणवत्ता प्रदर्शन अक्सर सावधानी से क्यूरेट किए गए संदर्भ से आता है—यह सुनिश्चित करते हुए कि मॉडल सबसे अधिक मात्रा नहीं, बल्कि सही जानकारी देखे।
संदर्भ विंडो का सर्वोत्तम उपयोग करने के लिए कई तरीके अपनाए जा सकते हैं—जैसे Retrieval Augmented Generation (RAG), संदर्भ इंजीनियरिंग, चंकिंग, और उपयुक्त मॉडल चयन।
रिट्रीवल ऑगमेंटेड जनरेशन (RAG) तब काम करता है जब ज़रूरत हो, तो किसी बाहरी डेटाबेस से अतिरिक्त जानकारी खींचकर मॉडल को खिलाता है।
पूरे दस्तावेज़ को संदर्भ विंडो में ठूंसने के बजाय, RAG सब कुछ अलग से सहेजता है और मौजूदा प्रश्न के लिए केवल प्रासंगिक हिस्से लाता है। इस तरह संदर्भ छोटा रहता है, फिर भी मॉडल को ज़रूरी जानकारी मिल जाती है।
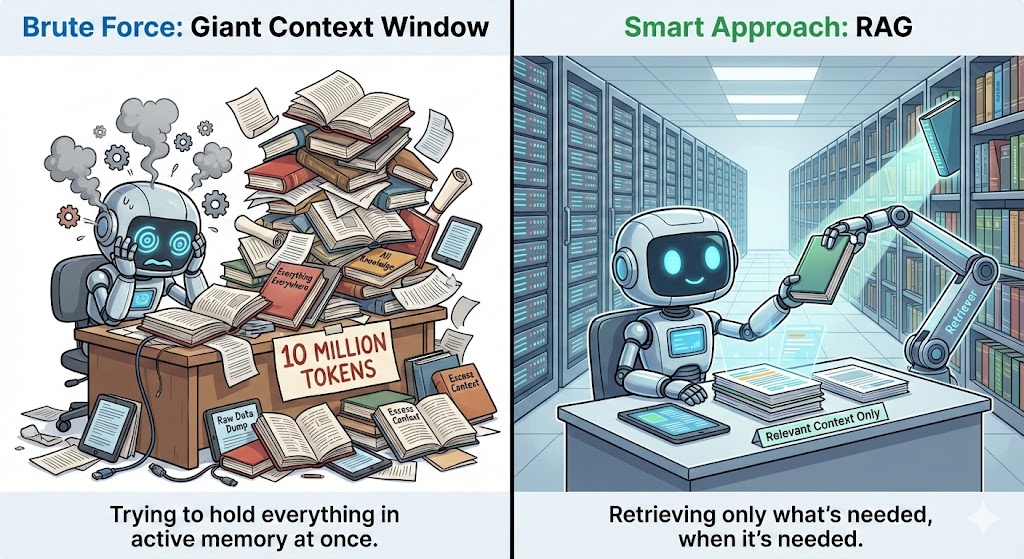
यह एम्बेडिंग या वेक्टर सर्च का उपयोग करके सबसे प्रासंगिक चंक्स ढूँढता है और उन्हें साफ़-सुथरे, संरचित तरीके से मॉडल तक पहुँचाता है। इससे सटीकता बढ़ती है क्योंकि मॉडल अपने प्रशिक्षण डेटा से आगे की प्रासंगिक अतिरिक्त जानकारी का उपयोग कर पाता है।
संदर्भ इंजीनियरिंग अनावश्यक विवरणों से मॉडल को भर देने के बजाय उसे प्रासंगिक जानकारी देने पर केंद्रित रहती है। प्रभावी रणनीतियों में लंबे दस्तावेज़ों का विभाजन, कम-मूल्य वाले हिस्सों का सारांश, और प्रमुख बिंदुओं को उभारने के लिए हल्के प्रीप्रोसेसिंग कदम शामिल हैं।
सिमेंटिक सर्च वर्तमान क्वेरी के लिए महत्त्वपूर्ण पाठ पहचानने में मदद करती है। आप सबसे महत्वपूर्ण जानकारी को संदर्भ की शुरुआत या अंत में ले जाकर भी परिणाम सुधार सकते हैं, क्योंकि मॉडल प्रायः इन स्थानों को बेहतर याद रखते हैं।
चंकिंग लंबे दस्तावेज़ों को छोटे, सुसंगत हिस्सों में बाँटती है। विचार यह है कि सामग्री को उसके विषय, संरचना, या जिस कार्य का वह समर्थन करती है, उसके आधार पर समूहित किया जाए।
इससे हर चंक सुसंगत रहता है और मॉडल एक बड़े, अव्यवस्थित ब्लॉक में खोने के बजाय केंद्रित रहता है। अधिक जानना चाहें, तो उन्नत चंकिंग रणनीतियों पर यह लेख देखें।
सिमेंटिक चंकिंग यादृच्छिक कैरेक्टर सीमाओं पर कट लगाने के बजाय समान अर्थ साझा करने वाले वाक्यों को समूहित करती है। यह विषय परिवर्तन, पैराग्राफ संक्रमण, या सेक्शन हेडर जैसे प्राकृतिक ब्रेकपॉइंट्स पर पाठ को विभाजित करती है।
टास्क-आधारित चंकिंग इससे आगे बढ़कर हर चंक को उस विशेष प्रश्न के इर्द-गिर्द आकार देती है, जिसका आप उत्तर देना चाहते हैं। तब प्रत्येक सेक्शन में केवल वही जानकारी रहती है जो वास्तव में उस कार्य से संबंधित हो।
पूर्ण-दस्तावेज़ विश्लेषण, बहु-फ़ाइल तर्क, या लंबी बातचीत वाले कार्य 200k–1M विंडो वाले मॉडलों से लाभान्वित होते हैं। अधिक केंद्रित कार्यों—जैसे सारांशण, कोड समीक्षा, या लघु प्रश्नोत्तर—के लिए 100k–200k रेंज के मॉडल अक्सर गति, लागत, और सटीकता का बेहतर संतुलन देते हैं।
छोटी विंडो भी सशक्त रिट्रीवल सिस्टम के साथ अच्छा प्रदर्शन कर सकती हैं। एक अच्छा RAG सिस्टम या Model Context Protocol (MCP) ज़रूरत पड़ने पर सही जानकारी खींच सकता है, ताकि मॉडल को सब कुछ मेमोरी में रखने की ज़रूरत न पड़े।
समापन से पहले, आइए देखें कि संदर्भ विंडो के मामले में तकनीक किस दिशा में जा रही है।
भविष्य की मॉडल आर्किटेक्चर तय-आकार विंडो के बजाय डायनेमिक संदर्भ विंडो की ओर बढ़ रही हैं।
शोधकर्ता ऐसी विधियाँ खोज रहे हैं जो ट्रांसफॉर्मर की ताकतों को नए दूरगामी मेमोरी सिस्टम्स के साथ मिलाती हैं—ऐसे मॉडल बनाते हुए जो केवल अटेंशन मैकेनिज़्म पर निर्भर हुए बिना जानकारी को संग्रहीत और पुनःस्मरण कर सकें।
ये आर्किटेक्चर आज की सीमाएँ इस तरह पार करते हैं कि स्थिर संदर्भ विंडो से हटकर कार्य के साथ बढ़ने वाली डायनेमिक मेमोरी लेयर्स अपनाई जाती हैं।
मेमोरी सिस्टम एक और नवाचार क्षेत्र हैं। भविष्य के मॉडल एकल सत्र से परे फैले और समय के साथ निरंतरता प्रदान करने वाले संदर्भ-सचेत मेमोरी सिस्टम पर अधिक निर्भर रहने की उम्मीद है।
हर बातचीत को नई शुरुआत मानने के बजाय, ये सिस्टम प्रमुख प्राथमिकताएँ, पिछले निर्णय, और आवर्ती थीम्स को एक संरचित मेमोरी लेयर में सहेजते हैं, जिसे ज़रूरत पड़ने पर पुनः बुलाया जा सकता है।
इससे वैयक्तिकरण प्रतिक्रियात्मक से सक्रिय हो जाता है—मॉडल उपयोगकर्ताओं को अधिक समग्र रूप से समझ पाता है और दीर्घकालिक लक्ष्यों को अधिक स्थिरता के साथ समर्थन देता है।
बाहरी रिट्रीवल भी विकसित हो रहा है। फिलहाल, RAG एक सर्च इंजन की तरह काम करता है—प्रासंगिक पाठ को प्रॉम्प्ट में लाकर। उन्नत संस्करण, जैसे Corrective Retrieval-Augmented Generation (CRAG), पहले ही सामने आ चुके हैं, पर यह तो बस शुरुआत है।
भविष्य में, रिट्रीवल अधिक अंतर्निर्मित-सा लगेगा—मानो मॉडल की अपनी बाहरी मेमोरी हो। वे स्वतः जानकारी जुटाएँगे, संकुचित करेंगे, और न्यूनतम उपयोगकर्ता दखल के साथ फिर सतह पर लाएँगे।
स्थायी मेमोरी भी हमारे AI के साथ संवाद करने के तरीके को बदलेगी। सत्र समाप्त होने पर सब कुछ भूलने के बजाय, मॉडल दिन, हफ्तों, या महीनों तक अहम विवरण याद रखेगा। जैसे-जैसे वह आपकी शैली, आदतें, और प्राथमिकताएँ सीखता है, वह अधिक उपयुक्त और सहायक उत्तर दे सकेगा—वह भी बिना आपको खुद को दोहराने की ज़रूरत के।
उपकरण जैसे Mem0 पहले से ही इस दृष्टिकोण का अगुवा कर रहे हैं—एप्लिकेशन और LLMs के बीच एक समर्पित मेमोरी लेयर की तरह काम करते हुए। आगे देखते हुए, हमें उम्मीद है कि ये क्षमताएँ बाहरी लेयर्स पर निर्भर रहने के बजाय सीधे मॉडल आर्किटेक्चर में ही अधिकाधिक निर्मित होंगी।
बड़ी विंडो शक्तिशाली नए कार्यप्रवाह खोलती हैं, पर साथ ही ध्यान से जुड़ी चुनौतियाँ, अधिक कम्प्यूटेशनल लागत, और संदर्भ ओवरलोड होने पर गुणवत्ता जोखिम भी लाती हैं। इसलिए रणनीतिक संदर्भ प्रबंधन अनिवार्य है।
रिट्रीवल ऑगमेंटेशन, सिमेंटिक चंकिंग, और संदर्भ इंजीनियरिंग जैसी तकनीकें मॉडलों को उनकी क्षमता बढ़ने के बावजूद केंद्रित, कुशल, और विश्वसनीय बनाए रखती हैं।
आगे चलकर, सर्वश्रेष्ठ LLM-संचालित सिस्टम समझदार टूल्स और इस बोध का मेल होंगे कि संदर्भ तर्क को कैसे प्रभावित करता है। इन सिद्धांतों को लागू करके टीमें लंबे-संदर्भ मॉडलों के फायदे उठा सकती हैं—और अगली पीढ़ी की उन आर्किटेक्चर के लिए तैयार हो सकती हैं जो संदर्भ की सीमाएँ और आगे बढ़ाएँगी।
अपने Python बेसिक्स को अगले स्तर पर ले जाइए के साथ Developing Large Language Models स्किल ट्रैक। यह आपको बुनियादी कोड से लेकर अपने शक्तिशाली AI अनुप्रयोग बनाने और उन्हें फाइन-ट्यून करने तक मार्गदर्शन करने के लिए डिज़ाइन किया गया है।
LLM पाठ्यक्रम
कोर्स
लर्निंग पाथ
कोर्स