Last chance! 50% off DataCamp Premium
Sale ends in
यूक्लिडियन दूरी, जिसकी जड़ें प्राचीन ग्रीक गणित तक जाती हैं, आधुनिक डेटा साइंस, मशीन लर्निंग और स्थानिक विश्लेषण में एक आवश्यक उपकरण बन गई है। प्रसिद्ध यूक्लिड के नाम पर आधारित, यह मीट्रिक अंतरिक्ष में बिंदुओं के बीच सीधी रेखा की दूरी मापने का एक मूलभूत तरीका प्रदान करती है, चाहे वह दो आयाम हों या उससे अधिक।
यूक्लिडियन दूरी यूक्लिडियन स्पेस में दो बिंदुओं के बीच सबसे छोटा मार्ग दर्शाती है। यह वही दूरी है जिसे आप पैमाने से नापेंगे, बस इसे किसी भी संख्या के आयामों तक विस्तारित कर दिया गया है। यह अवधारणा पाइथागोरस प्रमेय में गहराई से निहित है, जो कहता है कि समकोण त्रिभुज में कर्ण की लंबाई का वर्ग अन्य दो भुजाओं के वर्गों के योग के बराबर होता है।

“दार्शनिक यूक्लिडियन दूरी सिखा रहा है।” छवि: Dall-E
आइए अलग-अलग आयामों के लिए यूक्लिडियन दूरी के सूत्र को समझें:
दो-आयामी समतल में, बिंदु A(x₁, y₁) और B(x₂, y₂) के बीच यूक्लिडियन दूरी इस प्रकार दी जाती है:
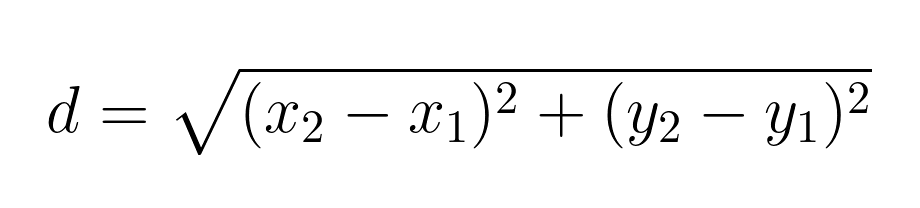
उदाहरण के लिए, बिंदु A(1, 2) और B(4, 6) के बीच दूरी निकालते हैं:
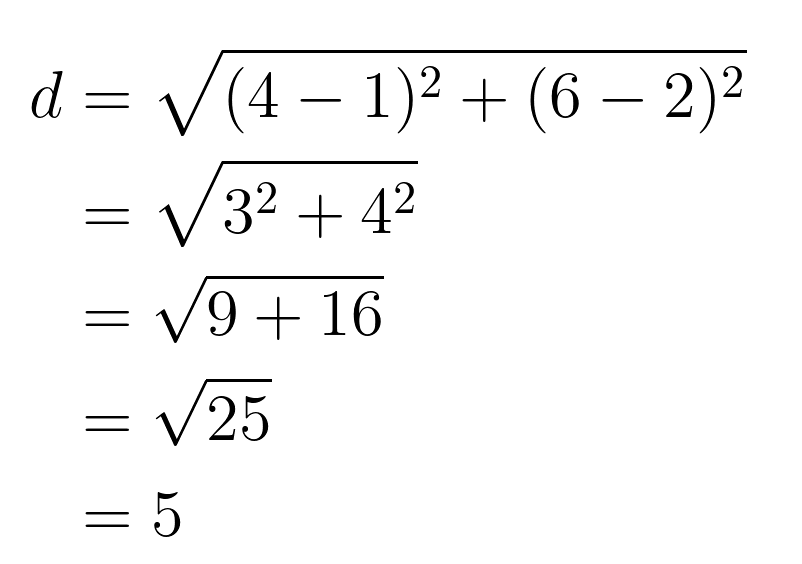
2D यूक्लिडियन दूरी को बेहतर समझने के लिए, इसे देखें:
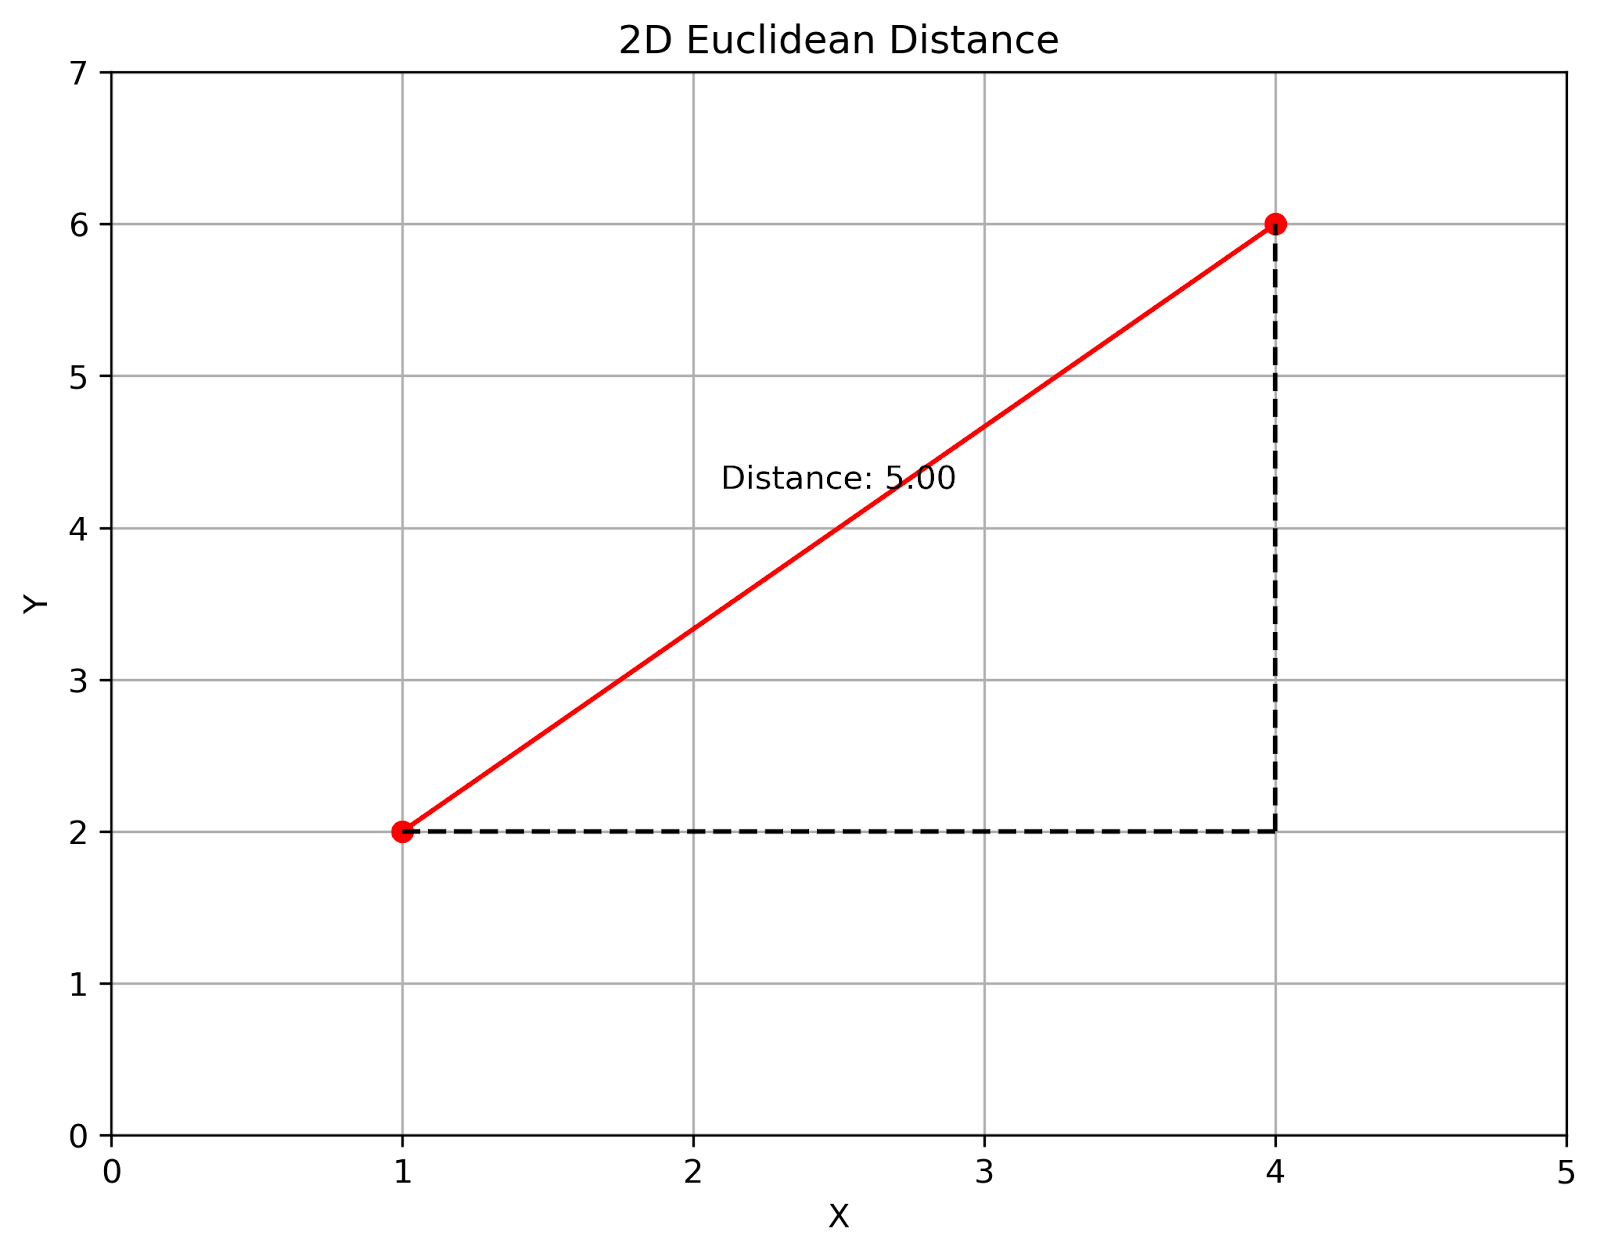
2D यूक्लिडियन दूरी। छवि: लेखक
यह विज़ुअलाइज़ेशन 2D समतल में दो बिंदुओं के बीच यूक्लिडियन दूरी दिखाता है। लाल रेखा प्रत्यक्ष दूरी दर्शाती है, जबकि बिंदीदार रेखाएँ समकोण त्रिभुज बनाती हैं, जो पाइथागोरस प्रमेय को क्रियान्वित होते दिखाती हैं।
तीन आयामों तक विस्तार करते हुए, बिंदु A(x₁, y₁, z₁) और B(x₂, y₂, z₂) के लिए सूत्र बनता है:
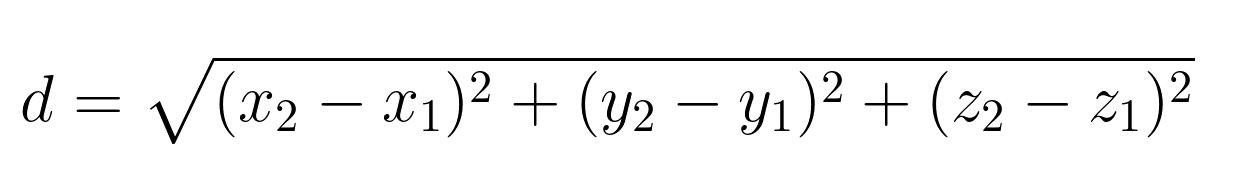
आइए 3D यूक्लिडियन दूरी को देखें:
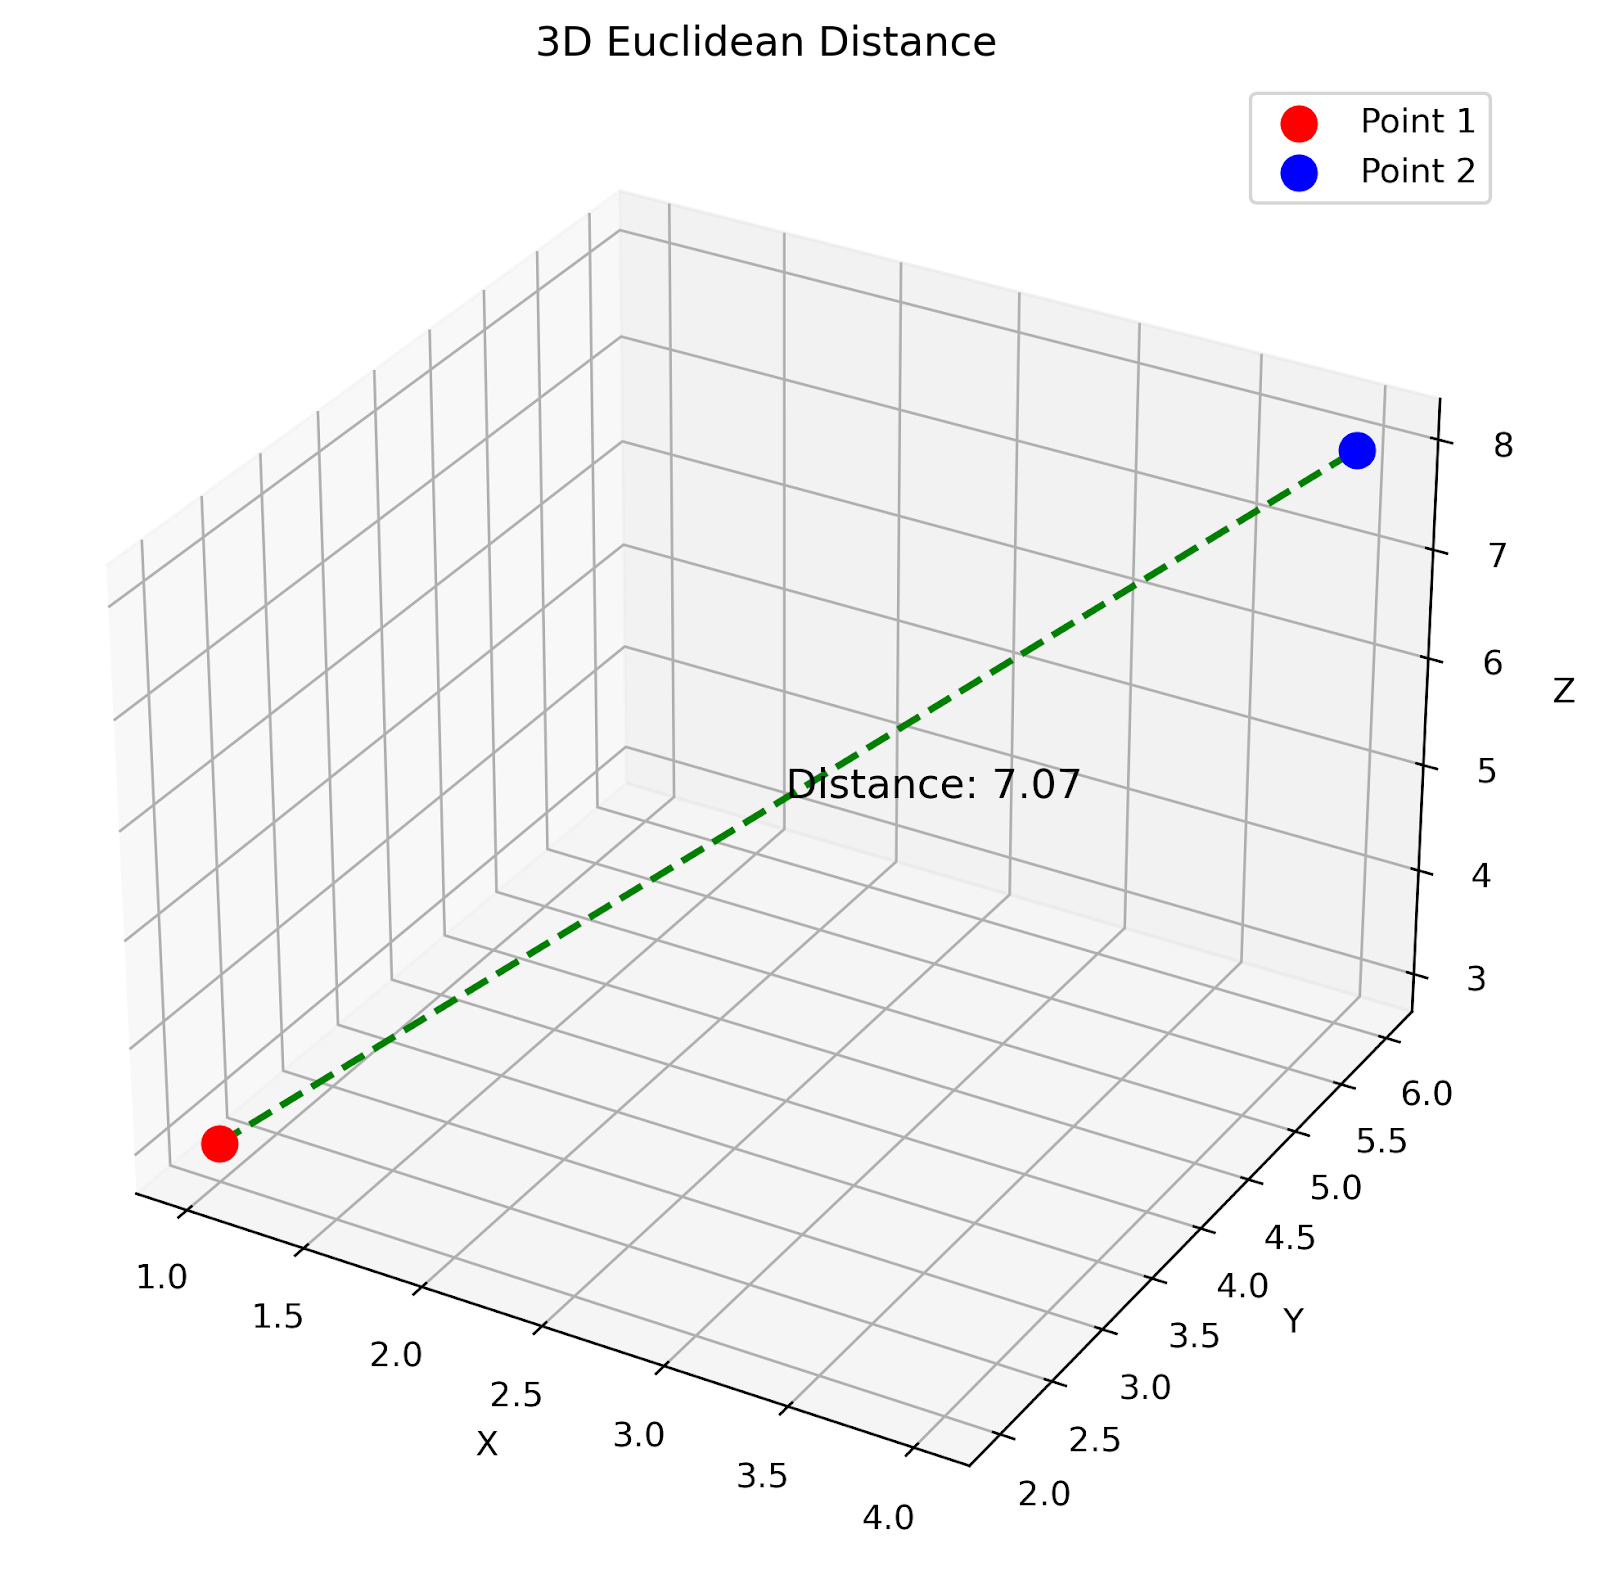
3D यूक्लिडियन दूरी। छवि: लेखक
यह 3D प्लॉट त्रि-आयामी स्पेस में दो बिंदुओं के बीच यूक्लिडियन दूरी दिखाता है। हरी बिंदीदार रेखा बिंदुओं के बीच प्रत्यक्ष दूरी दर्शाती है।
n आयामों वाले स्पेस में, बिंदु A(a₁, a₂, ..., aₙ) और B(b₁, b₂, ..., bₙ) के बीच यूक्लिडियन दूरी:
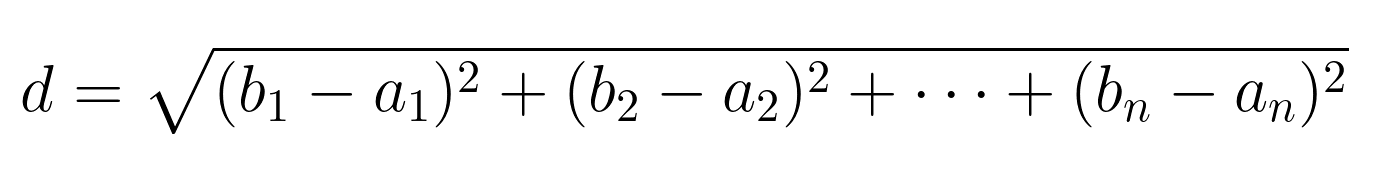
इसे जोड़-संकेत (summation) संकेतन से और संक्षेप में लिखा जा सकता है:
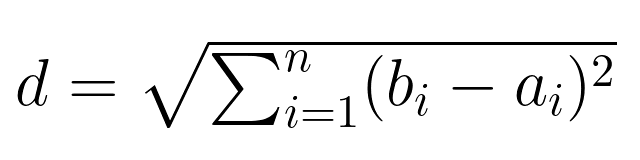
यूक्लिडियन दूरी को समझना केवल दो बिंदुओं के बीच सबसे छोटे मार्ग को मापना जानना ही नहीं है। यह इन दूरियों को रेखीय बीजगणित के दृष्टिकोण से देखना भी है—वह क्षेत्र जो वेक्टर और उनकी विशेषताओं का उपयोग करके स्पेस और आयामों से जुड़े समस्याओं का वर्णन और समाधान करता है। इस विषय पर और जानकारी के लिए, Linear Algebra for Data Science in R पाठ्यक्रम देखें, जो इन अवधारणाओं को व्यापक रूप से कवर करता है।
यूक्लिडियन दूरी बताती है कि स्पेस में दो बिंदु कितने दूर हैं। मान लीजिए आपके पास एक बिंदु पहाड़ी मार्ग की शुरुआत पर है और दूसरा पहाड़ी की चोटी पर। शुरुआत से चोटी तक सीधा रास्ता यूक्लिडियन दूरी जैसा है। रेखीय बीजगणित में, यह उस तीर (या वेक्टर) की लंबाई खोजने जैसा है जो मार्ग की शुरुआत (बिंदु A) से सीधे चोटी (बिंदु B) की ओर इशारा करता है। इस लंबाई को वेक्टर का "नॉर्म" कहा जाता है—यानी इस सीधी रेखा की लंबाई।
दिशाओं के संदर्भ में, डॉट प्रोडक्ट किसी भी दो तीरों के बीच कोण को समझने में मदद करता है। उदाहरण के लिए, यदि आप दो सड़कों के चौराहे पर हैं, तो डॉट प्रोडक्ट बताएगा कि एक सड़क दूसरी की ओर कितनी इशारा करती है। इसे प्रत्येक सड़क की लंबाई (जैसे नॉर्म) और उनके बीच के कोण का उपयोग कर निकाला जाता है। यह मान जितना 0 के करीब होगा, सड़कें उतनी ही परस्पर लम्बवत के करीब होंगी। दूरी से जोड़कर देखें तो, डॉट प्रोडक्ट का सूत्र यूक्लिडियन दूरी को ऐसे घटकों में बांटने में मदद करता है जिन्हें संभालना आसान हो, और दिखाता है कि दिशा में बदलाव कुल दूरी को कैसे प्रभावित करता है।
वेक्टरों का उपयोग करके दो बिंदुओं के बीच यूक्लिडियन दूरी निकालने के लिए, मूल रूप से आप एक बिंदु से दूसरे को घटाते हैं ताकि एक नया वेक्टर बने। यह नया वेक्टर सीधे एक बिंदु से दूसरे की ओर इशारा करता है और इसकी लंबाई ही वह यूक्लिडियन दूरी है जिसमें आपकी रुचि है। यह मानो मानचित्र पर आपके घर से निकटतम किराना स्टोर तक सीधा मार्ग बनाना हो—उनके निर्देशांक घटाने से आपको सीधी रेखा (या वेक्टर) मिलती है जो सबसे छोटा रास्ता दिखाती है।
आइए Python और R दोनों का उपयोग करके यूक्लिडियन दूरी की गणना के कार्यान्वयन देखें। हम कस्टम फ़ंक्शन बनाना और दक्षता बढ़ाने के लिए बिल्ट-इन लाइब्रेरी का उपयोग करना समझेंगे।
Python में, हम प्रभावी एरे ऑपरेशन्स के लिए NumPy और विशेष दूरी गणनाओं के लिए SciPy की शक्ति का उपयोग कर सकते हैं। यूक्लिडियन दूरी इस प्रकार लागू की जा सकती है:
import numpy as np
from scipy.spatial.distance import euclidean
def euclidean_distance(point1, point2):
return np.sqrt(np.sum((np.array(point1) - np.array(point2))**2))
# 2D example
point_a = (1, 2)
point_b = (4, 6)
distance_2d = euclidean_distance(point_a, point_b)
print(f"2D Euclidean distance: {distance_2d:.2f}")
# 3D example
point_c = (1, 2, 3)
point_d = (4, 6, 8)
distance_3d = euclidean_distance(point_c, point_d)
print(f"3D Euclidean distance: {distance_3d:.2f}")
# Using SciPy for efficiency
distance_scipy = euclidean(point_c, point_d)
print(f"3D Euclidean distance (SciPy): {distance_scipy:.2f}")
जब हम यह कोड चलाते हैं, तो हमें इस तरह का आउटपुट दिखेगा:
2D Euclidean distance: 5.00
3D Euclidean distance: 7.07
3D Euclidean distance (SciPy): 7.07
SciPy फ़ंक्शन आमतौर पर तेज़ और अधिक अनुकूलित होता है, विशेष रूप से उच्च-आयामी डेटा के लिए, लेकिन हमारा कस्टम फ़ंक्शन अंतर्निहित गणना को समझाने में मदद करता है।
R यूक्लिडियन दूरी की गणना के कई तरीके प्रदान करता है। हम एक कस्टम फ़ंक्शन बनाएंगे और उसकी तुलना stats लाइब्रेरी के dist() फ़ंक्शन से करेंगे।
euclidean_distance <- function(point1, point2) {
sqrt(sum((point1 - point2)^2))
}
# 2D example
point_a <- c(1, 2)
point_b <- c(4, 6)
distance_2d <- euclidean_distance(point_a, point_b)
print(paste("2D Euclidean distance:", round(distance_2d, 2)))
# 3D example
point_c <- c(1, 2, 3)
point_d <- c(4, 6, 8)
distance_3d <- euclidean_distance(point_c, point_d)
print(paste("3D Euclidean distance:", round(distance_3d, 2)))
# Using the dist() function from stats
distance_builtin <- stats::dist(rbind(point_c, point_d), method = "euclidean")
print(paste("3D Euclidean distance (built-in):", round(as.numeric(distance_builtin), 2)))
यह R कोड चलाने पर ऐसा आउटपुट मिलना चाहिए:
[1] "2D Euclidean distance: 5"
[1] "3D Euclidean distance: 7.07"
[1] "3D Euclidean distance (built-in): 7.07"
हमारा कस्टम euclidean_distance फ़ंक्शन R के वेक्टराइज़्ड ऑपरेशन्स का उपयोग करता है, जिससे यह संक्षिप्त और कुशल बनता है। stats का dist() फ़ंक्शन वही परिणाम देता है, जिससे हमारे कस्टम फ़ंक्शन की पुष्टि होती है। दोनों तरीकों से एक मैट्रिक्स मिलता है।
यूक्लिडियन दूरी चीज़ों के बीच दूरी मापने का एक सरल तरीका है। इसका उपयोग विभिन्न क्षेत्रों में स्पेस और दूरी से जुड़े समस्याओं को सुलझाने में किया जाता है।
k-nearest neighbors एल्गोरिथ्म में, यूक्लिडियन दूरी किसी बिंदु के सबसे नजदीकी पड़ोसी ढूंढने में मदद करती है। इससे नए डेटा का वर्गीकरण तय करने में सहायता मिलती है—जैसे समान ईमेल्स के आधार पर किसी ईमेल को स्पैम ठहराना, या ग्राहक की पसंद से मिलते-जुलते उत्पाद सुझाना।
k-means क्लस्टरिंग में, यूक्लिडियन दूरी डेटा बिंदुओं को समूहों में बाँटने में मदद करती है, प्रत्येक बिंदु को निकटतम क्लस्टर केंद्र से जोड़कर। इससे समानताओं वाले श्रेणीबद्ध समूह बनते हैं, जो ग्राहक विभाजन या शोध में समान विषयों को समूहित करने में उपयोगी है।
मल्टिडाइमेंशनल स्केलिंग जटिल डेटा को सरल बनाने के लिए यूक्लिडियन दूरी का उपयोग करती है, ताकि उसे देखना और समझना आसान हो जाए। यह अधिक आयामों वाले डेटा को घटाकर विश्लेषण के लिए सरल बनाती है, जिससे रुझान और पैटर्न अधिक स्पष्ट दिखते हैं।
छवियों में किनारे पहचानने या वस्तुओं को पहचानने जैसे कार्यों में, यूक्लिडियन दूरी पिक्सेल रंगों में बदलाव को मापती है, जो वस्तुओं की रूपरेखा बनाने या छवि में महत्त्वपूर्ण विशेषताएँ पहचानने में सहायक होती है। यह मेडिकल इमेजिंग में रोग पहचानने, या सुरक्षा प्रणालियों में चेहरे या वस्तुएँ पहचानने जैसी चीज़ों में मददगार है।
ड्रोन या सेल्फ-ड्राइविंग कार जैसे रोबोटों के लिए, यूक्लिडियन दूरी एक बिंदु से दूसरे तक का सबसे सरल मार्ग निकालने में मदद करती है। इससे रोबोट और अन्य स्वचालित प्रणालियाँ कुशलता और सुरक्षा के साथ चल पाती हैं, बाधाओं से बचते हुए अपने गंतव्य तक आसान रास्ते खोजती हैं।
यूक्लिडियन दूरी बिंदुओं के बीच दूरी मापने के कई तरीकों में से एक है, पर अलग-अलग परिदृश्यों में अलग विधियाँ बेहतर होती हैं। यहाँ इसकी तुलना अन्य सामान्य दूरी मीट्रिक्स से की गई है:
"सिटी ब्लॉक" दूरी के नाम से भी जानी जाने वाली मैनहट्टन दूरी प्रत्येक आयाम के साथ पूर्ण अंतरों के योग को मापती है। कल्पना करें कि आप शहर की जालीदार सड़कों पर चल रहे हैं; ब्लॉक-ब्लॉक चलते हुए तय की गई दूरी ही आपकी मैनहट्टन दूरी है। यह तरीका विशेष रूप से ग्रिड-जैसे परिवेशों में उपयोगी है, जैसे शहर में नेविगेशन या कुछ प्रकार के खेलों में। बहुत उच्च-आयामी डेटा के लिए भी यह उपयोगी हो सकता है, जहाँ यूक्लिडियन दूरी कम विश्वसनीय हो जाती है। और जानने के लिए हमारा Manhattan distance ट्यूटोरियल देखें।
कोसाइन दूरी दो बिंदुओं या वेक्टरों के बीच कोण को देखती है। उनके बीच की रेखा कितनी लंबी है इस पर ध्यान देने के बजाय, यह देखती है कि वे एक-दूसरे के सापेक्ष कैसे उन्मुख हैं। यही कारण है कि यह टेक्स्ट विश्लेषण या अनुशंसा प्रणालियों में विशेष रूप से उपयोगी है, जहाँ डेटा की दिशा (जैसे लेखों में शब्द-गणना या उपयोगकर्ता प्राथमिकताएँ) परिमाण (कितना) से अधिक मायने रखती है। गहराई से समझने के लिए हमारा cosine distance लेख देखें।
चेबिशेव दूरी दूरी मापने का एक और तरीका है, जो किसी भी आयाम के साथ सबसे बड़े अंतर पर ध्यान केंद्रित करती है। यह शतरंज खेलने जैसा है: राजा क्षैतिज, ऊर्ध्वाधर या तिरछी दिशा की परवाह किए बिना, न्यूनतम चालों में सबसे दूर वाले खाने तक पहुँचता है। यह मीट्रिक उन स्थितियों में विशेष रूप से उपयोगी है जहाँ आपको कई अंतरों में से केवल सबसे महत्त्वपूर्ण पर ध्यान देना होता है। अधिक जानने के लिए हमारा Chebyshev distance ट्यूटोरियल पढ़ें।
हालाँकि यूक्लिडियन दूरी अपनी सहज प्रकृति और सरल गणना के कारण व्यापक रूप से इस्तेमाल होती है, लेकिन इसकी कुछ उल्लेखनीय सीमाएँ भी हैं। इन्हें समझना सही दूरी माप चुनने या डेटा को समायोजित कर इन मुद्दों को कम करने में मदद कर सकता है।
यूक्लिडियन दूरी फीचर्स के स्केल से असंगत रूप से प्रभावित हो सकती है। उदाहरण के लिए, आय और उम्र वाले डेटासेट में, आय आमतौर पर बहुत बड़े दायरे (हज़ारों या दसियों हज़ार) में फैली होती है, जबकि उम्र आमतौर पर लगभग 100 तक ही रहती है। यह असमानता दूरी गणना में आय को हावी कर सकती है और परिणामों को उसके स्केल की ओर झुका सकती है।
निवारण: डेटा का नॉर्मलाइज़ेशन या मानकीकरण (स्टैंडर्डाइज़ेशन) अलग-अलग फीचर्स के स्केल को संतुलित करने में मदद कर सकता है, ताकि कोई एकल फीचर दूरी गणना पर अनुचित प्रभाव न डाले।
आयामों का अभिशाप उन विभिन्न घटनाओं को दर्शाता है जो किसी डेटासेट में आयामों की संख्या बढ़ने पर उभरती हैं। इनमें से एक यह है कि 'निकटता' या 'दूरी' की अवधारणा कम अर्थपूर्ण हो जाती है—दूरियाँ अभिसरित होने लगती हैं, जिससे पास और दूर के बिंदुओं में प्रभावी अंतर करना कठिन हो जाता है।
निवारण: प्रिंसिपल कंपोनेंट एनालिसिस (PCA) या t-distributed stochastic neighbor embedding (t-SNE) जैसी तकनीकें डेटा की आयाम संख्या कम करती हैं। ये विधियाँ सर्वाधिक वैरिएंस वाली आवश्यक विशेषताओं को समेटकर डेटा को सरल बनाती हैं।
यूक्लिडियन दूरी की गणनाएँ आउटलायर्स से भी काफी प्रभावित हो सकती हैं। उच्च-आयामी स्पेस में, एकमात्र आउटलायर भी दूरियों को नाटकीय रूप से बदल सकता है, जिससे कुछ डेटा बिंदु वास्तविकता से अधिक समान या विभिन्न दिख सकते हैं।
वास्तव में, लिनियर रिग्रेशन की आउटलायर्स के प्रति संवेदनशीलता यूक्लिडियन दूरी की अवधारणा से जुड़ी हुई है। इसका कारण यह है कि लिनियर रिग्रेशन में मॉडल स्क्वेयर्ड रेजिडुअल्स (देखे गए और भविष्यवाणी किए गए मानों के अंतर) के योग को न्यूनतम करता है। ऐसा करना मूलतः देखे गए डेटा बिंदुओं और रिग्रेशन रेखा के बीच यूक्लिडियन दूरी को मापना है। आउटलायर्स इस दूरी को असंगत रूप से प्रभावित कर सकते हैं क्योंकि बड़े विचलनों के वर्ग छोटे विचलनों की तुलना में अधिक तेज़ी से बढ़ते हैं।
निवारण: ऐसे अधिक मज़बूत मीट्रिक्स का उपयोग करना जो आउटलायर्स के प्रति कम संवेदनशील हों, मददगार हो सकता है—जैसे कुछ प्रकार के डेटा के लिए मैनहट्टन दूरी। साथ ही, डेटा का प्रीप्रोसेसिंग कर आउटलायर्स की पहचान और उपचार—उन्हें समायोजित करना या हटाना—दूरी गणनाओं को विकृत होने से बचा सकता है।
वैकल्पिक तरीका: वेटेड यूक्लिडियन दूरी पर विचार करना एक और रणनीति है। यूक्लिडियन दूरी का यह रूपांतर अलग-अलग आयामों या फीचर्स को अलग-अलग वज़न देता है, और आउटलायर्स या शोर की आशंका वाले आयामों का वज़न कम किया जा सकता है।
जैसा कि हमने देखा, यूक्लिडियन दूरी कई विश्लेषणात्मक और तकनीकी क्षेत्रों में एक बुनियादी मीट्रिक है, जो बिंदुओं के बीच सीधी रेखा की दूरी मापने का सरल तरीका प्रदान करती है। यूक्लिडियन दूरी को समझना और उसका उपयोग करना, मशीन लर्निंग एल्गोरिद्म से लेकर स्थानिक विश्लेषण तक, कई अनुप्रयोगों की सटीकता और प्रभावशीलता बढ़ा सकता है।
मैं आपको अपने प्रोजेक्ट्स में यूक्लिडियन दूरी के साथ प्रयोग करने के लिए प्रोत्साहित करता/करती हूँ, और Designing Machine Learning Workflows in Python तथा Anomaly Detection in Python Course जैसे पाठ्यक्रमों के माध्यम से आगे सीखने के अवसरों का अन्वेषण करें।
विनोद चुगानी ने टोक्यो में जेपीमॉर्गन के सबसे कम उम्र के हेज फंड सेल्स डेस्क हेड के रूप में अपना करियर शुरू किया और बाद में लेहमन ब्रदर्स में व्यक्तिगत बिक्री का रिकॉर्ड बनाया, फिर 30 देशों में फैला एक इलेक्ट्रॉनिक्स डिस्ट्रीब्यूशन व्यवसाय बनाया, जिसकी आय SG$100 मिलियन से आगे बढ़ी, इसके बाद उन्होंने डेटा की ओर रुख किया। ड्यूक में अर्थशास्त्र के स्नातक और NYC डेटा साइंस अकादमी के पूर्व छात्र, वे मेवन पर ह्यूगो बोव्न-एंडरसन के Building AI Applications कोर्स के लिए 100+ आवेदनों में से तीन छात्रवृत्ति प्राप्तकर्ताओं में से एक थे। आज, वे DataCamp, KDnuggets, Machine Learning Mastery, और Statology के लिए सांख्यिकी से लेकर एजेंटिक एआई तक के विषयों पर लिखते हैं, और NYC डेटा साइंस अकादमी में डेटा प्रोफेशनलों को मेंटर करते हैं, उनके नाम पर 1,000 से अधिक एक-से-एक सत्र हैं।
यूक्लिडियन दूरी विभिन्न मशीन लर्निंग एल्गोरिद्म में डेटा बिंदुओं की समानता या असमानता को मापकर मदद करती है, जो वर्गीकरण, क्लस्टरिंग और विसंगति पहचान जैसे कार्यों के लिए महत्त्वपूर्ण है।
हर बार नहीं। सर्वश्रेष्ठ दूरी मीट्रिक डेटा के प्रकार और विशिष्ट समस्या पर निर्भर करती है। उदाहरण के लिए, बहुत उच्च-आयामी डेटा या ऐसे परिदृश्यों में जहाँ ग्रिड-जैसी गति अधिक उपयुक्त है, मैनहट्टन दूरी बेहतर हो सकती है।
यूक्लिडियन दूरी संगत निर्देशांकों के बीच पूर्ण अंतर मापती है और सभी निर्देशांकों को समान रूप से लेती है, चाहे वे धनात्मक हों या ऋणात्मक।
नहीं, यूक्लिडियन दूरी आमतौर पर दूरी की गणना के लिए संख्यात्मक इनपुट की आवश्यकता होती है। श्रेणीय (categorical) डेटा के लिए Hamming दूरी या अन्य कस्टम समानता माप जैसे वैकल्पिक तरीकों का उपयोग किया जाता है।
K-means जैसे क्लस्टरिंग एल्गोरिद्म में यूक्लिडियन दूरी का चुनाव सीधे इस बात को प्रभावित करता है कि क्लस्टर कैसे बनते हैं, क्योंकि यह इन क्लस्टरों के ज्यामितीय गुण निर्धारित करता है। यूक्लिडियन दूरी प्रवृत्ततः गोलाकार (spherical) क्लस्टर बनाती है, जहाँ माध्य (mean) क्लस्टर केंद्र की भूमिका निभाता है। जब डेटा में प्राकृतिक क्लस्टर गोलाकार न हों, तो इससे प्रदर्शन प्रभावित हो सकता है।
