
कोर्स
इंटरमीडिएट Deep Learning with PyTorch
4 घंटा
30K
Convolutional Neural Networks (CNNs) आधुनिक कंप्यूटर विज़न का आधार हैं, जो इमेज रिकग्निशन, चेहरे की पहचान, और सेल्फ-ड्राइविंग कारों जैसे अनुप्रयोगों को सक्षम बनाते हैं। ये नेटवर्क स्वतः छवियों से पैटर्न और फीचर्स निकालने के लिए डिज़ाइन किए गए हैं, जिससे वे दृश्य कार्यों के लिए पारंपरिक मशीन लर्निंग तकनीकों की तुलना में अधिक शक्तिशाली बन जाते हैं।
इस ट्यूटोरियल में, हम PyTorch का उपयोग करके एक CNN लागू करेंगे, जो शोध और उत्पादन अनुप्रयोगों के लिए उपयोगकर्ता-अनुकूल और अत्यंत कुशल डीप लर्निंग फ्रेमवर्क है।
CNNs के विवरण में जाने से पहले, आपको डीप लर्निंग के क्षेत्र और उन Python लाइब्रेरियों से परिचित होना चाहिए जिन्हें हम अपने वातावरण की सेटअप के दौरान उपयोग करेंगे।
डीप लर्निंग मशीन लर्निंग का एक उपसमूह है, जिसमें मूलभूत मॉडल संरचना इनपुट्स, हिडन लेयर्स, और आउटपुट्स के नेटवर्क के रूप में होती है। ऐसे नेटवर्क में एक या कई हिडन लेयर्स हो सकती हैं। डीप लर्निंग के पीछे मूल अंतर्दृष्टि यह थी कि ऐसे मॉडल बनाए जाएँ जो मानव मस्तिष्क के सीखने के तरीके—न्यूरॉन नामक परस्पर जुड़े सेल्स—से प्रेरित हों। यही कारण है कि हम डीप लर्निंग मॉडलों को आज भी "न्यूरल" नेटवर्क कहते हैं। इन परतदार मॉडल संरचनाओं को अनस्ट्रक्चर्ड डेटा से पैटर्न निकालने के लिए अन्य सुपरवाइज़्ड लर्निंग मॉडलों की तुलना में कहीं अधिक डेटा की आवश्यकता होती है। आमतौर पर हम कम से कम सैकड़ों हज़ारों डेटा पॉइंट्स की बात करते हैं।
हालाँकि डीप लर्निंग एल्गोरिद्म को लागू करने के लिए कई फ्रेमवर्क और पैकेज उपलब्ध हैं, हम PyTorch पर ध्यान केंद्रित करेंगे, जो सबसे लोकप्रिय और अच्छी तरह से मेंटेंड फ्रेमवर्क्स में से एक है। उद्योग में डीप लर्निंग इंजीनियरों द्वारा उपयोग किए जाने के अलावा, PyTorch शोधकर्ताओं के बीच भी पसंदीदा टूल है। कई डीप लर्निंग पेपर्स PyTorch का उपयोग करके प्रकाशित किए जाते हैं। इसे सहज और उपयोगकर्ता-अनुकूल होने के लिए डिज़ाइन किया गया है और यह Python लाइब्रेरी NumPy के साथ बहुत समानता साझा करता है।
यदि आपको इन अवधारणाओं पर एक प्राइमर चाहिए, तो आज ही Deep Learning with PyTorch कोर्स में नामांकन करने पर विचार करें।
Convolutional neural networks, जिन्हें आमतौर पर CNN या ConvNet कहा जाता है, कंप्यूटर विज़न कार्यों के लिए उपयुक्त एक विशेष प्रकार के डीप न्यूरल नेटवर्क हैं। CNNs का आविष्कार 1980 के दशक का है, लेकिन वे 2010 के दशक में मुख्यधारा में आए, जब ग्राफिक्स प्रोसेसिंग यूनिट्स (GPUs) के कार्यान्वयन से कंप्यूटिंग में बड़ी प्रगति हुई। वास्तव में, CNNs की तीव्र लोकप्रियता ने न्यूरल नेटवर्क्स के क्षेत्र को फिर से प्रमुखता दिलाई, जिसके परिणामस्वरूप तथाकथित "न्यूरल नेटवर्क्स की तीसरी लहर" आई, जिसमें हम आज भी जी रहे हैं।
CNNs विशेष रूप से जैविक विज़ुअल कॉर्टेक्स से प्रेरित हैं। कॉर्टेक्स में कोशिकाओं के छोटे क्षेत्र होते हैं जो दृश्य क्षेत्र के विशिष्ट हिस्सों के प्रति संवेदनशील होते हैं। इस विचार का Hubel और Wiesel के 1962 के एक आकर्षक प्रयोग द्वारा विस्तार किया गया था।
CNNs इस विशेषता की नकल करने की कोशिश करते हैं, ऐसे जटिल न्यूरल नेटवर्क बनाकर जो विभिन्न, कार्य-विशिष्ट लेयर्स से बने होते हैं। CNNs को "फीड-फॉरवर्ड" कहा जाता है क्योंकि सूचना मॉडल के भीतर सीधी दिशा में प्रवाहित होती है। उन अन्य मॉडलों की तुलना में जिनमें बैकप्रोपेगेशन जैसी तकनीकों का उपयोग होता है, इनमें आउटपुट्स को वापस मॉडल में फीड करने वाले फीडबैक कनेक्शंस नहीं होते।
आम तौर पर, एक CNN निम्नलिखित लेयर्स से बना होता है:
यह CNN का पहला बिल्डिंग ब्लॉक है। जैसा कि नाम से संकेत मिलता है, मुख्य गणितीय कार्य कन्वोल्यूशन है, जो किसी छवि का प्रतिनिधित्व करने वाली पिक्सेल मैट्रिक्स पर स्लाइडिंग विंडो फ़ंक्शन लागू करता है। मैट्रिक्स पर लागू स्लाइडिंग फ़ंक्शन को कर्नेल या फ़िल्टर कहा जाता है। कन्वोल्यूशन लेयर में समान आकार के कई फ़िल्टर्स लागू किए जाते हैं, और प्रत्येक फ़िल्टर छवि से किसी विशिष्ट पैटर्न को पहचानने के लिए उपयोग होता है, जैसे अंकों की वक्रता, किनारे, अंकों का समग्र आकार, आदि।
आमतौर पर, प्रत्येक कन्वोल्यूशन ऑपरेशन के बाद ReLU एक्टिवेशन फ़ंक्शन लागू किया जाता है। यह फ़ंक्शन छवि में फीचर्स के बीच गैर-रेखीय संबंध सीखने में नेटवर्क की मदद करता है, जिससे अलग-अलग पैटर्न पहचानने के लिए नेटवर्क अधिक सक्षम बनता है। यह वैनिशिंग ग्रेडिएंट समस्या को कम करने में भी मदद करता है।
Pooling लेयर का उद्देश्य कन्वोल्यूटेड मैट्रिक्स से सबसे महत्वपूर्ण फीचर्स निकालना है। यह कुछ एग्रीगेशन ऑपरेशंस लागू करके किया जाता है, जो फीचर मैप (कन्वोल्यूटेड मैट्रिक्स) के आयाम को कम कर देते हैं, और इस प्रकार नेटवर्क को ट्रेन करते समय मेमोरी की खपत भी घटती है। पूलिंग ओवरफिटिंग को कम करने के लिए भी प्रासंगिक है।
ये लेयर्स कन्वोल्यूशनल न्यूरल नेटवर्क के अंतिम भाग में होती हैं, और इनका इनपुट अंतिम पूलिंग लेयर द्वारा जनित फ्लैट की गई एक-आयामी मैट्रिक्स होता है। इन पर गैर-रेखीयता के लिए ReLU एक्टिवेशन फ़ंक्शंस लागू किए जाते हैं।
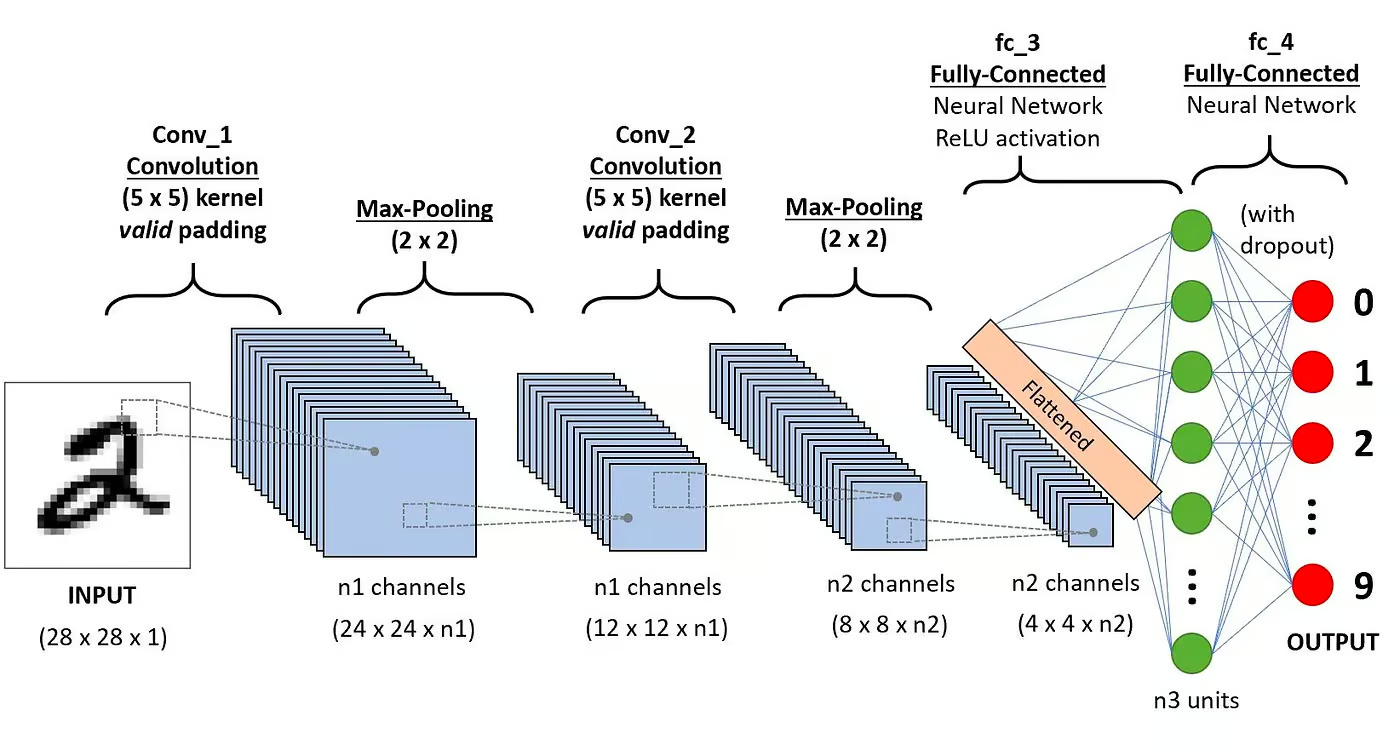 Convolution Neural Network आर्किटेक्चर। स्रोत: DataCamp
आप हमारे ट्यूटोरियल Convolutional Neural Networks in Python में CNNs के पीछे के गणित की अधिक विस्तृत व्याख्या पढ़ सकते हैं।
कंप्यूटर विज़न के क्षेत्र में कन्वोल्यूशनल न्यूरल नेटवर्क्स सबसे प्रभावशाली नवाचारों में से एक रहे हैं। उन्होंने पारंपरिक मशीन लर्निंग मॉडलों, जैसे SVMs और डिसीज़न ट्रीज़, की तुलना में कहीं बेहतर प्रदर्शन किया है और अत्याधुनिक परिणाम दिए हैं।
इसके अलावा, कन्वोल्यूशनल लेयर्स CNNs को अनुवाद-निरपेक्ष (translation-invariant) विशेषताएँ प्रदान करती हैं, जिससे वे स्थिति, अभिविन्यास, स्केल या ट्रांसलेशन में भिन्नताओं के बावजूद डेटा से पैटर्न और फीचर्स की पहचान और निष्कर्षण करने में सक्षम होते हैं।
CNNs कई वास्तविक जीवन के केस स्टडीज़ और अनुप्रयोगों में सफल साबित हुए हैं, जैसे:
इमेज क्लासिफिकेशन कार्यों से परे, CNNs बहुमुखी हैं और इन्हें नैचुरल लैंग्वेज प्रोसेसिंग, टाइम सीरीज़ विश्लेषण, और स्पीच रिकग्निशन जैसे कई अन्य डोमेन्स में भी लागू किया जा सकता है।
अब जब आप CNNs के सिद्धांत से परिचित हैं, तो हम व्यावहारिक रूप से काम शुरू करने के लिए तैयार हैं। इस भाग में, हम PyTorch के साथ एक साधारण CNN बनाएँगे और ट्रेन करेंगे। हमारा लक्ष्य छवियों में अंकों का वर्गीकरण करने वाला मॉडल बनाना है। अपने मॉडल को ट्रेन और टेस्ट करने के लिए, हम प्रसिद्ध MNIST डेटासेट का उपयोग करेंगे, जिसमें 70,000 ग्रेस्केल, 28x28 आकार की हस्तलिखित अंकों की छवियाँ शामिल हैं।
नीचे वे लाइब्रेरियाँ दी गई हैं जिन्हें हम इस ट्यूटोरियल में उपयोग करेंगे। मूल रूप से, हम अपना CNN बनाने के लिए PyTorch का उपयोग करेंगे, और MNIST डेटासेट को डाउनलोड और लोड करने के लिए PyTorch का कंप्यूटर विज़न मॉड्यूल torchvision काम आएगा। अंत में, हम अपने मॉडल के प्रदर्शन का मूल्यांकन करने के लिए torchmetrics का भी उपयोग करेंगे।
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


import torch
from torch import optim
from torch import nn
from torch.utils.data import DataLoader
from tqdm import tqdm

# !pip install torchvision
import torchvision

import torch.nn.functional as F
import torchvision.datasets as datasets
import torchvision.transforms as transforms

# !pip install torchmetrics
import torchmetricsPyTorch समृद्ध टूल्स और एक्सटेंशंस के इकोसिस्टम के साथ आता है, जिनमें कंप्यूटर विज़न के लिए torchvision मॉड्यूल शामिल है। Torchvision में कई इमेज डेटासेट हैं जिन्हें न्यूरल नेटवर्क्स के प्रशिक्षण और परीक्षण के लिए उपयोग किया जा सकता है। अपने ट्यूटोरियल में, हम MNIST डेटासेट का उपयोग करेंगे।
सबसे पहले, हम MNIST डेटासेट को डाउनलोड करेंगे और उसे टेन्सर में कन्वर्ट करेंगे—PyTorch में कोर डेटा संरचना—जो NumPy एरेज़ के समान है, लेकिन GPU एक्सेलेरेशन की क्षमता के साथ।
इसके बाद, हम DataLoader का उपयोग करके ट्रेन और टेस्ट दोनों डेटासेट्स के लिए बैचिंग और शफ़लिंग संभालेंगे। PyTorch DataLoader, Dataset से बनाया जा सकता है ताकि डेटा लोड किया जा सके, उसे बैचों में विभाजित किया जा सके, और इच्छानुसार ट्रांसफॉर्मेशन लागू किए जा सकें। फिर यह प्रशिक्षण के लिए तैयार डेटा सैंपल प्रदान करता है। नीचे दिए गए कोड में, हम डेटा लोड करते हैं और उसे 60 इमेज के बैच साइज वाले DataLoaders में सहेजते हैं:
batch_size = 60

train_dataset = datasets.MNIST(root="dataset/", download=True, train=True, transform=transforms.ToTensor())

train_loader = DataLoader(dataset=train_dataset, batch_size=batch_size, shuffle=True)

test_dataset = datasets.MNIST(root="dataset/", download=True, train=False, transform=transforms.ToTensor())

test_loader = DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=True)
वैकल्पिक रूप से, ट्रेन डेटासेट को आगे ट्रेन और वैलिडेशन के दो हिस्सों में विभाजित किया जा सकता है। वैलिडेशन, डीप लर्निंग में प्रशिक्षण के दौरान मॉडल के प्रदर्शन का मूल्यांकन करने की तकनीक है। यह संभावित ओवरफिटिंग और अंडरफिटिंग का पता लगाने में मदद करती है और हाइपरपैरामीटर ट्यूनिंग में विशेष रूप से सहायक होती है। हालाँकि, सरलता के लिए हम इस ट्यूटोरियल में वैलिडेशन का उपयोग नहीं करेंगे। यदि आप वैलिडेशन के बारे में अधिक सीखना चाहते हैं, तो हमारे Introduction to Deep Learning with PyTorch Course में पूरी व्याख्या देख सकते हैं।
अब जब हमारे पास डेटा है, तो देखते हैं कि अंकों का एक रैंडम बैच कैसा दिखता है:
def imshow(img):
   npimg = img.numpy()
   plt.imshow(np.transpose(npimg, (1, 2, 0)))
   plt.show()

# get some random training images
dataiter = iter(dataloader_train)
images, labels = next(dataiter)
labels
# show images
imshow(torchvision.utils.make_grid(images))
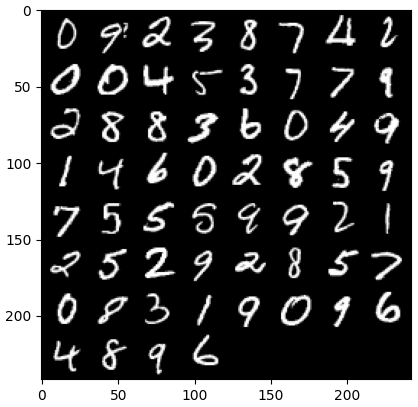
क्लासिफिकेशन समस्या को हल करने के लिए, हम nn.Module क्लास का लाभ उठाएँगे, जो PyTorch में उन्नत न्यूरल नेटवर्क आर्किटेक्चर सहजता से बनाने का बिल्डिंग ब्लॉक है।
नीचे दिए गए कोड में, हम CNN नामक एक क्लास बनाते हैं, जो nn.Module क्लास की विशेषताओं को विरासत में लेती है। CNN क्लास दो कन्वोल्यूशनल लेयर्स और उनके बाद एक फुली कनेक्टेड लेयर वाले CNN का ब्लूप्रिंट होगी।
PyTorch में, हम कन्वोल्यूशनल लेयर को परिभाषित करने के लिए nn.Conv2d का उपयोग करते हैं। हम इसमें इनपुट और आउटपुट फीचर मैप्स की संख्या पास करते हैं। हम कर्नेल या फ़िल्टर साइज और पैडिंग सहित कन्वोल्यूशनल लेयर के काम करने के लिए कुछ पैरामीटर्स भी सेट करते हैं।
इसके बाद, हम nn.MaxPool2d के साथ एक मैक्स पूलिंग लेयर जोड़ते हैं। इसमें, हम पिछले कन्वोल्यूशनल लेयर के आउटपुट पर एक नॉन-ओवरलैपिंग विंडो स्लाइड करते हैं। प्रत्येक पोज़िशन पर, हम विंडो से अधिकतम मान चुनते हैं और आगे पास करते हैं। यह ऑपरेशन फीचर मैप्स के स्थानिक आयामों को कम करता है, जिससे नेटवर्क में पैरामीटर्स की संख्या और गणनात्मक जटिलता कम होती है। अंत में, हम एक फुली कनेक्टेड लीनियर लेयर जोड़ते हैं।
forward() फ़ंक्शन बताता है कि अलग-अलग लेयर्स कैसे कनेक्ट होती हैं, और प्रत्येक कन्वोल्यूशनल लेयर के बाद कई ReLU एक्टिवेशन फ़ंक्शंस जोड़ता है।
class CNN(nn.Module):
   def __init__(self, in_channels, num_classes):

       """
       Building blocks of convolutional neural network.

       Parameters:
           * in_channels: Number of channels in the input image (for grayscale images, 1)
           * num_classes: Number of classes to predict. In our problem, 10 (i.e digits from  0 to 9).
       """
       super(CNN, self).__init__()

       # 1st convolutional layer
       self.conv1 = nn.Conv2d(in_channels=in_channels, out_channels=8, kernel_size=3, padding=1)
       # Max pooling layer
       self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
       # 2nd convolutional layer
       self.conv2 = nn.Conv2d(in_channels=8, out_channels=16, kernel_size=3, padding=1)
       # Fully connected layer
       self.fc1 = nn.Linear(16 * 7 * 7, num_classes)

   def forward(self, x):
       """
       Define the forward pass of the neural network.

       Parameters:
           x: Input tensor.

       Returns:
           torch.Tensor
               The output tensor after passing through the network.
       """
       x = F.relu(self.conv1(x))  # Apply first convolution and ReLU activation
       x = self.pool(x)           # Apply max pooling
       x = F.relu(self.conv2(x))  # Apply second convolution and ReLU activation
       x = self.pool(x)           # Apply max pooling
       x = x.reshape(x.shape[0], -1)  # Flatten the tensor
       x = self.fc1(x)            # Apply fully connected layer
       return x
       x = x.reshape(x.shape[0], -1)  # Flatten the tensor
       x = self.fc1(x)            # Apply fully connected layer
       return x
एक बार जब हमने CNN क्लास परिभाषित कर ली, तो हम अपना मॉडल बना सकते हैं और उसे उस डिवाइस पर ले जा सकते हैं जहाँ इसे ट्रेन और रन किया जाएगा।
न्यूरल नेटवर्क्स, जिनमें CNNs भी शामिल हैं, GPUs पर चलने पर बेहतर प्रदर्शन दिखाते हैं, लेकिन यह आपके कंप्यूटर पर हर बार संभव नहीं हो सकता। इसलिए, हम मॉडल को तभी GPU पर चलाएँगे जब वह उपलब्ध हो; अन्यथा, हम सामान्य CPU का उपयोग करेंगे।
device = "cuda" if torch.cuda.is_available() else "cpu"

model = CNN(in_channels=1, num_classes=10).to(device)
print(model)
>>> CNN(
  (conv1): Conv2d(1, 8, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (pool): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (conv2): Conv2d(8, 16, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (fc1): Linear(in_features=784, out_features=10, bias=True)
)अब जब हमारे पास मॉडल है, तो इसे ट्रेन करने का समय है। ऐसा करने के लिए, पहले हमें यह तय करना होगा कि हम मॉडल के प्रदर्शन को कैसे मापेंगे। चूँकि हम एक मल्टी-क्लास क्लासिफिकेशन समस्या से निपट रहे हैं, हम क्रॉस-एंट्रॉपी लॉस फ़ंक्शन का उपयोग करेंगे, जो PyTorch में nn.CrossEntropyLoss के रूप में उपलब्ध है। हम Adam ऑप्टिमाइज़र का भी उपयोग करेंगे, जो सबसे लोकप्रिय ऑप्टिमाइज़ेशन एल्गोरिद्म्स में से एक है।
# Define the loss function
criterion = nn.CrossEntropyLoss()

# Define the optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001)
हम दस epochs और प्रशिक्षण बैचों पर इटरेट करेंगे और प्रत्येक बैच के लिए नीचे दिखाए गए सामान्य चरण अनुक्रम का पालन करेंगे।
num_epochs=10
for epoch in range(num_epochs):
 # Iterate over training batches
   print(f"Epoch [{epoch + 1}/{num_epochs}]")

   for batch_index, (data, targets) in enumerate(tqdm(dataloader_train)):
       data = data.to(device)
       targets = targets.to(device)
       scores = model(data)
       loss = criterion(scores, targets)
       optimizer.zero_grad()
       loss.backward()
       optimizer.step()
Epoch [1/10]
100%|██████████| 1000/1000 [00:13<00:00, 72.94it/s]
Epoch [2/10]
100%|██████████| 1000/1000 [00:12<00:00, 77.27it/s]
Epoch [3/10]
100%|██████████| 1000/1000 [00:12<00:00, 77.16it/s]
Epoch [4/10]
100%|██████████| 1000/1000 [00:12<00:00, 77.00it/s]
Epoch [5/10]
100%|██████████| 1000/1000 [00:13<00:00, 75.69it/s]
Epoch [6/10]
100%|██████████| 1000/1000 [00:12<00:00, 77.24it/s]
Epoch [7/10]
100%|██████████| 1000/1000 [00:12<00:00, 78.23it/s]
Epoch [8/10]
100%|██████████| 1000/1000 [00:12<00:00, 78.16it/s]
Epoch [9/10]
100%|██████████| 1000/1000 [00:12<00:00, 77.96it/s]
Epoch [10/10]
100%|██████████| 1000/1000 [00:12<00:00, 77.93it/s]मॉडल के ट्रेन होने के बाद, हम इसके प्रदर्शन का परीक्षण डेटासेट पर मूल्यांकन कर सकते हैं। हम शुद्धता (accuracy) का उपयोग करेंगे, जो क्लासिफिकेशन समस्याओं के लिए एक लोकप्रिय मीट्रिक है। एक्यूरेसी, डेटासेट में मौजूद कुल वस्तुओं में से सही ढंग से वर्गीकृत मामलों के अनुपात को मापती है। इसे मॉडल द्वारा की गई सही भविष्यवाणियों की संख्या को कुल भविष्यवाणियों की संख्या से विभाजित करके गणना किया जाता है।
सबसे पहले, हम torchmetrics से एक्यूरेसी मीट्रिक सेट करते हैं। अगला, हम मॉडल के .eval मेथड का उपयोग करके मॉडल को इवैल्यूएशन मोड में डालते हैं, क्योंकि PyTorch मॉडलों की कुछ लेयर्स प्रशिक्षण और परीक्षण चरणों में अलग तरह से व्यवहार करती हैं। हम torch.no_grad के साथ एक Python कॉन्टेक्स्ट भी जोड़ते हैं, जो इंगित करता है कि हम ग्रेडिएंट गणना नहीं करेंगे।
इसके बाद, हम बिना ग्रेडिएंट गणना के टेस्ट उदाहरणों पर इटरेट करते हैं। प्रत्येक टेस्ट बैच के लिए, हम मॉडल आउटपुट प्राप्त करते हैं, सबसे संभावित क्लास लेते हैं, और उसे लेबल्स के साथ एक्यूरेसी फ़ंक्शन को पास करते हैं। अंत में, हम मीट्रिक्स की गणना करते हैं और परिणाम प्रिंट करते हैं। हमें 0.98 की एक्यूरेसी स्कोर मिला, जिसका अर्थ है कि हमारे मॉडल ने 98% अंकों को सही वर्गीकृत किया। बुरा नहीं!
# Set up of multiclass accuracy metric
acc = Accuracy(task="multiclass",num_classes=10)

# Iterate over the dataset batches
model.eval()
with torch.no_grad():
   for images, labels in dataloader_test:
       # Get predicted probabilities for test data batch
       outputs = model(images)
       _, preds = torch.max(outputs, 1)
       acc(preds, labels)
       precision(preds, labels)
       recall(preds, labels)

#Compute total test accuracy
test_accuracy = acc.compute()
print(f"Test accuracy: {test_accuracy}")

>>> Test accuracy: 0.9857000112533569
आप अन्य लोकप्रिय क्लासिफिकेशन मीट्रिक्स, जैसे रिकॉल और प्रिसीजन, का भी उपयोग कर सकते हैं। इन मीट्रिक्स के बारे में व्यावहारिक उदाहरणों के साथ हम आपको अपने Intermediate Deep Learning with PyTorch Course में सब बताते हैं।
हालाँकि हमारा CNN मॉडल अच्छा प्रदर्शन करता है, हम इसकी सटीकता, मजबूती, और नए डेटा पर सामान्यीकरण को और बेहतर करने के लिए कई रणनीतियों का उपयोग कर सकते हैं।
इस भाग में, हम डेटा ऑग्मेंटेशन, हाइपरपैरामीटर ट्यूनिंग, और ट्रांसफर लर्निंग जैसी प्रमुख तकनीकों का पता लगाएंगे, ताकि अपने मॉडल के प्रदर्शन को अनुकूलित कर सकें।
डेटा ऑग्मेंटेशन एक तकनीक है जिसका उपयोग रैंडम तरीके से नया प्रशिक्षण डेटा बनाकर हमारे मॉडल की सटीकता में सुधार करने के लिए किया जाता है। उदाहरण के लिए, लोडिंग के दौरान, प्रशिक्षण छवियों पर रीसाइज़िंग, हॉरिज़ॉन्टल या वर्टिकल फ्लिपिंग, रैंडम रोटेशन आदि जैसे ट्रांसफॉर्मेशन लागू किए जा सकते हैं। इस तरह, हम ऑग्मेंटेड इमेज बना सकते हैं और उन्हें मूल छवि वाले ही लेबल असाइन कर सकते हैं, जिससे प्रशिक्षण सेट का आकार बढ़ जाता है।
मूल छवियों में रैंडम ट्रांसफॉर्मेशन जोड़ने से हम अधिक डेटा जनरेट कर सकते हैं और प्रशिक्षण सेट के आकार और विविधता—दोनों—में वृद्धि कर सकते हैं। यह मॉडल को वास्तविक दुनिया की छवियों में आमतौर पर पाई जाने वाली विविधताओं और विकृतियों के प्रति अधिक सक्षम बनाता है और ओवरफिटिंग को कम करता है क्योंकि मॉडल रैंडम ट्रांसफॉर्मेशंस की अनदेखी करना सीखता है।
हालाँकि, डेटा ऑग्मेंटेशन के बारे में सावधान रहना महत्वपूर्ण है, क्योंकि कभी-कभी यह प्रशिक्षण प्रक्रिया को नुकसान पहुँचा सकता है। उदाहरण के लिए, हमारी समस्या में, यदि हम संख्या "6" पर वर्टिकल फ्लिप लागू करते हैं, तो वह "9" जैसी लगेगी। उसे "6" के लेबल के साथ मॉडल को पास करना मॉडल को भ्रमित करेगा और प्रशिक्षण में बाधा डालेगा। ये उदाहरण दिखाते हैं कि कभी-कभी विशिष्ट ऑग्मेंटेशन लेबल को प्रभावित कर सकते हैं।
हमारे मॉडल के प्रदर्शन में सुधार करने की एक और रणनीति मॉडल की विभिन्न लेयर्स में शामिल हाइपरपैरामीटर्स के मानों को बदलना है। यह हाइपरपैरामीटर ट्यूनिंग न्यूरल नेटवर्क्स के पीछे के गणित और विभिन्न हाइपरपैरामीटर्स के महत्व की गहरी समझ की माँग करती है।
उदाहरण के लिए, आप अपने CNN लेयर्स को फ़िल्टर्स के आकार को बदलकर या पैडिंग बढ़ाकर ट्यून कर सकते हैं। आप न्यूरॉन्स के प्रारंभिक वेट्स के लिए अलग मान भी सेट कर सकते हैं।
चूँकि हमें पहले से हाइपरपैरामीटर्स के इष्टतम मान नहीं पता होंगे, कुछ हद तक ट्रायल-एंड-एरर की आवश्यकता होगी। यह आमतौर पर ग्रिड सर्च नामक तकनीक के माध्यम से किया जाता है, जो आपको पैरामीटर मानों के ग्रिड पर किसी मॉडल का व्यवस्थित रूप से मूल्यांकन करने की अनुमति देती है।
हालाँकि, इस तकनीक का उपयोग करते समय सावधान रहें, क्योंकि यह सामान्यतः गणनात्मक रूप से महँगी होती है, विशेष रूप से जटिल न्यूरल नेटवर्क्स और बड़े प्रशिक्षण डेटासेट्स के साथ काम करते समय।
इसी तरह, आप अधिक कन्वोल्यूशनल और लीनियर लेयर्स जोड़कर अपने मॉडल की जटिलता बढ़ा सकते हैं। लेकिन नई लेयर्स जोड़ते समय सावधानी बरतें, क्योंकि न्यूरॉन्स की संख्या तेजी से बढ़ सकती है, जिसके परिणामस्वरूप ट्रेनिंग समय लंबा हो सकता है और संभावित ओवरफिटिंग हो सकती है।
आप हमारे Introduction to Deep Learning with PyTorch Course में हाइपरपैरामीटर ट्यूनिंग के बारे में और अधिक सीख सकते हैं।
डीप लर्निंग मॉडलों को शून्य से ट्रेन करना एक लंबी और थकाऊ प्रक्रिया है, और आमतौर पर बहुत अधिक प्रशिक्षण डेटा की आवश्यकता होती है। इसके बजाय, हम अक्सर प्री-ट्रेंड मॉडल का उपयोग कर सकते हैं, यानी ऐसे मॉडल जो पहले से किसी कार्य पर प्रशिक्षित किए जा चुके हैं।
कभी-कभी, यदि कोई प्री-ट्रेंड मॉडल पहले से ही हमारे वांछित कार्य को हल कर सकता है, तो हम उसे सीधे पुनः उपयोग कर सकते हैं। अन्य मौकों पर, हमें नए कार्य में फिट करने के लिए प्री-ट्रेंड मॉडल को समायोजित करने की आवश्यकता हो सकती है। इसे ट्रांसफर लर्निंग कहा जाता है।
PyTorch में प्री-ट्रेंड मॉडलों का उपयोग करना काफी आसान है। Torchvision विभिन्न इमेज-संबंधी कार्यों के लिए प्री-ट्रेंड मॉडलों का एक संग्रह प्रदान करता है। ये मॉडल बड़े पैमाने के इमेज डेटासेट्स पर प्री-ट्रेंड होते हैं और आसानी से उपलब्ध हैं। इनके बारे में सब कुछ सीखने के लिए हमारा Deep Learning for Images with PyTorch Course देखें।
PyTorch में अपने उच्च-सटीकता वाले क्लासिफिकेशन मॉडल को ट्रेन करने के बाद, अब आप मॉडल और उसके प्री-ट्रेंड वेट्स को भविष्य में उपयोग के लिए सहेज सकते हैं और अपनी टीम के साथ साझा कर सकते हैं, यह सुनिश्चित करते हुए कि वे उसे सहजता से लोड कर सकें।
मॉडल को सहेजने के लिए, हम torch.save का उपयोग कर सकते हैं। torch मॉडलों के लिए एक सामान्य फ़ाइल एक्सटेंशन pt या pth होता है। मॉडल के वेट्स को सहेजने के लिए, हम model.state_dict को आउटपुट फ़ाइल नाम के साथ torch.save में पास करते हैं, उदाहरण के लिए, MulticlassCNN.pth।
सेव किए गए मॉडल को लोड करने के लिए, हम समान आर्किटेक्चर के साथ एक नया मॉडल इनिशियलाइज़ करते हैं। फिर हम torch.load के साथ लोड स्टेट dict मेथड का उपयोग करके नए मॉडल में पैरामीटर्स लोड करते हैं।
# Save the model
torch.save(model.state_dict(), 'MulticlassCNN.pth')

# Create a new model
loaded_model = CNN(in_channels=1, num_classes=10)

# Load the saved model
loaded_model.load_state_dict(torch.load('MulticlassCNN.pth'))
print(loaded_model)


CNN(
  (conv1): Conv2d(1, 8, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (pool): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (conv2): Conv2d(8, 16, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (fc1): Linear(in_features=784, out_features=10, bias=True)
)हमने CNNs का एक संपूर्ण अवलोकन किया, जिसमें CNN आर्किटेक्चर की प्रत्येक लेयर के बारे में विवरण प्रदान किया। आगे, हमने PyTorch में CNN को कैसे लागू करें, इस पर एक गाइड दिया—डेटा लोडिंग और मॉडल डिज़ाइन से लेकर मॉडल ट्रेनिंग और इवैल्यूएशन तक के मुख्य चरणों को कवर किया। अंत में, हमने अपने मॉडल के प्रदर्शन में सुधार के लिए कई रणनीतियों का भी विश्लेषण किया। हमने इन सभी कौशलों को एक वास्तविक-जीवन परिदृश्य—एक मल्टीक्लास क्लासिफिकेशन कार्य—पर लागू किया।
डीप लर्निंग के बारे में सीखने के लिए बहुत कुछ है—यह AI के सबसे रोमांचक और चुनौतिपूर्ण क्षेत्रों में से एक है। सौभाग्य से, DataCamp आपकी मदद के लिए मौजूद है। हमारे समर्पित मटेरियल्स और कोर्सेज देखें और न्यूरल नेटवर्क विशेषज्ञ बनें:
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स