
Last chance! 50% off DataCamp Premium
Sale ends in
अटेंशन मैकेनिज्म ट्रांसफॉर्मर मॉडलों का हृदय है। सभी लोकप्रिय मॉडल आर्किटेक्चर, जैसे GPT, LLaMA, और Mixture of Experts (MoE), टोकनों को जोड़ने और अर्थ गढ़ने के लिए इसी पर निर्भर करते हैं।
लेकिन अटेंशन महंगा है। इसकी गणना में बड़े मैट्रिक्स गुणा और, उससे भी महत्वपूर्ण, GPU मेमोरी और कंप्यूट यूनिट्स के बीच भारी मात्रा में डेटा मूवमेंट शामिल होता है। जैसे-जैसे सीक्वेंस की लंबाई बढ़ती है, मेमोरी बैंडविड्थ असली बाधा बन जाती है।
इसलिए अटेंशन का अनुकूलन LLM प्रदर्शन पर असाधारण प्रभाव डालता है—और यहीं फ्लैश अटेंशन काम आता है। इस लेख में, मैं आपको बताऊंगा कि फ्लैश अटेंशन क्या है, यह कैसे काम करता है, और इसे PyTorch तथा Hugging Face Transformers के साथ कैसे उपयोग करें।
यदि आप LLMs से शुरुआत करने का तरीका ढूंढ रहे हैं, तो मैं हमारे LLM अवधारणाएँ पर परिचयात्मक पाठ्यक्रम को लेने की सिफारिश करता हूँ।
फ्लैश अटेंशन एक अनुकूलित ट्रांसफॉर्मर अटेंशन मैकेनिज्म है, जो GPUs पर इसे नाटकीय रूप से तेज़ और मेमोरी-कुशल बनाता है।
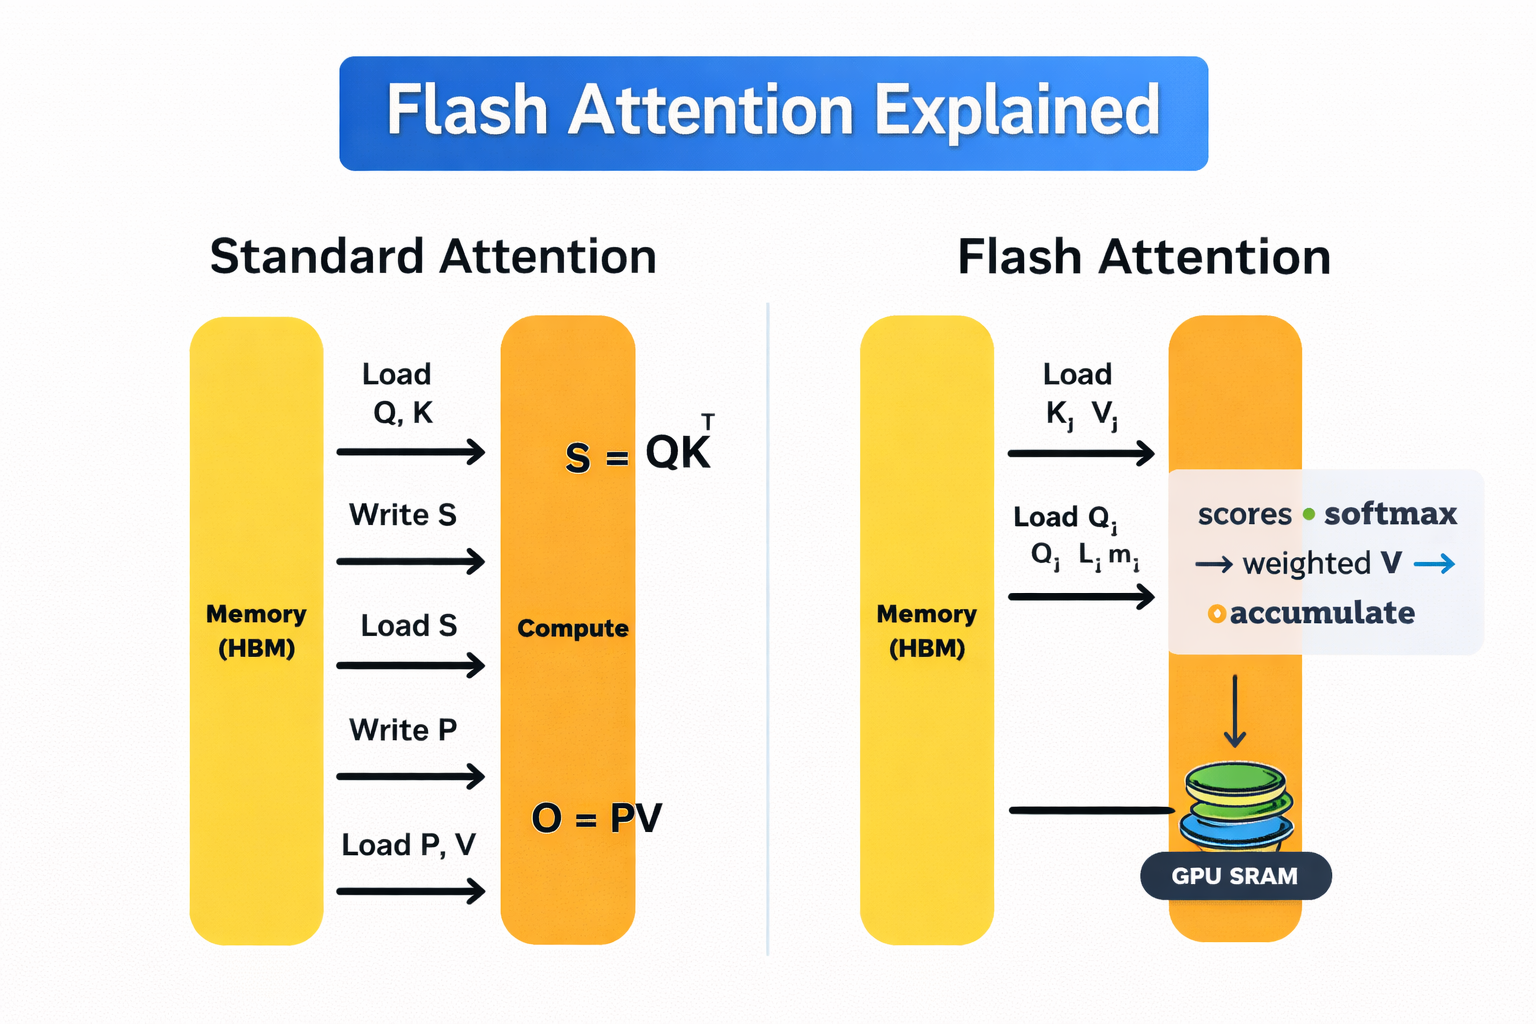
मानक अटेंशन बनाम फ्लैश अटेंशन
GPUs में दो मुख्य मेमोरी प्रकार होते हैं। हाई-बैंडविड्थ मेमोरी (HBM) बड़ी होती है लेकिन अपेक्षाकृत धीमी। ऑन-चिप SRAM अत्यंत तेज़ होती है, पर आकार में बहुत सीमित।
मानक सेल्फ-अटेंशन लगातार इन दोनों के बीच डेटा ले-जा रहा होता है। यह आगे-पीछे का सफर महंगा पड़ता है और सीक्वेंस लंबा होने पर यह लागत काफी बढ़ जाती है।
फ्लैश अटेंशन इससे बचता है क्योंकि यह अटेंशन को छोटे-छोटे टाइल्स में गणना करता है, जो पूरी तरह तेज़ SRAM में समा जाते हैं। हर टाइल को शुरू से अंत तक प्रोसेस किया जाता है, और सॉफ्टमैक्स क्रमिक रूप से लागू होता है, ताकि मध्यवर्ती परिणामों को HBM में वापस नहीं लिखना पड़े। इसलिए, पूरी अटेंशन मैट्रिक्स कभी भी मेमोरी में स्टोर नहीं होती।
स्पार्स या लीनियर अटेंशन विधियों के विपरीत, फ्लैश अटेंशन कोई एप्रॉक्सिमेशन नहीं है। यह मानक सेल्फ-अटेंशन जैसा ही सटीक गणितीय आउटपुट देता है—बस इसे अधिक मेमोरी-कुशल तरीके से निष्पादित करता है।
फ्लैश अटेंशन अपनी कुशलता GPU पर अटेंशन की गणना करने के तरीके को फिर से डिजाइन करके हासिल करता है। इसका सरल सिद्धांत है: जितना संभव हो उतना काम तेज़ ऑन-चिप मेमोरी में करें और धीमी मेमोरी में अनावश्यक मूवमेंट से बचें।
इसे समझने का एक सहायक तरीका किचन का उदाहरण है। GPU की ऑन-चिप SRAM एक छोटे, तेज़ किचन काउंटर जैसी है—यहीं आप वास्तव में तैयारी और खाना बनाते हैं। GPU हाई-बैंडविड्थ मेमोरी (HBM) गली के नीचे बड़ी ग्रॉसरी स्टोर जैसी है। यह सब कुछ स्टोर कर सकती है, लेकिन बार-बार जाना-आना समय लेता है।
सरल शब्दों में, मानक अटेंशन हर चरण के बाद ग्रॉसरी स्टोर भागता रहता है। इसके विपरीत, फ्लैश अटेंशन पकाने की ऐसी योजना बनाता है कि सब कुछ काउंटर पर ही समा जाए। आइए इसे विस्तार से समझते हैं:
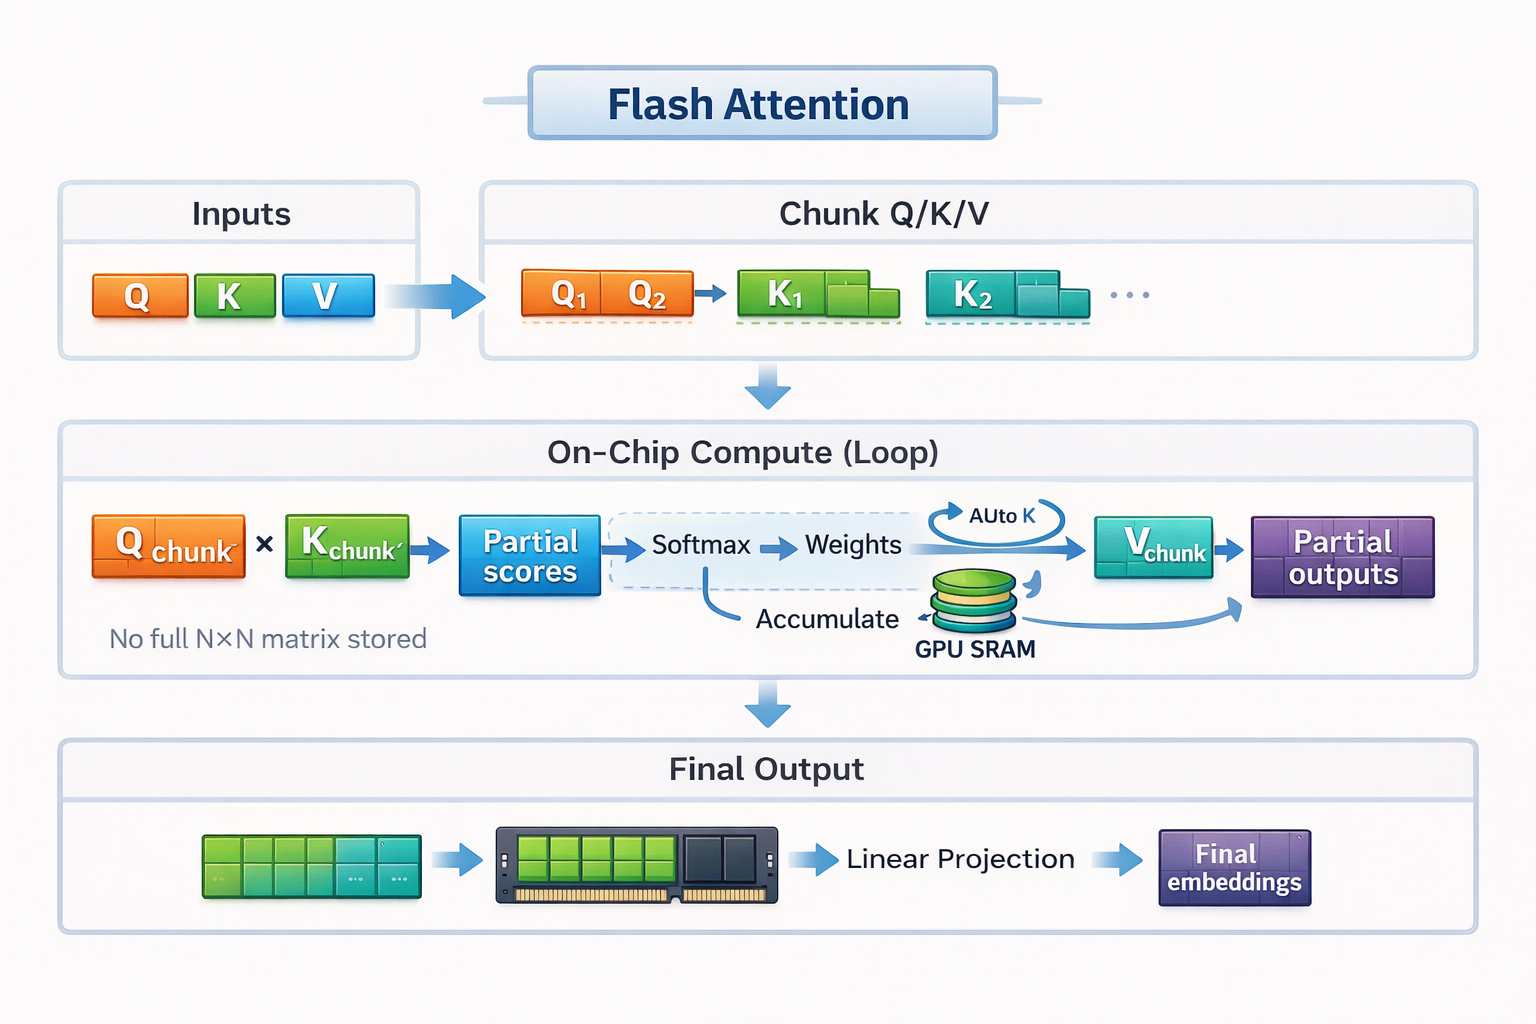
फ्लैश अटेंशन का कार्य तंत्र
फ्लैश अटेंशन दो मुख्य विचारों पर आधारित है: टाइलिंग और रिकम्प्यूटेशन।
हमारे किचन उदाहरण में, टाइलिंग वह तरीका है जिससे फ्लैश अटेंशन छोटी काउंटर स्पेस पर अटेंशन की गणना फिट करता है।
पूरे सीक्वेंस को लोड करके पूरी अटेंशन मैट्रिक्स बनाने की बजाय, फ्लैश अटेंशन इनपुट्स को छोटे ब्लॉक्स या टाइल्स में बांट देता है। हर टाइल GPU की तेज़ SRAM में पूरी तरह समा जाती है। फ्लैश अटेंशन हर टाइल की अटेंशन शुरुआत से अंत तक गणना करता है, फिर अगली टाइल पर बढ़ता है।
किचन सादृश्य से, आप छोटे काउंटर पर पूरे भोज के लिए सामग्री फिट नहीं कर सकते। इसलिए आप छोटे बैचों में तैयारी और पकाना करते हैं—कुछ सब्जियाँ काटते हैं, पकाते हैं, जगह साफ़ करते हैं, फिर अगले बैच पर जाते हैं। इस तरह काम करके, आप ग्रॉसरी स्टोर के चक्कर लगाने से बचते हैं।
यह ब्लॉक-दर-ब्लॉक निष्पादन फ्लैश अटेंशन को डेटा को स्थानीय, तेज़ और कुशल बनाए रखने देता है, बिना कभी धीमी मेमोरी में पूरी अटेंशन मैट्रिक्स तैयार किए।
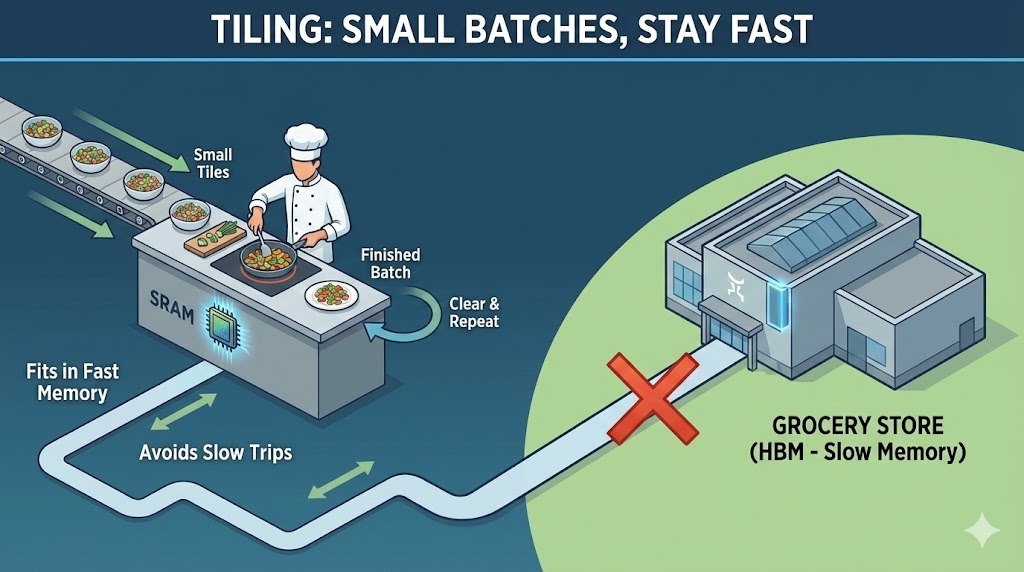
फ्लैश अटेंशन में टाइलिंग
ट्रेनिंग के दौरान, मानक अटेंशन बैकवर्ड पास में पुन: उपयोग के लिए बड़े मध्यवर्ती परिणामों को स्टोर करता है। यह स्टोरेज भारी मेमोरी लागत लाता है। फ्लैश अटेंशन अलग तरीका अपनाता है—इन इंटरमीडिएट्स को स्टोर करने के बजाय, ज़रूरत पड़ने पर यह अटेंशन स्कोर के छोटे हिस्सों को दोबारा गणना करता है।
किचन में लौटें तो, यह प्याज़ काटने जैसा है। आप कटे प्याज़ को बचाने के लिए ग्रॉसरी स्टोर तक चलकर जा सकते हैं और बाद में वापस लेने के लिए फिर जा सकते हैं। या आप उन्हें फेंक दें और पकाने का समय आने पर ताज़ा प्याज़ फिर से काट लें। चौंकाने वाली बात यह है कि दूसरा विकल्प तेज़ है क्योंकि यह बार-बार/लंबी आवाजाही से बचता है।
आधुनिक GPUs पर, रिकम्प्यूटेशन इसी तर्क का अनुसरण करता है क्योंकि अतिरिक्त गणना, मेमोरी मूवमेंट्स की तुलना में सस्ती पड़ती है। छोटे मानों को स्टोर और लोड करने के बजाय दुबारा गणना करके, फ्लैश अटेंशन मेमोरी ट्रैफिक को काफी घटाता है जबकि ट्रेनिंग को कुशल बनाए रखता है।
साथ मिलकर, टाइलिंग और रिकम्प्यूटेशन फ्लैश अटेंशन को काउंटर पर ही अटेंशन की गणना रखने, ग्रॉसरी के चक्कर न्यूनतम करने, और आधुनिक GPU हार्डवेयर की ताकत का पूरा उपयोग करने देते हैं।
फ्लैश अटेंशन 2 (FA2), 2023 में जारी, पहली पीढ़ी पर एक बड़ा अपग्रेड है। यह IO-सचेत, सटीक अटेंशन के उसी मूल विचार को रखता है, पर वास्तविक वर्कलोड्स में मायने रखने वाले कई आयामों में दक्षता बढ़ाता है।
फ्लैश अटेंशन के पहले संस्करण ने बैच साइज और अटेंशन हेड्स में पैरेललिज़्म लागू किया। यह बड़े बैच वाली ट्रेनिंग सेटअप्स में अच्छा काम करता था, पर इन्फरेंस के लिए कम उपयुक्त था, जहाँ अक्सर बैच छोटे और सीक्वेंस लंबे होते हैं।
FA2 ने स्वयं सीक्वेंस लंबाई के आयाम में पैरेललिज़्म जोड़ा। इससे, भले ही बैच साइज छोटा हो, अटेंशन गणना के अधिक हिस्से एक साथ चल सकते हैं। सीक्वेंस के टोकनों में काम फैलाकर, v2 GPU की अधिक compute यूनिट्स को एक साथ व्यस्त रखता है।
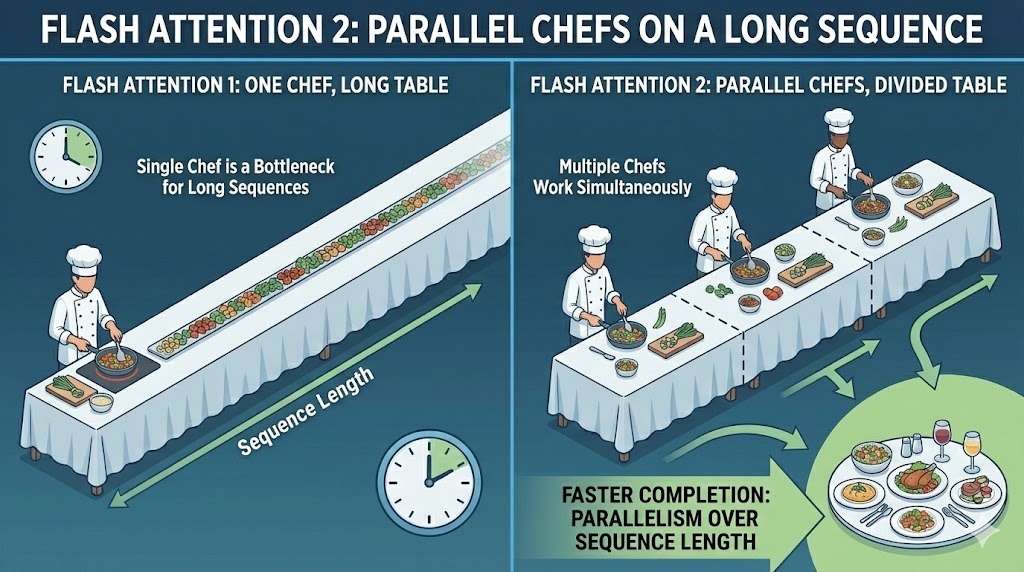
फ्लैश अटेंशन 2 में बैचों में पैरेललिज़्म
व्यावहारिक लाभ यह है कि आम इन्फरेंस परिदृश्यों में, जहाँ लंबे प्रॉम्प्ट और छोटे बैच सामान्य हैं, थ्रूपुट अधिक और हार्डवेयर उपयोग बेहतर होता है।
GPUs मैट्रिक्स गुणा में अत्यंत अच्छे होते हैं। Tensor Cores नामक विशेष हार्डवेयर जनरल मैट्रिक्स मल्टिप्लिकेशन (GEMM) ऑपरेशंस को बहुत तेज़ी से निष्पादित कर सकता है।
समस्या यह है कि अटेंशन केवल मैट्रिक्स गुणा नहीं है: इसमें स्केलिंग, मास्किंग और सॉफ्टमैक्स जैसी क्रियाएँ भी शामिल हैं, जो मानक GPU कोर्स पर चलती हैं और तुलना में काफी धीमी होती हैं।
FA2 ने इस असंतुलन को घटाया। यह गणना को पुनर्संरचित करता है ताकि नॉन-मैट्रिक्स फ्लोटिंग-पॉइंट ऑपरेशंस, खासकर अटेंशन स्कोर के रिस्केलिंग से जुड़े, न्यूनतम हों। रनटाइम का अधिकांश हिस्सा बड़े, कुशल मैट्रिक्स ऑपरेशंस के भीतर व्यतीत होता है जिन्हें Tensor Cores तेज़ कर सकते हैं।
फ्लैश अटेंशन v1 को 64 या 128 की हेड डायमेंशंस के आसपास अनुकूलित किया गया था, जो BERT और GPT-3 जैसे मॉडलों से मेल खाती थीं। जैसे-जैसे आर्किटेक्चर विकसित हुए, एम्बेडिंग साइज और उच्च मॉडल क्षमता को सपोर्ट करने के लिए हेड डायमेंशंस बड़े हुए।
FA2 ने समर्थन को 256 तक की हेड डायमेंशंस तक बढ़ा दिया। इससे यह नए आर्किटेक्चर के साथ संगत हो गया जो वाइडर अटेंशन हेड्स पर निर्भर हैं।
फ्लैश अटेंशन 3 (FA3) वर्तमान उद्योग मानक है जो GPT-5.2 जैसे अत्याधुनिक मॉडलों को शक्ति देता है। यह पहले के संस्करणों की तरह ही IO-सचेत, सटीक अटेंशन नींव पर बना है, लेकिन इसे विशेष रूप से NVIDIA H100 (Hopper) GPUs के लिए आर्किटेक्ट किया गया है।
मुख्य बदलाव यह है कि FA3 Hopper की नई असिंक्रोनस हार्डवेयर क्षमताओं का लाभ उठाने के लिए डिज़ाइन किया गया है, जिससे मेमोरी मूवमेंट और गणना पहले से कहीं अधिक आक्रामक तरीके से ओवरलैप हो पाते हैं।
पहले के संस्करणों में, सभी GPU थ्रेड्स, जिन्हें वॉर्प कहा जाता है, एक ही निष्पादन पथ का पालन करते थे। FA3 इस मॉडल को वॉर्प स्पेशलाइज़ेशन के माध्यम से बदलता है। यह प्रत्येक वॉर्प को दो अलग-अलग भूमिकाओं में से एक सौंपता है:
यह विभाजन डेटा ट्रांसफर और गणना को एक ही समय में होने देता है। जब प्रोड्यूसर वॉर्प अगले डेटा टाइल्स लाते हैं, तब कंज्यूमर वॉर्प मौजूदा टाइल्स पर गणना में व्यस्त रहते हैं, जिससे लेटेंसी में उल्लेखनीय सुधार होता है
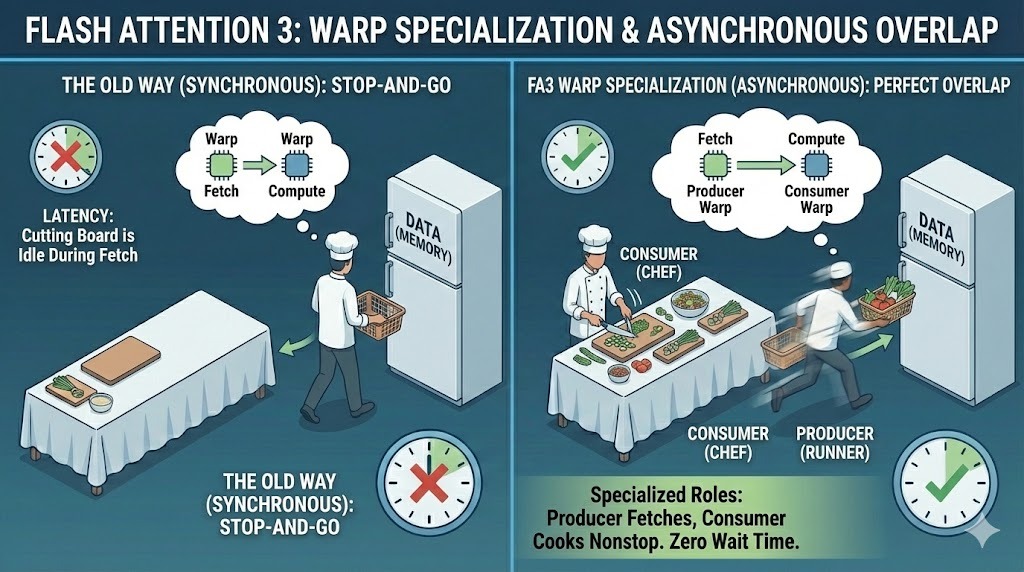
फ्लैश अटेंशन 3 में वॉर्प स्पेशलाइज़ेशन
फ्लैश अटेंशन 3 में FP8, यानी 8-बिट फ्लोटिंग पॉइंट प्रिसिशन के लिए नेटिव समर्थन भी आता है। पहले के संस्करण मुख्यतः FP16 या BF16 पर निर्भर थे, जो FP32 की तुलना में मेमोरी उपयोग घटाते थे, पर फिर भी पर्याप्त बैंडविड्थ लेते थे।
FP8 मेमोरी फ़ुटप्रिंट को लगभग आधा फिर से घटा देता है। यह कमी सीधे उच्च थ्रूपुट और कम मेमोरी दबाव में अनुवादित होती है। Hopper GPUs पर FP8 हार्डवेयर-त्वरित है, जिसका अर्थ है कि FA3 बिना मॉडल-स्तरीय सटीकता खोए प्रति सेकंड अधिक अटेंशन ऑपरेशन प्रोसेस कर सकता है।
यही क्षमता एक बड़ा कारण है कि Gemini 3 जैसे बड़े मॉडल कॉन्टेक्स्ट विंडो को विशाल स्तर पर संभालते हुए भी लाखों उपयोगकर्ताओं को कुशलता से सर्व कर पाते हैं।
FA3 डिज़ाइन का अंतिम हिस्सा H100 के Tensor Memory Accelerator (TMA) का उपयोग है। TMA एक विशेष हार्डवेयर है जो मेमोरी कॉपीज़ को असिंक्रोनस रूप से हैंडल करता है, बिना मुख्य compute कोर्स को व्यस्त किए।
फ्लैश अटेंशन 3 TMA का उपयोग करके बैकग्राउंड में डेटा की टाइल्स को मूव करता है, जबकि गणना बिना रुकावट जारी रहती है। मेमोरी मूवमेंट को गणित के साथ कड़ी तरह ओवरलैप करके, FA3 हार्डवेयर की सैद्धांतिक अधिकतम प्रदर्शन का लगभग 75 प्रतिशत निकाल पाने में सक्षम है।
फ्लैश अटेंशन 4 (FA4) अटेंशन अनुकूलन का अगला प्रायोगिक कदम है। इसे NVIDIA के आने वाले Blackwell B200 GPUs के लिए डिज़ाइन किया गया है और यह जांचता है कि जब अटेंशन कर्नेल पूरी तरह नई श्रेणी के हार्डवेयर के लिए बनाए जाएँ तो क्या संभव हो जाता है।
जैसे-जैसे मॉडल का आकार बढ़ता जा रहा है और ट्रेनिंग ट्रिलियन-पैरामीटर पैमाने की ओर बढ़ रही है, फ्लैश अटेंशन 3 भी अंततः सीमाओं से टकराएगा। FA4 उन सीमाओं को हटाने का प्रारंभिक प्रयास है—किसी भी पिछले अटेंशन कर्नेल से आगे बढ़कर हार्डवेयर उपयोग को धकेलते हुए।
इस चरण में, फ्लैश अटेंशन 4 रिसर्च और प्री-प्रोडक्शन तकनीक है। यह मजबूत संभावनाएँ दिखाता है, पर अभी तक तैनात या प्रोडक्शन-ग्रेड मॉडलों में उपयोग नहीं होता।
फ्लैश अटेंशन 4 का एक प्रमुख मील का पत्थर प्रदर्शन है। यह पहला अटेंशन कर्नेल है जिसे एकल GPU पर 1 PFLOPS—यानी एक क्वाड्रिलियन फ्लोटिंग-पॉइंट ऑपरेशंस प्रति सेकंड—से अधिक करने के लिए डिज़ाइन किया गया है।
यह उस भविष्य को लक्षित करता है जहाँ ट्रिलियन-पैरामीटर मॉडलों को ट्रेन करना अव्यावहारिक रूप से लंबा समय लेगा। उस पैमाने पर, छोटी-छोटी अक्षमताएँ भी बड़े विलंब में बदल जाती हैं। FA4 एक ही चिप से चरम प्रदर्शन निकालकर ऐसे भविष्य के ट्रेनिंग रन को संभव बनाना चाहता है।
उस प्रदर्शन तक पहुँचने के लिए, FA4 असिंक्रोनसता को पहले के संस्करणों से कहीं आगे तक धकेलता है। यह प्रोड्यूसर-कंज्यूमर मॉडल को अत्यंत जटिल, बहु-चरण पाइपलाइनों में विस्तारित करता है जहाँ डेटा मूवमेंट, गणना और सिंक्रोनाइज़ेशन—तीनों स्वतंत्र रूप से संचालित होते हैं।
लोडिंग और कंप्यूटिंग के अपेक्षाकृत साधारण ओवरलैप के बजाय, FA4 कई चरणों में गहरी असिंक्रोनस एक्ज़ीक्यूशन को मैनेज करता है। कर्नेल के अलग-अलग हिस्से अलग रफ्तार से आगे बढ़ते हैं, जिन्हें एकल सिंक्रोनाइज़्ड फ्लो की जगह हार्डवेयर-स्तरीय शेड्यूलिंग समन्वित करती है।
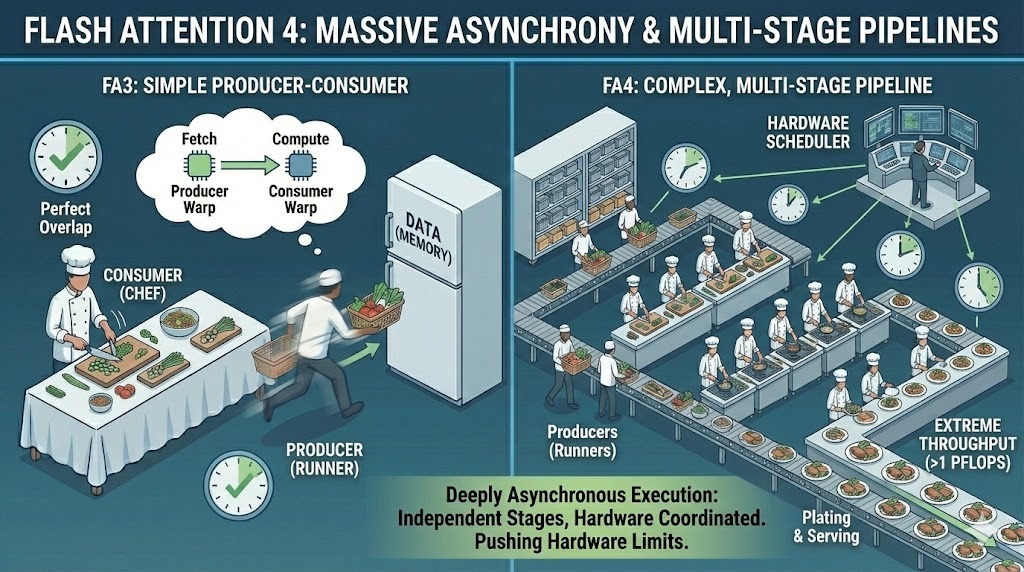
फ्लैश अटेंशन 4 में विशाल असिंक्रोनसता
यही जटिलता कारण है कि FA4 अभी प्रायोगिक है। इस स्तर पर सटीकता, स्थिरता और इंटीग्रेशन को संभालना चुनौतीपूर्ण है। समुदाय को इसे बड़े प्रोडक्शन मॉडलों में भरोसेमंद रूप से उपयोग करने से पहले और कार्य करने की आवश्यकता है।
आइए कुछ प्रमुख क्षेत्रों में देखें कि फ्लैश अटेंशन मानक अटेंशन मैकेनिज्म से कैसे तुलना करता है।
बेंचमार्क लगातार दिखाते हैं कि फ्लैश अटेंशन के सभी संस्करण मानक सेल्फ-अटेंशन से बेहतर प्रदर्शन करते हैं, और सीक्वेंस लंबाई बढ़ने के साथ लाभ और बढ़ते हैं।
मूल फ्लैश अटेंशन पेपर अनुकूलित मानक अटेंशन पर लगभग 2 से 4× स्पीडअप की रिपोर्ट करता है। फ्लैश अटेंशन 2 इससे आगे सुधार करता है—पैरेललिज़्म बढ़ाकर और GPU को बेहतर सैचुरेट करके—और व्यवहार में अक्सर ~2× अतिरिक्त सुधार देता है।
फ्लैश अटेंशन 3 Hopper GPUs पर, खासकर FP8 के साथ, प्रदर्शन को और आगे धकेलता है, और मानक अटेंशन की तुलना में कहीं अधिक उच्च हार्डवेयर उपयोग हासिल करता है।
मानक अटेंशन N × N की पूरी अटेंशन मैट्रिक्स को स्पष्ट रूप से तैयार करता है, जिसके कारण सीक्वेंस लंबाई के साथ मेमोरी का द्विघात (quadratic) वृद्धि होती है। जैसे-जैसे N बढ़ता है, मेमोरी उपयोग विस्फोटक रूप से बढ़ता है और GPU मेमोरी जल्दी फुल हो जाती है। फ्लैश अटेंशन इस मैट्रिक्स को स्टोर करना पूरी तरह टाल देता है।
टाइल्स में अटेंशन की गणना करके और इंटरमीडिएट परिणामों को तेज़ ऑन-चिप मेमोरी में रखकर, यह निश्चित हेड डायमेंशंस के लिए मेमोरी उपयोग को सीक्वेंस लंबाई के सापेक्ष रैखिक (linear) बना देता है। द्विघात से रैखिक स्केलिंग में यह बदलाव मानक अटेंशन की सबसे बड़ी संरचनात्मक बाधा को हटा देता है।
यह मेमोरी कमी सीधे लंबी कॉन्टेक्स्ट विंडो सक्षम करती है। मानक अटेंशन के साथ, कुछ हज़ार टोकनों पर ही मॉडल अक्सर आउट-ऑफ-मेमोरी त्रुटियों से टकरा जाते हैं।
फ्लैश अटेंशन एकल GPU पर 4k और 8k टोकन कॉन्टेक्स्ट को व्यावहारिक बनाता है, और अन्य मेमोरी-बचत तकनीकों के साथ मिलकर उसी डिवाइस पर 16k या 32k जैसे कहीं लंबे विंडो भी अनलॉक करता है।
यहाँ भ्रमित न हों: कुछ अग्रिम पंक्ति के मॉडलों जैसे Gemini 3 में हासिल की गई लाख-टोकन वाली विशाल विंडो, वास्तव में, सीक्वेंस को बड़े GPU क्लस्टर्स में बाँटकर हासिल की जाती हैं—क्योंकि वे किसी एक डिवाइस की मेमोरी क्षमता से बहुत आगे होती हैं।
आज फ्लैश अटेंशन का उपयोग पहले से कहीं सरल है। अधिकांश मामलों में, आपको कस्टम CUDA कर्नेल लिखने या अपने मॉडल आर्किटेक्चर को बदलने की ज़रूरत नहीं है। लोकप्रिय टूल्स में सपोर्ट पहले से मौजूद है।
PyTorch 2.0 से, फ्लैश अटेंशन सीधे torch.nn.functional.scaled_dot_product_attention के माध्यम से उपलब्ध है। जब आप इस फ़ंक्शन को कॉल करते हैं, तो PyTorch आपके हार्डवेयर के लिए उपलब्ध सबसे तेज़ अटेंशन बैकएंड स्वतः चुनता है।
समर्थित GPUs पर, वह बैकएंड फ्लैश अटेंशन होता है। उपयोगकर्ता के नज़रिये से, यह अक्सर मानक अटेंशन कोड जैसा दिखता है, पर अंदर ही अंदर PyTorch एक अनुकूलित फ्लैश अटेंशन कर्नेल डिस्पैच करता है।
यदि आप Hugging Face Transformers का उपयोग कर रहे हैं, तो फ्लैश अटेंशन सक्षम करना आमतौर पर एक लाइन का बदलाव है। मॉडल कॉन्फ़िगरेशन में attn_implementation="flash_attention_2" सेट करने से लाइब्रेरी जहाँ संभव हो, फ्लैश अटेंशन 2 का उपयोग करती है।
कई ट्रांसफॉर्मर मॉडलों के लिए, इतना करना ही स्पीड और मेमोरी—दोनों में सुधार पाने के लिए काफ़ी है, बिना बाकी ट्रेनिंग या इन्फरेंस कोड को छुए।
फ्लैश अटेंशन 2 आधुनिक NVIDIA GPUs को लक्षित करता है और Ampere, Ada, और Hopper आर्किटेक्चर—जैसे A100, RTX 3090, RTX 4090, और H100—पर सबसे अच्छा चलता है। ये GPUs मेमोरी बैंडविड्थ और आर्किटेक्चरल सुविधाएँ प्रदान करते हैं जो FA2 में टाइलिंग और पैरेललिज़्म का पूरा लाभ लेने के लिए आवश्यक हैं।
यह भी उल्लेखनीय है कि मूल फ्लैश अटेंशन v1 पुराने GPUs को भी सपोर्ट करता है। Turing-आधारित कार्ड्स, जैसे T4 और RTX 2080, अभी भी फ्लैश अटेंशन v1 का उपयोग कर सकते हैं, हालांकि नए संस्करणों के पूर्ण प्रदर्शन लाभ अनलॉक करने के लिए अधिक हालिया हार्डवेयर चाहिए।
व्यवहार में, यदि आप पहले से ही किसी आधुनिक NVIDIA GPU पर PyTorch 2.x या Hugging Face Transformers का उपयोग कर रहे हैं, तो फ्लैश अटेंशन अक्सर सिर्फ एक कॉन्फ़िगरेशन स्विच भर दूर है।
मानक अटेंशन एक सख्त दीवार से टकराया क्योंकि द्विघात मेमोरी वृद्धि ने लंबी सीक्वेंस को धीमा, महंगा या मेमोरी खत्म होने के कारण असंभव बना दिया। फ्लैश अटेंशन ने अटेंशन के निष्पादन के तरीके को फिर से डिज़ाइन करके इसे बदल दिया।
सीक्वेंस लंबाई के सापेक्ष मेमोरी उपयोग को द्विघात से रैखिक करने से, फ्लैश अटेंशन लंबी-कॉन्टेक्स्ट मॉडलिंग को व्यावहारिक बनाता है। वे कॉन्टेक्स्ट विंडो, जो कुछ हज़ार टोकनों पर GPUs को अभिभूत कर देती थीं, अब उसी हार्डवेयर पर 4k, 8k, और यहाँ तक कि 32k+ टोकनों तक स्केल करती हैं।
यदि आप बड़े पैमाने पर ट्रांसफॉर्मरों के साथ काम कर रहे हैं और फ्लैश अटेंशन का उपयोग नहीं कर रहे हैं, तो आप लगभग निश्चित रूप से प्रदर्शन मेज़ पर छोड़ रहे हैं।
अपने ऐसे मॉडल बनाने के इच्छुक हैं जो फ्लैश अटेंशन का उपयोग कर सकें? हमारा PyTorch के साथ ट्रांसफॉर्मर मॉडल पर पाठ्यक्रम करें!
AI पाठ्यक्रम
कोर्स
कोर्स
लर्निंग पाथ
