

कोर्स
Claude मॉडलों का परिचय
3 घंटा
15K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंपिछले सप्ताह Claude Opus 4.7 जारी हुआ, जो Anthropic के प्रमुख मॉडल का नवीनतम संस्करण है। लगभग तीन गुना दृश्य रेजोल्यूशन और जटिल प्रॉम्प्ट्स के प्रति अधिक शाब्दिक अनुपालन के साथ, Opus 4.7 जटिल यूज़र इंटरफेस में नेविगेट करने और उच्च-निष्ठा वाले तकनीकी आरेखों को अभूतपूर्व सटीकता से पढ़ने के लिए बनाया गया है।
इस ट्यूटोरियल में, मैं आपको Claude Opus 4.7 में किए गए मुख्य बदलावों से अवगत कराऊँगा। हम देखेंगे कि यह मॉडल क्या है, यह कौन-सी महत्वपूर्ण नई सुविधाएँ लाता है, और इसे Python के साथ लोकली कैसे सेट करें। अंत में, हम एक पूर्णत: कार्यात्मक, बहु-चरणीय डेमो प्रोजेक्ट बनाएँगे: एक स्वायत्त, उच्च-रेजोल्यूशन विज़ुअल चार्ट डिजिटाइज़र।
यदि आप Anthropic के बड़े भाषा मॉडल्स (LLMs) के बारे में और जानना चाहते हैं, तो हमारा Introduction to Claude Models कोर्स करने की मैं अनुशंसा करता हूँ।
Claude Opus 4.7 Anthropic का नवीनतम फ्लैगशिप LLM है। चूँकि कंपनी अपने अधिक शक्तिशाली Claude Mythos Preview को केवल स्वीकृत सुरक्षा विशेषज्ञों तक सीमित रखती है, इसलिए Opus 4.7 सामान्य डेवलपर्स के लिए इसका मुख्य, व्यापक रूप से उपलब्ध एप्लिकेशन प्रोग्रामिंग इंटरफेस बना हुआ है।
इस संस्करण में कई क्षेत्रों में अपग्रेड्स आए हैं:
डेवलपर्स ने कड़े निर्देशों का पालन करने और दोहराए जाने वाले प्रोसेसिंग लूप्स से बचने की इसकी क्षमता में उल्लेखनीय सुधार देखा है। Opus 4.7 स्वाभाविक रूप से अपना काम डबल-चेक करता है और कोड लिखने से पहले मान्यताओं की समीक्षा करता है, जिससे एजेंट्स के निरंतर त्रुटि लूप्स में फँसने की संभावना काफी घट जाती है।
बेंचमार्क डेटा को देखते समय, एक परिणाम विशेष रूप से उभरकर आता है। चुनौतीपूर्ण SWE-bench Pro टेस्ट में, जो मापता है कि AI ओपन-सोर्स GitHub सॉफ्टवेयर बग्स को कितनी अच्छी तरह ठीक करता है, Opus 4.7 ने अपने पूर्ववर्ती की तुलना में 10.9 अंकों की बढ़त हासिल की। यह छलांग Opus मॉडल परिवार की भूमिका को एजेंटिक प्रोग्रामिंग के प्रमुख रूप में पुख्ता करती है।
मॉडल के बारे में अधिक जानने के लिए हमारी Claude Opus 4.7 गाइड देखें।
Opus 4.7 में संक्रमण से कम्प्यूट संसाधनों को प्रबंधित करने के लिए कई नए नियंत्रण-प्लेन और प्रॉम्प्ट इंजीनियरिंग में कुछ बदलाव आते हैं। यहाँ वे प्रमुख परिवर्तन और नई सुविधाएँ हैं जिनके बारे में आपको जानना चाहिए:
हाई-रेजोल्यूशन मल्टीमोडल विज़न: मॉडल सबसे लंबी किनारे पर अधिकतम स्वीकृत इमेज डाइमेंशन को 2,576 पिक्सेल तक बढ़ाता है, जिससे लगभग 3.75 मेगापिक्सेल का प्रभावी रेजोल्यूशन मिलता है। ज्यामितीय कोऑर्डिनेट मैपिंग को पुनर्गठित किया गया है, यानी अब बाउंडिंग बॉक्स कोऑर्डिनेट्स का वास्तविक इमेज पिक्सेल्स के साथ सख्त 1:1 मैपिंग है, जिससे जटिल स्केल-फैक्टर गणना की आवश्यकता समाप्त हो जाती है।
एडेप्टिव थिंकिंग: विस्तारित थिंकिंग बजट्स (जैसे budget_tokens) पूरी तरह हटा दिए गए हैं। पुराने अनुरोध सबमिट करने पर HTTP 400 त्रुटि मिलेगी। इसके बजाय, Opus 4.7 "एडेप्टिव थिंकिंग" (thinking: {"type": "adaptive"}) का उपयोग अनिवार्य करता है, जो मॉडल को प्रॉम्प्ट की जटिलता के आधार पर अपना आंतरिक रीजनिंग बजट गतिशील रूप से आवंटित करने देता है।
सूक्ष्म प्रयास-नियंत्रण: एक नया पैरामीटर मान xhigh (एक्स्ट्रा हाई) मानक high और अधिकतम max प्रयास सेटिंग्स के बीच गणितीय रूप से स्थित है। Anthropic xhigh को एजेंटिक कोडिंग और जटिल समस्या-समाधान के लिए आदर्श आरंभिक बिंदु के रूप में दृढ़ता से अनुशंसित करता है। मॉडल और अधिक "लिटरलिज़्म" की ओर मुड़ा है; यह दिए गए टेक्स्ट को बिना "बीच की बातें पढ़े" ठीक-ठीक निष्पादित करता है।
टास्क बजेट्स: बेकाबू एजेंटिक लूप्स को गणितीय रूप से कम करने के लिए, Opus 4.7 "टास्क बजेट्स" (वर्तमान में पब्लिक बीटा में) पेश करता है। task_budget परिभाषित करके, डेवलपर्स मॉडल को पूरे टास्क जीवनचक्र के लिए कुल टोकन अनुमति स्पष्ट रूप से बताते हैं। मॉडल इस काउंटडाउन को लगातार ट्रैक करता है और सुगम टास्क पूर्णता सुनिश्चित करने के लिए स्वयं-संयम रखता है।
क्लाइंट-साइड मेमोरी टूल: Opus 4.7 मैनेज्ड स्क्रैचपैड में लिखने और पढ़ने में असाधारण रूप से दक्ष है। इसे औपचारिक बनाने के लिए, Anthropic ने क्लाइंट-साइड मेमोरी टूल को बेहतर किया, जो MemFS (Memory File System) वर्कफ्लोज़ के लिए अनुकूलित git-बैक्ड सिंक्रोनाइज़ेशन क्षमताएँ प्रदान करता है।
डेमो प्रोजेक्ट को कोड करने से पहले, हमें अपना वातावरण Opus 4.7 को सपोर्ट करने के लिए सेट करना होगा। इस ट्यूटोरियल में, हम असिंक्रोनस Python का उपयोग करेंगे, क्योंकि यह डेटा-इंटेंसिव, हाई-कन्करेंसी वर्कफ्लोज़ के लिए इंडस्ट्री स्टैंडर्ड है।
हमारे सिस्टम पर Python 3.8 या उससे ऊपर इंस्टॉल होना चाहिए। डिपेंडेंसी कॉन्फ्लिक्ट्स से बचने के लिए मैं एक आइसोलेटेड वर्चुअल वातावरण बनाने की कड़ी अनुशंसा करता हूँ।
यहाँ Anaconda का उपयोग करके opus_4_7 नाम का ऐसा वातावरण बनाने और सक्रिय करने का तरीका है:
conda create -n opus_4_7 python=3.10 -y
conda activate opus_4_7
Claude Opus 4.7 की सैद्धांतिक क्षमताओं को व्यावहारिक अनुप्रयोग में लाने के लिए, हम एक स्वायत्त हाई-रेजोल्यूशन चार्ट डिजिटाइज़र बनाएँगे।
डेटा वैज्ञानिकों को अक्सर मूल्यवान डेटा स्थिर छवियों या PDFs के रूप में मिलता है (जैसे स्कैटर प्लॉट, बार चार्ट, या लाइन ग्राफ)। पुराने AI मॉडलों के साथ इन चार्ट्स से डेटा निकालने के स्वचालन हेतु जटिल स्केल-फैक्टर गणनाएँ लिखनी पड़ती थीं।
इस प्रोजेक्ट में, हम एक Python स्क्रिप्ट बनाएँगे जो किसी भी चार्ट का स्क्रीनशॉट ले और कच्चे डेटा के साथ एक CSV फ़ाइल बनाए।
हम स्पष्ट रूप से यह करेंगे:
नए 3.75MP विज़न और 1:1 पिक्सल मैपिंग का उपयोग करके ग्राफ को पूरी तरह पढ़ना।
xhigh प्रयास स्तर पर एडेप्टिव थिंकिंग का उपयोग करके X और Y अक्षों का कठोरता से निष्कर्ष निकालना।
सटीक डेटा बिंदुओं वाला साफ-सुथरा Pandas DataFrame आउटपुट करना।
मैं आपको यह प्रक्रिया चरण-दर-चरण समझाऊँगा। यह ट्यूटोरियल स्व-निहित है, लेकिन यदि आप मॉडल की क्षमताओं के बारे में और जानना चाहते हैं या अपने एजेंट्स को लागू करते समय अटक जाते हैं, तो इसका आधिकारिक दस्तावेज़ देखें।
सबसे पहले, हमें ऑथेंटिकेशन सक्षम करना होगा। इसके लिए, हमें Anthropic Developer Console पर एक API की बनानी होगी।
API क्रेडेंशियल्स को कभी भी सीधे अपने सोर्स कोड रिपॉज़िटरी में हार्डकोड न करें। इसके बजाय, अपने प्रोजेक्ट की रूट डायरेक्टरी में एक सुरक्षित .env फ़ाइल बनाएं:
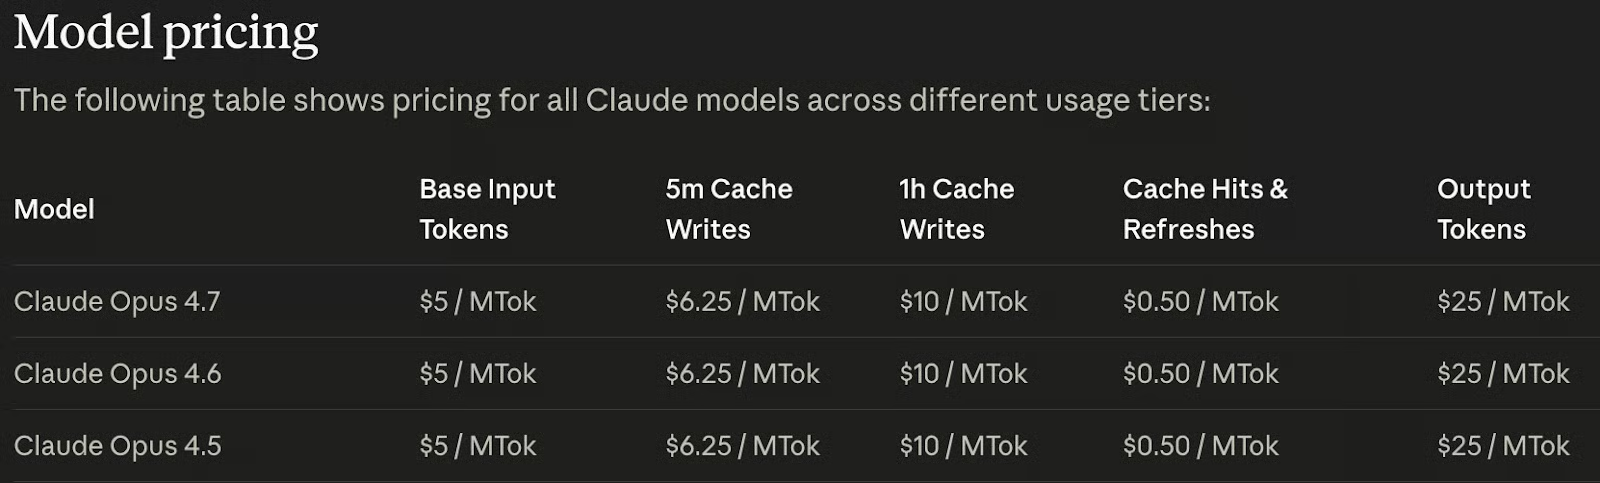
ANTHROPIC_API_KEY=<paste_your_api_key_here>ध्यान दें कि मॉडल निःशुल्क नहीं है। API की सक्षम करने के लिए हमें अपने खाते में क्रेडिट्स जोड़ने होंगे। अच्छी खबर यह है कि मॉडल की कीमत पिछले दो मॉडलों के समान है:
अब आवश्यक लाइब्रेरीज़ इंस्टॉल करें। हमें आवश्यकता होगी:
anthropic, API इंटीग्रेशन के लिए आधिकारिक anthropic SDK;
python-dotenv वातावरण वेरिएबल प्रबंधन के लिए;
pandas हमारे निकाले गए डेटा की संरचना के लिए।
अपना टर्मिनल खोलें और निम्न कमांड चलाएँ (सुनिश्चित करें कि ऊपर बनाया गया opus_4_7 वातावरण सक्रिय है):
pip install anthropic python-dotenv pandasआइए एक बुनियादी असिंक्रोनस कमांड-लाइन इंटरफ़ेस बनाकर नींव रखें। यह चरण Opus 4.7 के नए xhigh प्रयास स्तर और एडेप्टिव थिंकिंग आर्किटेक्चर का परिचय देता है। chart_digitizer.py नामक फ़ाइल बनाएँ और निम्न कोड जोड़ें:
import os
import asyncio
from dotenv import load_dotenv
from anthropic import AsyncAnthropic

# Ingest secure environment variables
load_dotenv()

# Initialize the asynchronous Anthropic client
client = AsyncAnthropic(
    api_key=os.environ.get("ANTHROPIC_API_KEY")
)

async def test_adaptive_thinking():
    print("Initiating Text Agent with Adaptive Thinking...")

    response = await client.messages.create(
        model="claude-opus-4-7",
        max_tokens=64000,
        stream=True, # Required for long responses
        thinking={"type": "adaptive"}, # NEW: Replaces budget_tokens
        output_config={"effort": "xhigh"}, # NEW: Extra high effort level
        messages=[
            {"role": "user", "content": "Explain why 1:1 pixel mapping is crucial for data extraction."}
        ]
    )

    # Parse the streaming response structure
    async with response as stream:
        async for event in stream:
            if event.type == "content_block_start":
                if event.content_block.type == "thinking":
                    print("\n--- Internal Reasoning Trace ---")
                elif event.content_block.type == "text":
                    print("\n--- Final Output ---")
            elif event.type == "content_block_delta":
                if event.delta.type == "thinking_delta":
                    print(event.delta.thinking, end="", flush=True)
                elif event.delta.type == "text_delta":
                    print(event.delta.text, end="", flush=True)

if __name__ == "__main__":
    asyncio.run(test_adaptive_thinking())
इसे हम इस कमांड से चला सकते हैं:
python chart_digitizer.pyयह स्क्रिप्ट दिखाती है कि Claude Opus 4.7 को अनुरोध कैसे भेजें, लेकिन यह अभी चार्ट से डेटा नहीं निकालती। यह केवल यह प्रॉम्प्ट भेजती है:
Explain why 1:1 pixel mapping is crucial for data extraction.यह सुनिश्चित करने के लिए कि मॉडल हमें Pandas में उपयोग करने योग्य साफ डेटा दे, हम "टूल" का उपयोग करेंगे ताकि स्ट्रक्चर्ड आउटपुट मजबूरन प्राप्त हो। हम एक JSON स्कीमा परिभाषित करते हैं जो Claude को बताता है कि निकाले गए चार्ट कोऑर्डिनेट्स को ठीक-ठीक कैसे फ़ॉर्मैट करना है।
मॉडल को टूल और सिस्टम प्रॉम्प्ट का उपयोग करने के लिए बाध्य करने हेतु, क्लाइंट इनिशियलाइज़ेशन के बाद chart_digitizer.py फ़ाइल को टूल स्कीमा और सिस्टम प्रॉम्प्ट जोड़कर अपडेट करें:
# Define the JSON schema to force structured data extraction
extraction_tool = {
    "name": "save_chart_data",
    "description": "Saves the extracted data points from the chart into a structured format.",
    "input_schema": {
        "type": "object",
        "properties": {
            "x_axis_label": {"type": "string", "description": "The label for the X axis"},
            "y_axis_label": {"type": "string", "description": "The label for the Y axis"},
            "data_points": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "x": {"type": "number", "description": "X-axis value"},
                        "y": {"type": "number", "description": "Y-axis value"}
                    },
                    "required": ["x", "y"]
                }
            }
        },
        "required": ["x_axis_label", "y_axis_label", "data_points"]
    }
}

SYSTEM_PROMPT = """
You are an expert Data Scientist. Your task is to digitize the provided chart image.
Execute the following strict, literal directives:
1. Scan the image using your 1:1 pixel mapping capabilities to identify the X and Y axes, their scales, and all plotted data points.
2. Utilize your adaptive thinking space to perform the mathematical conversions from visual pixel locations to the actual chart values.
3. You MUST use the 'save_chart_data' tool to output the final extracted data points.
Do not guess. Be highly precise.
"""
मॉडल को टूल और सिस्टम प्रॉम्प्ट का उपयोग कराने के लिए, हम अनुरोध को tool और system पैरामीटर्स के साथ अपडेट करते हैं:
response = await client.messages.create(
        model="claude-opus-4-7",
        max_tokens=64000,
        stream=True,
        thinking={"type": "adaptive"},
        system=SYSTEM_PROMPT, # Add to enable the system prompt
        tools=[extraction_tool], # Add to provide the tool to the model
        messages=messages,
        output_config={
            "effort": "xhigh",
        }
)सैकड़ों डेटा बिंदुओं का विज़ुअल मैपिंग और उनके सटीक मानों की गणना के लिए अत्यधिक संज्ञानात्मक प्रोसेसिंग चाहिए। अपने कम्प्यूट क्रेडिट्स की सुरक्षा के लिए, हम एक टास्क बजट लागू करेंगे। इस ऑपरेशन के लिए हम 80,000 टोकन्स की सलाहकार सीमा तय करेंगे।
हम इस सीमा को अनुरोध में output_config के भीतर task_budget जोड़कर सेट कर सकते हैं:
response = await client.messages.create(
        model="claude-opus-4-7",
        max_tokens=64000,
        stream=True,
        thinking={"type": "adaptive"},
        system=SYSTEM_PROMPT,
        tools=[extraction_tool],
        messages=messages,
        output_config={
            "effort": "xhigh",
            "task_budget": {"type": "tokens", "total": 80000} # Add to limit output tokens
        }
    )
ध्यान दें कि इस क्षमता को अनलॉक करने के लिए बीटा हेडर्स आवश्यक हैं। इसे सेट करने के लिए, हमें एजेंट इनिशियलाइज़ेशन को इस प्रकार अपडेट करना होगा:
client = AsyncAnthropic(
    api_key=os.environ.get("ANTHROPIC_API_KEY"),
    default_headers={"anthropic-beta": "task-budgets-2026-03-13"}
)अंतिम चरण में, हम 3.75MP विज़ुअल क्षमताओं को एकीकृत करेंगे। हम इमेज इनजेशन को संभालने के लिए एक मजबूत यूटिलिटी फ़ंक्शन बनाएँगे और कोड को अंतिम रूप देंगे ताकि डेटा के साथ एक CSV फ़ाइल आउटपुट हो।
हमारे विज़ुअल डिजिटाइज़र के लिए तैयार, अंतिम कोड यहाँ है:
import os
import asyncio
import mimetypes
import sys
from dotenv import load_dotenv
from anthropic import AsyncAnthropic
import base64
import pandas as pd

# Ingest secure environment variables
load_dotenv()

# Initialize the asynchronous Anthropic client
client = AsyncAnthropic(
    api_key=os.environ.get("ANTHROPIC_API_KEY"),
    default_headers={"anthropic-beta": "task-budgets-2026-03-13"}
)

# Define the JSON schema to force structured data extraction
extraction_tool = {
    "name": "save_chart_data",
    "description": "Saves the extracted data points from the chart into a structured format.",
    "input_schema": {
        "type": "object",
        "properties": {
            "x_axis_label": {"type": "string", "description": "The label for the X axis"},
            "y_axis_label": {"type": "string", "description": "The label for the Y axis"},
            "data_points": {
                "type": "array",
                "items": {
                    "type": "object",
                    "properties": {
                        "x": {"type": "number", "description": "X-axis value"},
                        "y": {"type": "number", "description": "Y-axis value"}
                    },
                    "required": ["x", "y"]
                }
            }
        },
        "required": ["x_axis_label", "y_axis_label", "data_points"]
    }
}

SYSTEM_PROMPT = """
You are an expert Data Scientist. Your task is to digitize the provided chart image.
Execute the following strict, literal directives:
1. Scan the image using your 1:1 pixel mapping capabilities to identify the X and Y axes, their scales, and all plotted data points.
2. Utilize your adaptive thinking space to perform the mathematical conversions from visual pixel locations to the actual chart values.
3. You MUST use the 'save_chart_data' tool to output the final extracted data points.
Do not guess. Be highly precise.
"""

def encode_high_res_image(image_path: str) -> tuple[str, str]:
    if not os.path.exists(image_path):
        raise FileNotFoundError(f"Critical Error: Image not located at {image_path}")
    with open(image_path, "rb") as image_file:
        base64_data = base64.b64encode(image_file.read()).decode("utf-8")

    media_type, _ = mimetypes.guess_type(image_path)
    if not media_type or not media_type.startswith("image/"):
        media_type = "image/png"
    return base64_data, media_type

async def digitize_chart(image_path: str = "chart.jpg"):
    print("\nInitiating Opus 4.7 Autonomous Chart Digitization...")
    IMAGE_PATH = image_path
    base64_image_data, media_type = encode_high_res_image(IMAGE_PATH)

    messages = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                    "source": {
                        "type": "base64",
                        "media_type": media_type,
                        "data": base64_image_data
                    }
                },
                {
                    "type": "text",
                    "text": "Please digitize this chart and extract the data points."
                }
            ]
        }
    ]

    response = await client.messages.create(
        model="claude-opus-4-7",
        max_tokens=64000,
        stream=True,
        thinking={"type": "adaptive"},
        system=SYSTEM_PROMPT,
        tools=[extraction_tool],
        messages=messages,
        output_config={
            "effort": "xhigh",
            "task_budget": {"type": "tokens", "total": 80000}
        }
    )

    # Accumulate tool input and thinking from the stream
    import json
    tool_name = None
    tool_input_json = ""
    thinking_text = ""

    async with response as stream:
        async for event in stream:
            if event.type == "content_block_start":
                if event.content_block.type == "tool_use":
                    tool_name = event.content_block.name
                    tool_input_json = ""
                elif event.content_block.type == "thinking":
                    thinking_text = ""
            elif event.type == "content_block_delta":
                if event.delta.type == "input_json_delta":
                    tool_input_json += event.delta.partial_json
                elif event.delta.type == "thinking_delta":
                    thinking_text += event.delta.thinking

    if thinking_text:
        print("\n--- Internal Thinking (Math & Scaling) ---")
        print(thinking_text[:500] + "...\n[Cognitive trace truncated]")

    if tool_name == "save_chart_data" and tool_input_json:
        print("\n--- Data Extraction Complete! ---")
        chart_data = json.loads(tool_input_json)
        df = pd.DataFrame(chart_data["data_points"])

        print(f"\nX-Axis: {chart_data['x_axis_label']}")
        print(f"Y-Axis: {chart_data['y_axis_label']}")
        print("\nExtracted DataFrame:")
        print(df.head(10))

        output_path = "chart_data.csv"
        df.to_csv(output_path, index=False)
        print(f"\nDataFrame saved to {output_path}")

if __name__ == "__main__":
    image_path = sys.argv[1] if len(sys.argv) > 1 else "chart.jpg"
    asyncio.run(digitize_chart(image_path))
इसे परखने के लिए, मैंने Yahoo Sports से यह चार्ट डाउनलोड किया, जो वर्षवार FIFA वर्ल्ड कप उपस्थिति दिखाता है, और उसे fifa.webp नाम की फ़ाइल में सहेजा:
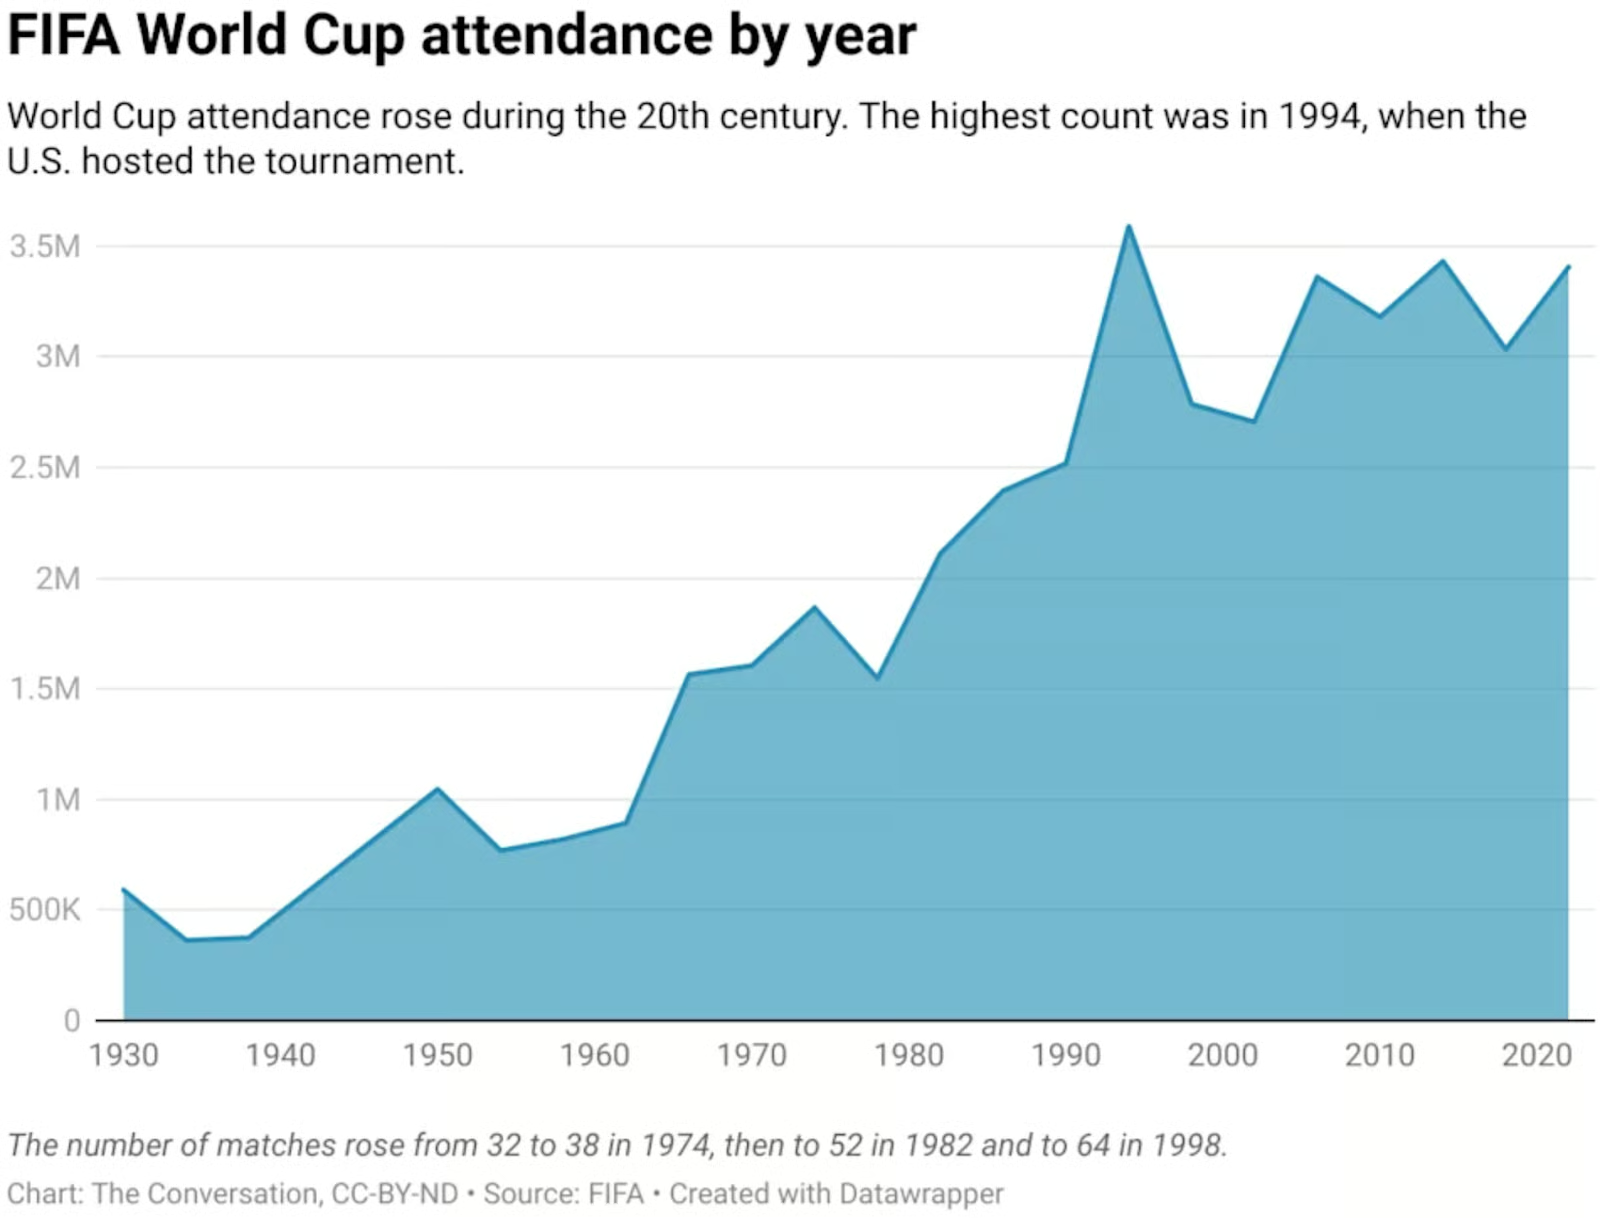
हम पहले की तरह स्क्रिप्ट चलाते हैं, लेकिन तर्क (argument) के रूप में चार्ट इमेज का नाम देकर:
python chart_digitizer.py fifa.webp यह रहा परिणाम:
Extracted DataFrame:
      x        y
0  1930   590000
1  1934   375000
2  1938   375000
3  1950  1040000
4  1954   770000
5  1958   820000
6  1962   890000
7  1966  1560000
8  1970  1600000
9  1974  1870000
यदि हम इसे प्लॉट करें, तो हम सत्यापित कर सकते हैं कि यह काफ़ी सटीक है, भले ही मूल चार्ट में y-अक्ष पर लेबल न हों।
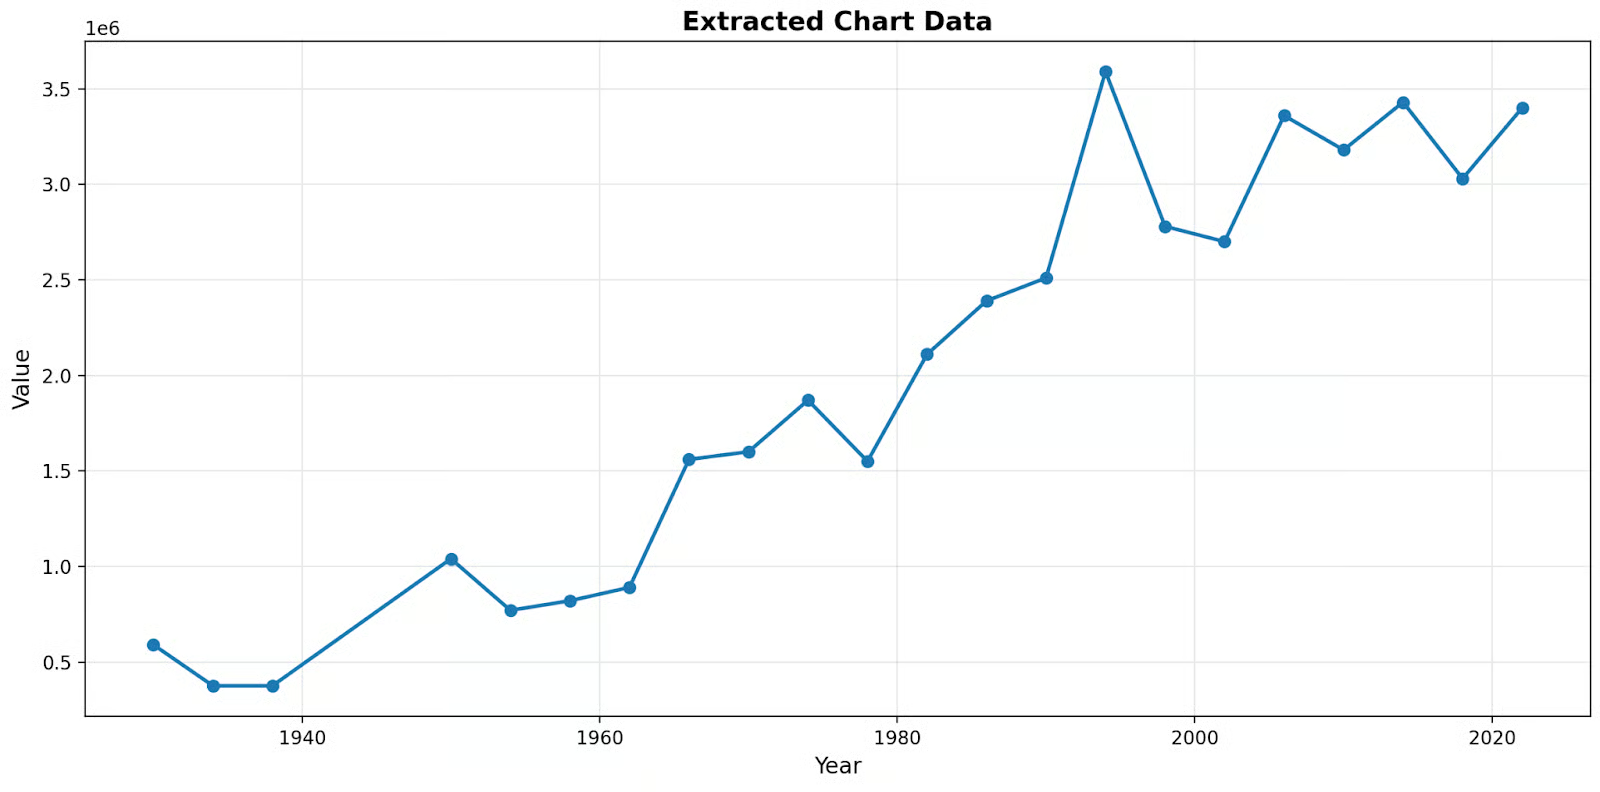
हमने एक साधारण असिंक्रोनस चैटबॉट से लेकर डेटा साइंस के लिए एक अत्यंत मज़बूत विज़ुअल रीजनिंग इंजन तक सफलतापूर्वक संक्रमण किया है।
क्योंकि मॉडल को डाउनसैंपलिंग की ज़रूरत नहीं होती, यह उप-पिक्सल निष्ठा खोए बिना जटिल चार्ट्स को पढ़ सकता है। मैं इसकी क्षमताओं की वास्तविक सराहना करने के लिए इस कोडबेस को विभिन्न जटिल ग्राफ़्स पर आज़माने की अनुशंसा करता हूँ!
कई चार्ट्स पर मॉडल का परीक्षण करते हुए, मैं विशेष रूप से इसकी सटीकता से प्रभावित हुआ। इस स्क्रिप्ट को अंतिम उत्पाद न मानें, क्योंकि अभी सुधार की काफी गुंजाइश है। यदि आप अपने कौशल का अभ्यास करना चाहते हैं, तो यहाँ कुछ सुझाव हैं:
यदि आप Anthropic के मॉडलों का उपयोग करके प्रोग्रामिंग करने में रुचि रखते हैं, तो मैं हमारा Software Development with Claude Code कोर्स करने की कड़ी अनुशंसा करता हूँ!
एजेंटिक AI कोर्स
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें