

कोर्स
R में Data Science के लिए Linear Algebra
4 घंटा
21.9K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंलैपलेशियन ग्राफ-आधारित एल्गोरिदम, इमेज प्रोसेसिंग पाइपलाइनों, और स्पेक्ट्रल क्लस्टरिंग में दिखाई देता है। इसलिए यदि आप ऐसे मॉडल बना रहे हैं जो ग्राफ, छवियों, या उच्च-आयामी डेटा के साथ काम करते हैं, तो लैपलेशियन कोई वैकल्पिक पृष्ठभूमि-गणित नहीं है। यही वह चीज़ है जो अंदरखाने वास्तविक काम कर रही है।
इस लेख में, मैं लैपलेशियन को बुनियाद से कवर करूंगा: इसके पीछे का गणित, ज्यामितीय अंतर्ज्ञान, ग्राफ लैपलेशियन और उसका मैट्रिक्स रूप, और यह वास्तविक मशीन लर्निंग अनुप्रयोगों में कैसे उपयोग होता है।
क्या आपको डिफरेंशियल समीकरणों का एक व्यावहारिक परिचय चाहिए? हमारी हाल की लेख पढ़ें और मूलभूत बातों से लेकर व्यावहारिक मशीन लर्निंग अनुप्रयोगों तक जाएँ।
लैपलेशियन एक द्वितीय-कोटि का डिफरेंशियल ऑपरेटर है। यह बताता है कि किसी भी बिंदु पर एक फ़ंक्शन कैसे मुड़ रहा है।
कभी-कभी इसे ग्रेडिएंट के डायवर्जेंस के रूप में भी वर्णित किया जाता है।
और यही समझने की कुंजी है कि यह ऑपरेटर वास्तव में क्या करता है:
एक साथ मिलकर, लैपलेशियन बताता है कि कोई बिंदु स्थानीय शिखर है, स्थानीय गर्त है, या बीच का कोई समतल क्षेत्र।
सरल शब्दों में, लैपलेशियन मापता है कि किसी बिंदु पर फ़ंक्शन का मान उसके पड़ोसियों के औसत मान से कितना भिन्न है। यदि लैपलेशियन शून्य है, तो फ़ंक्शन स्थानीय रूप से "संतुलित" है। धनात्मक का अर्थ है कि बिंदु अपने आस-पास से नीचे बैठा है। ऋणात्मक का अर्थ है कि वह उनके ऊपर बैठा है।
2D में, फ़ंक्शन f(x, y) के लिए:
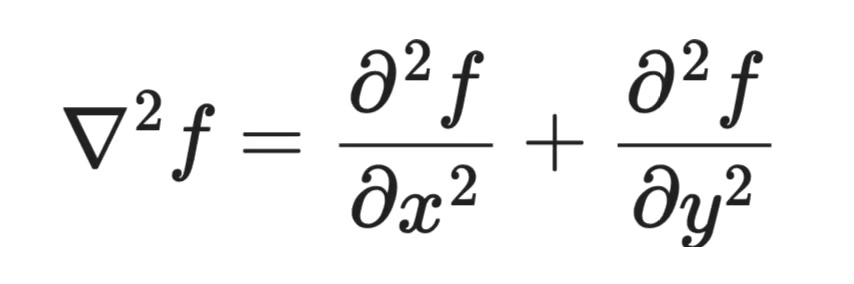
2D लैपलेशियन सूत्र
3D में, फ़ंक्शन f(x, y, z) के लिए:
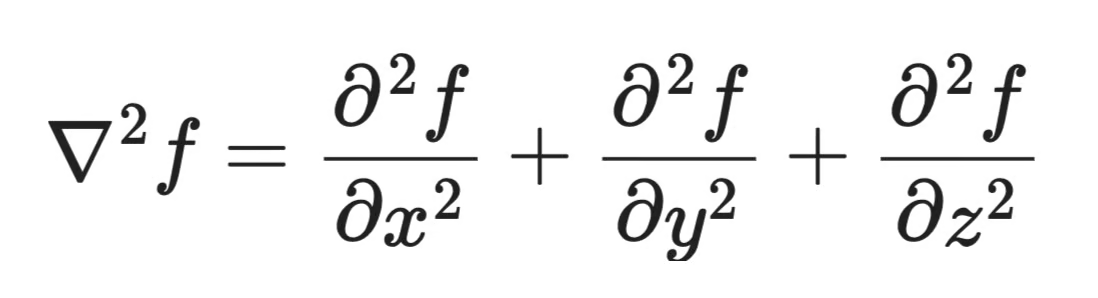
3D लैपलेशियन सूत्र
यह पैटर्न किसी भी संख्या के आयामों में लागू होता है - आप प्रत्येक अक्ष के साथ द्वितीय आंशिक अवकलनों का योग करते हैं। यही कारण है कि लैपलेशियन उच्च-आयामी डेटा के लिए उपयुक्त है, और यही वजह है कि यह मशीन लर्निंग में अक्सर दिखता है।
लैपलेशियन का सूत्र उतना छोटा है जितनी आप उम्मीद नहीं करेंगे, खासकर किसी ऐसी चीज़ के लिए जो मशीन लर्निंग में इतनी जगह-जगह दिखती है।
3D में, फ़ंक्शन f(x, y, z) के लिए, यह ऐसा दिखता है:
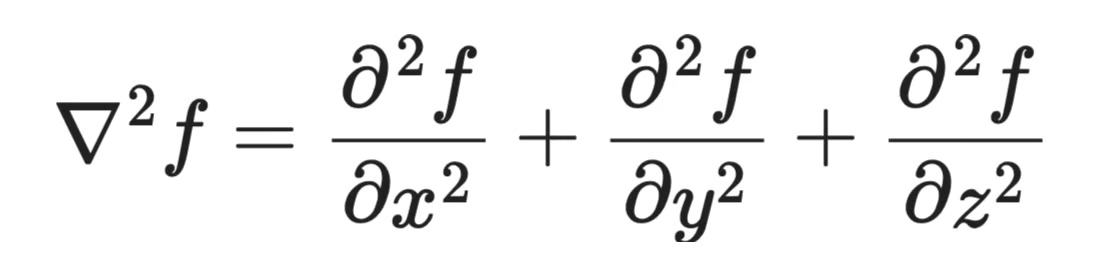
3D लैपलेशियन सूत्र
बस इतना ही। आप द्वितीय आंशिक अवकलनों का प्रत्येक आयाम के साथ योग कर रहे हैं।
प्रत्येक पद अपने अक्ष के साथ एक ही प्रश्न पूछता है: क्या फ़ंक्शन ऊपर की ओर मुड़ा हुआ है, नीचे की ओर मुड़ा हुआ है, या समतल है? जब आप उन उत्तरों को जोड़ते हैं, तो आपको एक एकल संख्या मिलती है जो उस बिंदु पर समग्र वक्रता का वर्णन करती है।
यह सूत्र n आयामों तक सामान्यीकृत होता है। यह n इनपुट आयामों वाले किसी फ़ंक्शन के लिए सामान्य सूत्र है:

लैपलेशियन सूत्र का सामान्यीकरण
यही कारण है कि लैपलेशियन मशीन लर्निंग में अच्छा काम करता है, जहाँ आपका डेटा अक्सर सैकड़ों या हजारों आयामों में रहता है। ऑपरेटर बस प्रत्येक आयाम के साथ वक्रता का योग करता है।
यदि आपने ग्रेडिएंट डिसेंट के साथ काम किया है, तो आप पहले अवकलों के बारे में सोचते हैं - किस दिशा में ढलान नीचे है? लैपलेशियन आपको एक कदम आगे ले जाता है।
द्वितीय अवकल आपको उस पहाड़ी के आकार के बारे में बताते हैं।
किसी बिंदु पर बड़ा धनात्मक लैपलेशियन का अर्थ है कि फ़ंक्शन सभी दिशाओं में तेज़ी से ऊपर की ओर मुड़ रहा है - आप किसी न्यूनतम के पास हैं। बड़ा ऋणात्मक मान का अर्थ है कि आप अधिकतम के पास हैं। शून्य के करीब का अर्थ है कि सतह स्थानीय रूप से समतल है।
यह वक्रता जानकारी सेकंड-ऑर्डर ऑप्टिमाइज़ेशन विधियों में मायने रखती है, जो सादा ग्रेडिएंट डिसेंट की तुलना में अधिक समझदारी से कदम उठाने के लिए इसका उपयोग करती हैं। लैपलेशियन उस वक्रता को एक एकल स्केलर मान में सारांशित करने का एक तरीका है।
किसी बिंदु पर लैपलेशियन का चिन्ह उसके आसपास फ़ंक्शन के आकार को बताता है।
यदि ∇²f > 0 है, तो फ़ंक्शन सभी दिशाओं में ऊपर की ओर मुड़ता है। बिंदु अपने आसपास से नीचे है। यही अवतलता-विपरीत (convexity) है।
यदि ∇²f < 0 है, तो फ़ंक्शन नीचे की ओर मुड़ता है। बिंदु अपने आसपास से ऊपर है। यही अवतलता (concavity) है।
यदि ∇²f = 0 है, तो फ़ंक्शन स्थानीय रूप से समतल है। किसी भी दिशा में शुद्ध वक्रता नहीं है।
यह वही बहु-चर संस्करण है जो आप 1D के दूसरे अवकल परीक्षण में जानते हैं। 1D में, धनात्मक दूसरा अवकल स्थानीय न्यूनतम का और ऋणात्मक स्थानीय अधिकतम का संकेत देता है। लैपलेशियन उसी विचार को किसी भी संख्या के आयामों तक फैलाता है, सभी अक्षों पर वक्रता का योग करके।
हैसियन मैट्रिक्स पूरी वक्रता की तस्वीर को कैद करता है। यह सभी द्वितीय आंशिक अवकलनों का मैट्रिक्स है, और प्रत्येक प्रविष्टि बताती है कि फ़ंक्शन किसी अक्ष-युग्म के साथ कैसे मुड़ता है।
लैपलेशियन हैसियन का ट्रेस है - इसके विकर्ण प्रविष्टियों का योग। जहाँ हैसियन आपको पूरी वक्रता का ब्यौरा देता है, वहीं लैपलेशियन उसे एक एकल संख्या में समेट देता है।
यह समझौता मशीन लर्निंग में महत्वपूर्ण है। उच्च-आयामी मॉडलों के लिए पूरा हैसियन निकालना महँगा है - n पैरामीटर वाले मॉडल का हैसियन n × n होता है। लैपलेशियन आपको वक्रता का सस्ता, स्केलर सारांश देता है जिस पर काम करना तेज़ होता है।
जब आप कोई मॉडल प्रशिक्षित कर रहे होते हैं, तो आप एक लॉस सतह पर नेविगेट कर रहे होते हैं। समतल क्षेत्र धीमी सीखने का मतलब होते हैं। उत्तल क्षेत्र का मतलब है कि ऑप्टिमाइज़र ओवरशूट कर सकता है। लैपलेशियन आपको जल्दी बताता है कि आप किस स्थिति में हैं।
ग्राफ-आधारित विधियाँ ग्राफ के नोड्स में मानों के कितने सुचारू रूप से बदलने को मापने के लिए लैपलेशियन का उपयोग करती हैं। यह सतत फ़ंक्शनों से लेकर असतत संरचनाओं तक उसी वक्रता अंतर्ज्ञान का सीधा विस्तार है।
ग्रेडिएंट डिसेंट केवल पहले अवकलों का उपयोग करता है।
ग्रेडिएंट आपको बताता है कि किस दिशा में कदम रखना है। यह यह नहीं बताता कि वह कदम कितना बड़ा होना चाहिए। समतल, चौड़ी घाटी में तीव्र ग्रेडिएंट बड़े कदम की माँग करता है। वही तीव्र ग्रेडिएंट यदि किसी तेज़ खाई के किनारे के पास है, तो छोटे कदम की। अकेले पहले अवकल यह फर्क नहीं बता सकते।
यही पर दूसरे अवकल काम आते हैं।
वक्रता बताती है कि स्वयं ग्रेडिएंट कितनी तेज़ी से बदल रहा है। उच्च वक्रता का अर्थ है कि लॉस सतह तेज़ी से मुड़ती है - पैरामीटर स्पेस में छोटे कदम ग्रेडिएंट में बड़े बदलाव उत्पन्न करते हैं। कम वक्रता का अर्थ है सतह समतल है और ग्रेडिएंट धीरे-धीरे बदलता है।
यदि आप वक्रता की अनदेखी करते हैं और स्थिर लर्निंग रेट का उपयोग करते हैं, तो आप अनुमान लगा रहे हैं। बहुत बड़ा होगा तो उच्च-वक्रता क्षेत्रों में ओवरशूट करेंगे। बहुत छोटा होगा तो समतल क्षेत्रों में रेंगेंगे।
दूसरे-क्रम की ऑप्टिमाइज़ेशन विधियाँ जैसे न्यूटन की विधि वक्रता का उपयोग अपने-आप स्टेप साइज सेट करने के लिए करती हैं। वे ग्रेडिएंट को वक्रता से भाग देती हैं, जहाँ सतह समतल है वहाँ बड़े कदम और जहाँ तेज़ है वहाँ छोटे कदम लेती हैं।
लैपलेशियन हैसियन का ट्रेस है - एक एकल स्केलर जो किसी बिंदु पर कुल वक्रता को सारांशित करता है। यह हैसियन की तरह पूरी तस्वीर नहीं पकड़ता, लेकिन इसे निकालना सस्ता है और यह एक उपयोगी संकेत है।
यहाँ सरल हिंदी में याद रखने लायक बातें हैं:
वक्रता प्रशिक्षण स्थिरता से भी जुड़ी है। तेज़ (शार्प) न्यूनतम - उच्च वक्रता वाले क्षेत्र - अक्सर समतल (फ्लैट) न्यूनतम की तुलना में बदतर सामान्यीकरण करते हैं। ऐसा मॉडल जो किसी तेज़ न्यूनतम में अभिसरण करता है, इनपुट में छोटे बदलावों के प्रति संवेदनशील होता है।
कुछ नियमितीकरण तकनीकें सीधे वक्रता पर दंड लगाती हैं ताकि ऑप्टिमाइज़ेशन को लॉस सतह के अधिक समतल क्षेत्रों की ओर धकेला जा सके। लैपलेशियन यहाँ भी आता है, एक ऐसे तरीके के रूप में जो इनपुट स्पेस में मॉडल की भविष्यवाणियों के कितनी तेज़ी से बदलने को मापे और सीमित करे।
वक्रता को समझना आपको समझने में मदद करता है कि आपका ऑप्टिमाइज़र क्यों रुक जाता है, आपका लर्निंग रेट इतना महत्वपूर्ण क्यों है, और कुछ न्यूनतम अन्य की तुलना में बेहतर सामान्यीकरण क्यों करते हैं।
अभी तक, लैपलेशियन सतत फ़ंक्शनों की दुनिया में था। लेकिन जब आपका डेटा कोई चिकनी सतह न होकर एक ग्राफ हो तब क्या होता है?
वहीं ग्राफ लैपलेशियन काम आता है। यह वही मूल विचार लेता है - किसी बिंदु पर मान अपने पड़ोसियों से कितना अलग है - और उसे नोड्स और एजेस पर लागू करता है।
ग्राफ लैपलेशियन L को इस प्रकार परिभाषित किया जाता है:

ग्राफ लैपलेशियन सूत्र (सरलीकृत)
दो मैट्रिक्स। बस इतना ही। आइए देखें दोनों का मतलब क्या है।
एडजेसेंसी मैट्रिक्स A बताता है कि कौन-से नोड्स जुड़े हैं। n नोड्स वाले ग्राफ के लिए, A एक n × n मैट्रिक्स है जहाँ A_ij = 1 यदि नोड i और नोड j के बीच एक एज है, और अन्यथा 0।
3 नोड्स वाले एक सरल अनिर्देशित ग्राफ के लिए, जहाँ नोड 1 नोड 2 और 3 से जुड़ता है, लेकिन 2 और 3 आपस में नहीं जुड़ते:

एडजेसेंसी मैट्रिक्स
डिग्री मैट्रिक्स D एक विकर्ण (डायगोनल) मैट्रिक्स है। प्रत्येक विकर्ण प्रविष्टि D_ii नोड i की डिग्री है - उससे जुड़े एजों की संख्या। सभी ऑफ-डायगोनल प्रविष्टियाँ शून्य होती हैं।
उसी ग्राफ के लिए यह सूत्र है:

डिग्री मैट्रिक्स
नोड 1 की डिग्री 2 है (दो नोड्स से जुड़ा)। नोड 2 और 3 प्रत्येक की डिग्री 1 है।
D में से A घटाएँ और आपको L मिलता है:

डिग्री मैट्रिक्स से एडजेसेंसी मैट्रिक्स घटाना
प्रत्येक विकर्ण प्रविष्टि बताती है कि किसी नोड के कितने कनेक्शन हैं। प्रत्येक ऑफ-डायगोनल प्रविष्टि L_ij -1 होती है यदि नोड i और j जुड़े हैं, और 0 यदि वे नहीं जुड़े।
यदि आप L को नोड-मानों के वेक्टर से गुणा करें, तो परिणाम मापता है कि प्रत्येक नोड का मान उसके पड़ोसियों के मानों से कितना भिन्न है। यह पहले वाला ही वक्रता अंतर्ज्ञान का असतत संस्करण है - बस इसे सतत सतह के बजाय ग्राफ पर लागू किया गया है।
L की असली ताकत इसके ईगेनवैल्यू और ईगेनवेक्टर से आती है:
सबसे छोटा ईगेनवैल्यू हमेशा 0 होता है। इसका संबंधित ईगेनवेक्टर एक कॉन्स्टेंट वेक्टर होता है - हर नोड को एक जैसा मान मिलता है। यह तार्किक है: एक स्थिर फ़ंक्शन में ग्राफ के पार "परिवर्तन" शून्य होता है।
शून्य ईगेनवैल्यू की संख्या ग्राफ में कनेक्टेड कंपोनेंट्स की संख्या के बराबर होती है। यदि आपके ग्राफ में तीन असंबद्ध क्लस्टर हैं, तो L में तीन शून्य ईगेनवैल्यू होंगे। यह मैट्रिक्स से ग्राफ कनेक्टिविटी पढ़ने का सीधा तरीका है।
छोटे गैर-शून्य ईगेनवैल्यू ऐसे ईगेनवेक्टर से मेल खाते हैं जो ग्राफ के पार धीरे-धीरे बदलते हैं - पास-पास के नोड्स को मिलते-जुलते मान मिलते हैं। बड़े ईगेनवैल्यू ऐसे ईगेनवेक्टर से मेल खाते हैं जो कनेक्टेड नोड्स के बीच तेज़ी से दोलन करते हैं।
रोचक तथ्य: ईगेनवैल्यू का यह स्पेक्ट्रम ही स्पेक्ट्रल विधियों को उनका नाम देता है।
स्पेक्ट्रल क्लस्टरिंग L के ईगेनवेक्टर का उपयोग ग्राफ-संरचित डेटा में क्लस्टर ढूँढने के लिए करती है। विचार यह है कि छोटे ईगेनवैल्यू से जुड़े ईगेनवेक्टर सघन रूप से जुड़े नोड्स को समान मान देते हैं और ढीले से जुड़े नोड्स को भिन्न मान।
k क्लस्टर खोजने के लिए, आप L के सबसे छोटे गैर-शून्य ईगेनवैल्यू से संबंधित k ईगेनवेक्टर लेते हैं, उन्हें एक मैट्रिक्स में स्टैक करते हैं, और पंक्तियों पर k-means चलाते हैं। प्रत्येक पंक्ति एक नोड है, और इस निम्न-आयामी स्पेस में उसकी स्थिति उसके ग्राफ पड़ोस को दर्शाती है।
यह सोशल नेटवर्क में समुदाय पहचान, दस्तावेज़ क्लस्टरिंग, इमेज सेगमेंटेशन, और जहाँ भी आपके डेटा की प्राकृतिक ग्राफ संरचना होती है, वहाँ काम करता है। दो नोड्स जो कड़ाई से जुड़े हैं, ईगेनवेक्टर स्पेस में पास आते हैं। अलग समुदायों के दो नोड्स दूर आ जाते हैं।
ग्राफ लैपलेशियन एक कठिन संयोज्य (कॉम्बिनेटोरियल) समस्या - इस ग्राफ में क्लस्टर ढूँढो - को रैखिक बीजगणित की समस्या में बदल देता है, जिसे हल करना आसान है।
स्पेक्ट्रल क्लस्टरिंग वह जगह है जहाँ ग्राफ लैपलेशियन दिलचस्प गणित से एक व्यावहारिक एमएल टूल बन जाता है।
मूल विचार यह है कि कच्चे डेटा बिंदुओं को सीधे क्लस्टर करने के बजाय, आप उन्हें L के ईगेनवेक्टर द्वारा परिभाषित स्पेस में क्लस्टर करते हैं। यह स्पेस ग्राफ संरचना को कैद करता है, इसलिए आप देख सकते हैं कि कौन-से नोड्स कड़ाई से जुड़े हैं, कौन-से ढीले से, और कौन-से अलग-अलग समुदायों से संबंधित हैं।
L के सबसे छोटे गैर-शून्य ईगेनवैल्यू से संबंधित k ईगेनवेक्टर लें। उन्हें कॉलम के रूप में एक मैट्रिक्स में स्टैक करें। उस मैट्रिक्स की प्रत्येक पंक्ति अब एक नोड है, जिसे k-आयामी स्पेस में एक बिंदु के रूप में दर्शाया गया है।
छोटे ईगेनवैल्यू से जुड़े ईगेनवेक्टर ग्राफ के पार धीरे-धीरे बदलते हैं। सघन रूप से जुड़े नोड्स को इन ईगेनवेक्टर में मिलते-जुलते मान मिलते हैं - और समान मानों का अर्थ समान पंक्तियाँ - और समान पंक्तियाँ मतलब नए स्पेस में पास-पास आना।
व्यवहार में आप ग्राफ लैपलेशियन के दो संस्करण देखते हैं।
अननॉर्मलाइज़्ड लैपलेशियन सीधा L = D - A है। यह तब अच्छा काम करता है जब नोड्स की डिग्री लगभग समान हो - यानी अधिकांश नोड्स के कनेक्शन की संख्या मिलती-जुलती हो।
नॉर्मलाइज़्ड लैपलेशियन डिग्री असंतुलन के लिए समायोजन करता है। इसके कुछ रूप हैं, लेकिन सबसे आम यह है:

नॉर्मलाइज़्ड लैपलेशियन सूत्र
यह प्रत्येक नोड के योगदान को उसकी डिग्री से पुनःस्केल करता है। वास्तविक दुनिया के ग्राफ़ों में - सोशल नेटवर्क, वेब ग्राफ, सिटेशन नेटवर्क - कुछ नोड्स के सैकड़ों कनेक्शन होते हैं और कुछ के बस एक-दो। बिना सामान्यीकरण के, उच्च-डिग्री नोड्स ईगेनवेक्टर पर हावी हो जाते हैं और क्लस्टरिंग के परिणाम बिगड़ते हैं।
जब तक आपको न पक्का हो कि आपके ग्राफ में डिग्री वितरण समान है, डिफ़ॉल्ट रूप से नॉर्मलाइज़्ड लैपलेशियन का उपयोग करें।
ग्राफ लैपलेशियन के साथ स्पेक्ट्रल क्लस्टरिंग मशीन लर्निंग के बहुत-से कार्यों में दिखाई देती है। कुछ उदाहरण:
जब भी आपके डेटा की कोई प्राकृतिक ग्राफ संरचना हो, या आप युग्मीय समानताओं से एक ग्राफ बना सकें, स्पेक्ट्रल क्लस्टरिंग आपको ऐसे समूह ढूँढने का सुसंगत तरीका देती है जिन्हें शुद्ध दूरी-आधारित विधियाँ चूक जाती हैं।
लैपलेशियन कंप्यूटर विज़न के सबसे पुराने टूल्स में से एक है, और आज भी सक्रिय उपयोग में है।
इमेज प्रोसेसिंग में, पिक्सेल तीव्रता ही फ़ंक्शन है। लैपलेशियन मापता है कि किसी पिक्सेल की तीव्रता उसके पड़ोसियों से कितनी भिन्न है। जहाँ तीव्रता धीरे बदलती है, वहाँ लैपलेशियन शून्य के पास होता है। जहाँ यह तेज़ी से बदलती है - किसी किनारे पर - वहाँ लैपलेशियन मजबूत प्रतिक्रिया देता है।
यही लैपलेशियन एज डिटेक्शन का पूरा आधार है।
पहला अवकल यह ढूँढता है कि तीव्रता कहाँ बदल रही है। दूसरा अवकल यह ढूँढता है कि वह परिवर्तन स्वयं कहाँ बदल रहा है - दूसरे शब्दों में, जहाँ परिवर्तन की दर शिखर पर जाती है और फिर गिरती है।
किसी किनारे पर, तीव्रता बढ़ती है और फिर समतल हो जाती है। पहला अवकल उस रैंप पर स्पाइक करता है। दूसरा अवकल - लैपलेशियन - ठीक उस स्पाइक के शिखर पर शून्य को पार करता है। ये ज़ीरो-क्रॉसिंग किनारे के सही स्थान को चिह्नित करते हैं, जो लैपलेशियन को सोबेल फ़िल्टर जैसे पहले-अवकल तरीकों की तुलना में किनारा स्थानीयकरण के लिए अधिक सटीक बनाता है।
व्यवहार में, छवियाँ सतत फ़ंक्शन नहीं बल्कि पिक्सेल की ग्रिड होती हैं। सतत लैपलेशियन का सन्निकटन एक कन्वोल्यूशन कर्नेल से किया जाता है - एक छोटा मैट्रिक्स जिसे आप छवि पर स्लाइड करते हैं।
मानक 3×3 डिस्क्रीट लैपलेशियन कर्नेल ऐसा दिखता है:
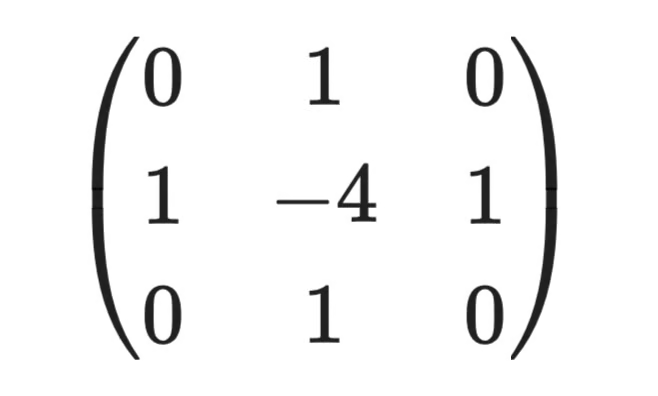
3x3 डिस्क्रीट लैपलेशियन कर्नेल
केंद्र वेट -4 है और चार सीधे पड़ोसियों को प्रत्येक को +1 मिलता है। जब आप इस कर्नेल को किसी पिक्सेल पर लागू करते हैं, तो आप उस पिक्सेल की तीव्रता और उसके चार पड़ोसियों के औसत के बीच का अंतर निकाल रहे होते हैं - पहले की ही "यह बिंदु अपने आसपास की तुलना में कैसा है" वाली बात का असतत संस्करण।
कच्चा लैपलेशियन फ़िल्टरिंग शोर के प्रति संवेदनशील होता है। एक अकेला शोरयुक्त पिक्सेल तीव्रता में तेज़ स्पाइक पैदा करता है, और लैपलेशियन उसे किनारे के रूप में चिह्नित कर देगा।
मानक उपाय यह है कि पहले छवि को गॉसियन ब्लर से स्मूथ किया जाए, फिर लैपलेशियन लगाया जाए। इस संयोजन को लैपलेशियन ऑफ गॉसियन (LoG) कहते हैं। गॉसियन शोर को दबाता है, और लैपलेशियन वास्तविक किनारों को ढूँढता है।
डीप लर्निंग में, कन्वोल्यूशनल न्यूरल नेटवर्क अपने खुद के एज-डिटेक्शन फ़िल्टर डेटा से सीखते हैं - लेकिन वे सीखे हुए फ़िल्टर अक्सर लैपलेशियन कर्नेल जैसे दिखते हैं। तो एक तरह से, वह गणित जिसने लैपलेशियन को पारंपरिक कंप्यूटर विज़न में उपयोगी बनाया, वही गणित न्यूरल नेटवर्क अपने आप फिर से खोज लेते हैं।
लैपलेशियन तीन संबंधित विचार हैं जो अलग-अलग संदर्भों में दिखाई देते हैं।
आप किस संस्करण के साथ काम कर रहे हैं यह समझना, कैलकुलस की पुस्तकों, संख्यात्मक कोड और ग्राफ एमएल पेपर्स के बीच जाते समय बहुत-सी उलझन से बचा लेता है।
कंटीन्यूअस लैपलेशियन कैलकुलस वाला है। किसी सतत स्पेस पर परिभाषित चिकने फ़ंक्शन f के लिए, यह द्वितीय आंशिक अवकलनों का योग है:

कंटीन्यूअस लैपलेशियन
यह संस्करण मानता है कि आपका फ़ंक्शन हर जगह चिकना और अवकलनीय है। यही सैद्धांतिक नींव है - पर वास्तविक डेटा कभी सतत नहीं होता। आप पिक्सेल ग्रिड या मापों की सारणी पर सटीक अवकल नहीं निकाल सकते।
जब आप सतत फ़ंक्शनों से सैंपल्ड डेटा पर जाते हैं, तो अवकलों की जगह सीमित अंतरों (फाइनाइट डिफरेंसेज) से ले ली जाती है - जो पड़ोसी मानों से निकाले गए सन्निकटन होते हैं।
समदूरी बिंदुओं पर सैंपल किए गए 1D फ़ंक्शन के लिए, बिंदु i पर डिस्क्रीट दूसरा अवकल होता है:
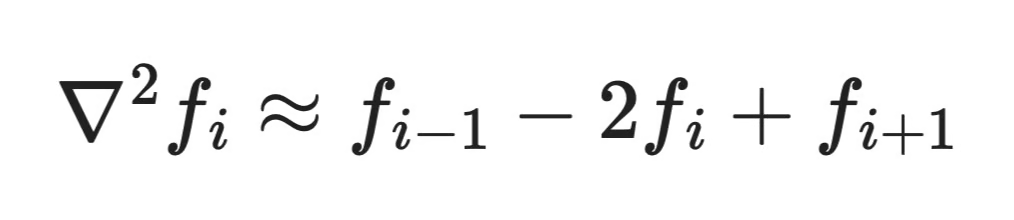
डिस्क्रीट लैपलेशियन
आप i पर मान की उसके दो पड़ोसियों से तुलना कर रहे हैं। यही विचार 2D ग्रिड (इमेज), 3D वॉल्यूम और आगे तक फैलता है। इमेज प्रोसेसिंग सेक्शन के कन्वोल्यूशन कर्नेल यही हैं - सतत लैपलेशियन के फाइनाइट डिफरेंस सन्निकटन, जिन्हें पिक्सेल ग्रिड पर लागू किया जाता है।
यह डिस्क्रीटीकरण लैपलेशियन को संख्यात्मक विधियों और एमएल पाइपलाइनों में गणनीय बनाता है। जब भी आप कोड में लैपलेशियन फ़िल्टर लागू करते हैं, तो आप सटीक कैलकुलस ऑपरेटर नहीं बल्कि फाइनाइट डिफरेंस सन्निकटन चला रहे होते हैं।
ग्राफ लैपलेशियन डिस्क्रीटीकरण को एक कदम और आगे बढ़ाता है। एक नियमित, समान दूरी वाले ग्रिड के बजाय, आपके पास अलग-अलग वज़नों वाली एजों से जुड़े मनमाने नोड्स का सेट होता है।
यहाँ "पड़ोसी पिक्सेल" की कोई धारणा नहीं है - केवल नोड्स और उनके बीच के कनेक्शन। ग्राफ लैपलेशियन L = D - A सीमित अंतरों की संरचना की जगह एडजेसेंसी संरचना रख देता है। मूल प्रश्न वही रहता है: किसी नोड का मान उसके पड़ोसियों से कैसे तुलना करता है? पर अब "पड़ोसी" का निर्धारण ग्राफ से होता है, स्थानिक निकटता से नहीं।
अधिकांश एमएल डेटा किसी नियमित ग्रिड पर नहीं रहता। अणु, सोशल नेटवर्क, नॉलेज ग्राफ, और 3D प्वाइंट क्लाउड्स सभी की अनियमित संरचना होती है। आप उन पर मानक फाइनाइट डिफरेंस लैपलेशियन लागू नहीं कर सकते।
ग्राफ लैपलेशियन एडजेसेंसी मैट्रिक्स के माध्यम से पड़ोस संरचना को स्पष्ट करके इसका हल देता है। यही कारण है कि ग्राफ न्यूरल नेटवर्क और स्पेक्ट्रल विधियाँ ऐसे डेटा पर लैपलेशियन-आधारित ऑपरेशन लागू कर पाती हैं जिनका कोई प्राकृतिक निर्देशांक तंत्र नहीं होता।
इसे दो उदाहरणों से ठोस बनाते हैं - एक कंटीन्यूअस, एक ग्राफ-आधारित।
फ़ंक्शन f(x, y) = x² + y² लें। यह एक सरल पैरबोलॉइड है - कटोरे का आकार जो हर दिशा में ऊपर की ओर मुड़ता है।
लैपलेशियन निकालने के लिए, आपको प्रत्येक चर के सापेक्ष द्वितीय आंशिक अवकल चाहिए।
पहले, x के सापेक्ष:
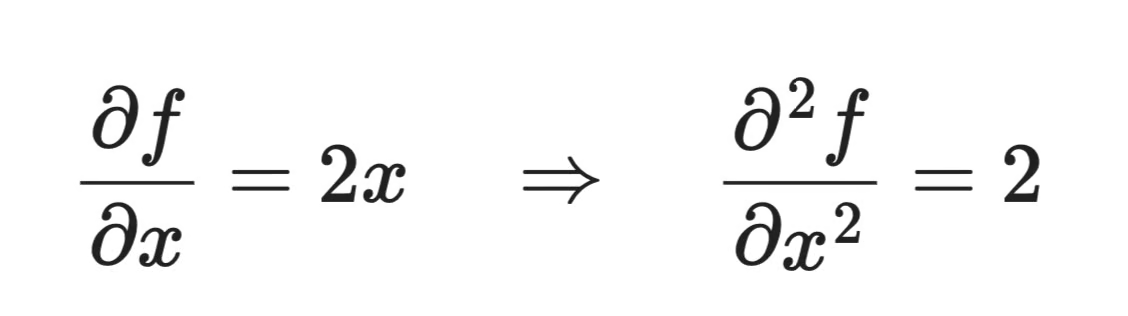
कंटीन्यूअस लैपलेशियन गणना (1)
फिर y के सापेक्ष:

कंटीन्यूअस लैपलेशियन गणना (2)
और अब बस इन्हें जोड़ दें:

कंटीन्यूअस लैपलेशियन गणना (3)
लैपलेशियन हर जगह एक स्थिर 4 है। यह तार्किक है क्योंकि पैरबोलॉइड की हर बिंदु पर वक्रता समान होती है। धनात्मक मान बताता है कि फ़ंक्शन सभी दिशाओं में ऊपर की ओर मुड़ता है, जो कटोरे के आकार से सुसंगत है।
4 नोड्स वाले एक ग्राफ को लें और निम्नलिखित एजेस:
एडजेसेंसी मैट्रिक्स A कनेक्शनों को एन्कोड करता है:

ग्राफ लैपलेशियन गणना (1)
डिग्री मैट्रिक्स D प्रत्येक नोड के कनेक्शन की गिनती को विकर्ण पर रखता है:

ग्राफ लैपलेशियन गणना (2)
नोड 1 और 2 के प्रत्येक के 2 कनेक्शन हैं। नोड 3 और 4 के प्रत्येक के 1।
अंत में, घटाकर L = D - A पाएं:
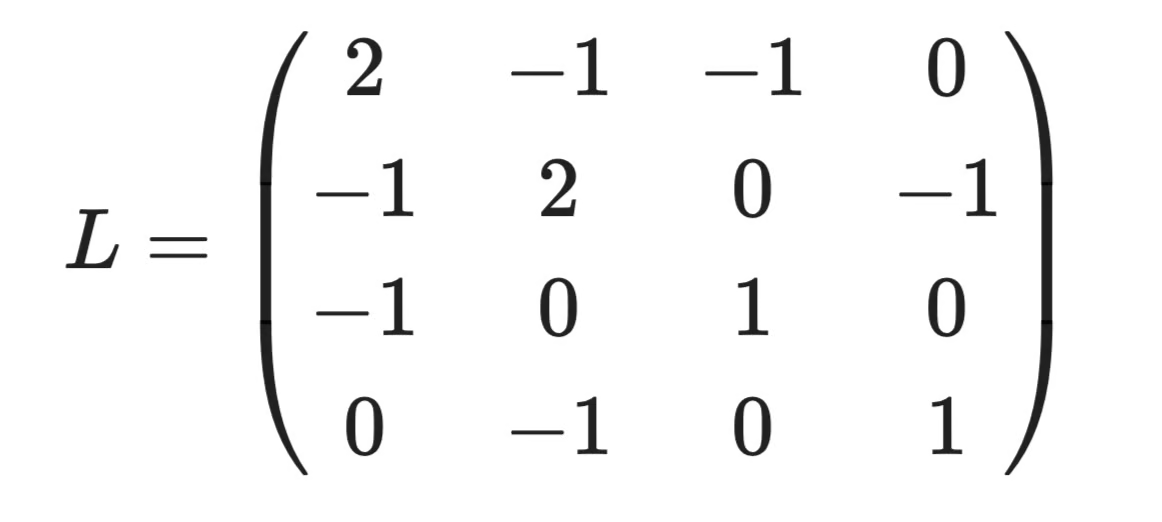
ग्राफ लैपलेशियन गणना (3)
इस मैट्रिक्स को ऐसे पढ़ें: पंक्ति 1 कहती है: नोड 1 की डिग्री 2 है, और यह नोड 2 और 3 से जुड़ा है (-1 प्रविष्टियाँ)। पंक्ति 3 कहती है: नोड 3 की डिग्री 1 है, जो केवल नोड 1 से जुड़ा है। शून्य बताते हैं कि किन नोड-युग्मों के बीच कोई एज नहीं है।
आप इसे सत्यापित करने के लिए Python में भी निकाल सकते हैं:
import numpy as np

A = np.array([
    [0, 1, 1, 0],
    [1, 0, 0, 1],
    [1, 0, 0, 0],
    [0, 1, 0, 0]
])

D = np.diag(A.sum(axis=1))
L = D - A

print(L)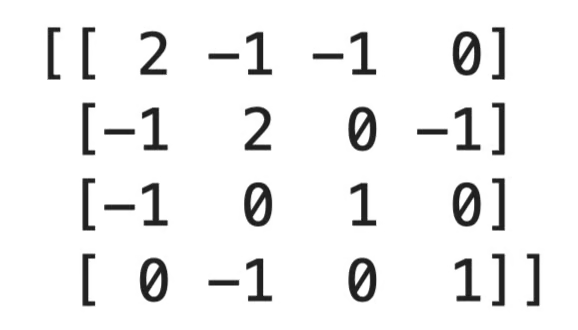
Python में ग्राफ लैपलेशियन गणना
लैपलेशियन कुछ अन्य अवधारणाओं के समान है, और केवल नामों से अंतर हमेशा स्पष्ट नहीं होता। इस खंड में, मैं सभी भ्रम के बिंदुओं को दूर करने की कोशिश करूँगा।
ग्रेडिएंट ∇f एक वेक्टर है। यह सबसे तेज़ वृद्धि की दिशा की ओर इशारा करता है और इसकी परिमाण बताती है कि फ़ंक्शन कितनी तेज़ी से बढ़ रहा है। यह पहले अवकलों का उपयोग करता है।
लैपलेशियन ∇²f एक स्केलर है। यह आपको किस दिशा में चलना है नहीं बताता - यह किसी बिंदु पर फ़ंक्शन के आकार के बारे में बताता है। यह दूसरे अवकलों से बना है।
यह सबसे ज़्यादा लोगों को उलझा देता है।
हैसियन H सभी द्वितीय आंशिक अवकलों का मैट्रिक्स है। n इनपुट वाले फ़ंक्शन के लिए, यह एक n × n मैट्रिक्स है जो बताता है कि हर अक्ष-युग्म के साथ ग्रेडिएंट कैसे बदलता है। यह पूरी वक्रता की तस्वीर देता है।
लैपलेशियन हैसियन का ट्रेस है - इसकी विकर्ण प्रविष्टियों का योग। आप ऑफ-डायगोनल वक्रता जानकारी खो देते हैं, लेकिन आपको एक एकल संख्या मिलती है जिसे तेज़ी से निकाला जा सकता है।
जब आपको वक्रता का पूरा ब्यौरा चाहिए, हैसियन का उपयोग करें। जब स्केलर सारांश पर्याप्त हो, तो लैपलेशियन का।
इनके नाम और मूल अंतर्ज्ञान एक जैसे हैं, लेकिन ये पूरी तरह अलग वस्तुओं पर काम करते हैं।
डिफरेंशियल लैपलेशियन चिकने, सतत फ़ंक्शनों पर काम करता है। इसमें अवकल चाहिए होते हैं, यानी यह मानता है कि आपका फ़ंक्शन हर जगह अवकलनीय है।
ग्राफ लैपलेशियन L = D - A ग्राफ़ों - नोड्स और एजेस वाली असतत संरचनाओं - पर काम करता है। यहाँ कोई अवकल शामिल नहीं हैं। यह मैट्रिक्स ऑपरेशनों का उपयोग करके मापता है कि प्रत्येक नोड पर मान उसके पड़ोसियों से कितना भिन्न है।
संबंध वैचारिक है, संगणनात्मक नहीं। दोनों पड़ोस के औसत से स्थानीय विचलन को मापते हैं, पर पूरी तरह अलग हैं।
कुछ क्षेत्रों में लैपलेशियन को नकारात्मक चिन्ह के साथ परिभाषित करते हैं: -∇²f। आप इसे भौतिकी और कुछ ग्राफ न्यूरल नेटवर्क पर एमएल पेपर्स में देखेंगे। नकारात्मक लैपलेशियन −L सकारात्मक अर्ध-निश्चित (positive semi-definite) होता है, जो कुछ ऑप्टिमाइज़ेशन समस्याओं के लिए बेहतर गुण देता है और ईगेनवैल्यू विश्लेषण को सरल बनाता है।
जब आप कोई पेपर पढ़ें और लैपलेशियन के सभी ईगेनवैल्यू गैर-ऋणात्मक दिखें, तो जाँचें कि वे L का उपयोग कर रहे हैं या -L का। गणित समतुल्य है, पर परंपराएँ मिलाने से गलत निष्कर्ष निकल सकते हैं।
इस बिंदु पर, आपने लैपलेशियन को कैलकुलस, ग्राफ थ्योरी, इमेज प्रोसेसिंग, और ऑप्टिमाइज़ेशन में प्रकट होते देखा है। वही ऑपरेटर अलग-अलग संदर्भों में वही मूल समस्या हल कर रहा है: किसी बिंदु पर मान अपने आसपास से कैसे संबंधित है।
डेटा साइंस में यह यहाँ दिखाई देता है:
ग्राफ-आधारित एमएल: ग्राफ लैपलेशियन L = D - A स्पेक्ट्रल विधियों की नींव है। जब भी आपके डेटा की प्राकृतिक ग्राफ संरचना हो, लैपलेशियन आपको एक मैट्रिक्स देता है जो पूरी कनेक्टिविटी पैटर्न को ऐसे रूप में एन्कोड करता है जिस पर आप रैखिक बीजगणित कर सकें।
क्लस्टरिंग: स्पेक्ट्रल क्लस्टरिंग L के ईगेनवेक्टर का उपयोग उन समूहों को ढूँढने के लिए करती है जिन्हें शुद्ध दूरी-आधारित विधियाँ चूक जाती हैं। यह तब अच्छा काम करती है जब क्लस्टर उत्तल या रैखिक रूप से विभाज्य न हों।
सेमी-सुपरवाइज़्ड लर्निंग: कई सेमी-सुपरवाइज़्ड विधियाँ लेबल वाले नोड्स से बिना लेबल वाले नोड्स तक लेबल फैलाने के लिए ग्राफ लैपलेशियन का उपयोग करती हैं। मान्यता यह है कि जुड़े नोड्स का लेबल संभवतः समान होता है, और लैपलेशियन यह परिमाणित करता है कि लेबल ग्राफ के पार कितनी सुचारू रूप से बदलने चाहिए।
मैनिफोल्ड लर्निंग: Laplacian Eigenmaps जैसे एल्गोरिदम उच्च-आयामी डेटा के निम्न-आयामी निरूपण खोजने के लिए ग्राफ लैपलेशियन का उपयोग करते हैं। L के ईगेनवेक्टर मूल स्पेस के नज़दीकी बिंदुओं को घटे हुए स्पेस में भी नज़दीक मैप करते हैं।
इमेज फीचर निष्कर्षण: डिस्क्रीट लैपलेशियन किनारों और तीव्रता के तेज़ परिवर्तनों वाले क्षेत्रों का पता लगाता है। वे फीचर्स सीधे पारंपरिक कंप्यूटर विज़न पाइपलाइनों में और डीप लर्निंग आर्किटेक्चर में प्रायर्स के रूप में जाते हैं।
संक्षेप में, लैपलेशियन उन कुछ गणितीय टूल्स में से एक है जो एक अकेली कैलकुलस समीकरण से लेकर बड़े ग्राफ न्यूरल नेटवर्क तक स्केल करता है।
लैपलेशियन एक कैलकुलस ऑपरेटर के रूप में शुरू होता है, सतत फ़ंक्शनों में वक्रता मापने का तरीका। ग्राफ-आधारित एमएल तक पहुँचते-पहुँचते, यह एक ऐसा मैट्रिक्स बन जाता है जो पूरे नेटवर्क की संरचना को एन्कोड करता है। मूल विचार बिल्कुल वही है, बस रूप अलग है।
हमारे Linear Algebra for Data Science in R कोर्स में नामांकन करें और इस लेख में शामिल कई अवधारणाओं व विषयों के साथ हाथ-से-हाथ का अनुभव प्राप्त करें।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें