
Last chance! 50% off DataCamp Premium
Sale ends in
ऐसे डेटा पर सीधी रेखा फिट करना जो मुड़ता हो, कभी अच्छी सोच नहीं होती।
लिनीयर रिग्रेशन मानकर चलता है कि आपके प्रेडिक्टर्स और लक्ष्य के बीच संबंध एक सीधी रेखा है। दुर्भाग्य से, ज़्यादातर वास्तविक दुनिया के संबंध ऐसे नहीं होते। आय और खर्च या समय और वृद्धि के रिश्ते के बारे में सोचिए—ये मुड़ते हैं, सपाट पड़ते हैं, फिर मुड़ते हैं, और दिशा ऐसे बदलते हैं जिन्हें एक ही ढाल से व्यक्त नहीं किया जा सकता।
स्प्लाइन रिग्रेशन इसे इस तरह संभालता है कि जहां ज़रूरत हो संबंध को मुड़ने देता है, बिना किसी अनियंत्रित, जंगली वक्र के। विचार यह है कि प्रेडिक्टर रेंज में कई स्मूथ बहुपद खंड फिट किए जाएं और उन्हें विशिष्ट बिंदुओं पर जोड़ा जाए।
इस लेख में, आप स्प्लाइन रिग्रेशन की मूल अवधारणाएँ, कैसे नॉट्स लचीलापन नियंत्रित करते हैं, मुख्य स्प्लाइन प्रकार, और उन्हें व्यवहार में कैसे लागू करें, सीखेंगे।
स्प्लाइन्स पर जाने से पहले, हमारा ट्यूटोरियल पढ़ें जो आपको सिंपल लिनीयर रिग्रेशन के बारे में हर ज़रूरी बात सिखाएगा।
स्प्लाइन रिग्रेशन एक रिग्रेशन तकनीक है जो पिस-वाइज़ पॉलिनोमियल फ़ंक्शनों से गैर-रेखीय संबंधों को मॉडल करती है, जिन्हें विशिष्ट बिंदुओं—नॉट्स—पर जोड़ा जाता है।
तो एक ही समीकरण से पूरे संबंध का वर्णन करने के बजाय, स्प्लाइन रिग्रेशन प्रेडिक्टर रेंज को छोटे-छोटे हिस्सों में बाँटता है और हर हिस्से पर अलग बहुपद फिट करता है। ये हिस्से नॉट्स पर मिलते हैं, और लगाए गए प्रतिबंध सुनिश्चित करते हैं कि बदलाव स्मूथ हों।
अंतिम परिणाम दो सिरों के बीच कहीं आता है। यह लिनीयर रिग्रेशन से ज़्यादा लचीला है, जो आपके डेटा पर सिर्फ एक सीधी रेखा खींच सकता है। और यह पूरी तरह अनियंत्रित गैर-रेखीय मॉडलों—जैसे डीप न्यूरल नेटवर्क या कर्नेल मेथड्स—से अधिक संरचित है, जो लगभग कुछ भी फिट कर सकते हैं लेकिन यह कम बताते हैं कि उन्होंने क्या फिट किया है।
इसी वजह से अनुप्रयुक्त सांख्यिकी में स्प्लाइन्स बहुत बार दिखते हैं।
वास्तविक डेटा लगभग कभी सीधी रेखा का पालन नहीं करता।
लिनीयर रिग्रेशन संबंधों को मॉडल करने का डिफ़ॉल्ट शुरुआती बिंदु है, लेकिन इसकी एक सख्त धारणा है: प्रेडिक्टर का प्रभाव पूरे रेंज में स्थिर रहता है। जब वास्तविक संबंध मुड़ता है या दिशा बदलता है, तो सीधी रेखा उसे अंडरफ़िट कर देती है। चरम पर त्रुटियाँ बढ़ती हैं और मॉडल पैटर्न का पीछा नहीं कर पाता।
इसका समाधान अधिक लचीला मॉडल है। हाई-डिग्री पॉलिनोमियल रिग्रेशन एक विकल्प है—आप x^2, x^3, x^4 जैसे पद जोड़ते हैं जब तक कि वक्र आपके डेटा से मेल खाने लायक न मुड़ जाए। लेकिन बहुपद डेटा के किनारों पर अस्थिर हो जाते हैं; वे ऊपर-नीचे झूलते हैं जहाँ डेटा बिंदु कम हैं। इस व्यवहार को रनगे की परिघटना कहते हैं, और यह हाई-डिग्री पॉलिनोमियल्स को प्रिडिक्शन के लिए जोखिमभरा बना देता है।
स्प्लाइन रिग्रेशन इन दोनों सिरों के बीच आता है।
जहाँ डेटा मुड़ता है वहाँ आपको स्थानीय लचीलापन मिलता है, बिना एक अकेले हाई-डिग्री पॉलिनोमियल की वैश्विक अस्थिरता के। हर खंड लो-डिग्री पॉलिनोमियल (आमतौर पर क्यूबिक) होता है, इसलिए कोई एक हिस्सा अप्रत्याशित व्यवहार नहीं कर सकता। और क्योंकि खंड नॉट्स पर स्मूथ तरीके से जुड़े होते हैं, कुल मिलाकर वक्र एक सतत फ़ंक्शन जैसा दिखता है।
संक्षेप में, स्प्लाइन इतना लचीलापन देता है कि जटिल पैटर्न का अनुसरण कर सके और इतना ढांचा रखता है कि किनारों पर संयत रहे।
स्प्लाइन रिग्रेशन हमेशा तीन सरल चरणों के वर्कफ़्लो का पालन करता है।
इन्हीं प्रतिबंधों की वजह से स्प्लाइन्स एक एकल, स्मूथ वक्र जैसे दिखते हैं जो स्थानीय रूप से मुड़ता है पर पूरे प्रेडिक्टर रेंज में निरंतर बहता है। देखने पर आप नहीं बता पाएंगे कि एक बहुपद कहाँ खत्म होता है और अगला कहाँ शुरू।
नॉट्स, बहुपद की डिग्री, और सततता के प्रतिबंध मिलकर स्प्लाइन को परिभाषित करते हैं। इनमें से किसी को बदलिए, तो अलग गुणों वाला अलग स्प्लाइन मिल जाएगा—अगले सेक्शनों में हम यही देखते हैं।
नॉट्स वे बिंदु हैं जहाँ एक बहुपद खंड समाप्त होता है और अगला शुरू होता है।
आप इन्हें स्प्लाइन के जोड़ समझ सकते हैं। यदि आप x = 5 पर एक नॉट रखते हैं, तो मॉडल 5 से कम मानों के लिए एक बहुपद और 5 से अधिक के लिए दूसरा बहुपद फिट करता है। दोनों बहुपद नॉट पर मिलते हैं, और सततता के प्रतिबंध उन्हें स्मूथ तरीके से जोड़ते हैं। अधिक नॉट्स जोड़ेंगे तो और खंड मिलेंगे, यानी वक्र अधिक जगहों पर मुड़ सकेगा।
इसीलिए नॉट्स मॉडल के लचीलेपन को नियंत्रित करने का प्रमुख साधन हैं।
नॉट्स की संख्या तय करती है कि स्प्लाइन में कितने अलग-अलग बहुपद खंड होंगे। नॉट्स का स्थान यह तय करता है कि वक्र कहाँ अपना आकार बदल सकता है। दो नॉट्स वाला स्प्लाइन कुछ ही जगहों पर मुड़ सकता है। बीस नॉट्स वाला स्प्लाइन लगभग हर डेटा बिंदु का पीछा कर सकता है।
इसलिए स्प्लाइन रिग्रेशन में नॉट्स की सही संख्या और स्थान चुनना सबसे बड़ा निर्णय है।
यदि नॉट्स बहुत कम हैं, तो स्प्लाइन के पास डेटा में वास्तविक पैटर्न का पीछा करने के लिए पर्याप्त खंड नहीं होते। वक्र बहुत सख्त रहता है। यह लगभग लो-डिग्री पॉलिनोमियल जैसा बर्ताव करता है—सामान्य रूप से लचीला, पर स्थानीय बदलाव पकड़ने में असमर्थ।
कल्पना कीजिए कि आप एक स्प्लाइन एक नॉट के साथ उस डेटा पर फिट कर रहे हैं जिसमें तीन स्पष्ट चरण हैं: बढ़त, फिर ठहराव, फिर गिरावट। सिर्फ एक नॉट होने पर स्प्लाइन के पास काम करने को दो ही खंड होंगे। वह बढ़त और अन्य में से किसी एक चरण को पकड़ पाएगा, पर तीनों को नहीं। नतीजा वही समस्या है जो लिनीयर रिग्रेशन में थी—वहाँ त्रुटियाँ जहाँ स्प्लाइन डेटा के आकार से मेल नहीं खा पाता।
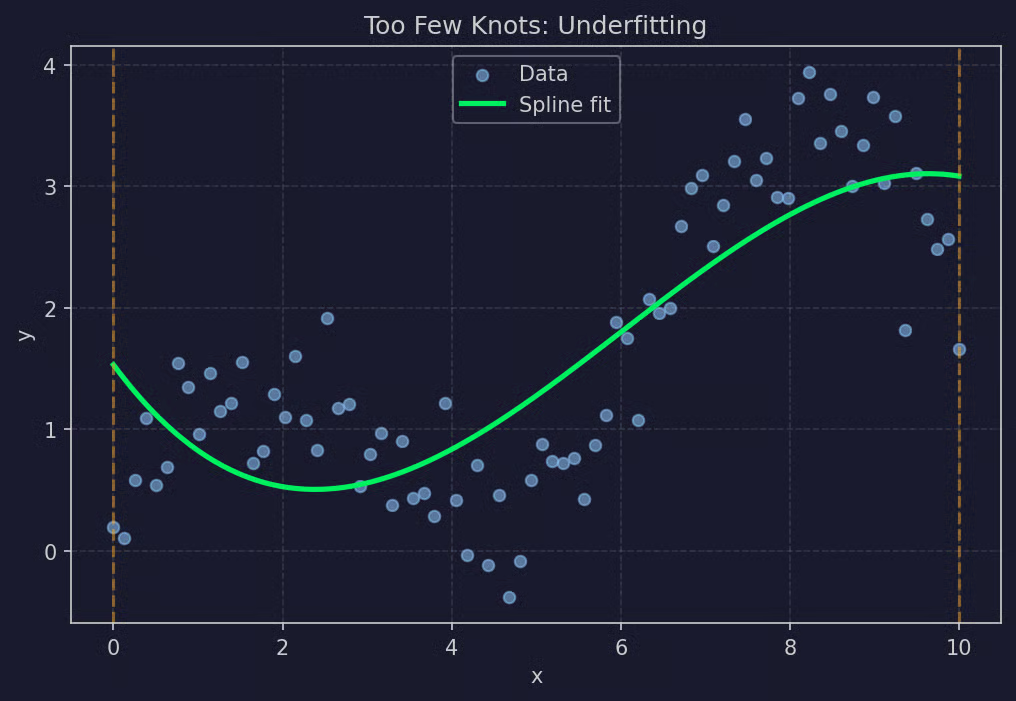
नॉट्स बहुत कम होने का उदाहरण
कम नॉट्स अंडरफ़िटिंग की ओर ले जाते हैं। मॉडल उपयोगी होने के लिए बहुत ज़्यादा स्मूथ हो जाता है।
उलटी समस्या भी उतनी ही बुरी है। यदि नॉट्स बहुत ज़्यादा हैं, तो स्प्लाइन में इतने खंड बन जाते हैं कि वह असल पैटर्न के बजाय डेटा के शोर को फिट करने लगता है। वक्र हर ऑब्ज़र्वेशन के बीच डोलता है और आधारभूत ट्रेंड के बजाय रैंडम उतार-चढ़ाव का पीछा करता है।
पचास बिंदुओं के डेटासेट पर बीस नॉट्स वाला स्प्लाइन कनेक्ट-द-डॉट्स चित्र जैसा लगेगा, न कि कोई मॉडल। यह ट्रेनिंग डेटा को लगभग पूरी तरह फिट कर देगा, लेकिन नए डेटा पर प्रिडिक्शन अविश्वसनीय होंगे। इनपुट में छोटे बदलाव आउटपुट में बड़े, अप्रत्याशित बदलाव ला देंगे।
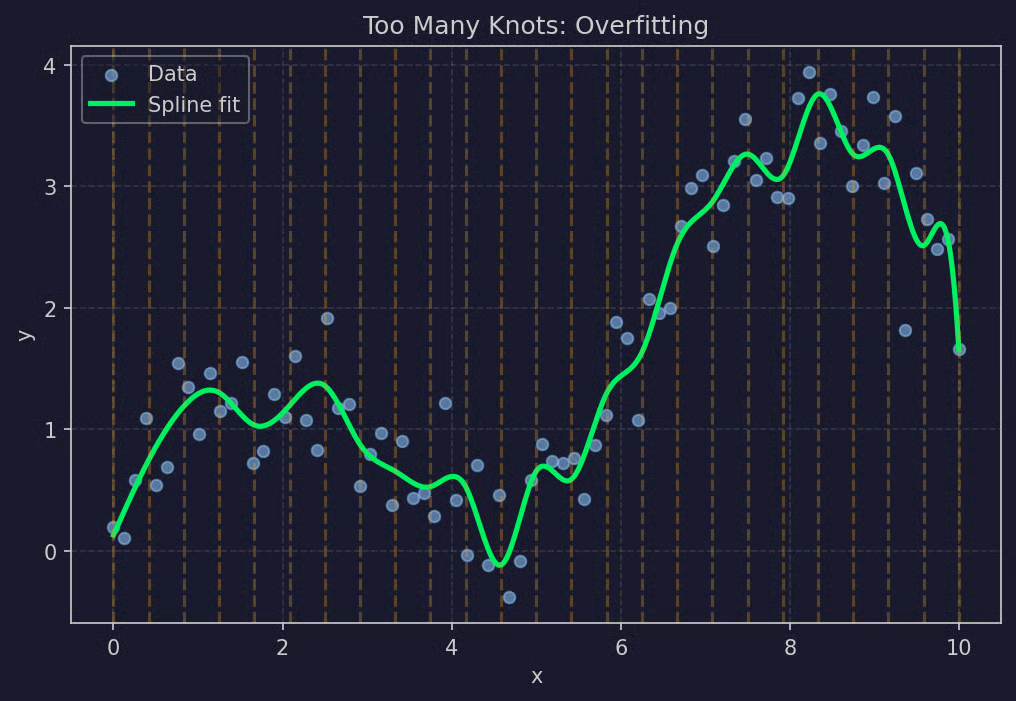
नॉट्स बहुत ज़्यादा होने का उदाहरण
बहुत ज़्यादा नॉट्स ओवरफ़िटिंग कराते हैं। मॉडल इतना लचीला हो जाता है कि सामान्यीकरण नहीं कर पाता।
आपको इतने नॉट्स चाहिए कि डेटा की वास्तविक मोड़ों को पकड़ा जा सके, पर इतने नहीं कि मॉडल शोर याद करने लगे। आगे के सेक्शन बताएँगे कि व्यवहार में यह फ़ैसला कैसे लें।
स्प्लाइन कुछ अलग स्वादों में आते हैं, और चुनाव मुख्यतः इस पर निर्भर करता है कि हर खंड में आप किस तरह का बहुपद लेते हैं और वक्र पर कौन-से प्रतिबंध लगाते हैं।
लिनीयर स्प्लाइन्स सबसे सरल संस्करण हैं। हर खंड एक सीधी रेखा है, और खंड नॉट्स पर जुड़ते हैं।
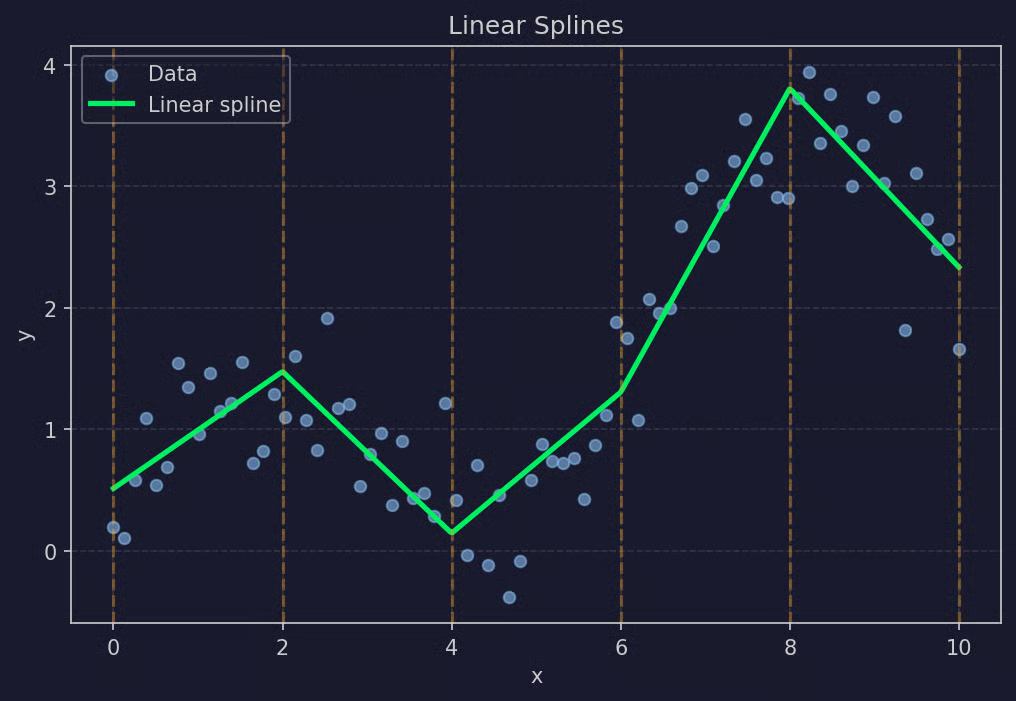
लिनीयर स्प्लाइन्स उदाहरण
यहाँ सततता का प्रतिबंध ढीला है, क्योंकि नॉट पर दोनों ओर के मान तो मिलने चाहिए, पर ढाल बदल सकती है। नतीजा जुड़ी हुई रेखा-खंडों की तरह दिखता है जिनमें हर नॉट पर कोने होते हैं। यह साधारण मोड़ों को संभालने के लिए पर्याप्त लचीला है, पर वक्र कभी-कभी स्मूथ नहीं दिखता।
लिनीयर स्प्लाइन्स तब अच्छे हैं जब आपको सिर्फ मोटे ट्रेंड चाहिए और दृश्य तीखापन बुरा नहीं लगता। इन्हें समझना भी सबसे आसान है क्योंकि हर खंड अपनी ढाल वाली एक रेखा ही है।
क्यूबिक स्प्लाइन्स अधिकांश अनुप्रयोगों में डिफ़ॉल्ट विकल्प हैं। हर खंड एक क्यूबिक बहुपद (डिग्री 3) होता है, और सततता के प्रतिबंध लिनीयर स्प्लाइन्स से कड़े होते हैं।
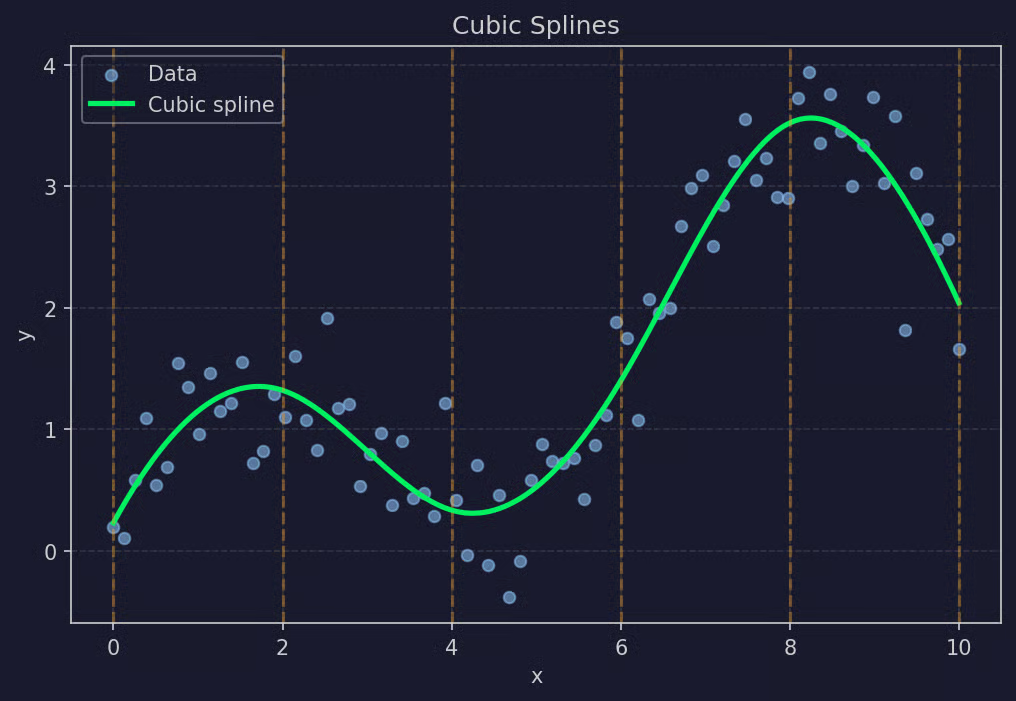
क्यूबिक स्प्लाइन्स उदाहरण
हर नॉट पर तीन शर्तें पूरी होनी चाहिए: मान मिलें, प्रथम अवकलज मिलें, और द्वितीय अवकलज मिलें। इसका अर्थ है न छलांगें, न कोने, और न वक्रता में अचानक बदलाव। वक्र नॉट्स से बिना किसी दृश्य संकेत के बहता है कि परिवर्तन कहाँ हुए।
क्यूबिक वह सबसे कम डिग्री है जो वक्रता में स्मूथ बदलावों की अनुमति देती है। इसलिए यह इतना लोकप्रिय है। उच्च डिग्री शायद ही उपयोगी लचीलापन जोड़ती हैं और मॉडल को नियंत्रित करना कठिन बना देती हैं।
नैचुरल क्यूबिक स्प्लाइन्स एक रूपांतर हैं जो डेटा की सीमाओं पर अतिरिक्त प्रतिबंध जोड़ते हैं।
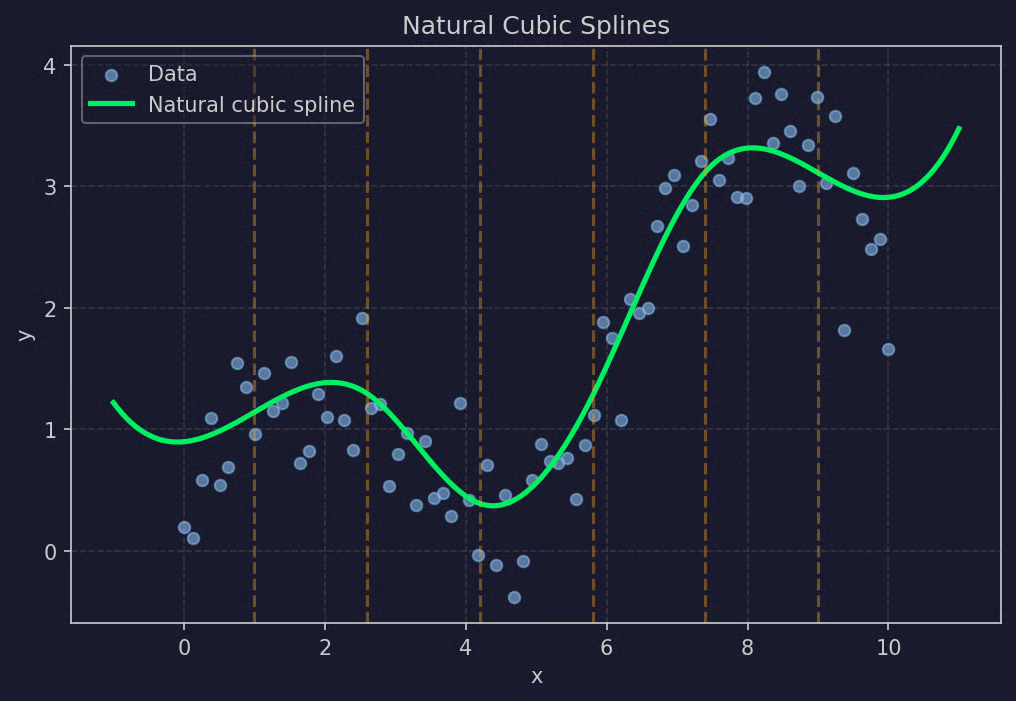
नैचुरल क्यूबिक स्प्लाइन्स उदाहरण
साधारण क्यूबिक स्प्लाइन्स की दिक्कत यह है कि वे किनारों पर अजीब बर्ताव कर सकते हैं, खासकर जहाँ आपके पास डेटा बिंदु कम हैं। सबसे बाएँ और सबसे दाएँ खंड अब भी क्यूबिक बहुपद होते हैं, और क्यूबिक बहुपद एक्सट्रापोलेशन में तेज़ी से ऊपर-नीचे जा सकते हैं।
नैचुरल क्यूबिक स्प्लाइन्स इसे इस तरह टालते हैं कि दोनों बॉर्डर नॉट्स पर द्वितीय अवकलज को शून्य कर देते हैं। व्यवहार में, इसका अर्थ है कि बाहरी नॉट्स के आगे वक्र रैखिक हो जाता है। एक्सट्रापोलेशन का व्यवहार कहीं अधिक स्थिर होता है, जिससे नैचुरल क्यूबिक स्प्लाइन्स तब बेहतर विकल्प बनते हैं जब आपको डेटा की सीमाओं के पास प्रिडिक्शन की परवाह हो।
बी-स्प्लाइन्स (बेसिस स्प्लाइन्स) स्प्लाइन्स बनाने का अलग तरीका हैं। हर बहुपद खंड को सीधे परिभाषित करने के बजाय, बी-स्प्लाइन्स स्प्लाइन को बेसिस फ़ंक्शन्स के वेटेड सम के रूप में बनाते हैं।
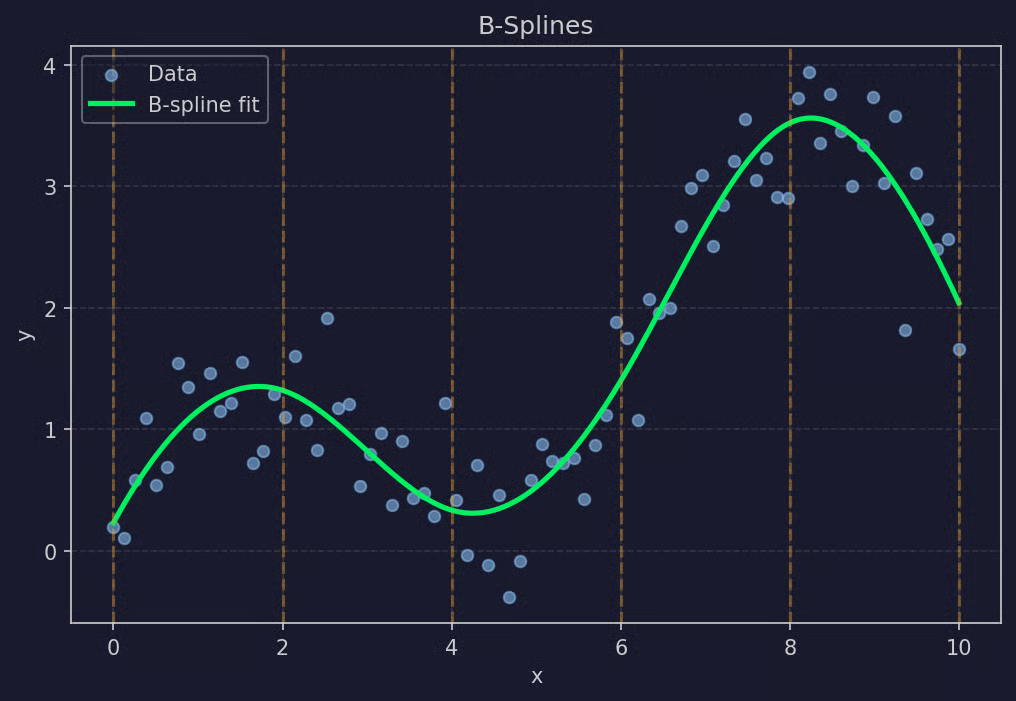
बी-स्प्लाइन्स उदाहरण
हर बेसिस फ़ंक्शन स्वयं एक छोटा स्प्लाइन होता है जो सिर्फ एक सीमित क्षेत्र में नॉन-ज़ीरो होता है। पूरा स्प्लाइन इन्हीं बेसिस फ़ंक्शन्स के योग से बनता है, जहाँ हर एक को एक गुणांक से गुणा किया जाता है जिसे रिग्रेशन अनुमानित करता है।
बी-स्प्लाइन्स संख्यात्मक रूप से स्थिर और बढ़ाने में आसान हैं। Python और R में अधिकतर आधुनिक स्प्लाइन इम्प्लीमेंटेशन बी-स्प्लाइन प्रतिरूपण का उपयोग करते हैं, भले ही यूज़र-फेसिंग इंटरफ़ेस सामान्य स्प्लाइन जैसा दिखे। यदि आपने R में bs() बुलाया है या scikit-learn में SplineTransformer इस्तेमाल किया है, तो आपने बी-स्प्लाइन्स का उपयोग किया है।
पॉलिनोमियल रिग्रेशन और स्प्लाइन रिग्रेशन दोनों गैर-रेखीय संबंधों को संभालते हैं, पर उनका तरीका अलग है। फर्क इस बात में है कि वक्र कैसे बनाया जाता है।
पॉलिनोमियल रिग्रेशन पूरे प्रेडिक्टर रेंज पर एक ही वैश्विक बहुपद फिट करता है। आप एक डिग्री चुनते हैं (2, 3, 5, 10), और मॉडल एक ही गुणांकों का सेट ढूँढता है जो पूरे डेटा पर त्रुटि न्यूनतम करे। वक्र की एक समीकरण होती है, और वही हर जगह संबंध बताती है।
यह सुनने में साफ़ लगता है, पर समस्या है। एक ही बहुपद को पूरे रेंज में फ़िट संतुलित करना पड़ता है, इसलिए एक क्षेत्र में जो होता है वह हर दूसरे क्षेत्र को प्रभावित करता है। यदि आप बीच में तेज़ मोड़ संभालने के लिए डिग्री बढ़ाते हैं, तो आप किनारों पर वक्र को झूलते देखेंगे। यही वह रनगे की परिघटना है जिसका पहले ज़िक्र हुआ—हाई-डिग्री बहुपद डेटा की सीमाओं के पास अस्थिर हो जाते हैं।
दूसरी दिक्कत यह है कि पॉलिनोमियल रिग्रेशन में स्थानीयता की समझ नहीं होती। x = 5 पर एक स्पाइक x = 50 पर फ़िट के आकार को बदल सकता है, क्योंकि हर ऑब्ज़र्वेशन एक ही वैश्विक समीकरण में योगदान देता है।
स्प्लाइन रिग्रेशन प्रेडिक्टर रेंज को खंडों में बाँटता है और प्रत्येक खंड में लो-डिग्री बहुपद फिट करता है। बहुपद नॉट्स पर स्मूथ तरीके से जुड़े होते हैं, पर हर एक अपनी आकृति में मुख्यतः अपने क्षेत्र के डेटा से संचालित होता है।
इससे आपको स्थानीय लचीलापन मिलता है। जहाँ तेज़ मोड़ है वहाँ अधिक वक्रित बहुपद मिलता है। जहाँ ट्रेंड सपाट है वहाँ लगभग सपाट बहुपद। और क्योंकि हर खंड लो-डिग्री (आमतौर पर क्यूबिक) है, कोई एक हिस्सा किनारों पर अजीब बर्ताव नहीं कर सकता। आपको विशेषकर डेटा की सीमाओं के पास अधिक स्मूथ, स्थिर फ़िट मिलता है।
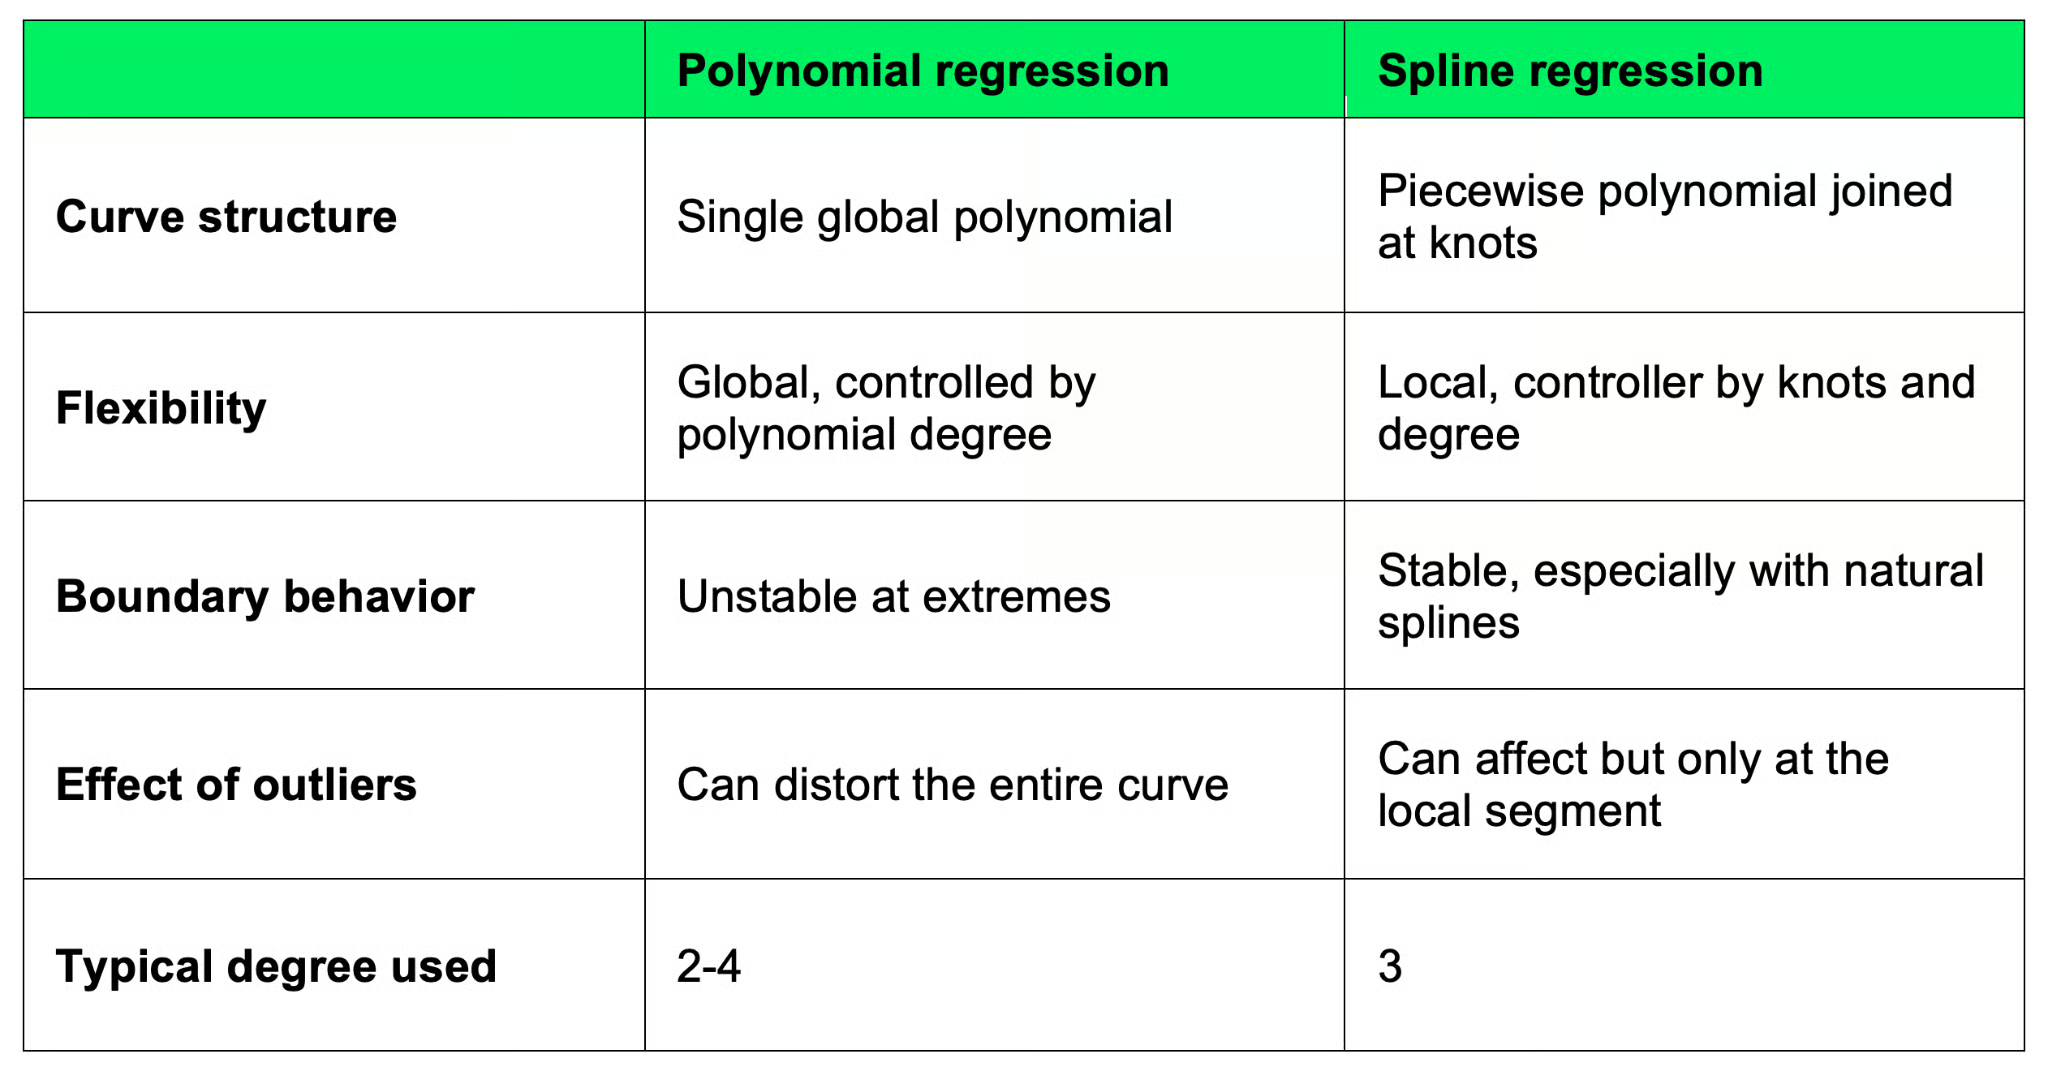
पॉलिनोमियल बनाम स्प्लाइन रिग्रेशन
तो यदि आपका संबंध हल्का गैर-रेखीय है और आप वैश्विक फ़िट से संतुष्ट हैं, तो पॉलिनोमियल रिग्रेशन काम कर सकता है। यदि पैटर्न अधिक जटिल है या आपको सीमाओं के पास प्रिडिक्शन मायने रखते हैं, तो स्प्लाइन्स सुरक्षित विकल्प हैं।
स्प्लाइन रिग्रेशन का सबसे अहम हिस्सा नॉट चयन है। बहुत कम नॉट्स अंडरफ़िट कराते हैं, और बहुत ज़्यादा ओवरफ़िट। और जहाँ आप उन्हें रखते हैं, वह तय करता है कि मॉडल कौन-से पैटर्न पकड़ पाएगा।
इनके कुछ तरीके हैं, और अक्सर आप इनमें से दो-तीन मिलाकर उपयोग करेंगे।
ट्रेड-ऑफ वही है जो हर रिग्रेशन समस्या में दिखता है: लचीलापन बनाम जटिलता। अधिक नॉट्स का मतलब अधिक लचीलापन, जो मॉडल को महीन पैटर्न का पीछा करने देता है पर शोर का भी। कम नॉट्स का मतलब अधिक स्थिर, अधिक समझने योग्य मॉडल जो असली पैटर्न छोड़ सकता है।
क्वांटाइल्स पर रखे 3–5 नॉट्स से शुरू करें, फिर रेजिडुअल्स जाँचें। यदि आपको व्यवस्थित पैटर्न दिखें जिन्हें स्प्लाइन नहीं पकड़ रहा, तो उस क्षेत्र में एक नॉट जोड़ें। अगर फ़िट बहुत डोलता लगे, तो एक हटाएँ। जब आपको अपने चयन का बचाव करना हो या मॉडल को प्रोडक्शन में ले जाना हो, तब क्रॉस-वैलिडेशन उपयोगी है।
जहाँ भी किसी को किसी स्मूथ गैर-रेखीय प्रभाव को बिना किसी विशिष्ट फंक्शनल फ़ॉर्म के बाँधे मॉडल करना होता है, वहाँ स्प्लाइन रिग्रेशन दिखता है। कुछ आम क्षेत्र ये हैं:
इन सभी मामलों में, स्प्लाइन्स आपको जहाँ ज़रूरत हो वहाँ लचीलापन देते हैं, बिना संबंध के फंक्शनल फ़ॉर्म का अनुमान लगवाए। इससे वे खोजपरक मॉडलिंग के लिए उपयुक्त और जब व्याख्येयता मायने रखे तो प्रोडक्शन मॉडलों के लिए ठोस विकल्प बनते हैं।
Python में स्प्लाइन रिग्रेशन फिट करने के तीन आम तरीके हैं: scikit-learn एमएल-स्टाइल पाइपलाइन के लिए, patsy फ़ॉर्मूला-आधारित मॉडल स्पेसिफिकेशन के लिए, और statsmodels सांख्यिकीय इन्फ़ेरेंस के लिए। अब हम हर एक पर चलते हैं।
scikit-learn आपको SplineTransformer देता है, जो एक संख्यात्मक फीचर को बी-स्प्लाइन बेसिस फ़ंक्शन्स के सेट में बदलता है। फिर आप उन फीचर्स को किसी भी लिनीयर रिग्रेशन मॉडल में देते हैं।
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import SplineTransformer
from sklearn.pipeline import make_pipeline

# Data
np.random.seed(42)
x = np.linspace(0, 10, 100).reshape(-1, 1)
y = np.sin(x).ravel() + 0.3 * x.ravel() + np.random.normal(0, 0.3, 100)

# Spline features + linear regression pipeline
model = make_pipeline(
    SplineTransformer(n_knots=5, degree=3),
    LinearRegression()
)
model.fit(x, y)
y_pred = model.predict(x)

print("R^2 score:", model.score(x, y))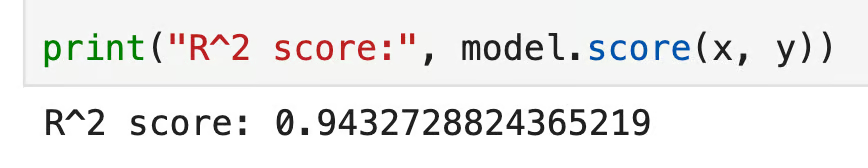
scikit-learn R2 स्कोर
यहाँ SplineTransformer 5 नॉट्स और क्यूबिक पॉलिनोमियल्स के साथ स्प्लाइन बेसिस बनाता है। फिर LinearRegression हर बेसिस फ़ंक्शन के लिए गुणांक ढूँढता है। आप यहाँ किसी भी sklearn रिग्रेसर—रिज, लैस्सो, इत्यादि—को लगा सकते हैं जो ट्रांसफ़ॉर्म किए गए फीचर्स पर लिनीयर मॉडल फिट करता हो।
यह तरीका sklearn वर्कफ़्लोज़ में फिट बैठता है, पर आपको स्टैंडर्ड एरर या p-वैल्यू जैसी सांख्यिकीय आउटपुट नहीं मिलतीं। उसके लिए आपको patsy या statsmodels चाहिए।
patsy डिज़ाइन मैट्रिस बनाने के लिए फ़ॉर्मूला-आधारित इंटरफ़ेस है। यह Python में R के मॉडल फ़ॉर्मूलों के सबसे नज़दीक है, और statsmodels के साथ उपयोग के लिए स्प्लाइन फीचर्स बनाने का मानक तरीका है।
import numpy as np
import pandas as pd
from patsy import dmatrix
import statsmodels.api as sm

np.random.seed(42)
x = np.linspace(0, 10, 100)
y = np.sin(x) + 0.3 * x + np.random.normal(0, 0.3, 100)
df = pd.DataFrame({"x": x, "y": y})

# B-spline basis using patsy
spline_basis = dmatrix("bs(x, df=6, degree=3)", data=df, return_type="dataframe")

# Fit with statsmodels OLS
model = sm.OLS(df["y"], spline_basis).fit()
print(model.summary())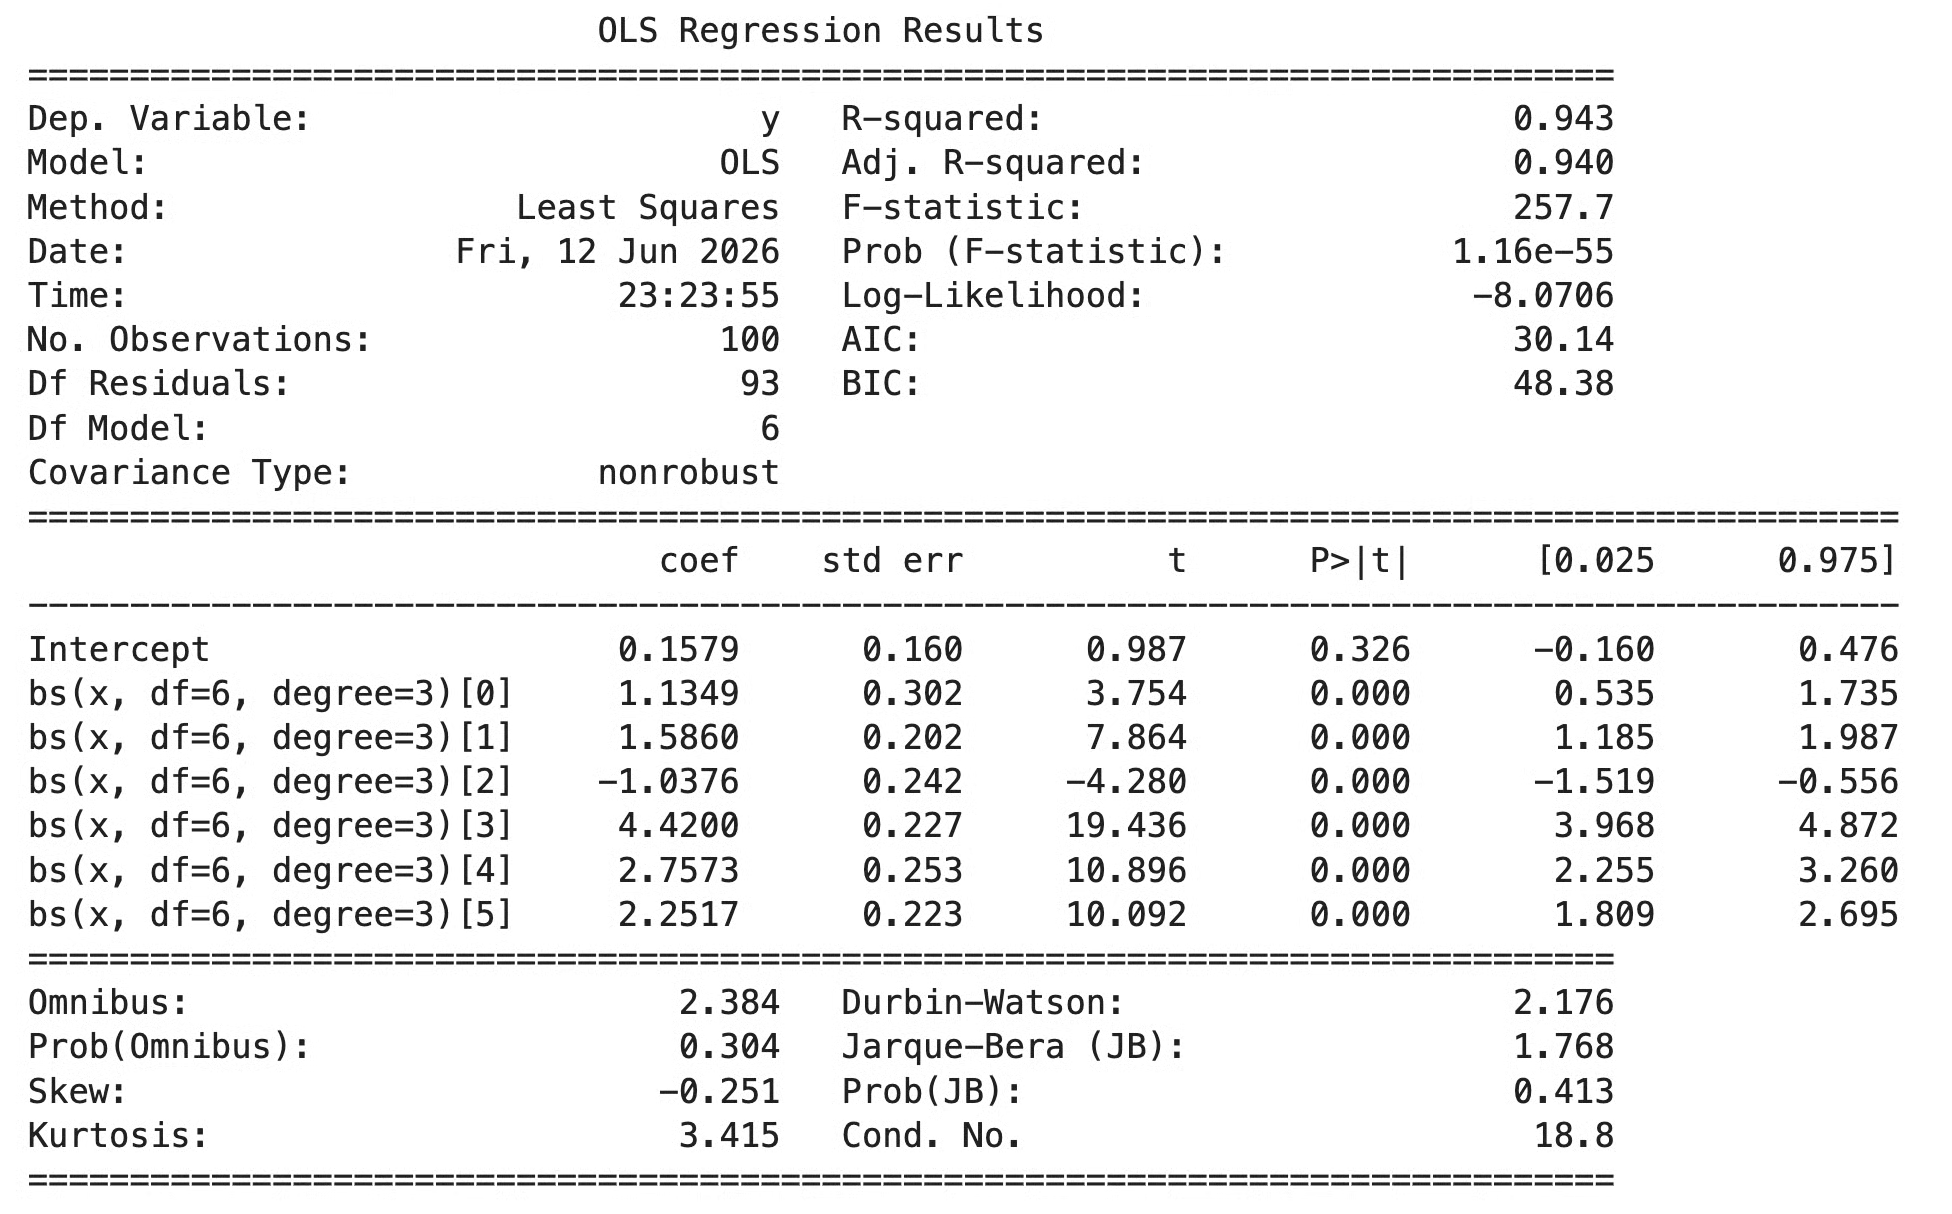
patsy मॉडल सारांश
फ़ॉर्मूला के अंदर bs() फ़ंक्शन patsy को 6 डिग्रीज़ ऑफ़ फ्रीडम और डिग्री 3 (क्यूबिक) के साथ बी-स्प्लाइन बेसिस बनाने को कहता है। patsy डिज़ाइन मैट्रिक्स लौटाता है, जो सीधे sm.OLS() में जाता है। df पैरामीटर स्प्लाइन बेसिस फ़ंक्शन्स की संख्या नियंत्रित करता है—उच्च मान अधिक लचीलापन देते हैं, ठीक वैसे ही जैसे अधिक नॉट्स जोड़ना।
यदि आप नैचरल स्प्लाइन्स चाहते हैं, तो bs() को ns() से बदल दें:
spline_basis = dmatrix("ns(x, df=6)", data=df, return_type="dataframe")statsmodels में patsy के साथ एकीकृत फॉर्मूला API भी है। जब आपको पूर्ण सांख्यिकीय आउटपुट के साथ एक-लाइन स्प्लाइन रिग्रेशन चाहिए, तो यह सबसे साफ-सुथरा तरीका है।
import statsmodels.formula.api as smf

model = smf.ols("y ~ bs(x, df=7, degree=3)", data=df).fit()
print(model.summary())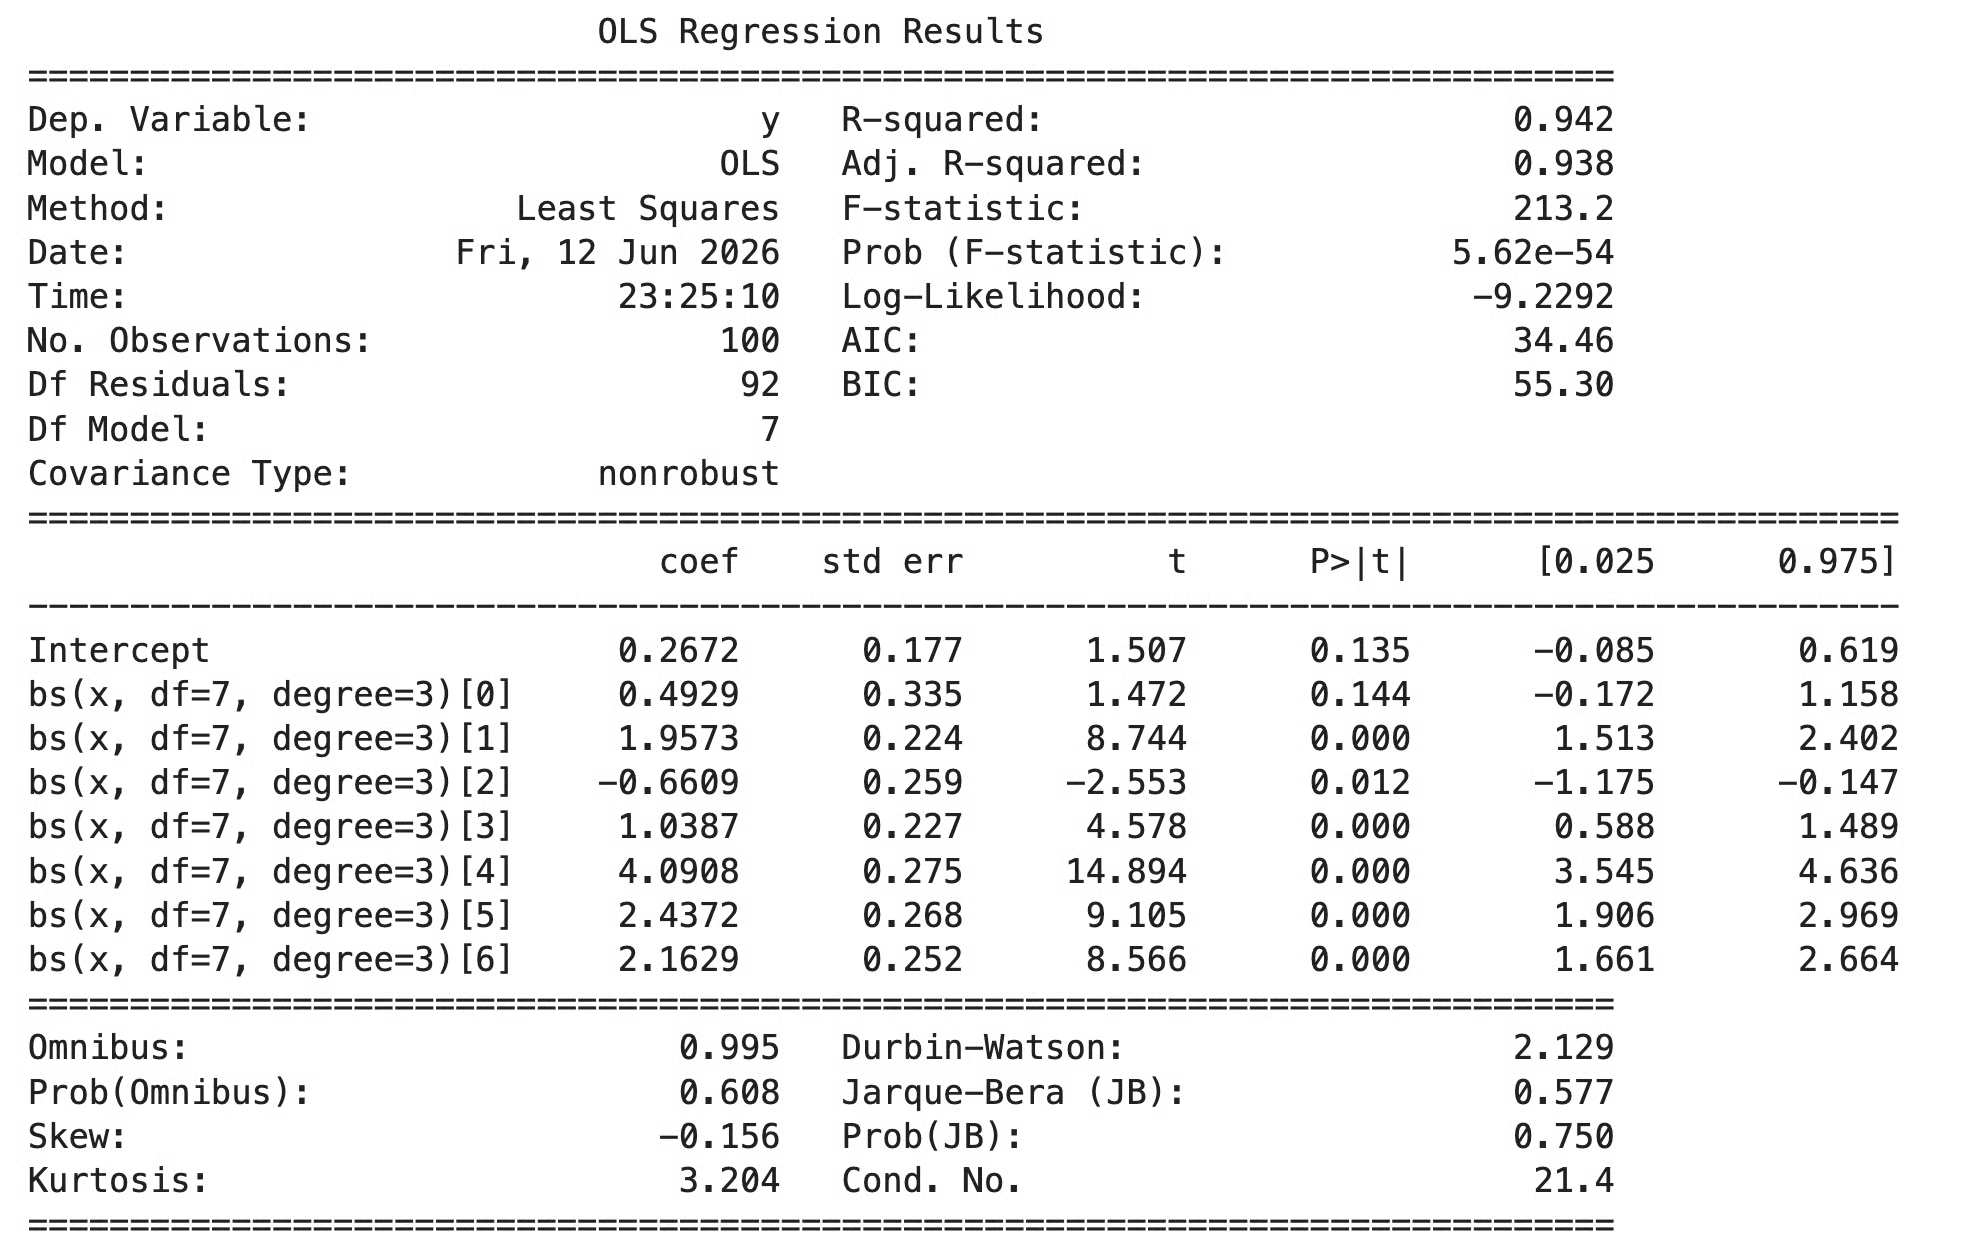
statsmodels मॉडल सारांश
summary() आउटपुट आपको प्रत्येक स्प्लाइन बेसिस फ़ंक्शन के गुणांक, मानक त्रुटियाँ, p-मूल्य, और सामान्य फिट सांख्यिकी देता है। स्वयं गुणांकों की सीधी व्याख्या नहीं की जा सकती, क्योंकि हर एक किसी बेसिस फ़ंक्शन से जुड़ा होता है, वास्तविक दुनिया की इकाई से नहीं। आप भविष्यवाणियों को प्रिडिक्टर रेंज में प्लॉट करके फिट की व्याख्या करते हैं।
अधिकांश सांख्यिकीय वर्कफ़्लोज़ के लिए, statsmodels फॉर्मूला API सबसे सुविधाजनक विकल्प है। जब स्प्लाइन्स बड़े ML पाइपलाइन का हिस्सा हों, तो scikit-learn का उपयोग करें।
मुख्य भाषाओं में से किसी में भी स्प्लाइन्स के लिए R का बिल्ट-इन सपोर्ट सबसे अच्छा है। splines पैकेज बेस R के साथ आता है, और इसके दो मुख्य फ़ंक्शन - bs() और ns() - किसी भी रिग्रेशन फॉर्मूला के अंदर सीधे काम करते हैं।
bs() फ़ंक्शन B-spline बेसिस बनाता है। ns() फ़ंक्शन नैचरल क्यूबिक स्प्लाइन बेसिस बनाता है। दोनों स्प्लाइन फीचर्स का एक मैट्रिक्स बनाते हैं जिसे R की फॉर्मूला प्रणाली स्वतः मॉडल में सम्मिलित कर देती है।
# Data
set.seed(42)
x <- seq(0, 10, length.out = 100)
y <- sin(x) + 0.3 * x + rnorm(100, sd = 0.3)
df <- data.frame(x = x, y = y)

# Cubic B-spline with 6 degrees of freedom
library(splines)
model <- lm(y ~ bs(x, df = 6, degree = 3), data = df)
summary(model)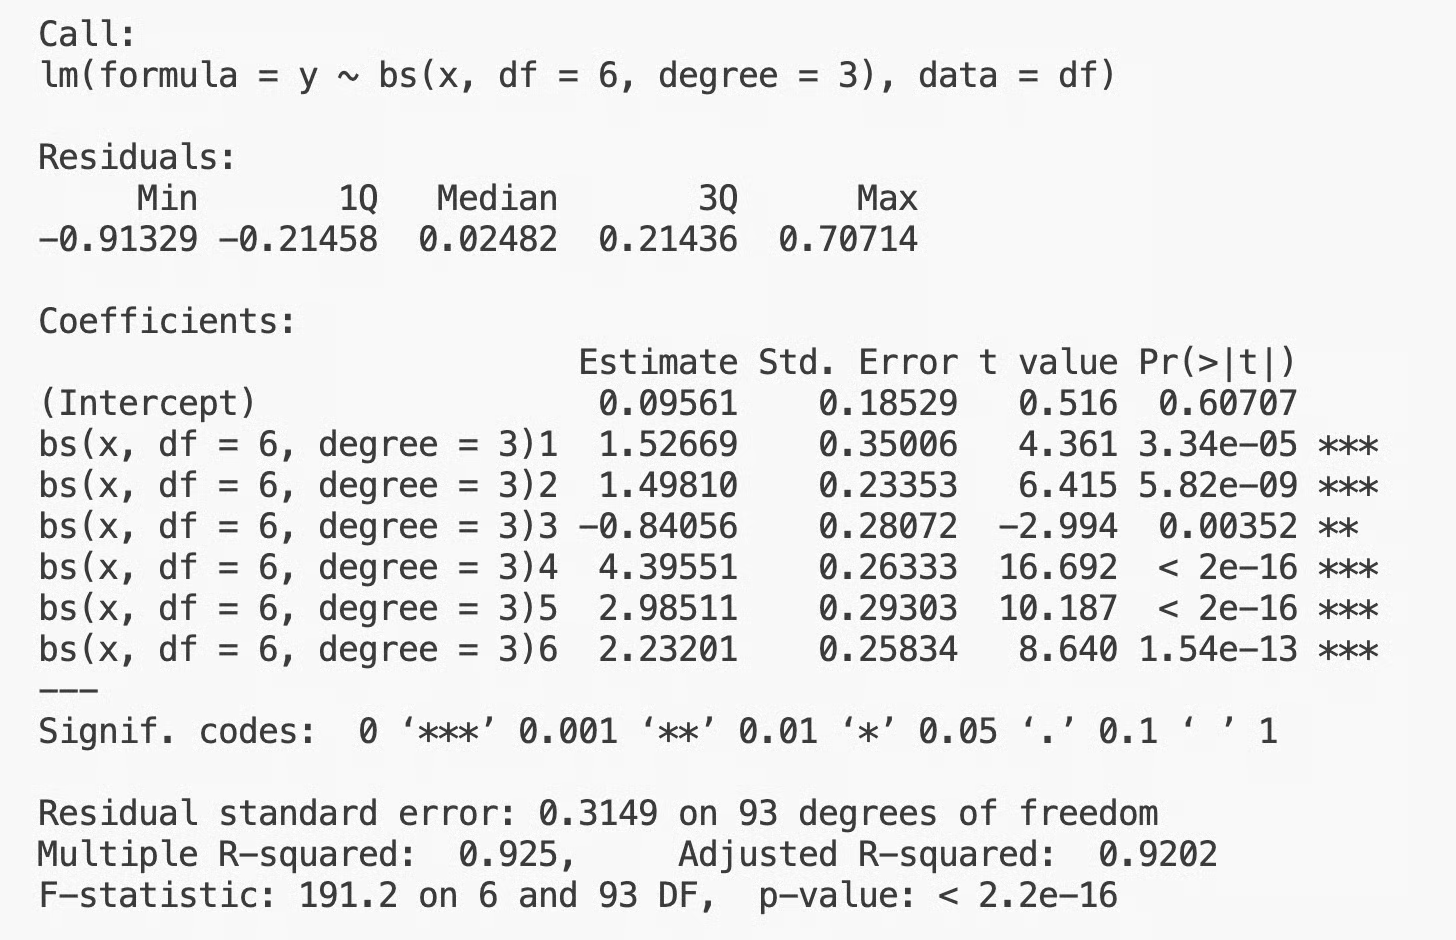
R में bs() आउटपुट
फॉर्मूला y ~ bs(x, df = 6, degree = 3) R को यह बताता है कि x को डिग्री 3 और 6 डिग्रीज़ ऑफ़ फ्रीडम वाले B-spline बेसिस से बदल दे। बाकी काम R संभालता है - यह बेसिस मैट्रिक्स बनाता है, लीनियर मॉडल फिट करता है, और सभी सामान्य डायग्नोस्टिक्स के साथ एक मानक lm ऑब्जेक्ट बनाता है।
यदि आप पूर्ण नियंत्रण चाहते हैं, तो आप नॉट पोज़िशन सीधे पास कर सकते हैं:
model <- lm(y ~ bs(x, knots = c(2, 5, 8), degree = 3), data = df)यह x = 2, x = 5, और x = 8 पर नॉट्स लगाता है, बजाय इसके कि R उन्हें आपके लिए चुने।
नैचरल क्यूबिक स्प्लाइन्स (जो सीमाओं के बाहर रेखीय व्यवहार करते हैं) के लिए, ns() का उपयोग करें:
model_natural <- lm(y ~ ns(x, df = 6), data = df)
summary(model_natural)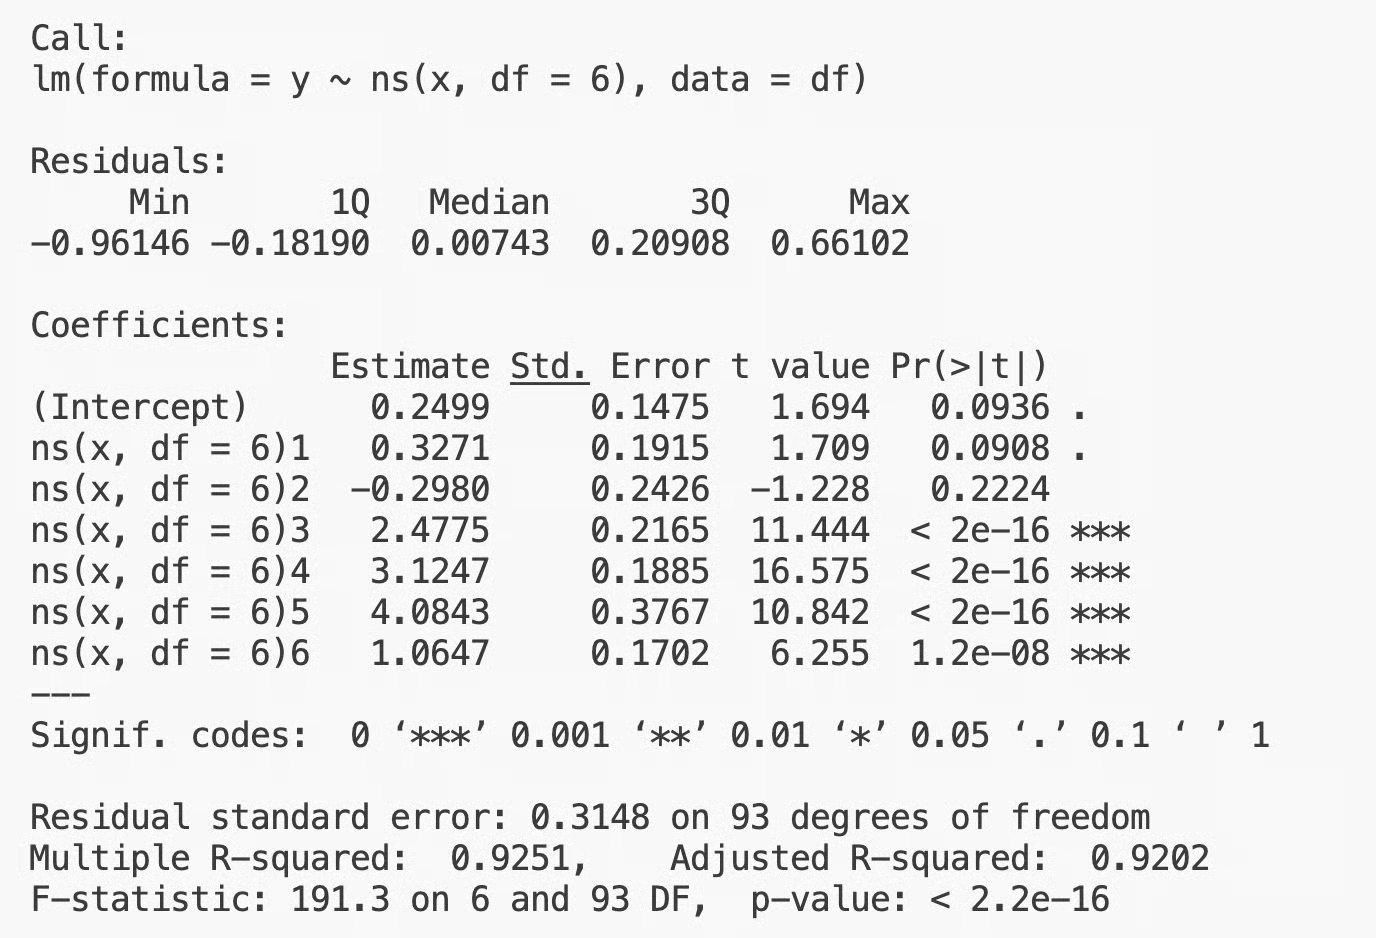
R में ns() आउटपुट
सिंटैक्स वही है, लेकिन सीमा के पास व्यवहार अलग है। जब आपको डेटा की किनारों के पास भविष्यवाणी या व्याख्या की परवाह हो, तो नैचरल स्प्लाइन्स आमतौर पर अधिक सुरक्षित विकल्प होते हैं।
summary() के आउटपुट में दिए गए गुणांक स्प्लाइन बेसिस फ़ंक्शन्स से संबंधित होते हैं, न कि व्याख्यायोग्य मात्राओं से। यह देखने के लिए कि मॉडल ने वास्तव में क्या सीखा, x मानों के एक ग्रिड पर भविष्यवाणी करें और परिणाम को प्लॉट करें:
x_grid <- data.frame(x = seq(0, 10, length.out = 200))
preds <- predict(model, newdata = x_grid)
plot(df$x, df$y)
lines(x_grid$x, preds, col = "green", lwd = 2)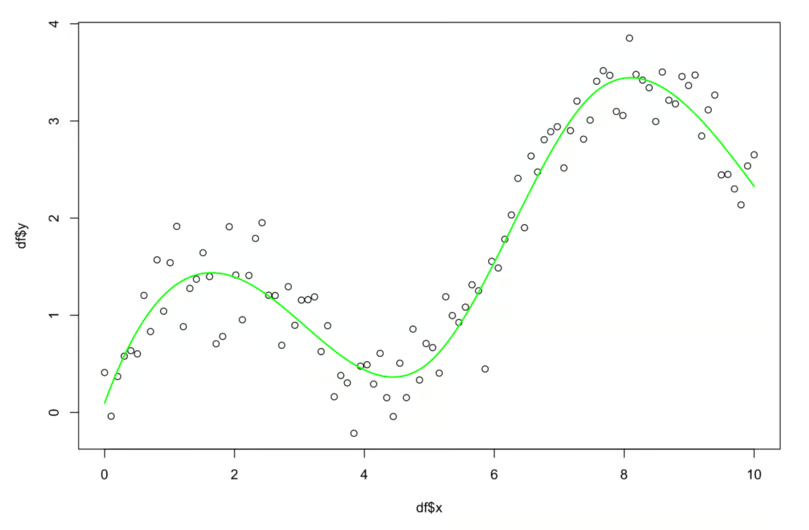
R में आउटपुट की व्याख्या
यह R में मानक पैटर्न है, जिसमें आप स्प्लाइन फिट करते हैं, स्मूथ ग्रिड पर भविष्यवाणी करते हैं, और कर्व को डेटा पर ओवरले करते हैं। R आपको उसी फॉर्मूला में अन्य प्रिडिक्टर्स के साथ स्प्लाइन टर्म्स का उपयोग करने की भी अनुमति देता है:
model_multi <- lm(y ~ ns(x, df = 6) + other_var, data = df)यह एक ही मॉडल में x के लिए नॉनलाइनियर प्रभाव और other_var के लिए लीनियर प्रभाव फिट करता है। यही लचीलापन R-आधारित सांख्यिकीय वर्कफ़्लोज़ में स्प्लाइन्स को इतना व्यापक रूप से उपयोगी बनाता है।
लोकप्रिय मशीन लर्निंग मॉडलों की तुलना में स्प्लाइन्स के कुछ फायदे यहाँ हैं:
ज्यादातर मॉडलों की तरह, स्प्लाइन्स के साथ कुछ समझौते आते हैं जिनके बारे में आपको जानना चाहिए:
अब मैं कुछ गलतियों पर जाता हूँ जो नए उपयोगकर्ता स्प्लाइन रिग्रेशन के साथ करते हैं:
नॉनलाइनियर संबंधों को मॉडल करने का यह एकमात्र तरीका नहीं है, लेकिन यदि आपको व्याख्यायोग्यता की परवाह है तो स्प्लाइन्स उपयोगी हैं। यहाँ यह सबसे आम विकल्पों की तुलना में कैसे हैं।
पॉलिनॉमियल रिग्रेशन एक एकल वैश्विक समीकरण का उपयोग करता है। इसे निर्दिष्ट करना सरल है लेकिन कम स्थिर है, खासकर सीमाओं पर। जब संबंध में एक से अधिक मोड़ हों, तो स्प्लाइन्स लचीलापन और स्थिरता में पॉलिनॉमियल्स से बेहतर होती हैं। पॉलिनॉमियल्स केवल बहुत कम डिग्री (2 या 3) पर ही व्याख्या में आसान होते हैं। उसके बाद, स्प्लाइन्स अधिक विश्वसनीय और अधिक व्याख्यायोग्य हो जाती हैं।
GAMs मूल रूप से बड़े पैमाने पर किए गए स्प्लाइन्स हैं। एक GAM आपको प्रत्येक प्रिडिक्टर के लिए अलग से स्प्लाइन फिट करने और उन्हें ऐडिटिव रूप से संयोजित करने देता है। आप स्प्लाइन रिग्रेशन को एक-चर GAM के रूप में, और GAM को अनेक चर पर स्प्लाइन्स के योग के रूप में सोच सकते हैं।
GAMs कई नॉनलाइनियर प्रिडिक्टर्स को, प्रत्येक के लिए अलग-अलग स्प्लाइन्स फिट करने की तुलना में, अधिक साफ-सुथरे ढंग से संभालते हैं। इनमें स्मूदिंग पेनल्टी भी शामिल होती हैं जो उपयुक्त लचीलापन चुनती हैं, जिससे नॉट-चयन का कुछ काम कम हो जाता है। यदि आप कई प्रिडिक्टर्स के साथ काम कर रहे हैं और उनमें से कुछ को नॉनलाइनियर ट्रीटमेंट चाहिए, तो GAMs आमतौर पर बेहतर विकल्प हैं।
डिसीज़न ट्रीज़ पूरी तरह अलग दृष्टिकोण अपनाते हैं। स्मूथ कर्व फिट करने के बजाय, वे प्रिडिक्टर स्पेस को आयताकार क्षेत्रों में विभाजित करते हैं और प्रत्येक क्षेत्र में एक स्थिर मान की भविष्यवाणी करते हैं। परिणाम एक स्टेप फ़ंक्शन होता है।
कुछ मामलों में ट्रीज़ स्प्लाइन्स से अधिक लचीले होते हैं—वे इंटरैक्शन्स और अचानक बदलावों को मॉडल कर सकते हैं। लेकिन फिट किया गया फ़ंक्शन स्मूथ या सतत नहीं होता। यह विरल डेटा वाले क्षेत्रों में उतना अच्छा सामान्यीकरण भी नहीं करता। यदि आपको स्मूदनेस और स्थिर एक्स्ट्रापोलेशन की परवाह है, तो स्प्लाइन्स बेहतर हैं। जब आपको कई चरों में तीखी सीमाएँ या इंटरैक्शन्स मॉडल करने की परवाह हो, तो ट्रीज़ बेहतर होते हैं।
एप्लाइड स्टैटिस्टिक्स में स्प्लाइन्स हर जगह हैं। वे क्लीनिकल रिसर्च, आर्थिक विश्लेषण, पर्यावरण विज्ञान, टाइम सीरीज़ मॉडलिंग, और किसी भी ऐसे क्षेत्र में दिखते हैं जहाँ किसी को ब्लैक-बॉक्स मॉडल के बिना एक स्मूथ नॉनलाइनियर प्रभाव मॉडल करना होता है।
कारण है उनका संतुलन—इतना लचीलापन कि गंदे डेटा को संभाल सकें, और इतनी संरचना कि व्याख्यायोग्य और स्थिर बने रहें।
वे अधिक उन्नत विधियों की बुनियाद भी हैं। जनरलाइज़्ड एडिटिव मॉडल्स सीधे स्प्लाइन्स पर बने हैं, स्मूदिंग स्प्लाइन्स इस विचार को इनबिल्ट रेग्युलराइज़ेशन के साथ बढ़ाते हैं, और कई आधुनिक नॉनलाइनियर रिग्रेशन तकनीकें स्प्लाइन बेसिस का उपयोग करती हैं। यदि आप इनमें से किसी को समझना चाहते हैं, तो पहले स्प्लाइन्स समझना होगा।
तो स्प्लाइन्स महत्वपूर्ण हैं क्योंकि वे व्यावहारिक हैं और क्योंकि वे आगे आने वाली बहुत सी चीज़ों के बिल्डिंग ब्लॉक हैं। वे सबसे शक्तिशाली मॉडल नहीं हैं, लेकिन सबसे विश्वसनीय में से एक हैं—और अक्सर वही मायने रखता है।
स्प्लाइन रिग्रेशन नॉट्स कहलाने वाले बिंदुओं पर पीसवाइज़ पॉलिनॉमियल्स को जोड़कर नॉनलाइनियर संबंधों का मॉडल बनाता है। यही विचार है, और बाकी उसी के विविध रूप हैं।
नॉट्स और स्मूदनेस—ये दो विचार हैं जिन्हें आपको समझना है। बाकी सब (स्प्लाइन प्रकार, बेसिस रिप्रेज़ेंटेशन्स, R और Python में इम्प्लीमेंटेशन) इन्हीं दो अवधारणाओं के साथ काम करने के अलग-अलग तरीके हैं।
अपने डेटा पर कुछ स्प्लाइन प्रकार आज़माएँ। क्यूबिक, नैचरल क्यूबिक, और B-splines की तुलना करें। नॉट्स को शिफ्ट करें और देखें क्या होता है। बस प्रयोग करें, क्योंकि फिट की दृश्य प्रकृति से यह देखना आसान हो जाता है कि हर विकल्प क्या करता है।
यदि आप स्प्लाइन्स और कई अन्य एल्गोरिद्म के पीछे के गणित में और गहराई से जाना चाहते हैं, तो हमारे Machine Learning Scientist in Python ट्रैक में नामांकन करें। इसमें 2026 में नौकरी के लिए तैयार होने के लिए आवश्यक सब कुछ है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स
