

Kursus
Pengantar Data Engineering
4 jam
130.4K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleAda beberapa teknik yang memfasilitasi data ingestion. Masing-masing dirancang untuk mengatasi berbagai kasus penggunaan dan kebutuhan pemrosesan data.
Pilihan teknik yang Anda gunakan bergantung pada 3 faktor:
Di bagian ini, saya akan membahas tiga teknik data ingestion dan kapan teknik tersebut paling efektif.
ETL adalah teknik data ingestion tradisional yang banyak digunakan. Dalam pendekatan ini, data diextract dari berbagai sistem sumber, kemudian ditransformasi ke format yang konsisten dan bersih, dan akhirnya dimuat ke dalam sistem penyimpanan data, seperti gudang data.
Metode ini sangat efektif untuk kasus penggunaan yang membutuhkan data konsisten dan terstruktur untuk pelaporan, analitik, dan pengambilan keputusan.
Kapan menggunakan ETL:
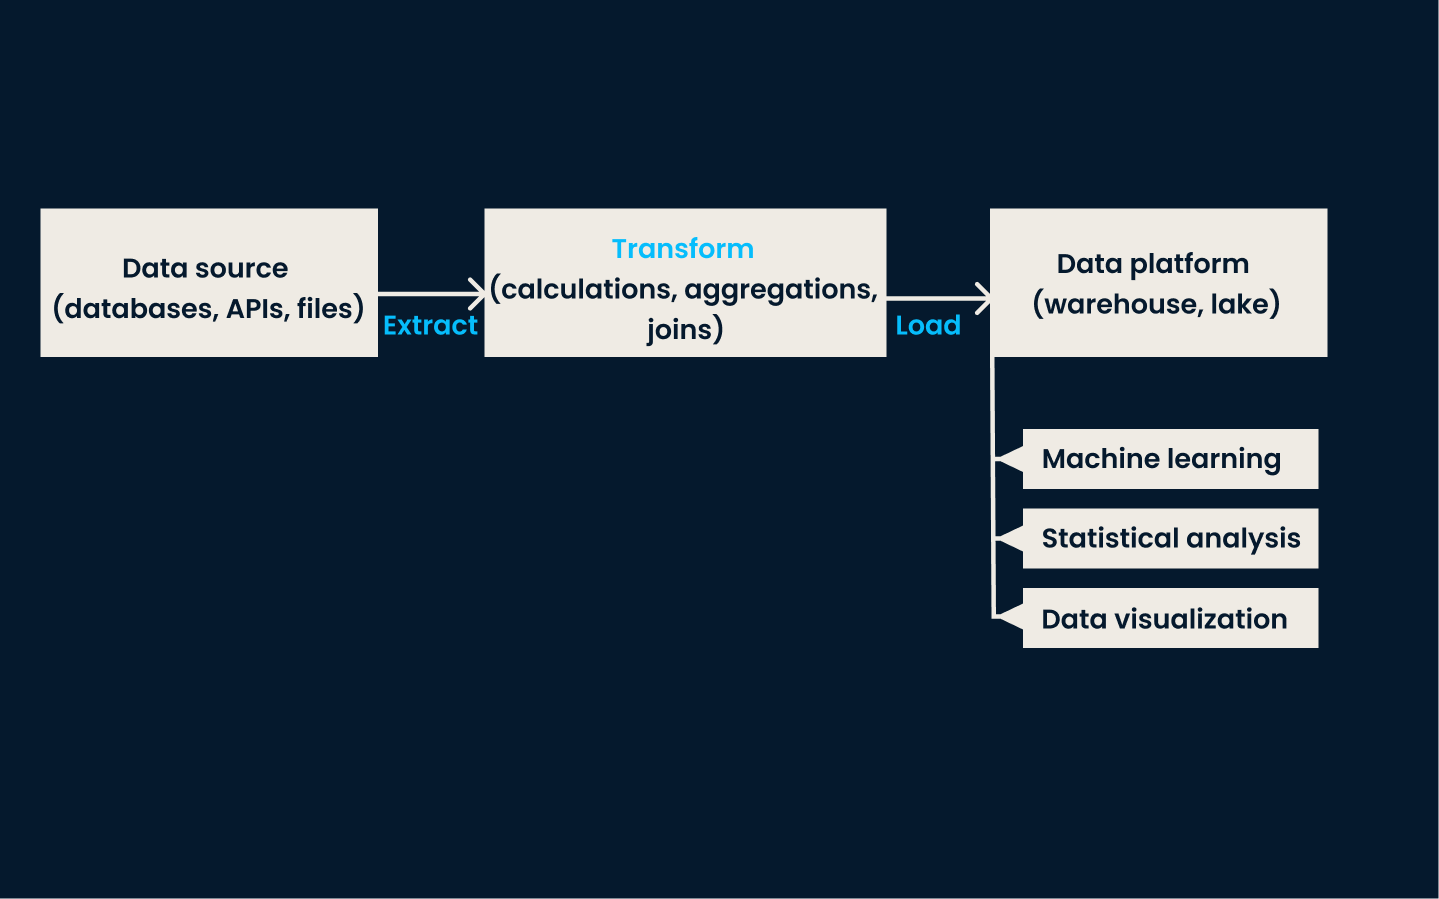
Arsitektur pipeline ETL.
ELT membalik urutan operasi dibandingkan ETL. Dalam pendekatan ini, data diextract dari sistem sumber dan dimuat langsung ke sistem target (biasanya data lake atau platform berbasis cloud). Setelah berada di sistem penyimpanan target, data ditransformasi sesuai kebutuhan, sering kali di lingkungan tujuan.
Pendekatan ELT sangat efektif saat menangani volume besar data tidak terstruktur atau semi-terstruktur, di mana transformasi dapat ditunda hingga analisis diperlukan.
Kapan menggunakan ELT:
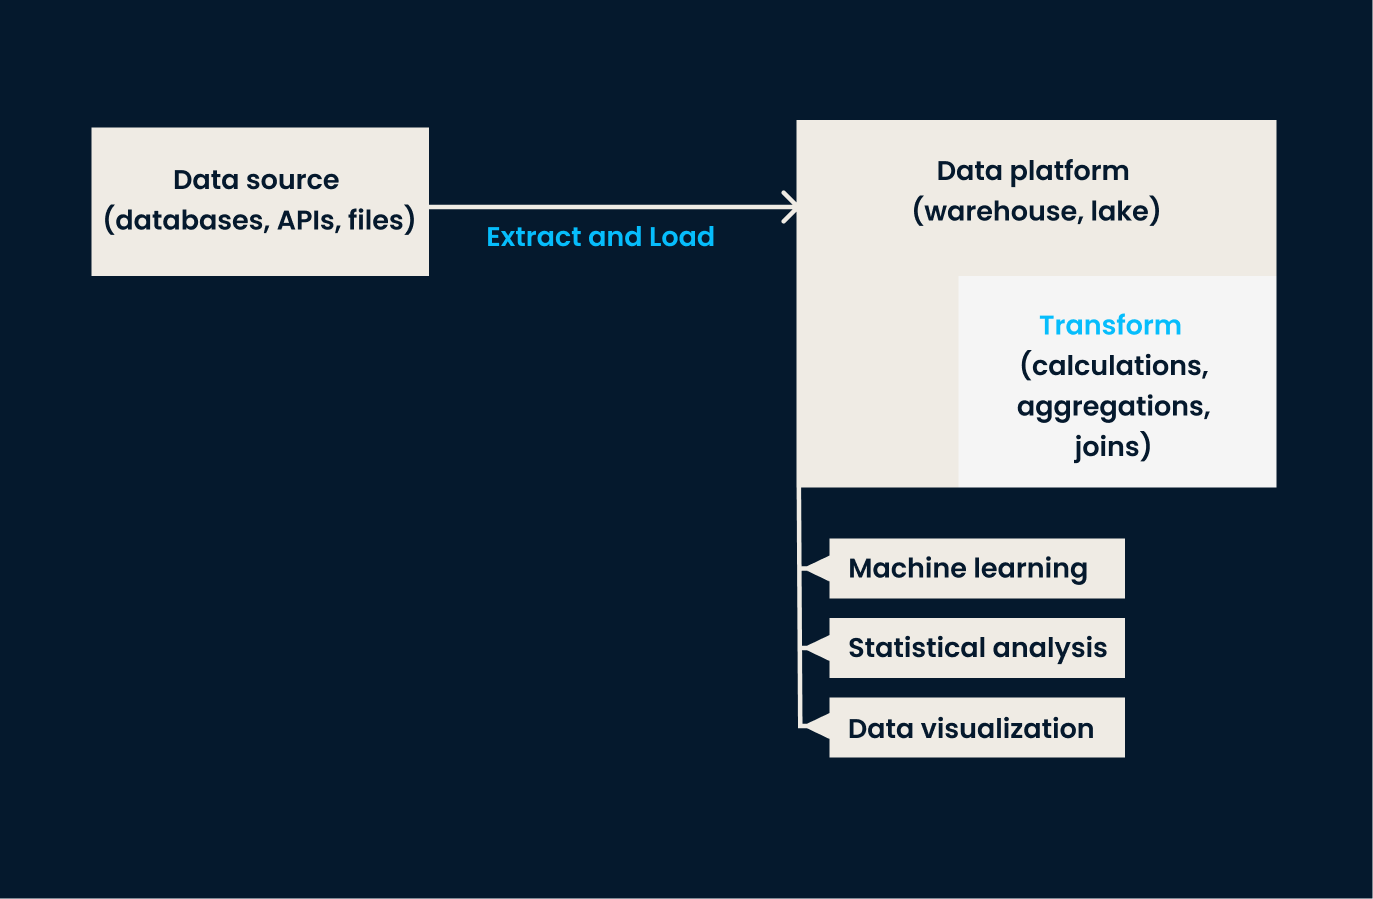
Arsitektur pipeline ELT.
CDC adalah teknik untuk mengidentifikasi dan menangkap perubahan (misalnya, insert, update, delete) yang dilakukan pada data di sistem sumber lalu mereplikasi perubahan tersebut secara real-time ke sistem tujuan.
Teknik ini memastikan bahwa sistem target selalu mutakhir tanpa memuat ulang seluruh dataset. CDC sangat efektif untuk mempertahankan sinkronisasi real-time antar basis data dan memastikan konsistensi di seluruh sistem.
Kapan menggunakan CDC:
Kita telah menetapkan bahwa data ingestion melibatkan pengambilan informasi dari berbagai sumber. Namun kita belum membahas apa saja strukturnya — dan itu yang akan kita lakukan di bagian ini.
Sumber data untuk ingestion umumnya mencakup 3 tipe utama:
Seperti yang akan Anda pelajari saat meninjau berbagai sumber, masing-masing memerlukan penanganan dan teknik pemrosesan berbeda agar dapat dimanfaatkan secara efektif.
Data terstruktur sangat terorganisir dan mengikuti skema yang telah ditentukan, sehingga lebih mudah diproses dan dianalisis. Data ini biasanya disimpan dalam basis data relasional, yang menyimpan dan menyediakan akses ke titik data yang saling terkait. Data diatur dalam tabel dengan baris dan kolom yang didefinisikan dengan jelas.
Karena sifatnya yang terorganisir, data terstruktur adalah yang paling mudah untuk diingest.
Alat tradisional seperti MySQL dan PostgreSQL biasanya digunakan untuk menangani data terstruktur. Alat berbasis SQL ini menyederhanakan proses validasi selama ingestion dengan menerapkan aturan skema yang ketat. Saat data diingest ke sistem ini, mereka secara otomatis memastikan data mematuhi struktur yang ditentukan oleh tabel basis data.
Sebagai contoh, jika sebuah kolom diatur untuk hanya menerima nilai bilangan bulat, MySQL atau PostgreSQL akan menolak data apa pun yang tidak memenuhi persyaratan ini.
Hal lain yang perlu dicatat tentang data terstruktur adalah:
Data semi-terstruktur, meskipun masih terorganisir hingga tingkat tertentu, tidak mengikuti skema kaku yang telah ditentukan seperti data terstruktur. Sebaliknya, data ini menggunakan tag atau penanda untuk memberikan sebagian organisasi, tetapi strukturnya tetap fleksibel.
Tipe data ini umumnya ditemukan dalam format seperti file JSON, file CSV, dan basis data NoSQL, serta umum digunakan dalam aplikasi web, API, dan sistem log.
Karena strukturnya dapat bervariasi, data semi-terstruktur menawarkan fleksibilitas dalam penyimpanan dan pemrosesan, sehingga cocok untuk sistem yang menangani format data yang berkembang atau tidak konsisten.
Menangani data semi-terstruktur memerlukan alat untuk mengurai dan mengekstrak informasi bermakna dari tag atau penanda yang tertanam. Misalnya, file JSON dapat berisi kumpulan pasangan key-value, dan proses ingestion akan melibatkan penguraian pasangan ini dan mentransformasikannya ke format yang sesuai.
Data semi-terstruktur sering diingest ke lingkungan yang fleksibel seperti data lake atau platform cloud, di mana data dapat disimpan dalam bentuk mentah dan diproses nanti sesuai kebutuhan.
Hal lain yang perlu diperhatikan tentang data semi-terstruktur meliputi:
Data tidak terstruktur adalah tipe yang paling kompleks untuk dikelola karena tidak memiliki format atau struktur organisasi khusus. Kategori ini mencakup data seperti:
Berbeda dengan data terstruktur atau semi-terstruktur, data tidak terstruktur tidak memiliki baris, kolom, atau tag yang jelas untuk mendefinisikan kontennya, sehingga lebih menantang untuk diproses dan dianalisis.
Walaupun kompleks, data tidak terstruktur dapat menyimpan wawasan berharga, terutama saat dianalisis menggunakan teknologi canggih seperti machine learning atau pemrosesan bahasa alami.
Karena data tidak terstruktur tidak diatur dengan cara yang telah ditentukan, diperlukan alat khusus untuk menangani proses ingestion. Alat-alat ini dapat mengekstrak informasi relevan dari sumber mentah yang tidak terstruktur dan mengubahnya menjadi format yang dapat dianalisis.
Terakhir, data tidak terstruktur biasanya disimpan di data lake, di mana data dapat diproses sesuai kebutuhan.
|
Fitur |
Data terstruktur |
Data semi-terstruktur |
Data tidak terstruktur |
|
Definisi |
Data yang sangat terorganisir dengan skema yang telah ditentukan (misalnya, baris dan kolom). |
Data yang sebagian terorganisir dengan tag atau penanda untuk fleksibilitas (misalnya, JSON, CSV). |
Data tanpa struktur atau organisasi yang telah ditentukan (misalnya, gambar, video). |
|
Contoh |
Basis data relasional seperti MySQL, PostgreSQL. |
File JSON, basis data NoSQL, log CSV. |
Gambar, video, file audio, dokumen teks. |
|
Kemudahan pemrosesan |
Paling mudah diproses karena skema yang ketat. |
Tingkat kesulitan sedang; memerlukan parsing dan transformasi. |
Paling menantang karena tidak adanya struktur. |
|
Penyimpanan |
Basis data relasional atau gudang data. |
Data lake, basis data NoSQL, penyimpanan cloud. |
Data lake atau penyimpanan khusus untuk file mentah. |
|
Pendekatan ingestion |
Biasanya diingest secara batch. |
Fleksibel; dapat diingest secara real-time atau batch. |
Utamanya diingest dalam format mentah untuk diproses nanti. |
|
Alat yang digunakan |
Alat berbasis SQL seperti MySQL, PostgreSQL. |
Alat yang menangani skema fleksibel, seperti MongoDB, Google BigQuery. |
Alat lanjutan seperti Hadoop, Apache Spark, atau alat pemrosesan berbasis AI/ML. |
|
Contoh kasus penggunaan |
Pembuatan laporan, sistem transaksional. |
Respons API, log aplikasi web. |
Pengenalan gambar, analisis ucapan, analisis sentimen. |
Data ingestion memiliki sejumlah tantangan yang harus Anda atasi untuk memastikan pengelolaan data yang efisien dan efektif. Di bagian ini, kita akan membahas tantangan tersebut dan solusi yang dapat diterapkan untuk mengatasinya.
Salah satu tantangan utama dalam data ingestion adalah besarnya volume data yang perlu diproses. Seiring pertumbuhan bisnis, jumlah data yang mereka hasilkan dan kumpulkan dapat meningkat secara eksponensial, terutama dengan munculnya aliran data real-time dari sumber seperti perangkat IoT dan platform media sosial.
Menskalakan proses data ingestion untuk menangani volume yang terus meningkat bisa sulit, terutama dengan data streaming yang memerlukan ingestion berkelanjutan.
Tim harus memastikan infrastruktur mereka dapat mendukung data ingestion batch dan real-time dalam skala besar tanpa degradasi. Kursus Streaming Concepts adalah cara yang tepat untuk memulai.
Kualitas dan konsistensi data juga menjadi tantangan besar, terutama ketika data diingest dari berbagai sumber yang terpisah. Setiap sumber dapat memiliki format berbeda, tingkat kelengkapan yang bervariasi, atau bahkan informasi yang saling bertentangan.
Meng-ingest data tanpa mengatasi inkonsistensi ini dapat mengarah pada dataset yang tidak akurat atau tidak lengkap, yang pada akhirnya berdampak pada analitik downstream.
Pemeriksaan validasi data harus diterapkan selama ingestion untuk memastikan hanya data berkualitas tinggi yang masuk ke sistem. Selain itu, tim perlu menjaga konsistensi di berbagai sumber untuk menghindari perbedaan data.
Saya merekomendasikan pendalaman topik ini melalui kursus pengantar Data Quality yang sangat baik.
Saat data sensitif diingest, keamanan dan kepatuhan menjadi prioritas utama. Tim yang menangani informasi pribadi (misalnya, nama pelanggan, alamat, detail pembayaran, dll.) harus melindungi data ini sepanjang proses ingestion.
Sebagai contoh, sebuah perusahaan jasa keuangan harus mematuhi peraturan ketat seperti GDPR atau HIPAA saat mengingest data klien untuk menghindari konsekuensi hukum. Gagal mengamankan data selama ingestion dapat mengakibatkan pelanggaran data, merusak kepercayaan pelanggan, dan menyebabkan denda finansial yang besar.
Untuk mengatasinya, tim harus menerapkan enkripsi dan kontrol akses yang aman selama proses ingestion. Ini memastikan data sensitif terlindungi dari akses tidak sah. Selain itu, data harus diingest dengan cara yang mematuhi semua standar regulasi yang relevan, dengan audit rutin untuk memverifikasi kepatuhan yang berkelanjutan.
Pelajari cara menjaga data tetap aman melalui kursus interaktif pemula Data Security.
Dalam skenario yang membutuhkan wawasan segera, keterlambatan dalam data ingestion dapat menghasilkan informasi yang usang atau tidak relevan. Data ingestion berlatensi rendah memerlukan kemampuan untuk memproses dan membuat data tersedia untuk analisis hampir seketika, yang bisa menjadi tantangan saat menangani volume data besar.
Tim harus mengoptimalkan sistem mereka dengan cermat untuk mengurangi latensi dan memastikan data tersedia saat dibutuhkan.
Ada beberapa praktik terbaik untuk memastikan data ingestion yang efisien dan efektif.
Data yang diingest akan digunakan untuk analitik, pelaporan, dan pengambilan keputusan, sehingga harus memenuhi standar akurasi dan kelengkapan yang telah ditentukan.
Menerapkan pemeriksaan validasi data selama ingestion dapat membantu memverifikasi bahwa data sesuai dengan format dan standar kualitas yang diharapkan. Saya sudah menulis tentang ini sebelumnya dalam tutorial Great Expectations.
Misalnya, jika data diharapkan berada dalam rentang tertentu atau memenuhi kriteria spesifik, gunakan aturan validasi untuk secara otomatis menolak atau menandai data yang tidak memenuhi standar tersebut. Ini meminimalkan kesalahan dan memastikan hanya data andal yang diproses di tahap berikutnya.
Praktik terbaik lainnya adalah memastikan Anda memilih pendekatan ingestion yang sesuai dengan kebutuhan bisnis Anda.
Ingestion batch biasanya digunakan untuk data yang kurang sensitif terhadap waktu, seperti laporan historis atau berkala. Sebaliknya, ingestion real-time digunakan untuk aplikasi yang memerlukan akses instan ke data terbaru, seperti deteksi penipuan atau pemantauan IoT.
Nilailah kebutuhan Anda berdasarkan frekuensi dan urgensi pembaruan data.
Volume data Anda akan bertambah seiring waktu. Oleh karena itu, penting untuk memilih alat dan infrastruktur yang dapat diskalakan untuk menangani peningkatan jumlah data tanpa mengorbankan kinerja. Ini memungkinkan Anda memperluas pipeline data dan kemampuan pemrosesan untuk mengakomodasi pertumbuhan di masa depan.
Kebutuhan ruang penyimpanan yang lebih sedikit berarti biaya infrastruktur lebih rendah. Kompresi juga mempercepat transfer data, yang berarti ingestion akan lebih cepat — terutama saat menangani dataset besar atau aliran dengan volume tinggi. Praktik ini sangat bermanfaat saat menangani data semi-terstruktur atau tidak terstruktur, karena sering kali berukuran besar.
Seperti yang Anda lihat, data ingestion adalah konsep sederhana tetapi bisa cukup sulit untuk diterapkan sendiri. Apa saja alat terbaik yang membantu Anda dalam data ingestion? Saya telah mengkurasi daftar yang paling umum digunakan.
Apache Kafka adalah platform streaming terdistribusi yang unggul dalam data ingestion real-time.
Kursus Introduction to Kafka dapat mengajarkan Anda cara membuat, mengelola, dan menelusuri masalah Kafka untuk tantangan data streaming dunia nyata.
Apache Nifi adalah alat data ingestion yang dikenal dengan antarmuka visual yang ramah pengguna.
Amazon Kinesis adalah layanan cloud-native dari AWS yang mengkhususkan diri dalam mengingest, memproses, dan menganalisis data streaming. Layanan ini dirancang untuk aplikasi yang membutuhkan pemrosesan hampir real-time untuk aliran data ber-throughput tinggi, seperti:
Salah satu manfaat Kinesis adalah kemampuannya untuk berintegrasi dengan layanan AWS lainnya untuk penyimpanan, analitik, dan machine learning.
Alat ini sangat cocok untuk organisasi yang memanfaatkan infrastruktur cloud dan menginginkan solusi terkelola sepenuhnya untuk menangani kebutuhan data ingestion tanpa harus memikirkan perangkat keras atau masalah skalabilitas.
Google Cloud Dataflow adalah layanan terkelola penuh dari Google Cloud yang mendukung pemrosesan data batch dan real-time.
Airbyte adalah platform data ingestion open-source yang menyederhanakan integrasi data dari berbagai sumber ke solusi penyimpanan.
| Alat | Tipe | Terbaik untuk | Fitur kunci | Penyebaran | Kemudahan penggunaan | Kustomisasi | Integrasi |
|---|---|---|---|---|---|---|---|
| Apache Kafka | Platform Streaming | Data ingestion real-time | Throughput tinggi, latensi rendah, dapat diskalakan | Cloud & On-Prem | Sedang | Tinggi | Dukungan ekosistem luas |
| Apache Nifi | Manajemen Alur Data | Pipeline data otomatis | UI seret-dan-lepas, pemrosesan real-time | Cloud & On-Prem | Tinggi | Tinggi | Beragam protokol, alat big data |
| Amazon Kinesis | Layanan Cloud Streaming | Analitik real-time native AWS | Terkelola penuh, skalabel, terintegrasi AWS | Cloud (AWS) | Tinggi | Sedang | Integrasi AWS yang mendalam |
| Google Cloud Dataflow | Layanan Pemrosesan Data | ETL batch & streaming | Auto-scaling, berbasis Apache Beam | Cloud (GCP) | Tinggi | Sedang | Integrasi GCP yang kuat |
| Airbyte | Platform Integrasi Data | Konektor siap pakai & kustom | Open-source, dukungan real-time & batch | Cloud & On-Prem | Tinggi | Sangat Tinggi | Ratusan sumber data |
Dalam artikel ini, kita telah membahas dasar-dasar data ingestion, jenis-jenisnya, dan teknik yang mendukungnya. Anda telah mempelajari ingestion batch dan real-time serta pendekatan populer seperti ETL, ELT, dan Change Data Capture (CDC). Kita juga telah membahas praktik terbaik, berbagai sumber data, dan tantangan yang dihadapi organisasi saat melaksanakannya.
Untuk wawasan lebih lanjut tentang pengelolaan data dan alat ingestion, saya merekomendasikan untuk menjelajahi sumber berikut:
Pelajari lebih lanjut tentang data engineering melalui kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



