

Khóa học
Introduction to Data Engineering
4 giờ
130.4K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleCó nhiều kỹ thuật hỗ trợ thu nạp dữ liệu. Mỗi kỹ thuật được thiết kế để giải quyết các trường hợp sử dụng và nhu cầu xử lý dữ liệu khác nhau.
Lựa chọn kỹ thuật phụ thuộc vào 3 yếu tố:
Trong phần này, tôi sẽ đề cập đến ba kỹ thuật thu nạp dữ liệu và thời điểm chúng phát huy hiệu quả nhất.
ETL là một kỹ thuật thu nạp dữ liệu truyền thống và được sử dụng rộng rãi. Ở cách tiếp cận này, dữ liệu được trích xuất từ nhiều hệ thống nguồn, được chuyển đổi sang định dạng nhất quán và sạch, và cuối cùng được nạp vào hệ thống lưu trữ dữ liệu, chẳng hạn như kho dữ liệu.
Phương pháp này rất hiệu quả cho các trường hợp sử dụng yêu cầu dữ liệu có cấu trúc, nhất quán để lập báo cáo, phân tích và ra quyết định.
Khi nào nên dùng ETL:
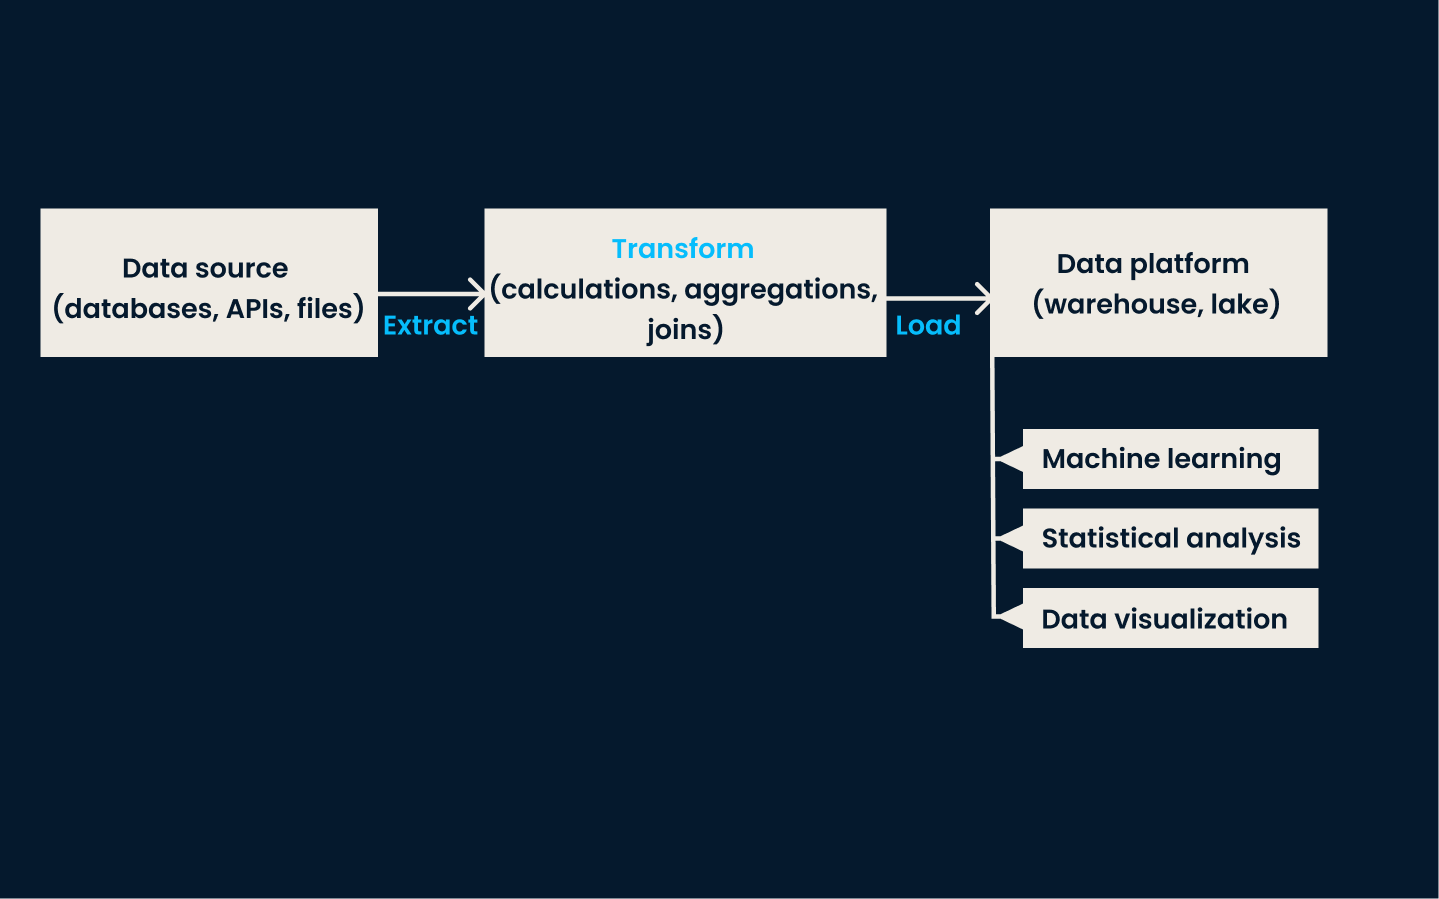
Kiến trúc đường ống ETL.
ELT đảo ngược thứ tự thao tác so với ETL. Ở cách tiếp cận này, dữ liệu được trích xuất từ các hệ thống nguồn và được nạp trực tiếp vào hệ thống đích (thường là hồ dữ liệu hoặc nền tảng đám mây). Khi đã ở trong hệ thống lưu trữ đích, dữ liệu sẽ được chuyển đổi khi cần, thường ngay trong môi trường đích.
Cách tiếp cận ELT đặc biệt hiệu quả khi xử lý khối lượng lớn dữ liệu phi cấu trúc hoặc bán cấu trúc, nơi việc chuyển đổi có thể hoãn lại cho đến khi cần phân tích.
Khi nào nên dùng ELT:
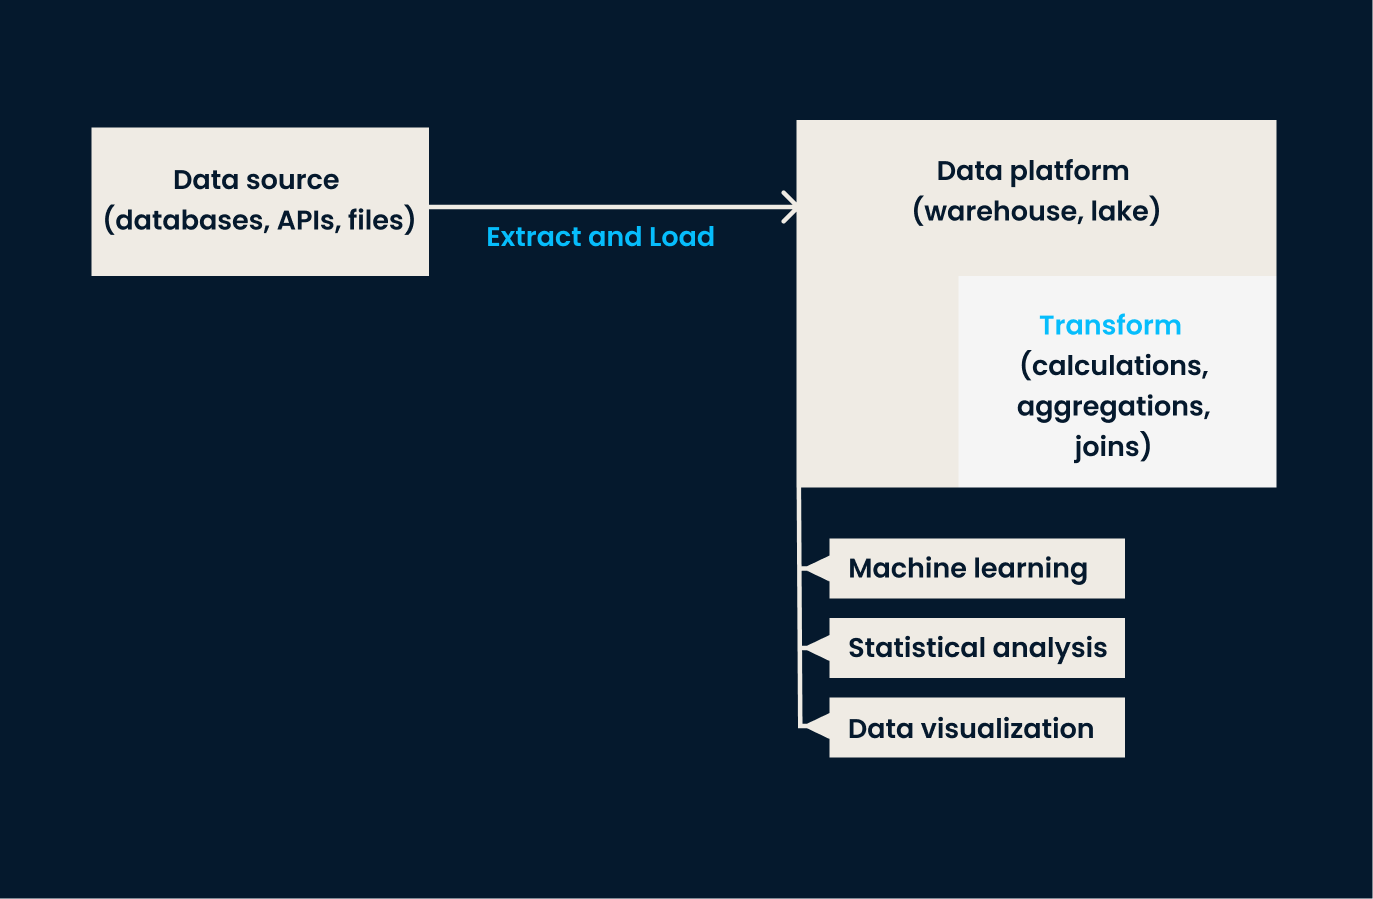
Kiến trúc đường ống ELT.
CDC là một kỹ thuật xác định và ghi nhận các thay đổi (ví dụ: chèn, cập nhật, xóa) được thực hiện đối với dữ liệu trong hệ thống nguồn và sau đó sao chép các thay đổi đó theo thời gian thực sang hệ thống đích.
Kỹ thuật này đảm bảo các hệ thống đích luôn được cập nhật mà không cần nạp lại toàn bộ tập dữ liệu. CDC rất hiệu quả để duy trì đồng bộ thời gian thực giữa các cơ sở dữ liệu và đảm bảo tính nhất quán giữa các hệ thống.
Khi nào nên dùng CDC:
Chúng ta đã xác định rằng thu nạp dữ liệu liên quan đến việc kéo thông tin từ nhiều nguồn. Nhưng chúng ta chưa bàn về những cấu trúc đó — và đó là nội dung của phần này.
Nguồn dữ liệu cho thu nạp thường thuộc 3 loại chính:
Như bạn sẽ thấy khi xem xét các nguồn khác nhau, mỗi loại đòi hỏi cách xử lý và kỹ thuật chế biến khác nhau để sử dụng hiệu quả.
Dữ liệu có cấu trúc được tổ chức cao và tuân theo một lược đồ xác định trước, giúp việc xử lý và phân tích dễ dàng hơn. Nó thường được lưu trữ trong cơ sở dữ liệu quan hệ, nơi lưu và cung cấp quyền truy cập tới các điểm dữ liệu liên quan. Dữ liệu được sắp xếp thành các bảng với hàng và cột được xác định rõ ràng.
Nhờ tính tổ chức này, dữ liệu có cấu trúc là loại dễ thu nạp nhất.
Các công cụ truyền thống như MySQL và PostgreSQL thường được sử dụng để xử lý dữ liệu có cấu trúc. Các công cụ dựa trên SQL này đơn giản hóa quá trình xác thực trong khi thu nạp bằng cách áp đặt các quy tắc lược đồ nghiêm ngặt. Khi dữ liệu được thu nạp vào các hệ thống này, chúng tự động đảm bảo dữ liệu tuân theo cấu trúc do các bảng cơ sở dữ liệu xác định.
Ví dụ, nếu một cột được đặt chỉ chấp nhận giá trị số nguyên, MySQL hoặc PostgreSQL sẽ từ chối bất kỳ dữ liệu nào không đáp ứng yêu cầu này.
Những điểm khác cần lưu ý về dữ liệu có cấu trúc:
Dữ liệu bán cấu trúc, dù vẫn có mức độ tổ chức nhất định, không tuân theo lược đồ cứng nhắc, xác định trước như dữ liệu có cấu trúc. Thay vào đó, nó dùng thẻ hoặc dấu để cung cấp một số tổ chức, nhưng cấu trúc vẫn linh hoạt.
Loại dữ liệu này thường được tìm thấy trong các định dạng như tệp JSON, tệp CSV và cơ sở dữ liệu NoSQL, và thường được dùng trong ứng dụng web, API và hệ thống nhật ký.
Vì cấu trúc có thể thay đổi, dữ liệu bán cấu trúc mang lại sự linh hoạt trong lưu trữ và xử lý, phù hợp với các hệ thống xử lý định dạng dữ liệu phát triển hoặc không nhất quán.
Xử lý dữ liệu bán cấu trúc đòi hỏi công cụ để phân tích cú pháp và trích xuất thông tin có ý nghĩa từ các thẻ hoặc dấu nhúng. Chẳng hạn, một tệp JSON có thể chứa tập hợp cặp khóa-giá trị, và quy trình thu nạp sẽ bao gồm việc phân tích các cặp này và chuyển đổi sang định dạng phù hợp.
Dữ liệu bán cấu trúc thường được thu nạp vào môi trường linh hoạt như hồ dữ liệu hoặc nền tảng đám mây, nơi có thể lưu trữ ở dạng thô và xử lý sau khi cần.
Những điểm khác về dữ liệu bán cấu trúc gồm:
Dữ liệu phi cấu trúc là loại phức tạp nhất để quản lý vì không có định dạng hoặc cấu trúc tổ chức cụ thể. Nhóm này bao gồm dữ liệu như:
Không giống dữ liệu có cấu trúc hoặc bán cấu trúc, dữ liệu phi cấu trúc không có hàng, cột hay thẻ rõ ràng để xác định nội dung, khiến việc xử lý và phân tích khó khăn hơn.
Dù phức tạp, dữ liệu phi cấu trúc có thể chứa những hiểu biết giá trị, đặc biệt khi được phân tích bằng các công nghệ tiên tiến như máy học hoặc xử lý ngôn ngữ tự nhiên.
Vì dữ liệu phi cấu trúc không được tổ chức theo cách xác định trước, cần có các công cụ chuyên dụng để xử lý quy trình thu nạp. Những công cụ này có thể trích xuất thông tin liên quan từ nguồn thô, phi cấu trúc và chuyển đổi thành định dạng có thể phân tích.
Cuối cùng, dữ liệu phi cấu trúc thường được lưu trữ trong hồ dữ liệu, nơi có thể xử lý khi cần.
|
Đặc điểm |
Dữ liệu có cấu trúc |
Dữ liệu bán cấu trúc |
Dữ liệu phi cấu trúc |
|
Định nghĩa |
Dữ liệu được tổ chức cao với lược đồ xác định trước (ví dụ: hàng và cột). |
Dữ liệu được tổ chức một phần với thẻ hoặc dấu để linh hoạt (ví dụ: JSON, CSV). |
Dữ liệu không có cấu trúc hay tổ chức xác định trước (ví dụ: hình ảnh, video). |
|
Ví dụ |
Cơ sở dữ liệu quan hệ như MySQL, PostgreSQL. |
Tệp JSON, cơ sở dữ liệu NoSQL, nhật ký CSV. |
Hình ảnh, video, tệp âm thanh, tài liệu văn bản. |
|
Mức độ dễ xử lý |
Dễ xử lý nhất do lược đồ chặt chẽ. |
Độ khó trung bình; cần phân tích cú pháp và chuyển đổi. |
Thách thức nhất do thiếu cấu trúc. |
|
Lưu trữ |
Cơ sở dữ liệu quan hệ hoặc kho dữ liệu. |
Hồ dữ liệu, cơ sở dữ liệu NoSQL, lưu trữ đám mây. |
Hồ dữ liệu hoặc lưu trữ chuyên dụng cho tệp thô. |
|
Cách thu nạp |
Thường thu nạp theo lô. |
Linh hoạt; có thể thu nạp theo thời gian thực hoặc theo lô. |
Chủ yếu thu nạp ở dạng thô để xử lý sau. |
|
Công cụ sử dụng |
Công cụ dựa trên SQL như MySQL, PostgreSQL. |
Công cụ xử lý lược đồ linh hoạt, như MongoDB, Google BigQuery. |
Công cụ nâng cao như Hadoop, Apache Spark, hoặc công cụ xử lý dựa trên AI/ML. |
|
Ví dụ trường hợp sử dụng |
Tạo báo cáo, hệ thống giao dịch. |
Phản hồi API, nhật ký ứng dụng web. |
Nhận dạng hình ảnh, phân tích giọng nói, phân tích cảm xúc. |
Thu nạp dữ liệu đi kèm nhiều thách thức mà bạn phải giải quyết để đảm bảo quản lý dữ liệu hiệu quả. Ở phần này, chúng ta sẽ thảo luận các thách thức đó và giải pháp có thể áp dụng để vượt qua.
Một trong những thách thức chính của thu nạp dữ liệu là khối lượng dữ liệu khổng lồ cần xử lý. Khi doanh nghiệp phát triển, lượng dữ liệu họ tạo ra và thu thập có thể tăng theo cấp số nhân, đặc biệt với sự gia tăng của các luồng dữ liệu thời gian thực từ thiết bị IoT và nền tảng mạng xã hội.
Mở rộng quy trình thu nạp dữ liệu để xử lý các khối lượng ngày càng lớn có thể khó khăn, nhất là với dữ liệu streaming cần thu nạp liên tục.
Các nhóm phải đảm bảo hạ tầng có thể hỗ trợ thu nạp dữ liệu theo lô và thời gian thực ở quy mô lớn mà không suy giảm. Khóa học Streaming Concepts là cách tuyệt vời để bắt đầu.
Chất lượng và tính nhất quán của dữ liệu là một thách thức đáng kể khác, đặc biệt khi dữ liệu được thu nạp từ nhiều nguồn khác biệt. Mỗi nguồn có thể có định dạng khác nhau, mức độ đầy đủ khác nhau, thậm chí thông tin xung đột.
Thu nạp dữ liệu mà không xử lý các điểm không nhất quán này có thể dẫn đến bộ dữ liệu không chính xác hoặc không đầy đủ, cuối cùng ảnh hưởng đến phân tích hạ nguồn.
Cần triển khai các kiểm tra xác thực dữ liệu trong quá trình thu nạp để đảm bảo chỉ dữ liệu chất lượng cao đi vào hệ thống. Ngoài ra, các nhóm cần duy trì tính nhất quán giữa nhiều nguồn để tránh sai lệch dữ liệu.
Tôi khuyên bạn đào sâu chủ đề này với khóa học Nhập môn Chất lượng Dữ liệu rất hay.
Khi thu nạp dữ liệu nhạy cảm, bảo mật và tuân thủ trở thành ưu tiên hàng đầu. Các nhóm xử lý thông tin cá nhân (ví dụ: tên khách hàng, địa chỉ, chi tiết thanh toán, v.v.) phải bảo vệ dữ liệu này trong suốt quá trình thu nạp.
Ví dụ, một công ty dịch vụ tài chính phải tuân thủ các quy định nghiêm ngặt như GDPR hoặc HIPAA khi thu nạp dữ liệu khách hàng để tránh hậu quả pháp lý. Không bảo mật dữ liệu trong quá trình thu nạp có thể dẫn đến rò rỉ, làm suy giảm niềm tin khách hàng và gây thiệt hại tài chính đáng kể.
Để giải quyết, các nhóm nên triển khai mã hóa và kiểm soát truy cập an toàn trong quá trình thu nạp. Điều này đảm bảo dữ liệu nhạy cảm được bảo vệ khỏi truy cập trái phép. Ngoài ra, dữ liệu phải được thu nạp theo cách tuân thủ tất cả các tiêu chuẩn quy định liên quan, với các cuộc đánh giá định kỳ để xác minh tuân thủ liên tục.
Khám phá cách giữ dữ liệu an toàn với khóa học tương tác dành cho người mới bắt đầu Data Security.
Trong các tình huống cần có thông tin ngay lập tức, việc chậm trễ trong thu nạp dữ liệu có thể dẫn đến thông tin lỗi thời hoặc không phù hợp. Thu nạp dữ liệu có độ trễ thấp đòi hỏi khả năng xử lý và đưa dữ liệu sẵn sàng phân tích gần như tức thì, điều này có thể là thách thức khi xử lý khối lượng dữ liệu lớn.
Các nhóm phải tối ưu hệ thống cẩn thận để giảm độ trễ và đảm bảo dữ liệu có sẵn khi cần.
Có một vài thực tiễn tốt nhất để đảm bảo thu nạp dữ liệu hiệu quả.
Dữ liệu được thu nạp sẽ được dùng cho phân tích, báo cáo và ra quyết định, do đó phải đáp ứng các tiêu chuẩn xác thực và đầy đủ đã định.
Triển khai các kiểm tra xác thực dữ liệu trong quá trình thu nạp có thể giúp xác minh dữ liệu tuân theo định dạng và tiêu chuẩn chất lượng mong đợi. Tôi đã viết về chủ đề này trước đây trong một hướng dẫn Great Expectations.
Ví dụ, nếu dữ liệu được kỳ vọng nằm trong một phạm vi nhất định hoặc đáp ứng tiêu chí cụ thể, hãy dùng quy tắc xác thực để tự động từ chối hoặc gắn cờ bất kỳ dữ liệu nào không đáp ứng các tiêu chuẩn này. Điều này giảm thiểu lỗi và đảm bảo chỉ dữ liệu đáng tin cậy được xử lý ở các bước sau.
Một thực tiễn tốt khác là đảm bảo bạn chọn cách thu nạp phù hợp với nhu cầu doanh nghiệp.
Thu nạp theo lô thường dùng cho dữ liệu ít nhạy thời gian, như báo cáo lịch sử hoặc định kỳ. Ngược lại, thu nạp thời gian thực dùng cho ứng dụng cần truy cập tức thì vào dữ liệu mới nhất, như phát hiện gian lận hoặc giám sát IoT.
Đánh giá nhu cầu dựa trên tần suất và mức độ khẩn cấp của cập nhật dữ liệu.
Khối lượng dữ liệu của bạn sẽ tăng theo thời gian. Vì vậy, quan trọng là chọn công cụ và hạ tầng có khả năng mở rộng để xử lý lượng dữ liệu tăng mà không làm giảm hiệu năng. Điều này cho phép bạn mở rộng đường ống dữ liệu và năng lực xử lý để đáp ứng tăng trưởng tương lai.
Cần ít không gian lưu trữ hơn đồng nghĩa giảm chi phí hạ tầng. Nén cũng tăng tốc truyền dữ liệu, tức là việc thu nạp sẽ nhanh hơn — đặc biệt khi xử lý tập dữ liệu lớn hoặc luồng dữ liệu có khối lượng cao. Thực tiễn này đặc biệt hữu ích khi xử lý dữ liệu bán cấu trúc hoặc phi cấu trúc, vì chúng thường có kích thước lớn.
Như bạn thấy, thu nạp dữ liệu là một khái niệm đơn giản nhưng có thể khá khó để tự triển khai. Những công cụ nào tốt nhất để hỗ trợ bạn thu nạp dữ liệu? Tôi đã tuyển chọn danh sách các công cụ được dùng phổ biến nhất.
Apache Kafka là một nền tảng streaming phân tán xuất sắc trong thu nạp dữ liệu thời gian thực.
Khóa học Introduction to Kafka có thể dạy bạn cách tạo, quản lý và xử lý sự cố Kafka cho các thách thức streaming dữ liệu trong thực tế.
Apache Nifi là một công cụ thu nạp dữ liệu nổi tiếng với giao diện trực quan thân thiện.
Amazon Kinesis là dịch vụ thuần đám mây từ AWS chuyên về thu nạp, xử lý và phân tích dữ liệu streaming. Nó được thiết kế cho các ứng dụng yêu cầu xử lý gần thời gian thực các luồng dữ liệu thông lượng cao, như:
Một lợi ích của Kinesis là khả năng tích hợp với các dịch vụ AWS khác cho lưu trữ, phân tích và máy học.
Công cụ này đặc biệt phù hợp cho các tổ chức tận dụng hạ tầng đám mây và muốn giải pháp được quản lý hoàn toàn để đáp ứng nhu cầu thu nạp dữ liệu mà không phải bận tâm đến phần cứng hay vấn đề mở rộng.
Google Cloud Dataflow là dịch vụ được quản lý hoàn toàn do Google Cloud cung cấp, hỗ trợ xử lý dữ liệu theo lô và thời gian thực.
Airbyte là nền tảng thu nạp dữ liệu mã nguồn mở đơn giản hóa tích hợp dữ liệu từ nhiều nguồn vào các giải pháp lưu trữ.
| Công cụ | Loại | Phù hợp nhất cho | Tính năng chính | Triển khai | Dễ sử dụng | Tùy biến | Tích hợp |
|---|---|---|---|---|---|---|---|
| Apache Kafka | Nền tảng Streaming | Thu nạp dữ liệu thời gian thực | Thông lượng cao, độ trễ thấp, có thể mở rộng | Đám mây & Tại chỗ | Trung bình | Cao | Hệ sinh thái hỗ trợ rộng |
| Apache Nifi | Quản lý luồng dữ liệu | Tự động hóa đường ống dữ liệu | Giao diện kéo-thả, xử lý thời gian thực | Đám mây & Tại chỗ | Cao | Cao | Nhiều giao thức, công cụ Big Data |
| Amazon Kinesis | Dịch vụ Streaming đám mây | Phân tích thời gian thực gốc AWS | Quản lý hoàn toàn, mở rộng, tích hợp AWS | Đám mây (AWS) | Cao | Trung bình | Tích hợp AWS sâu |
| Google Cloud Dataflow | Dịch vụ xử lý dữ liệu | ETL theo lô & streaming | Tự động mở rộng, dựa trên Apache Beam | Đám mây (GCP) | Cao | Trung bình | Tích hợp GCP mạnh |
| Airbyte | Nền tảng tích hợp dữ liệu | Connector dựng sẵn & tùy chỉnh | Mã nguồn mở, hỗ trợ thời gian thực & theo lô | Đám mây & Tại chỗ | Cao | Rất cao | Hàng trăm nguồn dữ liệu |
Trong bài viết này, chúng ta đã khám phá những điều cơ bản về thu nạp dữ liệu, các loại và các kỹ thuật giúp thực hiện nó. Bạn đã tìm hiểu về thu nạp theo lô và theo thời gian thực, cũng như các cách tiếp cận phổ biến như ETL, ELT và Change Data Capture (CDC). Chúng ta cũng đã đề cập thực tiễn tốt nhất, các nguồn dữ liệu khác nhau và những thách thức tổ chức gặp phải khi triển khai.
Để có thêm hiểu biết về quản lý dữ liệu và công cụ thu nạp, tôi khuyến nghị khám phá các tài nguyên sau:
Tìm hiểu thêm về kỹ thuật dữ liệu với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
