

Cursus
Introductie tot Data Engineering
4 uur
130.4K
Oefen en volg je voortgang.
Ga Verder Met GoogleEr zijn verschillende technieken die data-ingestie mogelijk maken. Elke techniek is ontworpen voor andere use-cases en verwerkingsbehoeften.
De techniek die je kiest, hangt af van 3 factoren:
In deze sectie behandel ik drie technieken voor data-ingestie en wanneer ze het meest effectief zijn.
ETL is een traditionele en veelgebruikte techniek voor data-ingestie. Bij deze aanpak wordt data geëxtraheerd uit verschillende bronsystemen, getransformeerd naar een consistent en schoon formaat en ten slotte geladen in een dataopslagsysteem, zoals een datawarehouse.
Deze methode is zeer effectief voor use-cases die consistente, gestructureerde data vereisen voor rapportage, analytics en besluitvorming.
Wanneer ETL gebruiken:
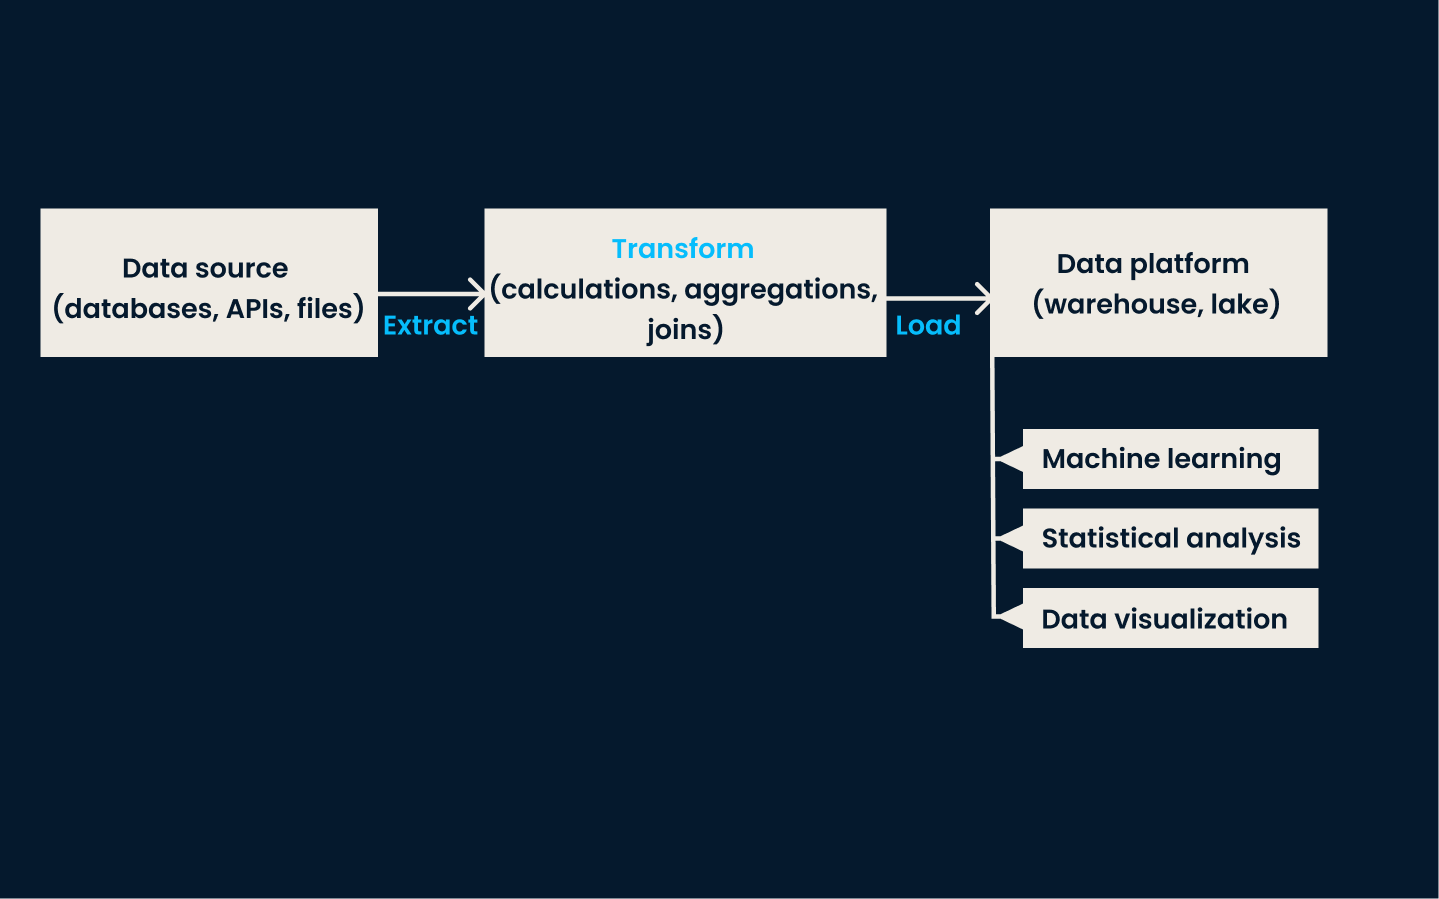
ETL-pijplijnarchitectuur.
ELT draait de volgorde van de stappen om ten opzichte van ETL. Bij deze aanpak wordt data geëxtraheerd uit bronsystemen en direct geladen in het doelsysteem (meestal een datalake of cloudplatform). Eenmaal in het doelsysteem wordt de data getransformeerd naar behoefte, vaak binnen de doellocatie zelf.
De ELT-aanpak is vooral effectief bij grote hoeveelheden ongestructureerde of semi-gestructureerde data, waarbij transformatie kan worden uitgesteld tot het moment dat analyse nodig is.
Wanneer ELT gebruiken:
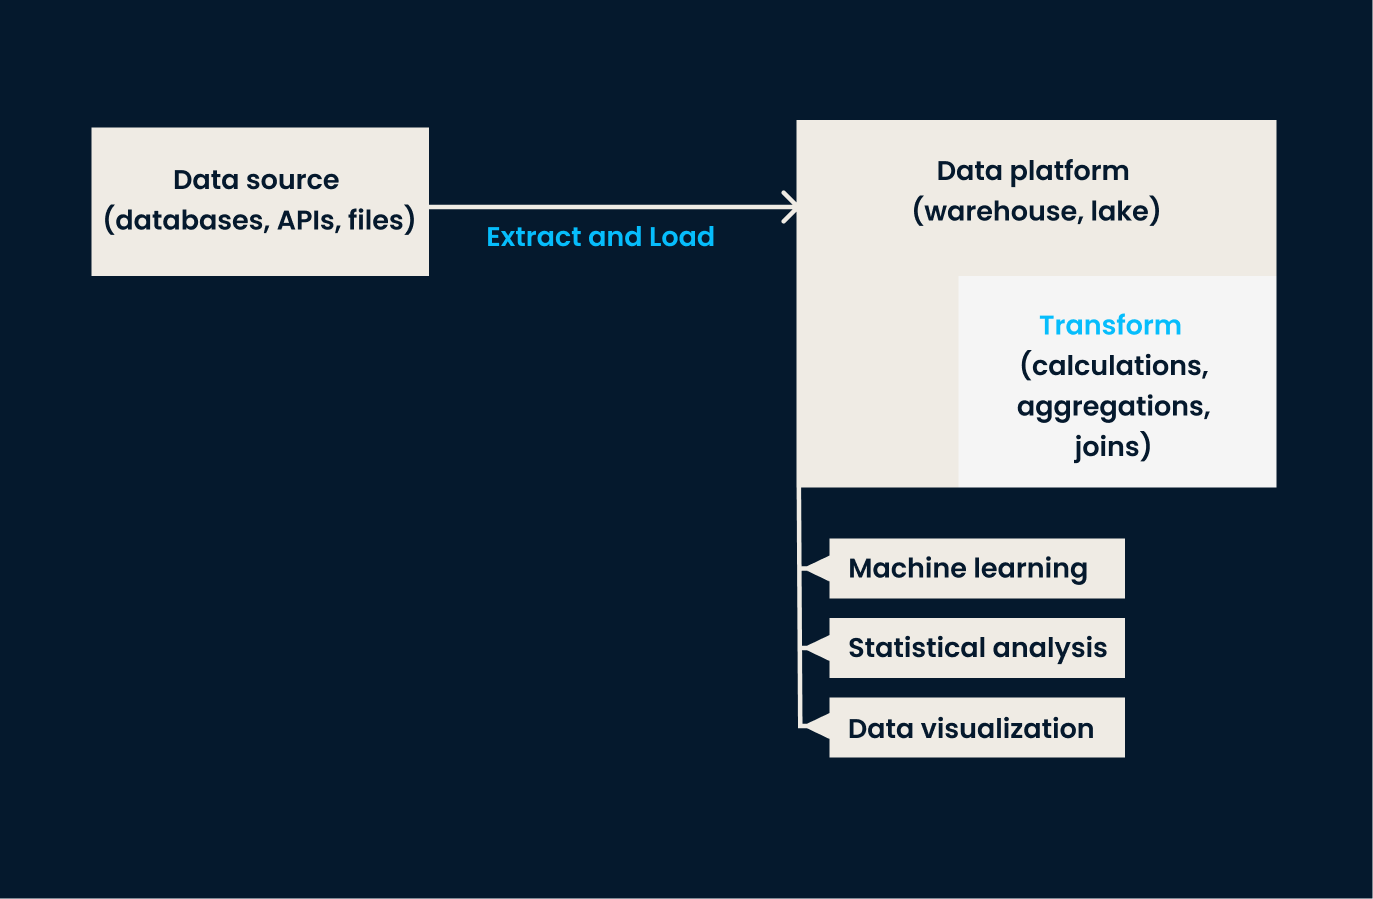
ELT-pijplijnarchitectuur.
CDC is een techniek om wijzigingen (bijv. inserts, updates, deletes) in bronsystemen te identificeren en vast te leggen en deze wijzigingen vervolgens in realtime te repliceren naar doelsystemen.
Deze techniek zorgt ervoor dat doelsystemen altijd up-to-date zijn zonder de volledige dataset opnieuw te laden. CDC is zeer effectief om realtime-synchronisatie tussen databases te behouden en consistentie tussen systemen te waarborgen.
Wanneer CDC gebruiken:
We hebben vastgesteld dat data-ingestie het ophalen van informatie uit verschillende bronnen inhoudt. Maar we hebben nog niet besproken wat die structuren zijn — en dat doen we in deze sectie.
De databronnen voor ingestie vallen doorgaans in 3 hoofdcategorieën:
Zoals je zult zien bij de verschillende bronnen, vereist elk type een andere manier van verwerken om effectief te kunnen worden gebruikt.
Gestructureerde data is sterk georganiseerd en volgt een vooraf gedefinieerd schema, waardoor het eenvoudiger te verwerken en te analyseren is. Het wordt doorgaans opgeslagen in relationele databases, die gerelateerde datapunten opslaan en toegankelijk maken. De data is ingedeeld in tabellen met duidelijk gedefinieerde rijen en kolommen.
Door dit georganiseerde karakter is gestructureerde data het gemakkelijkst te ingesteren.
Traditionele tools zoals MySQL en PostgreSQL worden doorgaans gebruikt om gestructureerde data te verwerken. Deze SQL-gebaseerde tools vereenvoudigen de validatie tijdens ingestie door strikte schemaregels af te dwingen. Wanneer data in deze systemen wordt ingeladen, zorgen ze automatisch dat deze voldoet aan de structuur die door de databasetabellen is gedefinieerd.
Als een kolom bijvoorbeeld alleen gehele waarden mag accepteren, zal MySQL of PostgreSQL alle data afwijzen die hier niet aan voldoet.
Andere aandachtspunten bij gestructureerde data:
Semi-gestructureerde data is tot op zekere hoogte georganiseerd, maar voldoet niet aan een star, vooraf gedefinieerd schema zoals gestructureerde data. In plaats daarvan gebruikt het tags of markeringen voor enige ordening, maar blijft de structuur flexibel.
Dit datatype wordt typisch aangetroffen in formaten zoals JSON-bestanden, CSV-bestanden en NoSQL-databases, en wordt veel gebruikt in webapplicaties, API’s en logsysteem
Omdat de structuur kan variëren, biedt semi-gestructureerde data flexibiliteit in opslag en verwerking, waardoor het geschikt is voor systemen die veranderende of inconsistente dataformaten verwerken.
Voor het verwerken van semi-gestructureerde data zijn tools nodig die betekenisvolle informatie uit de ingebedde tags of markeringen kunnen parsen en extraheren. Een JSON-bestand kan bijvoorbeeld een verzameling sleutel-waardeparen bevatten, en het ingestieproces houdt dan in dat je deze paren parseert en transformeert naar een geschikt formaat.
Semi-gestructureerde data wordt vaak ingeladen in flexibele omgevingen zoals datalakes of cloudplatforms, waar het in ruwe vorm kan worden opgeslagen en later naar behoefte kan worden verwerkt.
Overige aandachtspunten bij semi-gestructureerde data:
Ongestructureerde data is het meest complex om te beheren omdat het geen specifiek formaat of organisatorische structuur heeft. Deze categorie omvat data zoals:
In tegenstelling tot gestructureerde of semi-gestructureerde data heeft ongestructureerde data geen duidelijke rijen, kolommen of tags om de inhoud te definiëren, wat verwerking en analyse uitdagender maakt.
Ondanks de complexiteit kan ongestructureerde data waardevolle inzichten bevatten, vooral wanneer deze wordt geanalyseerd met geavanceerde technologieën zoals machine learning of natural language processing.
Omdat ongestructureerde data niet op een vooraf gedefinieerde manier is georganiseerd, zijn gespecialiseerde tools nodig voor het ingestieproces. Deze tools kunnen relevante informatie uit ruwe, ongestructureerde bronnen extraheren en transformeren naar formaten die geanalyseerd kunnen worden.
Tot slot wordt ongestructureerde data doorgaans opgeslagen in datalakes, waar het naar behoefte kan worden verwerkt.
|
Kenmerk |
Gestructureerde data |
Semi-gestructureerde data |
Ongestructureerde data |
|
Definitie |
Sterk georganiseerde data met een vooraf gedefinieerd schema (bijv. rijen en kolommen). |
Gedeeltelijk georganiseerde data met tags of markeringen voor flexibiliteit (bijv. JSON, CSV). |
Data zonder vooraf gedefinieerde structuur of organisatie (bijv. afbeeldingen, video’s). |
|
Voorbeelden |
Relationele databases zoals MySQL, PostgreSQL. |
JSON-bestanden, NoSQL-databases, CSV-logs. |
Afbeeldingen, video’s, audiobestanden, tekstdocumenten. |
|
Verwerkingsgemak |
Het gemakkelijkst te verwerken dankzij het strikte schema. |
Gemiddelde moeilijkheid; vereist parsing en transformatie. |
Het meest uitdagend door het ontbreken van structuur. |
|
Opslag |
Relationele databases of datawarehouses. |
Datalakes, NoSQL-databases, cloudopslag. |
Datalakes of gespecialiseerde opslag voor ruwe bestanden. |
|
Ingestieaanpak |
Wordt meestal in batches ingeladen. |
Flexibel; kan realtime of in batches worden ingeladen. |
Voornamelijk in ruwe vorm ingeladen voor latere verwerking. |
|
Gebruikte tools |
SQL-gebaseerde tools zoals MySQL, PostgreSQL. |
Tools die flexibele schema’s aankunnen, zoals MongoDB, Google BigQuery. |
Geavanceerde tools zoals Hadoop, Apache Spark, of AI/ML-gebaseerde verwerkingstools. |
|
Voorbeelden van use-cases |
Rapportages genereren, transactionele systemen. |
API-responses, logbestanden van webapplicaties. |
Beeldherkenning, spraakanalyse, sentimentanalyse. |
Data-ingestie kent diverse uitdagingen die je moet aanpakken om efficiënt en effectief databeheer te waarborgen. In deze sectie bespreken we wat deze uitdagingen zijn en welke oplossingen je kunt inzetten om ze te overwinnen.
Een van de grootste uitdagingen bij data-ingestie is de enorme hoeveelheid data die moet worden verwerkt. Naarmate bedrijven groeien, kan de hoeveelheid data die ze genereren en verzamelen exponentieel toenemen, vooral met de opkomst van realtime datastromen van bronnen zoals IoT-apparaten en socialmediaplatforms.
Het opschalen van data-ingestie om deze groeiende volumes aan te kunnen, kan lastig zijn, vooral bij streamingdata die continu moet worden ingeladen.
Teams moeten ervoor zorgen dat hun infrastructuur batch- en realtime-ingestie op schaal aankan zonder kwaliteitsverlies. De cursus Streaming Concepts is een goede start.
Datakwaliteit en consistentie zijn een andere grote uitdaging, vooral wanneer data uit meerdere, uiteenlopende bronnen wordt ingeladen. Elke bron kan andere formaten, verschillende volledigheidsgraden of zelfs conflicterende informatie hebben.
Data inladen zonder deze inconsistenties aan te pakken, kan leiden tot onnauwkeurige of onvolledige datasets, wat uiteindelijk de downstream-analytics beïnvloedt.
Tijdens ingestie moeten validatiecontroles worden geïmplementeerd om te waarborgen dat alleen data van hoge kwaliteit het systeem binnenkomt. Daarnaast moeten teams consistentie tussen verschillende bronnen behouden om dataverschillen te voorkomen.
Ik raad aan om dieper op dit onderwerp in te gaan met de uitstekende cursus Inleiding tot Datakwaliteit.
Wanneer gevoelige data wordt ingeladen, staan beveiliging en compliance bovenaan. Teams die persoonlijke informatie verwerken (bijv. namen van klanten, adressen, betaalgegevens, enz.) moeten deze data gedurende het hele ingestieproces beschermen.
Zo moet een financiële dienstverlener bij het inladen van klantdata voldoen aan strikte regelgeving zoals de AVG of HIPAA om juridische gevolgen te voorkomen. Als data tijdens ingestie niet goed is beveiligd, kan dat leiden tot datalekken, verlies van vertrouwen bij klanten en flinke financiële sancties.
Om dit aan te pakken, moeten teams tijdens het ingestieproces versleuteling en veilige toegangscontroles implementeren. Zo wordt gevoelige data beschermd tegen ongeautoriseerde toegang. Daarnaast moet data worden ingeladen op een manier die voldoet aan alle relevante regelgeving, met regelmatige audits om voortdurende naleving te verifiëren.
Ontdek hoe je data veilig houdt met de laagdrempelige interactieve cursus Data Security.
In situaties waarin directe inzichten nodig zijn, kunnen vertragingen bij data-ingestie resulteren in verouderde of irrelevante informatie. Ingestie met lage latency vereist dat data vrijwel onmiddellijk kan worden verwerkt en beschikbaar is voor analyse, wat een uitdaging kan zijn bij grote datavolumes.
Teams moeten hun systemen zorgvuldig optimaliseren om de latency te verlagen en te zorgen dat data beschikbaar is wanneer dat nodig is.
Er zijn enkele best practices om te zorgen voor efficiënte en effectieve data-ingestie.
Ingeladen data wordt gebruikt voor analytics, rapportage en besluitvorming, dus deze moet voldoen aan vooraf gedefinieerde normen voor nauwkeurigheid en volledigheid.
Het implementeren van datavalidatie tijdens ingestie helpt te verifiëren dat data aan de verwachte formaten en kwaliteitsnormen voldoet. Ik heb hier eerder over geschreven in een Great Expectations-tutorial.
Als data bijvoorbeeld binnen een bepaald bereik moet vallen of aan specifieke criteria moet voldoen, gebruik dan validatieregels om automatisch alle data die niet aan deze standaarden voldoet af te wijzen of te markeren. Dit minimaliseert fouten en zorgt ervoor dat downstream alleen betrouwbare data wordt verwerkt.
Een andere best practice is dat je de juiste ingestieaanpak kiest voor de behoeften van je bedrijf.
Batch-ingestie wordt doorgaans gebruikt voor minder tijdkritische data, zoals historische of periodieke rapporten. Realtime-ingestie daarentegen wordt gebruikt voor applicaties die direct toegang tot de nieuwste data vereisen, zoals fraudedetectie of IoT-monitoring.
Beoordeel je behoeften op basis van de frequentie en urgentie van data-updates.
Je datavolume zal in de loop van de tijd groeien. Daarom is het belangrijk om schaalbare tools en infrastructuur te kiezen die grotere hoeveelheden data aankunnen zonder prestatieverlies. Zo kun je je datapijplijnen en verwerkingscapaciteit uitbreiden om toekomstige groei op te vangen.
Minder opslagruimte betekent lagere infrastructuurkosten. Compressie versnelt ook de datatransfer, wat zorgt voor snellere ingestie — vooral bij grote datasets of stromen met hoog volume. Deze praktijk is vooral nuttig bij semi-gestructureerde of ongestructureerde data, die vaak groot van omvang zijn.
Zoals je ziet is data-ingestie een eenvoudig concept, maar het kan best lastig zijn om zelf te implementeren. Wat zijn de beste tools die je helpen bij data-ingestie? Ik heb de meest gebruikte op een rij gezet.
Apache Kafka is een gedistribueerd streamingplatform dat uitblinkt in realtime data-ingestie.
De cursus Introduction to Kafka leert je hoe je Kafka kunt opzetten, beheren en troubleshooten voor streaminguitdagingen in de echte wereld.
Apache Nifi is een tool voor data-ingestie die bekendstaat om zijn gebruiksvriendelijke visuele interface.
Amazon Kinesis is een cloud-native service van AWS die gespecialiseerd is in het inladen, verwerken en analyseren van streamingdata. Het is ontworpen voor applicaties die bijna realtime verwerking van datastromen met hoge doorvoer vereisen, zoals:
Een van de voordelen van Kinesis is de mogelijkheid om te integreren met andere AWS-services voor opslag, analytics en machine learning.
Deze tool is bijzonder geschikt voor organisaties die gebruikmaken van cloudinfrastructuur en een volledig beheerde oplossing zoeken om hun ingestiebehoeften af te handelen zonder zich zorgen te maken over hardware of schaalbaarheid.
Google Cloud Dataflow is een volledig beheerde service van Google Cloud die zowel batch- als realtime-dataverwerking ondersteunt.
Airbyte is een open-source platform voor data-ingestie dat het integreren van data uit diverse bronnen naar opslagoplossingen vereenvoudigt.
| Tool | Type | Beste voor | Belangrijkste functies | Implementatie | Gebruiksgemak | Aanpasbaarheid | Integratie |
|---|---|---|---|---|---|---|---|
| Apache Kafka | Streamingplatform | Realtime data-ingestie | Hoge doorvoer, lage latency, schaalbaar | Cloud & on-prem | Gemiddeld | Hoog | Breed ecosysteem |
| Apache Nifi | Datastroombeheer | Geautomatiseerde datapijplijnen | Drag-and-drop-UI, realtime verwerking | Cloud & on-prem | Hoog | Hoog | Meerdere protocollen, big-datatools |
| Amazon Kinesis | Cloudstreamingservice | AWS-native realtime analytics | Volledig beheerd, schaalbaar, AWS-geïntegreerd | Cloud (AWS) | Hoog | Gemiddeld | Diepe AWS-integratie |
| Google Cloud Dataflow | Dataverwerkingsservice | Batch & streaming ETL | Auto-scaling, gebaseerd op Apache Beam | Cloud (GCP) | Hoog | Gemiddeld | Sterke GCP-integratie |
| Airbyte | Dataintegratieplatform | Kant-en-klare & custom connectors | Open-source, ondersteuning voor realtime & batch | Cloud & on-prem | Hoog | Zeer hoog | Honderden databronnen |
In dit artikel hebben we de basis van data-ingestie, de typen en de technieken besproken die dit mogelijk maken. Je hebt geleerd over batch- en realtime-ingestie en populaire aanpakken zoals ETL, ELT en Change Data Capture (CDC). We hebben ook best practices, de verschillende databronnen en de uitdagingen behandeld waar organisaties mee te maken krijgen tijdens het uitvoeren.
Voor meer inzichten in databeheer en ingestietools raad ik de volgende resources aan:
Leer meer over data engineering met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

