
डेटा इन्जेशन तकनीकें
कई तकनीकें डेटा इन्जेशन को सुगम बनाती हैं। हर एक अलग उपयोग-परिदृश्यों और डेटा प्रोसेसिंग जरूरतों को संबोधित करने के लिए बनाई गई है.
आपकी तकनीक की पसंद 3 कारकों पर निर्भर करती है:
- व्यवसाय की विशिष्ट आवश्यकताएँ।
- डेटा की जटिलता।
- उपलब्ध अधोसंरचना।
इस खंड में, मैं तीन डेटा इन्जेशन तकनीकों और उनके सबसे प्रभावी उपयोग के समय पर बात करूँगा।
ETL (Extract, Transform, Load)
ETL एक पारंपरिक और व्यापक रूप से उपयोग की जाने वाली डेटा इन्जेशन तकनीक है। इस दृष्टिकोण में, डेटा निकाला जाता है विभिन्न स्रोत सिस्टमों से, परिवर्तित किया जाता है एक सुसंगत और स्वच्छ फ़ॉर्मेट में, और अंत में लोड किया जाता है किसी डेटा स्टोरेज सिस्टम में, जैसे डेटा वेयरहाउस.
यह तरीका उन उपयोग-परिदृश्यों में अत्यंत प्रभावी है जहाँ रिपोर्टिंग, एनालिटिक्स और निर्णय-निर्माण के लिए सुसंगत, संरचित डेटा की आवश्यकता होती है।
ETL कब उपयोग करें:
- जब डेटा को स्टोरेज सिस्टम में लोड करने से पहले प्री-प्रोसेस (क्लीन या ट्रांसफॉर्म) करने की आवश्यकता हो।
- वे परिस्थितियाँ जहाँ संरचित डेटा प्राथमिकता हो, जैसे व्यावसायिक रिपोर्ट बनाना या सख्त डेटा गुणवत्ता आवश्यकताओं का पालन करना।
- जब रिलेशनल डेटाबेस या छोटे पैमाने के डेटा वातावरण से निपटना हो जो स्वच्छ, विश्लेषण-तैयार डेटा को प्राथमिकता देते हैं।
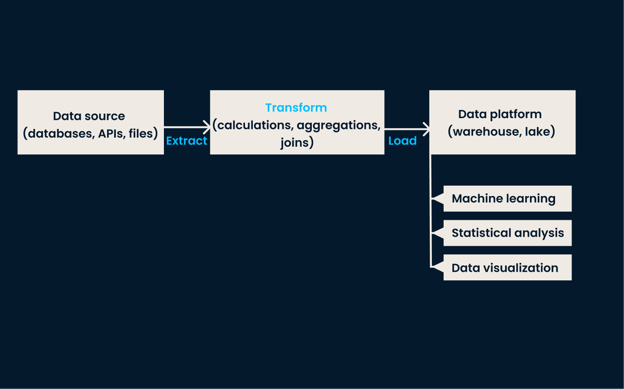
ETL पाइपलाइन आर्किटेक्चर।
ELT (Extract, Load, Transform)
ELT, ETL की तुलना में कार्यों के क्रम को उलट देता है। इस दृष्टिकोण में, डेटा निकाला जाता है स्रोत सिस्टमों से और सीधे लोड किया जाता है लक्ष्य सिस्टम में (आम तौर पर डेटा लेक या क्लाउड-आधारित प्लेटफ़ॉर्म)। एक बार लक्ष्य स्टोरेज सिस्टम में आने के बाद, डेटा को आवश्यकतानुसार ट्रांसफॉर्म किया जाता है, अक्सर डेस्टिनेशन वातावरण के भीतर.
ELT दृष्टिकोण विशेष रूप से तब प्रभावी होता है जब बड़े पैमाने पर अनस्ट्रक्चर्ड या सेमी-स्ट्रक्चर्ड डेटा से निपटना हो, जहाँ ट्रांसफॉर्मेशन को विश्लेषण की आवश्यकता तक टाला जा सकता है।
ELT कब उपयोग करें:
- जब डेटा लेक्स या क्लाउड स्टोरेज के साथ काम कर रहे हों, जो बड़े पैमाने पर रॉ डेटा संभाल सकते हैं।
- जब विविध, अनस्ट्रक्चर्ड या सेमी-स्ट्रक्चर्ड डेटा से निपटना हो, जिसे तुरंत ट्रांसफॉर्म करने की आवश्यकता नहीं हो सकती।
- जब लचीलापन आवश्यक हो, क्योंकि ELT स्टोरेज वातावरण के भीतर ऑन-डिमांड डेटा ट्रांसफॉर्मेशन की अनुमति देता है।
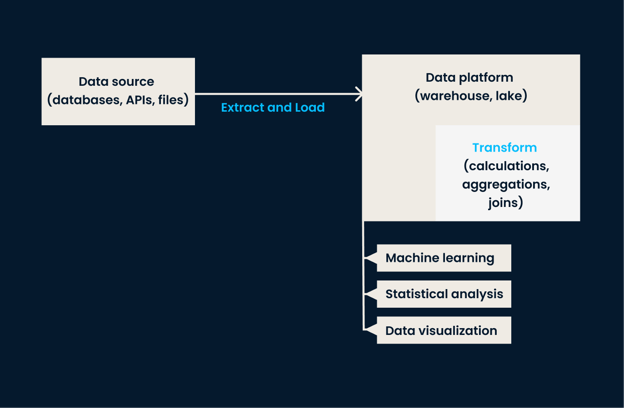
ELT पाइपलाइन आर्किटेक्चर।
चेंज डेटा कैप्चर (CDC)
CDC एक तकनीक है जो स्रोत सिस्टमों में डेटा में किए गए परिवर्तनों (जैसे, इन्सर्ट, अपडेट, डिलीट) की पहचान और कैप्चर करती है और फिर उन परिवर्तनों को रियल-टाइम में डेस्टिनेशन सिस्टमों में प्रतिलिपि करती है.
यह तकनीक यह सुनिश्चित करती है कि टार्गेट सिस्टम हमेशा अप-टू-डेट रहें, बिना पूरे डेटासेट को फिर से लोड किए। CDC डेटाबेसों के बीच रियल-टाइम सिंक्रोनाइज़ेशन बनाए रखने और सिस्टमों में स्थिरता सुनिश्चित करने के लिए अत्यंत प्रभावी है।
CDC कब उपयोग करें:
- जब रियल-टाइम डेटा सिंक्रोनाइज़ेशन महत्वपूर्ण हो, जैसे हाई-फ्रीक्वेंसी ट्रेडिंग, ई-कॉमर्स ट्रांज़ैक्शन, या ऑपरेशनल रिपोर्टिंग में।
- जब आपको न्यूनतम लैग या डेटा रीफ़्रेश समय के साथ डेस्टिनेशन सिस्टमों को अपडेट रखना हो।
- जब पूरे डेटासेट को फिर से इनजेस्ट करने के ओवरहेड से बचना आवश्यक हो।
इन्जेशन के लिए डेटा स्रोत
हमने स्थापित किया है कि डेटा इन्जेशन में विभिन्न स्रोतों से जानकारी खींचना शामिल है। लेकिन हमने यह नहीं चर्चा की कि वे संरचनाएँ क्या हैं — और यही हम इस खंड में करेंगे.
इन्जेशन के लिए डेटा स्रोत आमतौर पर 3 मुख्य प्रकारों में आते हैं:
- स्ट्रक्चर्ड
- सेमी-स्ट्रक्चर्ड
- अनस्ट्रक्चर्ड डेटा
जैसा कि आप विभिन्न स्रोतों की जाँच करते समय जानेंगे, प्रत्येक का प्रभावी उपयोग करने के लिए अलग हैंडलिंग और प्रोसेसिंग तकनीकों की आवश्यकता होती है.
स्ट्रक्चर्ड डेटा स्रोत
स्ट्रक्चर्ड डेटा अत्यधिक संगठित होता है और पूर्वनिर्धारित स्कीमा का पालन करता है, जिससे इसे प्रोसेस और विश्लेषण करना आसान हो जाता है। इसे आमतौर पर रिलेशनल डेटाबेस में संग्रहित किया जाता है, जो संबंधित डेटा बिंदुओं को संग्रहीत करते और उन तक पहुँच प्रदान करते हैं। डेटा को स्पष्ट रूप से परिभाषित रो और कॉलम वाली टेबल्स में व्यवस्थित किया जाता है.
इस संगठित प्रकृति के कारण, स्ट्रक्चर्ड डेटा को इनजेस्ट करना सबसे सरल है.
पारंपरिक टूल्स जैसे MySQL और PostgreSQL आमतौर पर स्ट्रक्चर्ड डेटा को संभालने के लिए उपयोग किए जाते हैं। ये SQL-आधारित टूल्स इन्जेशन के दौरान सख्त स्कीमा नियम लागू करके वैलिडेशन प्रक्रिया को सरल बनाते हैं। जब डेटा इन सिस्टमों में इनजेस्ट किया जाता है, तो ये स्वयंचालित रूप से सुनिश्चित करते हैं कि वह डेटाबेस टेबल्स द्वारा परिभाषित संरचना का पालन करे.
उदाहरण के लिए, यदि किसी कॉलम को केवल पूर्णांक मान स्वीकार करने के लिए सेट किया गया है, तो MySQL या PostgreSQL कोई भी डेटा जो इस आवश्यकता को पूरा नहीं करता, उसे अस्वीकार कर देगा।
स्ट्रक्चर्ड डेटा के बारे में अन्य बातें ध्यान देने योग्य हैं:
- यह आमतौर पर बड़े पैमाने पर (और एक अनुमानित फ़ॉर्मेट में) एकत्र किया जाता है।
- इसे अक्सर बैच प्रक्रियाओं के माध्यम से इनजेस्ट किया जाता है, जो आवश्यकता के अनुसार डेटा को रीफ़्रेश करने के लिए आवधिक अपडेट सक्षम करती हैं।
सेमी-स्ट्रक्चर्ड डेटा स्रोत
सेमी-स्ट्रक्चर्ड डेटा, जबकि किसी हद तक संगठित होता है, स्ट्रक्चर्ड डेटा की तरह कठोर, पूर्वनिर्धारित स्कीमा का पालन नहीं करता। इसके बजाय, यह कुछ संगठन प्रदान करने के लिए टैग्स या मार्कर्स का उपयोग करता है, लेकिन संरचना लचीली रहती है.
यह डेटा प्रकार टाइपिकाlly जैसे फ़ॉर्मेट्स में पाया जाता है JSON फाइलें, CSV फाइलें, और NoSQL डेटाबेस, और यह वेब अनुप्रयोगों, APIs, और लॉग सिस्टमों में आमतौर पर उपयोग होता है.
चूँकि संरचना में भिन्नता हो सकती है, सेमी-स्ट्रकचर्ड डेटा स्टोरेज और प्रोसेसिंग में लचीलापन प्रदान करता है, जिससे यह उन सिस्टमों के लिए उपयुक्त बनता है जो बदलते या असंगत डेटा फ़ॉर्मेट्स को संभालते हैं।
सेमी-स्ट्रक्चर्ड डेटा को संभालने के लिए ऐसे टूल्स की आवश्यकता होती है जो एम्बेडेड टैग्स या मार्कर्स से सार्थक जानकारी पार्स और एक्सट्रैक्ट कर सकें। उदाहरण के लिए, एक JSON फ़ाइल में की-वैल्यू पेयर्स का संग्रह हो सकता है, और इन्जेशन प्रक्रिया में इन पेयर्स को पार्स करके उन्हें उपयुक्त फ़ॉर्मेट में ट्रांसफॉर्म करना शामिल होगा.
सेमी-स्ट्रक्चर्ड डेटा को अक्सर डेटा लेक्स या क्लाउड प्लेटफ़ॉर्म जैसे लचीले वातावरण में इनजेस्ट किया जाता है, जहाँ इसे रॉ रूप में संग्रहित किया जा सकता है और आवश्यकता के अनुसार बाद में प्रोसेस किया जा सकता है।
सेमी-स्ट्रक्चर्ड डेटा के बारे में अन्य बातें:
- उपयोग-परिदृश्य पर निर्भर करते हुए, इसे रियल-टाइम में या निर्धारित बैचों के माध्यम से इनजेस्ट किया जा सकता है।
- उसे प्रभावी रूप से प्रोसेस या विश्लेषित करने के लिए इन्जेशन के दौरान ट्रांसफॉर्मेशन की आवश्यकता होती है।
अनस्ट्रक्चर्ड डेटा स्रोत
अनस्ट्रक्चर्ड डेटा प्रबंधन के लिए सबसे जटिल प्रकार है क्योंकि इसमें किसी विशिष्ट फ़ॉर्मेट या संगठनात्मक संरचना का अभाव होता है। इस श्रेणी में निम्न डेटा शामिल है:
- इमेजेस
- वीडियो
- ऑडियो
- दस्तावेज़
स्ट्रक्चर्ड या सेमी-स्ट्रक्चर्ड डेटा के विपरीत, अनस्ट्रक्चर्ड डेटा में उसकी सामग्री को परिभाषित करने के लिए स्पष्ट रो, कॉलम, या टैग्स नहीं होते, जिससे उसे प्रोसेस और विश्लेषित करना अधिक चुनौतीपूर्ण हो जाता है।
उसकी जटिलता के बावजूद, अनस्ट्रक्चर्ड डेटा में मूल्यवान इनसाइट्स हो सकती हैं, विशेष रूप से तब जब उसका विश्लेषण मशीन लर्निंग या नेचुरल लैंग्वेज प्रोसेसिंग जैसी उन्नत तकनीकों का उपयोग करके किया जाए।
क्योंकि अनस्ट्रक्चर्ड डेटा पूर्व-
परिभाषित तरीके से संगठित नहीं होता, इन्जेशन प्रक्रिया को संभालने के लिए विशेष टूल्स की आवश्यकता होती है। ये टूल्स कच्चे, अनस्ट्रक्चर्ड स्रोतों से प्रासंगिक जानकारी एक्सट्रैक्ट कर सकते हैं और उसे ऐसे फ़ॉर्मेट्स में ट्रांसफॉर्म कर सकते हैं जिन्हें विश्लेषित किया जा सके.
अंत में, अनस्ट्रक्चर्ड डेटा आमतौर पर डेटा लेक्स में संग्रहित किया जाता है, जहाँ आवश्यकता पड़ने पर उसे प्रोसेस किया जा सकता है।
तुलनात्मक तालिका: स्ट्रक्चर्ड बनाम सेमी-स्ट्रक्चर्ड बनाम अनस्ट्रक्चर्ड डेटा
|
फ़ीचर |
स्ट्रक्चर्ड डेटा |
सेमी-स्ट्रक्चर्ड डेटा |
अनस्ट्रक्चर्ड डेटा |
|
परिभाषा |
पूर्वनिर्धारित स्कीमा (जैसे, रो और कॉलम) के साथ अत्यधिक संगठित डेटा। |
लचीलापन देने के लिए टैग्स या मार्कर्स के साथ आंशिक रूप से संगठित डेटा (जैसे, JSON, CSV)। |
कोई पूर्वनिर्धारित संरचना या संगठन के बिना डेटा (जैसे, इमेजेस, वीडियो)। |
|
उदाहरण |
MySQL, PostgreSQL जैसे रिलेशनल डेटाबेस। |
JSON फाइलें, NoSQL डेटाबेस, CSV लॉग्स। |
इमेजेस, वीडियो, ऑडियो फाइलें, टेक्स्ट दस्तावेज़। |
|
प्रोसेसिंग में सहजता |
इसके सख्त स्कीमा के कारण प्रोसेस करना सबसे आसान। |
मध्यम कठिनाई; पार्सिंग और ट्रांसफॉर्मेशन की आवश्यकता। |
संरचना की कमी के कारण सबसे चुनौतीपूर्ण। |
|
स्टोरेज |
रिलेशनल डेटाबेस या डेटा वेयरहाउस। |
डेटा लेक्स, NoSQL डेटाबेस, क्लाउड स्टोरेज। |
डेटा लेक्स या रॉ फाइलों के लिए विशेष स्टोरेज। |
|
इन्जेशन दृष्टिकोण |
आम तौर पर बैचों में इनजेस्ट किया जाता है। |
लचीला; रियल-टाइम या बैच—दोनों में इनजेस्ट हो सकता है। |
मुख्यतः बाद में प्रोसेसिंग के लिए रॉ फ़ॉर्मेट में इनजेस्ट किया जाता है। |
|
उपयोग किए जाने वाले टूल्स |
MySQL, PostgreSQL जैसे SQL-आधारित टूल्स। |
लचीले स्कीमा संभालने वाले टूल्स, जैसे MongoDB, Google BigQuery। |
Hadoop, Apache Spark, या AI/ML-आधारित प्रोसेसिंग टूल्स जैसे उन्नत टूल्स। |
|
उपयोग-परिदृश्य उदाहरण |
रिपोर्ट बनाना, ट्रांज़ैक्शनल सिस्टम्स। |
API प्रतिक्रियाएँ, वेब एप्लिकेशन लॉग्स। |
इमेज रिकग्निशन, स्पीच एनालिसिस, सेंटिमेंट एनालिसिस। |
डेटा इन्जेशन में चुनौतियाँ
डेटा इन्जेशन कई चुनौतियों के साथ आता है जिन्हें कुशल और प्रभावी डेटा प्रबंधन सुनिश्चित करने के लिए संबोधित करना आवश्यक है। इस खंड में, हम इन चुनौतियों पर चर्चा करेंगे और उन्हें दूर करने के लिए अपनाए जा सकने वाले समाधानों पर बात करेंगे.
बड़े पैमाने के डेटा को संभालना
डेटा इन्जेशन की प्राथमिक चुनौतियों में से एक प्रोसेस किए जाने वाले डेटा की भारी मात्रा है। जैसे-जैसे व्यवसाय बढ़ते हैं, वे जो डेटा उत्पन्न और एकत्र करते हैं उसकी मात्रा गुणात्मक रूप से बढ़ सकती है, विशेष रूप से IoT डिवाइसेज़ और सोशल मीडिया प्लेटफ़ॉर्म जैसे स्रोतों से रियल-टाइम डेटा स्ट्रीम्स के बढ़ने के साथ.
इन बढ़ती मात्राओं को संभालने के लिए डेटा इन्जेशन प्रक्रियाओं का स्केल करना कठिन हो सकता है, खासकर स्ट्रीमिंग डेटा के साथ जिसे लगातार इन्जेशन की आवश्यकता होती है.
टीमों को सुनिश्चित करना होगा कि उनकी अधोसंरचना बैच और रियल-टाइम डेटा इन्जेशन को स्केल पर बिना गिरावट के सपोर्ट कर सके। Streaming Concepts कोर्स शुरुआत करने का एक बेहतरीन तरीका है.
डेटा गुणवत्ता और स्थिरता
डेटा गुणवत्ता और स्थिरता एक और बड़ी चुनौती है, खासकर जब डेटा कई असमान स्रोतों से इनजेस्ट किया जाता है। प्रत्येक स्रोत के फ़ॉर्मेट, पूर्णता के स्तर, या यहाँ तक कि परस्पर विरोधी जानकारी भी अलग हो सकती है।
इन असंगतियों को संबोधित किए बिना डेटा इनजेस्ट करना गलत या अधूरे डेटासेट्स का कारण बन सकता है, जो अंततः डाउनस्ट्रीम एनालिटिक्स को प्रभावित करेगा.
यह सुनिश्चित करने के लिए कि केवल उच्च-गुणवत्ता वाला डेटा सिस्टम में प्रवेश करे, इन्जेशन के दौरान डेटा वैलिडेशन जाँचें लागू की जानी चाहिए। इसके अलावा, टीमों को डेटा विसंगतियों से बचने के लिए विभिन्न स्रोतों के बीच स्थिरता बनाए रखने की आवश्यकता है।
मैंने इस विषय पर गहराई से अध्ययन करने की सिफारिश की है बेहतरीन Introduction to Data Quality कोर्स के साथ.
सुरक्षा और अनुपालन
जब संवेदनशील डेटा इनजेस्ट किया जाता है, तो सुरक्षा और अनुपालन सर्वोच्च प्राथमिकताएँ बन जाती हैं। जो टीमें व्यक्तिगत जानकारी (जैसे, ग्राहक नाम, पते, भुगतान विवरण, आदि) को संभालती हैं, उन्हें इन्जेशन प्रक्रिया के दौरान इस डेटा की सुरक्षा करनी चाहिए.
उदाहरण के लिए, एक वित्तीय सेवा कंपनी को क्लाइंट डेटा इनजेस्ट करते समय GDPR या HIPAA जैसे सख्त विनियमों का पालन करना चाहिए ताकि कानूनी परिणामों से बचा जा सके। इन्जेशन के दौरान डेटा को सुरक्षित करने में विफल रहने से डेटा उल्लंघनों का जोखिम हो सकता है, जिससे ग्राहक विश्वास प्रभावित होगा और भारी आर्थिक दंड लग सकते हैं.
इसे संबोधित करने के लिए, टीमों को इन्जेशन प्रक्रिया के दौरान एन्क्रिप्शन और सुरक्षित एक्सेस कंट्रोल्स लागू करने चाहिए। इससे यह सुनिश्चित होता है कि संवेदनशील डेटा अनधिकृत पहुँच से सुरक्षित है। इसके अलावा, डेटा को इस तरह से इनजेस्ट किया जाना चाहिए जो सभी प्रासंगिक नियामक मानकों का पालन करता हो, और चल रहे अनुपालन को सत्यापित करने के लिए नियमित ऑडिट किए जाएँ।
डेटा को सुरक्षित रखने और संरक्षित करने के तरीके जानें शुरुआती-अनुकूल Data Security इंटरैक्टिव कोर्स के साथ।
लेटेन्सी आवश्यकताएँ
ऐसी परिस्थितियों में जहाँ तत्काल इनसाइट्स आवश्यक हों, डेटा इन्जेशन में देरी के परिणामस्वरूप पुरानी या अप्रासंगिक जानकारी मिल सकती है। लो-लेटेन्सी डेटा इन्जेशन के लिए डेटा को लगभग तुरन्त प्रोसेस करने और विश्लेषण के लिए उपलब्ध कराने की क्षमता आवश्यक होती है, जो बड़े पैमाने पर डेटा से निपटने के दौरान चुनौतीपूर्ण हो सकती है.
टीमों को अपने सिस्टमों को सावधानीपूर्वक अनुकूलित करना चाहिए ताकि लेटेन्सी कम हो और आवश्यकता पड़ने पर डेटा उपलब्ध हो।
डेटा इन्जेशन के सर्वोत्तम अभ्यास
कुशल और प्रभावी डेटा इन्जेशन सुनिश्चित करने के लिए कुछ सर्वोत्तम अभ्यास हैं.
डेटा गुणवत्ता को प्राथमिकता दें
इनजेस्ट किया गया डेटा एनालिटिक्स, रिपोर्टिंग, और निर्णय-निर्माण में उपयोग होगा, इसलिए उसे सटीकता और पूर्णता के पूर्वनिर्धारित मानकों को पूरा करना चाहिए.
इन्जेशन के दौरान डेटा वैलिडेशन चेक्स लागू करना यह सत्यापित करने में मदद कर सकता है कि डेटा अपेक्षित फ़ॉर्मेट्स और गुणवत्ता मानकों के अनुरूप है। मैंने इस बारे में पहले एक Great Expectations ट्यूटोरियल में लिखा है।
उदाहरण के लिए, यदि डेटा के किसी निश्चित दायरे में होने या विशिष्ट मानदंडों को पूरा करने की अपेक्षा है, तो वैलिडेशन नियमों का उपयोग करें ताकि जो डेटा इन मानकों को पूरा नहीं करता उसे स्वचालित रूप से अस्वीकार या फ़्लैग किया जा सके। यह त्रुटियों को न्यूनतम करता है और सुनिश्चित करता है कि केवल भरोसेमंद डेटा डाउनस्ट्रीम प्रोसेस हो।
सही इन्जेशन दृष्टिकोण चुनें
एक और सर्वोत्तम अभ्यास यह सुनिश्चित करना है कि आप अपनी व्यावसायिक जरूरतों के लिए उपयुक्त इन्जेशन दृष्टिकोण का चयन करें.
बैच इन्जेशन आमतौर पर कम समय-संवेदी डेटा, जैसे ऐतिहासिक या आवधिक रिपोर्ट्स, के लिए उपयोग होता है। इसके विपरीत, रियल-टाइम इन्जेशन उन अनुप्रयोगों के लिए उपयोग होता है जिन्हें नवीनतम डेटा तक तात्कालिक पहुँच की आवश्यकता होती है, जैसे धोखाधड़ी का पता लगाना या IoT मॉनिटरिंग।
अपडेट्स की आवृत्ति और तात्कालिकता के आधार पर अपनी आवश्यकताओं का आकलन करें।
स्केलेबिलिटी सुनिश्चित करें
आपका डेटा वॉल्यूम समय के साथ बढ़ेगा। इसलिए, यह महत्वपूर्ण है कि आप ऐसे स्केलेबल टूल्स और अधोसंरचना का चयन करें जो प्रदर्शन से समझौता किए बिना बढ़ती डेटा मात्रा को संभाल सकें। इससे आप भविष्य की वृद्धि को समायोजित करने के लिए अपने डेटा पाइपलाइनों और प्रोसेसिंग क्षमताओं का विस्तार कर सकते हैं।
डेटा कंप्रेशन का उपयोग करें
कम स्टोरेज स्पेस की आवश्यकता का मतलब है कम अधोसंरचना लागत। कंप्रेशन डेटा ट्रांसफर को भी तेज करता है, जिसका अर्थ है इन्जेशन तेज होगा—खासकर जब बड़े डेटासेट्स या हाई-वॉल्यूम स्ट्रीम्स से निपटा जा रहा हो। यह अभ्यास विशेष रूप से सेमी-स्ट्रक्चर्ड या अनस्ट्रक्चर्ड डेटा के साथ फायदेमंद है, क्योंकि ये अक्सर बड़े आकार में आते हैं।
डेटा इन्जेशन टूल्स
जैसा कि आप देख सकते हैं, डेटा इन्जेशन एक सरल अवधारणा है लेकिन इसे अपने दम पर लागू करना काफी कठिन हो सकता है। डेटा इन्जेशन में आपकी मदद के लिए सबसे अच्छे टूल्स कौन से हैं? मैंने सबसे अधिक उपयोग किए जाने वाले टूल्स की सूची तैयार की है।
Apache Kafka
Apache Kafka एक डिस्ट्रिब्यूटेड स्ट्रीमिंग प्लेटफ़ॉर्म है जो रियल-टाइम डेटा इन्जेशन में उत्कृष्ट है।
- यह हाई-थ्रूपुट, लो-लेटेन्सी डेटा स्ट्रीम्स को संभालने के लिए डिज़ाइन किया गया है, जो इसे लगातार उत्पन्न होने वाले बड़े पैमाने के डेटा तक तात्कालिक पहुँच की आवश्यकता वाले उपयोग-परिदृश्यों के लिए आदर्श बनाता है।
- Kafka का एक महत्वपूर्ण लाभ यह है कि यह व्यवसायों को रियल-टाइम में स्ट्रीमिंग डेटा को प्रोसेस, स्टोर और विभिन्न सिस्टमों तक फ़ॉरवर्ड करने में सक्षम बनाता है।
- यह धोखाधड़ी का पता लगाने, IoT डेटा प्रोसेसिंग और रियल-टाइम एनालिटिक्स जैसे परिदृश्यों में व्यापक रूप से उपयोग होता है।
Introduction to Kafka कोर्स आपको सिखा सकता है कि कैसे वास्तविक दुनिया की डेटा स्ट्रीमिंग चुनौतियों के लिए Kafka को बनाना, प्रबंधित करना और ट्रबलशूट करना है।
Apache Nifi
Apache Nifi अपने उपयोगकर्ता-अनुकूल विज़ुअल इंटरफ़ेस के लिए जाना जाने वाला एक डेटा इन्जेशन टूल है।
- इसका सुलभ इंटरफ़ेस व्यवसायों को ड्रैग-एंड-ड्रॉप मेकैनिज़्म का उपयोग करके डेटा फ्लोज़ को डिज़ाइन, मॉनिटर और मैनेज करने में सक्षम बनाता है।
- Nifi कई डेटा स्रोतों—जिसमें बैच और रियल-टाइम डेटा शामिल हैं—का समर्थन करता है और Hadoop, रिलेशनल डेटाबेस और NoSQL स्टोर्स जैसे सिस्टमों के साथ एकीकरण कर सकता है।
- डेटा इन्जेशन वर्कफ़्लोज़ को स्वचालित करने और जटिल डेटा रूटिंग और ट्रांसफॉर्मेशन कार्यों को संभालने की इसकी क्षमता इसे छोटे पैमाने से लेकर एंटरप्राइज़-स्तर की डेटा इन्जेशन जरूरतों के लिए एक लचीला और शक्तिशाली टूल बनाती है।
Amazon Kinesis
Amazon Kinesis AWS की एक क्लाउड-नेटिव सेवा है जो स्ट्रीमिंग डेटा को इनजेस्ट करने, प्रोसेस करने और विश्लेषित करने में विशेषज्ञता रखती है। इसे उच्च थ्रूपुट डेटा स्ट्रीम्स के लगभग रियल-टाइम प्रोसेसिंग की आवश्यकता वाले अनुप्रयोगों के लिए डिज़ाइन किया गया है, जैसे:
- वीडियो फीड्स
- क्लिकस्ट्रीम डेटा
- IoT सेंसर डेटा
Kinesis का एक लाभ इसकी यह क्षमता है कि यह स्टोरेज, एनालिटिक्स और मशीन लर्निंग के लिए अन्य AWS सेवाओं के साथ एकीकृत हो सकता है।
यह टूल विशेष रूप से उन संगठनों के लिए उपयुक्त है जो क्लाउड अधोसंरचना का लाभ उठाते हैं और अपनी डेटा इन्जेशन आवश्यकताओं को संभालने के लिए पूर्णतः प्रबंधित समाधान चाहते हैं, बिना हार्डवेयर या स्केलेबिलिटी मुद्दों की चिंता किए।
Google Cloud Dataflow
Google Cloud Dataflow, Google Cloud द्वारा प्रदत्त एक पूर्णतः प्रबंधित सेवा है जो बैच और रियल-टाइम डेटा प्रोसेसिंग—दोनों—का समर्थन करती है।
- यह Apache Beam, एक ओपन-सोर्स एकीकृत प्रोग्रामिंग मॉडल, पर आधारित है और उपयोगकर्ताओं को जटिल डेटा पाइपलाइंस डिज़ाइन करने की अनुमति देता है जो बड़े पैमाने की बैच प्रोसेसिंग और रियल-टाइम स्ट्रीमिंग डेटा—दोनों—को संभाल सकती हैं।
- Dataflow संसाधन प्रबंधन और स्केलिंग को स्वचालित करता है, जिससे यह उन व्यवसायों के लिए आदर्श बनता है जो मैनुअल इंफ्रास्ट्रक्चर प्रबंधन के बिना डेटा को प्रोसेस और विश्लेषित करना चाहते हैं।
Airbyte
Airbyte एक ओपन-सोर्स डेटा इन्जेशन प्लेटफ़ॉर्म है जो विभिन्न स्रोतों से स्टोरेज सॉल्यूशंस में डेटा इंटीग्रेशन को सरल बनाता है।
- यह सैकड़ों डेटा स्रोतों और डेस्टिनेशनों के लिए प्री-बिल्ट कनेक्टर्स प्रदान करता है और बैच तथा रियल-टाइम इन्जेशन का समर्थन करता है।
- Airbyte की ख़ास बात यह है कि यह अत्यधिक कस्टमाइज़ेबल है—यह उपयोगकर्ताओं को अपनी जरूरतों के अनुरूप कनेक्टर्स का विस्तार करने की अनुमति देता है।
- इसके अलावा, यह उन लोगों के लिए एक मैनेज्ड क्लाउड सेवा प्रदान करता है जो हैंड्स-ऑफ समाधान चाहते हैं।
डेटा इन्जेशन टूल्स की तुलना
| टूल | प्रकार | किसके लिए सर्वश्रेष्ठ | मुख्य विशेषताएँ | डिप्लॉयमेंट | उपयोग में सहजता | कस्टमाइज़ेशन | इंटीग्रेशन |
|---|---|---|---|---|---|---|---|
| Apache Kafka | स्ट्रीमिंग प्लेटफ़ॉर्म | रियल-टाइम डेटा इन्जेशन | हाई-थ्रूपुट, लो-लेटेन्सी, स्केलेबल | क्लाउड और ऑन-प्रेम | मध्यम | उच्च | विस्तृत इकोसिस्टम समर्थन |
| Apache Nifi | डेटा फ्लो मैनेजमेंट | स्वचालित डेटा पाइपलाइंस | ड्रैग-एंड-ड्रॉप UI, रियल-टाइम प्रोसेसिंग | क्लाउड और ऑन-प्रेम | उच्च | उच्च | एकाधिक प्रोटोकॉल, बिग डेटा टूल्स |
| Amazon Kinesis | क्लाउड स्ट्रीमिंग सेवा | AWS-नेटिव रियल-टाइम एनालिटिक्स | पूर्णतः प्रबंधित, स्केलेबल, AWS-इंटीग्रेटेड | क्लाउड (AWS) | उच्च | मध्यम | डीप AWS इंटीग्रेशन |
| Google Cloud Dataflow | डेटा प्रोसेसिंग सेवा | बैच और स्ट्रीमिंग ETL | ऑटो-स्केलिंग, Apache Beam-आधारित | क्लाउड (GCP) | उच्च | मध्यम | मजबूत GCP इंटीग्रेशन |
| Airbyte | डेटा इंटीग्रेशन प्लेटफ़ॉर्म | प्री-बिल्ट और कस्टम कनेक्टर्स | ओपन-सोर्स, रियल-टाइम और बैच सपोर्ट | क्लाउड और ऑन-प्रेम | उच्च | बहुत उच्च | सैकड़ों डेटा स्रोत |
निष्कर्ष
इस लेख में, हमने डेटा इन्जेशन की बुनियादी बातें, उसके प्रकार, और उसे सक्षम बनाने वाली तकनीकों का अन्वेषण किया। आपने बैच और रियल-टाइम इन्जेशन तथा ETL, ELT, और चेंज डेटा कैप्चर (CDC) जैसे लोकप्रिय दृष्टिकोणों के बारे में सीखा। हमने सर्वोत्तम प्रथाओं, विभिन्न डेटा स्रोतों, और वह चुनौतियाँ भी कवर कीं जिनका संगठनों को क्रियान्वयन के दौरान सामना करना पड़ता है।
डेटा प्रबंधन और इन्जेशन टूल्स पर अधिक इनसाइट्स के लिए, मैं निम्न संसाधनों का अन्वेषण करने की सिफारिश करता हूँ:
FAQs
डेटा इन्जेशन डेटा इंटीग्रेशन से कैसे भिन्न है?
डेटा इन्जेशन विभिन्न स्रोतों से डेटा को एक केंद्रीकृत सिस्टम में एकत्रित और इम्पोर्ट करने पर केंद्रित होता है, जबकि डेटा इंटीग्रेशन विभिन्न स्रोतों से डेटा को संयोजित और समरूप बनाकर एकीकृत दृश्य प्रदान करता है। इंटीग्रेशन में अक्सर सिस्टमों के बीच अनुकूलता सुनिश्चित करने के लिए डेटा का ट्रांसफॉर्मेशन शामिल होता है, जो इन्जेशन के दायरे से परे है।
डेटा पाइपलाइन और डेटा इन्जेशन में क्या अंतर है?
डेटा इन्जेशन, डेटा पाइपलाइन का एक घटक है। जहाँ इन्जेशन लक्षित सिस्टम में डेटा को एकत्रित और ट्रांसफर करने के बारे में है, वहीं डेटा पाइपलाइन संपूर्ण प्रक्रिया को समेटती है, जिसमें इन्जेशन, ट्रांसफॉर्मेशन, वैलिडेशन, और आगे उपयोग या विश्लेषण के लिए डेटा लोड करना शामिल है।
डेटा इन्जेशन में डेटा गवर्नेंस की क्या भूमिका है?
डेटा गवर्नेंस सुनिश्चित करता है कि इनजेस्ट किया गया डेटा संगठनात्मक नीतियों, गुणवत्ता मानकों और नियामकीय आवश्यकताओं का पालन करता है। यह डेटा वैलिडेशन, एक्सेस कंट्रोल और डॉक्यूमेंटेशन के नियम परिभाषित करता है, जिससे इन्जेशन प्रक्रिया में भरोसा और सुरक्षा बनी रहती है।

मान लीजिए आप एक ई-कॉमर्स कंपनी के मालिक हैं। अपनी वेबसाइट को बेहतर बनाने और अधिक बिक्री उत्पन्न करने के लिए, आप ग्राहक व्यवहार को ट्रैक कर सकते हैं। इसमें हर क्लिक, खोज क्वेरी और खरीदारी को ट्रैक करना शामिल है, जो सभी मूल्यवान डेटा प्रदान करते हैं।
हालाँकि, जो डेटा आप एकत्र कर रहे हैं वह कई सिस्टमों (जैसे वेब एनालिटिक्स प्लेटफ़ॉर्म, ट्रांज़ैक्शन डेटाबेस, कस्टमर सपोर्ट लॉग्स, आदि) में बिखरा हुआ है, जो एक बड़ी समस्या है।
इस समस्या को कम करने के लिए, सभी एकत्रित डेटा को एक जगह समेकित किया जाना चाहिए, और यहीं डेटा इन्जेशन काम आता है।
डेटा इन्जेशन के माध्यम से, आप इस सभी डेटा को एक केंद्रीय डेटा वेयरहाउस में ला सकते हैं, जो आपको रियल-टाइम इनसाइट्स तेजी से जुटाने और आवश्यकता पड़ने पर एनालिटिक्स करने में सक्षम बनाता है।
इस लेख में, हम डेटा इन्जेशन की बुनियादी बातें और प्रक्रिया को सुगम बनाने के लिए उपयोग की जाने वाली तकनीकों का अन्वेषण करेंगे। आप उन टूल्स के बारे में जानेंगे जो डेटा इन्जेशन को सुव्यवस्थित करने में मदद करते हैं, आम चुनौतियाँ जो सामने आती हैं, और प्रक्रिया को स्केलेबिलिटी, दक्षता और डेटा गुणवत्ता के लिए अनुकूलित करने की सर्वोत्तम प्रथाएँ।
आइए शुरू करते हैं!
डेटा इन्जेशन क्या है?
डेटा इन्जेशन विभिन्न स्रोतों से डेटा को एक केंद्रीकृत सिस्टम (जैसे, डेटा वेयरहाउस, डेटा लेक, या क्लाउड प्लेटफ़ॉर्म) में एकत्रित करने, इम्पोर्ट करने और लोड करने की प्रक्रिया है। यह प्रक्रिया आपको अलग-अलग सिस्टमों से डेटा को समेकित करने और उसे आगे की प्रोसेसिंग और विश्लेषण के लिए उपलब्ध कराने में सक्षम बनाती है।
कुशल डेटा इन्जेशन महत्वपूर्ण है क्योंकि यह अन्य डेटा-चालित कार्यों—जैसे एनालिटिक्स, विज़ुअलाइज़ेशन, और शेयरिंग—की नींव रखता है।
डेटा इन्जेशन के प्रकार
तकनीकी रूप से, डेटा इन्जेशन को व्यापक तौर पर दो मुख्य प्रकारों में वर्गीकृत किया जा सकता है:
हर दृष्टिकोण अलग-अलग आवश्यकताओं की पूर्ति करता है और प्रोसेस किए जाने वाले डेटा की गति और मात्रा पर निर्भर विभिन्न उपयोग-परिदृश्यों के लिए उपयुक्त होता है।
बैच डेटा इन्जेशन
बैच इन्जेशन का अर्थ है डेटा को निर्धारित अंतरालों पर एकत्र करना और प्रोसेस करना। उदाहरण के लिए, आप डेटा को प्रति घंटा, दैनिक, या साप्ताहिक भी एकत्र और प्रोसेस कर सकते हैं। यह तरीका आमतौर पर तब उपयोग होता है जब तत्क्षण इनसाइट्स आवश्यक नहीं होते, और यह बड़े पैमाने पर डेटा को कुशलता से संभालने में मदद करता है।
बैच इन्जेशन के उपयोग-परिदृश्य के उदाहरण:
रियल-टाइम डेटा इन्जेशन
रियल-टाइम (या स्ट्रीमिंग) डेटा इन्जेशन का अर्थ है डेटा के उत्पन्न होते ही उसे लगातार एकत्र करना और प्रोसेस करना। यह तरीका आपको लगभग तत्क्षण इनसाइट्स प्राप्त करने देता है, जो उन परिस्थितियों में आदर्श है जहाँ समय-संवेदी निर्णय लेने की आवश्यकता होती है।
रियल-टाइम इन्जेशन के उपयोग-परिदृश्य के उदाहरण:
यदि आप बैचिंग और स्ट्रीमिंग के बीच अंतर, स्ट्रीमिंग सिस्टम्स का स्केलिंग, और वास्तविक दुनिया के अनुप्रयोगों के बारे में अधिक सीखना चाहते हैं, तो मैं e Streaming Concepts कोर्स की सिफारिश करता हूँ।