
Tecniche di Data Ingestion
Esistono diverse tecniche che facilitano la data ingestion. Ognuna è pensata per rispondere a differenti casi d’uso ed esigenze di elaborazione dei dati.
La scelta della tecnica dipende da 3 fattori:
- I requisiti specifici del business.
- La complessità dei dati.
- L’infrastruttura disponibile.
In questa sezione toccherò tre tecniche di data ingestion e quando sono più efficaci.
ETL (Extract, Transform, Load)
ETL è una tecnica tradizionale e ampiamente utilizzata per la data ingestion. In questo approccio, i dati vengono estratti da vari sistemi sorgente, trasformati in un formato coerente e pulito e infine caricati in un sistema di archiviazione, come un data warehouse.
Questo metodo è molto efficace per i casi d’uso che richiedono dati coerenti e strutturati per report, analytics e decision-making.
Quando usare ETL:
- Quando i dati devono essere pre-processati (ripuliti o trasformati) prima di essere caricati nel sistema di archiviazione.
- Scenari in cui i dati strutturati sono una priorità, ad esempio per generare report aziendali o rispettare stringenti requisiti di qualità dei dati.
- Quando si lavora con database relazionali o ambienti di dati su scala ridotta che privilegiano dati puliti e pronti per l’analisi.
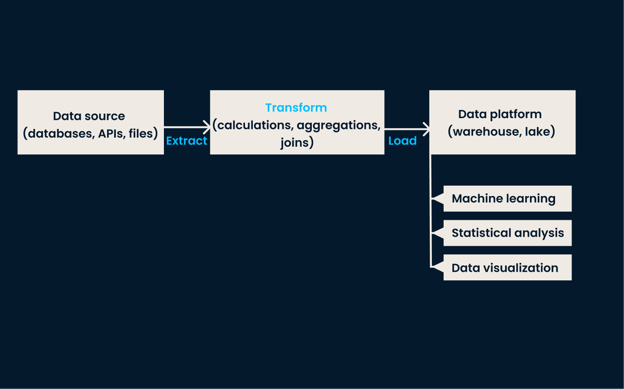
Architettura di una pipeline ETL.
ELT (Extract, Load, Transform)
ELT inverte l’ordine delle operazioni rispetto a ETL. In questo approccio, i dati vengono estratti dai sistemi sorgente e caricati direttamente nel sistema di destinazione (di solito un data lake o una piattaforma cloud). Una volta nel sistema di archiviazione di destinazione, i dati vengono trasformati secondo necessità, spesso all’interno dell’ambiente di destinazione.
L’approccio ELT è particolarmente efficace quando si gestiscono grandi volumi di dati non strutturati o semi-strutturati, in cui la trasformazione può essere rimandata fino al momento dell’analisi.
Quando usare ELT:
- Quando si lavora con data lake o archiviazione cloud, in grado di gestire dati grezzi su larga scala.
- Quando si gestiscono dati eterogenei, non strutturati o semi-strutturati che potrebbero non richiedere trasformazioni immediate.
- Quando serve flessibilità, poiché ELT permette di eseguire le trasformazioni su richiesta direttamente nell’ambiente di archiviazione.
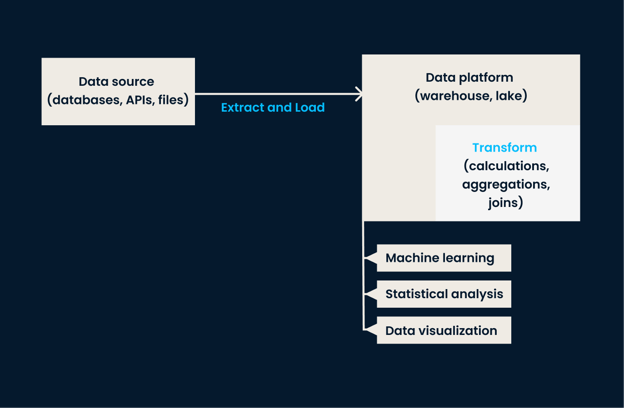
Architettura di una pipeline ELT.
Change Data Capture (CDC)
CDC è una tecnica per identificare e catturare le modifiche (ad esempio insert, update, delete) apportate ai dati nei sistemi sorgente e poi replicarle in tempo reale nei sistemi di destinazione.
Questa tecnica assicura che i sistemi di destinazione siano sempre aggiornati senza ricaricare l’intero dataset. Il CDC è molto efficace per mantenere la sincronizzazione in tempo reale tra database e garantire la coerenza tra i sistemi.
Quando usare il CDC:
- Quando la sincronizzazione dei dati in tempo reale è critica, come nel trading ad alta frequenza, nelle transazioni e-commerce o nella reportistica operativa.
- Quando devi mantenere i sistemi di destinazione aggiornati con un ritardo minimo o tempi di refresh ridotti.
- Quando è necessario evitare l’overhead di re-ingestire interi dataset.
Fonti di dati per l’ingestion
Abbiamo stabilito che la data ingestion comporta l’acquisizione di informazioni da varie fonti. Ma non abbiamo ancora discusso quali siano queste strutture — ed è ciò che faremo in questa sezione.
Le fonti di dati per l’ingestion rientrano generalmente in 3 tipi principali:
- Strutturati
- Semi-strutturati
- Non strutturati dati
Come vedrai esaminando le diverse fonti, ognuna richiede modalità di gestione ed elaborazione differenti per essere utilizzata in modo efficace.
Fonti di dati strutturati
I dati strutturati sono altamente organizzati e seguono uno schema predefinito, il che li rende più facili da elaborare e analizzare. Sono tipicamente archiviati in database relazionali, che memorizzano e forniscono accesso a punti dati correlati. I dati sono disposti in tabelle con righe e colonne ben definite.
Grazie a questa natura organizzata, i dati strutturati sono i più semplici da ingerire.
Strumenti tradizionali come MySQL e PostgreSQL sono comunemente usati per gestire dati strutturati. Questi strumenti basati su SQL semplificano la validazione durante l’ingestion imponendo regole di schema rigorose. Quando i dati vengono ingeriti in questi sistemi, verificano automaticamente che rispettino la struttura definita dalle tabelle del database.
Ad esempio, se una colonna è impostata per accettare solo valori interi, MySQL o PostgreSQL rifiuteranno qualsiasi dato che non rispetti questo requisito.
Altre cose da notare sui dati strutturati sono:
- Vengono tipicamente raccolti in grandi volumi (e in un formato prevedibile).
- Sono spesso ingeriti tramite processi batch, che consentono aggiornamenti periodici per rinfrescare i dati secondo necessità.
Fonti di dati semi-strutturati
I dati semi-strutturati, pur essendo ancora in parte organizzati, non aderiscono a uno schema rigido e predefinito come i dati strutturati. Utilizzano invece tag o marcatori per fornire una certa organizzazione, ma la struttura rimane flessibile.
Questo tipo di dati si trova tipicamente in formati come file JSON, file CSV e database NoSQL, ed è comunemente usato in applicazioni web, API e sistemi di log.
Poiché la struttura può variare, i dati semi-strutturati offrono flessibilità nell’archiviazione e nell’elaborazione, rendendoli adatti a sistemi che gestiscono formati di dati in evoluzione o incoerenti.
La gestione dei dati semi-strutturati richiede strumenti per effettuare il parsing ed estrarre informazioni significative dai tag o marcatori incorporati. Ad esempio, un file JSON può contenere una raccolta di coppie chiave-valore, e il processo di ingestion comporterà il parsing di queste coppie e la trasformazione in un formato adatto.
I dati semi-strutturati sono spesso ingeriti in ambienti flessibili come data lake o piattaforme cloud, dove possono essere archiviati in forma grezza ed elaborati successivamente secondo necessità.
Altre cose da notare sui dati semi-strutturati includono:
- A seconda del caso d’uso, possono essere ingeriti in tempo reale o tramite batch programmati.
- Richiedono trasformazioni durante l’ingestion per garantire che possano essere elaborati o analizzati in modo efficace.
Fonti di dati non strutturati
I dati non strutturati sono il tipo più complesso da gestire perché privi di un formato specifico o di una struttura organizzativa. Questa categoria include dati come:
- Immagini
- Video
- Audio
- Documenti
A differenza dei dati strutturati o semi-strutturati, i dati non strutturati non hanno righe, colonne o tag chiari a definirne il contenuto, il che li rende più impegnativi da elaborare e analizzare.
Nonostante la complessità, i dati non strutturati possono racchiudere insight preziosi, soprattutto se analizzati con tecnologie avanzate come il machine learning o l’elaborazione del linguaggio naturale.
Poiché i dati non strutturati non sono organizzati in modo predefinito, sono necessari strumenti specializzati per gestire il processo di ingestion. Questi strumenti possono estrarre informazioni rilevanti da fonti grezze e non strutturate e trasformarle in formati analizzabili.
Infine, i dati non strutturati vengono in genere archiviati in data lake, dove possono essere elaborati secondo necessità.
Tabella di confronto: dati strutturati vs. semi-strutturati vs. non strutturati
|
Caratteristica |
Dati strutturati |
Dati semi-strutturati |
Dati non strutturati |
|
Definizione |
Dati altamente organizzati con uno schema predefinito (es. righe e colonne). |
Dati parzialmente organizzati con tag o marcatori per maggiore flessibilità (es. JSON, CSV). |
Dati senza alcuna struttura o organizzazione predefinita (es. immagini, video). |
|
Esempi |
Database relazionali come MySQL, PostgreSQL. |
File JSON, database NoSQL, log CSV. |
Immagini, video, file audio, documenti di testo. |
|
Facilità di elaborazione |
I più facili da elaborare grazie allo schema rigido. |
Difficoltà moderata; richiedono parsing e trasformazione. |
I più impegnativi per la mancanza di struttura. |
|
Archiviazione |
Database relazionali o data warehouse. |
Data lake, database NoSQL, storage cloud. |
Data lake o storage specializzati per file grezzi. |
|
Approccio di ingestion |
Tipicamente ingeriti a batch. |
Flessibile; possono essere ingeriti in tempo reale o a batch. |
Principalmente ingeriti in formato grezzo per l’elaborazione successiva. |
|
Strumenti utilizzati |
Strumenti basati su SQL come MySQL, PostgreSQL. |
Strumenti che gestiscono schemi flessibili, come MongoDB, Google BigQuery. |
Strumenti avanzati come Hadoop, Apache Spark o strumenti di elaborazione basati su AI/ML. |
|
Esempi di casi d’uso |
Generazione di report, sistemi transazionali. |
Risposte API, log di applicazioni web. |
Riconoscimento immagini, analisi del parlato, analisi del sentiment. |
Sfide della Data Ingestion
La data ingestion comporta diverse sfide che devi affrontare per garantire una gestione dei dati efficiente ed efficace. In questa sezione, discuteremo quali sono queste sfide e le soluzioni che si possono adottare per superarle.
Gestione di grandi volumi di dati
Una delle principali sfide nella data ingestion è l’enorme volume di dati da elaborare. Con la crescita delle aziende, la quantità di dati generati e raccolti può aumentare esponenzialmente, soprattutto con l’ascesa di stream in tempo reale da fonti come dispositivi IoT e piattaforme social.
Scalare i processi di ingestion per gestire questi volumi crescenti può essere difficile, specialmente con dati in streaming che richiedono ingestion continua.
I team devono assicurarsi che la loro infrastruttura supporti ingestion di dati batch e in tempo reale su larga scala senza degradazioni. Il corso Streaming Concepts è un ottimo punto di partenza.
Qualità e coerenza dei dati
La qualità e la coerenza dei dati sono un’altra sfida significativa, soprattutto quando i dati vengono ingeriti da più fonti eterogenee. Ogni fonte può avere formati diversi, livelli di completezza differenti o persino informazioni in conflitto.
Ingerire dati senza affrontare queste incoerenze può portare a dataset inaccurati o incompleti, con un impatto negativo sulle analisi a valle.
Durante l’ingestion è necessario implementare controlli di validazione per garantire che nel sistema entrino solo dati di alta qualità. Inoltre, i team devono mantenere la coerenza tra le varie fonti per evitare discrepanze.
Consiglio di approfondire l’argomento con l’eccellente corso introduttivo sulla Qualità dei Dati.
Sicurezza e compliance
Quando si ingeriscono dati sensibili, sicurezza e compliance diventano priorità assolute. I team che gestiscono informazioni personali (ad esempio nomi dei clienti, indirizzi, dettagli di pagamento, ecc.) devono proteggere questi dati durante tutto il processo di ingestion.
Ad esempio, un’azienda di servizi finanziari deve rispettare normative stringenti come GDPR o HIPAA quando ingerisce i dati dei clienti per evitare ripercussioni legali. Non proteggere i dati durante l’ingestion può portare a violazioni, compromettere la fiducia dei clienti e causare pesanti sanzioni economiche.
Per affrontare questo aspetto, i team dovrebbero implementare crittografia e controlli di accesso sicuri durante il processo di ingestion. Ciò garantisce che i dati sensibili siano protetti da accessi non autorizzati. Inoltre, i dati devono essere ingeriti in modo conforme a tutti gli standard normativi pertinenti, con audit regolari per verificare la conformità continua.
Scopri come mantenere i dati sicuri e protetti con il corso interattivo per principianti Data Security.
Requisiti di latenza
In scenari in cui servono insight immediati, ritardi nell’ingestion possono produrre informazioni obsolete o irrilevanti. Un’ingestion a bassa latenza richiede la capacità di elaborare e rendere disponibili i dati per l’analisi quasi istantaneamente, il che può essere impegnativo quando si gestiscono grandi volumi di dati.
I team devono ottimizzare con cura i propri sistemi per ridurre la latenza e garantire che i dati siano disponibili quando servono.
Best practice per la Data Ingestion
Ci sono alcune best practice per garantire una data ingestion efficiente ed efficace.
Dai priorità alla qualità dei dati
I dati ingeriti saranno usati per analytics, report e decision-making, quindi devono soddisfare standard predefiniti di accuratezza e completezza.
Implementare controlli di validazione durante l’ingestion può aiutare a verificare che i dati rispettino i formati attesi e gli standard di qualità. Ne ho scritto in precedenza in un tutorial su Great Expectations.
Ad esempio, se ci si aspetta che i dati rientrino in un certo intervallo o soddisfino criteri specifici, usa regole di validazione per rifiutare automaticamente o segnalare qualsiasi dato che non rispetti tali standard. Questo riduce gli errori e assicura che a valle vengano elaborati solo dati affidabili.
Scegli l’approccio di ingestion giusto
Un’altra best practice è assicurarti di selezionare l’approccio di ingestion appropriato per le esigenze del tuo business.
L’ingestion a batch è tipicamente usata per dati meno sensibili al tempo, come report storici o periodici. Al contrario, l’ingestion in tempo reale è usata per applicazioni che richiedono accesso istantaneo ai dati più recenti, come il rilevamento frodi o il monitoraggio IoT.
Valuta le tue esigenze in base alla frequenza e all’urgenza degli aggiornamenti dei dati.
Garantisci la scalabilità
Il volume dei tuoi dati crescerà nel tempo. È quindi importante selezionare strumenti e infrastrutture scalabili per gestire quantità crescenti di dati senza compromettere le prestazioni. Questo ti permette di espandere pipeline e capacità di elaborazione per accogliere la crescita futura.
Usa la compressione dei dati
Meno spazio di archiviazione richiesto significa costi infrastrutturali inferiori. La compressione accelera anche il trasferimento dei dati, rendendo più veloce l’ingestion — soprattutto quando si hanno a che fare con dataset di grandi dimensioni o stream ad alto volume. Questa pratica è particolarmente vantaggiosa con dati semi-strutturati o non strutturati, poiché spesso hanno dimensioni rilevanti.
Strumenti per la Data Ingestion
Come vedi, la data ingestion è un concetto semplice ma può essere piuttosto difficile da implementare da soli. Quali sono i migliori strumenti per aiutarti con la data ingestion? Ho selezionato un elenco dei più utilizzati.
Apache Kafka
Apache Kafka è una piattaforma di streaming distribuita che eccelle nell’ingestion di dati in tempo reale.
- È progettata per gestire stream di dati ad alto throughput e bassa latenza, il che la rende ideale per casi d’uso che richiedono accesso istantaneo a grandi volumi di dati generati continuamente.
- Un vantaggio significativo di Kafka è che consente alle aziende di elaborare, archiviare e inoltrare dati in streaming a vari sistemi in tempo reale.
- È ampiamente utilizzata in scenari come rilevamento frodi, elaborazione di dati IoT e analytics in tempo reale.
Il corso Introduction to Kafka può insegnarti come creare, gestire e risolvere problemi con Kafka per sfide reali di data streaming.
Apache Nifi
Apache Nifi è uno strumento di data ingestion noto per la sua interfaccia visuale user-friendly.
- La sua interfaccia accessibile consente alle aziende di progettare, monitorare e gestire i flussi di dati tramite un meccanismo drag-and-drop.
- Nifi supporta molte fonti di dati — inclusi dati batch e in tempo reale — e può integrarsi con sistemi come Hadoop, database relazionali e archivi NoSQL.
- La capacità di automatizzare i workflow di ingestion e gestire attività complesse di instradamento e trasformazione dei dati lo rende uno strumento flessibile e potente sia per esigenze su piccola scala che a livello enterprise.
Amazon Kinesis
Amazon Kinesis è un servizio cloud-native di AWS specializzato nell’ingestione, elaborazione e analisi di dati in streaming. È progettato per applicazioni che richiedono l’elaborazione quasi in tempo reale di stream ad alto throughput, come:
- Feed video
- Dati di clickstream
- Dati da sensori IoT
Uno dei vantaggi di Kinesis è la sua capacità di integrarsi con altri servizi AWS per storage, analytics e machine learning.
Questo strumento è particolarmente adatto per le organizzazioni che sfruttano l’infrastruttura cloud e cercano una soluzione completamente gestita per soddisfare i requisiti di data ingestion senza doversi preoccupare di hardware o problemi di scalabilità.
Google Cloud Dataflow
Google Cloud Dataflow è un servizio completamente gestito fornito da Google Cloud che supporta sia l’elaborazione batch sia quella in tempo reale.
- È basato su Apache Beam, un modello di programmazione unificato open-source, e consente di progettare pipeline complesse in grado di gestire sia l’elaborazione batch su larga scala sia dati in streaming in tempo reale.
- Dataflow automatizza la gestione delle risorse e lo scaling, rendendolo ideale per le aziende che vogliono elaborare e analizzare dati senza gestione manuale dell’infrastruttura.
Airbyte
Airbyte è una piattaforma open-source di data ingestion che semplifica l’integrazione dei dati da varie fonti verso soluzioni di archiviazione.
- Offre connettori predefiniti per centinaia di fonti e destinazioni e supporta ingestion sia batch sia in tempo reale.
- La cosa interessante di Airbyte è l’elevata personalizzabilità — consente agli utenti di estendere i connettori in base alle proprie esigenze.
- Inoltre, fornisce un servizio cloud gestito per chi desidera una soluzione hands-off.
Confronto tra strumenti di data ingestion
| Strumento | Tipo | Ideale per | Caratteristiche chiave | Deployment | Facilità d’uso | Personalizzazione | Integrazione |
|---|---|---|---|---|---|---|---|
| Apache Kafka | Piattaforma di streaming | Ingestion di dati in tempo reale | Alto throughput, bassa latenza, scalabile | Cloud & On-Prem | Moderata | Alta | Ampio supporto dell’ecosistema |
| Apache Nifi | Gestione dei flussi di dati | Pipeline di dati automatizzate | UI drag-and-drop, elaborazione in tempo reale | Cloud & On-Prem | Alta | Alta | Molteplici protocolli, strumenti big data |
| Amazon Kinesis | Servizio di streaming cloud | Analytics in tempo reale nativi AWS | Completamente gestito, scalabile, integrato con AWS | Cloud (AWS) | Alta | Moderata | Integrazione profonda con AWS |
| Google Cloud Dataflow | Servizio di elaborazione dati | ETL batch & streaming | Auto-scaling, basato su Apache Beam | Cloud (GCP) | Alta | Moderata | Forte integrazione con GCP |
| Airbyte | Piattaforma di integrazione dati | Connettori predefiniti & custom | Open-source, supporto real-time & batch | Cloud & On-Prem | Alta | Molto alta | Centinaia di fonti di dati |
Conclusione
In questo articolo abbiamo esplorato le basi della data ingestion, i suoi tipi e le tecniche che la abilitano. Hai imparato a conoscere ingestion batch e in tempo reale e approcci diffusi come ETL, ELT e Change Data Capture (CDC). Abbiamo anche trattato le best practice, le varie fonti di dati e le sfide che le organizzazioni si trovano ad affrontare nell’esecuzione.
Per ulteriori approfondimenti sulla gestione dei dati e sugli strumenti di ingestion, ti consiglio di esplorare le seguenti risorse:
FAQs
In cosa differisce la data ingestion dall’integrazione dei dati?
La data ingestion si concentra sulla raccolta e l’importazione di dati da varie fonti in un sistema centralizzato, mentre l’integrazione dei dati combina e armonizza dati provenienti da fonti diverse per offrire una vista unificata. L’integrazione spesso comporta la trasformazione dei dati per garantirne la compatibilità tra i sistemi, andando oltre l’ambito dell’ingestion.
Qual è la differenza tra una data pipeline e la data ingestion?
La data ingestion è una componente di una pipeline di dati. Mentre l’ingestion riguarda la raccolta e il trasferimento dei dati verso un sistema di destinazione, una pipeline di dati comprende l’intero processo, inclusi ingestion, trasformazione, validazione e caricamento dei dati per l’uso o l’analisi successivi.
Che ruolo ha la data governance nella data ingestion?
La data governance assicura che i dati ingeriti rispettino le policy organizzative, gli standard di qualità e i requisiti normativi. Definisce regole per la validazione dei dati, il controllo degli accessi e la documentazione, contribuendo a mantenere fiducia e sicurezza nel processo di ingestion.





Immagina di possedere un’azienda di e-commerce. Per ottimizzare il tuo sito e generare più vendite, puoi tracciare il comportamento dei clienti. Questo implica monitorare ogni clic, query di ricerca e acquisto, tutti elementi che forniscono dati preziosi.
Tuttavia, i dati che stai raccogliendo sono sparsi su più sistemi (ad esempio, piattaforme di web analytics, database transazionali, log dell’assistenza clienti, ecc.), il che rappresenta un grosso problema.
Per ovviare a questo problema, tutti i dati raccolti dovrebbero essere consolidati in un unico posto, ed è qui che la data ingestion torna utile.
Attraverso la data ingestion, puoi convogliare tutti questi dati in un data warehouse centrale, che ti consente di ottenere insight in tempo reale più velocemente ed eseguire analisi quando necessario.
In questo articolo, esploreremo le basi della data ingestion e le tecniche utilizzate per facilitare il processo. Imparerai a conoscere gli strumenti che aiutano a snellire la data ingestion, le sfide comuni che emergono e le best practice per ottimizzare il processo in termini di scalabilità, efficienza e qualità dei dati.
Iniziamo!
Che cos’è la Data Ingestion?
La data ingestion è il processo di raccolta, importazione e caricamento di dati da varie fonti in un sistema centralizzato (ad esempio, un data warehouse, un data lake o una piattaforma cloud). Questo processo ti permette di consolidare i dati provenienti da sistemi diversi e renderli disponibili per ulteriori elaborazioni e analisi.
Un’ingestion efficiente è importante perché costituisce le fondamenta di altre operazioni data-driven, come analytics, visualizzazione e condivisione.
Tipi di Data Ingestion
Tecnicamente, la data ingestion può essere ampiamente suddivisa in due tipi principali:
Ogni approccio risponde a esigenze diverse ed è adatto a vari casi d’uso, a seconda della velocità e del volume dei dati elaborati.
Batch data ingestion
L’ingestion a batch si riferisce al processo di raccolta ed elaborazione dei dati a intervalli programmati. Ad esempio, puoi raccogliere ed elaborare dati ogni ora, ogni giorno o anche ogni settimana. Questo approccio è tipicamente usato quando non sono richiesti insight istantanei e aiuta a gestire in modo efficiente grandi volumi di dati.
Esempi di casi d’uso per l’ingestion a batch:
Real-time data ingestion
L’ingestion in tempo reale (o streaming) prevede la raccolta ed elaborazione continua dei dati man mano che vengono generati. Questo metodo permette di ottenere insight quasi istantanei, ideale per scenari in cui è richiesta una presa di decisione sensibile al fattore tempo.
Esempi di casi d’uso per l’ingestion in tempo reale:
Se vuoi approfondire la differenza tra batch e streaming, lo scaling dei sistemi di streaming e le applicazioni reali, consiglio il corso Streaming Concepts.