
Apache Iceberg dan Delta Lake: Persamaan
Karena Apache Iceberg dan Delta Lake sama-sama mengelola sejumlah besar data, mari kita bahas persamaan fundamentalnya.
Transaksi ACID dan konsistensi data
Kedua alat dapat memberikan konsistensi data penuh menggunakan transaksi ACID dan versioning. Namun, Iceberg menggunakan pendekatan merge-on-read, sedangkan Delta Lake menggunakan strategi merge-on-write.
Akibatnya, masing-masing menangani kinerja dan pengelolaan data secara berbeda. Iceberg dapat memberikan dukungan penuh untuk evolusi skema, sedangkan Delta Lake menegakkan kepatuhan skema.
Dukungan untuk time travel
Fungsionalitas time travel memungkinkan pengguna melakukan kueri versi historis data. Ini sangat berharga untuk audit, debugging, bahkan mereproduksi eksperimen. Baik Iceberg maupun Delta Lake mendukung time travel, sehingga Anda dapat mengakses kondisi data sebelumnya tanpa kekhawatiran.
Sifat sumber terbuka
Apache Iceberg dan Delta Lake adalah teknologi sumber terbuka. Ini berarti siapa pun dapat menggunakannya secara gratis dan bahkan membantu meningkatkannya. Selain itu, karena bersifat open-source, Anda tidak terikat pada produk satu perusahaan — Anda memiliki lebih banyak kebebasan untuk beralih atau menggabungkan alat sesuai kebutuhan. Dan karena kodenya bersifat publik, Anda bahkan dapat mengoptimalkannya untuk kebutuhan spesifik Anda.
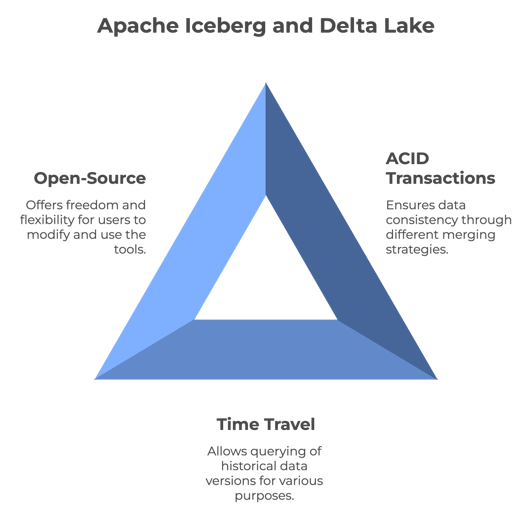
Fitur utama yang sama-sama dimiliki oleh Apache Iceberg dan Delta Lake. Gambar oleh Penulis dibuat dengan napkin.ai.
Iceberg vs Delta Lake: Perbedaan Arsitektur Inti
Walau Iceberg dan Delta Lake memiliki persamaan, keduanya berbeda dalam arsitektur. Mari lihat bagaimana:
Model transaksi
Iceberg dan Delta Lake memastikan keandalan data di data lake, tetapi mencapainya melalui mekanisme yang berbeda. Iceberg menggunakan snapshot untuk transaksi atomik guna memastikan perubahan sepenuhnya di-commit atau dibatalkan. Sedangkan Delta Lake menggunakan log transaksi untuk memastikan hanya perubahan tervalidasi yang di-commit ke tabel dan memberikan keandalan dalam pembaruan data.
Manajemen metadata
Apache Iceberg menggunakan struktur metadata hierarkis, yang mencakup file manifest, daftar manifest, dan file metadata. Desain ini merampingkan pemrosesan kueri dengan menghilangkan operasi mahal seperti pencantuman dan penggantian nama file.
Namun, Delta Lake mengadopsi pendekatan berbasis transaksi untuk mencatat setiap transaksi dalam sebuah log. Untuk meningkatkan efisiensi kueri dan menyederhanakan pengelolaan log, log ini secara berkala dikonsolidasikan ke dalam file checkpoint Parquet yang menangkap kondisi tabel secara lengkap.
Kompatibilitas format file
Iceberg fleksibel terhadap format file dan dapat bekerja secara native dengan file Parquet, ORC, dan Avro. Ini membantu jika Anda memiliki data dalam berbagai format atau ingin beralih format di masa depan tanpa mengubah seluruh sistem.
Delta Lake terutama menyimpan data dalam format Parquet karena Parquet efisien, khususnya untuk kueri analitik. Ia hanya berfokus pada satu format untuk memberikan kinerja terbaik bagi tipe file tersebut.
Performa dan skalabilitas
Iceberg dan Delta Lake menskalakan data lake tetapi menggunakan strategi berbeda. Iceberg memprioritaskan pengorganisasian data tingkat lanjut dengan fitur seperti partisi dan kompaksi, sementara Delta Lake menekankan kinerja tinggi melalui Delta Engine, auto compaction, dan kemampuan pengindeksan.
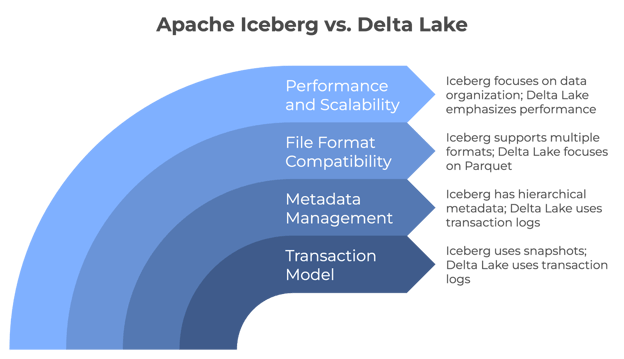
Perbedaan inti antara Apache Iceberg dan Delta Lake. Gambar oleh Penulis dibuat dengan napkin.ai.
Kasus Penggunaan untuk Apache Iceberg
Berkat fitur uniknya, Apache Iceberg dengan cepat menjadi solusi andalan untuk pengelolaan data lake modern. Mari bahas beberapa kasus penggunaannya yang utama untuk memahami kekuatannya.
Data lake cloud-native
Inilah alasan Iceberg menjadi pilihan populer bagi organisasi yang membangun data lake yang beroperasi pada skala cloud:
- Evolusi skema yang kuat: Memungkinkan Anda menambah, menghapus, atau memodifikasi kolom tanpa memengaruhi kueri yang ada. Misalnya, jika Anda perlu menambahkan field baru untuk melacak preferensi pengguna, Anda bisa melakukannya tanpa membangun ulang seluruh dataset atau memperbarui semua kueri.
- Performa: Teknik lanjutan seperti pengelompokan data dan manajemen metadata mengoptimalkan performa kueri. Keduanya dengan cepat memangkas file data yang tidak diperlukan untuk mengurangi jumlah data yang dipindai dan meningkatkan kecepatan kueri.
- Skalabilitas: Mengelola miliaran file dan petabyte data. Selain itu, fitur evolusi partisi memungkinkan Anda mengubah cara data diorganisasi tanpa downtime atau migrasi yang mahal.
Model data kompleks
Tim yang menangani model data kompleks menemukan Iceberg sangat berguna karena hal-hal berikut:
- Fleksibilitas skema: Mendukung tipe data bertingkat (struct, list, dan map) untuk merepresentasikan relasi kompleks. Misalnya, platform e-commerce dapat menyimpan detail pesanan, termasuk struktur bertingkat untuk item dan data pelanggan, semuanya dalam satu tabel.
- Kueri time-travel: Metode ini mempertahankan snapshot data Anda untuk mengkueri data sebagaimana adanya pada titik mana pun di masa lalu. Ini sangat berharga untuk merekonstruksi kondisi data Anda pada waktu tertentu demi kepatuhan, atau menjalankan ulang analisis pada snapshot data historis.
Integrasi dengan alat
Iceberg kompatibel dengan beragam alat, menjadikannya pilihan serbaguna untuk ekosistem data. Mari lihat beberapa integrasi kuncinya:
Iceberg bekerja mulus dengan berikut ini:
- Apache Spark untuk pemrosesan data skala besar dan machine learning.
- Trino untuk kueri SQL terdistribusi yang cepat di berbagai sumber data.
- Apache Flink untuk pemrosesan stream secara real-time dan komputasi batch.
Penyedia cloud besar berikut menawarkan dukungan native untuk Iceberg:
- Amazon Web Services (AWS) terintegrasi dengan AWS Glue, Redshift, EMR, dan Athena.
- Google Cloud Platform (GCP) bekerja dengan BigQuery dan Dataproc.
- Microsoft Azure kompatibel dengan Azure Synapse Analytics.
Iceberg juga menyediakan library klien untuk berbagai bahasa pemrograman, seperti:
- SQL menulis kueri SQL standar terhadap tabel Iceberg.
- Python menggunakan PySpark atau library seperti pyiceberg untuk manipulasi data.
- Java memanfaatkan API Java native untuk operasi level rendah dan integrasi kustom.
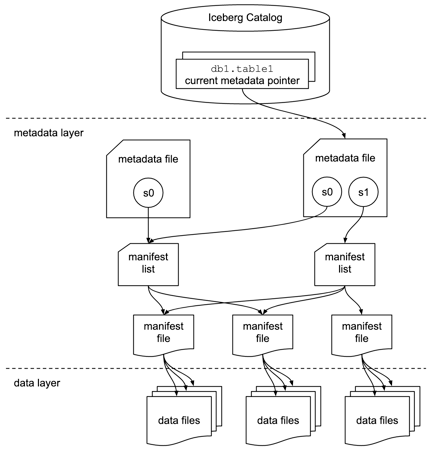
Spesifikasi format tabel Apache Iceberg. Sumber gambar: Dokumentasi Iceberg.
Kasus Penggunaan untuk Delta Lake
Delta Lake dapat menyelesaikan tantangan umum dan mempermudah pengelolaan data. Mari bahas beberapa situasi kunci di mana ini sangat membantu.
Beban kerja batch dan streaming terpadu
Dengan Delta Lake, Anda tidak memerlukan sistem terpisah untuk tipe data yang berbeda. Sebagai gantinya, Anda dapat memiliki satu sistem yang menangani semuanya. Anda dapat menambahkan data baru ke tabel secara real time, dan data tersebut langsung siap dianalisis. Ini berarti data Anda selalu mutakhir.
Anda dapat membangun satu alur kerja yang menangani data lama dan baru sehingga keseluruhan sistem menjadi kurang kompleks dan lebih mudah dikelola. Pendekatan terpadu ini akan menyederhanakan pipeline data Anda.
Transaksi ACID untuk data lake
Delta Lake menghadirkan keandalan data yang kuat ke data lake melalui transaksi ACID. Misalnya:
- Rumah sakit dapat menjaga rekam medis pasien yang akurat dan mutakhir untuk memberikan perawatan yang tepat dan mematuhi aturan privasi.
- Bank dapat memastikan semua transaksi keuangan tercatat dengan akurat dan tidak dapat diubah secara tidak sengaja.
- Toko ritel dapat menjaga hitungan persediaan tetap presisi, bahkan ketika banyak pembaruan terjadi secara bersamaan. Ini membantu mencegah masalah seperti menjual barang yang sebenarnya tidak tersedia.
Delta Lake mencapai keandalan ini dengan memastikan bahwa semua perubahan diterapkan sepenuhnya atau tidak sama sekali. Selain itu, ia memastikan data selalu berpindah dari satu kondisi valid ke kondisi valid lainnya dan berbagai operasi tidak saling mengganggu.
Ekosistem Apache Spark
Delta Lake juga bekerja mulus dengan Apache Spark, keunggulan besar bagi banyak organisasi. Jika Anda sudah menggunakan Spark, menambahkan Delta Lake akan sederhana dan tidak memerlukan perubahan besar pada penyiapan yang ada. Tim Anda dapat menggunakan alat Spark dan perintah SQL yang sudah familiar.
Hasilnya, pekerjaan Spark Anda akan berjalan lebih cepat, terutama saat menangani data dalam jumlah besar. Ini dilakukan dengan mengatur data lebih efisien dan menggunakan teknik pengindeksan yang cerdas.
Apache Iceberg vs Delta Lake: Ringkasan
Mari kita rangkum perbedaan utama antara Apache Iceberg dan Delta Lake untuk membantu Anda cepat memahami kekuatan format dan fitur kuncinya.
|
Fitur |
Apache Iceberg |
Delta Lake |
|
Transaksi ACID |
Ya |
Ya |
|
Time travel |
Ya |
Ya |
|
Versioning data |
Ya |
Ya |
|
Format file |
Parquet, ORC, Avro |
Parquet |
|
Evolusi skema |
Penuh |
Parsial |
|
Integrasi dengan mesin lain |
Apache Spark, Trino, Flink |
Utamanya Apache Spark |
|
Kompatibilitas Cloud |
AWS, GCP, Azure |
AWS, GCP |
|
Mesin Kueri |
Spark, Trino, Flink |
Spark |
|
Bahasa Pemrograman |
SQL, Python, Java |
SQL, Python |
Catatan: Pilihan terbaik bergantung pada kebutuhan Anda, persyaratan skalabilitas, dan strategi data jangka panjang.
Kesimpulan
Saat memilih antara Apache Iceberg dan Delta Lake, pertimbangkan kasus penggunaan spesifik dan tumpukan teknologi Anda saat ini. Fleksibilitas Iceberg terhadap format file dan mesin kueri menjadikannya ideal untuk lingkungan cloud-native. Namun, integrasi erat Delta Lake dengan Apache Spark merupakan opsi yang baik bagi organisasi yang sangat berinvestasi dalam ekosistem Spark.
Anda juga dapat melihat beberapa sumber daya DataCamp yang relevan untuk memperkuat pemahaman data Anda saat ini:
- Understanding Data Engineering course untuk memahami konsep dasar
- Database Design dan Data Warehousing courses untuk menata data berskala besar secara efektif.
- Modern Data Architecture course untuk mempelajari praktik terbaik dan tren saat ini.
Selamat belajar!
FAQs
Apa perbedaan utama antara strategi Merge-on-Read dan Merge-on-Write?
Merge-on-Read (digunakan oleh Iceberg) membaca data dari file yang ada dan menerapkan perubahan saat waktu kueri. Merge-on-Write (digunakan oleh Delta Lake) menggabungkan pembaruan ke data dasar selama proses penulisan untuk memastikan pembacaan lebih cepat dengan konsekuensi operasi tulis yang lebih lambat.
Dapatkah Apache Iceberg dan Delta Lake menangani data berskala petabyte?
Ya, baik Apache Iceberg maupun Delta Lake secara efisien menangani dataset berskala petabyte. Keduanya menyediakan fitur lanjutan seperti partisi, manajemen metadata, dan kompaksi untuk mengoptimalkan performa data lake besar.
Bagaimana kinerja Apache Iceberg dan Delta Lake saat melakukan kueri struktur data yang sangat bertingkat?
Apache Iceberg sangat baik dalam melakukan kueri pada struktur data yang sangat bertingkat. Ia mendukung format penyimpanan tabular seperti Parquet, yang dioptimalkan untuk data bertingkat. Di sisi lain, Delta Lake juga mendukung data bertingkat, tetapi kinerjanya dapat bervariasi tergantung kompleksitas kueri dan ukuran dataset.
Dapatkah Apache Iceberg dan Delta Lake bekerja bersama dalam arsitektur data lake yang sama?
Ya, baik Apache Iceberg maupun Delta Lake dapat hidup berdampingan dalam data lake yang sama. Masing-masing dapat digunakan untuk kasus penggunaan yang berbeda tergantung persyaratan. Misalnya, Anda mungkin menggunakan Delta Lake untuk beban kerja yang berpusat pada Apache Spark dan Iceberg untuk integrasi yang lebih fleksibel dengan beragam mesin kueri.
Apakah ada keterbatasan saat menggunakan Delta Lake dengan mesin non-Spark?
Delta Lake terintegrasi erat dengan Apache Spark, dan meski dapat bekerja dengan mesin lain seperti Presto atau Hive, integrasi ini masih terus berkembang. Kinerjanya mungkin tidak seoptimal dengan Spark, yang dapat membatasi efektivitasnya di luar ekosistem Spark.
Bagaimana Iceberg dan Delta Lake menangani masalah file kecil di data lake?
Baik Apache Iceberg maupun Delta Lake mengatasi masalah file kecil melalui kompaksi. Iceberg secara berkala menggabungkan file kecil untuk mengoptimalkan performa kueri, sementara Delta Lake menggunakan auto compaction untuk mengonsolidasikan file selama operasi tulis. Ini memastikan kinerja yang lebih baik dengan mengurangi overhead akibat banyaknya file kecil.
Mengapa Databricks mengakuisisi Tabular (perusahaan di balik Iceberg)?
Databricks mengakuisisi Tabular untuk memperkuat kemampuannya dengan Apache Iceberg, yang awalnya dibuat oleh para pendiri Tabular. Akuisisi ini bertujuan meningkatkan kompatibilitas dan interoperabilitas antara Delta Lake dan Iceberg, pada akhirnya menuju format lakehouse terpadu yang menggabungkan kekuatan kedua proyek open-source.
Apa arti akuisisi Tabular bagi pengguna Delta Lake dan Iceberg?
Akuisisi ini berarti Databricks akan aktif bekerja untuk mendekatkan Delta Lake dan Iceberg dari sisi kompatibilitas. Pengguna akan mendapatkan manfaat dari integrasi yang lebih baik, dengan Delta Lake UniForm yang sudah berperan sebagai platform untuk memungkinkan interoperabilitas antara Delta Lake, Iceberg, dan Apache Hudi. Ini memungkinkan pengguna bekerja lintas format tanpa terkunci pada satu solusi.
Apakah Databricks akan terus mendukung kedua format, Delta Lake dan Iceberg?
Ya, Databricks telah menyatakan komitmennya pada kedua format. Dengan mengakuisisi Tabular dan menghadirkan para pencipta asli Apache Iceberg, Databricks ingin mendorong kolaborasi antara komunitas Iceberg dan Delta Lake. Tujuannya adalah mengembangkan satu standar terbuka untuk interoperabilitas format lakehouse, yang akan memberikan lebih banyak opsi dan fleksibilitas bagi pengguna.

Saya seorang ahli strategi konten yang senang menyederhanakan topik kompleks. Saya telah membantu perusahaan seperti Splunk, Hackernoon, dan Tiiny Host membuat konten yang menarik dan informatif untuk audiens mereka.




Pemrosesan big data sering kali melibatkan data tidak terstruktur, yang menantang untuk dikelola dan dianalisis. Penghapusan tidak sengaja atau kesalahan lain dapat terjadi kapan saja — menimbulkan risiko besar terhadap integritas data.
Apache Iceberg dan Delta Lake adalah format tabel sumber terbuka yang terutama digunakan untuk mengelola data lake dan lakehouse berskala besar. Keduanya menyediakan fitur seperti evolusi skema, time travel, dan transaksi ACID untuk mengatasi tantangan penanganan kumpulan data masif. Meskipun masing-masing memiliki keunggulan unik, keduanya memiliki tujuan yang sama: menjaga konsistensi data di seluruh dataset.
Dalam artikel ini, saya akan menjelaskan fitur utama, persamaan, dan perbedaan arsitektural antara Apache Iceberg dan Delta Lake guna membantu Anda memilih alat yang tepat sesuai kebutuhan Anda.
Apa itu Apache Iceberg?
Dikembangkan oleh Netflix dan kemudian disumbangkan ke Apache Software Foundation, Iceberg bertujuan menyelesaikan tantangan pengelolaan data lake berskala besar. Ini adalah format berkinerja tinggi untuk tabel analitik besar yang secara efisien mengelola dan melakukan kueri atas dataset masif. Fitur-fiturnya mengatasi banyak keterbatasan pendekatan penyimpanan data lake tradisional.
Mari pahami Apache Iceberg lebih detail.
Fitur Apache Iceberg
Berikut beberapa fitur paling menonjol dari Apache Iceberg yang sangat membantu data engineer saat bekerja dengan dataset.
loyalty_points, Anda dapat melakukannya tanpa memengaruhi data yang ada atau merusak kueri saat ini. Fleksibilitas ini sangat berguna untuk proyek data jangka panjang yang perlu beradaptasi seiring waktu.Fitur-fitur ini membuat Iceberg sangat baik untuk analitik data berskala besar, terutama jika Anda menangani data yang sering berubah atau perlu diakses dengan berbagai cara dalam jangka panjang.
Lihat postingan blog Apache Iceberg Explained untuk penjelasan mendalam tentang teknologi menarik ini.
Apa itu Delta Lake?
Dikembangkan oleh Databricks, Delta Lake bekerja mulus dengan Spark, menjadikannya pilihan populer bagi organisasi yang sudah berinvestasi dalam ekosistem Spark. Ini adalah lapisan penyimpanan sumber terbuka yang menghadirkan transaksi ACID (Atomicity, Consistency, Isolation, Durability) ke Apache Spark dan beban kerja big data.
Lakehouse berbasis Delta Lake menyederhanakan pergudangan data dan machine learning untuk menjaga kualitas data melalui metadata yang dapat diskalakan, versioning, dan penegakan skema.
Fitur Delta Lake
Berikut fitur-fitur kunci yang menjadikan Delta Lake solusi yang baik untuk pemrosesan data modern:
Kursus Big Data Fundamentals with PySpark membahas secara mendalam pemrosesan data modern dengan Spark. Ini adalah penyegar yang bagus untuk teknologi yang kuat ini.