Cursus
Big data-verwerking omvat vaak het werken met ongestructureerde data, wat lastig kan zijn om te beheren en te analyseren. Per ongeluk verwijderen of andere fouten kunnen op elk moment optreden — en vormen een groot risico voor de dataintegriteit.
Apache Iceberg en Delta Lake zijn open-source tabelformaten die voornamelijk worden gebruikt voor het beheren van grootschalige data lakes en lakehouses. Beide platforms bieden functies zoals schema-evolutie, time travel en ACID-transacties om de uitdagingen bij het verwerken van enorme datasets aan te pakken. Hoewel elk unieke voordelen heeft, delen ze een gemeenschappelijk doel: dataconsistentie tussen datasets behouden.
In dit artikel leg ik de belangrijkste functies, overeenkomsten en architecturale verschillen tussen Apache Iceberg en Delta Lake uit, zodat je de juiste tool voor jouw behoeften kunt kiezen.
Wat is Apache Iceberg?

Ontwikkeld door Netflix en later gedoneerd aan de Apache Software Foundation, Iceberg pakt de uitdagingen aan van het beheren van grootschalige data lakes. Het is een high-performance formaat voor grote analytische tabellen dat enorme datasets efficiënt beheert en bevraagt. De functies pakken veel beperkingen van traditionele data lake-opslag aan.
Laten we Apache Iceberg in meer detail bekijken.
Functies van Apache Iceberg
Hier zijn enkele van de meest opvallende functies van Apache Iceberg, die erg handig zijn voor data engineers bij het werken met datasets.
- Schema-evolutie: In traditionele databases kan het wijzigen van de datastructuur (zoals het toevoegen van een nieuwe kolom) veel gedoe opleveren. Iceberg maakt dit eenvoudig. Als je bijvoorbeeld klantdata bijhoudt en een veld
loyalty_pointswilt toevoegen, kan dat zonder bestaande data te beïnvloeden of huidige queries te breken. Deze flexibiliteit is vooral nuttig voor langlopende dataprojecten die zich in de loop van de tijd moeten aanpassen. - Partitionering: Het helpt je data te organiseren in kleinere, beter beheersbare stukken. Dit maakt queries sneller, omdat je niet elke keer alle data hoeft te doorzoeken. Stel dat ik een enorme dataset met verkooprecords heb. Iceberg kan deze data automatisch organiseren op datum, locatie of een andere relevante factor.
- Time travel: Met deze functie kun je eenvoudig historische versies van data benaderen. Als iemand per ongeluk belangrijke informatie verwijdert of je huidige data wilt vergelijken met een vorige staat, kun je terugreizen naar een specifiek moment. Deze point-in-time-queries vereenvoudigen audit- en herstelprocessen.
- Dataintegriteit: Datacorruptie kan om vele redenen optreden, zoals netwerkproblemen, opslagissues of softwarebugs. Iceberg gebruikt wiskundige technieken (checksums) om te detecteren of zelfs maar één bit van je data onverwacht is gewijzigd. Zo weet je zeker dat de data die je analyseert exact is wat oorspronkelijk is opgeslagen.
- Compactie en optimalisatie: Na verloop van tijd kunnen datasystemen vervuild raken met veel kleine bestanden, wat de verwerking vertraagt. Iceberg ruimt dit periodiek op door kleine bestanden samen te voegen en data efficiënter te organiseren.
Deze functies maken Iceberg bijzonder geschikt voor grootschalige data-analyse, vooral als je werkt met data die vaak verandert of die je op verschillende manieren en over lange perioden moet kunnen benaderen.
Bekijk de blogpost Apache Iceberg uitgelegd voor een deep dive in deze spannende technologie.
Wat is Delta Lake?

Ontwikkeld door Databricks werkt Delta Lake naadloos met Spark, waardoor het een populaire keuze is voor organisaties die al in het Spark-ecosysteem hebben geïnvesteerd. Het is een open-source-opslaglaag die ACID (Atomicity, Consistency, Isolation, Durability) transacties naar Apache Spark en big data-workloads brengt.
Op Delta Lake gebaseerde lakehouses stroomlijnen datawarehousing en machine learning om datakwaliteit te behouden via schaalbare metadata, versies en schemahandhaving.
Functies van Delta Lake
Dit zijn de belangrijkste functies die Delta Lake tot een goede oplossing maken voor moderne dataverwerking:
- ACID-transacties: Traditionele data lakes hebben vaak moeite om dataconsistentie te behouden. Om dit te verhelpen, brengt Delta Lake de ACID-eigenschappen die bij databases horen naar data lakes. Dit betekent dat je complexe bewerkingen op je data kunt uitvoeren zonder je zorgen te maken over corruptie of inconsistenties, zelfs als er halverwege iets misgaat.
- Dataversies en time travel: Nu regelgeving zoals AVG steeds strenger wordt, is het bijhouden van dataveranderingen in de tijd van onschatbare waarde. Met de time travel-functie van Delta Lake kun je eerdere versies van je data benaderen en herstellen. Dit is handig voor compliance en voor het uitvoeren van experimenten met verschillende versies van je datasets.
- Geünificeerde batch en streaming: Traditioneel hadden organisaties aparte systemen nodig voor batchverwerking (in één keer grote hoeveelheden data verwerken) en streamverwerking (realtime data). Delta Lake overbrugt deze kloof, zodat je hetzelfde systeem voor beide kunt gebruiken. Dit vereenvoudigt je data-architectuur en laat je flexibelere datapijplijnen bouwen.
- Schaalbare metadataverwerking: Naarmate datavolumes schalen naar petabytes, wordt het beheren van metadata (data over je data) lastig. Veel systemen vertragen aanzienlijk bij miljoenen bestanden. Delta Lake kan echter enorme schaal aan zonder prestatiedegradatie, wat het geschikt maakt voor zeer grote data lakes.
- Geoptimaliseerd lezen en schrijven: Prestaties zijn cruciaal in big data-scenario's. Delta Lake gebruikt data skipping, caching en compactie om lees- en schrijfbewerkingen te versnellen. Dit betekent snellere queries en efficiënter gebruik van rekenresources, wat kosten bespaart in cloudomgevingen.
De cursus Big Data Fundamentals with PySpark gaat diep in op moderne dataverwerking met Spark. Het is een fijne opfrisser van deze krachtige technologie.
Apache Iceberg en Delta Lake: overeenkomsten
Omdat Apache Iceberg en Delta Lake beide grote hoeveelheden data beheren, bekijken we hun fundamentele overeenkomsten.
ACID-transacties en dataconsistentie
Beide tools kunnen volledige dataconsistentie bieden met ACID-transacties en versiebeheer. Iceberg gebruikt echter de merge-on-read-benadering, terwijl Delta Lake de merge-on-write-strategie gebruikt.
Daardoor gaan ze verschillend om met prestaties en databeheer. Iceberg kan volledige ondersteuning voor schema-evolutie bieden, terwijl Delta Lake schema-compliance afdwingt.
Ondersteuning voor time travel
Time travel-functionaliteit maakt het mogelijk om historische versies van data te bevragen. Dit is van onschatbare waarde voor auditing, debuggen en zelfs het reproduceren van experimenten. Zowel Iceberg als Delta Lake ondersteunen time travel, waardoor je zonder zorgen vorige toestanden van data kunt raadplegen.
Open-source karakter
Apache Iceberg en Delta Lake zijn open-source technologieën. Dit betekent dat iedereen ze gratis kan gebruiken en zelfs kan helpen ze te verbeteren. Bovendien ben je als open-sourcegebruiker niet gebonden aan het product van één bedrijf — je hebt meer vrijheid om tools te wisselen of te combineren. En omdat hun code openbaar is, kun je die zelfs optimaliseren voor jouw specifieke behoeften.
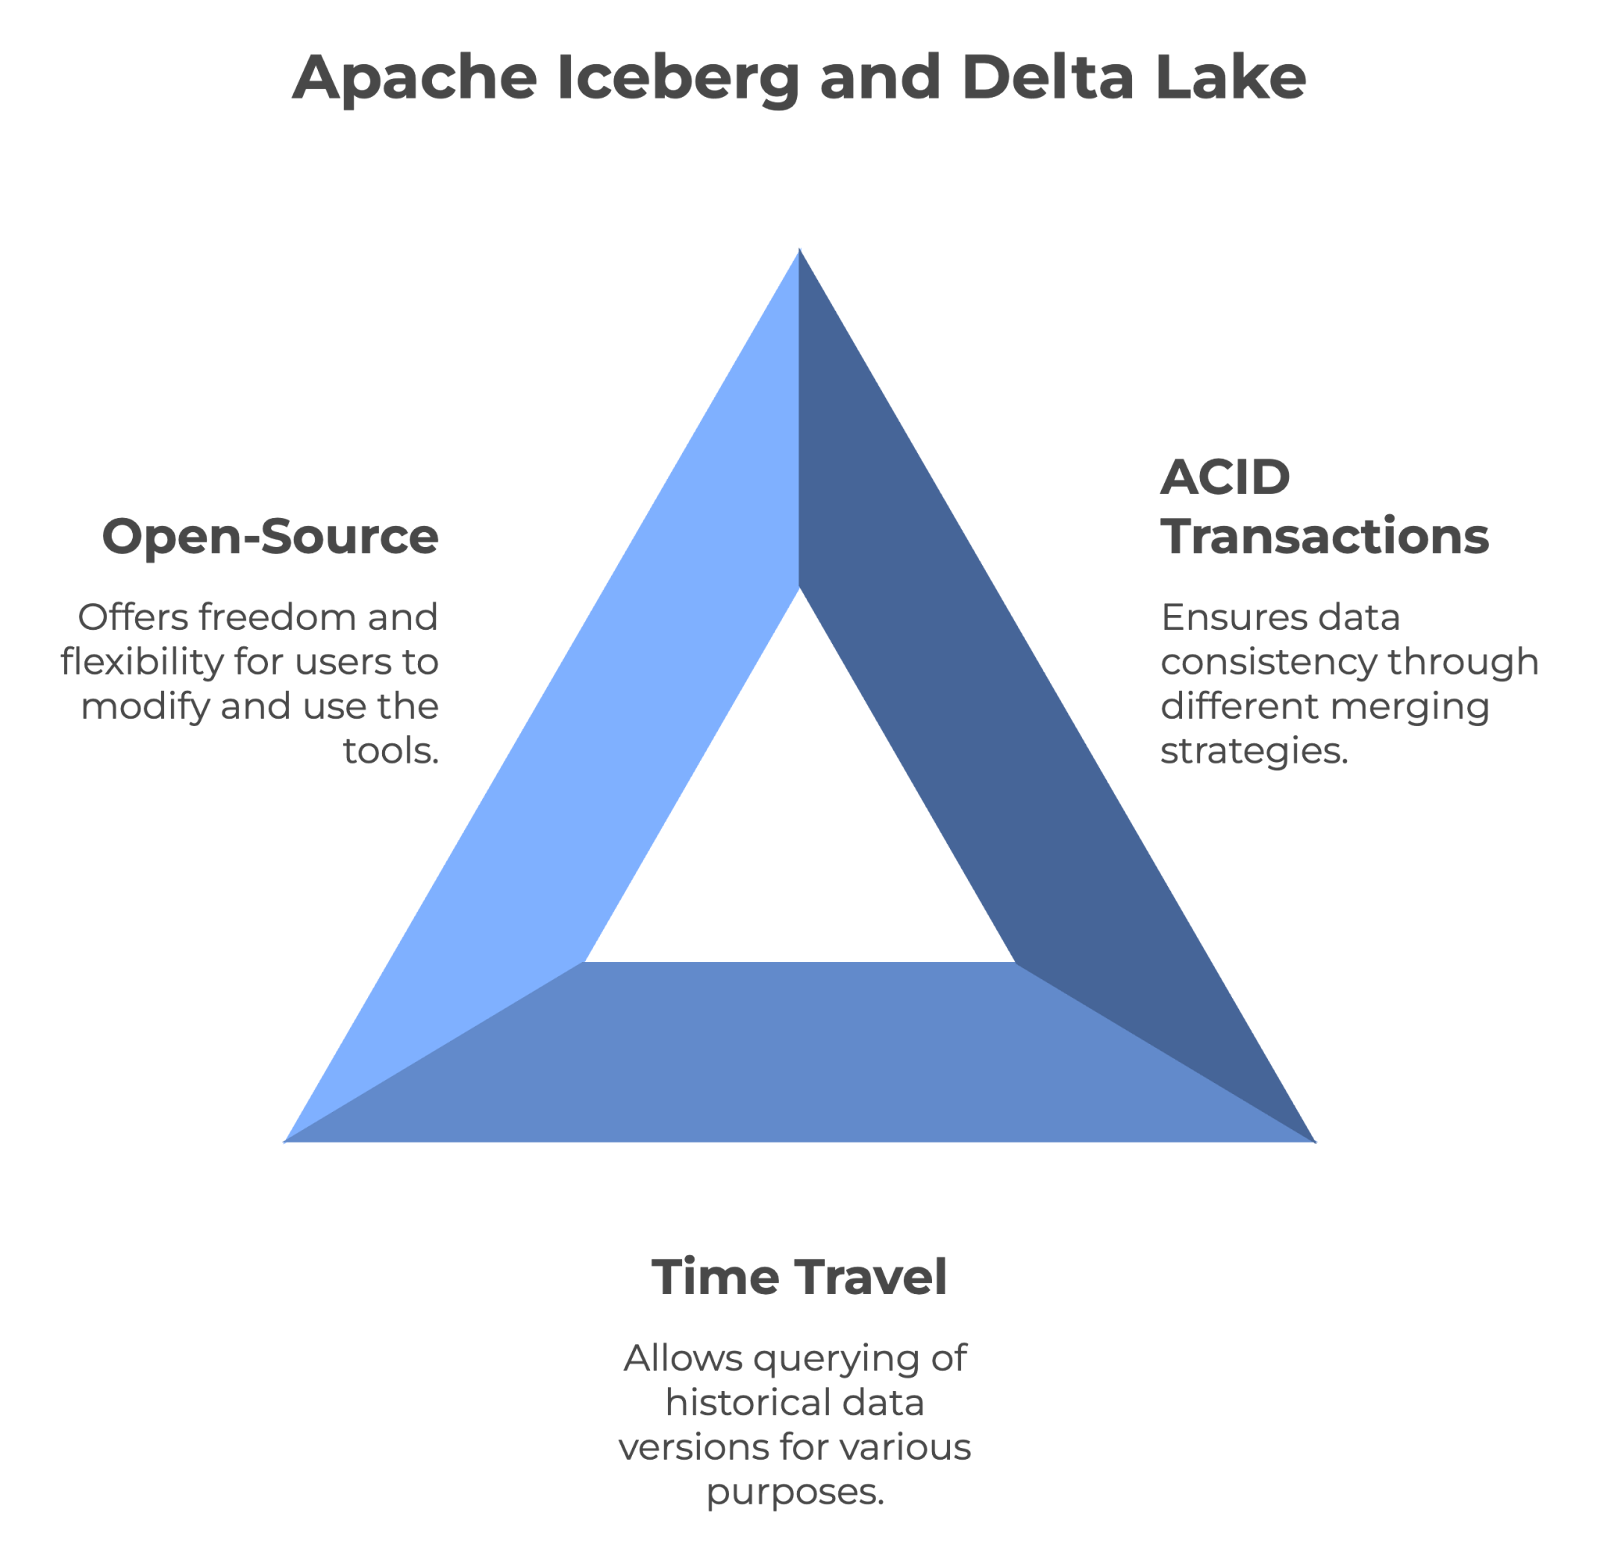
De belangrijkste functies die Apache Iceberg en Delta Lake delen. Afbeelding door de auteur, gemaakt met napkin.ai.
Iceberg vs Delta Lake: kernverschillen in architectuur
Hoewel Iceberg en Delta Lake overeenkomsten hebben, verschillen ze in architectuur. Zo zit dat:
Transactiemodel
Iceberg en Delta Lake zorgen voor databetrouwbaarheid in data lakes, maar bereiken dit via verschillende mechanismen. Iceberg gebruikt snapshots voor atomaire transacties om te verzekeren dat wijzigingen volledig worden doorgevoerd of teruggedraaid. Maar Delta Lake gebruikt transactielogboeken om te garanderen dat alleen gevalideerde wijzigingen aan de tabel worden doorgevoerd en biedt zo betrouwbaarheid bij data-updates.
Metadatabeheer
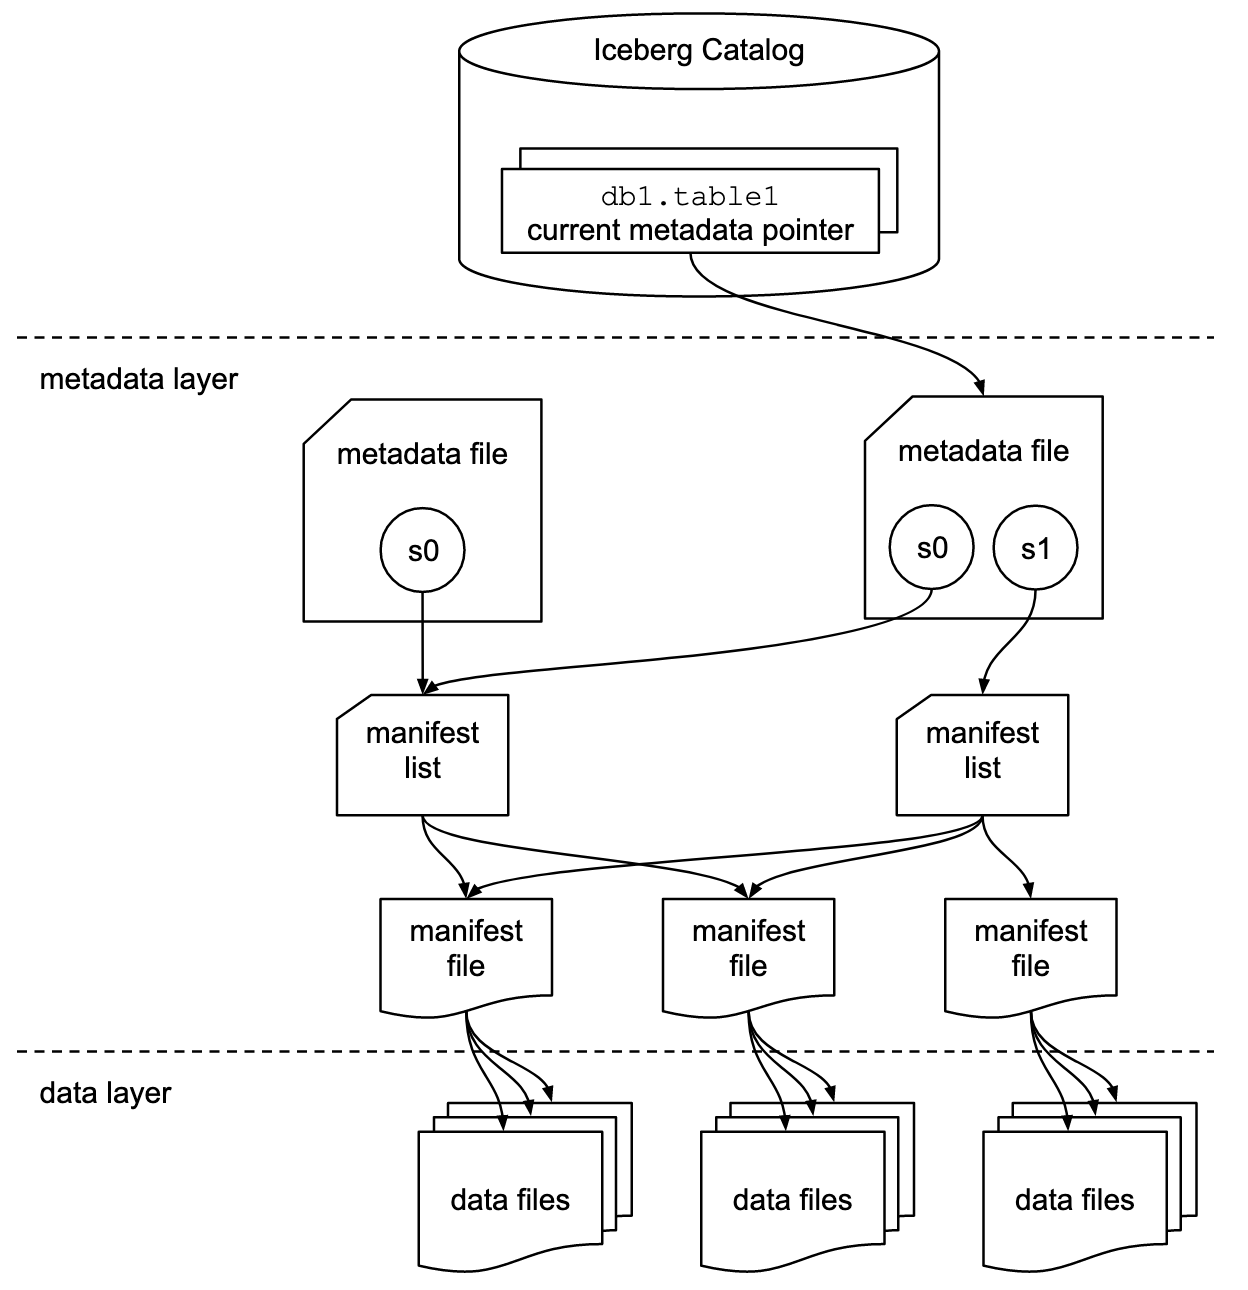
Apache Iceberg hanteert een hiërarchische metadatastructuur, met manifestbestanden, manifestlijsten en metadatabestanden. Dit ontwerp stroomlijnt queryverwerking door dure bewerkingen zoals bestandslijstjes maken en hernoemen te elimineren.
Delta Lake daarentegen hanteert een transactiegerichte aanpak waarbij elke transactie in een log wordt vastgelegd. Om de query-efficiëntie te vergroten en het logbeheer te vereenvoudigen, worden deze logs periodiek geconsolideerd in Parquet checkpoint-bestanden, die de volledige tabelstatus vastleggen.
Bestandsformaat-compatibiliteit
Iceberg is flexibel met bestandsformaten en werkt native met Parquet-, ORC- en Avro-bestanden. Dit is handig als je data in verschillende formaten hebt of als je in de toekomst van formaat wilt wisselen zonder je hele systeem te wijzigen.
Delta Lake slaat data primair op in het Parquet-formaat, omdat Parquet efficiënt is, vooral voor analytische queries. Het focust op één formaat om de best mogelijke prestaties voor dat specifieke bestandstype te leveren.
Prestaties en schaalbaarheid
Iceberg en Delta Lake schalen data lakes, maar hanteren verschillende strategieën. Iceberg prioriteert geavanceerde dataorganisatie met functies zoals partitionering en compactie, terwijl Delta Lake hoge prestaties benadrukt via de Delta Engine, automatische compactie en indexeringsmogelijkheden.
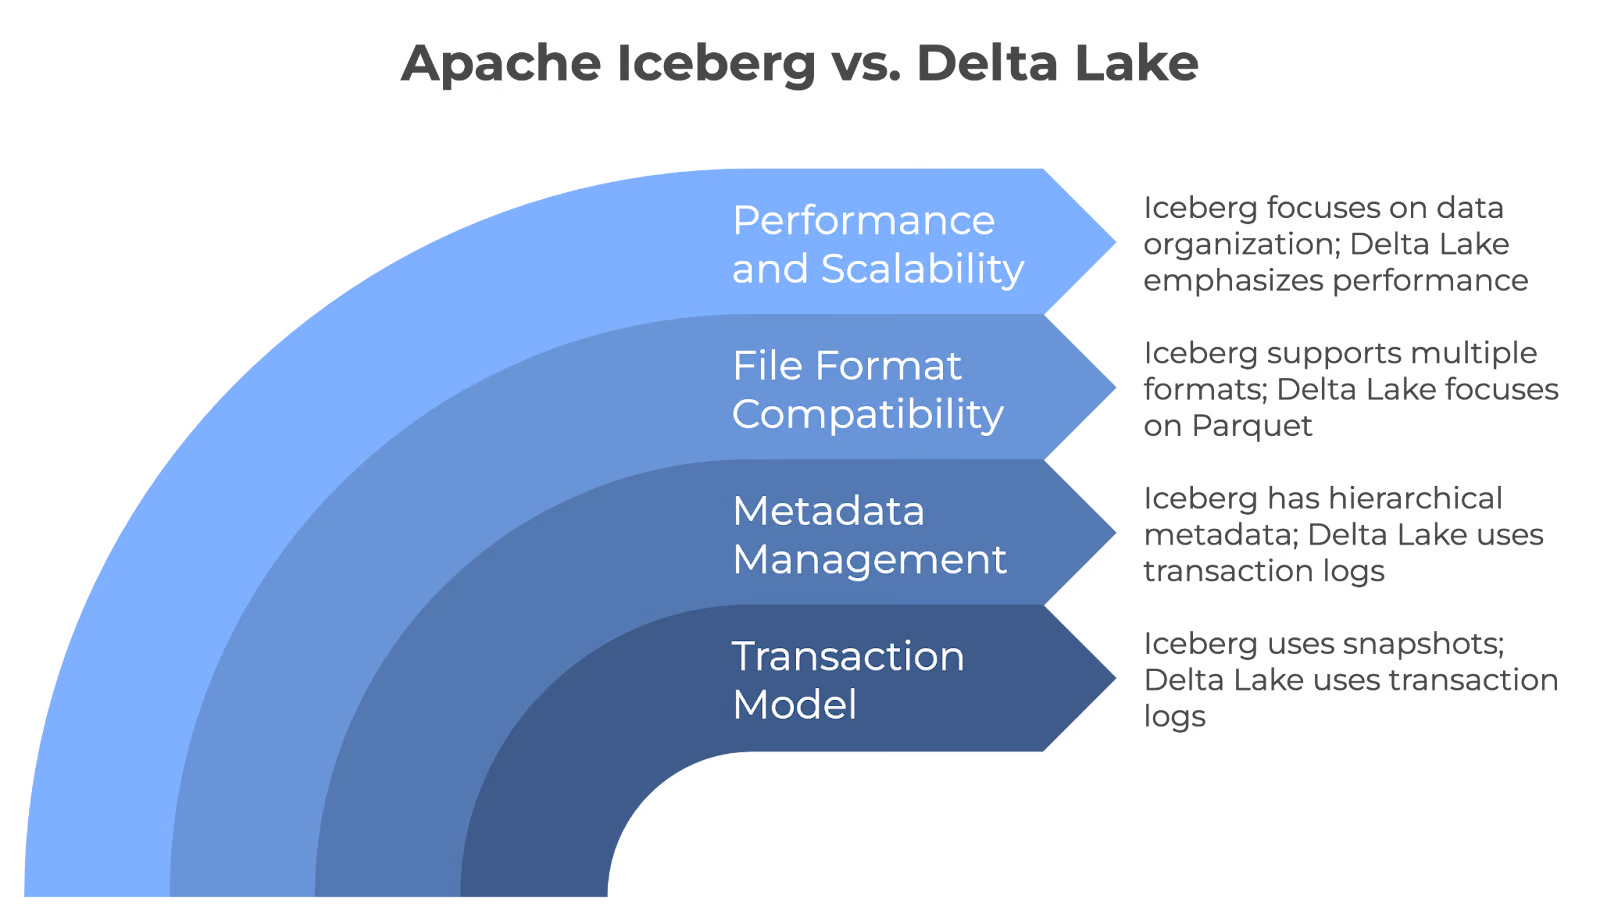
Kernverschillen tussen Apache Iceberg en Delta Lake. Afbeelding door de auteur, gemaakt met napkin.ai.
Use-cases voor Apache Iceberg
Dankzij zijn unieke functies is Apache Iceberg snel uitgegroeid tot een favoriete oplossing voor modern datalakebeheer. Laten we enkele primaire use-cases bekijken om de sterke punten te begrijpen.
Cloud-native data lakes
Dit is waarom Iceberg een populaire keuze is voor organisaties die data lakes op cloudschaal bouwen:
- Sterke schema-evolutie: Je kunt kolommen toevoegen, verwijderen of wijzigen zonder bestaande queries te beïnvloeden. Als je bijvoorbeeld een nieuw veld wilt toevoegen om gebruikersvoorkeuren bij te houden, kun je dat doen zonder je hele dataset opnieuw op te bouwen of al je queries aan te passen.
- Prestaties: Geavanceerde technieken zoals dataclustering en metadatabeheer optimaliseren queryprestaties. Ze snoeien snel overbodige databestanden weg om de hoeveelheid gescande data te verminderen en de querysnelheid te verbeteren.
- Schaalbaarheid: Beheer miljarden bestanden en petabytes aan data. Bovendien laat de functie partition evolution je de data-indeling wijzigen zonder downtime of dure migraties.
Complexe datamodellen
Teams die met complexe datamodellen werken, vinden Iceberg bijzonder nuttig vanwege het volgende:
- Schemaflexibiliteit: Ondersteunt geneste datatypes (structs, lijsten en mappen) om complexe relaties te representeren. Een e-commerceplatform kan bijvoorbeeld bestelinformatie opslaan, inclusief geneste structuren voor items en klantdata, allemaal binnen één tabel.
- Time-travel-queries: Deze methode bewaart snapshots van je data zodat je data kunt bevragen zoals die op elk moment in het verleden bestond. Dit is van onschatbare waarde om de staat van je data op een bepaald moment te reconstrueren voor compliance-doeleinden of om analyses opnieuw uit te voeren op historische snapshots.
Integratie met tools
Iceberg is compatibel met diverse tools en is daardoor een veelzijdige keuze binnen het data-ecosysteem. Laten we enkele van de belangrijkste integraties bekijken:
Iceberg werkt naadloos met het volgende:
- Apache Spark voor grootschalige dataverwerking en machine learning.
- Trino voor snelle, gedistribueerde SQL-queries over meerdere databronnen.
- Apache Flink voor realtime streamverwerking en batchberekening.
De volgende grote cloudproviders bieden native ondersteuning voor Iceberg:
- Amazon Web Services (AWS) integreert met AWS Glue, Redshift, EMR en Athena.
- Google Cloud Platform (GCP) werkt met BigQuery en Dataproc.
- Microsoft Azure is compatibel met Azure Synapse Analytics.
Iceberg biedt ook clientbibliotheken voor verschillende programmeertalen, zoals:
- SQL schrijft standaard SQL-queries tegen Iceberg-tabellen.
- Python gebruikt PySpark of bibliotheken zoals pyiceberg voor datamanipulatie.
- Java maakt gebruik van de native Java-API voor low-level bewerkingen en maatwerkintegraties.

Apache Iceberg-specificatie voor het tabelformaat. Beeldbron: Iceberg-documentatie.
Use-cases voor Delta Lake
Delta Lake kan veelvoorkomende uitdagingen oplossen en databeheer eenvoudiger maken. Laten we enkele situaties bekijken waarin het echt helpt.
Geünificeerde batch- en streamingworkloads
Met Delta Lake heb je geen aparte systemen nodig voor verschillende datatypes. In plaats daarvan kun je één systeem hebben dat alles aankan. Je kunt nieuwe data in realtime aan je tabellen toevoegen, die vervolgens meteen klaar is voor analyse. Je data is dus altijd up-to-date.
Je kunt één workflow bouwen die oude en nieuwe data verwerkt, waardoor je hele systeem minder complex en makkelijker te beheren wordt. Deze uniforme aanpak vereenvoudigt je datapijplijnen.
ACID-transacties voor data lakes
Delta Lake brengt sterke databetrouwbaarheid naar data lakes via ACID-transacties. Bijvoorbeeld:
- Ziekenhuizen kunnen nauwkeurige en actuele patiëntgegevens bijhouden om goede zorg te bieden en privacyregels te volgen.
- Banken kunnen ervoor zorgen dat alle financiële transacties accuraat worden vastgelegd en niet per ongeluk kunnen worden gewijzigd.
- Winkels kunnen hun voorraadniveaus precies houden, zelfs bij veel gelijktijdige updates. Dit helpt problemen te voorkomen, zoals het verkopen van artikelen die niet op voorraad zijn.
Delta Lake bereikt deze betrouwbaarheid door te zorgen dat alle wijzigingen ofwel volledig worden toegepast of helemaal niet. Daarnaast zorgt het ervoor dat data altijd van de ene geldige staat naar de andere gaat en dat verschillende bewerkingen elkaar niet in de weg zitten.
Apache Spark-ecosysteem
Delta Lake werkt ook naadloos met Apache Spark, een groot voordeel voor veel organisaties. Als je al Spark gebruikt, is Delta Lake toevoegen eenvoudig en zijn er geen grote wijzigingen in je huidige setup nodig. Je team kan dezelfde Spark-tools en SQL-commando's gebruiken waarmee ze al vertrouwd zijn.
Daardoor zullen je Spark-jobs sneller draaien, vooral bij grote hoeveelheden data. Dit gebeurt door data efficiënter te organiseren en slimme indexeringstechnieken te gebruiken.
Apache Iceberg vs Delta Lake: een samenvatting
Laten we de belangrijkste verschillen tussen Apache Iceberg en Delta Lake samenvatten, zodat je snel hun sterke punten en kernfuncties begrijpt.
|
Functies |
Apache Iceberg |
Delta Lake |
|
ACID-transactie |
Ja |
Ja |
|
Time travel |
Ja |
Ja |
|
Dataversies |
Ja |
Ja |
|
Bestandsformaat |
Parquet, ORC, Avro |
Parquet |
|
Schema-evolutie |
Volledig |
Gedeeltelijk |
|
Integratie met andere engines |
Apache Spark, Trino, Flink |
Voornamelijk Apache Spark |
|
Cloudcompatibiliteit |
AWS, GCP, Azure |
AWS, GCP |
|
Query-engines |
Spark, Trino, Flink |
Spark |
|
Programmeertaal |
SQL, Python, Java |
SQL, Python |
Opmerking: De beste keuze hangt af van je behoeften, schaalbaarheidsvereisten en langetermijn datastrategie.
Conclusie
Kies je tussen Apache Iceberg en Delta Lake, kijk dan naar je specifieke use-case en je bestaande technologiestack. De flexibiliteit van Iceberg met bestandsformaten en query-engines maakt het ideaal voor cloud-native omgevingen. De nauwe integratie van Delta Lake met Apache Spark is echter een goede optie voor organisaties die zwaar in het Spark-ecosysteem hebben geïnvesteerd.
Je kunt ook enkele relevante DataCamp-bronnen bekijken om je bestaande databasis te versterken:
- Understanding Data Engineering-cursus om fundamentele concepten te begrijpen
- Database Design en Data Warehousing-cursussen voor het effectief structureren van grootschalige data.
- Modern Data Architecture-cursus om te leren over huidige best practices en trends.
Veel leerplezier!
FAQs
Wat is het belangrijkste verschil tussen Merge-on-Read en Merge-on-Write-strategieën?
Merge-on-Read (gebruikt door Iceberg) leest data uit bestaande bestanden en past wijzigingen toe tijdens de query. Merge-on-Write (gebruikt door Delta Lake) voegt updates samen met de basisdata tijdens het schrijven om snellere reads te garanderen, ten koste van tragere write-bewerkingen.
Kunnen Apache Iceberg en Delta Lake data op petabyteschaal aan?
Ja, zowel Apache Iceberg als Delta Lake gaan efficiënt om met datasets op petabyteschaal. Ze bieden geavanceerde functies zoals partitionering, metadatabeheer en compactie om de prestaties van grote data lakes te optimaliseren.
Hoe presteren Apache Iceberg en Delta Lake bij het bevragen van diep geneste datastructuren?
Apache Iceberg blinkt uit in het bevragen van diep geneste datastructuren. Het ondersteunt tabelopslagformaten zoals Parquet, die zijn geoptimaliseerd voor geneste data. Delta Lake ondersteunt eveneens geneste data, maar de prestaties kunnen variëren afhankelijk van de querycomplexiteit en de grootte van de dataset.
Kunnen Apache Iceberg en Delta Lake samenwerken in dezelfde data lake-architectuur?
Ja, zowel Apache Iceberg als Delta Lake kunnen naast elkaar bestaan binnen hetzelfde datalake. Elk kan worden gebruikt voor verschillende use-cases, afhankelijk van de vereisten. Zo kun je Delta Lake inzetten voor workloads rond Apache Spark en Iceberg voor flexibelere integratie met diverse query-engines.
Zijn er beperkingen bij het gebruik van Delta Lake met niet-Spark-engines?
Delta Lake is nauw geïntegreerd met Apache Spark, en hoewel het met andere engines zoals Presto of Hive kan werken, zijn deze integraties nog in ontwikkeling. De prestaties zijn mogelijk niet zo geoptimaliseerd als met Spark, wat de effectiviteit buiten het Spark-ecosysteem kan beperken.
Hoe gaan Iceberg en Delta Lake om met small file-problemen in data lakes?
Zowel Apache Iceberg als Delta Lake pakken het small files-probleem aan via compactie. Iceberg voegt periodiek kleine bestanden samen om queryprestaties te optimaliseren, terwijl Delta Lake automatische compactie gebruikt om bestanden tijdens schrijfbewerkingen te consolideren. Dit zorgt voor betere prestaties door de overhead van veel kleine bestanden te verminderen.
Waarom heeft Databricks Tabular (het bedrijf achter Iceberg) overgenomen?
Databricks nam Tabular over om zijn mogelijkheden met Apache Iceberg te versterken, dat oorspronkelijk is gemaakt door de oprichters van Tabular. De overname is bedoeld om de compatibiliteit en interoperabiliteit tussen Delta Lake en Iceberg te verbeteren, met als uiteindelijk doel een verenigd lakehouse-formaat dat de sterke punten van beide open-sourceprojecten combineert.
Wat betekent de Tabular-overname voor gebruikers van Delta Lake en Iceberg?
De overname betekent dat Databricks actief zal werken aan het dichter bij elkaar brengen van Delta Lake en Iceberg qua compatibiliteit. Gebruikers profiteren van verbeterde integratie, waarbij Delta Lake UniForm al dient als platform om interoperabiliteit tussen Delta Lake, Iceberg en Apache Hudi mogelijk te maken. Dit stelt gebruikers in staat om over verschillende formaten te werken zonder aan één oplossing vast te zitten.
Blijft Databricks zowel Delta Lake als Iceberg ondersteunen?
Ja, Databricks heeft zijn betrokkenheid bij beide formaten bevestigd. Door Tabular over te nemen en de oorspronkelijke makers van Apache Iceberg aan boord te halen, wil Databricks samenwerking tussen de Iceberg- en Delta Lake-gemeenschappen stimuleren. Het doel is om één open standaard voor lakehouse-formaatinteroperabiliteit te ontwikkelen, wat gebruikers meer opties en flexibiliteit biedt.
Ik ben een contentstrateeg die graag complexe onderwerpen eenvoudig maakt. Ik heb bedrijven als Splunk, Hackernoon en Tiiny Host geholpen om boeiende en informatieve content te maken voor hun doelgroep.


